Переранжирование
Строит для 40 юридических запросов CLERC короткие списки BM25 по 30 пассажей, а затем одним вопросом TypeSafe на каждую пару «запрос–кандидат» поднимает точность top-1 с 5% до 18%, а точность top-10 — с 38% до 62%.
У вас есть тысячи документов, и нужно найти тот, который отвечает на конкретный вопрос. Так как же его найти?
Сначала быстрый метод, например сопоставление по ключевым словам, сокращает эти тысячи кандидатов до короткого списка правдоподобных. Это мы называем быстрым поиском.
Быстрый поиск хорошо справляется с этим, но не может сказать, какой из кандидатов в коротком списке правильный. Здесь и вступает в дело переранжирование. Оно напрямую оценивает каждого кандидата из короткого списка против запроса и ставит лучшего первым.
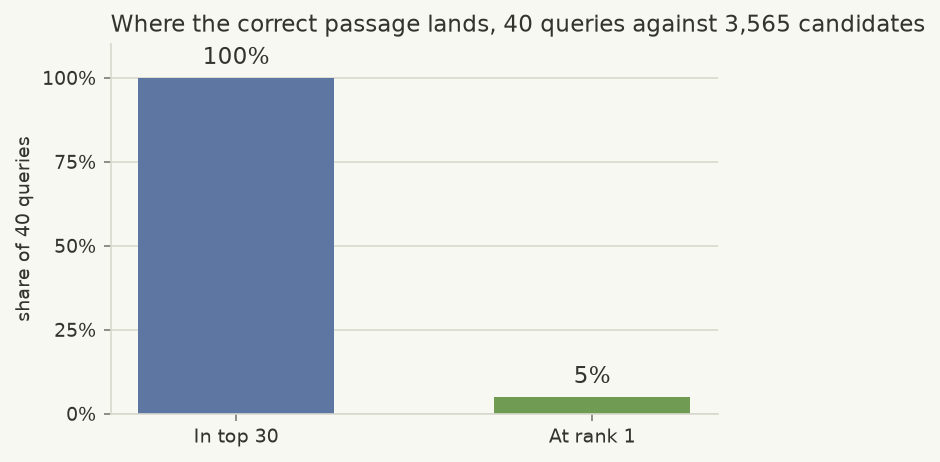
Оба шага выполняются ниже на 3,565 пассажах судебных мнений из набора данных CLERC: BM25 строит короткий список быстрого поиска из 30 кандидатов для каждого из 40 запросов, затем TypeSafe переранжирует каждый короткий список. С переранжированием правильный пассаж оказывается на первом месте для 18% запросов — против 5% при одном только быстром поиске.
По ходу вы узнаете:
- Что делает быстрый поиск и почему это не весь ответ
- Что такое переранжирование и как оно встаёт после шага быстрого поиска
- Как TypeSafe оценивает одного кандидата против запроса и насколько это улучшает результат
Попробуйте сами
Откройте запрос, кандидата и вопрос переранжирования в Playground TypeSafe
Как найти один документ среди тысяч?
У вас есть груда документов и запрос — фрагмент текста, описывающий то, что вы ищете. Где-то в этой груде лежит один документ, который на него отвечает.
Проверять каждый документ против запроса по одному работает, при одной проверке на документ: миллионы документов означают миллионы проверок на запрос. Производительность можно улучшить двухшаговым подходом:
- Сократите груду до короткого списка вероятных кандидатов методом, достаточно быстрым, чтобы прогнать его по всей груде.
- Примените к этому короткому списку более точный шаг, чтобы найти единственно верный ответ.

Этот cookbook проверяет такую схему на наборе данных судебных мнений, в разделе Пример переранжирования ниже.
Что такое быстрый поиск?
Быстрый поиск — это любой метод, способный сравнить запрос с каждым документом большого корпуса и быстро вернуть ранжированный короткий список. Обычные методы включают поиск по ключевым словам, например BM25, и плотные эмбеддинги, которые сравнивают пассажи по смыслу. Системы часто сочетают оба метода.
Первый шаг здесь — BM25 и ничего больше. BM25 ранжирует пассажи по общим словам. Простота этого шага оставляет всё внимание на переранжировании, ради чего и написан cookbook. Выбор метода быстрого поиска — второстепенный вопрос: переранжирование видит только те пассажи, что попали в короткий список.
Что такое переранжирование?
Переранжирование берёт короткий список, уже построенный быстрым поиском, и ставит его в лучший порядок. Вместо того чтобы сравнивать запрос со всем корпусом сразу, оно сравнивает запрос с каждым кандидатом из короткого списка по отдельности и сортирует короткий список по этой оценке.
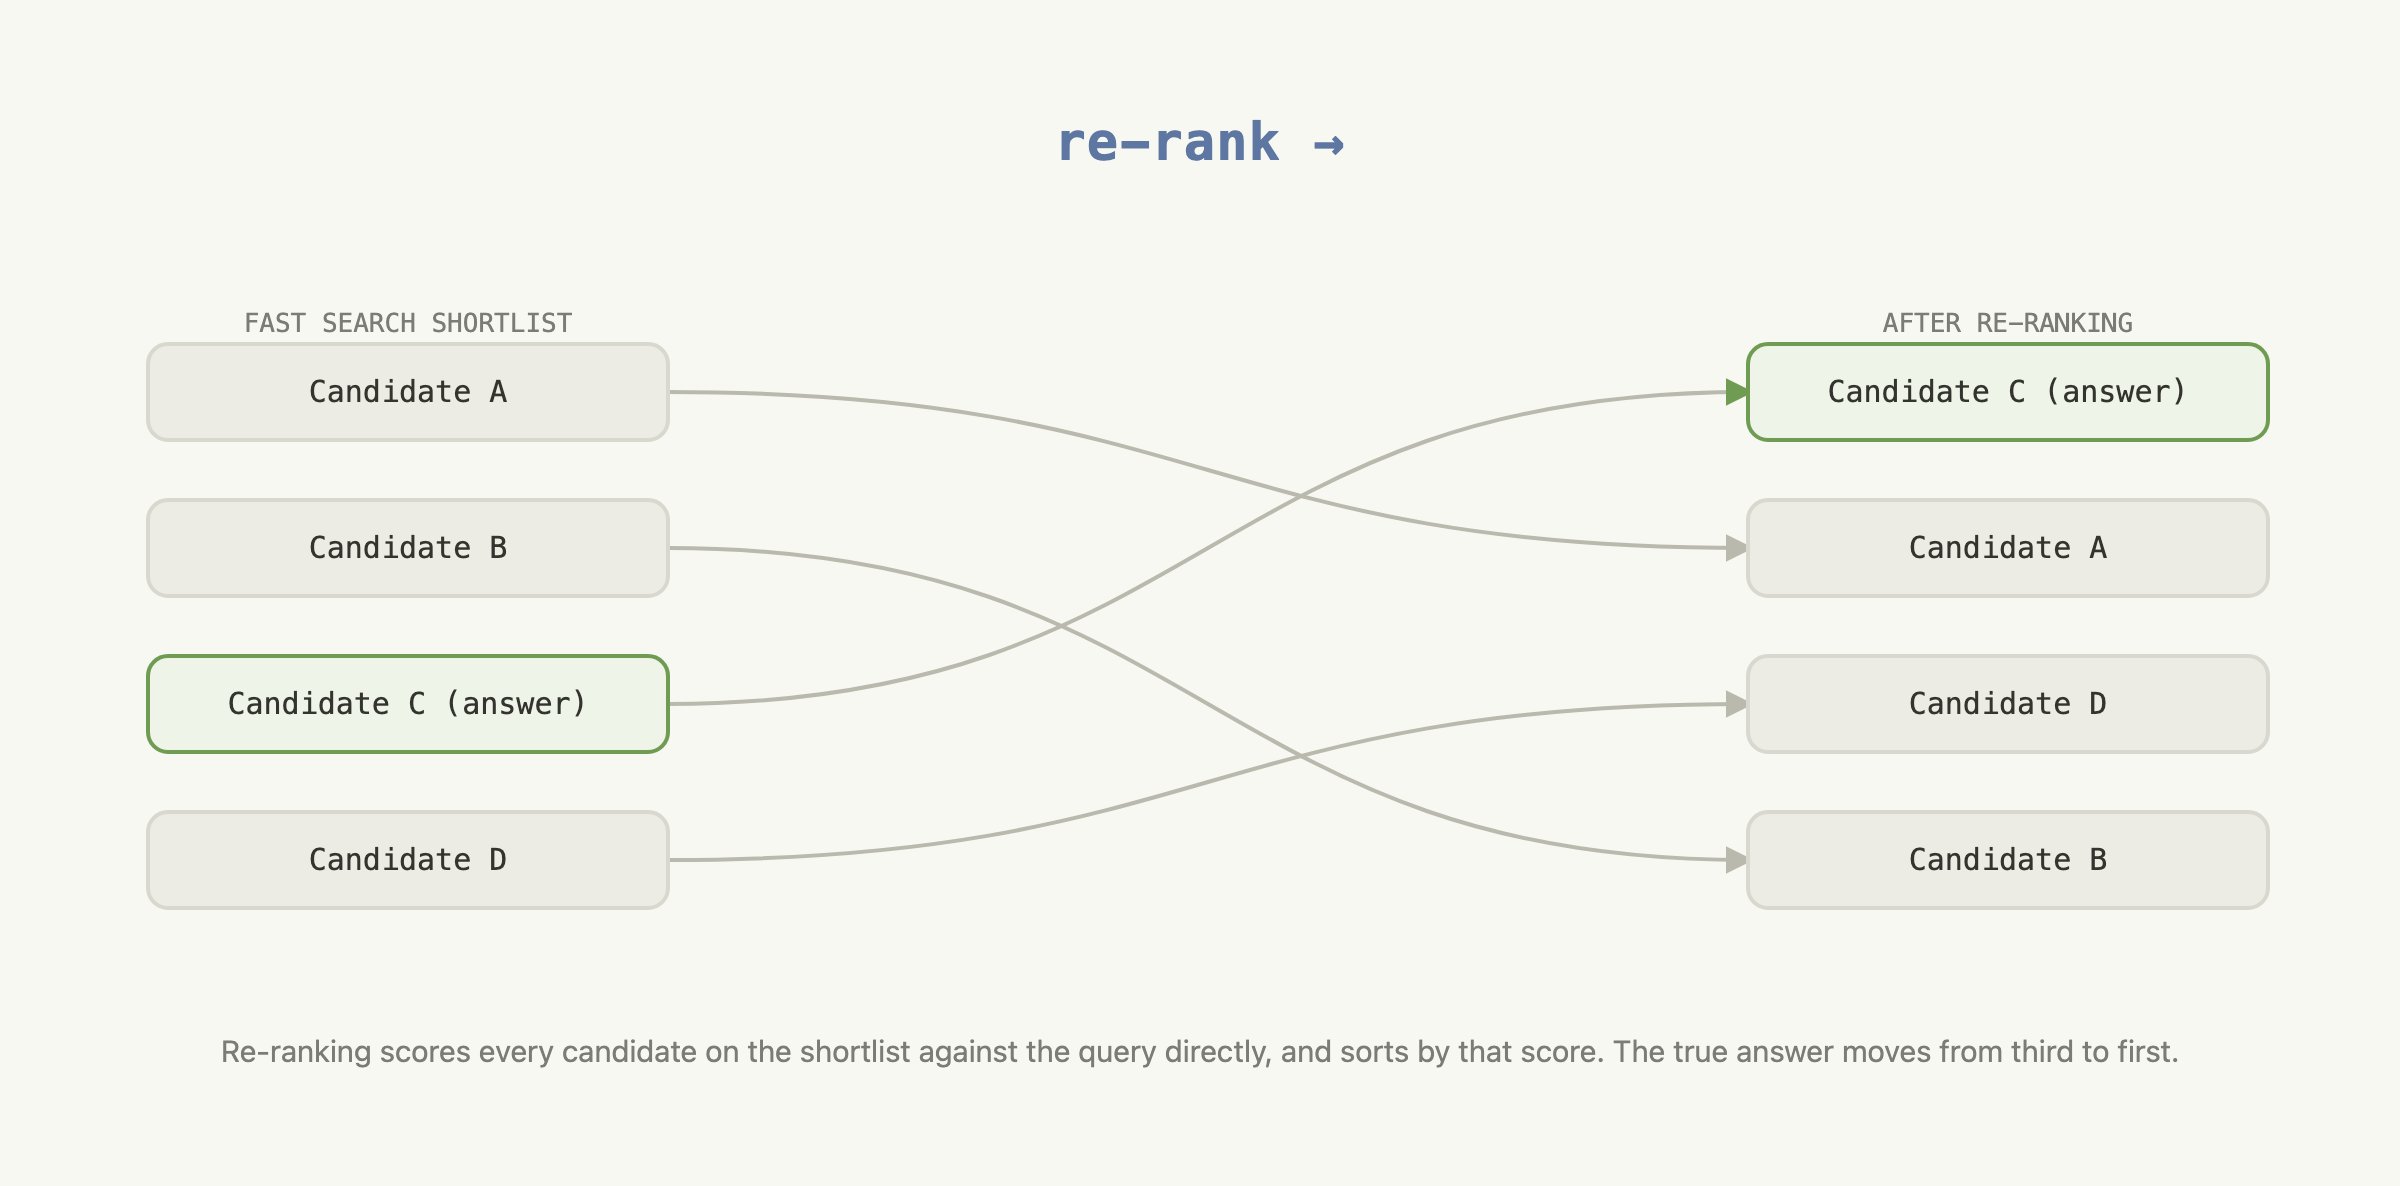
Оценка может исходить от языковой модели. Дайте ей запрос и одного кандидата вместе и спросите, насколько хорошо кандидат отвечает на запрос. Тогда переранжирование находит лучшее совпадение в коротком списке, даже когда его формулировка отличается от запроса.
Переранжирование с TypeSafe
Переранжировщику нужна сопоставимая оценка для каждой пары запрос–кандидат. Языковая модель общего назначения может выдавать такие оценки или ранжировать весь короткий список напрямую. Однако для независимой оценки пар нужно задать шкалу оценок и попросить модель применять один и тот же критерий к каждому кандидату. Повторные вызовы всё равно могут давать разные оценки для одной пары, а генерация общего назначения добавляет время и стоимость задаче, которой нужно лишь одно число.
Что возвращает TypeSafe
С TypeSafe запрос на оценку может остаться вопросом да/нет:
Could this candidate passage be from the cited precedent?Простое «да» или «нет» не позволило бы ранжировать 30 кандидатов. Вместо этого Noul возвращает число от 0 до 1, называемое noul. Noul — это оценка TypeSafe того, насколько вероятно, что ответ будет «да».
Критерии вопроса определяют, что считается истинным, а что ложным. TypeSafe применяет их к каждой паре запрос–кандидат и возвращает noul напрямую. Этот noul и есть оценка, по которой сортирует приложение. Не нужно изобретать шкалу оценок для модели общего назначения, а TypeSafe создан, чтобы выполнять эту повторяющуюся оценку быстрее, дешевле и согласованнее.
В упрощённом псевдокоде один вызов оценки TypeSafe выглядит так:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafe читает запрос и одного кандидата вместе относительно этого вопроса и возвращает noul.
С помощью этого можно переранжировать короткий список, прогнав один и тот же вопрос по каждому кандидату из него, а затем отсортировав короткий список по noul, который вернул каждый вызов, от большего к меньшему.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
Диаграмма ниже показывает, как один запрос на кандидата даёт оценки, по которым переупорядочивается короткий список.
flowchart LR
    q["query excerpt<br/><i>one opinion passage,<br/>citation removed</i>"]
    sl["shortlist from fast search<br/><i>30 candidate passages</i>"]
    quest["<b>one Noul</b><br/>could this candidate be<br/>from the cited precedent?<br/><i>criteria fix true and false</i>"]

    %% direction LR inside an LR chart keeps each state beside its noul, two columns,
    %% so the fan-out is four rows tall instead of eight
    subgraph fan["one request per candidate · no request sees another"]
        direction LR
        d1["state<br/>{query, candidate 1}"] --> n1["noul<br/>0.87"]
        d2["state<br/>{query, candidate 2}"] --> n2["noul<br/>0.41"]
        dx["⋮"] --> nx["⋮"]
        d30["state<br/>{query, candidate 30}"] --> n30["noul<br/>0.12"]
    end

    sort["sort by noul,<br/>highest first"]
    out["re-ranked shortlist<br/><i>same 30, better order</i>"]

    q --> fan
    sl --> fan
    quest --> fan
    fan --> sort --> out

    %% the elision is not a node - drop its box so it reads as "and so on"
    classDef elide fill:none,stroke:none
    class dx,nx elide
    linkStyle 2 stroke:none
Пример переранжирования
Быстрый поиск и переранжирование теперь выполняются на CLERC, наборе данных для юридического поиска. В этом примере 3,565 пассажей судебных мнений и 40 запросов.
Установка
Первый шаг устанавливает пакеты, от которых зависит это руководство.
bm25sиdatasetsстроят короткий список быстрого поиска.typesafe-sdkиcooksafeотвечают за переранжирование и кэширование API.matplotlibрисует графики результатов.
pip install bm25s datasets matplotlib 'cooksafe>=0.2.0,<0.3.0'Следующий блок настраивает клиент TypeSafe и константы, которые использует остальное руководство, — например, какую модель TypeSafe вызывать и насколько большим должен быть короткий список, который быстрый поиск передаёт переранжировщику. Для вызова TypeSafe нужен TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Ранжирование пассажей быстрым поиском
Набор данных здесь — это корпус судебных мнений судов США, 170 строк, объединённых вместе. Каждая строка устроена так:
- Запрос: отрывок мнения, из которого удалена цитата.
- Gold: пассаж, на который указывала удалённая цитата, единственный правильный ответ на запрос.
- Кандидаты: все остальные пассажи корпуса, каждый — то, с чем запрос мог бы ошибочно совпасть.
Из 170 строк 40 отобраны для оценки в качестве запросов. Остальные 130 появляются только как кандидаты.
Следующая ячейка строит короткий список, используя технику, описанную выше:
- Загрузите корпус.
- Ранжируйте его против каждого запроса с помощью BM25.
Здесь TypeSafe пока нет, это только шаг быстрого поиска.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)

def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]

@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}

def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}

def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None

SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"

def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)

ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)
Быстрый поиск редко ставит нужный пассаж первым
График показывает, куда быстрый поиск помещает правильный пассаж из 3,565 кандидатов.
Быстрый поиск надёжно сокращает корпус до короткого списка, содержащего правильный ответ. Он содержит правильный ответ для 100% из 40 запросов. Но этот пассаж редко оказывается первым в коротком списке — лишь в 5% случаев.
Переранжирование ниже только переупорядочивает 30 кандидатов, уже попавших в короткий список. Оно не может добавить пассаж, который быстрый поиск не отобрал. Здесь короткий список содержит правильный пассаж для всех 40 запросов, так что переранжирование может сосредоточиться на том, чтобы поставить каждый в лучшую позицию.
Переранжирование с помощью TypeSafe
Переранжирование оценивает каждого кандидата из короткого списка против его запроса, затем сортирует по этой оценке. Вопрос, который TypeSafe задаёт о каждой паре, — может ли кандидат быть тем пассажем, на который указывает удалённая цитата запроса.
Следующая ячейка делает следующее:
- Определите этот вопрос.
- Задайте его по одному разу на каждого кандидата в каждом коротком списке: 40 запросов умножить на 30 кандидатов — 1,200 вызовов всего, выполняемых параллельно, а не один за другим.
- Отсортируйте каждый короткий список по оценке, которую возвращает TypeSafe, получая переранжированный результат.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)

@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }

# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = is_cited_source.model_dump_json(exclude_none=True)
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}

def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)

chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.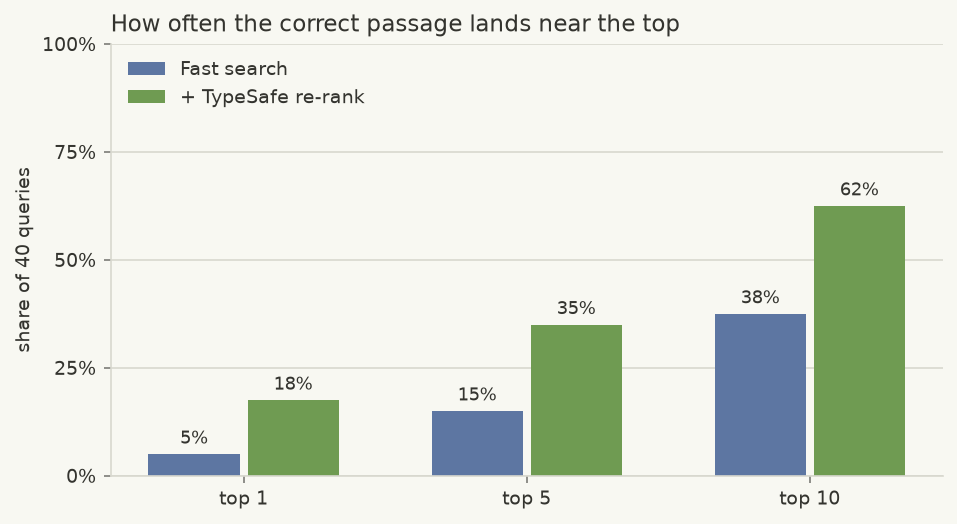
Переранжирование поднимает правильный ответ к вершине
График сравнивает быстрый поиск с быстрым поиском плюс переранжирование на трёх порогах. Переранжирование приближает правильный пассаж к вершине на каждом из них:
- Top 1 — 5% → 18%
- Top 5 — 15% → 35%
- Top 10 — 38% → 62%
Приведённые число токенов и стоимость охватывают все 1,200 вызовов TypeSafe, использованных для переранжирования 40 коротких списков.
Каждая строка CLERC содержит один правильный пассаж и 20 негативных. Это руководство объединяет пассажи из 170 строк в один общий корпус. Для каждого из 40 оценочных запросов BM25 отбирает 30 кандидатов из этого полного корпуса, а не только 20 негативных, приложенных к этой строке. Затем TypeSafe читает запрос против каждого отобранного кандидата и переранжирует эти 30 пассажей.
В этом руководстве для ясности задавался один вопрос на пару. Настоящее приложение задавало бы несколько вопросов об одной паре в одном вызове. См. cookbook о параллельных вопросах и шаблон «Спекулятивный fan-out».
Что дальше
Те же строительные блоки встречаются и в других местах документации TypeSafe:
- Noul — о том, как TypeSafe превращает вопрос да/нет в оценку.
- Спекулятивный fan-out — о том, как задать несколько вопросов об одном документе в одном вызове.
- Построчный поиск — о другом способе искать в корпусе по смыслу, а не по ключевым словам.