Reordenación
Construye listas cortas BM25 de 30 pasajes para 40 consultas legales de CLERC y luego usa una pregunta de TypeSafe por par consulta-candidato para subir la precisión top-1 del 5% al 18% y la precisión top-10 del 38% al 62%.
Tienes miles de documentos y necesitas encontrar el que responde a una pregunta concreta. Entonces, ¿cómo lo encuentras?
Primero, usa un método rápido como la coincidencia de palabras clave para reducir esos miles de candidatos a una lista corta de candidatos plausibles. A esto lo llamamos búsqueda rápida.
La búsqueda rápida es buena en eso, pero no puede decirte cuál de los candidatos de la lista corta es el correcto. Ahí es donde entra la reordenación. Puntúa cada candidato de la lista corta directamente contra la consulta y coloca el mejor en primer lugar.
Ambos pasos se ejecutan más abajo sobre 3,565 pasajes de opiniones judiciales del conjunto de datos CLERC: BM25 construye una lista corta de búsqueda rápida de 30 candidatos para cada una de las 40 consultas, y luego TypeSafe reordena cada lista corta. Con la reordenación, el pasaje correcto queda en primer lugar en el 18% de las consultas, frente al 5% de la búsqueda rápida sola.
En el camino, vas a aprender:
- Qué hace la búsqueda rápida y por qué no es toda la respuesta
- Qué es la reordenación y cómo encaja después de un paso de búsqueda rápida
- Cómo puntúa TypeSafe un candidato contra una consulta y cuánto mejora eso el resultado
Pruébalo tú mismo
Abre una consulta, un candidato y una pregunta de reordenación en el Playground de TypeSafe
¿Cómo encontramos un documento entre miles?
Tienes un montón de documentos y una consulta, un fragmento de texto que describe lo que buscas. En algún lugar del montón está el documento que responde a esa consulta.
Comprobar cada documento contra la consulta uno a uno funciona, a razón de una comparación por documento: millones de documentos significan millones de comparaciones por consulta. Puedes mejorar el rendimiento con un enfoque de dos pasos:
- Reduce el montón a una lista corta de candidatos probables, con un método lo bastante rápido para ejecutarse sobre todo el montón.
- Aplica un paso más preciso a esa lista corta para encontrar la respuesta exacta.

Este cookbook prueba esa configuración con un conjunto de datos de opiniones judiciales, en Un ejemplo de reordenación más abajo.
¿Qué es la búsqueda rápida?
La búsqueda rápida es cualquier método capaz de comparar una consulta con todos los documentos de un corpus grande y devolver rápidamente una lista corta ordenada. Entre los métodos habituales están la búsqueda por palabras clave, como BM25, y los embeddings densos, que comparan pasajes por su significado. A menudo los sistemas combinan ambos métodos.
El primer paso aquí es BM25 y nada más. BM25 ordena los pasajes por palabras compartidas. Mantener este paso simple deja la atención en la reordenación, que es el objetivo del cookbook. La elección del método de búsqueda rápida es un asunto secundario: la reordenación solo ve los pasajes que llegan a la lista corta.
¿Qué es la reordenación?
La reordenación toma la lista corta que ya produjo la búsqueda rápida y la pone en un orden mejor. En lugar de comparar la consulta con todo el corpus de una vez, compara la consulta con cada candidato de la lista corta por separado y ordena la lista corta según esa puntuación.
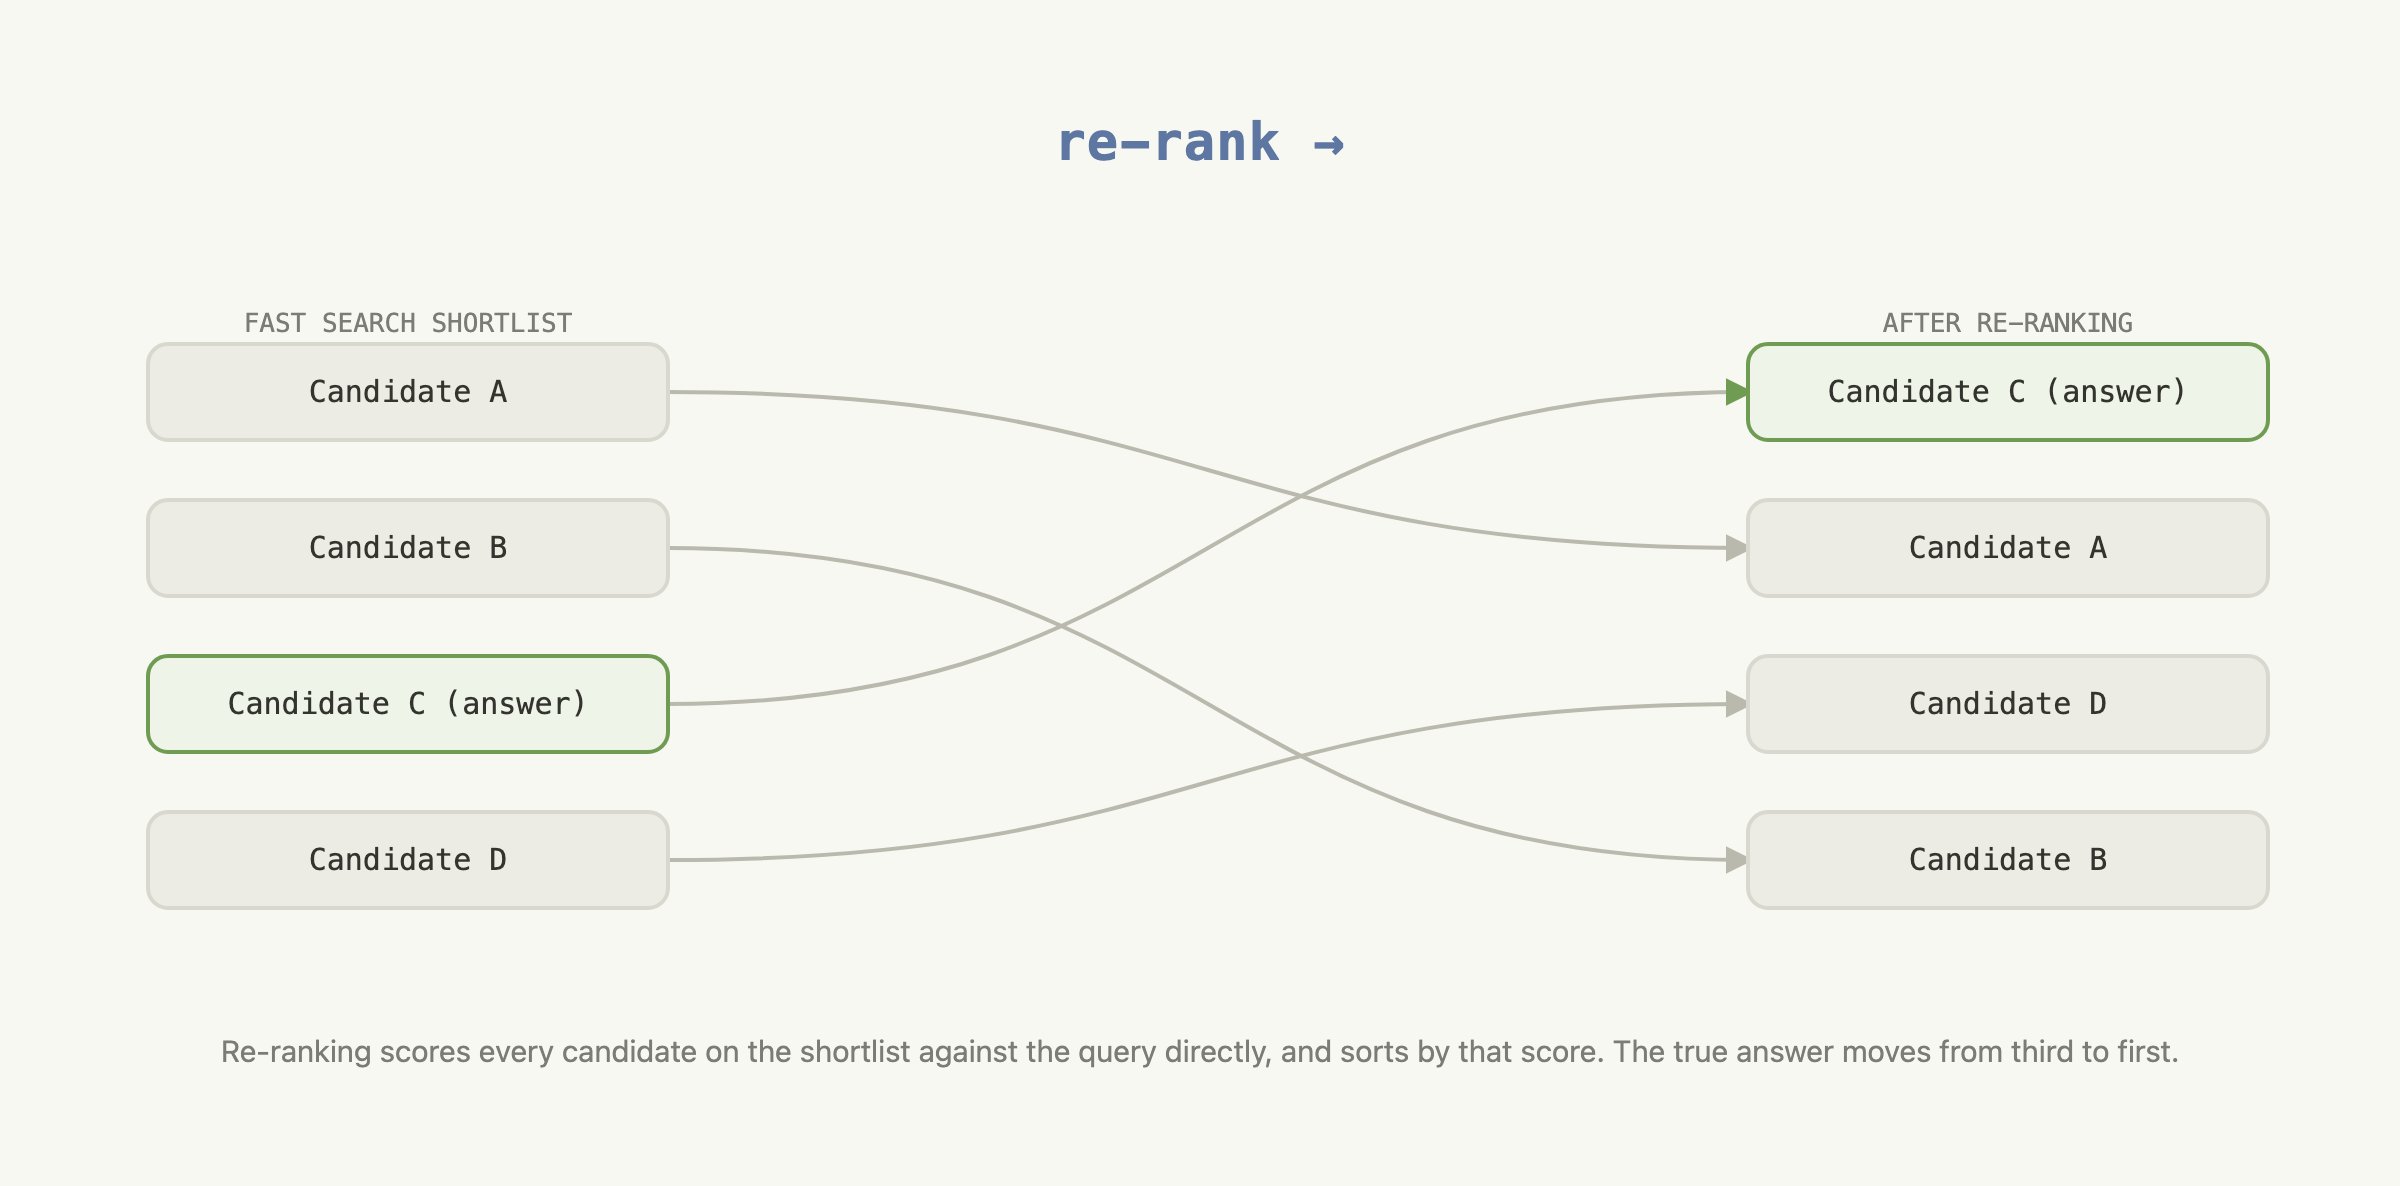
La puntuación puede venir de un modelo de lenguaje. Dale la consulta y un candidato juntos y pregúntale qué tan bien responde el candidato a la consulta. La reordenación encuentra entonces la mejor coincidencia de la lista corta, incluso cuando su redacción difiere de la de la consulta.
Reordenación con TypeSafe
Un reordenador necesita una puntuación comparable para cada par consulta-candidato. Un modelo de lenguaje de propósito general puede producir esas puntuaciones, o clasificar directamente toda la lista corta. Para puntuar pares de forma independiente, sin embargo, necesitas definir una escala de puntuación y pedirle al modelo que aplique el mismo criterio a cada candidato. Las llamadas repetidas pueden aun así producir puntuaciones distintas para el mismo par, mientras que la generación de propósito general añade tiempo y coste a una tarea que solo necesita un número.
Qué devuelve TypeSafe
Con TypeSafe, la solicitud de puntuación puede seguir siendo una pregunta de sí o no:
Could this candidate passage be from the cited precedent?Un simple sí o no no bastaría para ordenar 30 candidatos. Un Noul, en cambio, devuelve un número entre 0 y 1, llamado noul. El noul es la estimación de TypeSafe de la probabilidad de que la respuesta sea sí.
Los criteria de la pregunta definen qué cuenta como verdadero y qué como falso. TypeSafe los aplica a cada par consulta-candidato y devuelve el noul directamente. Ese noul es la puntuación por la que ordena la aplicación. No hay que inventar una escala de puntuación para un modelo de propósito general, y TypeSafe está construido para hacer esta puntuación repetida de forma más rápida, más barata y más consistente.
En pseudocódigo simplificado, una llamada de puntuación a TypeSafe se ve así:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafe lee la consulta y un candidato juntos contra esa pregunta y devuelve un noul.
Puedes usar esto para reordenar una lista corta ejecutando la misma pregunta contra cada candidato de la lista y luego ordenando la lista corta por el noul que devuelve cada llamada, de mayor a menor.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
El diagrama de abajo muestra cómo un request por candidato produce las puntuaciones que se usan para reordenar la lista corta.
flowchart LR
    q["query excerpt<br/><i>one opinion passage,<br/>citation removed</i>"]
    sl["shortlist from fast search<br/><i>30 candidate passages</i>"]
    quest["<b>one Noul</b><br/>could this candidate be<br/>from the cited precedent?<br/><i>criteria fix true and false</i>"]

    %% direction LR inside an LR chart keeps each state beside its noul, two columns,
    %% so the fan-out is four rows tall instead of eight
    subgraph fan["one request per candidate · no request sees another"]
        direction LR
        d1["state<br/>{query, candidate 1}"] --> n1["noul<br/>0.87"]
        d2["state<br/>{query, candidate 2}"] --> n2["noul<br/>0.41"]
        dx["⋮"] --> nx["⋮"]
        d30["state<br/>{query, candidate 30}"] --> n30["noul<br/>0.12"]
    end

    sort["sort by noul,<br/>highest first"]
    out["re-ranked shortlist<br/><i>same 30, better order</i>"]

    q --> fan
    sl --> fan
    quest --> fan
    fan --> sort --> out

    %% the elision is not a node - drop its box so it reads as "and so on"
    classDef elide fill:none,stroke:none
    class dx,nx elide
    linkStyle 2 stroke:none
Un ejemplo de reordenación
La búsqueda rápida y la reordenación se ejecutan ahora sobre CLERC, un conjunto de datos de recuperación jurídica. Este ejemplo usa 3,565 pasajes de opiniones judiciales y 40 consultas.
Configuración
El primer paso instala los paquetes de los que depende este recorrido.
bm25sydatasetsconstruyen la lista corta de búsqueda rápida.typesafe-sdkycooksafese encargan de la reordenación y del almacenamiento en caché de la API.matplotlibdibuja las gráficas de resultados.
pip install bm25s datasets matplotlib 'cooksafe>=0.2.0,<0.3.0'El siguiente bloque configura el cliente de TypeSafe y las constantes que usa el resto del recorrido, como qué modelo de TypeSafe llamar y qué tamaño de lista corta entrega la búsqueda rápida al reordenador. Llamar a TypeSafe requiere una TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Ordenar los pasajes con búsqueda rápida
El conjunto de datos que se usa aquí es un corpus de opiniones de tribunales de EE. UU., 170 filas reunidas. Cada fila se descompone así:
- Consulta: un extracto de opinión al que se le quitó una cita.
- Gold: el pasaje al que apuntaba la cita eliminada, la única respuesta correcta a la consulta.
- Candidatos: todos los demás pasajes del corpus, cada uno algo con lo que la consulta podría emparejarse por error.
De las 170 filas, se eligen 40 para evaluarlas como consultas. Las otras 130 solo aparecen como candidatos.
La siguiente celda construye la lista corta, con la técnica descrita antes:
- Carga el corpus.
- Ordénalo contra cada consulta con BM25.
Aquí todavía no hay TypeSafe; este es solo el paso de búsqueda rápida.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)

def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]

@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}

def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}

def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None

SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"

def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)

ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)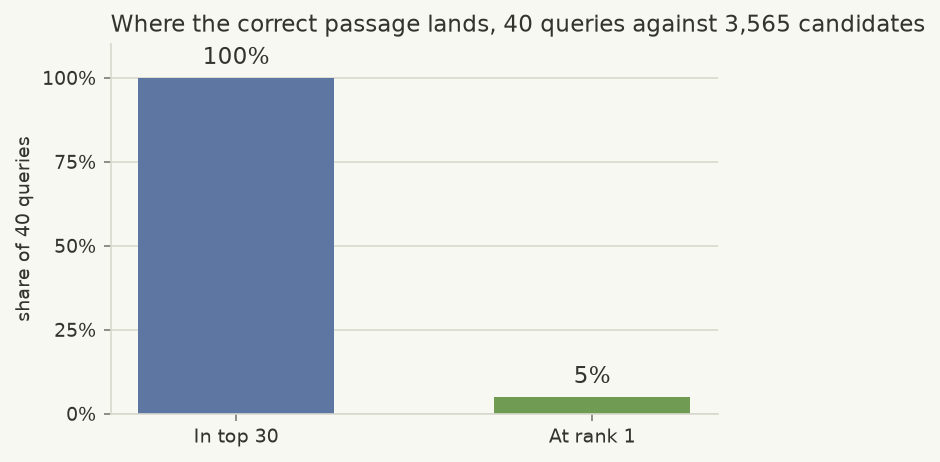
Es poco probable que la búsqueda rápida ordene primero el pasaje correcto
La gráfica muestra dónde coloca la búsqueda rápida el pasaje correcto, entre 3,565 candidatos.
La búsqueda rápida reduce el corpus de forma fiable a una lista corta que contiene la respuesta correcta. La contiene en el 100% de las 40 consultas. Pero ese pasaje rara vez es el primero de la lista corta: solo el 5% de las veces.
La reordenación de abajo solo reordena los 30 candidatos que ya están en la lista corta. No puede añadir un pasaje que la búsqueda rápida no seleccionó. Aquí la lista corta contiene el pasaje correcto para las 40 consultas, así que la reordenación puede centrarse en colocar cada uno en una posición mejor.
Reordenarlo con TypeSafe
La reordenación puntúa cada candidato de la lista corta contra su consulta y luego ordena por esa puntuación. La pregunta que TypeSafe hace sobre cada par es si el candidato podría ser el pasaje al que apunta la cita eliminada de la consulta.
La siguiente celda hace lo siguiente:
- Define esa pregunta.
- La hace una vez por candidato en cada lista corta: 40 consultas por 30 candidatos, 1,200 llamadas en total, ejecutadas en paralelo en lugar de una tras otra.
- Ordena cada lista corta por la puntuación que devuelve TypeSafe, produciendo el resultado reordenado.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)

@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }

# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = is_cited_source.model_dump_json(exclude_none=True)
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}

def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)

chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.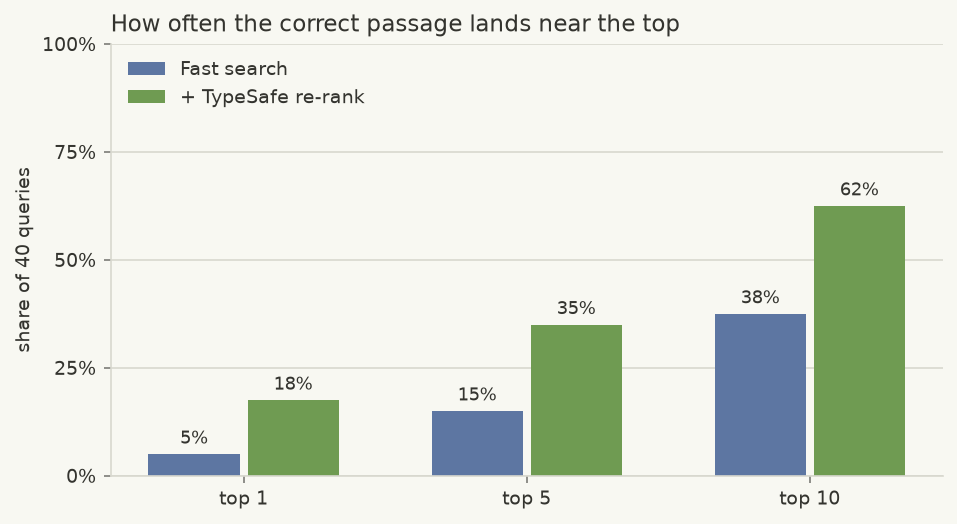
La reordenación acerca la respuesta correcta a lo más alto
La gráfica compara la búsqueda rápida con la búsqueda rápida más la reordenación, en tres umbrales. La reordenación acerca el pasaje correcto a lo más alto en todos ellos:
- Top 1 — 5% → 18%
- Top 5 — 15% → 35%
- Top 10 — 38% → 62%
El recuento de tokens y el coste reportados cubren las 1,200 llamadas a TypeSafe usadas para reordenar las 40 listas cortas.
Cada fila de CLERC contiene un pasaje correcto y 20 pasajes negativos. Este recorrido reúne los pasajes de 170 filas en un único corpus compartido. Para cada una de las 40 consultas de evaluación, BM25 selecciona 30 candidatos de ese corpus completo, no solo los 20 negativos que acompañan a esa fila. Después TypeSafe lee la consulta contra cada candidato seleccionado y reordena esos 30 pasajes.
Este recorrido hizo una pregunta por par para mayor claridad. Una aplicación real haría varias preguntas sobre el mismo par en una sola llamada. Consulta el cookbook de preguntas en paralelo y el patrón Fan-out especulativo para ver cómo.
Qué sigue
Los mismos bloques de construcción aparecen en otros lugares de la documentación de TypeSafe:
- Noul, para ver cómo TypeSafe convierte una pregunta de sí o no en una puntuación.
- Fan-out especulativo, para hacer varias preguntas sobre un documento en una sola llamada.
- Búsqueda línea por línea, para ver otra forma de buscar en un corpus por significado en lugar de por palabras clave.