Re-Ranking
Baut BM25-Kurzlisten mit 30 Passagen für 40 CLERC-Anfragen; eine TypeSafe-Frage pro Paar hebt Top-1 von 5% auf 18% und Top-10 von 38% auf 62%.
Du hast Tausende Dokumente und musst das eine finden, das eine bestimmte Frage beantwortet. Wie findest du es also?
Nutze zuerst eine schnelle Methode wie Keyword-Matching, um diese Tausende Kandidaten auf eine Kurzliste plausibler Kandidaten zu reduzieren. Wir nennen das schnelle Suche.
Die schnelle Suche ist darin gut, aber sie kann dir nicht sagen, welcher Kandidat auf der Kurzliste der richtige ist. Hier kommt das Re-Ranking ins Spiel. Es bewertet jeden Kandidaten auf der Kurzliste direkt gegen die Anfrage und setzt den besten nach vorn.
Beide Schritte laufen unten auf 3,565 Passagen aus Gerichtsurteilen aus dem CLERC-Datensatz: BM25 baut eine Kurzliste der schnellen Suche mit 30 Kandidaten für jede der 40 Anfragen, dann ordnet TypeSafe jede Kurzliste neu. Mit Re-Ranking landet die richtige Passage bei 18% der Anfragen auf Platz eins, gegenüber 5% mit der schnellen Suche allein.
Unterwegs lernst du:
- Was die schnelle Suche tut und warum sie nicht die ganze Antwort ist
- Was Re-Ranking ist und wie es nach einem Schritt der schnellen Suche passt
- Wie TypeSafe einen Kandidaten gegen eine Anfrage bewertet und wie sehr das das Ergebnis verbessert
Probiere es selbst aus
Öffne eine Anfrage, einen Kandidaten und eine Re-Ranking-Frage im TypeSafe Playground
Wie finden wir ein Dokument unter Tausenden?
Du hast einen Haufen Dokumente und eine Anfrage, ein Stück Text, der beschreibt, wonach du suchst. Irgendwo im Haufen liegt das eine Dokument, das sie beantwortet.
Jedes Dokument einzeln gegen die Anfrage zu prüfen funktioniert, bei einem Vergleich pro Dokument: Millionen Dokumente bedeuten Millionen Vergleiche pro Anfrage. Du kannst die Leistung mit einem zweistufigen Ansatz verbessern:
- Reduziere den Haufen auf eine kurze Liste wahrscheinlicher Kandidaten, mit einer Methode, die schnell genug ist, um auf dem ganzen Haufen zu laufen.
- Wende einen genaueren Schritt auf diese kurze Liste an, um die exakt richtige Antwort zu finden.

Dieses Cookbook testet dieses Setup an einem Datensatz aus Gerichtsurteilen, unten in Ein Re-Ranking-Beispiel.
Was ist schnelle Suche?
Die schnelle Suche ist jede Methode, die eine Anfrage gegen jedes Dokument in einem großen Korpus vergleichen und schnell eine gerankte Kurzliste zurückgeben kann. Häufige Methoden sind Keyword-Suche, etwa BM25, und dichte Embeddings, die Passagen nach Bedeutung vergleichen. Systeme kombinieren oft beide Methoden.
Der erste Schritt hier ist BM25 und nichts anderes. BM25 rankt Passagen nach gemeinsamen Wörtern. Diesen Schritt einfach zu halten, lässt die Aufmerksamkeit auf dem Re-Ranking, das der Punkt des Cookbooks ist. Die Wahl der Methode für die schnelle Suche ist eine Nebensache: Das Re-Ranking sieht ohnehin nur die Passagen, die es auf die Kurzliste schaffen.
Was ist Re-Ranking?
Re-Ranking nimmt die Kurzliste, die die schnelle Suche bereits erzeugt hat, und bringt sie in eine bessere Reihenfolge. Statt die Anfrage auf einmal gegen den ganzen Korpus zu vergleichen, vergleicht es die Anfrage mit jedem Kandidaten auf der Kurzliste einzeln und sortiert die Kurzliste nach diesem score.
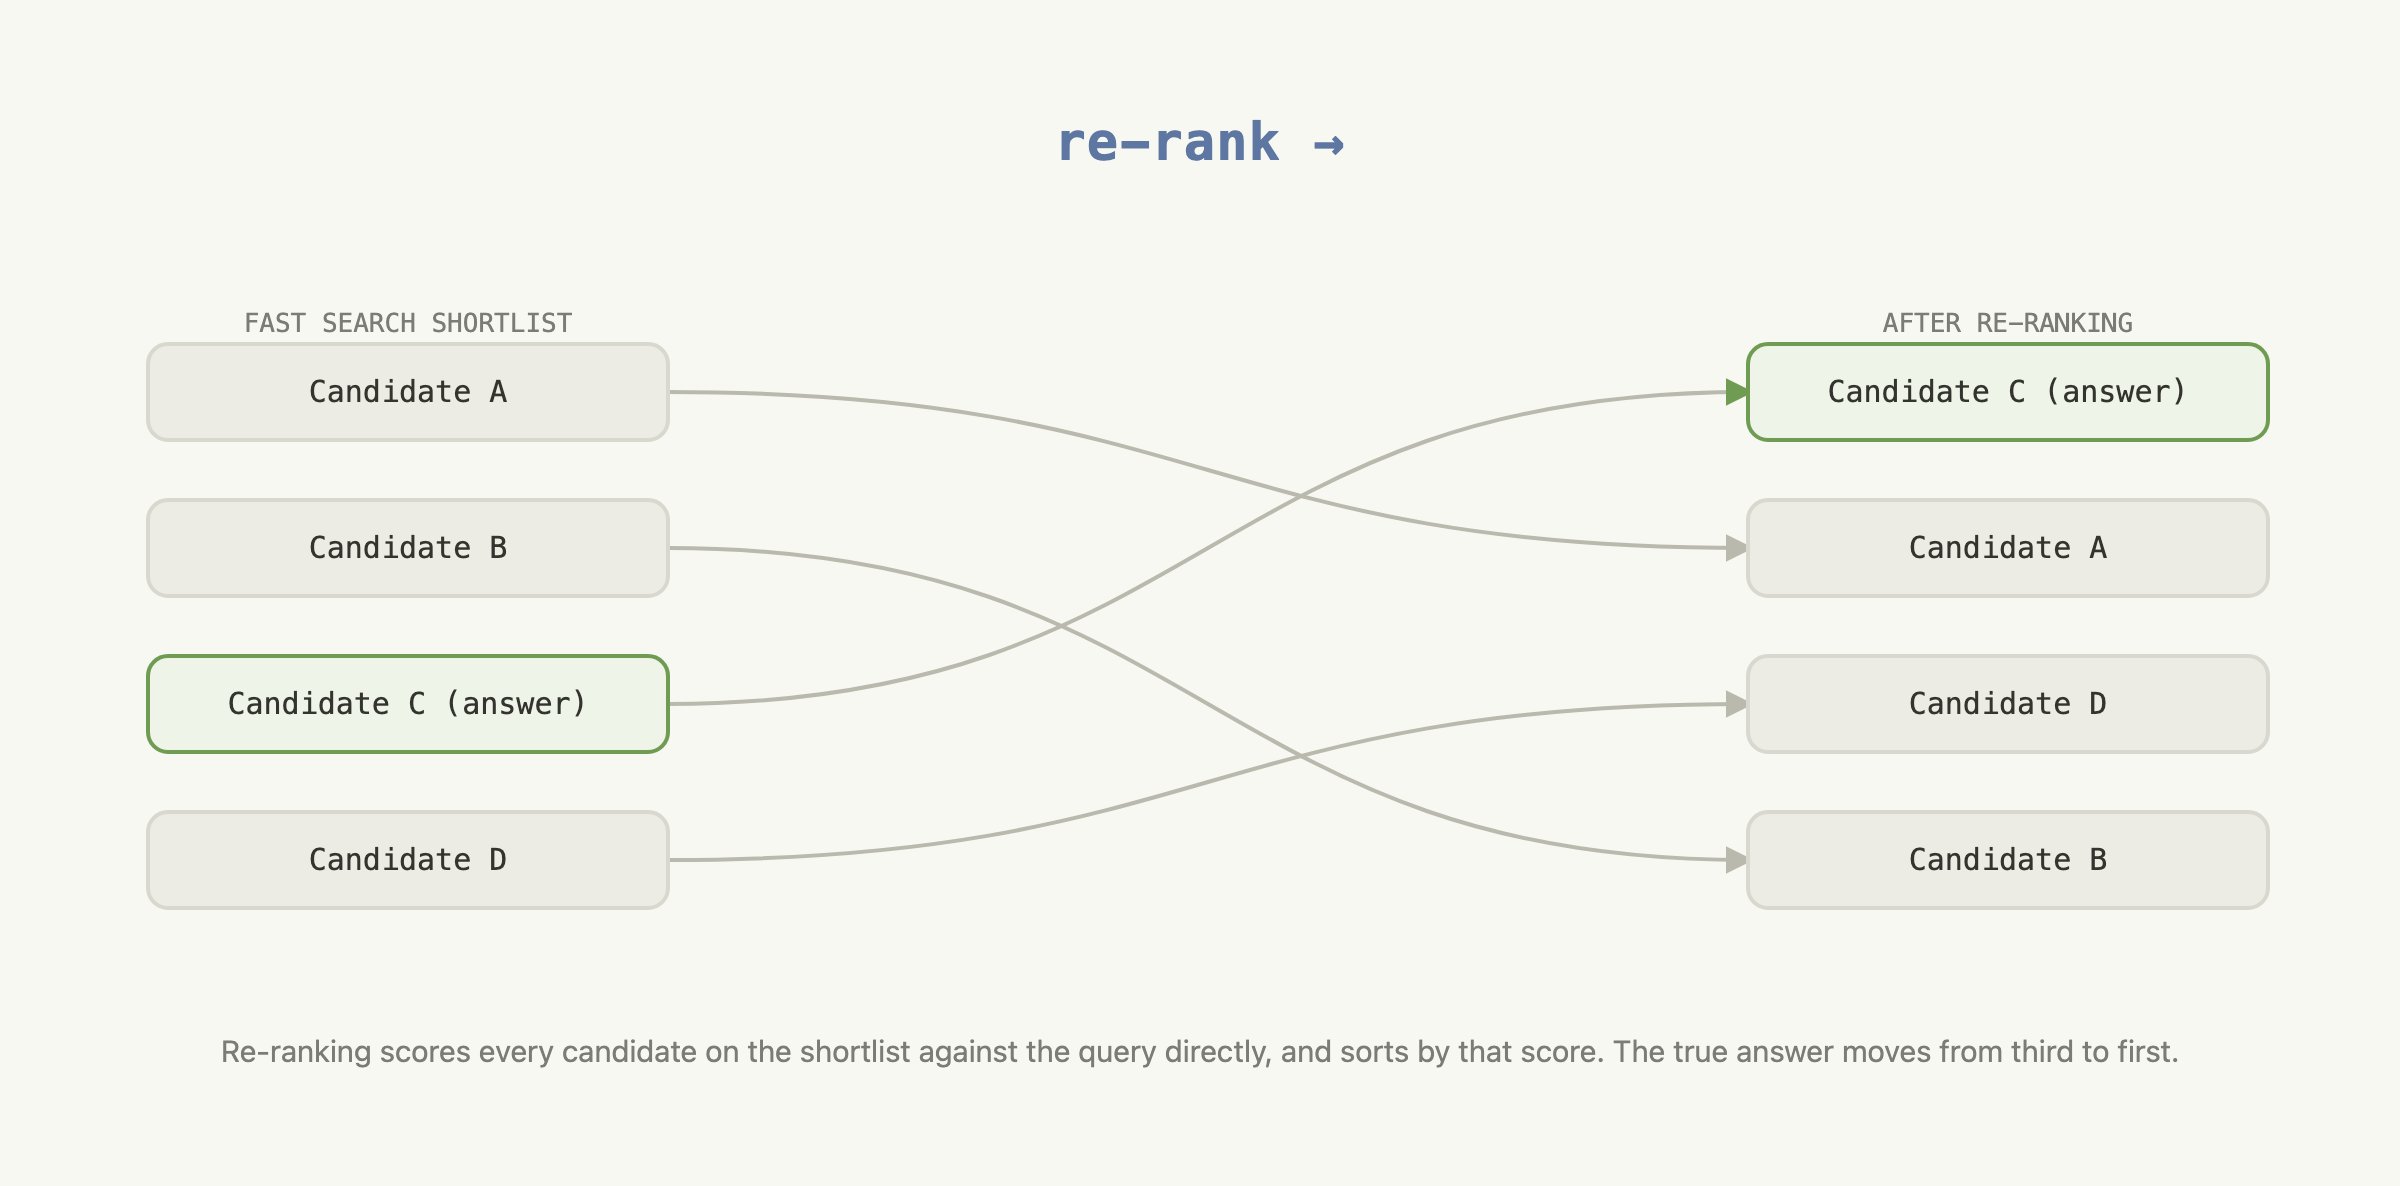
Der score kann von einem Sprachmodell kommen. Gib ihm die Anfrage und einen Kandidaten gemeinsam und frage, wie gut der Kandidat die Anfrage beantwortet. Das Re-Ranking findet dann die beste Übereinstimmung auf der Kurzliste, auch wenn ihr Wortlaut von dem der Anfrage abweicht.
Re-Ranking mit TypeSafe
Ein Re-Ranker braucht einen vergleichbaren score für jedes Anfrage-Kandidat-Paar. Ein Allzweck-Sprachmodell kann diese scores erzeugen oder die ganze Kurzliste direkt ranken. Für die unabhängige Bewertung von Paaren musst du jedoch eine Bewertungsskala definieren und das Modell anweisen, denselben Maßstab auf jeden Kandidaten anzuwenden. Wiederholte Aufrufe können trotzdem verschiedene scores für dasselbe Paar erzeugen, während Allzweck-Generierung Zeit und Kosten zu einer Aufgabe hinzufügt, die nur eine Zahl braucht.
Was TypeSafe zurückgibt
Bei TypeSafe kann die Bewertungsanfrage eine Ja/Nein-Frage bleiben:
Could this candidate passage be from the cited precedent?Ein blankes Ja oder Nein würde nicht ausreichen, um 30 Kandidaten zu ranken. Ein Noul
gibt stattdessen eine Zahl zwischen 0 und 1 zurück, genannt noul. Der noul ist die
Schätzung von TypeSafe, wie wahrscheinlich die Antwort Ja lautet.
Die Kriterien der Frage legen fest, was als wahr und falsch zählt. TypeSafe wendet sie auf jedes Anfrage-Kandidat-Paar an und gibt den noul direkt zurück. Dieser noul ist der score, nach dem die Anwendung sortiert. Es muss keine Bewertungsskala für ein Allzweck-Modell erfunden werden, und TypeSafe ist darauf gebaut, diese wiederholte Bewertung schneller, günstiger und konsistenter zu erledigen.
In vereinfachtem Pseudocode sieht ein TypeSafe-Bewertungsaufruf so aus:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafe liest die Anfrage und einen Kandidaten gemeinsam gegen diese Frage und gibt einen noul zurück.
Du kannst das nutzen, um eine Kurzliste neu zu ranken, indem du dieselbe Frage gegen jeden Kandidaten darauf laufen lässt und die Kurzliste dann nach dem noul sortierst, den jeder Aufruf zurückgibt, den höchsten zuerst.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
Das Diagramm unten zeigt, wie eine Anfrage pro Kandidat die scores erzeugt, mit denen die Kurzliste neu geordnet wird.
flowchart LR
    q["query excerpt<br/><i>one opinion passage,<br/>citation removed</i>"]
    sl["shortlist from fast search<br/><i>30 candidate passages</i>"]
    quest["<b>one Noul</b><br/>could this candidate be<br/>from the cited precedent?<br/><i>criteria fix true and false</i>"]

    %% direction LR inside an LR chart keeps each state beside its noul, two columns,
    %% so the fan-out is four rows tall instead of eight
    subgraph fan["one request per candidate · no request sees another"]
        direction LR
        d1["state<br/>{query, candidate 1}"] --> n1["noul<br/>0.87"]
        d2["state<br/>{query, candidate 2}"] --> n2["noul<br/>0.41"]
        dx["⋮"] --> nx["⋮"]
        d30["state<br/>{query, candidate 30}"] --> n30["noul<br/>0.12"]
    end

    sort["sort by noul,<br/>highest first"]
    out["re-ranked shortlist<br/><i>same 30, better order</i>"]

    q --> fan
    sl --> fan
    quest --> fan
    fan --> sort --> out

    %% the elision is not a node - drop its box so it reads as "and so on"
    classDef elide fill:none,stroke:none
    class dx,nx elide
    linkStyle 2 stroke:none
Ein Re-Ranking-Beispiel
Schnelle Suche und Re-Ranking laufen nun auf CLERC, einem juristischen Retrieval-Datensatz. Dieses Beispiel verwendet 3,565 Passagen aus Gerichtsurteilen und 40 Anfragen.
Einrichtung
Der erste Schritt installiert die Pakete, von denen diese Anleitung abhängt.
bm25sunddatasetsbauen die Kurzliste der schnellen Suche.typesafe-sdkundcooksafeübernehmen Re-Ranking und API-Caching.matplotlibzeichnet die Ergebnisdiagramme.
pip install bm25s datasets matplotlib 'cooksafe>=0.2.0,<0.3.0'Der nächste Block richtet den TypeSafe-Client und die Konstanten ein, die der Rest der
Anleitung verwendet, etwa welches TypeSafe-Modell aufgerufen wird und wie groß eine
Kurzliste ist, die die schnelle Suche an den Re-Ranker übergibt. Der Aufruf von TypeSafe
braucht einen TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Die Passagen mit schneller Suche ranken
Der hier verwendete Datensatz ist ein Korpus von US-Gerichtsurteilen, 170 Zeilen zusammengefasst. Jede Zeile gliedert sich so:
- Query: ein Urteilsauszug mit einem entfernten Zitat.
- Gold: die Passage, auf die das entfernte Zitat zeigte, die eine richtige Antwort auf die Anfrage.
- Kandidaten: jede andere Passage im Korpus, jede etwas, wogegen die Anfrage irrtümlicherweise abgeglichen werden könnte.
Von den 170 Zeilen werden 40 ausgewählt, um sie als Anfragen auszuwerten. Die anderen 130 erscheinen nur als Kandidaten.
Die nächste Zelle baut die Kurzliste mit der oben beschriebenen Technik:
- Lade den Korpus.
- Ranke ihn gegen jede Anfrage mit BM25.
Hier ist noch kein TypeSafe, das ist nur der Schritt der schnellen Suche.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)

def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]

@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}

def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}

def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None

SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"

def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)

ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)
Die schnelle Suche setzt die richtige Passage selten auf Platz eins
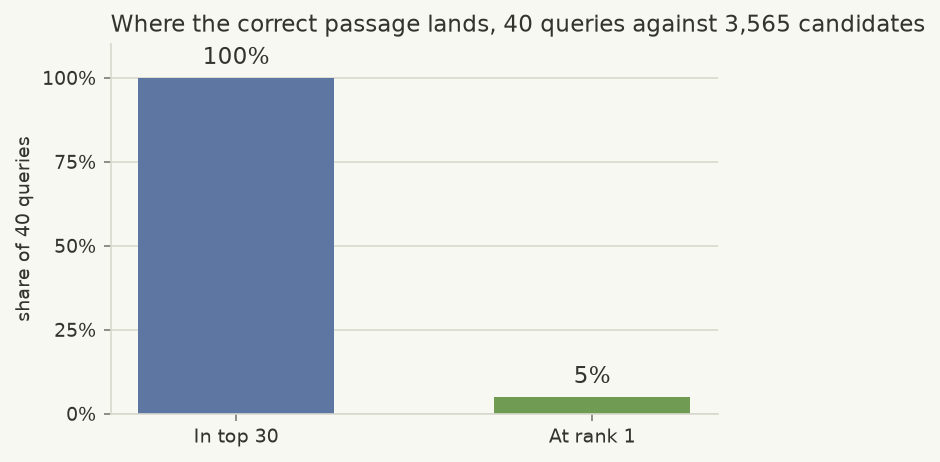
Das Diagramm zeigt, wohin die schnelle Suche die richtige Passage setzt, aus 3,565 Kandidaten.
Die schnelle Suche verengt den Korpus zuverlässig auf eine Kurzliste, die die richtige Antwort enthält. Sie enthält die richtige Antwort für 100% der 40 Anfragen. Aber diese Passage ist selten die am höchsten gerankte auf der Kurzliste, nur in 5% der Fälle.
Das Re-Ranking unten ordnet nur die obersten 30 Kandidaten neu, die bereits auf der Kurzliste stehen. Es kann keine Passage hinzufügen, die die schnelle Suche nicht ausgewählt hat. Hier enthält die Kurzliste die richtige Passage für alle 40 Anfragen, sodass sich das Re-Ranking darauf konzentrieren kann, jede in eine bessere Position zu bringen.
Das Re-Ranking mit TypeSafe durchführen
Re-Ranking bewertet jeden Kandidaten auf der Kurzliste gegen seine Anfrage und sortiert dann nach diesem score. Die Frage, die TypeSafe zu jedem Paar stellt, ist, ob der Kandidat die Passage sein könnte, auf die das entfernte Zitat der Anfrage zeigt.
Die nächste Zelle tut Folgendes:
- Diese Frage definieren.
- Sie einmal pro Kandidat auf jeder Kurzliste stellen, 40 Anfragen mal 30 Kandidaten, insgesamt 1,200 Aufrufe, nebenläufig statt nacheinander ausgeführt.
- Jede Kurzliste nach dem score sortieren, den TypeSafe zurückgibt, was das neu gerankte Ergebnis erzeugt.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)

@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }

# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = is_cited_source.model_dump_json(exclude_none=True)
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}

def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)

chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.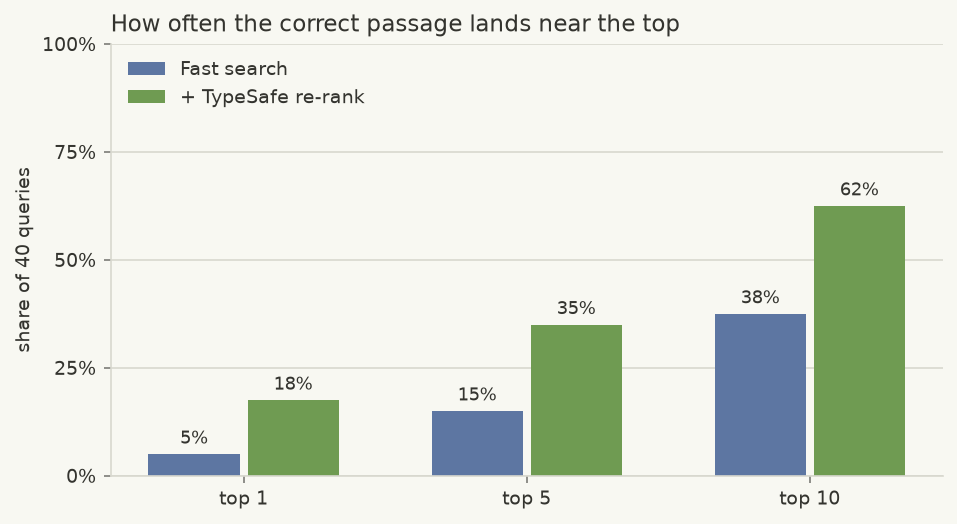
Re-Ranking rückt die richtige Antwort nach oben
Das Diagramm vergleicht die schnelle Suche mit der schnellen Suche plus Re-Ranking, bei drei Schwellenwerten. Das Re-Ranking rückt die richtige Passage bei jedem davon näher nach oben:
- Top 1 — 5% → 18%
- Top 5 — 15% → 35%
- Top 10 — 38% → 62%
Die gemeldete Token-Zahl und die Kosten decken alle 1,200 TypeSafe-Aufrufe ab, mit denen die 40 Kurzlisten neu gerankt wurden.
Jede CLERC-Zeile enthält eine richtige Passage und 20 negative Passagen. Diese Anleitung fasst die Passagen aus 170 Zeilen zu einem gemeinsamen Korpus zusammen. Für jede der 40 Auswertungsanfragen wählt BM25 30 Kandidaten aus diesem vollen Korpus, nicht nur die 20 negativen, die mit dieser Zeile geliefert werden. TypeSafe liest dann die Anfrage gegen jeden ausgewählten Kandidaten und rankt diese 30 Passagen neu.
Diese Anleitung stellte der Klarheit halber eine Frage pro Paar. Eine echte Anwendung würde mehrere Fragen zum selben Paar in einem Aufruf stellen. Siehe Cookbook zu parallelen Fragen und Speculative-Fan-Out-Muster, wie das geht.
Wie geht es weiter
Dieselben Bausteine tauchen anderswo in TypeSafes Dokumentation auf:
- Noul, wie TypeSafe eine Ja/Nein-Frage in einen score verwandelt.
- Speculative Fan-Out, um mehrere Fragen zu einem Dokument in einem einzigen Aufruf zu stellen.
- Zeilenweise Suche, für eine andere Möglichkeit, einen Korpus nach Bedeutung statt nach Keywords zu durchsuchen.