Reordenação
Constrói listas curtas BM25 de 30 trechos para 40 consultas jurídicas do CLERC e depois usa uma pergunta do TypeSafe por par consulta-candidato para elevar a precisão top-1 de 5% para 18% e a top-10 de 38% para 62%.
Você tem milhares de documentos e precisa encontrar o que responde a uma pergunta específica. Então como você o encontra?
Primeiro, use um método rápido, como correspondência de palavras-chave, para reduzir esses milhares de candidatos a uma lista curta de candidatos plausíveis. Chamamos isso de busca rápida.
A busca rápida é boa nisso, mas não consegue dizer qual candidato da lista curta está correto. É aí que entra a reordenação. Ela pontua cada candidato da lista curta diretamente contra a consulta e coloca o melhor em primeiro lugar.
Ambos os passos rodam abaixo sobre 3,565 trechos de opiniões judiciais do conjunto de dados CLERC: o BM25 constrói uma lista curta de busca rápida com 30 candidatos para cada uma das 40 consultas, e depois o TypeSafe reordena cada lista curta. Com a reordenação, o trecho correto fica em primeiro lugar em 18% das consultas, contra 5% com a busca rápida sozinha.
Ao longo do caminho, você vai aprender:
- O que a busca rápida faz e por que ela não é toda a resposta
- O que é a reordenação e como ela se encaixa depois de um passo de busca rápida
- Como o TypeSafe pontua um candidato contra uma consulta e quanto isso melhora o resultado
Experimente você mesmo
Abra uma consulta, um candidato e uma pergunta de reordenação no Playground do TypeSafe
Como encontramos um documento entre milhares?
Você tem uma pilha de documentos e uma consulta, um trecho de texto descrevendo o que você procura. Em algum lugar da pilha está o documento que responde a ela.
Verificar cada documento contra a consulta um a um funciona, a uma comparação por documento: milhões de documentos significam milhões de comparações por consulta. Você pode melhorar o desempenho com uma abordagem de dois passos:
- Reduza a pilha a uma lista curta de candidatos prováveis, com um método rápido o bastante para rodar sobre a pilha inteira.
- Aplique um passo mais preciso a essa lista curta, para encontrar a resposta exata.

Este cookbook testa essa configuração num conjunto de dados de opiniões judiciais, em Um exemplo de reordenação abaixo.
O que é a busca rápida?
A busca rápida é qualquer método capaz de comparar uma consulta com todos os documentos de um corpus grande e retornar rapidamente uma lista curta ordenada. Métodos comuns incluem a busca por palavras-chave, como o BM25, e embeddings densos, que comparam trechos por significado. Os sistemas costumam combinar os dois métodos.
O primeiro passo aqui é o BM25 e nada mais. O BM25 ordena os trechos por palavras compartilhadas. Manter esse passo simples deixa a atenção na reordenação, que é o ponto do cookbook. A escolha do método de busca rápida é uma questão secundária: a reordenação só enxerga os trechos que entram na lista curta.
O que é a reordenação?
A reordenação pega a lista curta que a busca rápida já produziu e a coloca numa ordem melhor. Em vez de comparar a consulta com o corpus inteiro de uma vez, ela compara a consulta com cada candidato da lista curta individualmente e ordena a lista curta por essa pontuação.
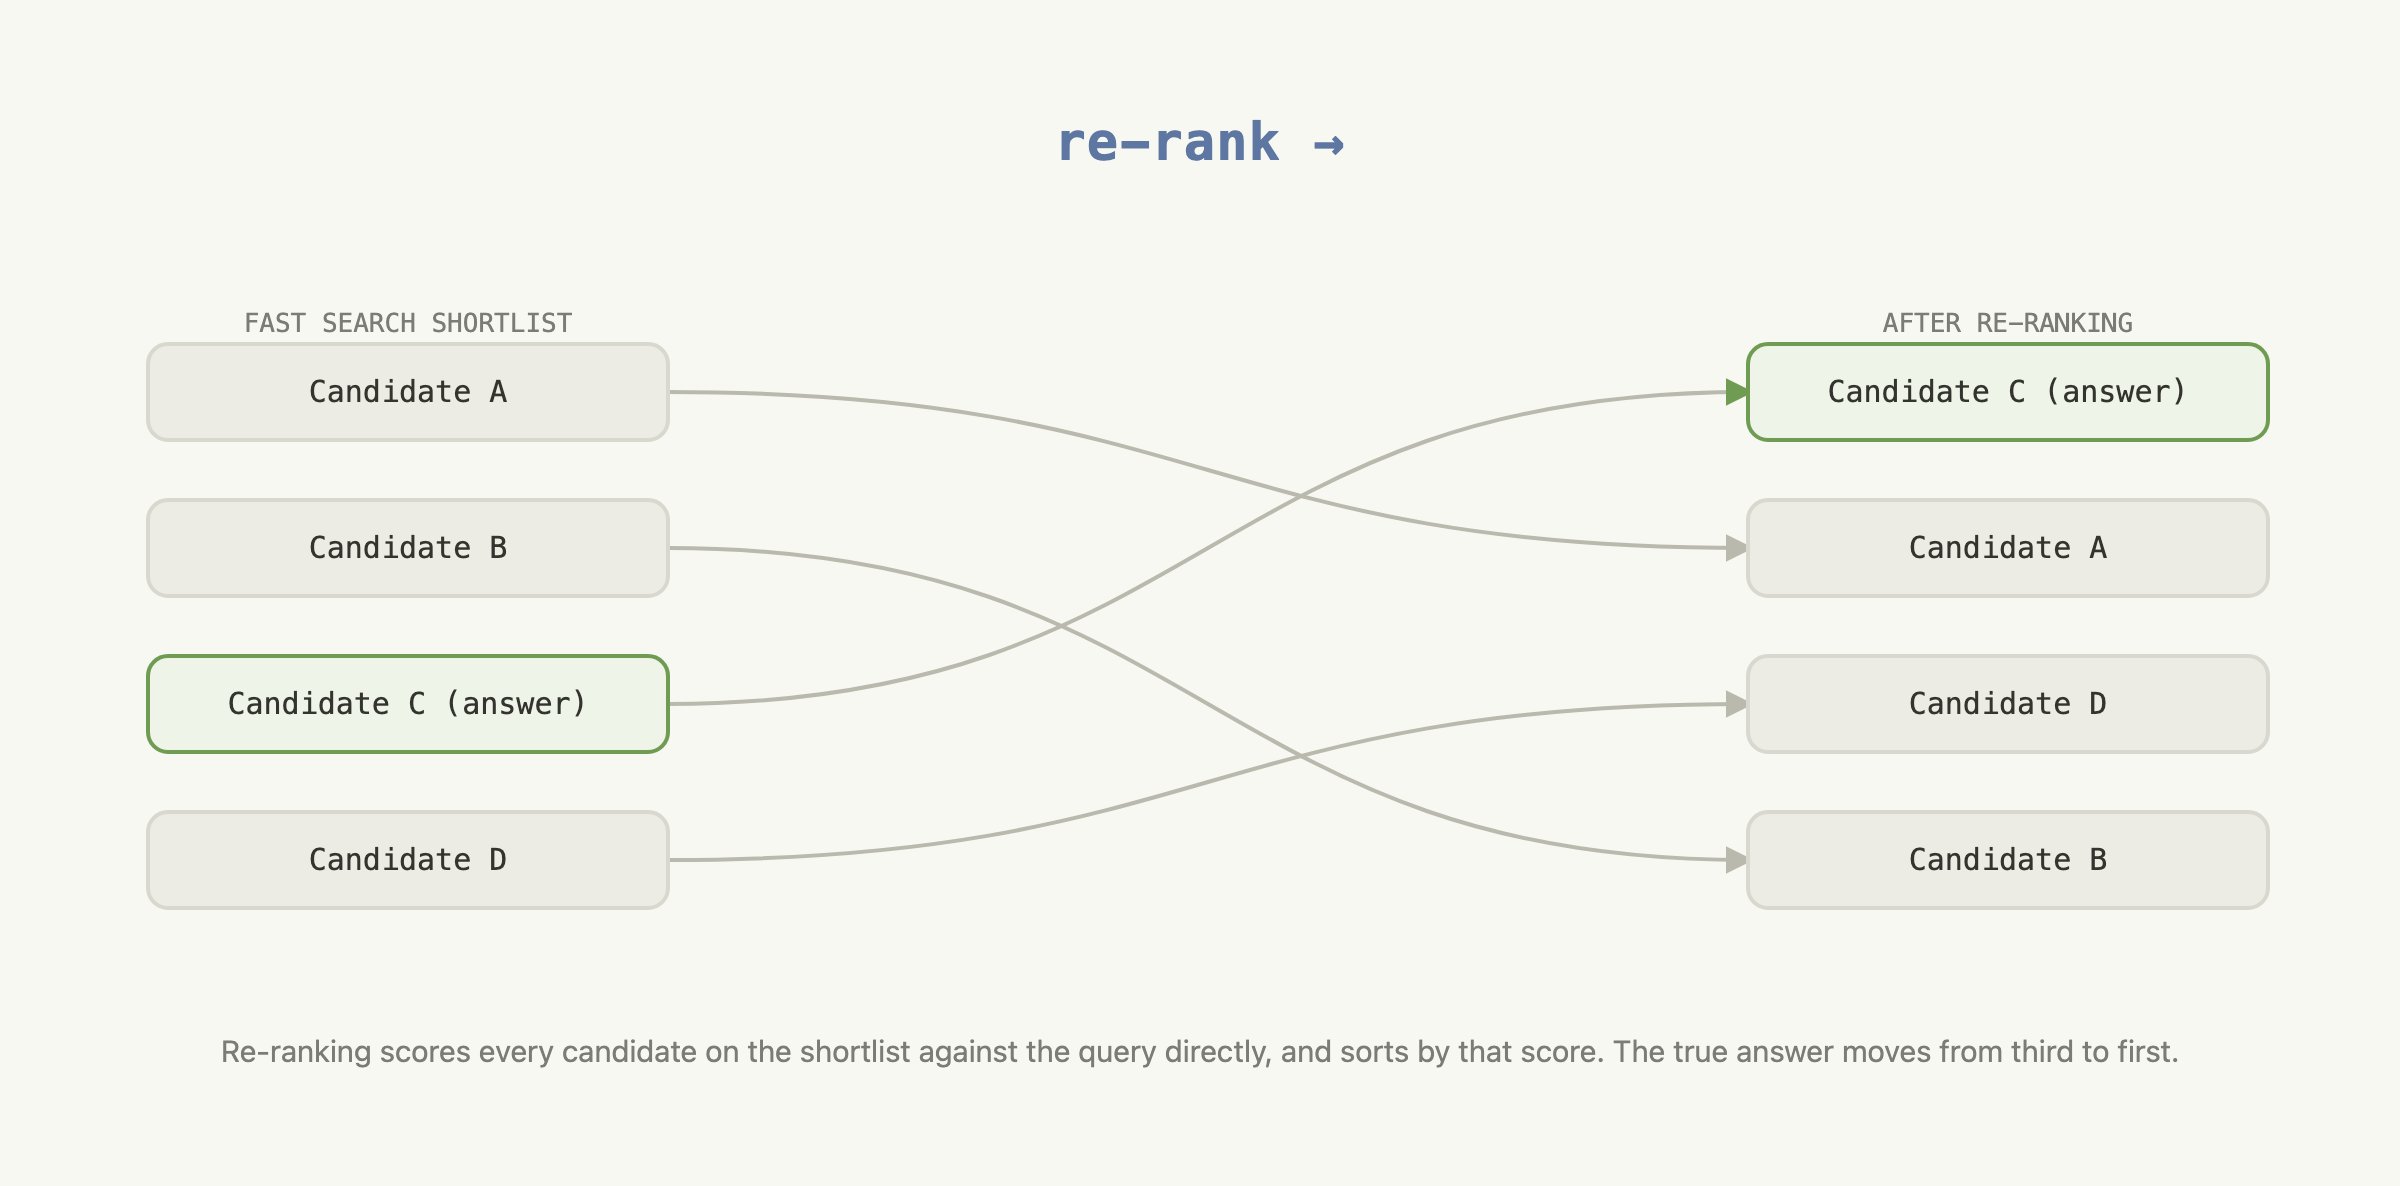
A pontuação pode vir de um modelo de linguagem. Dê a ele a consulta e um candidato juntos e pergunte quão bem o candidato responde à consulta. A reordenação então encontra a melhor correspondência da lista curta, mesmo quando a redação dela difere da da consulta.
Reordenação com TypeSafe
Um reordenador precisa de uma pontuação comparável para cada par consulta-candidato. Um modelo de linguagem de propósito geral pode produzir essas pontuações, ou classificar a lista curta inteira diretamente. Para pontuar pares de forma independente, porém, você precisa definir uma escala de pontuação e pedir ao modelo que aplique o mesmo critério a cada candidato. Chamadas repetidas ainda podem produzir pontuações diferentes para o mesmo par, enquanto a geração de propósito geral adiciona tempo e custo a uma tarefa que só precisa de um número.
O que o TypeSafe retorna
Com o TypeSafe, a requisição de pontuação pode continuar sendo uma pergunta de sim ou não:
Could this candidate passage be from the cited precedent?Um simples sim ou não não bastaria para ordenar 30 candidatos. Um Noul, em vez disso, retorna
um número entre 0 e 1, chamado
noul. O noul é a estimativa do TypeSafe de quão provável é que a resposta
seja sim.
Os criteria da pergunta definem o que conta como verdadeiro e falso. O TypeSafe os aplica a cada par consulta-candidato e retorna o noul diretamente. Esse noul é a pontuação pela qual a aplicação ordena. Não é preciso inventar uma escala de pontuação para um modelo de propósito geral, e o TypeSafe é construído para fazer essa pontuação repetida de forma mais rápida, mais barata e mais consistente.
Em pseudocódigo simplificado, uma chamada de pontuação ao TypeSafe se parece com isto:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
O TypeSafe lê a consulta e um candidato juntos contra essa pergunta e retorna um noul.
Você pode usar isso para reordenar uma lista curta executando a mesma pergunta contra cada candidato dela e depois ordenando a lista curta pelo noul que cada chamada retorna, do maior para o menor.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
O diagrama abaixo mostra como uma requisição por candidato produz as pontuações usadas para reordenar a lista curta.
flowchart LR
    q["query excerpt<br/><i>one opinion passage,<br/>citation removed</i>"]
    sl["shortlist from fast search<br/><i>30 candidate passages</i>"]
    quest["<b>one Noul</b><br/>could this candidate be<br/>from the cited precedent?<br/><i>criteria fix true and false</i>"]

    %% direction LR inside an LR chart keeps each state beside its noul, two columns,
    %% so the fan-out is four rows tall instead of eight
    subgraph fan["one request per candidate · no request sees another"]
        direction LR
        d1["state<br/>{query, candidate 1}"] --> n1["noul<br/>0.87"]
        d2["state<br/>{query, candidate 2}"] --> n2["noul<br/>0.41"]
        dx["⋮"] --> nx["⋮"]
        d30["state<br/>{query, candidate 30}"] --> n30["noul<br/>0.12"]
    end

    sort["sort by noul,<br/>highest first"]
    out["re-ranked shortlist<br/><i>same 30, better order</i>"]

    q --> fan
    sl --> fan
    quest --> fan
    fan --> sort --> out

    %% the elision is not a node - drop its box so it reads as "and so on"
    classDef elide fill:none,stroke:none
    class dx,nx elide
    linkStyle 2 stroke:none
Um exemplo de reordenação
A busca rápida e a reordenação agora rodam sobre o CLERC, um conjunto de dados de recuperação jurídica. Este exemplo usa 3,565 trechos de opiniões judiciais e 40 consultas.
Configuração
O primeiro passo instala os pacotes dos quais este passo a passo depende.
bm25sedatasetsconstroem a lista curta de busca rápida.typesafe-sdkecooksafecuidam da reordenação e do cache da API.matplotlibdesenha os gráficos de resultado.
pip install bm25s datasets matplotlib 'cooksafe>=0.2.0,<0.3.0'O próximo bloco configura o cliente TypeSafe e as constantes que o resto do passo a passo usa,
como qual modelo TypeSafe chamar e qual tamanho de lista curta a busca rápida entrega ao
reordenador. Chamar o TypeSafe exige uma TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Ordenando os trechos com busca rápida
O conjunto de dados usado aqui é um corpus de opiniões de tribunais dos EUA, 170 linhas reunidas. Cada linha se decompõe assim:
- Consulta: um trecho de opinião com uma citação removida.
- Gold: o trecho ao qual a citação removida apontava, a única resposta correta à consulta.
- Candidatos: todos os outros trechos do corpus, cada um algo com que a consulta poderia ser pareada por engano.
Das 170 linhas, 40 são escolhidas para avaliar como consultas. As outras 130 só aparecem como candidatos.
A próxima célula constrói a lista curta, com a técnica descrita acima:
- Carregue o corpus.
- Ordene-o contra cada consulta com o BM25.
Aqui ainda não há TypeSafe; este é só o passo de busca rápida.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)

def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]

@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}

def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}

def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None

SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"

def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)

ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)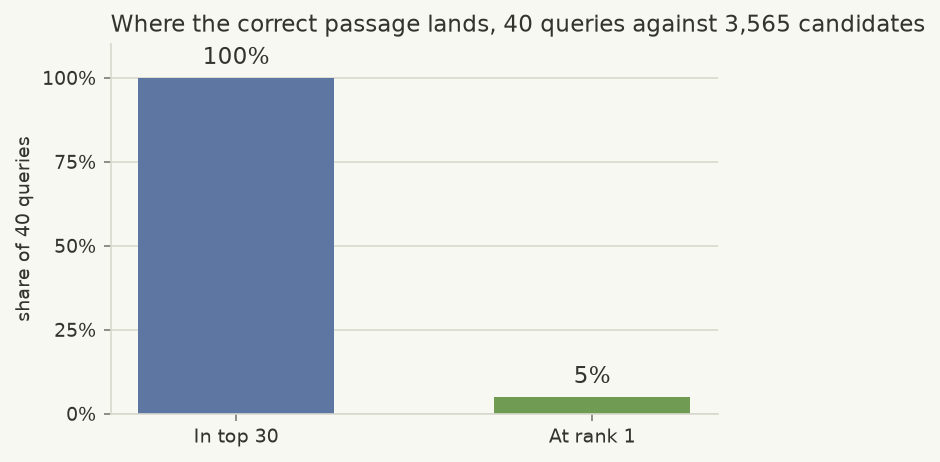
É improvável que a busca rápida ordene o trecho correto em primeiro
O gráfico mostra onde a busca rápida coloca o trecho correto, entre 3,565 candidatos.
A busca rápida reduz o corpus de forma confiável a uma lista curta que contém a resposta correta. Ela a contém em 100% das 40 consultas. Mas esse trecho raramente é o primeiro da lista curta: apenas 5% das vezes.
A reordenação abaixo só reordena os 30 candidatos que já estão na lista curta. Ela não pode adicionar um trecho que a busca rápida não selecionou. Aqui, a lista curta contém o trecho correto para todas as 40 consultas, então a reordenação pode se concentrar em colocar cada um numa posição melhor.
Reordenando com o TypeSafe
A reordenação pontua cada candidato da lista curta contra sua consulta e depois ordena por essa pontuação. A pergunta que o TypeSafe faz sobre cada par é se o candidato poderia ser o trecho ao qual a citação removida da consulta aponta.
A próxima célula faz o seguinte:
- Define essa pergunta.
- A faz uma vez por candidato em cada lista curta, 40 consultas vezes 30 candidatos, 1,200 chamadas no total, executadas em paralelo em vez de uma após a outra.
- Ordena cada lista curta pela pontuação que o TypeSafe retorna, produzindo o resultado reordenado.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)

@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }

# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = is_cited_source.model_dump_json(exclude_none=True)
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}

def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)

chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.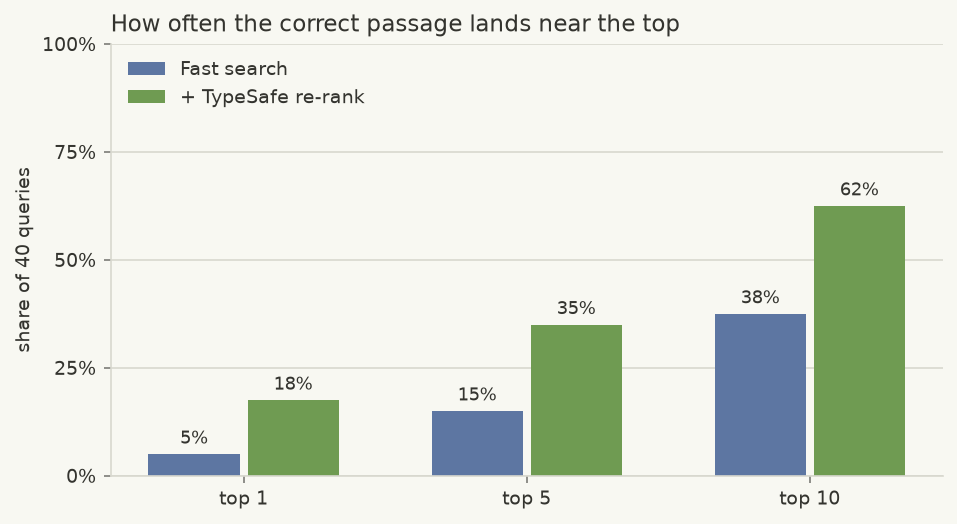
A reordenação aproxima a resposta correta do topo
O gráfico compara a busca rápida com a busca rápida mais a reordenação, em três limiares. A reordenação aproxima o trecho correto do topo em todos eles:
- Top 1 — 5% → 18%
- Top 5 — 15% → 35%
- Top 10 — 38% → 62%
A contagem de tokens e o custo reportados cobrem todas as 1,200 chamadas ao TypeSafe usadas para reordenar as 40 listas curtas.
Cada linha do CLERC contém um trecho correto e 20 trechos negativos. Este passo a passo reúne os trechos de 170 linhas num único corpus compartilhado. Para cada uma das 40 consultas de avaliação, o BM25 seleciona 30 candidatos desse corpus completo, não apenas os 20 negativos fornecidos com aquela linha. Depois o TypeSafe lê a consulta contra cada candidato selecionado e reordena esses 30 trechos.
Este passo a passo fez uma pergunta por par para maior clareza. Uma aplicação real faria várias perguntas sobre o mesmo par numa única chamada. Veja o cookbook de perguntas em paralelo e o padrão fan-out especulativo para saber como.
O que vem a seguir
Os mesmos blocos de construção aparecem em outros lugares da documentação do TypeSafe:
- Noul, para ver como o TypeSafe transforma uma pergunta de sim ou não em uma pontuação.
- Fan-out especulativo, para fazer várias perguntas sobre um documento numa única chamada.
- Busca linha por linha, para ver outra forma de buscar num corpus por significado em vez de por palavras-chave.