Reclassement
Construit des listes courtes BM25 de 30 passages pour 40 requêtes juridiques CLERC, puis utilise une question TypeSafe par paire requête-candidat pour faire passer la précision top-1 de 5 % à 18 % et la précision top-10 de 38 % à 62 %.
Tu as des milliers de documents, et tu dois trouver celui qui répond à une question précise. Alors, comment le trouver ?
D’abord, utilise une méthode rapide comme la correspondance de mots-clés pour réduire ces milliers de candidats à une liste courte de candidats plausibles. C’est ce qu’on appelle la recherche rapide.
La recherche rapide est bonne pour ça, mais elle ne peut pas te dire quel candidat de la liste courte est le bon. C’est là qu’intervient le reclassement. Il évalue chaque candidat de la liste courte directement face à la requête, et place le meilleur en premier.
Les deux étapes tournent ci-dessous sur 3 565 passages d’opinions judiciaires du jeu de données CLERC : BM25 construit une liste courte de recherche rapide de 30 candidats pour chacune des 40 requêtes, puis TypeSafe reclasse chaque liste courte. Avec le reclassement, le bon passage arrive en première place pour 18 % des requêtes, contre 5 % avec la recherche rapide seule.
En chemin, tu vas apprendre :
- Ce que fait la recherche rapide, et pourquoi elle ne suffit pas
- Ce qu’est le reclassement, et comment il s’insère après une étape de recherche rapide
- Comment TypeSafe note un candidat face à une requête, et de combien cela améliore le résultat
Essaie par toi-même
Ouvre une requête, un candidat et la question de reclassement dans le playground TypeSafe
Comment trouver un document parmi des milliers ?
Tu as une pile de documents et une requête, un bout de texte qui décrit ce que tu cherches. Quelque part dans la pile se trouve le document qui y répond.
Vérifier chaque document face à la requête un par un fonctionne, à raison d’une comparaison par document : des millions de documents, c’est des millions de comparaisons par requête. Tu peux améliorer les performances avec une approche en deux étapes :
- Réduis la pile à une liste courte de candidats probables, avec une méthode assez rapide pour tourner sur toute la pile.
- Applique une étape plus précise à cette liste courte, pour trouver la bonne réponse exacte.

Ce cookbook teste ce dispositif sur un jeu de données d’opinions judiciaires, dans Un exemple de reclassement ci-dessous.
Qu’est-ce que la recherche rapide ?
La recherche rapide est toute méthode capable de comparer une requête à chaque document d’un grand corpus et de renvoyer rapidement une liste courte classée. Les méthodes courantes incluent la recherche par mots-clés, comme BM25, et les embeddings denses, qui comparent les passages par le sens. Les systèmes combinent souvent les deux méthodes.
La première étape ici, c’est BM25 et rien d’autre. BM25 classe les passages par mots partagés. Garder cette étape simple laisse l’attention sur le reclassement, qui est le but du cookbook. Le choix de la méthode de recherche rapide est un détail : le reclassement ne voit jamais que les passages qui atteignent la liste courte.
Qu’est-ce que le reclassement ?
Le reclassement prend la liste courte déjà produite par la recherche rapide et la met dans un meilleur ordre. Au lieu de comparer la requête à tout le corpus d’un coup, il compare la requête à chaque candidat de la liste courte individuellement, puis trie la liste courte selon ce score.
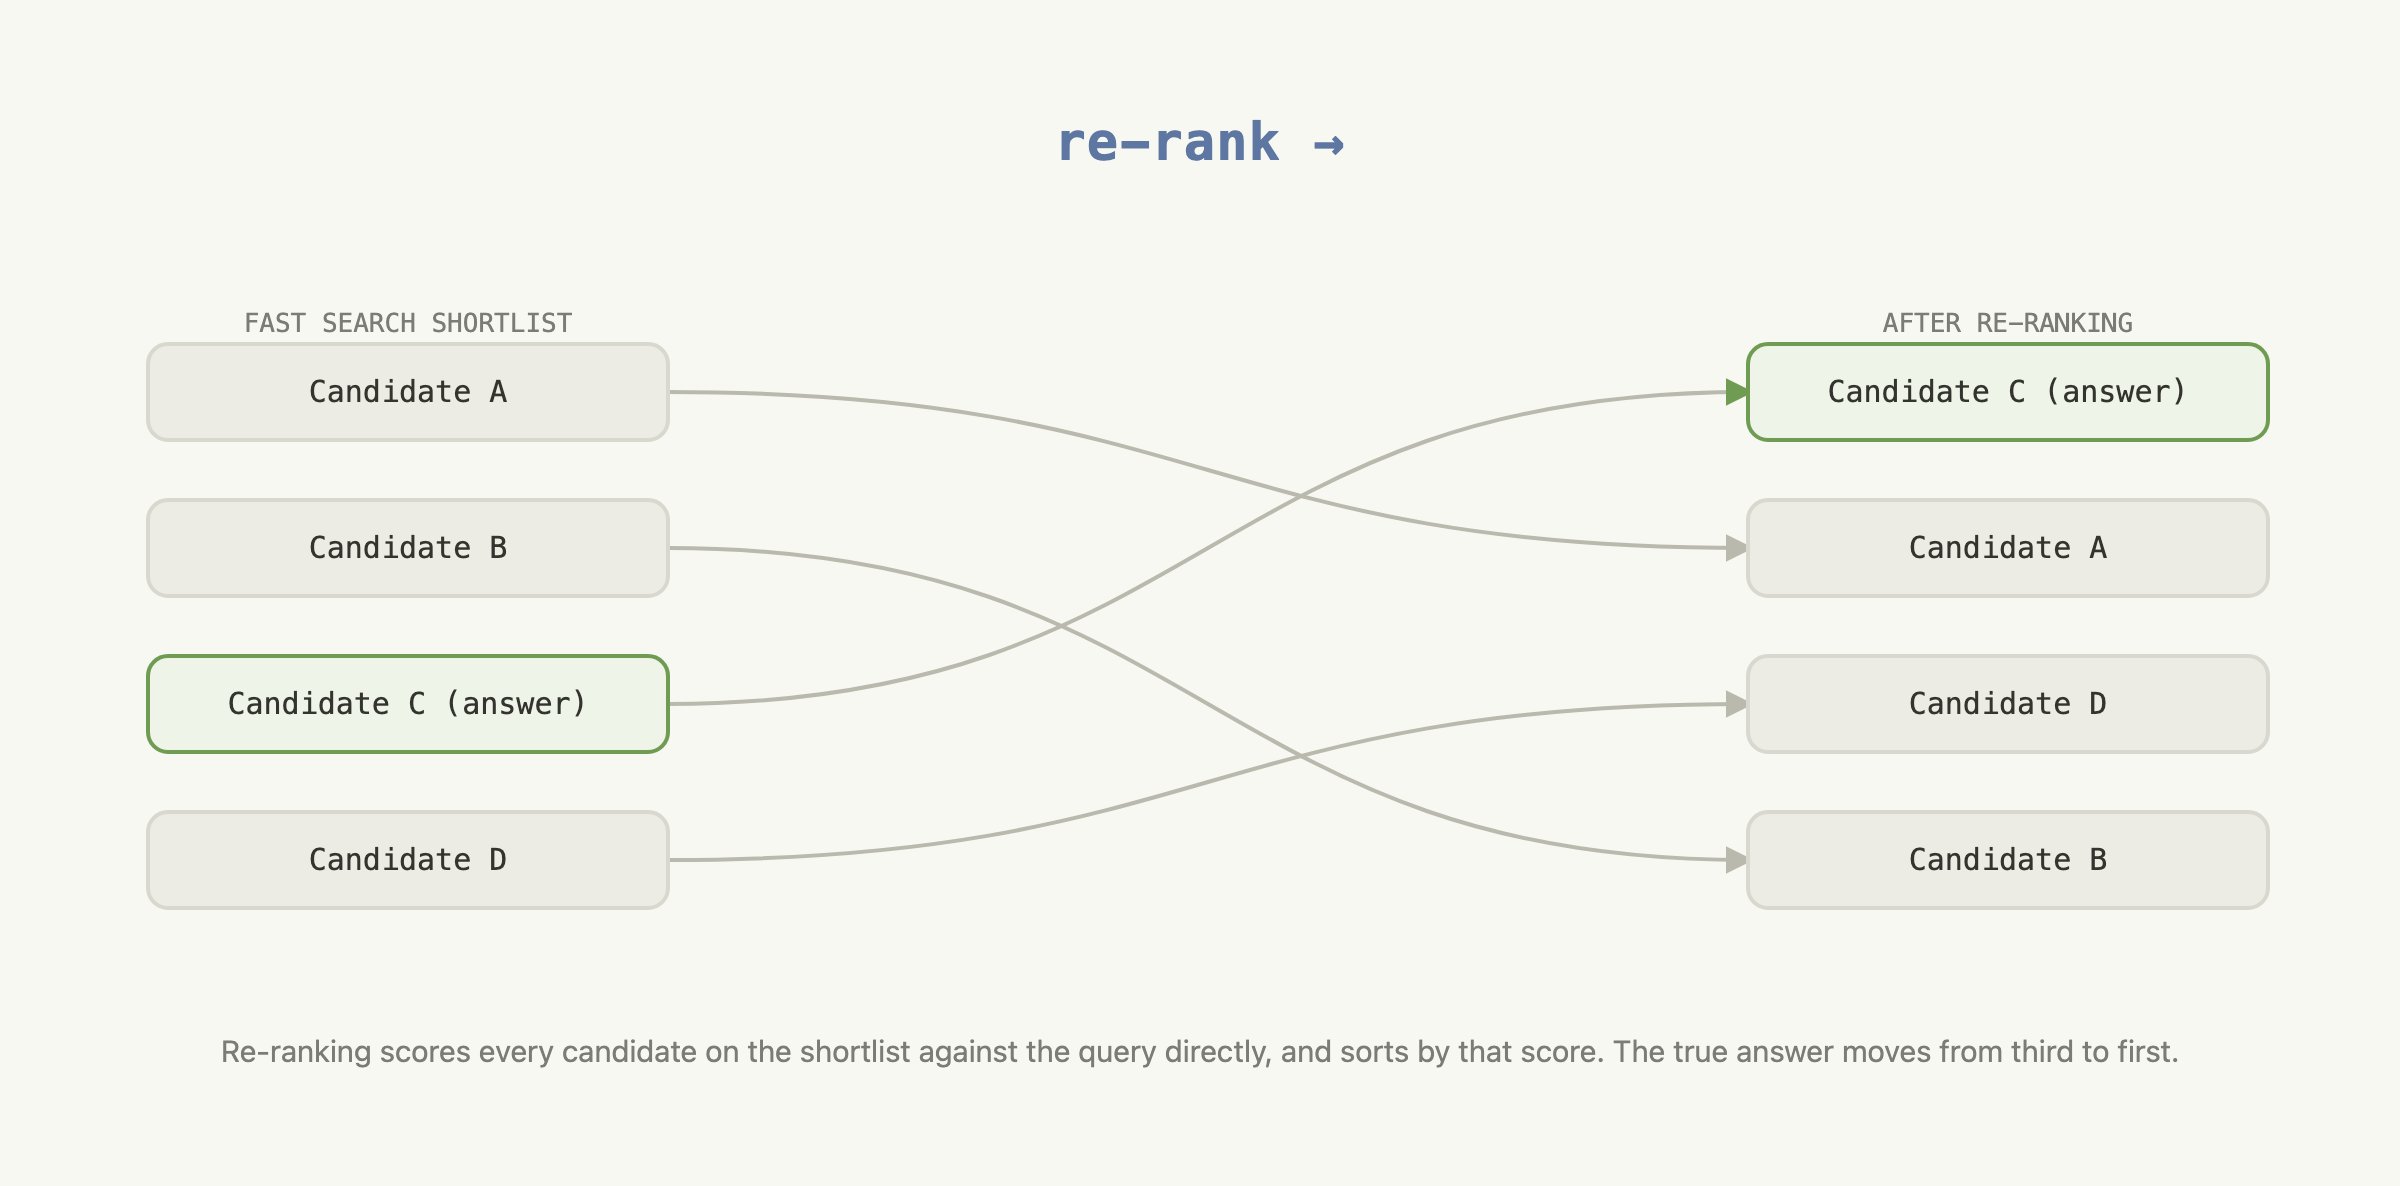
Le score peut venir d’un modèle de langage. Donne-lui la requête et un candidat ensemble, et demande-lui dans quelle mesure le candidat répond à la requête. Le reclassement trouve alors la meilleure correspondance de la liste courte, même quand sa formulation diffère de celle de la requête.
Le reclassement avec TypeSafe
Un reclasseur a besoin d’un score comparable pour chaque paire requête-candidat. Un modèle de langage généraliste peut produire ces scores, ou classer directement toute la liste courte. Pour une notation indépendante par paire, en revanche, tu dois définir une échelle de notation et demander au modèle d’appliquer le même standard à chaque candidat. Des appels répétés peuvent tout de même produire des scores différents pour la même paire, tandis qu’une génération généraliste ajoute du temps et du coût à une tâche qui ne demande qu’un seul nombre.
Ce que renvoie TypeSafe
Avec TypeSafe, la demande de notation peut rester une question oui/non :
Could this candidate passage be from the cited precedent?Un simple oui ou non ne suffirait pas à classer 30 candidats. Un Noul renvoie à la place un
nombre entre 0 et 1, appelé un
noul. Le noul est l’estimation
par TypeSafe de la probabilité que la réponse soit oui.
Les critères de la question définissent ce qui compte comme vrai et comme faux. TypeSafe les applique à chaque paire requête-candidat et renvoie directement le noul. Ce noul est le score sur lequel l’application trie. Aucune échelle de notation n’a à être inventée pour un modèle généraliste, et TypeSafe est conçu pour faire cette notation répétée plus vite, moins cher et plus régulièrement.
En pseudocode simplifié, un appel de notation TypeSafe ressemble à ceci :
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafe lit la requête et un candidat ensemble face à cette question, et renvoie un noul.
Tu peux t’en servir pour reclasser une liste courte en posant la même question à chaque candidat qu’elle contient, puis en triant la liste courte selon le noul renvoyé par chaque appel, du plus haut au plus bas.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
Le schéma ci-dessous montre comment une requête par candidat produit les scores utilisés pour réordonner la liste courte.
flowchart LR
    q["query excerpt<br/><i>one opinion passage,<br/>citation removed</i>"]
    sl["shortlist from fast search<br/><i>30 candidate passages</i>"]
    quest["<b>one Noul</b><br/>could this candidate be<br/>from the cited precedent?<br/><i>criteria fix true and false</i>"]

    %% direction LR inside an LR chart keeps each state beside its noul, two columns,
    %% so the fan-out is four rows tall instead of eight
    subgraph fan["one request per candidate · no request sees another"]
        direction LR
        d1["state<br/>{query, candidate 1}"] --> n1["noul<br/>0.87"]
        d2["state<br/>{query, candidate 2}"] --> n2["noul<br/>0.41"]
        dx["⋮"] --> nx["⋮"]
        d30["state<br/>{query, candidate 30}"] --> n30["noul<br/>0.12"]
    end

    sort["sort by noul,<br/>highest first"]
    out["re-ranked shortlist<br/><i>same 30, better order</i>"]

    q --> fan
    sl --> fan
    quest --> fan
    fan --> sort --> out

    %% the elision is not a node - drop its box so it reads as "and so on"
    classDef elide fill:none,stroke:none
    class dx,nx elide
    linkStyle 2 stroke:none
Un exemple de reclassement
La recherche rapide et le reclassement tournent maintenant sur CLERC, un jeu de données de recherche juridique. Cet exemple utilise 3 565 passages d’opinions judiciaires et 40 requêtes.
Configuration
La première étape installe les paquets dont ce parcours dépend.
bm25setdatasetsconstruisent la liste courte de recherche rapide.typesafe-sdketcooksafegèrent le reclassement et la mise en cache des appels API.matplotlibdessine les graphiques de résultat.
pip install bm25s datasets matplotlib 'cooksafe>=0.2.0,<0.3.0'Le bloc suivant configure le client TypeSafe et les constantes que le reste du parcours
utilise, comme le modèle TypeSafe à appeler et la taille de la liste courte que la recherche
rapide remet au reclasseur. Appeler TypeSafe nécessite une TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Classer les passages avec la recherche rapide
Le jeu de données utilisé ici est un corpus d’opinions judiciaires américaines, 170 lignes regroupées. Chaque ligne se décompose ainsi :
- Requête : un extrait d’opinion dont une citation a été retirée.
- Gold : le passage vers lequel pointait la citation retirée, la seule bonne réponse à la requête.
- Candidats : tous les autres passages du corpus, chacun étant quelque chose à quoi la requête pourrait être associée par erreur.
Sur les 170 lignes, 40 sont choisies pour être évaluées comme requêtes. Les 130 autres n’apparaissent jamais que comme candidats.
La cellule suivante construit la liste courte, avec la technique décrite plus haut :
- Charge le corpus.
- Classe-le face à chaque requête avec BM25.
Il n’y a pas encore de TypeSafe ici, c’est seulement l’étape de recherche rapide.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)

def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]

@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}

def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}

def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None

SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"

def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)

ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)
La recherche rapide place rarement le bon passage en premier
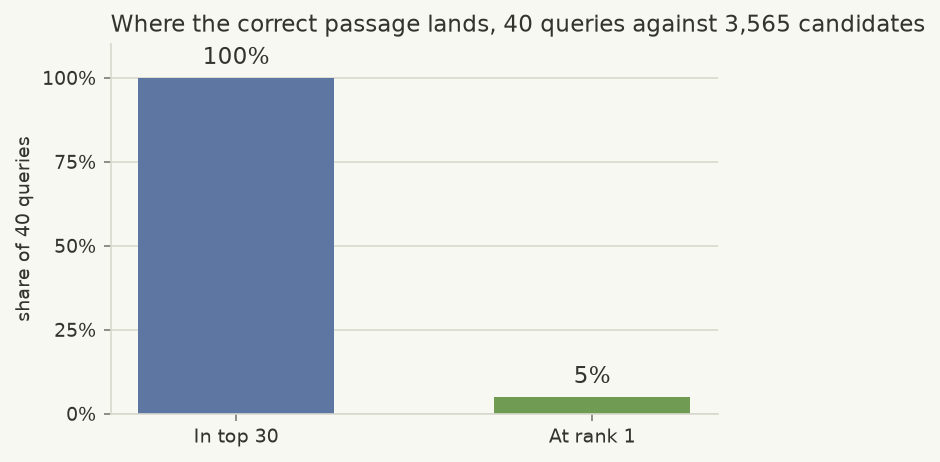
Le graphique montre où la recherche rapide place le bon passage, parmi 3 565 candidats.
La recherche rapide réduit fidèlement le corpus à une liste courte qui contient la bonne réponse. Elle contient la bonne réponse pour 100 % des 40 requêtes. Mais ce passage est rarement celui du haut de la liste courte, seulement 5 % du temps.
Le reclassement ci-dessous ne fait que réordonner les 30 premiers candidats déjà présents dans la liste courte. Il ne peut pas ajouter un passage que la recherche rapide n’a pas sélectionné. Ici, la liste courte contient le bon passage pour les 40 requêtes, donc le reclassement peut se concentrer sur le fait de mettre chacun dans une meilleure position.
Le reclasser avec TypeSafe
Le reclassement note chaque candidat de la liste courte face à sa requête, puis trie selon ce score. La question que TypeSafe pose sur chaque paire est de savoir si le candidat pourrait être le passage vers lequel pointe la citation retirée de la requête.
La cellule suivante fait ce qui suit :
- Définir cette question.
- La poser une fois par candidat sur chaque liste courte, 40 requêtes fois 30 candidats, 1 200 appels au total, exécutés en parallèle plutôt que l’un après l’autre.
- Trier chaque liste courte selon le score renvoyé par TypeSafe, ce qui produit le résultat reclassé.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)

@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }

# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = is_cited_source.model_dump_json(exclude_none=True)
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}

def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)

chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.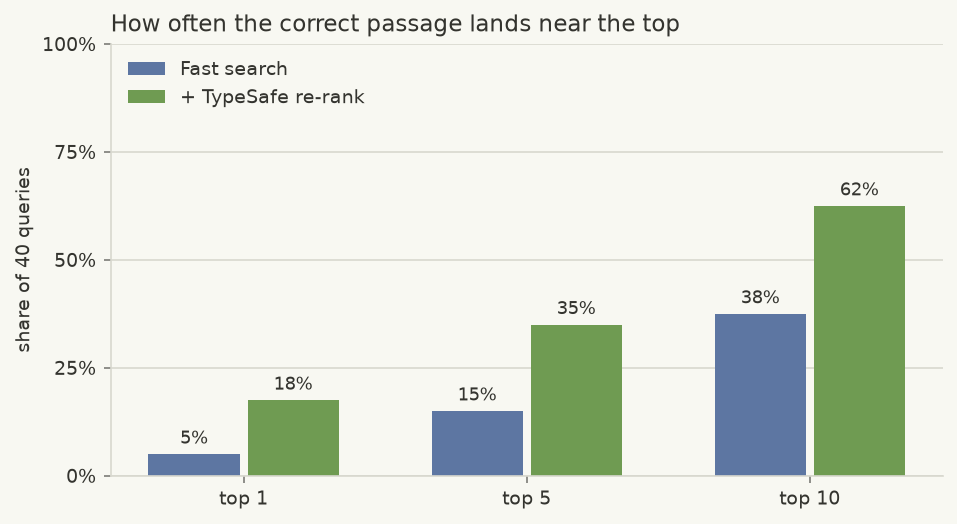
Le reclassement rapproche la bonne réponse du sommet
Le graphique compare la recherche rapide à la recherche rapide plus le reclassement, sur trois seuils. Le reclassement rapproche le bon passage du sommet à chacun d’eux :
- Top 1 — 5 % → 18 %
- Top 5 — 15 % → 35 %
- Top 10 — 38 % → 62 %
Le nombre de jetons et le coût rapportés couvrent les 1 200 appels TypeSafe utilisés pour reclasser les 40 listes courtes.
Chaque ligne CLERC contient un bon passage et 20 passages négatifs. Ce parcours regroupe les passages de 170 lignes dans un seul corpus partagé. Pour chacune des 40 requêtes d’évaluation, BM25 sélectionne 30 candidats dans ce corpus complet, pas seulement les 20 négatifs fournis avec la ligne. TypeSafe lit ensuite la requête face à chaque candidat sélectionné et reclasse ces 30 passages.
Ce parcours a posé une question par paire pour la clarté. Une vraie application poserait plusieurs questions sur la même paire en un seul appel. Voir le cookbook des questions en parallèle et le patron Fan-out spéculatif pour la marche à suivre.
Et ensuite
Les mêmes briques réapparaissent ailleurs dans la documentation de TypeSafe :
- Noul, pour voir comment TypeSafe transforme une question oui/non en score.
- Fan-out spéculatif, pour poser plusieurs questions sur un document en un seul appel.
- Recherche ligne par ligne, pour une autre façon de chercher dans un corpus par le sens plutôt que par les mots-clés.