バージョン 0.2.0 は、適用可能なプロンプトと結果の修正をアップストリーム 4aa6761(ソースバージョン 0.3.23)を通じて同期します。Core ML と ANE の両ランタイムが、カスタムの noul 表示ラベル({"false": "no", "true": "yes"})を受け付け、質問ごとのエラーで質問を検証し、Unicode の構造化命令を保持します。長い会話リストは最新のトークンを保持し、文字列とオブジェクトは先頭を保持します。usage は状態の切り詰めと、該当する場合は折りたたまれた選択肢を報告します。answer_confidence は最も高い回答確率であり、既存の confidence の意味は変わりません。どちらのフィールドも較正の正確さを保証するものではありません。以下に記述するチェックポイントの温度クランプはこのリリースに含まれます。エクスポートされたグラフの容量制限は、黙って切り詰めるのではなく、依然としてエラーを送出します。
メンテナンスは、これらのランタイムに適用可能なアップストリーム Laya の修正に追随します。新しいランタイム機能やバックエンド固有の最適化提案には、アップストリームに整合した実装と検証が必要です。issue をクローズしても、報告された挙動が修正されたことにはなりません。
Apple Silicon 上のオープンウェイトな型付き意思決定。Core ML、Neural Engine、生成トークンはゼロ。
PyPI · Hugging Face の重み · 中文
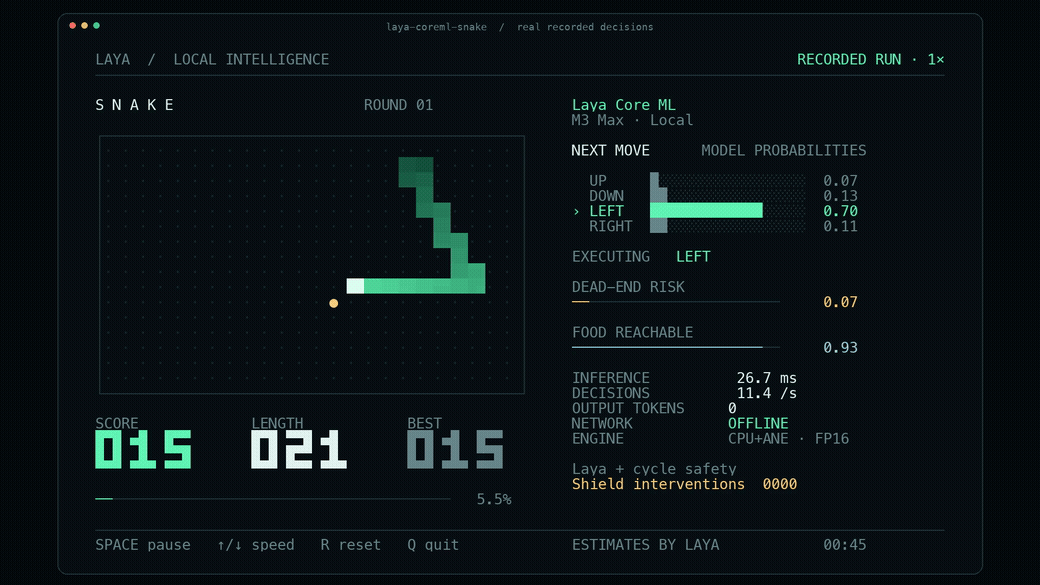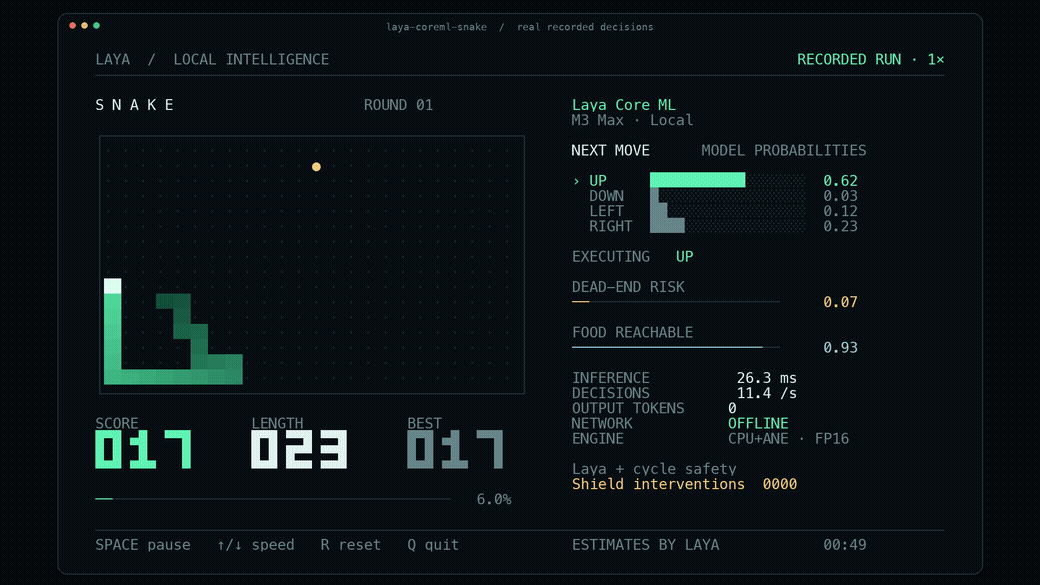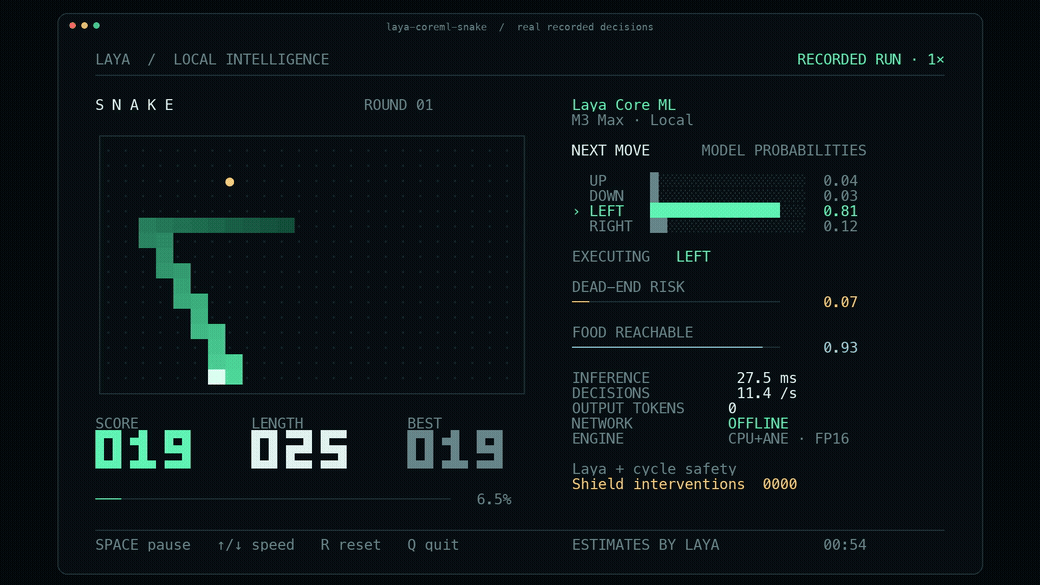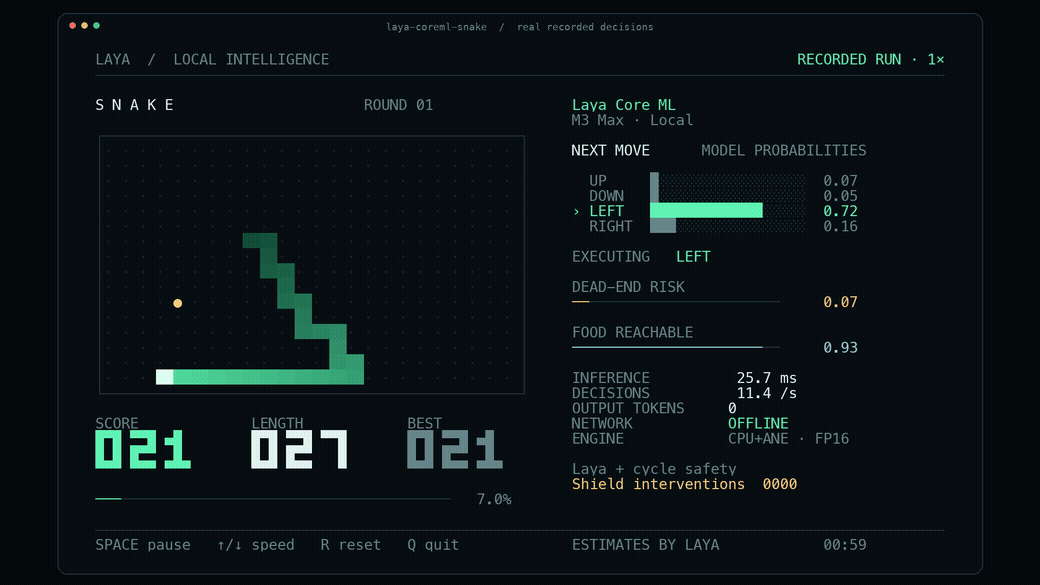
本物の Laya モデルが Snake をローカルでプレイし、確率・スコア・長さ・レイテンシ・安全介入が可視化されます。GIF は記録された Core ML の実行を 1× 速度で再生したものです。ゲームは明示的なプランナー特徴量と、可視化されたサイクル安全層を使います。
完全なアクティブ Snake ループは、上限なしの 600 ステップのエピソード 3 本にわたり 49.1〜50.0 意思決定/秒を持続し、死亡ゼロ、安全介入 2 回でした。ゲームループのタイミングとペース制御レートの限界にはレンダリングのシリアライズが含まれ、端末の描画は除かれます。
短い多言語の意思決定 1 回:M3 Max で ANE FP16 により 4.98 ms P50 / 5.31 ms P95。 同じ実験で、コンパイル済み MLX FP16 より 意思決定あたりのシステム全体エネルギーが 2.78 倍良好と測定されました。別途検証された W8 パレット版は 4.88 ms、エネルギー改善 3.19 倍に達しました。これらは単一質問の結果であり、Snake のフレーム時間全体ではありません。要求された 10 倍の改善は達成されていません。
デモを実行する
Apple Silicon · macOS 15+ · Python 3.11〜3.13。
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
一度ダウンロードすれば、その後はオフラインでプレイできます。推論に PyTorch、Transformers、MLX は不要です。端末には 104 列 × 35 行が必要です。Space で一時停止、↑/↓ で速度変更、R でリセット、Q で終了します。初回の Core ML 初期化には数十秒かかることがあります。
操作方法・録画・動画エクスポート · 実測された安定した意思決定レート · 共有可能な動画と録画の出所
意思決定を求める
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])Laya は choice、順序尺度の score、真偽の noul の各質問に対して確率を返します。自己回帰的なデコードや、パースすべき生成 JSON はありません。Hub のモデルは初期化前にダウンロードされ、以降の予測はローカルにとどまります。既存のキャッシュを必須にするには local_files_only=True を渡すか、ローカルディレクトリをロードしてください。
アップストリーム v0.3.5 に従い、フィット済みの較正温度は使用前に [0.5, 5.0] にクランプされます。同梱の choice:11+ バケットは 0.1006 で、そのままではロジットを約 10 倍鋭くし、コイントスをほぼ確実と報告してしまいます。チェックポイントの生の値は agent.temperature_raw と agent.temperature_by_options_raw として引き続き利用でき、ロード時にクランプされた各バケットを RuntimeWarning が名指しします。
ANE バンドルには 合計 96 トークンの上限があり、質問・選択肢・状態を含みます。それより長いリクエストは容量エラーを送出します。汎用の 1024 トークンモデルには aac6fef/laya-multilingual-coreml を使ってください。API 全体・モデル選択・オフライン利用。
M3 Max での実測
40 コア GPU、128 GiB、macOS 27.2。91 トークンの質問 1 件を 96 にパディングし、プロンプト準備・トークン化・配列・同期推論・較正・フォーマットを含みます。ロードとウォームアップは除きます。MLX は compile、プレフィックスキャッシュ、シェイプバケットを有効にします。実装ごとに 20 秒のブロックを交互に 6 回実行し、65,598 回の安定した呼び出しが得られました。
| 指標 | コンパイル済み MLX FP16 | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| 平均システム電力推定 | 61.39 W | 30.75 W | 27.39 W |
| システムエネルギー / 意思決定 | 0.4288 J | 0.1540 J | 0.1344 J |
| 速度向上 | 1× | 1.39× | 1.42× |
| システムエネルギー向上 | 1× | 2.78× | 3.19× |
エネルギーは直接の SMC PSTR センサー読み取りを使用し、生サンプルと明示的な異常値除外を伴います。これはセンサーとバックグラウンド負荷の不確かさを含む推定です。速度向上 × 平均電力比 = エネルギー向上であり、エネルギーにさらに速度を掛けると時間を二重計上することになります。W8 版は重みを圧縮しつつ FP16 演算を維持します。これは近似であり、パッケージサイズの削減は速度比ではありません。
利用可能なチェックポイント
| Hugging Face バンドル | 既定のエンジン | 容量 | 用途 |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 tokens | 元の英語モデル |
| Multilingual 322M | CPU + GPU | 1024 tokens | 汎用の多言語意思決定 |
| Typed Decisions 421M | CPU + GPU | 1024 tokens | 元の専用チェックポイント |
| Snake GPU | CPU + GPU | B3 / L64 | コンパクトな 3 つのゲーム質問をバッチ化 |
| Multilingual ANE | CPU + ANE | B1 / L96 | 短い意思決定、FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | 任意の近似的パレット圧縮 |
すべてのバンドルには、tokenizer/設定、モデルカード、出所、チェックサム、パッケージング時の検証が含まれます。ANE バンドルにはさらに、必要となる元のホスト埋め込み/アクションのテンソルがそのまま含まれます。元の学習チェックアウトは不要です。
移植の忠実性と限界
3 つの汎用 FP16 チェックポイントは、189/189 の検証質問でアップストリームの選択回答と一致します。それぞれ 100 回の繰り返し呼び出しを通過します。ANE FP16 L96 は 59/59 の適合質問を通過し、較正確率の最大ドリフトは 0.002925 です。W8 は同じサブセットを、変更されていない 0.02 のゲートの下でドリフト 0.014393 で通過します。6 ビットと 4 ビットの実験はそのゲートを通過できず、公開された重みではありません。これらは変換忠実性のフィクスチャであり、一般的なタスク精度の証明ではありません。
別途エクスポートされた FP16 ANE L1024 グラフは完全な 63/63 のフィクスチャを通過しますが、実際の 1024 トークンリクエストはその直列スクリーニングで約 91.7 ms かかります。短い ANE の結果は長文脈の優位性を示すものではありません。600 ステップのペア Snake チェックは 600/600 のアクションで一致し、死亡ゼロ、シールド介入ゼロでした。現在の ANE アダプタの 3 回の逐次呼び出しは、コンパイル済み MLX に対する一貫したゲーム全体の高速化を示すものではありません。
通常の SDPA Core ML エクスポートと ANE グラフは別の実装です。通常のエクスポートは、制限なしの RangeDim GPU シェイプがローカルの忠実性チェックに失敗したため、既定で CPU+GPU になります。そのデバイス設定を変えるだけでは ANE の結果は再現しません。ANE の書き直しは BC1L アクティベーション、1×1 射影、ヘッド単位のアテンションを使用し、その計画と別途の Instruments トレースが Neural Engine での処理を裏付けます。入出力の境界は依然として CPU が担います。
ドキュメントと再現性
- インストールと Python/CLI API
- Snake デモとメディア
- リリース成果物と固定した Hub リビジョン
- 一般的な Core ML ベンチマーク
- ANE エンジニアリング実験
- 10 倍目標の数学的検討
- 変換の問題と対応シェイプ
自分でエクスポートするには、laya-coreml[convert] をインストールして laya-coreml convert laya-multilingual models/custom を実行します。ANE 研究用の変換・圧縮・ベンチマークのスクリプトは Git チェックアウト内にあります。推論ホイールには可搬なランタイムと任意のターミナルデモが含まれます。
Apache-2.0。Laya の独立した移植であり、Convai Innovations とコントリビューターによるもので、MLX の姉妹プロジェクトを土台にしています。Convai Innovations または Apple の公式リリースではありません。NOTICE を参照してください。