버전 0.2.0은 해당 런타임에 적용되는 프롬프트 및 결과 수정을 업스트림
4aa6761(소스 버전 0.3.23)을 통해 동기화합니다. Core ML과 ANE 런타임 모두
사용자 지정 noul 표시 레이블({"false": "no", "true": "yes"})을 받아들이고,
질문별 오류로 질문을 검증하며, 유니코드 구조화 instructions를 보존합니다. 긴
대화 목록은 가장 최신 토큰을 유지하고, 문자열과 객체는 시작 부분을 유지합니다.
usage는 상태 잘림과, 있는 경우 축약된 옵션을 보고합니다.
answer_confidence는 가장 높은 답 확률이며, 기존 confidence 의미는 그대로입니다.
어느 필드도 캘리브레이션 정확도를 입증하지 않습니다.
아래에 문서화된 체크포인트 온도 클램프가 이번 릴리스에 포함됩니다.
내보낸 그래프의 용량 한도는 조용히 잘라내지 않고 여전히 오류를 발생시킵니다.
유지보수는 이 런타임들에 적용되는 업스트림 Laya 수정을 따릅니다. 새 런타임 기능과 백엔드별 최적화 제안은 업스트림에 맞춘 구현과 검증이 필요합니다. 이슈를 닫았다고 해서 보고된 동작이 수정되었다는 뜻은 아닙니다.
Apple Silicon에서의 오픈 웨이트 타입 지정 의사결정. Core ML, Neural Engine, 생성 토큰 0개.
PyPI · Hugging Face 가중치 · 중국어
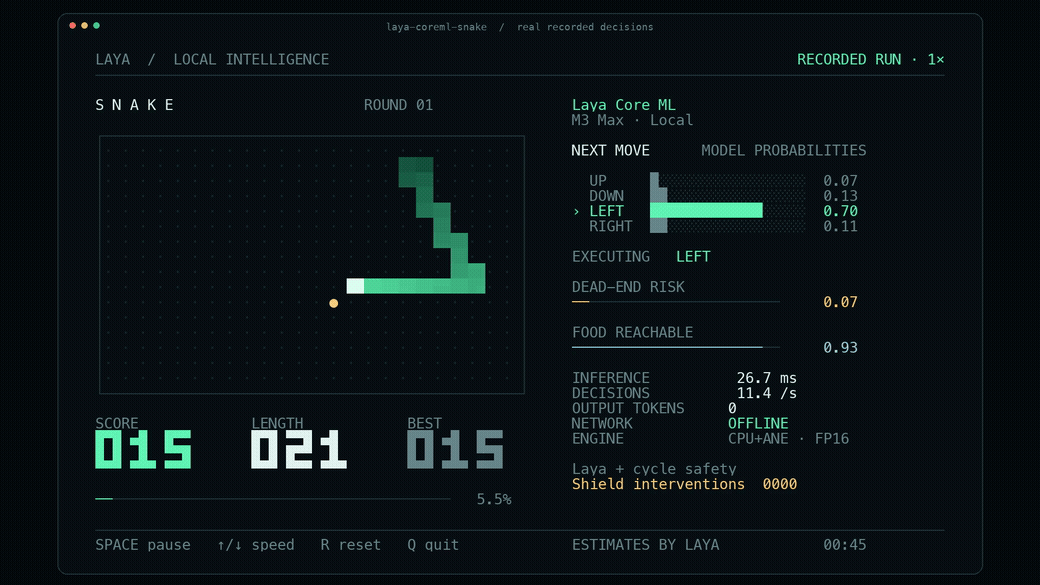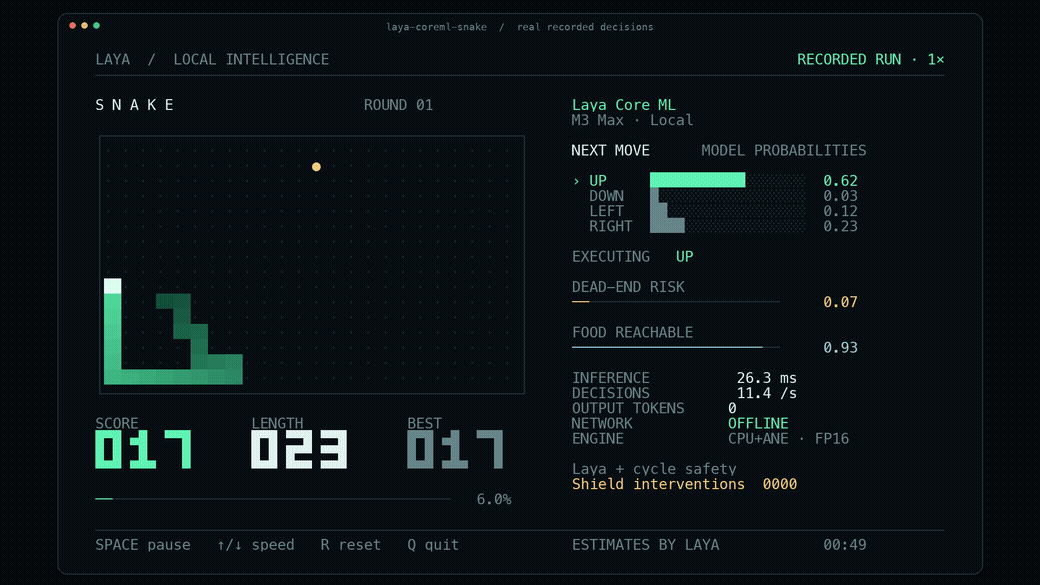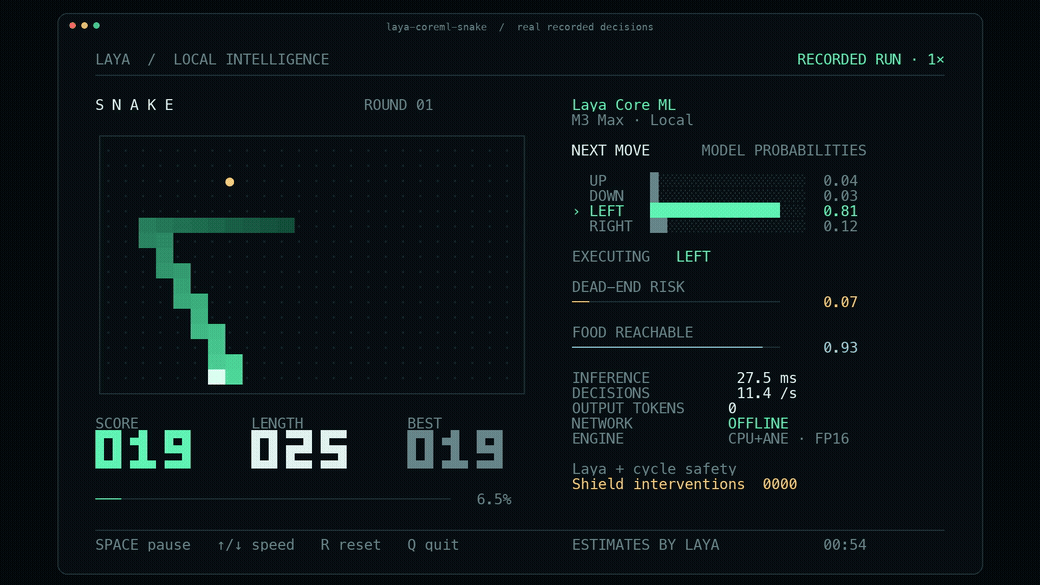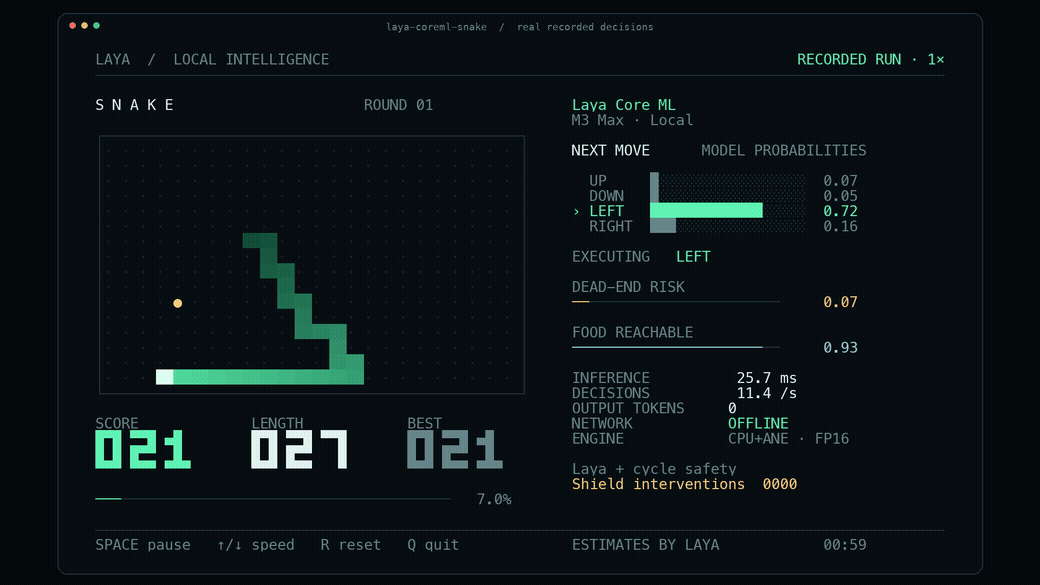
실제 Laya 모델이 로컬에서 Snake를 플레이하며, 확률·점수·길이·지연 시간·안전 개입이 모두 화면에 보입니다. GIF는 기록된 Core ML 실행을 1× 속도로 재생한 것입니다. 게임은 명시적인 플래너 특징을 사용하고, 순환 안전 계층(cycle safety layer)이 화면에 표시됩니다.
완전한 활성 Snake 루프는 제한 없는 600스텝 에피소드 세 번에서 49.1–50.0 의사결정/초를 유지했고, 사망 0회, 안전 개입 2회를 기록했습니다. 게임 루프 타이밍과 속도 제한에는 렌더링 직렬화가 포함되며, 터미널 페인팅은 제외됩니다.
짧은 다국어 의사결정 하나: ANE FP16를 쓴 M3 Max에서 4.98 ms P50 / 5.31 ms P95. 같은 실험에서 컴파일된 MLX FP16보다 의사결정당 전체 시스템 에너지가 2.78× 더 우수한 것으로 측정되었습니다. 별도로 검증된 W8 팔레트 변형은 4.88 ms와 3.19× 에너지 개선에 도달했습니다. 이는 단일 질문 결과이며 전체 Snake 프레임 시간이 아닙니다. 요청된 10× 개선은 달성되지 않았습니다.
데모 실행
Apple Silicon · macOS 15+ · Python 3.11–3.13.
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
한 번만 다운로드하면 이후 오프라인으로 플레이할 수 있습니다. 추론에는 PyTorch, Transformers, MLX가 필요하지 않습니다. 터미널은 104열 × 35행이 필요합니다. Space는 일시정지, ↑/↓는 속도 변경, R은 리셋, Q는 종료입니다. 처음 Core ML 초기화에는 수십 초가 걸릴 수 있습니다.
조작, 녹화 및 영상 내보내기 · 측정된 안정 의사결정 속도 · 공유 가능한 영상과 녹화 출처
의사결정 요청하기
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])Laya는 choice, 서수형 score, 불리언 noul 질문에 대해 확률을
돌려줍니다. 자기회귀 디코딩도, 파싱할 생성 JSON도 없습니다. Hub 모델은 초기화
전에 다운로드되며, 이후 예측은 로컬에서 이루어집니다. local_files_only=True를
전달하면 기존 캐시를 요구하고, 로컬 디렉터리를 로드할 수도 있습니다.
업스트림 v0.3.5에 따라, 적합된 캘리브레이션 온도는 사용 전에 [0.5, 5.0]으로
클램프됩니다. 배포된 choice:11+ 버킷은 0.1006인데, 이대로면 로짓을 약 10배로
예리하게 만들어 동전 던지기를 거의 확실한 것으로 보고하게 됩니다. 체크포인트의
원시 값은 agent.temperature_raw와 agent.temperature_by_options_raw로 여전히
사용할 수 있으며, 로드 시 RuntimeWarning이 클램프된 모든 버킷을 알려줍니다.
ANE 번들은 질문, 옵션, 상태를 포함해 총 96토큰 한도를 가집니다. 더 긴 요청은
용량 오류를 발생시킵니다. 범용 1024토큰 모델이 필요하면
aac6fef/laya-multilingual-coreml을 사용하십시오.
전체 API, 모델 선택 및 오프라인 사용.
M3 Max에서의 측정
40코어 GPU, 128 GiB, macOS 27.2. 91토큰 질문 하나를 96으로 패딩했으며, 프롬프트 준비, 토크나이즈, 배열, 동기 추론, 캘리브레이션, 포매팅을 포함합니다. 로딩과 워밍업은 제외합니다. MLX는 컴파일, 프리픽스 캐싱, 셰이프 버킷을 활성화합니다. 구현마다 20초 블록을 여섯 번 번갈아 실행해 65,598회의 안정 호출을 얻었습니다.
| 지표 | 컴파일된 MLX FP16 | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| 평균 시스템 전력 추정 | 61.39 W | 30.75 W | 27.39 W |
| 의사결정당 시스템 에너지 | 0.4288 J | 0.1540 J | 0.1344 J |
| 속도 이득 | 1× | 1.39× | 1.42× |
| 시스템 에너지 이득 | 1× | 2.78× | 3.19× |
에너지는 SMC PSTR 센서를 직접 읽어 측정하며, 원시 샘플과 명시적 이상치 제거를 사용합니다. 이는 센서와 백그라운드 부하 불확실성을 가진 추정치입니다. 속도 이득 × 평균 전력 비율 = 에너지 이득이며, 에너지에 속도를 다시 곱하면 시간을 이중 계산하게 됩니다. W8 변형은 FP16 연산을 유지하면서 가중치를 압축합니다. 이는 근사이며, 패키지 크기 감소는 속도 비율이 아닙니다.
사용 가능한 체크포인트
| Hugging Face 번들 | 기본 엔진 | 용량 | 용도 |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 토큰 | 원래 영어 모델 |
| 다국어 322M | CPU + GPU | 1024 토큰 | 범용 다국어 의사결정 |
| Typed Decisions 421M | CPU + GPU | 1024 토큰 | 원래 특화 체크포인트 |
| Snake GPU | CPU + GPU | B3 / L64 | 세 가지 압축 게임 질문을 배치 처리 |
| 다국어 ANE | CPU + ANE | B1 / L96 | 짧은 의사결정, FP16 |
| 다국어 ANE W8 | CPU + ANE | B1 / L96 | 선택적 근사 팔레트 압축 |
모든 번들에는 토크나이저/구성, 모델 카드, 출처, 체크섬, 패키징 시점 검증이 포함됩니다. ANE 번들은 필요한 정확한 원본 호스트 임베딩/액션 텐서도 포함합니다. 원본 학습 체크아웃은 필요하지 않습니다.
포팅 충실도와 한계
세 개의 범용 FP16 체크포인트는 업스트림 선택 답과 189/189 검증 질문에서 일치합니다. 각각 반복 호출 100회를 통과합니다. ANE FP16 L96은 59/59 적합 질문을 통과하며, 최대 캘리브레이션 확률 드리프트는 0.002925입니다. W8은 변경되지 않은 0.02 게이트에서 드리프트 0.014393으로 같은 부분집합을 통과합니다. 6비트와 4비트 실험은 그 게이트를 통과하지 못했고 공개 가중치가 아닙니다. 이는 변환 충실도 픽스처이며, 일반 작업 정확도의 증명이 아닙니다.
별도로 내보낸 FP16 ANE L1024 그래프는 완전한 63/63 픽스처를 통과하지만, 실제 1024토큰 요청은 직렬 스크린에서 약 91.7 ms가 걸립니다. 짧은 ANE 결과가 장문맥 우위를 입증하지는 않습니다. 600스텝 페어링 Snake 검사는 600/600 액션에서 일치하며, 사망 0회, 실드 개입 0회입니다. 현재 ANE 어댑터의 순차 호출 세 번은 컴파일된 MLX 대비 일관된 전체 게임 속도 향상을 입증하지 않습니다.
일반 SDPA Core ML 내보내기와 ANE 그래프는 서로 다른 구현입니다. 일반 내보내기는 제한 없는 RangeDim GPU 셰이프가 로컬 충실도 검사를 통과하지 못한 뒤 CPU+GPU를 기본으로 합니다. 기기 설정만 바꿔서는 ANE 결과를 재현할 수 없습니다. ANE 재작성은 BC1L 활성화, 1×1 투영, 헤드별 어텐션을 사용하며, 그 계획과 별도의 Instruments 트레이스가 Neural Engine 작업을 뒷받침합니다. 입출력 경계는 여전히 CPU가 처리합니다.
문서와 재현성
- 설치와 Python/CLI API
- Snake 데모와 미디어
- 릴리스 아티팩트와 고정된 Hub 리비전
- 일반 Core ML 벤치마크
- ANE 엔지니어링 실험
- 10× 목표에 대한 수학적 조사
- 변환 문제와 지원되는 셰이프
직접 내보내려면 laya-coreml[convert]를 설치하고
laya-coreml convert laya-multilingual models/custom을 실행하십시오. ANE 연구용
변환, 압축, 벤치마크 스크립트는 Git 체크아웃에 있습니다. 추론 휠에는 이식
가능한 런타임과 선택적 터미널 데모가 들어 있습니다.
Apache-2.0. Laya의 독립 포트로, Convai Innovations와 기여자들이 만들었으며 MLX 자매 프로젝트를 기반으로 합니다. 공식 Convai Innovations 또는 Apple 릴리스가 아닙니다. NOTICE를 참조하십시오.