A versão 0.2.0 sincroniza as correções aplicáveis de prompt e de resultado através
do upstream 4aa6761 (versão de origem 0.3.23). Tanto os runtimes Core ML como os
ANE aceitam etiquetas de apresentação noul personalizadas
({"false": "no", "true": "yes"}), validam as perguntas com erros específicos de
cada pergunta e preservam instruções estruturadas em Unicode. As listas de
conversa longas mantêm os tokens mais recentes; as cadeias de caracteres e os
objetos mantêm o início. O usage reporta o truncamento do estado e, quando
existem, as opções colapsadas. O answer_confidence é a probabilidade mais alta
da resposta; a semântica existente de confidence mantém-se inalterada. Nenhum
dos campos estabelece exatidão de calibração. O clamp de temperatura do
checkpoint documentado abaixo está incluído nesta versão. Os limites de
capacidade dos grafos exportados continuam a gerar erros em vez de cortarem
silenciosamente.
A manutenção segue as correções do Laya upstream aplicáveis a estes runtimes. Funcionalidades novas do runtime e propostas de otimização específicas de um backend exigem uma implementação e uma validação alinhadas com o upstream; fechar uma issue não estabelece que o comportamento reportado ficou corrigido.
Decisões tipadas com pesos abertos em Apple Silicon. Core ML, Neural Engine, zero tokens gerados.
PyPI · Pesos no Hugging Face · Chinês
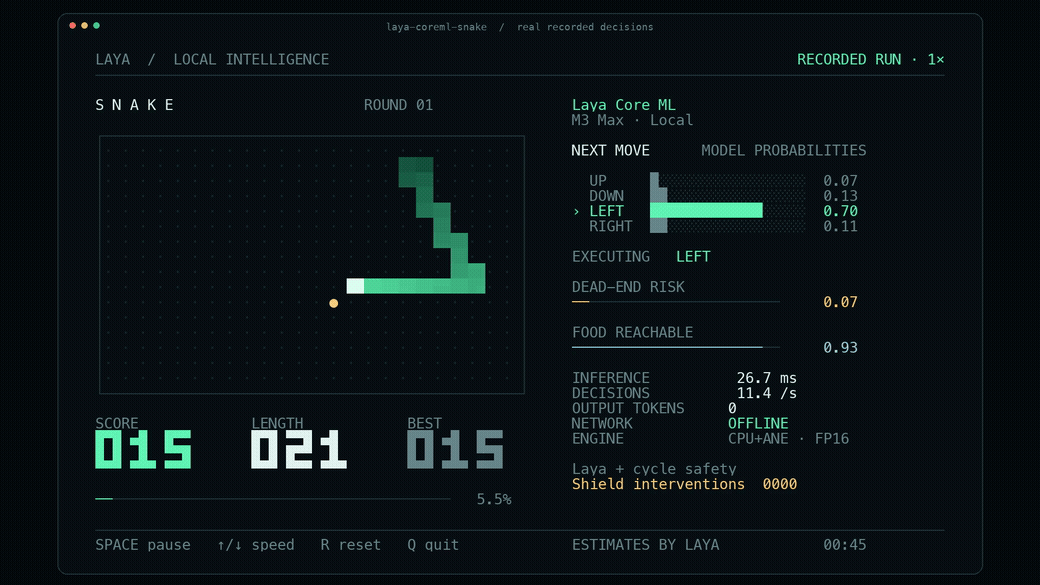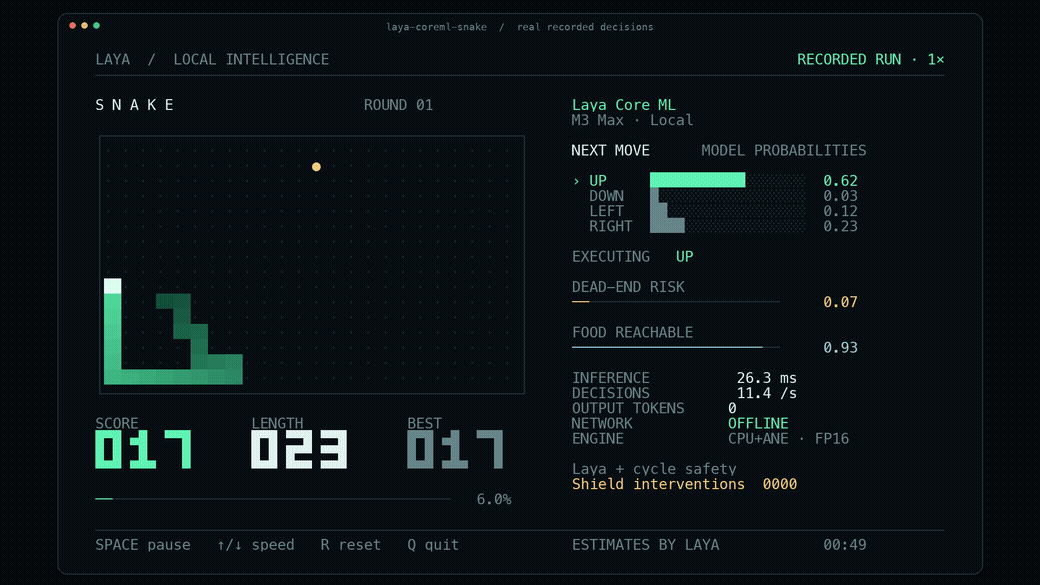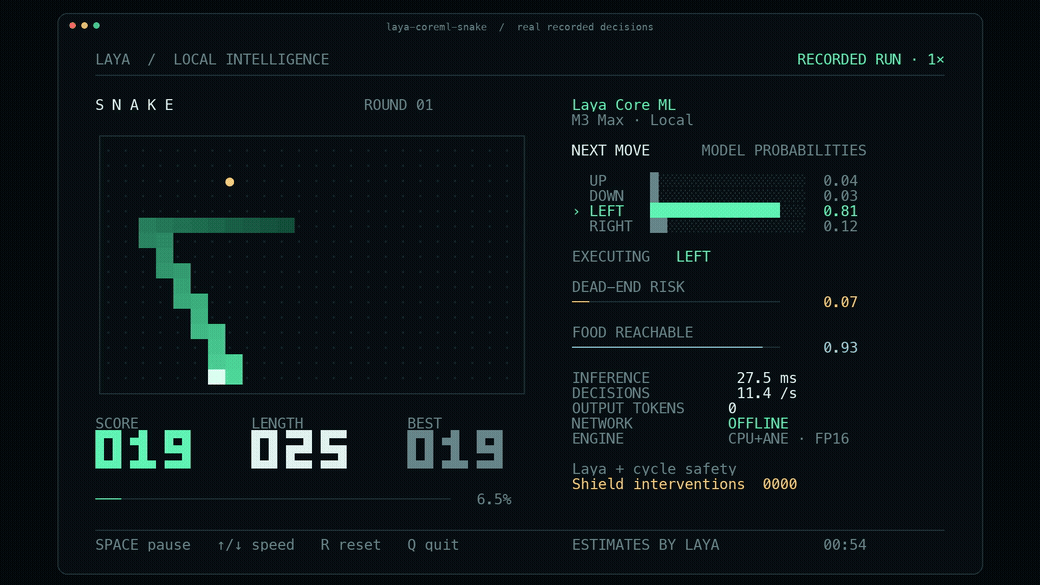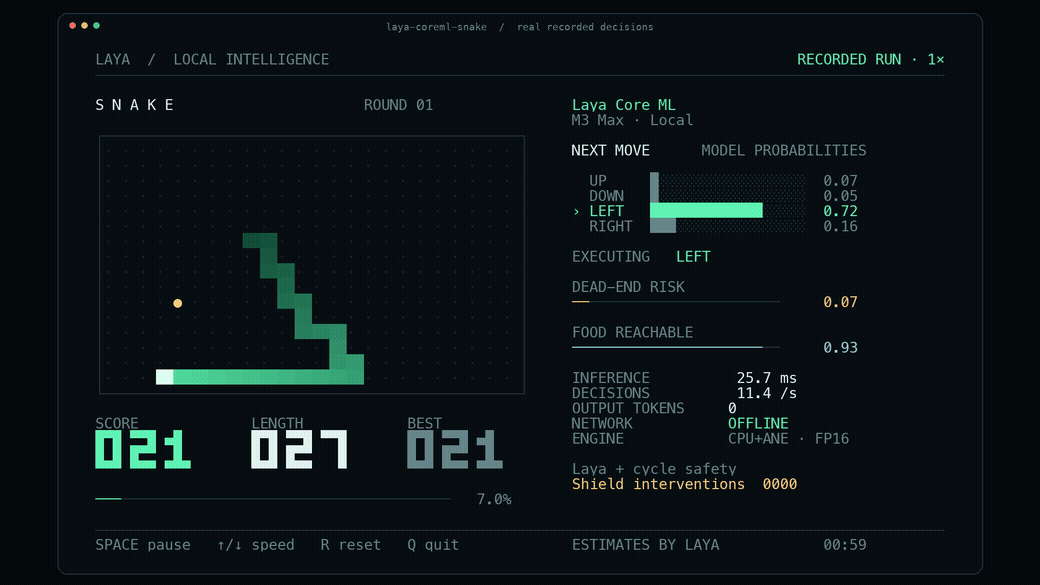
Um modelo Laya real joga Snake localmente, com probabilidades, pontuação, comprimento, latência e intervenções de segurança visíveis. O GIF reproduz uma execução Core ML gravada a velocidade 1×. O jogo usa características explícitas do planeador e uma camada de segurança de ciclo visível.
O ciclo ativo completo do Snake sustentou 49.1–50.0 decisões/s ao longo de três episódios sem limite de 600 passos, com zero mortes e duas intervenções de segurança. Tempos do ciclo de jogo e limites de ritmo fixo incluem a serialização da renderização; a pintura do terminal está excluída.
Uma decisão multilingue curta: 4.98 ms P50 / 5.31 ms P95 num M3 Max com ANE FP16. A mesma experiência mediu energia total do sistema por decisão 2.78× melhor do que o MLX FP16 compilado. Uma variante de paleta W8, validada em separado, alcançou 4.88 ms e uma melhoria de energia de 3.19×. Estes resultados são de uma única pergunta, não tempos de fotograma completos do Snake; a melhoria de 10× pedida não foi alcançada.
Executar a demonstração
Apple Silicon · macOS 15+ · Python 3.11–3.13.
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
Descarrega uma vez e joga depois offline. Não é preciso PyTorch, Transformers nem MLX para a inferência. O terminal precisa de 104 colunas × 35 linhas. A barra de espaços pausa; ↑/↓ muda a velocidade; R reinicia; Q sai. A inicialização do Core ML na primeira utilização pode demorar dezenas de segundos.
Controlos, gravação e exportação de vídeo · Taxas de decisão estáveis medidas · Proveniência do vídeo e da gravação partilháveis
Pedir uma decisão
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])O Laya devolve probabilidades para perguntas choice, score ordinais e
noul booleanas. Não há descodificação autorregressiva nem JSON gerado para
analisar. Os modelos do Hub são descarregados antes da inicialização; as predições
seguintes ficam locais. Passa local_files_only=True para exigir uma cache
existente, ou carrega um diretório local.
Seguindo o upstream v0.3.5, as temperaturas de calibração ajustadas são limitadas
(clamp) a [0.5, 5.0] antes de serem usadas: o bucket choice:11+ distribuído é
0.1006, o que aguçaria os logits ~10x e reportaria um lançamento de moeda como
quase certeza. Os valores em bruto do checkpoint continuam disponíveis como
agent.temperature_raw e agent.temperature_by_options_raw, e um
RuntimeWarning nomeia cada bucket limitado no carregamento.
O pacote ANE tem um limite total de 96 tokens, incluindo a pergunta, as opções
e o estado. Pedidos mais longos geram um erro de capacidade. Usa
aac6fef/laya-multilingual-coreml para o modelo de uso geral de 1024 tokens.
API completa, seleção de modelo e utilização offline.
Medido num M3 Max
GPU de 40 núcleos, 128 GiB, macOS 27.2. Uma pergunta de 91 tokens preenchida até 96, incluindo a preparação do prompt, a tokenização, os arrays, a inferência síncrona, a calibração e a formatação. O carregamento e o aquecimento estão excluídos. O MLX ativa a compilação, a cache de prefixos e os buckets de forma. Seis blocos alternados de 20 segundos por implementação produziram 65,598 chamadas estáveis.
| Métrica | MLX FP16 compilado | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| Estimativa da potência média do sistema | 61.39 W | 30.75 W | 27.39 W |
| Energia do sistema / decisão | 0.4288 J | 0.1540 J | 0.1344 J |
| Ganho de velocidade | 1× | 1.39× | 1.42× |
| Ganho de energia do sistema | 1× | 2.78× | 3.19× |
A energia usa leituras diretas do sensor SMC PSTR, com amostras em bruto e rejeição explícita de anomalias. É uma estimativa com incerteza do sensor e da carga em segundo plano. Ganho de velocidade × rácio de potência média = ganho de energia; multiplicar novamente a energia pela velocidade contaria o tempo duas vezes. A variante W8 comprime os pesos mantendo o cálculo em FP16. É aproximada, e a sua redução do tamanho do pacote não é um rácio de velocidade.
Provas de velocidade, energia e hardware · Medições em bruto.
Checkpoints disponíveis
| Pacote do Hugging Face | Motor predefinido | Capacidade | Finalidade |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 tokens | Modelo inglês original |
| Multilingue 322M | CPU + GPU | 1024 tokens | Decisões multilingues de uso geral |
| Decisões Tipadas 421M | CPU + GPU | 1024 tokens | Checkpoint especializado original |
| Snake GPU | CPU + GPU | B3 / L64 | Agrupa as três perguntas compactas do jogo |
| Multilingue ANE | CPU + ANE | B1 / L96 | Decisões curtas, FP16 |
| Multilingue ANE W8 | CPU + ANE | B1 / L96 | Compressão de paleta aproximada opcional |
Todos os pacotes incluem tokenizer/configuração, cartão de modelo, proveniência, somas de verificação e validação no momento do empacotamento. Os pacotes ANE incluem ainda os tensores exatos de embedding/ação do anfitrião de que precisam. Não é preciso um checkout original de treino.
Fidelidade da portagem e limites
Os três checkpoints FP16 de uso geral coincidem com as respostas selecionadas do upstream em 189/189 perguntas de validação. Cada um passa 100 chamadas repetidas. O ANE FP16 L96 passa 59/59 perguntas compatíveis, com um desvio máximo de probabilidade calibrada de 0.002925; o W8 passa o mesmo subconjunto com um desvio de 0.014393 sob um gate inalterado de 0.02. As experiências de seis e quatro bits falharam esse gate e não são pesos publicados. Estes são fixtures de fidelidade de conversão, não uma prova de exatidão geral na tarefa.
Um grafo FP16 ANE L1024 exportado em separado passa o fixture completo de 63/63, mas um pedido real de 1024 tokens demora cerca de 91.7 ms no seu ecrã serial. O resultado curto do ANE não estabelece uma vantagem de contexto longo. Uma verificação pareada de Snake de 600 passos coincide em 600/600 ações, com zero mortes e zero intervenções do escudo; as três chamadas sequenciais do adaptador ANE atual não estabelecem uma aceleração consistente do jogo completo face ao MLX compilado.
A exportação Core ML SDPA normal e o grafo ANE são implementações diferentes. A exportação normal usa CPU+GPU por predefinição depois de as formas GPU RangeDim irrestritas falharem as verificações locais de fidelidade. Alterar apenas a definição do dispositivo não reproduz o resultado ANE. A reescrita ANE usa ativações BC1L, projeções 1×1 e atenção por cabeça; o seu plano e um traço Instruments separado sustentam trabalho no Neural Engine. A CPU continua a tratar das fronteiras de entrada/saída.
Documentação e reprodutibilidade
- Instalação e API Python/CLI
- Demonstração do Snake e multimédia
- Artefactos da versão e revisões fixadas do Hub
- Benchmarks gerais do Core ML
- Experiências de engenharia do ANE
- Investigação matemática do objetivo de 10×
- Problemas de conversão e formas suportadas
Para exportares tu mesmo, instala laya-coreml[convert] e executa
laya-coreml convert laya-multilingual models/custom. Os scripts de conversão,
compressão e benchmark da investigação ANE vivem no checkout Git. O wheel de
inferência contém o runtime portátil e a demonstração de terminal opcional.
Apache-2.0. Portagem independente do Laya, pela Convai Innovations e colaboradores, construída sobre o projeto irmão MLX. Não é uma versão oficial da Convai Innovations nem da Apple. Vê o NOTICE.