Version 0.2.0 synchronisiert anwendbare Prompt- und Ergebnis-Fixes aus dem Upstream
4aa6761 (Quellversion 0.3.23). Sowohl die Core ML- als auch die ANE-Laufzeit akzeptieren
benutzerdefinierte noul-Anzeigelabels ({"false": "no", "true": "yes"}), validieren
Fragen mit fragespezifischen Fehlern und erhalten Unicode-strukturierte Anweisungen. Lange
Konversationslisten behalten ihre neuesten Tokens; Strings und Objekte behalten ihren
Anfang. usage meldet Zustands-Trunkierung und, falls vorhanden, zusammengefasste Optionen.
answer_confidence ist die höchste Antwortwahrscheinlichkeit; die bestehende Semantik von
confidence bleibt unverändert. Keines der beiden Felder belegt Kalibrierungsgenauigkeit.
Die unten dokumentierte Temperaturbegrenzung des Checkpoints ist in dieser Version enthalten.
Kapazitätsgrenzen exportierter Graphen lösen weiterhin Fehler aus, statt still abzuschneiden.
Die Wartung folgt den Upstream-Laya-Fixes, die für diese Laufzeiten relevant sind. Neue Laufzeitfunktionen und backendspezifische Optimierungsvorschläge erfordern eine mit dem Upstream abgestimmte Implementierung und Validierung; das Schließen eines Issues belegt nicht, dass das gemeldete Verhalten behoben ist.
Offene Gewichte, typisierte Entscheidungen auf Apple Silicon. Core ML, Neural Engine, null generierte Tokens.
PyPI · Hugging Face-Gewichte · Chinesisch
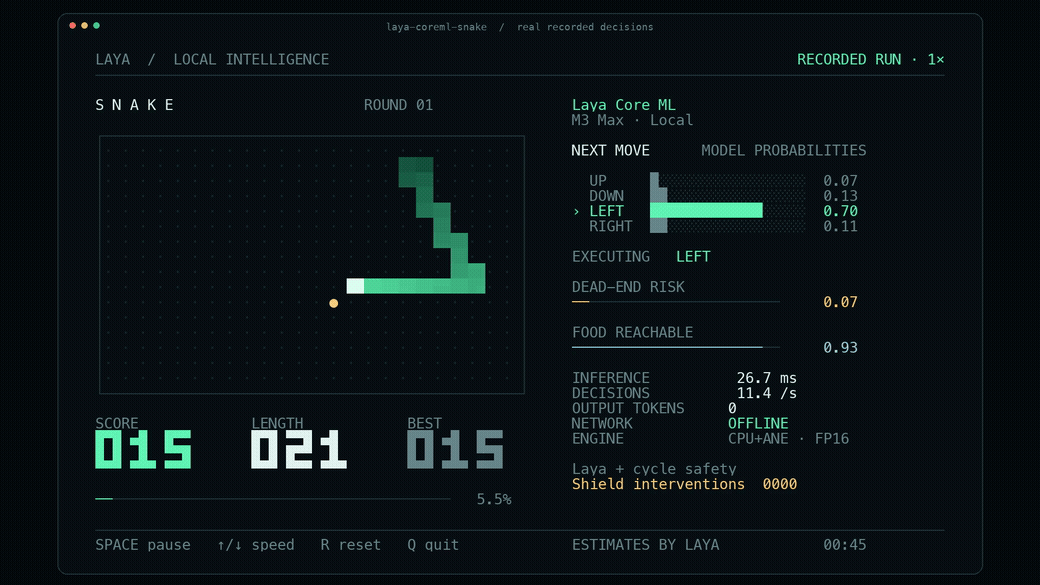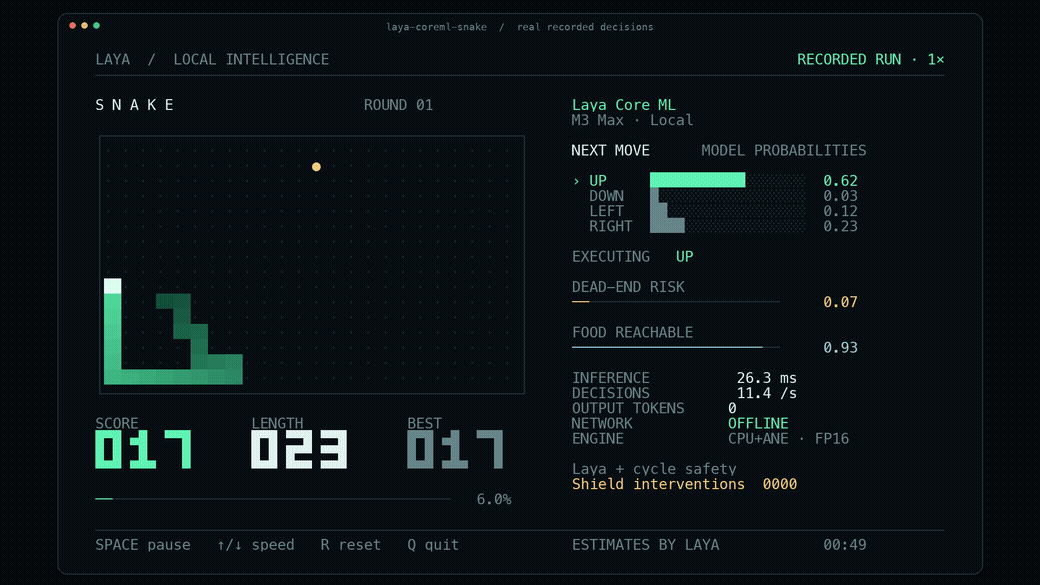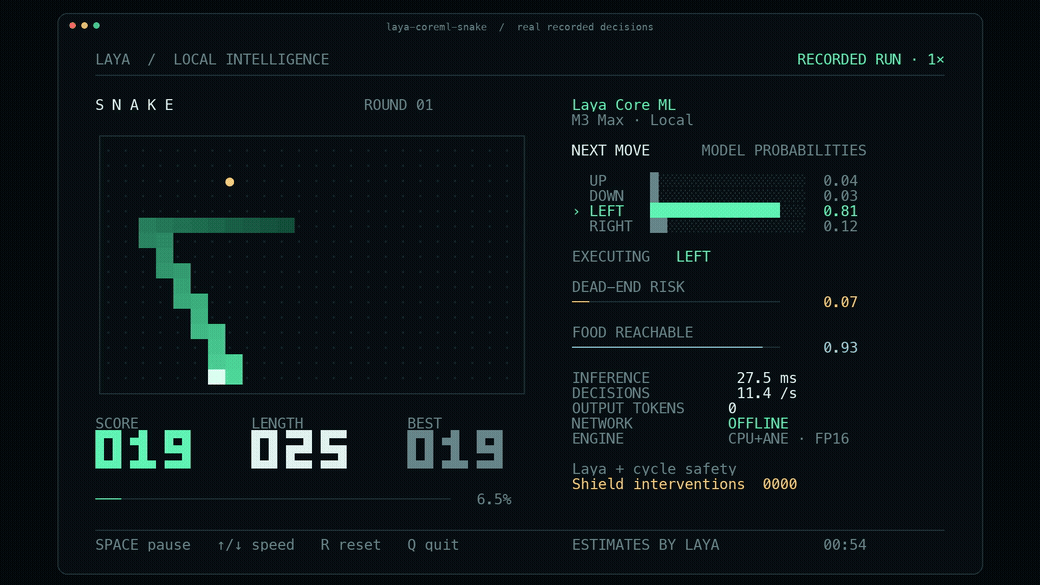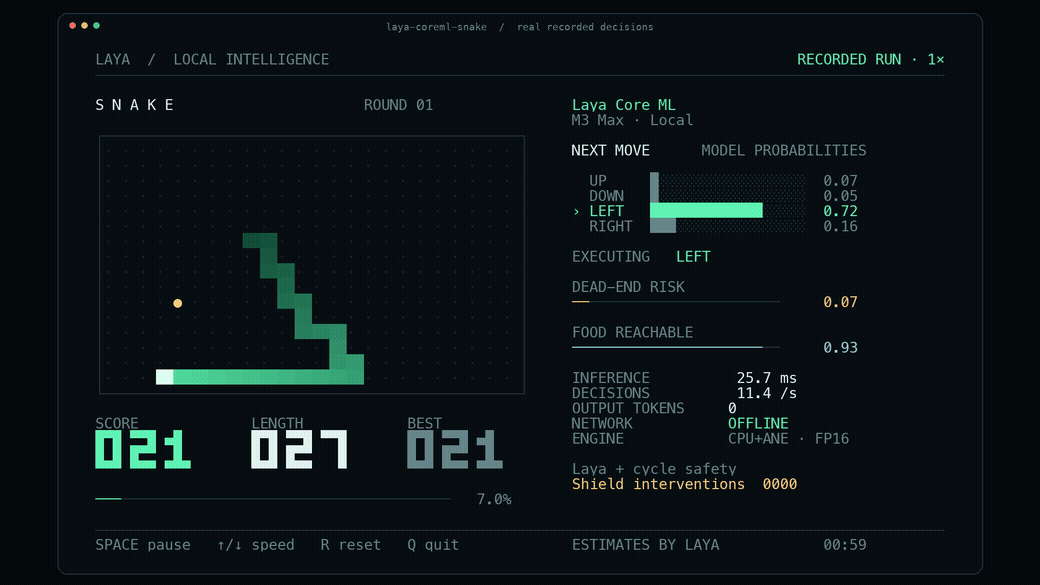
Ein echtes Laya-Modell spielt Snake lokal, mit sichtbaren Wahrscheinlichkeiten, Punktzahl, Länge, Latenz und Sicherheitseingriffen. Das GIF spielt einen aufgezeichneten Core ML-Lauf in 1× Geschwindigkeit ab. Das Spiel verwendet explizite Planner-Features und eine sichtbare Zyklus-Sicherheitsschicht.
Die vollständige aktive Snake-Schleife hielt 49.1–50.0 Entscheidungen/s über drei ungedrosselte 600-Schritt-Episoden, mit null Toden und zwei Sicherheitseingriffen. Timings der Spielschleife und Grenzen der getakteten Rate schließen die Rendering-Serialisierung ein; das Terminal-Zeichnen ist ausgeschlossen.
Eine kurze mehrsprachige Entscheidung: 4.98 ms P50 / 5.31 ms P95 auf M3 Max mit ANE FP16. Dasselbe Experiment maß 2.78× bessere Gesamtsystem-Energie pro Entscheidung als kompiliertes MLX FP16. Eine separat validierte W8-Palettenvariante erreichte 4.88 ms und 3.19× Energieverbesserung. Dies sind Ergebnisse einzelner Fragen, keine vollständigen Snake-Frame-Zeiten; die geforderte 10×-Verbesserung wurde nicht erreicht.
Demo ausführen
Apple Silicon · macOS 15+ · Python 3.11–3.13.
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
Einmal herunterladen, dann offline spielen. Für die Inferenz werden weder PyTorch, Transformers noch MLX benötigt. Das Terminal braucht 104 Spalten × 35 Zeilen. Leertaste pausiert; ↑/↓ ändert die Geschwindigkeit; R setzt zurück; Q beendet. Die erstmalige Core ML-Initialisierung kann Dutzende Sekunden dauern.
Steuerung, Aufzeichnung und Videoexport · Gemessene stabile Entscheidungsraten · Teilbares Video und Herkunft der Aufzeichnung
Eine Entscheidung anfordern
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])Laya liefert Wahrscheinlichkeiten für choice-, ordinale score- und boolesche noul-Fragen.
Es gibt kein autoregressives Decoding und kein generiertes JSON zum Parsen. Hub-Modelle werden
vor der Initialisierung heruntergeladen; nachfolgende Vorhersagen bleiben lokal. Übergib
local_files_only=True, um einen vorhandenen Cache vorauszusetzen, oder lade ein lokales Verzeichnis.
Ab Upstream v0.3.5 werden gefittete Kalibrierungstemperaturen vor der Verwendung auf
[0.5, 5.0] begrenzt: Der mitgelieferte choice:11+-Bucket beträgt 0.1006, was die Logits
um ~10x schärfen und einen Münzwurf als nahezu sicher melden würde. Die Rohwerte des
Checkpoints bleiben als agent.temperature_raw und agent.temperature_by_options_raw
verfügbar, und ein RuntimeWarning benennt beim Laden jeden begrenzten Bucket.
Das ANE-Bundle hat ein Gesamtlimit von 96 Tokens, einschließlich Frage, Optionen und
Zustand. Längere Anfragen lösen einen Kapazitätsfehler aus. Verwende
aac6fef/laya-multilingual-coreml für das Allzweckmodell mit 1024 Tokens.
Vollständige API, Modellauswahl und Offline-Nutzung.
Gemessen auf M3 Max
40-Kern-GPU, 128 GiB, macOS 27.2. Eine 91-Token-Frage auf 96 aufgefüllt, einschließlich Prompt-Vorbereitung, Tokenisierung, Arrays, synchroner Inferenz, Kalibrierung und Formatierung. Laden und Aufwärmen sind ausgeschlossen. MLX aktiviert Compile, Prefix-Caching und Shape-Buckets. Sechs abwechselnde 20-Sekunden-Blöcke pro Implementierung ergaben 65,598 stabile Aufrufe.
| Metrik | Kompiliertes MLX FP16 | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| Mittlere Systemleistungsschätzung | 61.39 W | 30.75 W | 27.39 W |
| Systemenergie / Entscheidung | 0.4288 J | 0.1540 J | 0.1344 J |
| Geschwindigkeitsgewinn | 1× | 1.39× | 1.42× |
| Systemenergiegewinn | 1× | 2.78× | 3.19× |
Die Energie basiert auf direkten SMC-PSTR-Sensorwerten, mit Rohproben und expliziter Anomalieabweisung. Das ist eine Schätzung mit Unsicherheit durch Sensor und Hintergrundlast. Geschwindigkeitsgewinn × mittleres Leistungsverhältnis = Energiegewinn; würde man Energie erneut mit der Geschwindigkeit multiplizieren, zählte man die Zeit doppelt. Die W8-Variante komprimiert Gewichte und behält dabei FP16-Berechnung bei. Sie ist approximativ, und ihre Paketgrößenreduktion ist kein Geschwindigkeitsverhältnis.
Belege zu Geschwindigkeit, Energie und Hardware · Rohmessungen.
Verfügbare Checkpoints
| Hugging-Face-Bundle | Standard-Engine | Kapazität | Zweck |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 Tokens | Ursprüngliches englisches Modell |
| Multilingual 322M | CPU + GPU | 1024 Tokens | Allgemeine mehrsprachige Entscheidungen |
| Typed Decisions 421M | CPU + GPU | 1024 Tokens | Ursprünglicher spezialisierter Checkpoint |
| Snake GPU | CPU + GPU | B3 / L64 | Bündelt die drei kompakten Spielfragen |
| Multilingual ANE | CPU + ANE | B1 / L96 | Kurze Entscheidungen, FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | Optionale approximative Palettenkompression |
Jedes Bundle enthält Tokenizer/Konfiguration, Modellkarte, Herkunft, Prüfsummen und eine Validierung zur Paketierungszeit. ANE-Bundles enthalten außerdem die exakt benötigten ursprünglichen Host-Embedding-/Action-Tensoren. Ein ursprünglicher Trainings-Checkout ist nicht erforderlich.
Port-Treue und Grenzen
Die drei Allzweck-FP16-Checkpoints stimmen bei 189/189 Validierungsfragen mit den ausgewählten Antworten des Upstreams überein. Jeder besteht 100 wiederholte Aufrufe. ANE FP16 L96 besteht 59/59 passende Fragen, mit einer maximalen Abweichung der kalibrierten Wahrscheinlichkeit von 0.002925; W8 besteht dieselbe Teilmenge mit Abweichung 0.014393 unter einem unveränderten 0.02-Gate. Experimente mit sechs und vier Bit scheiterten an diesem Gate und sind keine veröffentlichten Gewichte. Das sind Konvertierungstreue-Fixtures, kein Beweis allgemeiner Aufgaben-Genauigkeit.
Ein separat exportierter FP16-ANE-L1024-Graph besteht das vollständige 63/63-Fixture, aber eine tatsächliche 1024-Token-Anfrage dauert in seinem seriellen Screen etwa 91.7 ms. Das kurze ANE-Ergebnis belegt keinen Langkontext-Vorteil. Ein gepaarter Snake-Test über 600 Schritte stimmt bei 600/600 Aktionen überein, mit null Toden und null Schild-Eingriffen; die drei sequenziellen Aufrufe des aktuellen ANE-Adapters belegen keine konsistente Beschleunigung des ganzen Spiels gegenüber kompiliertem MLX.
Der gewöhnliche SDPA-Core-ML-Export und der ANE-Graph sind unterschiedliche Implementierungen. Der gewöhnliche Export verwendet standardmäßig CPU+GPU, nachdem uneingeschränkte RangeDim-GPU-Shapes lokale Treueprüfungen nicht bestanden. Allein das Ändern seiner Geräteeinstellung reproduziert das ANE-Ergebnis nicht. Die ANE-Neuschreibung verwendet BC1L-Aktivierungen, 1×1-Projektionen und Per-Head-Attention; ihr Plan und ein separater Instruments-Trace stützen die Arbeit der Neural Engine. Die CPU übernimmt weiterhin die Ein-/Ausgabe-Grenzen.
Dokumentation und Reproduzierbarkeit
- Installation und Python/CLI-API
- Snake-Demo und Medien
- Release-Artefakte und fixierte Hub-Revisionen
- Allgemeine Core ML-Benchmarks
- ANE-Engineering-Experimente
- Mathematische Untersuchung des 10×-Ziels
- Konvertierungsprobleme und unterstützte Shapes
Um selbst zu exportieren, installiere laya-coreml[convert] und führe
laya-coreml convert laya-multilingual models/custom aus. Die Skripte für ANE-Forschungskonvertierung,
Kompression und Benchmarks liegen im Git-Checkout. Das Inferenz-Wheel enthält die portable
Laufzeit und die optionale Terminal-Demo.
Apache-2.0. Unabhängiger Port von Laya, von Convai Innovations und Mitwirkenden, aufbauend auf dem MLX-Schwesterprojekt. Kein offizielles Release von Convai Innovations oder Apple. Siehe NOTICE.