La versión 0.2.0 sincroniza las correcciones aplicables de prompt y de resultado a
través del upstream 4aa6761 (versión del origen 0.3.23). Tanto el runtime de Core ML
como el de ANE aceptan etiquetas de visualización personalizadas para noul
({"false": "no", "true": "yes"}), validan las preguntas con errores específicos de
cada pregunta y conservan las instrucciones estructuradas en Unicode. Las listas de
conversación largas conservan sus tokens más recientes; las cadenas y los objetos
conservan su comienzo. usage informa del truncamiento del estado y, cuando están
presentes, de las opciones colapsadas. answer_confidence es la probabilidad de
respuesta más alta; la semántica existente de confidence no cambia. Ninguno de los
dos campos establece la precisión de calibración. El límite (clamp) de temperatura del
checkpoint que se documenta más abajo se incluye en esta versión. Los límites de
capacidad de los grafos exportados siguen generando errores en lugar de recortar en
silencio.
El mantenimiento sigue las correcciones de Laya del upstream que son aplicables a estos runtimes. Las nuevas funciones del runtime y las propuestas de optimización específicas de cada backend requieren una implementación y una validación alineadas con el upstream; cerrar una incidencia no demuestra que el comportamiento reportado esté corregido.
Decisiones tipadas con pesos abiertos en Apple Silicon. Core ML, Neural Engine, cero tokens generados.
PyPI · Hugging Face weights · 中文
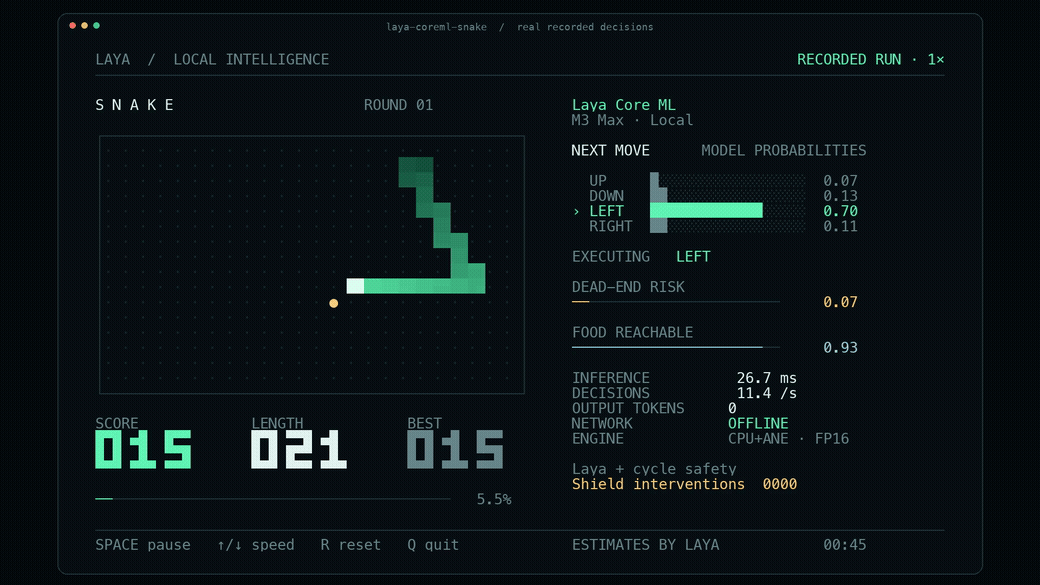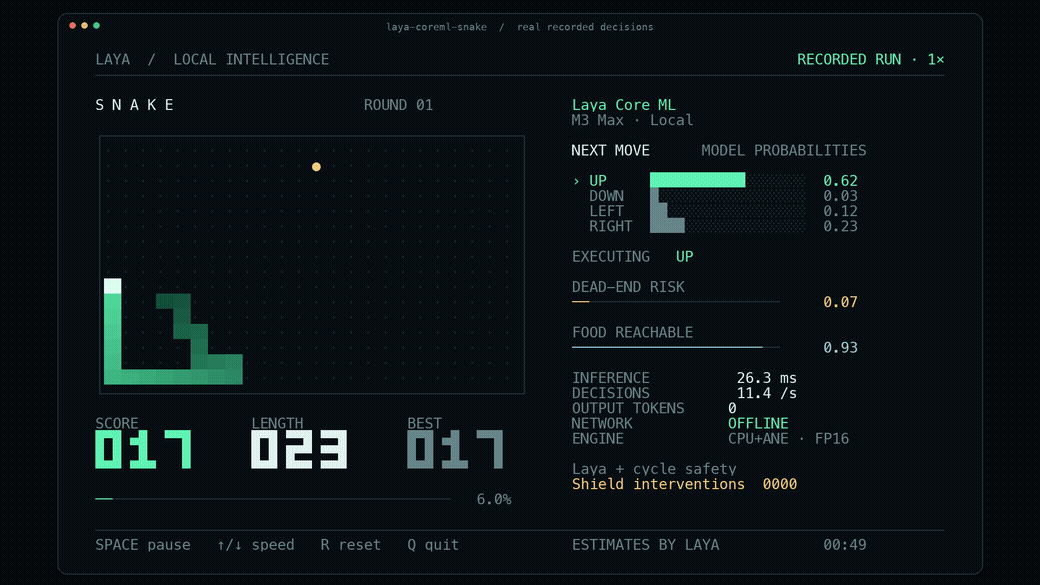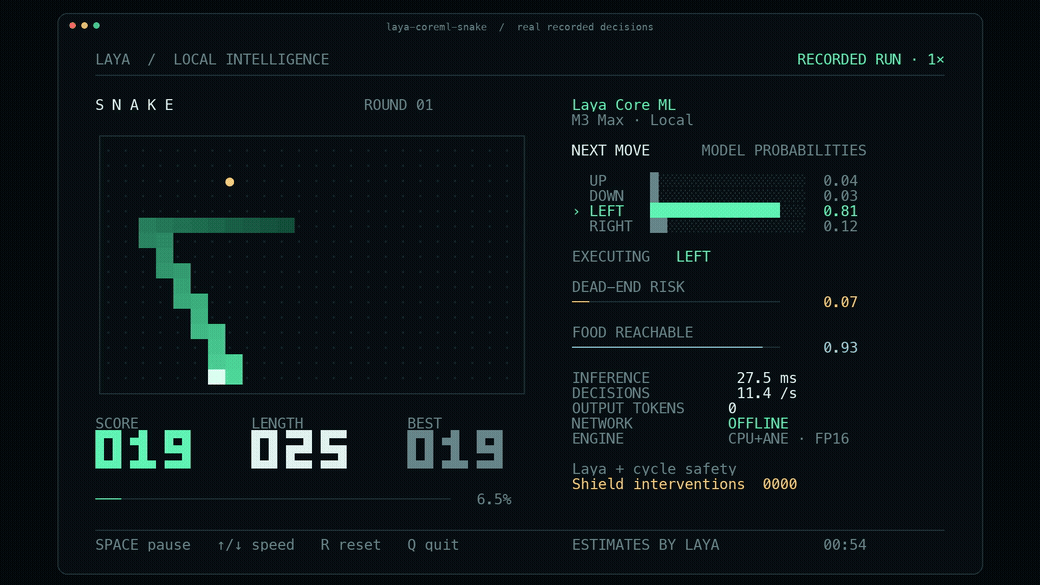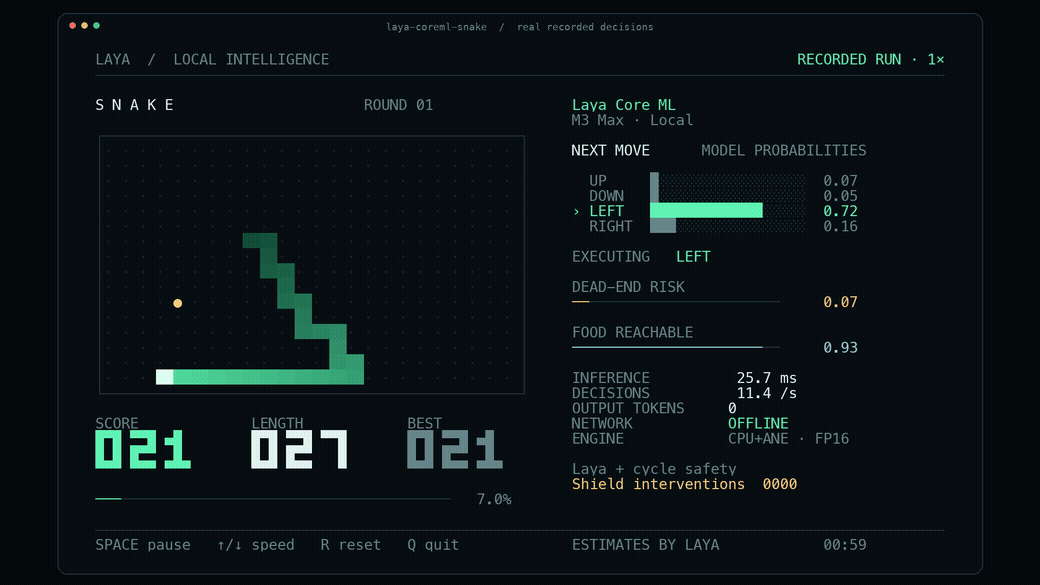
Un modelo Laya real juega a Snake en local, con probabilidades, puntuación, longitud, latencia e intervenciones de seguridad visibles. El GIF reproduce a velocidad 1× una ejecución de Core ML grabada. El juego usa características explícitas del planificador y una capa de seguridad de ciclo visible.
El bucle activo completo de Snake sostuvo 49.1–50.0 decisiones/s en tres episodios de 600 pasos sin límite, con cero muertes y dos intervenciones de seguridad. Los tiempos del bucle de juego y los límites de ritmo pautado incluyen la serialización del renderizado; el pintado del terminal queda excluido.
Una decisión multilingüe corta: 4.98 ms P50 / 5.31 ms P95 en un M3 Max con ANE FP16. El mismo experimento midió una energía por decisión de todo el sistema 2.78× mejor que MLX FP16 compilado. Una variante de paleta W8 validada por separado alcanzó 4.88 ms y una mejora de energía de 3.19×. Son resultados de una sola pregunta, no tiempos de fotograma completos de Snake; la mejora de 10× solicitada no se logró.
Ejecutar la demo
Apple Silicon · macOS 15+ · Python 3.11–3.13.
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
Descarga una vez y luego juega sin conexión. Para la inferencia no se necesita PyTorch, Transformers ni MLX. El terminal necesita 104 columnas × 35 filas. La barra espaciadora pausa; ↑/↓ cambia la velocidad; R reinicia; Q sale. La primera inicialización de Core ML puede tardar decenas de segundos.
Controles, grabación y exportación de vídeo · Ritmos de decisión estables medidos · Vídeo compartible y procedencia de la grabación
Pedir una decisión
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])Laya devuelve probabilidades para preguntas choice, score ordinales y noul
booleanas. No hay decodificación autorregresiva ni JSON generado que analizar. Los modelos
del Hub se descargan antes de la inicialización; las predicciones posteriores se quedan en
local. Pasa local_files_only=True para exigir una caché existente, o carga un directorio
local.
Siguiendo el upstream v0.3.5, las temperaturas de calibración ajustadas se limitan (clamp)
a [0.5, 5.0] antes de usarse: el bucket choice:11+ que se distribuye es 0.1006, lo que
agudizaría los logits ~10x y reportaría un lanzamiento de moneda como casi certeza. Los
valores sin procesar del checkpoint siguen disponibles como agent.temperature_raw y
agent.temperature_by_options_raw, y un RuntimeWarning nombra cada bucket limitado al
cargar.
El paquete ANE tiene un límite total de 96 tokens, incluidos pregunta, opciones y
estado. Las solicitudes más largas generan un error de capacidad. Usa
aac6fef/laya-multilingual-coreml para el modelo de propósito general de 1024 tokens.
API completa, selección de modelo y uso sin conexión.
Medido en un M3 Max
GPU de 40 núcleos, 128 GiB, macOS 27.2. Una pregunta de 91 tokens rellenada a 96, incluida la preparación del prompt, la tokenización, los arrays, la inferencia síncrona, la calibración y el formateo. La carga y el calentamiento quedan excluidos. MLX habilita compile, la caché de prefijo y los buckets de forma. Seis bloques alternos de 20 segundos por implementación produjeron 65,598 llamadas estables.
| Métrica | MLX FP16 compilado | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| Estimación de potencia media del sistema | 61.39 W | 30.75 W | 27.39 W |
| Energía del sistema / decisión | 0.4288 J | 0.1540 J | 0.1344 J |
| Ganancia de velocidad | 1× | 1.39× | 1.42× |
| Ganancia de energía del sistema | 1× | 2.78× | 3.19× |
La energía usa lecturas directas del sensor SMC PSTR, con muestras sin procesar y rechazo explícito de anomalías. Es una estimación con incertidumbre de sensor y de carga de fondo. Ganancia de velocidad × relación de potencia media = ganancia de energía; multiplicar otra vez la energía por la velocidad contaría el tiempo dos veces. La variante W8 comprime los pesos y mantiene el cómputo en FP16. Es aproximada, y su reducción de tamaño del paquete no es una relación de velocidad.
Evidencia de velocidad, energía y hardware · Mediciones sin procesar.
Checkpoints disponibles
| Paquete de Hugging Face | Motor por defecto | Capacidad | Propósito |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 tokens | Modelo original en inglés |
| Multilingüe 322M | CPU + GPU | 1024 tokens | Decisiones multilingües de propósito general |
| Typed Decisions 421M | CPU + GPU | 1024 tokens | Checkpoint especializado original |
| Snake GPU | CPU + GPU | B3 / L64 | Procesa por lotes las tres preguntas compactas del juego |
| Multilingüe ANE | CPU + ANE | B1 / L96 | Decisiones cortas, FP16 |
| Multilingüe ANE W8 | CPU + ANE | B1 / L96 | Compresión de paleta aproximada opcional |
Todos los paquetes incluyen tokenizer/configuración, model card, procedencia, sumas de verificación y validación en el momento del empaquetado. Los paquetes ANE también incluyen los tensores originales exactos de embedding/acción del host que necesitan. No se requiere un checkout de entrenamiento original.
Fidelidad del port y límites
Los tres checkpoints FP16 de propósito general coinciden con las respuestas seleccionadas del upstream en 189/189 preguntas de validación. Cada uno supera 100 llamadas repetidas. ANE FP16 L96 supera 59/59 preguntas que caben, con una deriva máxima de probabilidad calibrada de 0.002925; W8 supera el mismo subconjunto con deriva 0.014393 bajo un umbral sin cambios de 0.02. Los experimentos de seis y cuatro bits no superaron ese umbral y no son pesos publicados. Son fixtures de fidelidad de conversión, no prueba de precisión general en tareas.
Un grafo FP16 ANE L1024 exportado por separado supera el fixture completo de 63/63, pero una solicitud real de 1024 tokens tarda unos 91.7 ms en su cribado en serie. El resultado corto de ANE no demuestra una ventaja en contexto largo. Una comprobación emparejada de Snake de 600 pasos coincide en 600/600 acciones, con cero muertes y cero intervenciones del escudo; las tres llamadas secuenciales del adaptador ANE actual no demuestran una aceleración constante del juego completo frente a MLX compilado.
La exportación ordinaria de Core ML con SDPA y el grafo ANE son implementaciones distintas. La exportación ordinaria usa CPU+GPU por defecto después de que las formas GPU RangeDim sin restricción fallaran las comprobaciones de fidelidad locales. Cambiar solo su ajuste de dispositivo no reproduce el resultado de ANE. La reescritura ANE usa activaciones BC1L, proyecciones 1×1 y atención por cabeza; su plan y una traza de Instruments aparte respaldan el trabajo en Neural Engine. La CPU sigue encargándose de los límites de entrada/salida.
Documentación y reproducibilidad
- Instalación y API de Python/CLI
- Demo de Snake y contenido multimedia
- Artefactos de la versión y revisiones fijadas del Hub
- Benchmarks generales de Core ML
- Experimentos de ingeniería de ANE
- Investigación matemática del objetivo de 10×
- Problemas de conversión y formas admitidas
Para exportar tú mismo, instala laya-coreml[convert] y ejecuta
laya-coreml convert laya-multilingual models/custom. Los scripts de conversión,
compresión y benchmark de la investigación ANE están en el checkout de Git. La wheel de
inferencia contiene el runtime portátil y la demo opcional de terminal.
Apache-2.0. Port independiente de Laya, de Convai Innovations y colaboradores, basado en el proyecto hermano MLX. No es una versión oficial de Convai Innovations ni de Apple. Consulta NOTICE.