0.2.0 版把適用的 prompt 與結果修復同步到了上游 4aa6761(源版本 0.3.23)。Core ML 與 ANE 兩種執行時現在都接受自定義 noul 顯示標籤({"false": "no", "true": "yes"}),用針對具體問題型別的錯誤來校驗問題,並保留 Unicode 結構化指令。較長的對話列表保留最新的 token;字串和物件則保留開頭部分。usage 會報告狀態截斷,以及存在時的選項摺疊。answer_confidence 是最高答案機率;既有的 confidence 語義保持不變。這兩個欄位都不代表校準準確率。下文記錄的 checkpoint 溫度鉗制也包含在此版本中。匯出的圖容量限制仍會報錯,而不是靜默裁剪。
維護工作跟隨上游 Laya 中適用於這些執行時的修復。新的執行時特性以及特定後端的最佳化提議,都需要有與上游一致的實現與驗證;關閉一個 issue 並不代表它所報告的行為已經修復。
在 Apple Silicon 上做開放權重的型別化決策。Core ML、Neural Engine、零生成 token。
PyPI · Hugging Face 權重 · 中文
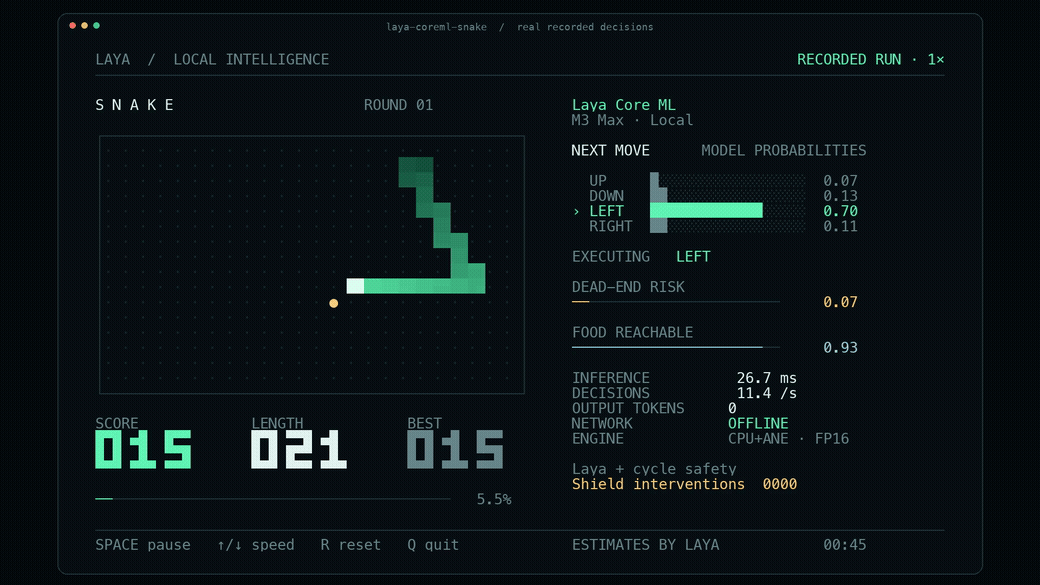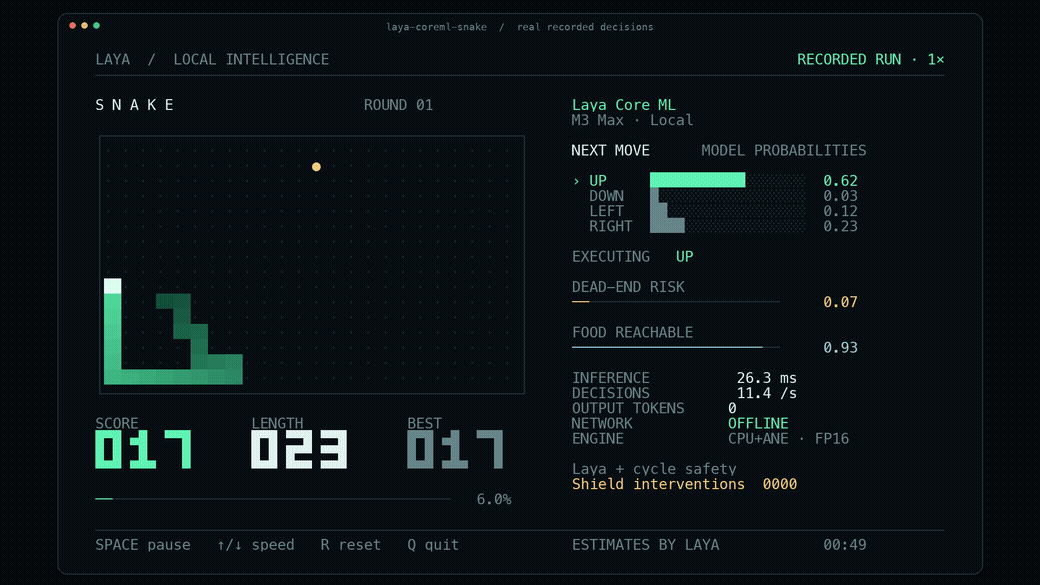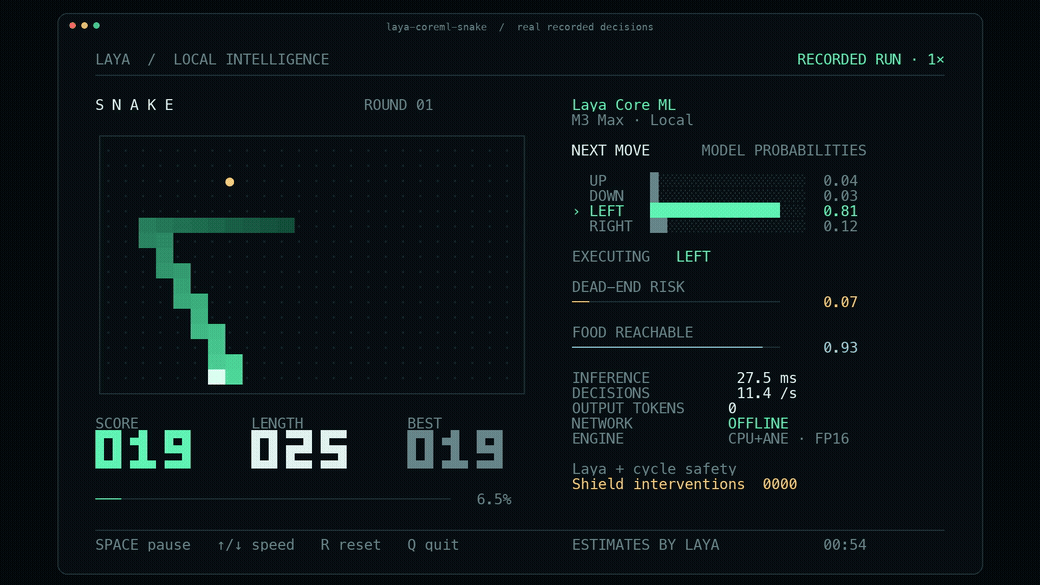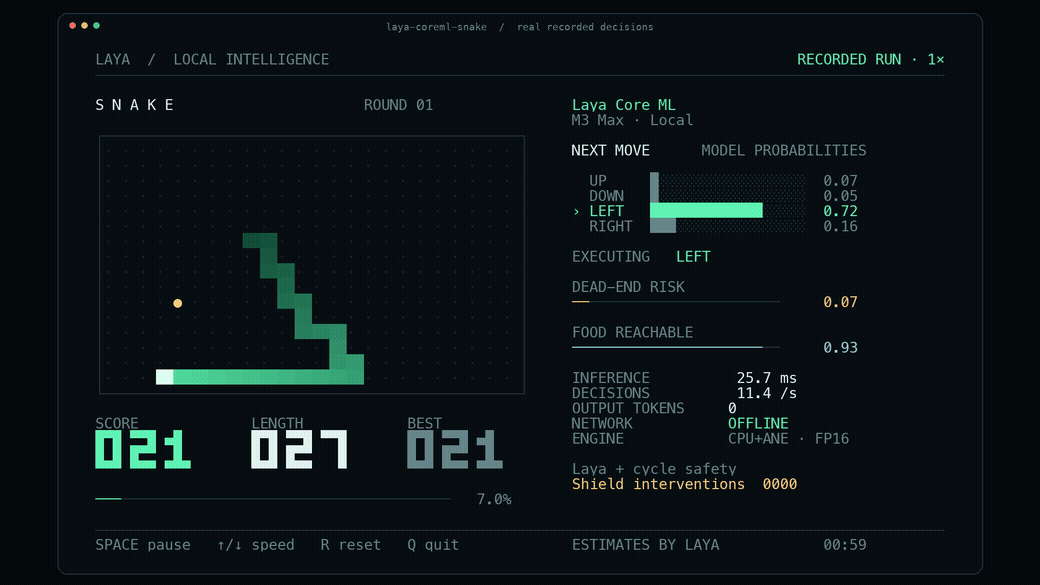
一個真實的 Laya 模型在本地玩 Snake,機率、分數、長度、延遲和安全乾預都可見。GIF 以 1× 速度回放一段錄製的 Core ML 執行。遊戲使用顯式的規劃器特徵和一個可見的迴圈安全層。
完整的 Snake 活動迴圈在三個不設上限的 600 步回合中持續達到 49.1–50.0 次決策/秒,零死亡、兩次安全乾預。遊戲迴圈的計時與限速上限 包含渲染序列化;終端繪製不計入。
一次簡短的多語言決策:在 M3 Max 上使用 ANE FP16 時為 P50 4.98 ms / P95 5.31 ms。 同一實驗測得每個決策的整機能耗比編譯後的 MLX FP16 好 2.78×。一個單獨驗證過的 W8 調色盤變體達到 4.88 ms 和 3.19× 能耗改善。這些都是單問題結果,不是完整的 Snake 幀時間;所要求的 10× 提升並未達到。
執行演示
Apple Silicon · macOS 15+ · Python 3.11–3.13。
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
下載一次,之後即可離線遊玩。推理不需要 PyTorch、Transformers 或 MLX。終端需要 104 列 × 35 行。空格暫停;↑/↓ 調速;R 重置;Q 退出。首次 Core ML 初始化可能需要幾十秒。
控制、錄製與影片匯出 · 實測的穩定決策速率 · 可分享的影片與錄製來源
請求一次決策
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])Laya 會為 choice、有序的 score 和布林的 noul 問題返回機率。沒有自迴歸解碼,也沒有需要解析的生成 JSON。Hub 模型會在初始化前下載;之後的預測都留在本地。傳入 local_files_only=True 可要求使用已有的快取,或載入一個本地目錄。
跟隨上游 v0.3.5,擬合出的校準溫度在使用前會被鉗制到 [0.5, 5.0]:隨包提供的 choice:11+ 桶是 0.1006,這會把 logits 銳化約 10 倍,把一次拋硬幣說成近乎確定。checkpoint 的原始值仍可通過 agent.temperature_raw 和 agent.temperature_by_options_raw 獲取,載入時 RuntimeWarning 會逐一指出被鉗制的桶。
ANE 包有一個 96 token 的總上限,包含問題、選項和狀態。更長的請求會觸發容量錯誤。通用型 1024-token 模型請使用 aac6fef/laya-multilingual-coreml。完整 API、模型選擇與離線用法。
在 M3 Max 上的實測
40 核 GPU、128 GiB、macOS 27.2。一個 91 token 的問題補齊到 96,計時包含 prompt 準備、分詞、陣列構建、同步推理、校準和格式化。載入與預熱不計入。MLX 啟用了 compile、字首快取和形狀分桶。每種實現各跑六個交替的 20 秒區塊,共產生 65,598 次穩定呼叫。
| 指標 | 編譯後的 MLX FP16 | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| 平均系統功耗估計 | 61.39 W | 30.75 W | 27.39 W |
| 每決策系統能耗 | 0.4288 J | 0.1540 J | 0.1344 J |
| 速度提升 | 1× | 1.39× | 1.42× |
| 系統能耗提升 | 1× | 2.78× | 3.19× |
能耗使用直接的 SMC PSTR 感測器讀數,保留原始取樣並顯式剔除異常。這是一個帶感測器和後臺負載不確定性的估計。速度提升 × 平均功耗比 = 能耗提升;再把能耗乘以速度就是重複計算時間。W8 變體在保留 FP16 計算的同時壓縮權重。它是近似的,其包體積縮小並不等於速度比。
速度、能耗與硬體證據 · 原始測量資料。
可用的 checkpoint
| Hugging Face 包 | 預設引擎 | 容量 | 用途 |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 token | 原始英文模型 |
| Multilingual 322M | CPU + GPU | 1024 token | 通用多語言決策 |
| Typed Decisions 421M | CPU + GPU | 1024 token | 原始專用 checkpoint |
| Snake GPU | CPU + GPU | B3 / L64 | 批處理三個緊湊的遊戲問題 |
| Multilingual ANE | CPU + ANE | B1 / L96 | 簡短決策,FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | 可選的近似調色盤壓縮 |
每個包都包含 tokenizer/配置、模型卡、來源資訊、校驗和以及打包時的驗證。ANE 包還包含它們所需的、與原始完全一致的主機端 embedding/action 張量。不需要原始的 training checkout。
移植保真度與限制
三個通用型 FP16 checkpoint 在 189/189 個驗證問題上與上游的選定答案一致。每個都通過了 100 次重複呼叫。ANE FP16 L96 通過 59/59 個適配問題,最大校準機率漂移為 0.002925;W8 在不變的 0.02 門檻下以 0.014393 的漂移通過同一子集。六位和四位實驗未通過該門檻,因此不作為權重發布。這些是轉換保真度夾具,不能證明通用任務準確率。
另一個單獨匯出的 FP16 ANE L1024 圖通過了完整的 63/63 夾具,但在其序列篩選中,一次真正的 1024-token 請求約需 91.7 ms。短輸入的 ANE 結果並不能證明長上下文有優勢。一次 600 步的配對 Snake 檢查中 600/600 個動作一致,零死亡、零護盾干預;當前 ANE adapter 的三次順序呼叫並不能證明相對編譯後 MLX 有穩定的整局加速。
普通的 SDPA Core ML 匯出與 ANE 圖是兩種不同的實現。在不受限的 RangeDim GPU 形狀未通過本地保真度檢查之後,普通匯出預設使用 CPU+GPU。只改它的裝置設定並不能復現 ANE 的結果。ANE 重寫使用 BC1L 啟用、1×1 投影和逐頭注意力;它的計算計劃以及一份單獨的 Instruments trace 都支援 Neural Engine 在工作。CPU 仍負責輸入/輸出邊界。
文件與可復現性
要自行匯出,請安裝 laya-coreml[convert] 並執行 laya-coreml convert laya-multilingual models/custom。ANE 研究用的轉換、壓縮與基準指令碼都在 Git checkout 裡。推理 wheel 包含可移植的執行時和可選的終端演示。
Apache-2.0。由 Convai Innovations 及貢獻者獨立移植的 Laya,構建在 MLX 姊妹專案 之上。不是 Convai Innovations 或 Apple 的官方釋出。見 NOTICE。