0.2.0 版把适用的 prompt 与结果修复同步到了上游 4aa6761(源版本 0.3.23)。Core ML 与 ANE 两种运行时现在都接受自定义 noul 显示标签({"false": "no", "true": "yes"}),用针对具体问题类型的错误来校验问题,并保留 Unicode 结构化指令。较长的对话列表保留最新的 token;字符串和对象则保留开头部分。usage 会报告状态截断,以及存在时的选项折叠。answer_confidence 是最高答案概率;既有的 confidence 语义保持不变。这两个字段都不代表校准准确率。下文记录的 checkpoint 温度钳制也包含在此版本中。导出的图容量限制仍会报错,而不是静默裁剪。
维护工作跟随上游 Laya 中适用于这些运行时的修复。新的运行时特性以及特定后端的优化提议,都需要有与上游一致的实现与验证;关闭一个 issue 并不代表它所报告的行为已经修复。
在 Apple Silicon 上做开放权重的类型化决策。Core ML、Neural Engine、零生成 token。
PyPI · Hugging Face 权重 · 中文
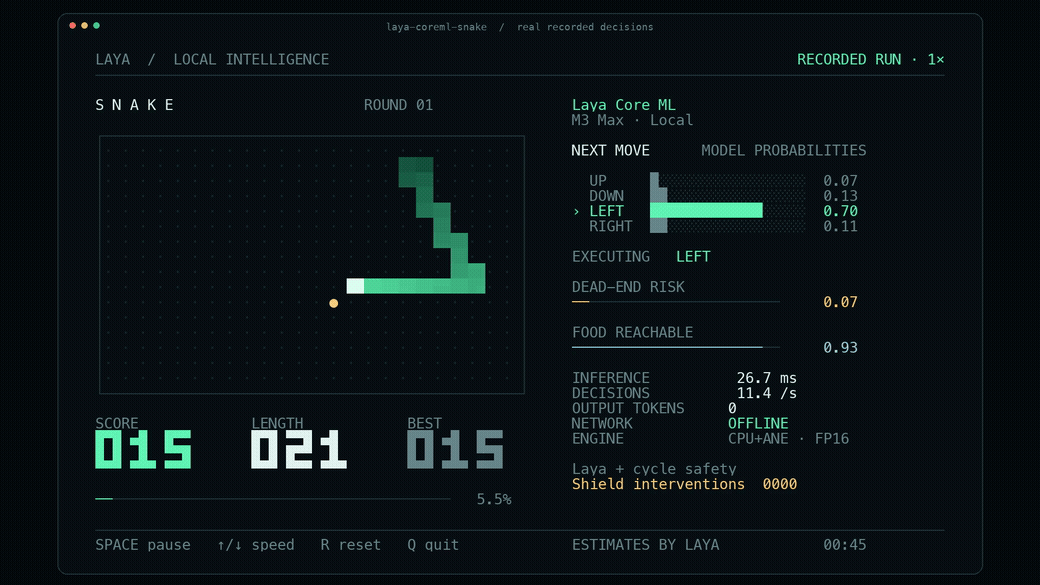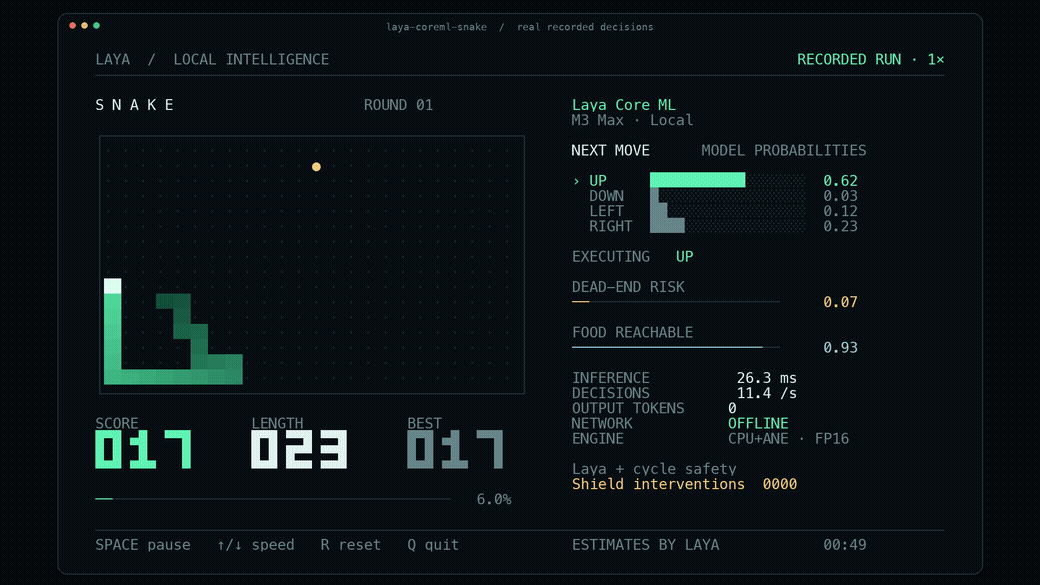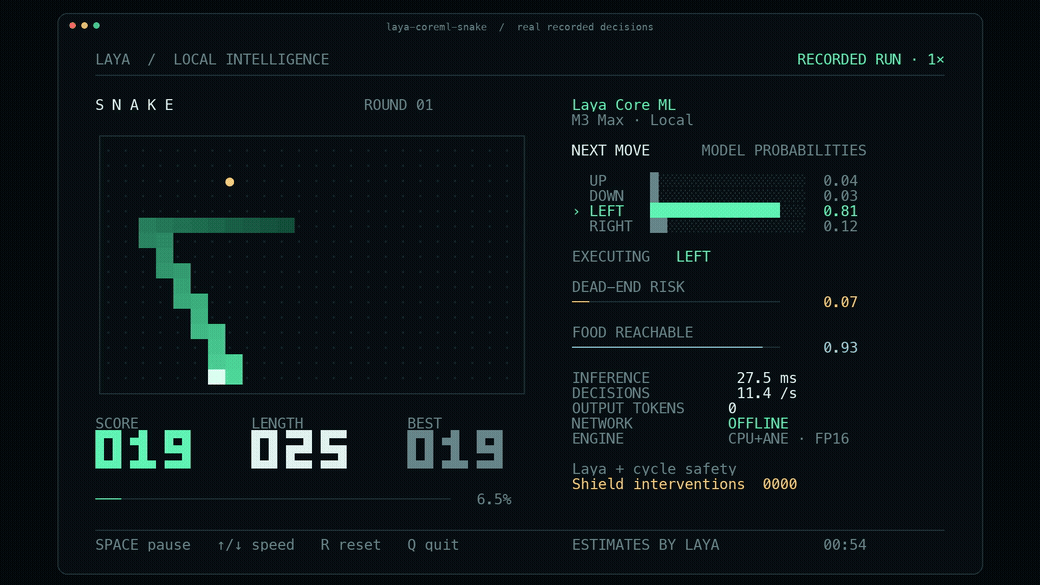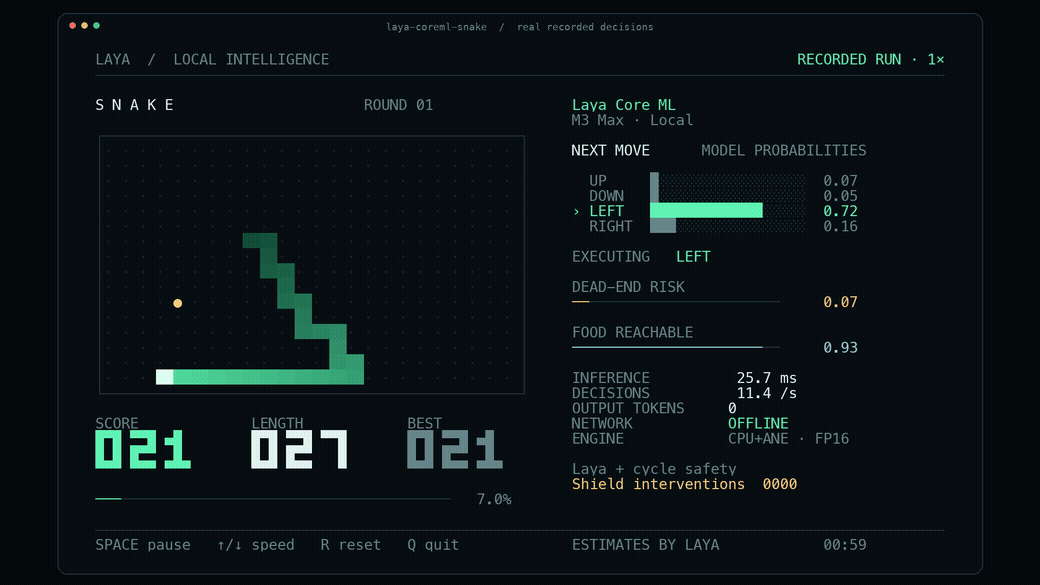
一个真实的 Laya 模型在本地玩 Snake,概率、分数、长度、延迟和安全干预都可见。GIF 以 1× 速度回放一段录制的 Core ML 运行。游戏使用显式的规划器特征和一个可见的循环安全层。
完整的 Snake 活动循环在三个不设上限的 600 步回合中持续达到 49.1–50.0 次决策/秒,零死亡、两次安全干预。游戏循环的计时与限速上限 包含渲染序列化;终端绘制不计入。
一次简短的多语言决策:在 M3 Max 上使用 ANE FP16 时为 P50 4.98 ms / P95 5.31 ms。 同一实验测得每个决策的整机能耗比编译后的 MLX FP16 好 2.78×。一个单独验证过的 W8 调色板变体达到 4.88 ms 和 3.19× 能耗改善。这些都是单问题结果,不是完整的 Snake 帧时间;所要求的 10× 提升并未达到。
运行演示
Apple Silicon · macOS 15+ · Python 3.11–3.13。
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
下载一次,之后即可离线游玩。推理不需要 PyTorch、Transformers 或 MLX。终端需要 104 列 × 35 行。空格暂停;↑/↓ 调速;R 重置;Q 退出。首次 Core ML 初始化可能需要几十秒。
控制、录制与视频导出 · 实测的稳定决策速率 · 可分享的视频与录制来源
请求一次决策
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])Laya 会为 choice、有序的 score 和布尔的 noul 问题返回概率。没有自回归解码,也没有需要解析的生成 JSON。Hub 模型会在初始化前下载;之后的预测都留在本地。传入 local_files_only=True 可要求使用已有的缓存,或加载一个本地目录。
跟随上游 v0.3.5,拟合出的校准温度在使用前会被钳制到 [0.5, 5.0]:随包提供的 choice:11+ 桶是 0.1006,这会把 logits 锐化约 10 倍,把一次抛硬币说成近乎确定。checkpoint 的原始值仍可通过 agent.temperature_raw 和 agent.temperature_by_options_raw 获取,加载时 RuntimeWarning 会逐一指出被钳制的桶。
ANE 包有一个 96 token 的总上限,包含问题、选项和状态。更长的请求会触发容量错误。通用型 1024-token 模型请使用 aac6fef/laya-multilingual-coreml。完整 API、模型选择与离线用法。
在 M3 Max 上的实测
40 核 GPU、128 GiB、macOS 27.2。一个 91 token 的问题补齐到 96,计时包含 prompt 准备、分词、数组构建、同步推理、校准和格式化。加载与预热不计入。MLX 启用了 compile、前缀缓存和形状分桶。每种实现各跑六个交替的 20 秒区块,共产生 65,598 次稳定调用。
| 指标 | 编译后的 MLX FP16 | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| 平均系统功耗估计 | 61.39 W | 30.75 W | 27.39 W |
| 每决策系统能耗 | 0.4288 J | 0.1540 J | 0.1344 J |
| 速度提升 | 1× | 1.39× | 1.42× |
| 系统能耗提升 | 1× | 2.78× | 3.19× |
能耗使用直接的 SMC PSTR 传感器读数,保留原始采样并显式剔除异常。这是一个带传感器和后台负载不确定性的估计。速度提升 × 平均功耗比 = 能耗提升;再把能耗乘以速度就是重复计算时间。W8 变体在保留 FP16 计算的同时压缩权重。它是近似的,其包体积缩小并不等于速度比。
速度、能耗与硬件证据 · 原始测量数据。
可用的 checkpoint
| Hugging Face 包 | 默认引擎 | 容量 | 用途 |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 token | 原始英文模型 |
| Multilingual 322M | CPU + GPU | 1024 token | 通用多语言决策 |
| Typed Decisions 421M | CPU + GPU | 1024 token | 原始专用 checkpoint |
| Snake GPU | CPU + GPU | B3 / L64 | 批处理三个紧凑的游戏问题 |
| Multilingual ANE | CPU + ANE | B1 / L96 | 简短决策,FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | 可选的近似调色板压缩 |
每个包都包含 tokenizer/配置、模型卡、来源信息、校验和以及打包时的验证。ANE 包还包含它们所需的、与原始完全一致的主机端 embedding/action 张量。不需要原始的 training checkout。
移植保真度与限制
三个通用型 FP16 checkpoint 在 189/189 个验证问题上与上游的选定答案一致。每个都通过了 100 次重复调用。ANE FP16 L96 通过 59/59 个适配问题,最大校准概率漂移为 0.002925;W8 在不变的 0.02 门槛下以 0.014393 的漂移通过同一子集。六位和四位实验未通过该门槛,因此不作为权重发布。这些是转换保真度夹具,不能证明通用任务准确率。
另一个单独导出的 FP16 ANE L1024 图通过了完整的 63/63 夹具,但在其串行筛选中,一次真正的 1024-token 请求约需 91.7 ms。短输入的 ANE 结果并不能证明长上下文有优势。一次 600 步的配对 Snake 检查中 600/600 个动作一致,零死亡、零护盾干预;当前 ANE adapter 的三次顺序调用并不能证明相对编译后 MLX 有稳定的整局加速。
普通的 SDPA Core ML 导出与 ANE 图是两种不同的实现。在不受限的 RangeDim GPU 形状未通过本地保真度检查之后,普通导出默认使用 CPU+GPU。只改它的设备设置并不能复现 ANE 的结果。ANE 重写使用 BC1L 激活、1×1 投影和逐头注意力;它的计算计划以及一份单独的 Instruments trace 都支持 Neural Engine 在工作。CPU 仍负责输入/输出边界。
文档与可复现性
要自行导出,请安装 laya-coreml[convert] 并运行 laya-coreml convert laya-multilingual models/custom。ANE 研究用的转换、压缩与基准脚本都在 Git checkout 里。推理 wheel 包含可移植的运行时和可选的终端演示。
Apache-2.0。由 Convai Innovations 及贡献者独立移植的 Laya,构建在 MLX 姊妹项目 之上。不是 Convai Innovations 或 Apple 的官方发布。见 NOTICE。