Версия 0.2.0 переносит применимые исправления промптов и результатов из upstream-коммита
4aa6761 (версия исходников 0.3.23). Оба рантайма, Core ML и ANE, принимают пользовательские
отображаемые метки noul ({"false": "no", "true": "yes"}), проверяют вопросы с ошибками,
специфичными для каждого типа вопроса, и сохраняют Unicode-инструкции для структурированных
запросов. Длинные списки беседы сохраняют самые новые токены; строки и объекты сохраняют своё
начало. usage сообщает об усечении состояния и, если оно есть, о свёрнутых вариантах.
answer_confidence — это наибольшая вероятность ответа; смысл существующего confidence
не меняется. Ни одно из полей не устанавливает точность калибровки. Описанный ниже клампинг
температуры контрольной точки включён в этот выпуск. Ограничения ёмкости экспортированного
графа по-прежнему вызывают ошибки, а не молчаливое усечение.
Сопровождение следует за исправлениями upstream Laya, применимыми к этим рантаймам. Новые возможности рантайма и предложения по оптимизации под конкретный бэкенд требуют реализации и валидации в русле upstream; закрытие issue не означает, что описанное в нём поведение исправлено.
Открытые типизированные решения на Apple Silicon. Core ML, Neural Engine, ноль сгенерированных токенов.
PyPI · Веса на Hugging Face · 中文
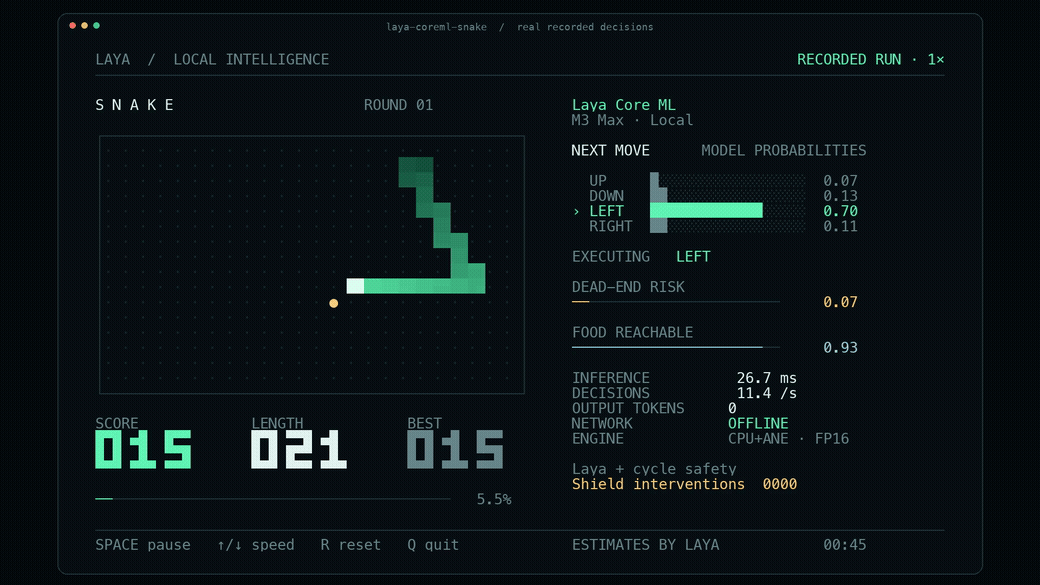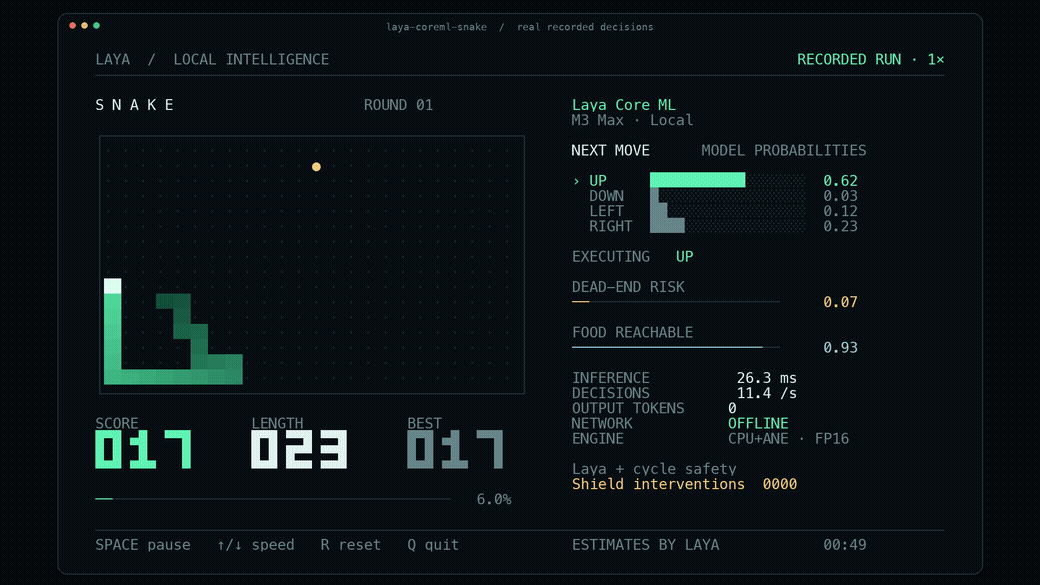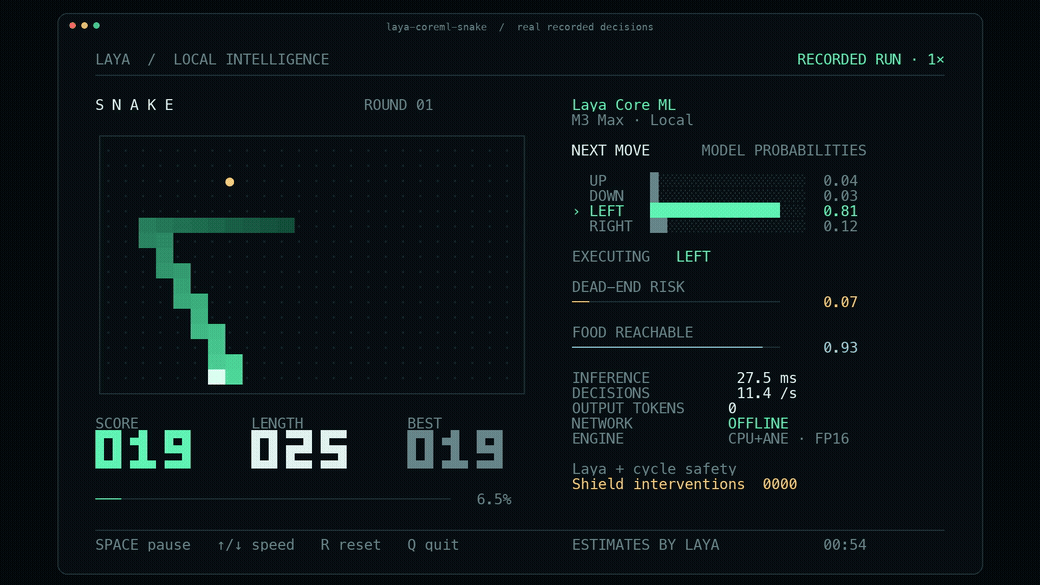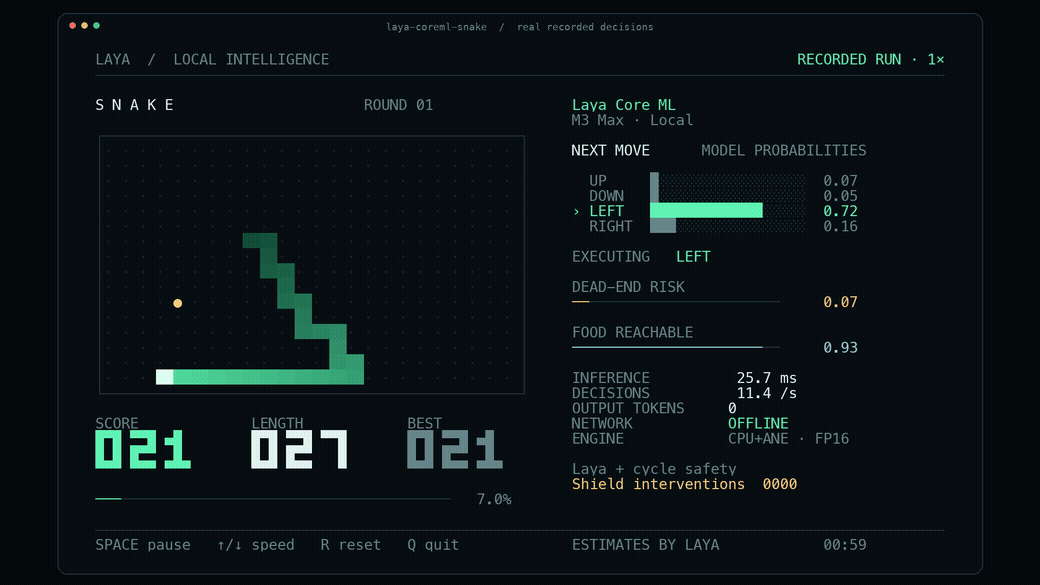
Настоящая модель Laya играет в Snake локально, с видимыми вероятностями, счётом, длиной, задержкой и вмешательствами системы безопасности. GIF воспроизводит записанный прогон Core ML на скорости 1×. В игре используются явные признаки планировщика и видимый слой защиты от циклов.
Полный активный игровой цикл Snake выдержал 49.1–50.0 решений/с в трёх неограниченных эпизодах по 600 шагов, без смертей и с двумя вмешательствами системы безопасности. Тайминги игрового цикла и ограничения задаваемой частоты включают сериализацию отрисовки; отрисовка в терминале исключена.
Одно короткое многоязычное решение: 4.98 мс P50 / 5.31 мс P95 на M3 Max с ANE FP16. В том же эксперименте измерена в 2.78× лучшая энергия всей системы на решение, чем у скомпилированного MLX FP16. Отдельно проверенный вариант с палитрой W8 достиг 4.88 мс и улучшения энергии в 3.19×. Это результаты для одного вопроса, а не времена полного кадра Snake; запрошенное улучшение в 10× не достигнуто.
Запустите демо
Apple Silicon · macOS 15+ · Python 3.11–3.13.
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
Скачайте один раз, затем играйте офлайн. Для инференса не нужны ни PyTorch, ни Transformers, ни MLX. Терминалу нужно 104 столбца × 35 строк. Пробел ставит на паузу; ↑/↓ меняет скорость; R сбрасывает; Q завершает. Первая инициализация Core ML может занять десятки секунд.
Управление, запись и экспорт видео · Измеренные стабильные частоты решений · Видео для публикации и происхождение записи
Запросите решение
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])Laya возвращает вероятности для вопросов choice, порядковых score и булевых noul.
Здесь нет авторегрессионного декодирования и нет сгенерированного JSON, который нужно разбирать.
Модели из Hub скачиваются до инициализации; последующие предсказания остаются локальными.
Передайте local_files_only=True, чтобы потребовать существующий кэш, или загрузите локальный каталог.
Следуя upstream v0.3.5, подобранные температуры калибровки перед использованием зажимаются в
[0.5, 5.0]: поставляемое значение для корзины choice:11+ равно 0.1006, что усилило бы логиты
примерно в 10 раз и выдало бы подбрасывание монеты за почти полную уверенность. Сырые значения
контрольной точки остаются доступны как agent.temperature_raw и
agent.temperature_by_options_raw, а RuntimeWarning называет каждую зажатую корзину при загрузке.
Пакет ANE имеет общий лимит в 96 токенов, включая вопрос, варианты и состояние. Более длинные
запросы вызывают ошибку ёмкости. Используйте aac6fef/laya-multilingual-coreml для
универсальной модели на 1024 токена.
Полный API, выбор модели и офлайн-использование.
Измерено на M3 Max
40-ядерный GPU, 128 ГиБ, macOS 27.2. Один вопрос на 91 токен, дополненный до 96, включая подготовку промпта, токенизацию, массивы, синхронный инференс, калибровку и форматирование. Загрузка и прогрев исключены. MLX включает compile, кэширование префикса и корзины форм. Шесть чередующихся 20-секундных блоков на каждую реализацию дали 65 598 стабильных вызовов.
| Метрика | Скомпилированный MLX FP16 | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 мс | 4.98 / 5.31 мс | 4.88 / 5.23 мс |
| Оценка средней мощности системы | 61.39 Вт | 30.75 Вт | 27.39 Вт |
| Энергия системы / решение | 0.4288 Дж | 0.1540 Дж | 0.1344 Дж |
| Прирост скорости | 1× | 1.39× | 1.42× |
| Прирост энергии системы | 1× | 2.78× | 3.19× |
Для энергии используются прямые показания датчика SMC PSTR, с сырыми выборками и явным отбрасыванием аномалий. Это оценка с неопределённостью от датчика и фоновой нагрузки. Прирост скорости × отношение средней мощности = прирост энергии; умножение энергии на скорость снова дало бы двойной учёт времени. Вариант W8 сжимает веса, сохраняя вычисления в FP16. Он приближённый, и сокращение размера его пакета не является отношением скоростей.
Доказательства по скорости, энергии и оборудованию · Сырые измерения.
Доступные контрольные точки
| Пакет Hugging Face | Движок по умолчанию | Ёмкость | Назначение |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 токенов | Исходная английская модель |
| Multilingual 322M | CPU + GPU | 1024 токена | Универсальные многоязычные решения |
| Typed Decisions 421M | CPU + GPU | 1024 токена | Исходная специализированная контрольная точка |
| Snake GPU | CPU + GPU | B3 / L64 | Батчит три компактных игровых вопроса |
| Multilingual ANE | CPU + ANE | B1 / L96 | Короткие решения, FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | Опциональное приближённое сжатие палитры |
Каждый пакет включает токенизатор/конфигурацию, карточку модели, происхождение, контрольные суммы и валидацию на этапе упаковки. Пакеты ANE также включают точные исходные тензоры эмбеддингов и действий хоста, которые им нужны. Исходная рабочая копия для обучения не требуется.
Точность порта и ограничения
Три универсальные контрольные точки FP16 совпадают с upstream по выбранным ответам на 189/189 проверочных вопросах. Каждая проходит 100 повторных вызовов. ANE FP16 L96 проходит 59/59 подходящих вопросов, с максимальным дрейфом калиброванной вероятности 0.002925; W8 проходит то же подмножество с дрейфом 0.014393 при неизменном пороге 0.02. Эксперименты с шестью и четырьмя битами не прошли этот порог и не являются опубликованными весами. Это фикстуры точности конвертации, а не доказательство общей точности на задачах.
Отдельно экспортированный граф FP16 ANE L1024 проходит полную фикстуру 63/63, но реальный запрос на 1024 токена занимает около 91.7 мс в его последовательном экране. Короткий результат ANE не устанавливает преимущества на длинном контексте. Парная проверка Snake на 600 шагов совпадает по 600/600 действиям, без смертей и без вмешательств щита; три последовательных вызова текущего адаптера ANE не устанавливают устойчивого ускорения полной игры относительно скомпилированного MLX.
Обычный экспорт SDPA Core ML и граф ANE — это разные реализации. Обычный экспорт по умолчанию использует CPU+GPU после того, как неограниченные формы RangeDim GPU не прошли локальные проверки точности. Изменение только его настройки устройства не воспроизводит результат ANE. Переписывание под ANE использует активации BC1L, проекции 1×1 и внимание по головам; его план и отдельная трасса Instruments подтверждают работу Neural Engine. CPU по-прежнему обрабатывает границы ввода/вывода.
Документация и воспроизводимость
- Установка и Python/CLI API
- Демо Snake и медиа
- Артефакты выпуска и закреплённые ревизии Hub
- Общие бенчмарки Core ML
- Инженерные эксперименты ANE
- Математическое исследование цели 10×
- Проблемы конвертации и поддерживаемые формы
Чтобы экспортировать самостоятельно, установите laya-coreml[convert] и выполните
laya-coreml convert laya-multilingual models/custom. Исследовательские скрипты ANE для
конвертации, сжатия и бенчмарков находятся в Git-копии. Колесо инференса содержит переносимый
рантайм и опциональное терминальное демо.
Apache-2.0. Независимый порт Laya от Convai Innovations и участников, основанный на родственном проекте MLX. Не является официальным выпуском Convai Innovations или Apple. См. NOTICE.