A versão 0.2.0 sincroniza as correções aplicáveis de prompt e de resultado por meio do upstream
4aa6761 (versão de origem 0.3.23). Os runtimes Core ML e ANE aceitam rótulos de exibição
noul personalizados ({"false": "no", "true": "yes"}), validam perguntas com
erros específicos de cada pergunta e preservam instruções estruturadas em Unicode. Listas longas
de conversa retêm seus tokens mais recentes; strings e objetos retêm seu
início. usage relata o truncamento de estado e, quando presente, as opções recolhidas.
answer_confidence é a maior probabilidade de resposta; a semântica existente de confidence
permanece inalterada. Nenhum dos campos estabelece precisão de calibração.
O limite de temperatura do checkpoint documentado abaixo está incluído nesta versão.
Os limites de capacidade dos grafos exportados ainda geram erro em vez de cortar silenciosamente.
A manutenção acompanha as correções do upstream Laya aplicáveis a esses runtimes. Novos recursos de runtime e propostas de otimização específicas de backend exigem uma implementação alinhada ao upstream e uma validação; fechar uma issue não estabelece que o comportamento relatado foi corrigido.
Decisões tipadas de pesos abertos em Apple Silicon. Core ML, Neural Engine, zero tokens gerados.
PyPI · pesos no Hugging Face · Chinês
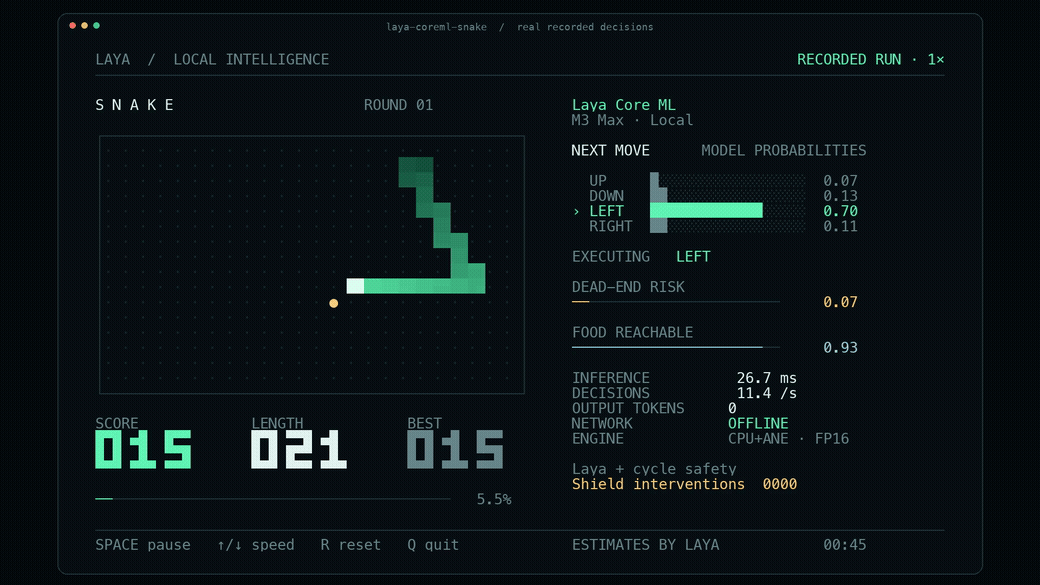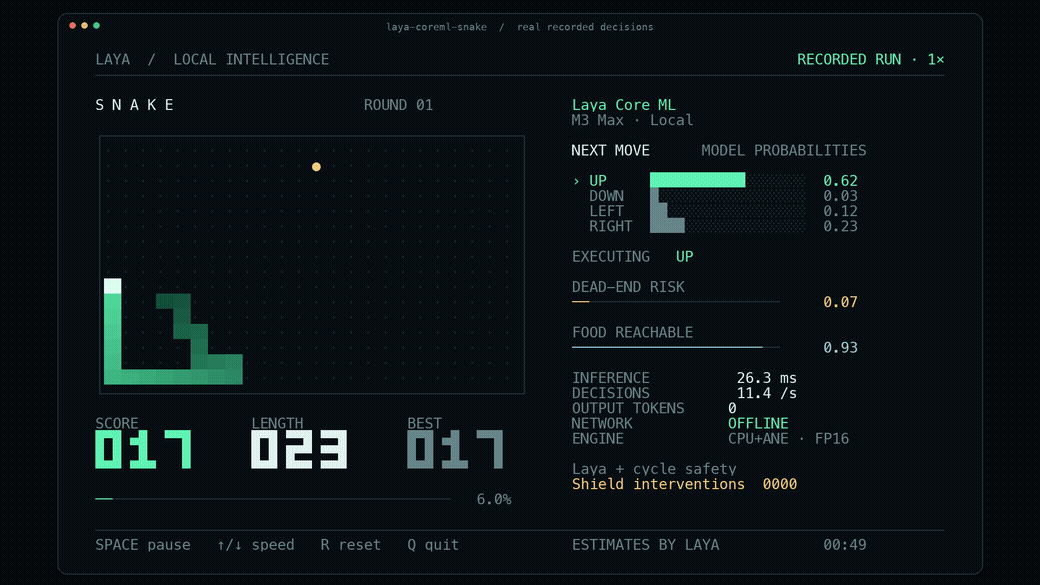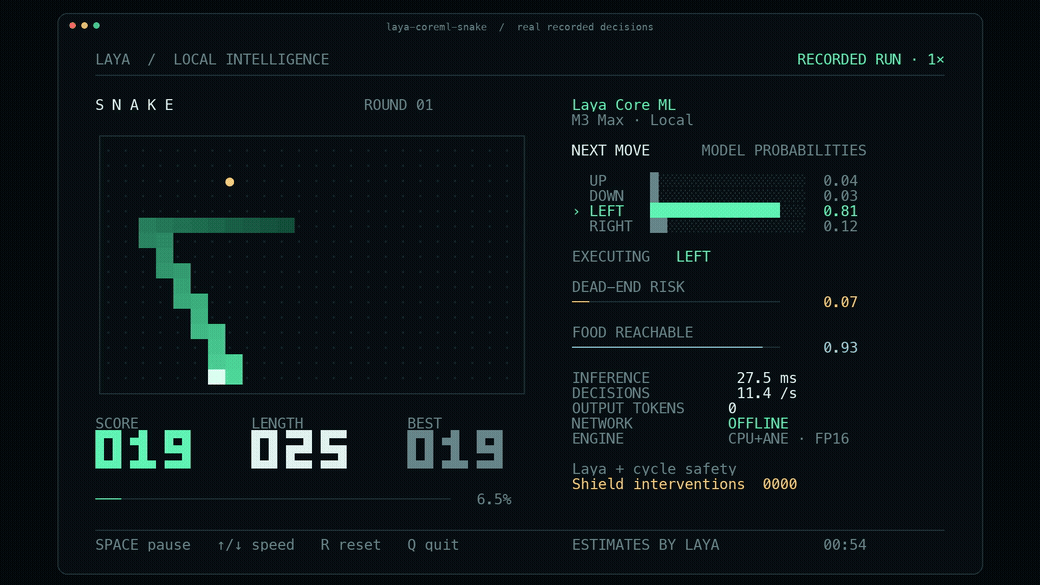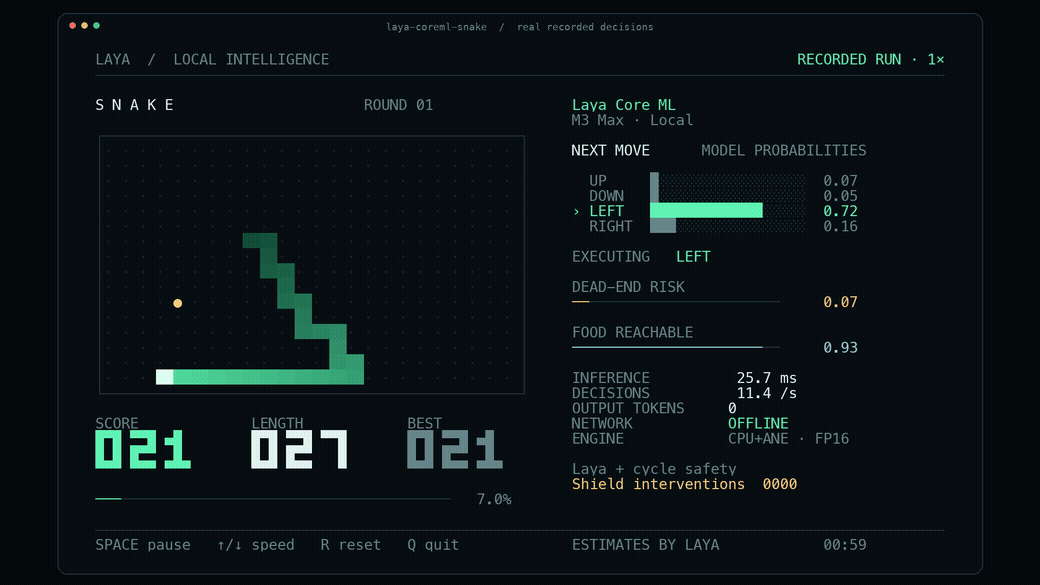
Um modelo Laya real joga Snake localmente, com probabilidades, pontuação, comprimento, latência e intervenções de segurança visíveis. O GIF reproduz uma execução Core ML gravada a velocidade de 1×. O jogo usa recursos explícitos de planejador e uma camada de segurança de ciclo visível.
O laço ativo completo do Snake sustentou 49.1–50.0 decisões/s em três episódios de 600 passos sem limite, com zero mortes e duas intervenções de segurança. Os tempos do laço de jogo e os limites de taxa cadenciada incluem a serialização de renderização; a pintura do terminal fica de fora.
Uma decisão multilíngue curta: 4.98 ms de P50 / 5.31 ms de P95 no M3 Max com ANE FP16. O mesmo experimento mediu energia de sistema inteiro por decisão 2.78× melhor do que o MLX FP16 compilado. Uma variante de paleta W8 validada separadamente alcançou 4.88 ms e 3.19× de melhoria de energia. Esses são resultados de uma única pergunta, não tempos completos de quadro do Snake; a melhoria de 10× solicitada não foi alcançada.
Execute a demonstração
Apple Silicon · macOS 15+ · Python 3.11–3.13.
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
Baixe uma vez e depois jogue offline. Não é preciso PyTorch, Transformers nem MLX para inferência. O terminal precisa de 104 colunas × 35 linhas. Espaço pausa; ↑/↓ muda a velocidade; R reinicia; Q sai. A primeira inicialização do Core ML pode levar dezenas de segundos.
Controles, gravação e exportação de vídeo · Taxas de decisão estáveis medidas · Vídeo compartilhável e proveniência da gravação
Peça uma decisão
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])O Laya retorna probabilidades para perguntas choice, score ordinais e noul
booleanas. Não há decodificação autorregressiva nem JSON gerado para analisar. Os modelos do Hub
baixam antes da inicialização; as predições seguintes permanecem locais. Passe
local_files_only=True para exigir um cache existente, ou carregue um diretório local.
Seguindo o upstream v0.3.5, as temperaturas de calibração ajustadas são limitadas a
[0.5, 5.0] antes do uso: o bucket choice:11+ fornecido é 0.1006, o que
aguçaria os logits em ~10x e relataria um cara ou coroa como quase certeza. Os valores
brutos do checkpoint continuam disponíveis como agent.temperature_raw e
agent.temperature_by_options_raw, e um RuntimeWarning nomeia cada bucket limitado
no carregamento.
O pacote ANE tem um limite total de 96 tokens, incluindo pergunta, opções e
estado. Requisições mais longas geram um erro de capacidade. Use
aac6fef/laya-multilingual-coreml para o modelo de propósito geral de 1024 tokens.
API completa, seleção de modelo e uso offline.
Medido no M3 Max
GPU de 40 núcleos, 128 GiB, macOS 27.2. Uma pergunta de 91 tokens preenchida até 96, incluindo preparação do prompt, tokenização, arrays, inferência síncrona, calibração e formatação. O carregamento e a fase de aquecimento ficam de fora. O MLX habilita compile, cache de prefixo e buckets de forma. Seis blocos alternados de 20 segundos por implementação produziram 65,598 chamadas estáveis.
| Métrica | MLX FP16 compilado | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| Estimativa de potência média do sistema | 61.39 W | 30.75 W | 27.39 W |
| Energia do sistema / decisão | 0.4288 J | 0.1540 J | 0.1344 J |
| Ganho de velocidade | 1× | 1.39× | 1.42× |
| Ganho de energia do sistema | 1× | 2.78× | 3.19× |
A energia usa leituras diretas do sensor SMC PSTR, com amostras brutas e rejeição explícita de anomalias. É uma estimativa com incerteza de sensor e de carga de fundo. Ganho de velocidade × razão de potência média = ganho de energia; multiplicar a energia pela velocidade de novo contaria o tempo duas vezes. A variante W8 comprime os pesos mantendo a computação em FP16. Ela é aproximada, e sua redução de tamanho de pacote não é uma razão de velocidade.
Velocidade, energia e evidência de hardware · Medições brutas.
Checkpoints disponíveis
| Pacote Hugging Face | Engine padrão | Capacidade | Finalidade |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 tokens | Modelo inglês original |
| Multilingual 322M | CPU + GPU | 1024 tokens | Decisões multilíngues gerais |
| Typed Decisions 421M | CPU + GPU | 1024 tokens | Checkpoint especializado original |
| Snake GPU | CPU + GPU | B3 / L64 | Faz batching das três perguntas compactas do jogo |
| Multilingual ANE | CPU + ANE | B1 / L96 | Decisões curtas, FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | Compressão de paleta aproximada opcional |
Cada pacote inclui tokenizer/configuração, model card, proveniência, checksums e validação no momento do empacotamento. Os pacotes ANE também incluem os tensores exatos de embedding/ação do host de que precisam. Não é necessário nenhum checkout de treinamento original.
Fidelidade da portabilidade e limites
Os três checkpoints FP16 de propósito geral correspondem às respostas selecionadas do upstream em 189/189 perguntas de validação. Cada um passa em 100 chamadas repetidas. O ANE FP16 L96 passa em 59/59 perguntas de ajuste, com desvio máximo de probabilidade calibrada de 0.002925; o W8 passa no mesmo subconjunto com desvio de 0.014393 sob um limiar inalterado de 0.02. Os experimentos de seis e quatro bits falharam nesse limiar e não são pesos publicados. Esses são fixtures de fidelidade de conversão, não prova de acurácia geral de tarefa.
Um grafo FP16 ANE L1024 exportado separadamente passa na fixture completa de 63/63, mas uma requisição real de 1024 tokens leva cerca de 91.7 ms em sua triagem serial. O resultado curto do ANE não estabelece uma vantagem de contexto longo. Uma verificação pareada de Snake de 600 passos corresponde a 600/600 ações, com zero mortes e zero intervenções de escudo; as três chamadas sequenciais do adapter ANE atual não estabelecem uma aceleração consistente de jogo completo em relação ao MLX compilado.
A exportação Core ML comum com SDPA e o grafo ANE são implementações diferentes. A exportação comum usa CPU+GPU por padrão depois que formas RangeDim de GPU irrestritas falharam nos testes locais de fidelidade. Mudar apenas sua configuração de dispositivo não reproduz o resultado do ANE. A reescrita ANE usa ativações BC1L, projeções 1×1 e atenção por cabeça; seu plano e um trace separado do Instruments sustentam o trabalho do Neural Engine. A CPU ainda cuida das fronteiras de entrada/saída.
Documentação e reprodutibilidade
- Instalação e API Python/CLI
- Demonstração e mídia do Snake
- Artefatos de lançamento e revisões fixadas do Hub
- Benchmarks gerais do Core ML
- Experimentos de engenharia do ANE
- Investigação matemática da meta de 10×
- Problemas de conversão e formas suportadas
Para exportar por conta própria, instale laya-coreml[convert] e execute
laya-coreml convert laya-multilingual models/custom. Os scripts de conversão, compressão e benchmark
da pesquisa do ANE ficam no checkout do Git. A wheel de inferência
contém o runtime portátil e a demonstração de terminal opcional.
Apache-2.0. Porte independente do Laya, feito pela Convai Innovations e colaboradores, construído sobre o projeto irmão MLX. Não é um lançamento oficial da Convai Innovations nem da Apple. Consulte NOTICE.