La version 0.2.0 synchronise les correctifs applicables de prompt et de résultat via
l’amont 4aa6761 (version source 0.3.23). Les runtimes Core ML et ANE acceptent tous
deux des libellés d’affichage noul personnalisés ({"false": "no", "true": "yes"}),
valident les questions avec des erreurs propres à chaque question et préservent les
instructions structurées Unicode. Les longues listes de conversation conservent leurs
tokens les plus récents ; les chaînes et les objets conservent leur début. usage
signale la troncature d’état et, le cas échéant, les options réduites.
answer_confidence est la probabilité de réponse la plus élevée ; la sémantique
existante de confidence reste inchangée. Aucun des deux champs n’établit la précision
de calibration. Le plafonnement de température du checkpoint documenté ci-dessous est
inclus dans cette version. Les limites de capacité des graphes exportés continuent de
lever des erreurs plutôt que de tronquer silencieusement.
La maintenance suit les correctifs amont de Laya applicables à ces runtimes. Les nouvelles fonctionnalités de runtime et les propositions d’optimisation propres à un backend nécessitent une implémentation et une validation alignées sur l’amont ; fermer un ticket n’établit pas que le comportement signalé est corrigé.
Décisions typées à poids ouverts sur Apple Silicon. Core ML, Neural Engine, zéro jeton généré.
PyPI · Poids Hugging Face · 中文
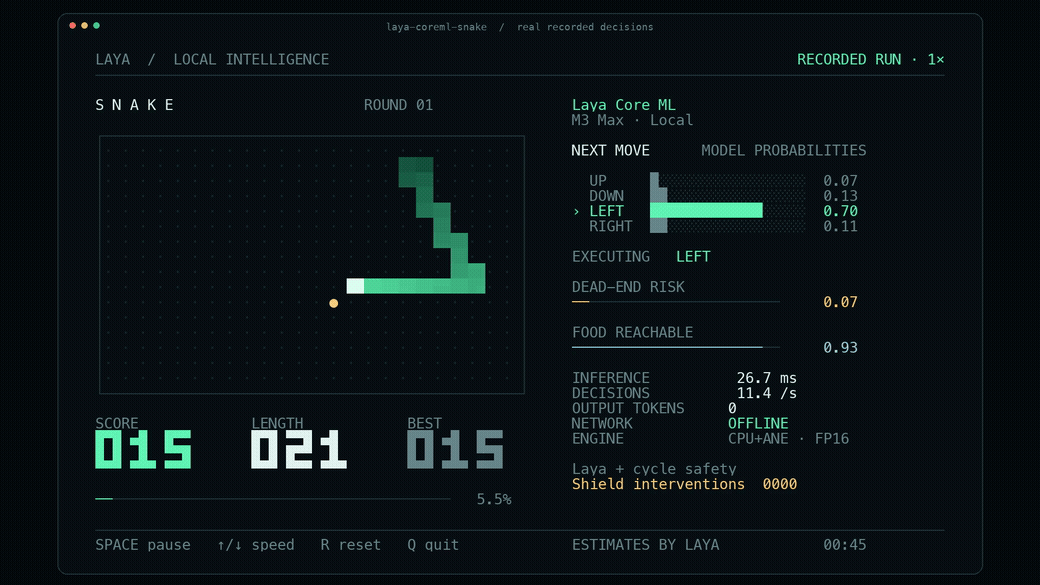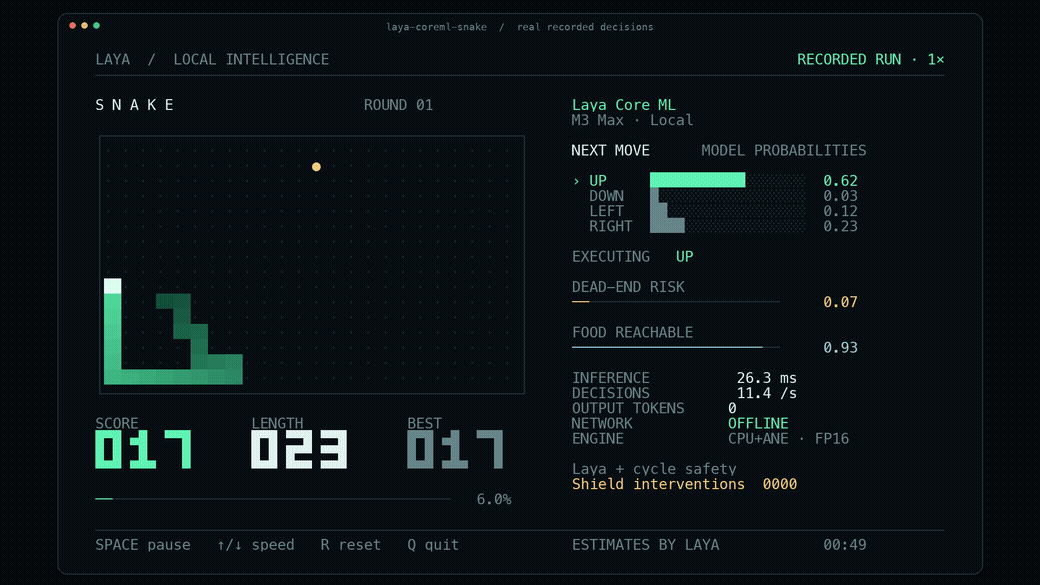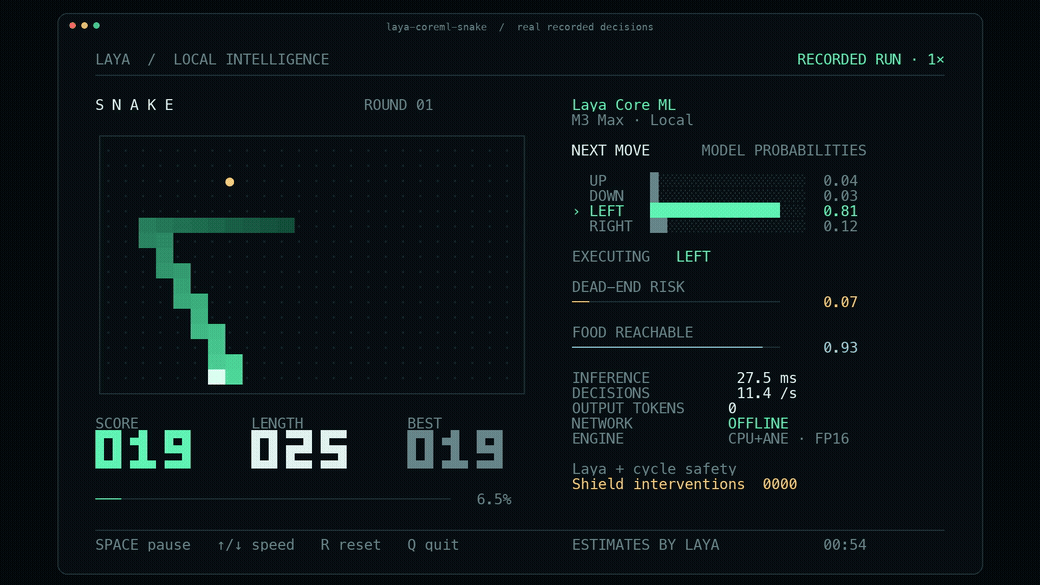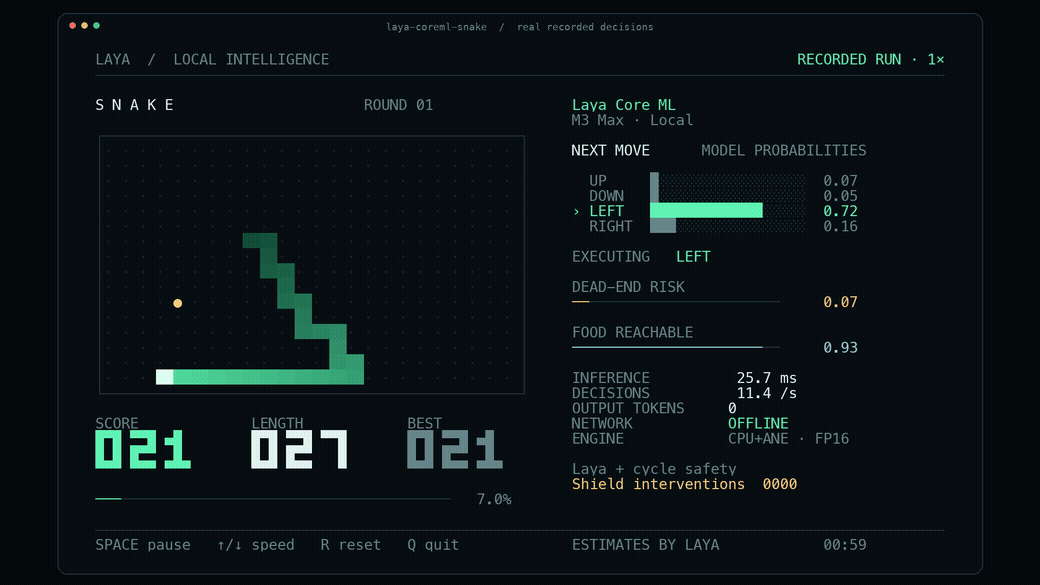
Un vrai modèle Laya joue à Snake en local, avec des probabilités visibles, le score, la longueur, la latence et les interventions de sécurité. Le GIF rejoue une exécution Core ML enregistrée à vitesse d’origine (1×). Le jeu utilise des caractéristiques explicites de planificateur et une couche de sécurité de cycle visible.
La boucle Snake active complète a soutenu 49.1–50.0 décisions/s sur trois épisodes de 600 pas sans plafond, avec zéro mort et deux interventions de sécurité. Les temps de la boucle de jeu et les limites de cadence incluent la sérialisation du rendu ; le dessin dans le terminal est exclu.
Une courte décision multilingue : 4.98 ms P50 / 5.31 ms P95 sur M3 Max avec ANE FP16. La même expérience a mesuré une énergie système totale par décision 2.78× meilleure que MLX FP16 compilé. Une variante à palette W8 validée séparément atteint 4.88 ms et une amélioration énergétique de 3.19×. Ce sont des résultats à une seule question, pas des temps par image Snake complets ; l’amélioration de 10× demandée n’a pas été atteinte.
Lancer la démo
Apple Silicon · macOS 15+ · Python 3.11–3.13.
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
Télécharge une fois, puis joue hors ligne. PyTorch, Transformers ou MLX ne sont pas nécessaires pour l’inférence. Le terminal nécessite 104 colonnes × 35 lignes. Espace met en pause ; ↑/↓ change la vitesse ; R réinitialise ; Q quitte. La première initialisation Core ML peut prendre des dizaines de secondes.
Contrôles, enregistrement et export vidéo · Débits de décision stables mesurés · Vidéo partageable et provenance de l’enregistrement
Demander une décision
pip install laya-coremlimport laya_coreml as laya
agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
"The customer requests a refund of a duplicate payment.",
{
"refund": {
"type": "noul",
"instructions": "Does the customer request a refund?",
}
},
)
print(result["answers"]["refund"])Laya renvoie des probabilités pour les questions choice, score ordinales et
noul booléennes. Il n’y a pas de décodage autorégressif ni de JSON généré à
analyser. Les modèles du Hub se téléchargent avant l’initialisation ; les prédictions
suivantes restent locales. Passe local_files_only=True pour exiger un cache
existant, ou charge un répertoire local.
À la suite de la v0.3.5 en amont, les températures de calibration ajustées sont
bornées à [0.5, 5.0] avant utilisation : le bucket livré choice:11+ vaut 0.1006,
ce qui aiguiserait les logits d’environ 10x et rapporterait un pile ou face comme une
quasi-certitude. Les valeurs brutes du checkpoint restent disponibles via
agent.temperature_raw et agent.temperature_by_options_raw, et un
RuntimeWarning nomme chaque bucket borné au chargement.
Le bundle ANE a une limite totale de 96 tokens, y compris la question, les options
et l’état. Les requêtes plus longues lèvent une erreur de capacité. Utilise
aac6fef/laya-multilingual-coreml pour le modèle généraliste à 1024 tokens.
API complète, sélection de modèle et usage hors ligne.
Mesuré sur M3 Max
GPU 40 cœurs, 128 GiB, macOS 27.2. Une question de 91 tokens complétée à 96, incluant la préparation du prompt, la tokenisation, les tableaux, l’inférence synchrone, la calibration et le formatage. Le chargement et l’échauffement sont exclus. MLX active compile, le cache de préfixes et les buckets de forme. Six blocs alternés de 20 secondes par implémentation ont produit 65,598 appels stables.
| Métrique | MLX FP16 compilé | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| Estimation de puissance système moyenne | 61.39 W | 30.75 W | 27.39 W |
| Énergie système / décision | 0.4288 J | 0.1540 J | 0.1344 J |
| Gain de vitesse | 1× | 1.39× | 1.42× |
| Gain d’énergie système | 1× | 2.78× | 3.19× |
L’énergie utilise des relevés directs du capteur SMC PSTR, avec des échantillons bruts et un rejet explicite des anomalies. C’est une estimation entachée d’incertitude liée au capteur et à la charge de fond. Gain de vitesse × rapport de puissance moyenne = gain d’énergie ; multiplier à nouveau l’énergie par la vitesse compterait le temps deux fois. La variante W8 compresse les poids tout en conservant le calcul FP16. Elle est approximative, et sa réduction de taille de paquet n’est pas un rapport de vitesse.
Preuves de vitesse, d’énergie et de matériel · Mesures brutes.
Checkpoints disponibles
| Bundle Hugging Face | Moteur par défaut | Capacité | Usage |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 tokens | Modèle anglais d’origine |
| Multilingual 322M | CPU + GPU | 1024 tokens | Décisions multilingues générales |
| Typed Decisions 421M | CPU + GPU | 1024 tokens | Checkpoint spécialisé d’origine |
| Snake GPU | CPU + GPU | B3 / L64 | Met en lot les trois questions de jeu compactes |
| Multilingual ANE | CPU + ANE | B1 / L96 | Décisions courtes, FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | Compression de palette approximative en option |
Chaque bundle inclut le tokenizer et la configuration, la fiche modèle, la provenance, les sommes de contrôle et la validation au moment du packaging. Les bundles ANE incluent aussi les tenseurs exacts d’embedding hôte et d’action d’origine dont ils ont besoin. Aucun checkout d’entraînement d’origine n’est requis.
Fidélité du portage et limites
Les trois checkpoints FP16 généralistes correspondent aux réponses sélectionnées en amont sur 189/189 questions de validation. Chacun passe 100 appels répétés. Le ANE FP16 L96 passe 59/59 questions de fitting, avec une dérive maximale de probabilité calibrée de 0.002925 ; le W8 passe le même sous-ensemble avec une dérive de 0.014393 sous un seuil inchangé de 0.02. Les expériences à six et quatre bits ont échoué à ce seuil et ne sont pas des poids publiés. Ce sont des fixtures de fidélité de conversion, pas une preuve d’exactitude générale sur les tâches.
Un graphe FP16 ANE L1024 exporté séparément passe la fixture complète 63/63, mais une vraie requête de 1024 tokens prend environ 91.7 ms dans son écran série. Le résultat ANE court n’établit pas d’avantage sur le contexte long. Un contrôle Snake apparié de 600 pas correspond à 600/600 actions, avec zéro mort et zéro intervention de bouclier ; les trois appels séquentiels de l’adaptateur ANE actuel n’établissent pas d’accélération cohérente sur toute la partie par rapport à MLX compilé.
L’export Core ML SDPA ordinaire et le graphe ANE sont des implémentations différentes. L’export ordinaire est par défaut sur CPU+GPU après l’échec des formes GPU RangeDim sans restriction aux contrôles de fidélité locaux. Changer seul son réglage d’appareil ne reproduit pas le résultat ANE. La réécriture ANE utilise des activations BC1L, des projections 1×1 et une attention par tête ; son plan et une trace Instruments séparée étayent le travail du Neural Engine. Le CPU gère encore les frontières d’entrée/sortie.
Documentation et reproductibilité
- Installation et API Python/CLI
- Démo Snake et médias
- Artefacts de release et révisions Hub épinglées
- Benchmarks Core ML généraux
- Expériences d’ingénierie ANE
- Investigation mathématique de l’objectif 10×
- Problèmes de conversion et formes prises en charge
Pour exporter toi-même, installe laya-coreml[convert] et lance
laya-coreml convert laya-multilingual models/custom. Les scripts de conversion, de
compression et de benchmark de la recherche ANE se trouvent dans le checkout Git. La
wheel d’inférence contient le runtime portable et la démo terminal en option.
Apache-2.0. Portage indépendant de Laya, par Convai Innovations et des contributeurs, construit sur le projet frère MLX. Ce n’est pas une version officielle de Convai Innovations ni d’Apple. Voir NOTICE.