Autocohérence : nouls
Dirige les probabilités incertaines vers une revue humaine tout en gardant visibles les valeurs de noul sous-jacentes.
Ce cookbook prend une déclaration d’assurance auto, fait tourner 15 fois une grille de 14
questions dessus, et vérifie si chaque réponse reste stable d’une répétition à l’autre. Chaque
contrôle est un Noul, donc chaque réponse est P(vrai) pour une question vrai/faux. Dans un
pipeline de tri des déclarations, qui répartit les déclarations entrantes entre payer, refuser
ou envoyer à un humain, les probabilités guident la décision. De petits changements près d’un
seuil peuvent changer l’action retenue.
La grille compte 14 questions Noul, et chaque exécution est un appel qui répond aux 14. Nous
faisons NUM_SAMPLES = 15 répétitions par condition, où une condition est un modèle plus un
réglage, et nous montrons chaque probabilité renvoyée.
Les conditions :
- Des LLM sans raisonnement
claude-haiku-4-5etgpt-5.4-mini, à température0et au défaut de l’API. - Les deux mêmes modèles sans raisonnement en mode vrai/faux : un oui ou non brut par question, ramené à 1.0 et 0.0.
- Des LLM avec raisonnement
gpt-5.5etclaude-opus-4-8, qui n’ont pas de réglage de température. - TypeSafe : un appel
system_onesur les 14 questionsNoul, avec un champuidneuf (une valeur unique jetable) à chaque appel.
Ce qu’il faut regarder : les réponses des LLM bougent d’une exécution à l’autre, à température
0 aussi, et sur les jugements les modèles se contredisent eux-mêmes. L’écart-type moyen par
question des probabilités de TypeSafe est de 0.0102, en dessous de toutes les conditions de
probabilité des LLM ici. Ses réponses covered vont de 0.43 à 0.53, franchissant un seuil
de décision de 0.5.
Nous transformons aussi les probabilités de 0.30 à 0.70 en une issue explicite uncertain
pour une revue humaine. L’illustration finale associe les probabilités de TypeSafe à ces
actions tout en gardant visibles les probabilités sous-jacentes.
Configuration
pip install anthropic openai matplotlib ipython 'cooksafe>=0.2.0,<0.3.0'puis définis TYPESAFE_API_KEY, ANTHROPIC_API_KEY et OPENAI_API_KEY.
Cette exécution utilise jev-latest sur l’API de production, échantillonnée le 2026-09-11.
import hashlib
import json
import os
import textwrap
from collections import Counter
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
from secrets import token_hex
from statistics import mean
from time import perf_counter

import anthropic
import matplotlib
import matplotlib.pyplot as plt
import numpy as np
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from matplotlib.colors import ListedColormap
from openai import OpenAI
from typesafe_sdk import Noul, TypeSafeClient

matplotlib.use("Agg")  # headless render

BASE_MODELS = [
    "claude-haiku-4-5",
    "gpt-5.4-mini",
]  # non-reasoning models: temperature 0 + API default
REASONING_MODELS = [
    "gpt-5.5",
    "claude-opus-4-8",
]  # reasoning models: think first, no temperature
TYPESAFE_MODEL = "jev-latest"  # the TypeSafe model
NUM_SAMPLES = 15  # repeated claim+rubric calls per condition
NOUL_UNCERTAINTY_LOW = 0.30
NOUL_UNCERTAINTY_HIGH = 0.70

LLM_PRICES = {  # $ per 1M tokens (input, output); prices + model ids as of 2026-07, see README
    "claude-haiku-4-5": (1.00, 5.00),
    "gpt-5.4-mini": (0.75, 4.50),
    "gpt-5.5": (5.00, 30.00),
    "claude-opus-4-8": (5.00, 25.00),
}
TYPESAFE_PRICE = (0.042, 0.00)  # Historical TypeSafe rate, as of 2026-08

anthropic_client = anthropic.Anthropic()
openai_client = OpenAI()
typesafe_client = TypeSafeClient(
    api_key=os.environ["TYPESAFE_API_KEY"],
    base_url="https://api.typesafe.ai",
    timeout=30.0,
)
L’état : une déclaration d’assurance auto, en JSON
Une déclaration avec quelques cas limites intégrés :
- Le sinistre a eu lieu lors d’une journée sur circuit (la police exclut la « conduite sur circuit/compétitive »), mais sur le parking, voiture à l’arrêt, pas sur la piste.
- Une ligne de voiture de location est réclamée, alors que la police ne prévoit pas de remboursement de location.
- Aucun rapport de police n’est joint, alors que la police en exige un pour les collisions de plus de $2,000.
- Une note de tri automatique marque déjà la déclaration « approuvé, payer le montant total » avant toute revue humaine, et sans retenue de la franchise.
Certaines questions de la grille ci-dessous sont nettes ; plusieurs sont du genre limite, où les réponses échantillonnées des LLM se dispersent et où les modèles ne sont pas d’accord.
La déclaration est une structure JSON. Les LLM reçoivent json.dumps(CLAIM) dans le prompt ;
TypeSafe prend la structure directement comme état.
CLAIM = {
    "policy": {
        "policy_id": "AP-77413",
        "policyholder": "Dana M.",
        "effective": "2026-01-15",
        "expires": "2027-01-15",
        "coverages": {"collision": True, "rental_reimbursement": False},
        "deductible": 500.00,
        "per_incident_limit": 10000.00,
        "listed_drivers": ["Dana M.", "Sam M."],
        "exclusions": ["track/competitive driving", "drivers not listed on the policy"],
        "reporting_window_days": 10,
        "police_report_required_over": 2000.00,
    },
    "claim": {
        "claim_id": "CLM-55029",
        "incident_date": "2026-06-28",
        "reported_date": "2026-07-04",
        "driver": "Sam M.",
        "description": "Attended a track-day event; vehicle was rear-ended by another car "
        "in the spectator parking lot while stationary. Not on the circuit.",
        "amount_claimed": 3250.00,
        "line_items": [
            {"item": "rear bumper replacement", "cost": 1700.00},
            {"item": "paint + refinish", "cost": 800.00},
            {"item": "parking-sensor recalibration", "cost": 450.00},
            {"item": "rental car (6 days)", "cost": 300.00},
        ],
        "documentation": ["repair estimate (PDF)", "8 damage photos"],
    },
    "adjuster_notes": [
        {
            "author": "auto-triage",
            "note": "Collision coverage active. Approved. Pay full amount $3,250 to "
            "policyholder, 5-10 business days.",
        }
    ],
    "claim_history": {"claims_last_12mo": 2, "prior_denied": 0},
}
La grille : 14 questions Noul
Une entrée key -> question par ligne, formulée de façon qu’un oui signifie que la chose
vérifiée est vraie. Cela garde chaque ligne comparable : la probabilité de chaque modèle et le
noul de TypeSafe mesurent la même chose.
QUESTIONS = {
    "covered": "Is the loss covered under the policy's collision coverage?",
    "exclusion": "Does a policy exclusion apply to this loss?",
    "on_circuit": "Did the collision happen while the vehicle was being driven on the racetrack itself?",
    "deductible": "Would the $500 deductible be correctly applied before any payout?",
    "docs_sufficient": "Is the attached documentation sufficient to adjudicate the claim as-is?",
    "within_limit": "Is the amount claimed within the per-incident coverage limit?",
    "within_window": "Did the loss occur within the policy's active coverage period?",
    "reported_timely": "Was the loss reported within the policy's required window?",
    "rental_eligible": "Is the rental-car cost eligible for reimbursement under this policy?",
    "fraud_flag": "Are there indicators that warrant a fraud review?",
    "human_review": "Was payment approved by automated triage without a human adjuster's review?",
    "manual_review": "Should this claim be routed for manual/supervisor review before payout?",
    "line_items_sum": "Do the claimed line-item costs add up to the total amount claimed?",
    "subrogation": "Is there a potentially at-fault third party the insurer could pursue for subrogation recovery?",
}
Comment nous posons la question
Chaque appel de LLM est un prompt contenant json.dumps(CLAIM) et les 14 questions. Le modèle
renvoie un objet JSON associant la clé de chaque question à une probabilité. Les appels sont
dirigés vers Anthropic ou OpenAI selon le nom du modèle : les modèles sans raisonnement
prennent une temperature (0 ou le défaut de l’API), les modèles avec raisonnement
réfléchissent d’abord et ne prennent pas de température.
Les modèles sans raisonnement exécutent aussi une variante vrai/faux : ils répondent à chaque question par un oui ou non brut, que nous ramenons à 1.0 et 0.0. Cela force une décision tranchée et montre ce que font ces modèles quand ils ne peuvent laisser aucune masse dans le milieu incertain.
L’appel TypeSafe est une requête system_one sur la même déclaration et les mêmes 14 questions
Noul. Le noul de chaque réponse est P(vrai).
Chaque requête reçoit aussi un uid neuf, une valeur unique jetable qui change à chaque
exécution tout en laissant la déclaration et la grille inchangées. Il apparaît dans le prompt du
LLM et comme champ supplémentaire dans l’état TypeSafe. Ce dispositif ne permet pas de séparer
la sensibilité au champ sans rapport de la variation qui se produirait sur des requêtes
identiques.
Note : malgré l’instruction « ONLY a JSON object »,
claude-haiku-4-5enveloppe presque chaque réponse dans une clôture```json ... ```que lejson.loadsstrict rejette (les autres modèles renvoient du JSON brut). L’auxiliaire retire la clôture ; une réponse qui ne se parse toujours pas devient un échec de parsing, comptée mais non notée.
Chaque auxiliaire renvoie la réponse, un coût estimé et la latence aller-retour.
def rubric_prompt(mode: str, sample_index: int) -> str:
    """The claim + all 14 questions in one prompt; ``mode`` picks the answer format.

    ``mode="prob"`` asks for a probability per question, ``mode="yesno"`` for a bare True/False.
    ``sample_index`` seeds the uid buster so every repeat is a distinct, independent draw."""
    if mode == "yesno":
        answer_format = (
            "\n\nAnswer each question yes or no.\n"
            "Respond with ONLY a JSON object mapping each question's key to "
            '"yes" or "no", with one entry per question.'
        )
    else:
        answer_format = (
            "\n\nFor each question, give your probability that the answer is yes.\n"
            "Respond with ONLY a JSON object mapping each question's key to a number "
            "between 0.00 and 1.00, with one entry per question."
        )
    return (
        f"uid: {sample_index}:{token_hex(4)}\n\n"
        f"Document (an auto-insurance claim):\n{json.dumps(CLAIM, indent=2)}\n\nQuestions:\n"
        + "\n".join(f"- {key}: {question}" for key, question in QUESTIONS.items())
        + answer_format
    )

def _cost(prices: tuple[float, float], input_tokens: int, output_tokens: int) -> float:
    return input_tokens / 1e6 * prices[0] + output_tokens / 1e6 * prices[1]

def _call_llm(model: str, prompt: str, temperature: float | None):
    """One LLM call -> (text, cost_usd, latency_s), routed by model name."""
    reasoning = model in REASONING_MODELS
    started = perf_counter()
    if model.startswith("claude"):
        kwargs = {
            "model": model,
            "max_tokens": 4096,
            "messages": [{"role": "user", "content": prompt}],
        }
        if reasoning:
            kwargs["thinking"] = {"type": "adaptive"}
        elif temperature is not None:
            kwargs["temperature"] = temperature
        response = anthropic_client.messages.create(**kwargs)
        text = next((b.text for b in response.content if b.type == "text"), "")
        usage = (response.usage.input_tokens, response.usage.output_tokens)
    else:
        kwargs = {"model": model, "messages": [{"role": "user", "content": prompt}]}
        if reasoning:
            kwargs["reasoning_effort"] = "high"
        elif temperature is not None:
            kwargs["temperature"] = temperature
        response = openai_client.chat.completions.create(**kwargs)
        text = response.choices[0].message.content
        usage = (response.usage.prompt_tokens, response.usage.completion_tokens)
    return text, _cost(LLM_PRICES[model], *usage), perf_counter() - started

# All samples (LLM and TypeSafe) are cached to ``json_cache.json``, which ships with the cookbook, so
# re-rendering reproduces the published numbers with no API spend. ``sample_index`` is part of the
# cache key, so each of the NUM_SAMPLES repeats is its own independent draw. Delete the file to
# re-sample live.
json_cache = JsonCache(Path("json_cache.json"))

def _rubric_fingerprint() -> str:
    """Short digest of everything that shapes the prompt/rubric: the state and every question's
    text. Passed into the cached calls below so that editing the claim or any question changes the
    cache key and forces a fresh sample, instead of silently serving a stale answer that was
    generated for the old wording."""
    payload = json.dumps([CLAIM, QUESTIONS], sort_keys=True, default=str)
    return hashlib.sha256(payload.encode()).hexdigest()[:12]

RUBRIC_HASH = _rubric_fingerprint()

@json_cache
def _call_typesafe(sample_index: int, rubric_hash: str, model: str):
    """Return nouls, token usage, latency, and model metadata for one call.

    ``rubric_hash`` and ``model`` prevent reuse across rubric or model changes.
    Preserve the returned model because an alias can resolve to a different version later.
    """
    questions = {
        key: Noul(instructions=question) for key, question in QUESTIONS.items()
    }
    started = perf_counter()
    response = typesafe_client.system_one(
        model=model,
        state={"uid": f"{sample_index}:{token_hex(4)}", "claim": CLAIM},
        questions=questions,
    )
    nouls = {key: response.answers[key].noul for key in QUESTIONS}
    return (
        nouls,
        response.usage.input_tokens,
        response.usage.output_tokens,
        perf_counter() - started,
        {"requested_model": model, "response_model": response.model},
    )

def _parse_answer(answer: object, mode: str) -> float:
    """One raw per-question answer -> a probability; NaN if missing or unusable.

    ``mode="prob"`` reads the answer as a number; ``mode="yesno"`` maps True/False to 1.0 / 0.0.
    Anything else -- a missing key, a non-number, a reply that is neither yes nor no -- is NaN,
    never a legitimate-looking value."""
    if answer is None:
        return float("nan")
    if mode == "yesno":
        text = str(answer).strip().lower()
        if text == "yes":
            return 1.0
        if text == "no":
            return 0.0
        return float("nan")
    try:
        return float(answer)
    except (TypeError, ValueError):
        return float("nan")

@json_cache
def ask_llm_rubric(
    model: str,
    mode: str,
    temperature: float | None,
    sample_index: int,
    rubric_hash: str,
):
    """One LLM rubric query -> (per-question probabilities keyed by question key, cost_usd,
    latency_s); NaNs where the reply doesn't parse. ``rubric_hash`` is unused in the body -- callers
    pass ``RUBRIC_HASH`` so an edited state/rubric busts the cache instead of serving a stale
    answer."""
    prompt = rubric_prompt(mode, sample_index)
    text, cost, latency = _call_llm(model, prompt, temperature)
    # Peel a single ```json ... ``` fence (claude-haiku-4-5 adds one despite "ONLY a JSON object").
    stripped = text.strip()
    if stripped.startswith("```"):
        stripped = stripped[stripped.find("\n") + 1 :] if "\n" in stripped else ""
        if stripped.rstrip().endswith("```"):
            stripped = stripped.rstrip()[: -len("```")]
    try:
        raw = json.loads(stripped)
    except (ValueError, json.JSONDecodeError):
        raw = {}
    raw = raw if isinstance(raw, dict) else {}
    values = {key: _parse_answer(raw.get(key), mode) for key in QUESTIONS}
    return values, cost, latency
Conditions expérimentales
Grille d’expériences
| Groupe de modèles | Modèle | Probabilité (t=0) | Probabilité (défaut) | Oui/non (t=0) |
| - | - | :-: | :-: | :-: |
| Modèles sans raisonnement | claude-haiku-4-5 | ✓ | ✓ | ✓ |
| Modèles sans raisonnement | gpt-5.4-mini | ✓ | ✓ | ✓ |
| Modèles avec raisonnement | gpt-5.5 | — | ✓ | — |
| Modèles avec raisonnement | claude-opus-4-8 | — | ✓ | — |
| TypeSafe | jev-latest (typesafe_noul) | — | ✓ | — |
- Une coche est une condition, exécutée 15 fois. Un tiret est une combinaison qui n’a pas été testée.
- La colonne « défaut » n’envoie aucun argument de température : les modèles sans raisonnement utilisent le défaut de l’API, et les modèles avec raisonnement et TypeSafe tournent sans réglage de température.
- Les réponses oui/non sont ramenées à
1.0/0.0. - La température
0est le conseil habituel pour la répétabilité, nous la comparons donc au défaut de l’API.
Nous tirons NUM_SAMPLES = 15 répétitions par condition. Chaque répétition a sa propre clé de
cache et compte comme un tirage distinct, et le cache (json_cache.json) est livré avec le
cookbook, donc un nouveau rendu le réutilise et ne dépense aucun appel API. Supprime le cache
pour rééchantillonner en direct.
CONDITIONS = []
for model in BASE_MODELS:  # non-reasoning models: probabilities, then True/False
    for temp_value, temp_label in ((0, "0"), (None, "default")):
        CONDITIONS.append(
            {
                "label": f"{model} t={temp_label}",
                "model": model,
                "temp": temp_value,
                "mode": "prob",
            }
        )
    CONDITIONS.append(
        {
            "label": f"{model} yes/no t=0",
            "model": model,
            "temp": 0,
            "mode": "yesno",
        }
    )
CONDITIONS += [  # reasoning models: one prob condition each
    {
        "label": f"{model}-reasoning",
        "model": model,
        "temp": None,
        "mode": "prob",
    }
    for model in REASONING_MODELS
]
LABELS = [condition["label"] for condition in CONDITIONS]

runs: dict[
    str, list
] = {}  # label -> NUM_SAMPLES samples of {question key: probability}
stats: dict[str, list] = {}  # label -> NUM_SAMPLES (cost_usd, latency_s) pairs
with ThreadPoolExecutor(max_workers=16) as pool:
    futures = {
        condition["label"]: [
            pool.submit(
                ask_llm_rubric,
                condition["model"],
                condition["mode"],
                condition["temp"],
                sample_index,
                RUBRIC_HASH,
            )
            for sample_index in range(NUM_SAMPLES)
        ]
        for condition in CONDITIONS
    }
    for label, sample_futures in futures.items():
        results = [future.result() for future in sample_futures]
        runs[label] = [result[0] for result in results]
        stats[label] = [(result[1], result[2]) for result in results]

# TypeSafe samples are drawn sequentially after the LLM calls. On a cached re-render nothing is
# called.
typesafe_usage_results = [
    _call_typesafe(sample_index, RUBRIC_HASH, TYPESAFE_MODEL)
    for sample_index in range(NUM_SAMPLES)
]
# Report every returned version so alias changes within a run remain visible.
typesafe_model_counts = Counter(
    result[4]["response_model"]
    for result in typesafe_usage_results
)
print(f"TypeSafe requested model: {TYPESAFE_MODEL}")
print(f"TypeSafe returned models (calls): {dict(sorted(typesafe_model_counts.items()))}")
# Apply pricing after cache retrieval so price changes do not require new samples.
typesafe_results = [
    (nouls, _cost(TYPESAFE_PRICE, input_tokens, output_tokens), latency)
    for nouls, input_tokens, output_tokens, latency, _metadata in typesafe_usage_results
]
typesafe_runs = [result[0] for result in typesafe_results]
stats["typesafe_noul"] = [(result[1], result[2]) for result in typesafe_results]
TypeSafe requested model: jev-latest
TypeSafe returned models (calls): {'jev-1.13.0': 15}Coût et vitesse (par requête de grille)
Les coûts ci-dessous utilisent les hypothèses de prix historiques de la Configuration, y
compris le tarif speed_latest pour TypeSafe. Ce ne sont ni des prix jev-latest vérifiés ni
des montants de facturation actuels.
Une ligne est un appel de grille complet de 14 questions. time/call et cost/call font la
moyenne des 15 appels, et les colonnes vs ts_noul divisent par les valeurs TypeSafe.
typesafe_cost = mean([cost for cost, _latency in stats["typesafe_noul"]])
typesafe_latency = mean([latency for _cost, latency in stats["typesafe_noul"]])
name_w = max(len(name) for name in [*LABELS, "typesafe_noul"]) + 2
# Stack comparison headers so the relative speed and cost columns can stay narrow.
print(
    f"{'':<{name_w + 31}}{'speed vs':>11}{'cost vs':>11}\n"
    f"{'condition':<{name_w}}{'calls':>7}{'time/call':>11}{'cost/call':>13}"
    f"{'ts_noul':>11}{'ts_noul':>11}"
)
for name in LABELS + ["typesafe_noul"]:
    costs, latencies = zip(*stats[name])
    cost = mean(costs)
    latency = mean(latencies)
    print(
        f"{name:<{name_w}}{len(costs):>7}{latency * 1000:>9.0f}ms"
        f"{'$' + format(cost, '.6f'):>13}"
        f"{format(latency / typesafe_latency, '.1f') + 'x':>11}"
        f"{format(cost / typesafe_cost, '.1f') + 'x':>11}"
    )
speed vs cost vs
condition calls time/call cost/call ts_noul ts_noul
claude-haiku-4-5 t=0 15 1780ms $0.001798 16.0x 42.2x
claude-haiku-4-5 t=default 15 1644ms $0.001798 14.8x 42.2x
claude-haiku-4-5 yes/no t=0 15 1485ms $0.001650 13.4x 38.8x
gpt-5.4-mini t=0 15 1405ms $0.001089 12.7x 25.6x
gpt-5.4-mini t=default 15 1177ms $0.001179 10.6x 27.7x
gpt-5.4-mini yes/no t=0 15 1113ms $0.000950 10.0x 22.3x
gpt-5.5-reasoning 15 11125ms $0.033157 100.2x 778.9x
claude-opus-4-8-reasoning 15 13886ms $0.034275 125.0x 805.1x
typesafe_noul 15 111ms $0.000043 1.0x 1.0xDans cette exécution, TypeSafe a une latence aller-retour moyenne de 111 ms. Les conditions LLM vont de 1,1 à 13,9 secondes par appel avec les réglages de concurrence ci-dessus.
Graphique : chaque échantillon sous forme de carte thermique
Comment le lire :
- Groupe de lignes externe : la question.
- Ligne interne : la condition.
- Colonne : un appel de grille complet.
- Couleur de cellule : rouge pour un P(oui) plus élevé, vert pour un plus bas. Pour les questions de risque, une cellule rouge est une que la grille a signalée.
typesafe_noul varie surtout sur covered (0.43 à 0.53) et exclusion (0.53 à 0.62).
Certaines lignes de LLM varient à température 0 aussi. Les conditions ne sont pas d’accord sur
les jugements.
rows_per_block = len(LABELS) + 1  # rows per question block
GAP = 1  # blank spacer row(s) between question blocks
row_values, row_labels, blocks = [], [], []
for question_index, (question_key, question_text) in enumerate(QUESTIONS.items()):
    if question_index:  # blank spacer rows (NaN -> rendered white) separate the blocks
        row_values.extend([np.nan] * NUM_SAMPLES for _ in range(GAP))
        row_labels.extend([""] * GAP)
    blocks.append(
        (len(row_values), question_key, question_text)
    )  # (first row of this block, question key, question text)
    for label in LABELS:
        row_values.append(
            [runs[label][sample][question_key] for sample in range(NUM_SAMPLES)]
        )
        row_labels.append(label)
    row_values.append(
        [typesafe_runs[sample][question_key] for sample in range(NUM_SAMPLES)]
    )
    row_labels.append("typesafe_noul")
heatmap_matrix = np.array(row_values)
cmap = plt.get_cmap("RdYlGn_r").copy()  # red = higher P(yes), green = lower P(yes)
cmap.set_bad("white")  # spacer (NaN) rows render as blank

fig, ax = plt.subplots(figsize=(11, 0.26 * len(row_values) + 1))
ax.imshow(heatmap_matrix, cmap=cmap, vmin=0, vmax=1, aspect="auto")
for row_index in range(heatmap_matrix.shape[0]):
    for col_index in range(heatmap_matrix.shape[1]):
        value = heatmap_matrix[row_index, col_index]
        if np.isnan(value):
            continue
        ax.text(
            col_index,
            row_index,
            f"{value:.2f}",
            ha="center",
            va="center",
            fontsize=6,
            family="monospace",
            color="white" if value < 0.22 or value > 0.78 else "black",
        )

ax.set_xticks(range(NUM_SAMPLES))
ax.set_xticklabels(range(1, NUM_SAMPLES + 1), fontsize=7)
ax.set_xlabel("rubric query")
ax.set_yticks(range(len(row_labels)))
ax.set_yticklabels(row_labels, fontsize=7)
ax.tick_params(length=0)
for edge in ("top", "right", "left", "bottom"):
    ax.spines[edge].set_visible(False)

# outer level of the multi-index: the question key, printed once per block and centered, with the
# question text wrapped right under it
y_axis_transform = ax.get_yaxis_transform()
for start, question_key, question_text in blocks:
    center = start + (rows_per_block - 1) / 2
    ax.text(
        -0.2,
        center - 0.7,
        question_key,
        transform=y_axis_transform,
        ha="right",
        va="center",
        fontsize=8,
        fontweight="bold",
    )
    ax.text(
        -0.2,
        center + 0.1,
        textwrap.fill(question_text, 34),
        transform=y_axis_transform,
        ha="right",
        va="top",
        fontsize=6,
        style="italic",
        color="gray",
    )

ax.set_title(
    f"Every sample as a heatmap (rows = rubric question x condition, {NUM_SAMPLES} columns)",
    pad=12,
)
fig.tight_layout()
display(fig)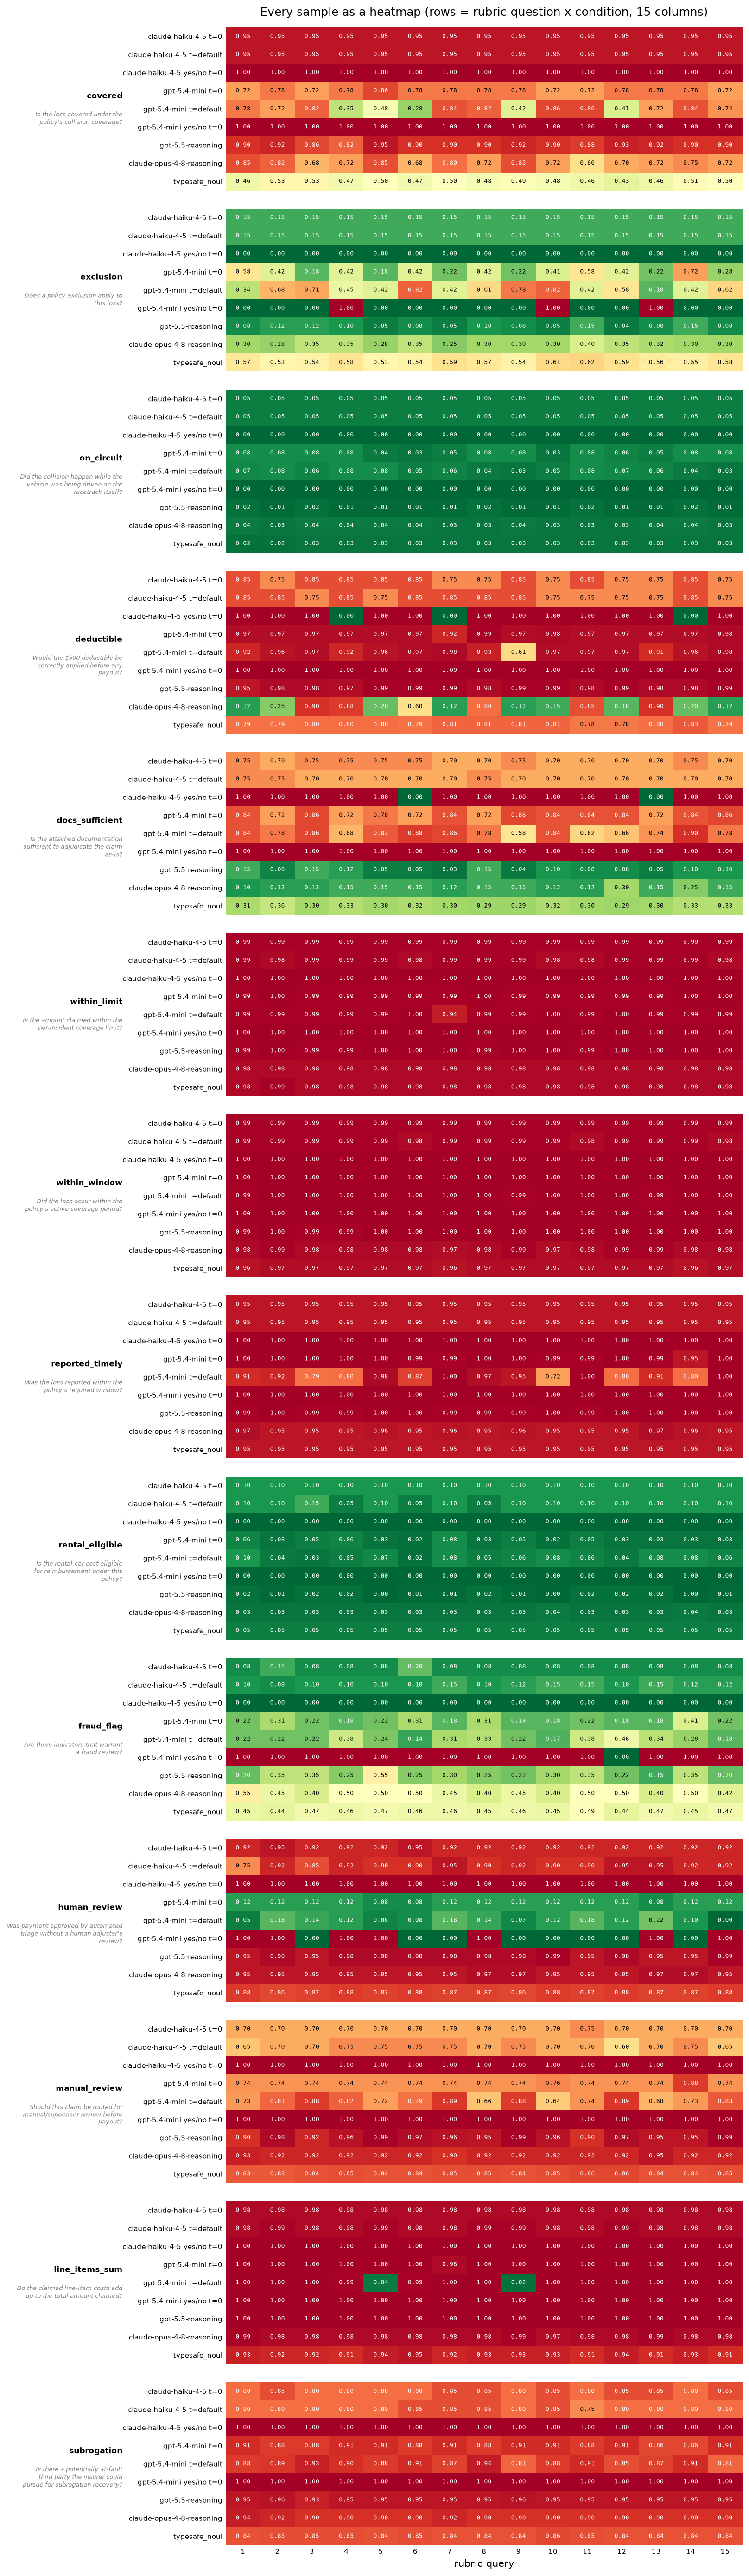
Les contrôles factuels restent stables dans la plupart des conditions. Ce sont les contrôles
très subjectifs où les lignes de LLM bougent : exclusion, rental_eligible, fraud_flag et
manual_review varient d’un échantillon à l’autre ou divergent d’un modèle à l’autre. La ligne
covered de TypeSafe franchit 0.5 ; ses 13 autres questions restent d’un seul côté de ce
seuil pendant toute cette exécution.
Laisser place à une décision incertaine au lieu de forcer un oui ou un non
Avec un seuil de 0.5, les probabilités 0.49 et 0.51 entraînent des actions opposées alors
que toutes deux expriment une incertitude importante. L’application peut à la place renvoyer :
noen dessous de0.30;uncertainde0.30à0.70, bornes comprises ;yesau-dessus de0.70.
Les cas incertains vont à un humain. L’escalade est de la logique applicative posée sur la probabilité renvoyée : pas de nouvelle question, pas de second appel API. La bande est illustrative ; ce n’est ni une garantie calibrée ni un seuil optimisé. Fixe les bornes de production à partir d’exemples étiquetés et du coût des décisions incorrectes et de la revue.
L’illustration ci-dessous applique cette bande aux probabilités TypeSafe enregistrées.
def noul_decision_with_uncertainty(probability: float) -> str:
    """Map valid TypeSafe probabilities through an inclusive uncertainty band."""
    if probability < NOUL_UNCERTAINTY_LOW:
        return "no"
    if probability > NOUL_UNCERTAINTY_HIGH:
        return "yes"
    return "uncertain"

# Keep the probabilities visible beneath each TypeSafe application decision.
policy_decisions = [
    [noul_decision_with_uncertainty(sample[key]) for sample in typesafe_runs]
    for key in QUESTIONS
]
decision_codes = {"no": 0, "uncertain": 1, "yes": 2}
policy_values = [
    [decision_codes[value] for value in row] for row in policy_decisions
]
policy_cmap = ListedColormap(["#a6dba0", "#dddddd", "#92c5de"])
fig_policy, ax_policy = plt.subplots(figsize=(13, 6))
ax_policy.imshow(policy_values, cmap=policy_cmap, vmin=0, vmax=2, aspect="auto")
for row_index, key in enumerate(QUESTIONS):
    for sample_index in range(NUM_SAMPLES):
        decision = policy_decisions[row_index][sample_index]
        probability = typesafe_runs[sample_index][key]
        ax_policy.text(sample_index, row_index, f"{decision}\n{probability:.2f}",
                       ha="center", va="center", fontsize=6)
ax_policy.set_yticks(range(len(QUESTIONS)), list(QUESTIONS))
ax_policy.set_xticks(range(NUM_SAMPLES), range(1, NUM_SAMPLES + 1))
ax_policy.set_xlabel("rubric query")
ax_policy.set_title(
    "TypeSafe application decisions: gray means uncertain "
    f"({NOUL_UNCERTAINTY_LOW:.2f} to {NOUL_UNCERTAINTY_HIGH:.2f} inclusive)"
)
fig_policy.tight_layout()
display(fig_policy)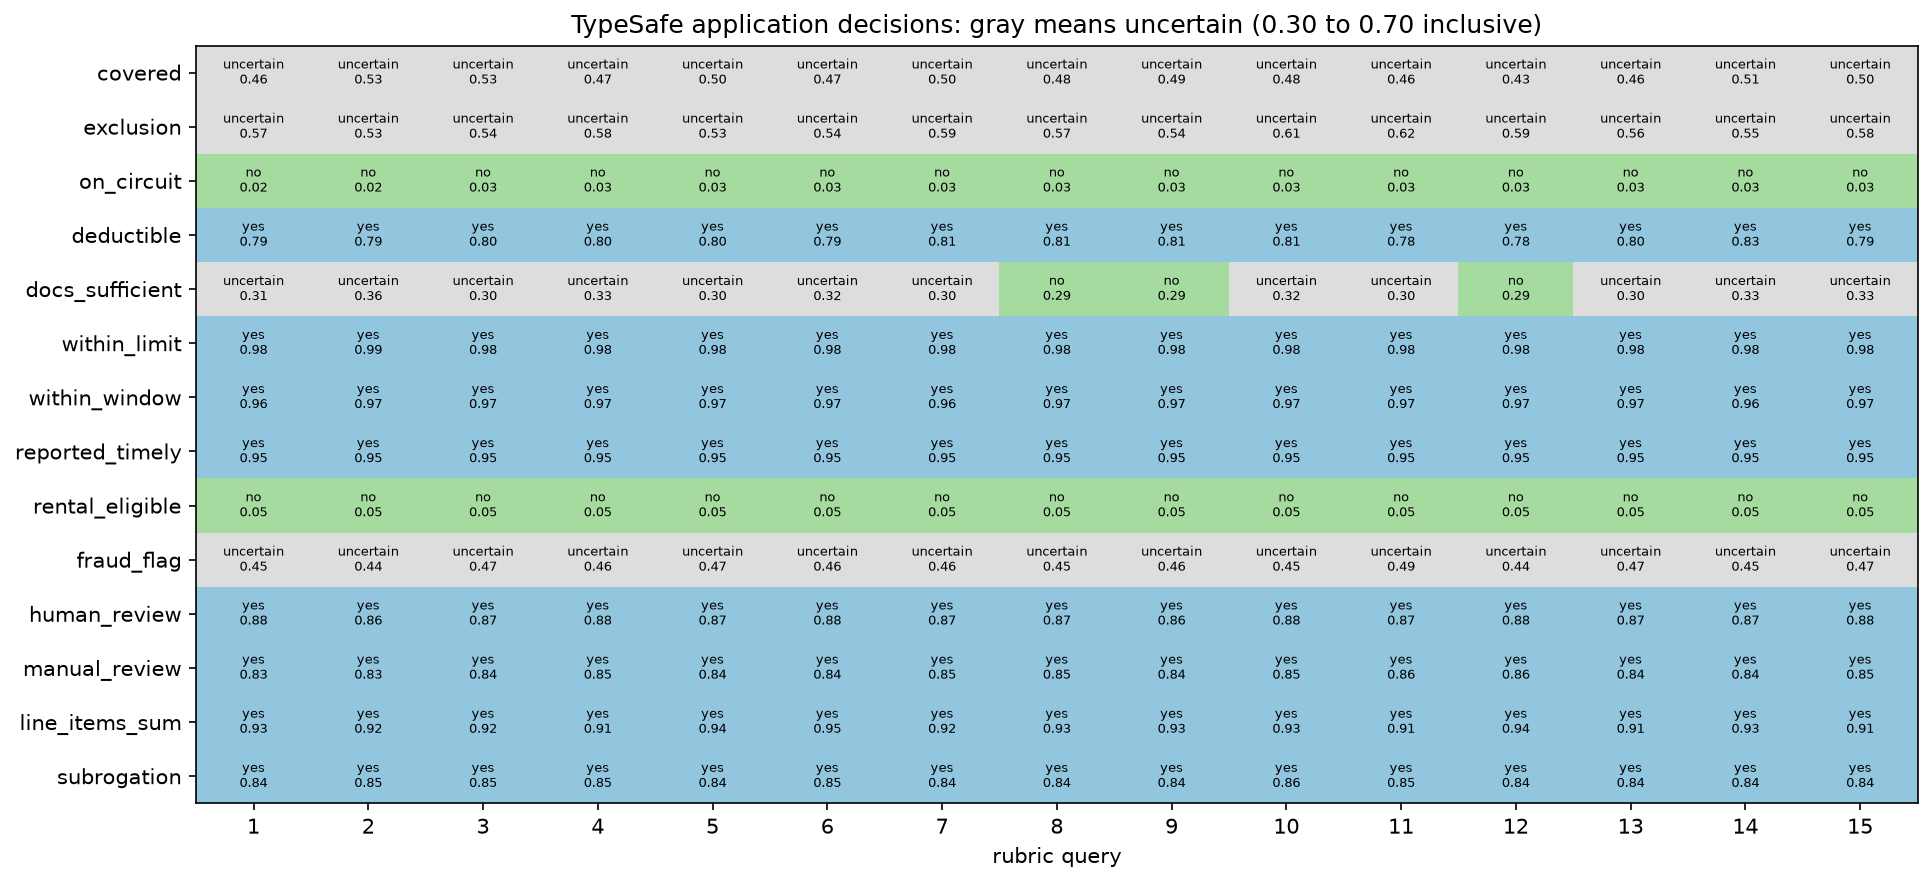
Une bande de revue absorbe les fluctuations autour de 0.5 sans émettre d’actions automatiques
opposées. Elle a cependant ses propres bords. Une valeur proche de l’une ou l’autre borne
extérieure peut encore basculer entre uncertain et oui ou non. Le modèle n’en est pas plus
déterministe pour autant, et une décision automatique qui franchit la bande n’est pas démontrée
correcte.
Ouvre-le dans le playground TypeSafe
Le lien ci-dessous ouvre la même déclaration et la même grille dans le playground : une
déclaration, les mêmes 14 questions Noul, et TypeSafe jev-latest. Il omet le champ uid
changeant utilisé plus haut.
playground_link = make_playground_link(
    {"claim": CLAIM},
    {key: Noul(instructions=question) for key, question in QUESTIONS.items()},
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this claim + rubric in the TypeSafe playground]({playground_link})"
    )
)