Cascade de SDE
Utilise une cascade d’extraction de données structurées en 2 étapes (mini → vérifier → raisonnement) pour obtenir l’essentiel de la qualité d’un grand modèle de raisonnement à une fraction du coût.
- Vue d’ensemble
- les grands modèles de raisonnement extraient bien les données structurées, mais sont lents et coûteux
- les petits modèles sont bon marché, mais font des erreurs
- une cascade obtient l’essentiel de la qualité à une fraction du coût
- les modèles que nous utilisons, et leur prix ($ par million de jetons, entrée / sortie ;
tarifs standards vérifiés le 15 septembre 2026) :
- échelon 0 (mini) :
gpt-5.4-minià $0,75 / $4,50 - échelon 1 (raisonnement) :
gpt-5.5à $5,00 / $30,00 (environ 7x le mini) - vérificateur : TypeSafe
jev-1.12à $0,042 / $0,00 (les jetons de sortie sont gratuits ; tarification Jev publiée)
- échelon 0 (mini) :
- Algorithme
- Extraire avec un modèle bon marché/petit.
- Vérifier avec les primitives TypeSafe : une question oui/non par champ
(« question Noul »)
- (p. ex. « cette valeur est-elle absente de la source ? », « a-t-elle été tirée d’un texte sans rapport ? »), chacune renvoyant P(quelque chose ne va pas).
- Escalader vers un modèle de raisonnement coûteux si un signal de vérification se déclenche ; sinon, garder la réponse bon marché.
- Ce cookbook
- déroule un exemple réel de bout en bout, puis montre le compromis sur 100 prompts
- note : les deux échelons d’extraction utilisent OpenAI en mode texte
- nous n’utilisons pas les sorties structurées, les appels d’outils ni le mode json, parce
que :
- une erreur de suivi de schéma n’est pas l’erreur qu’on attend d’un LLM (il est facile de fabriquer des données synthétiques pour ça)
- si un LLM échoue vraiment à suivre le schéma, c’est presque toujours qu’il est très confus, donc le décodage contraint ne règle pas le problème sous-jacent
- nous t’encourageons quand même à les essayer !
Configuration
- installe les dépendances (le client vérificateur TypeSafe est servi depuis l’index de paquets de TypeSafe) :
pip install openai datasets jsonschema ipython 'cooksafe>=0.2.0,<0.3.0'- puis définis
OPENAI_API_KEYetTYPESAFE_API_KEYdans ton environnement
import json
import os
from pathlib import Path

import jsonschema
from cooksafe import JsonCache, make_playground_link
from datasets import load_dataset
from IPython.display import Markdown, display
from openai import OpenAI
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

MINI = "gpt-5.4-mini"  # rung 0: cheap + fast
REASONING = "gpt-5.5"  # rung 1: strong, run with reasoning_effort="high"
TS_MODEL = "jev-1.12"  # the TypeSafe verifier model
FIRE_T = 0.7  # escalate if any per-field P(wrong) exceeds this; also the "<== FIRES" display marker

oai = OpenAI()

ts = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"], timeout=30.0)
Étape 1 : les données
Nous choisissons un jeu de données huggingface appelé scrapegraphai
SCRAPEGRAPHAI_REVISION = "4bb9fba1dff9181c5acdb60a5a26fea62fa54fe9"
row = load_dataset(
    "scrapegraphai/scrapegraphai-100k",
    revision=SCRAPEGRAPHAI_REVISION,
    split="train",
)[516]
schema = json.loads(row["schema"])
prompt = row["prompt"]
content = row["content"]

print(
    f"""
PROMPT
===========
{prompt}

SCHEMA
===========
{json.dumps(schema, indent=2)}

CONTENT
===========
{content}
""".strip()
)
PROMPT
===========
Find registration open date fall semester for New York University in New York, NY for the 2024-2025 school year.
SCHEMA
===========
{
"properties": {
"registration_open_date": {
"description": "The date that registration opens for the fall semester. MUST be in the format mm/dd/yyyy. For example, for a college in the 2024-2025 school year, it might be something like 09/05/2024. Return a blank string if you are unsure.",
"title": "Registration Open Date",
"type": "string"
},
"description": {
"description": "A brief description of the registration open date. For example, 'Registration opens for the fall semester'.",
"title": "Description",
"type": "string"
}
},
"required": [
"registration_open_date",
"description"
],
"title": "RegistrationOpen",
"type": "object"
}
CONTENT
===========
Skip to content Skip to current page navigation
[ ](https://www.nyu.edu/)
Search Site
[ ](https://www.nyu.edu/)
* [ Academics](https://www.nyu.edu/academics.html)
* [ Admissions](https://www.nyu.edu/admissions.html)
* [ Research](https://www.nyu.edu/research.html)
* [ University Life](https://www.nyu.edu/life.html)
* [ About](https://www.nyu.edu/about.html)
All NYU
# Mobile Navigation
[ ](https://www.nyu.edu/)
Search Site
* [Academics](https://www.nyu.edu/academics.html)
* [Admissions](https://www.nyu.edu/admissions.html)
* [Research](https://www.nyu.edu/research.html)
* [University Life](https://www.nyu.edu/life.html)
* [About](https://www.nyu.edu/about.html)
All NYU
Info for
* Back to main menu
* Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](http://home.nyu.edu/)
Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](https://home.nyu.edu/)
Search Site Search
# Events Calendar
Search Events
Apply Reset
* [About the Events Calendar ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar.html)
* [Events Calendar Tutorial ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar/tutorials.html)
* [Report issue or provide feedback ](https://nyu.service-now.com/sp?id=sc_cat_item&sys_id=7698dd2a98bcf4004c8c03063d84e274)
Search Filters Calendar
New York University
Equal Opportunity and Non-Discrimination at NYU - New York University is committed to maintaining an environment that encourages and fosters respect for individual values and appropriate conduct among all persons. In all University spaces--physical and digital--programming, activities, and events are carried out in accordance with applicable law as well as University policy, which includes but is not limited to its Non-Discrimination and Anti-Harassment Policy.
Unless otherwise noted, all content copyright New York University. All rights reserved.
* [Search](https://search.nyu.edu/)
* [Campus Map](https://www.nyu.edu/map.html)
* [Events](https://events.nyu.edu/)
* [Contact Us](https://www.nyu.edu/contact-us.html)
* [Give](https://www.nyu.edu/about/giving.html)
* [Copyright & Fair Use](https://www.nyu.edu/copyright-and-fair-use.html)
* [Privacy](https://www.nyu.edu/privacy.html)
* [Accessibility](https://www.nyu.edu/accessibility.html)
* [Feedback](https://www.nyu.edu/#feedback.html)
* [New York Campus](https://www.nyu.edu/)
* [Abu Dhabi Campus](https://nyuad.nyu.edu/)
* [Shanghai Campus](https://shanghai.nyu.edu/)
* [](https://facebook.com/)
* [](https://linkedin.com/)
* [](https://x.com/)
* [](https://instagram.com/)
* [](https://youtube.com/)- Cette ligne est une page de calendrier d’événements de la NYU (« Fall 2024 Census Date ») :
- le schéma ne demande que deux champs :
registration_open_dateetdescription - le scrape du prompt n’a capturé que la navigation du calendrier et du texte de remplissage : il n’y a aucune date d’inscription, ni description
- note que le champ
descriptiondu schéma embarque même une valeur d’exemple (« Registration opens for the fall semester ») dans sa propre description de champ
- le schéma ne demande que deux champs :
- donc un extracteur bien élevé devrait refuser d’inventer les champs que la page ne contient pas
- voyons si le petit modèle fait ce qu’il faut !
Étape 2 : extraire avec le modèle mini (mode texte)
- note :
gpt-5.4-miniest très stochastique sur cette entrée – même àtemperature=0il invente unedescriptiondifférente à presque chaque exécution. Pour une démonstration reproductible, nous codons en dur l’unique fabrication canonique que le reste de ce notebook explique (et que le vérificateur signale à P(wrong) > 0,8). Un vrai pipeline prendrait simplementextract(MINI, prompt, schema, content, temperature=0)directement.
EXTRACT_SYSTEM = (
    "You extract structured data from documents. Return only values supported by the text. "
    "Follow any value format specified by the schema or its field descriptions."
)

# LLM and TypeSafe calls are cached to ``json_cache.json``, which ships with the cookbook, so
# re-rendering reproduces the published results with no API spend; delete the file to re-run live.
json_cache = JsonCache(Path("json_cache.json"))

@json_cache
def extract(
    model: str,
    prompt: str,
    schema: dict,
    content: str,
    *,
    reasoning_effort: str | None = None,
    temperature: float | None = None,
) -> dict:
    user = (
        f"{prompt}\n\nReturn ONLY a JSON object matching this JSON Schema:\n"
        f"{json.dumps(schema, indent=2)}\n\nDocument:\n{content}"
    )
    kwargs = {
        "model": model,
        "messages": [
            {"role": "system", "content": EXTRACT_SYSTEM},
            {"role": "user", "content": user},
        ],
    }
    if reasoning_effort:
        kwargs["reasoning_effort"] = reasoning_effort
    if temperature is not None:
        kwargs["temperature"] = temperature
    text = oai.chat.completions.create(**kwargs).choices[0].message.content
    # The prompt asks for ONLY a JSON object, so parse the reply as-is -- no regex fishing a
    # substring out of a malformed reply. If ``json.loads`` fails, treat it as an empty extraction
    # (the record-level analog of NaN): every field reads as absent, which the verifier flags and the
    # gate escalates -- the safe direction. Schema-following errors are rare here (see the overview).
    try:
        return json.loads(text)
    except (ValueError, json.JSONDecodeError):
        return {}

# Hard-coded canonical fabrication (see note above); a real pipeline would use extract(MINI, prompt, schema, content, temperature=0).
mini_record = {
    "registration_open_date": "",
    "description": "Registration opens for the fall semester",
}
print("mini extraction:\n", json.dumps(mini_record, indent=2))

# The record is a perfect fit for the JSON Schema -- and still wrong. Schema validation is necessary
# but not sufficient: it catches structural errors, never semantic ones. That gap is the whole point.
print("\nschema-valid:", jsonschema.Draft202012Validator(schema).is_valid(mini_record))
mini extraction:
{
"registration_open_date": "",
"description": "Registration opens for the fall semester"
}
schema-valid: True- L’enregistrement est valide vis-à-vis du schéma (la ligne ci-dessus imprime
True), et pourtant il est faux :registration_open_dateest laissé vide, ce qui correspond à la page : elle n’énonce aucune date- mais
descriptionest fabriqué : la page ne décrit jamais de date d’inscription, donc mini en invente une plausible. Il peut répéter comme un perroquet l’exemple du schéma, « Registration opens for the fall semester », ou raconter « …was not found in the document » - une vérification JSON-Schema ne peut pas le voir. Un modèle bon marché produit des fabrications confiantes et conformes au schéma de ce genre, et les attraper est le travail d’un vérificateur sémantique
Étape 3 : vérifier avec TypeSafe
- le vérificateur est TypeSafe ; pour chaque champ nous construisons une question
Noul:- un oui/non étroit, formulé de sorte que
true= quelque chose ne va pas (escalader)
- un oui/non étroit, formulé de sorte que
- TypeSafe renvoie un
noulcalibré =P(true)par question, en un seul appel system_one - l’ensemble de questions :
- une tête holistique
__overall__::judge(« cet enregistrement doit-il être escaladé ? »). Nous la calculons et l’affichons pour opposer un jugement sur l’enregistrement entier aux têtes par champ, mais la porte de l’étape 4 ne l’utilise pas – l’escalade est pilotée par la batterie par champ. - une batterie par champ
- les champs non vides reçoivent l’ensemble complet des têtes
- les champs vides (null / “” / []) ne reçoivent que la tête
absence_wrong
- (le pipeline complet a aussi une tête
spuriouspour les conteneurs entiers et un score globaldifficulty; non montrés ici, pour limiter cette démonstration aux deux têtes de déclenchement)
- une tête holistique
- La méthode TypeSafe : la décomposition
- Remarque comme tout est décomposé par programme, c’est la méthode TypeSafe.
- La décomposition maximise l’intelligence de chaque prompt, et rend l’algorithme réglable et interprétable.
-
# metric -> (question, NoulCriteria)
MAIN_QUESTIONS = {
    "name_desc_mismatch": (
        "Does the `extracted_field` fail to match the field at `path` or the `description` in the "
        "`field_spec`? If the `description` is empty, judge against the `path` alone.",
        NoulCriteria(
            true="the `extracted_field` does not match the field name or its `description`",
            false="the `extracted_field` matches the field name and `description`",
        ),
    ),
    "type_mismatch": (
        "Does the `extracted_field` violate the `type` declared in the `field_spec`?",
        NoulCriteria(
            true="the `extracted_field` violates the declared `type`",
            false="the `extracted_field` conforms to the declared `type`",
        ),
    ),
    "unreasonable": (
        "Is the `extracted_field` one that a reasonable person would not have extracted for this "
        "`field_spec`?",
        NoulCriteria(
            true="a reasonable person would not have extracted this value",
            false="the extraction is reasonable",
        ),
    ),
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    "off_target": (
        "Does the source text fail to genuinely report the thing the `field_spec` describes, so the "
        "value was pulled from incidental text?",
        NoulCriteria(
            true="the source does not genuinely provide this field -- the value was pulled "
            "from incidental text",
            false="the source genuinely reports this field",
        ),
    ),
    "incomplete": (
        "Does the `extracted_field` fail to capture a value the source supports (note whether the "
        "`field_spec` is `required`)?",
        NoulCriteria(
            true="the field is wrongly empty, null, or missing a value the source supports",
            false="the field captures the value the source supports",
        ),
    ),
    "format_violation": (
        "Does the `extracted_field` violate the format or constraints implied by the `description`, "
        "the schema `type`, and the extraction instructions (e.g. date format, units, enum membership)?",
        NoulCriteria(
            true="the `extracted_field` violates the implied format or constraints",
            false="the `extracted_field` satisfies the format and constraints",
        ),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text contain the "
    "information the `field_spec` describes, making the empty result wrong?"
)
ABSENCE_CRITERIA = NoulCriteria(
    true="a value was wrongly omitted", false="returning nothing is correct"
)

# The pipeline also asks one holistic, whole-record head: "should this be escalated?"
OVERALL_JUDGE = (
    "Is this extracted record an incorrect extraction -- some value unsupported by the source or "
    "not conforming to the schema, required information missing or wrong, or some field hallucinated -- "
    "so it should be escalated to a smarter model?"
)
OVERALL_JUDGE_CRITERIA = NoulCriteria(
    true="the record is an incorrect extraction",
    false="the record is a correct extraction",
)

def is_empty(v) -> bool:
    return v is None or (isinstance(v, (str, list, dict)) and len(v) == 0)

def field_spec(name: str) -> dict:
    """Minimal spec pulled from the schema (unwrapping anyOf/null for optional fields)."""
    p = schema["properties"][name]
    branches = p.get("anyOf") or []
    typ = p.get("type") or next(
        (b["type"] for b in branches if b.get("type") != "null"), "unknown"
    )
    return {
        "path": name,
        "type": typ,
        "description": p.get("description", ""),
        "required": name in schema.get("required", []),
    }

def build_questions(record: dict) -> dict[str, Noul]:
    """The verify question set: one holistic ``__overall__::judge`` head plus a per-field battery,
    keyed ``field::metric`` (mirrors build_verify_prompts)."""
    questions: dict[str, Noul] = {
        "__overall__::judge": Noul(
            instructions=OVERALL_JUDGE, criteria=OVERALL_JUDGE_CRITERIA
        ),
    }
    for name, value in record.items():
        spec = field_spec(name)
        if is_empty(value):
            questions[f"{name}::absence_wrong"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": ABSENCE_QUESTION,
                },
                criteria=ABSENCE_CRITERIA,
            )
            continue
        for metric, (question, criteria) in MAIN_QUESTIONS.items():
            if metric == "type_mismatch" and spec["type"] == "unknown":
                continue
            questions[f"{name}::{metric}"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": question,
                },
                criteria=criteria,
            )
    return questions

@json_cache
def verify(record: dict) -> dict[str, float | str]:
    """Run the whole Noul battery over a record in one TypeSafe call; return ``{field::metric: P(true)}``."""
    state = {
        "system_message": EXTRACT_SYSTEM,
        "instruction": "Extract the structured record from this document",
        "source_text": row["content"],
        "schema": schema,
        "extraction": record,
    }
    questions = build_questions(record)
    answers = ts.system_one(state=state, questions=questions, model=TS_MODEL).answers
    return {qid: ans.noul for qid, ans in answers.items()} | {
        "playground_link": make_playground_link(state, questions)
    }
Lancer toute la batterie sur l’extraction mini
checks = verify(mini_record)
playground_link = checks.pop("playground_link")
display(
    Markdown(
        f"🔗 [Open this verification in the TypeSafe playground]({playground_link})"
    )
)

print(f"{'qid':<40}{'P(wrong)':>9}")
print("-" * 50)
for fld, p in sorted(checks.items(), key=lambda c: -c[-1]):
    flag = "  <== FIRES" if p > FIRE_T else ""
    print(f"{fld:<40}{p:>9.2f}{flag}")
qid P(wrong)
--------------------------------------------------
description::hallucinated 0.95 <== FIRES
description::off_target 0.85 <== FIRES
description::unreasonable 0.58
__overall__::judge 0.56
description::incomplete 0.16
registration_open_date::absence_wrong 0.14
description::format_violation 0.10
description::name_desc_mismatch 0.08
description::type_mismatch 0.02- TypeSafe concentre le signal sur les champs réellement faux.
- Nos résultats sont calibrés : élevés sur le champ faux, bas sur le champ correct, moyens sur un champ qui semble suspect sans être clairement faux
- C’est ce qu’un vérificateur typesafe t’apporte face à un juge grossier du type « est-ce que tout ça est bien ? »
Étape 4 : la porte d’escalade
- maintenant nous déclenchons sur
any_flag: escalader si un drapeau de champ dépasseFIRE_T(0,7, défini plus haut et partagé avec le marqueur<== FIRESde l’étape 3) - c’est une porte de type
max(escalader si un champ se déclenche), pas une moyenne, donc un seul drapeau rouge confiant suffit au lieu d’être noyé dans une moyenne
# any_flag is a per-field gate: the holistic __overall__ head is shown above but not part of it
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > FIRE_T
}
escalate = bool(fired)

print(
    f"any_flag gate (threshold {FIRE_T}): {'ESCALATE' if escalate else 'ACCEPT cheap result'}"
)
for qid, p in sorted(fired.items(), key=lambda c: -c[1]):
    print(f"  fired: {qid}  (P={p:.2f})")
any_flag gate (threshold 0.7): ESCALATE
fired: description::hallucinated (P=0.95)
fired: description::off_target (P=0.85)Étape 5 : escalader vers le modèle de raisonnement
Comme un signal s’est déclenché, nous payons le modèle fort (gpt-5.5, reasoning_effort="high")
final_record = (
    extract(REASONING, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)

print("mini      :", json.dumps(mini_record))
print("reasoning :", json.dumps(final_record))
print("\nfield-level diff (mini -> final):")
for name in mini_record:
    if mini_record[name] != final_record.get(name):
        print(f"  {name}: {mini_record[name]!r}  ->  {final_record.get(name)!r}")
mini : {"registration_open_date": "", "description": "Registration opens for the fall semester"}
reasoning : {"description": "", "registration_open_date": ""}
field-level diff (mini -> final):
description: 'Registration opens for the fall semester' -> ''- L’amélioration
- Le modèle de raisonnement abandonne la
descriptionfabriquée et renvoie"" - Il a reconnu que la page ne décrit jamais de date d’inscription, et a refusé d’en inventer une
- La cascade a transformé une fabrication confiante et valide vis-à-vis du schéma en un champ vide honnête
- Et elle n’a dépensé des dollars de modèle de raisonnement que sur cet élément parce que le vérificateur le lui a dit
- Le modèle de raisonnement abandonne la
Étape 6 : à quoi cela ressemble sur 100 prompts
- Ce sont des résultats internes de TypeSafe, produits avec la méthode générale ci-dessus :
- la même boucle
extract → verify → escalate,gpt-5.4-mini → gpt-5.5-reasoning, porteany_flagsur les têtes par champ, exécutée sur 100 prompts scrapegraphai - l’extraction de l’échelon bon marché de chaque élément est notée par TypeSafe ; le seuil de la porte (« cut ») est balayé de 0→1, et chaque configuration résultante est tracée dans l’espace (coût, qualité)
- le graphique est un instantané historique ; ses coûts n’ont pas été recalculés au tarif Jev actuel indiqué plus haut
- la même boucle
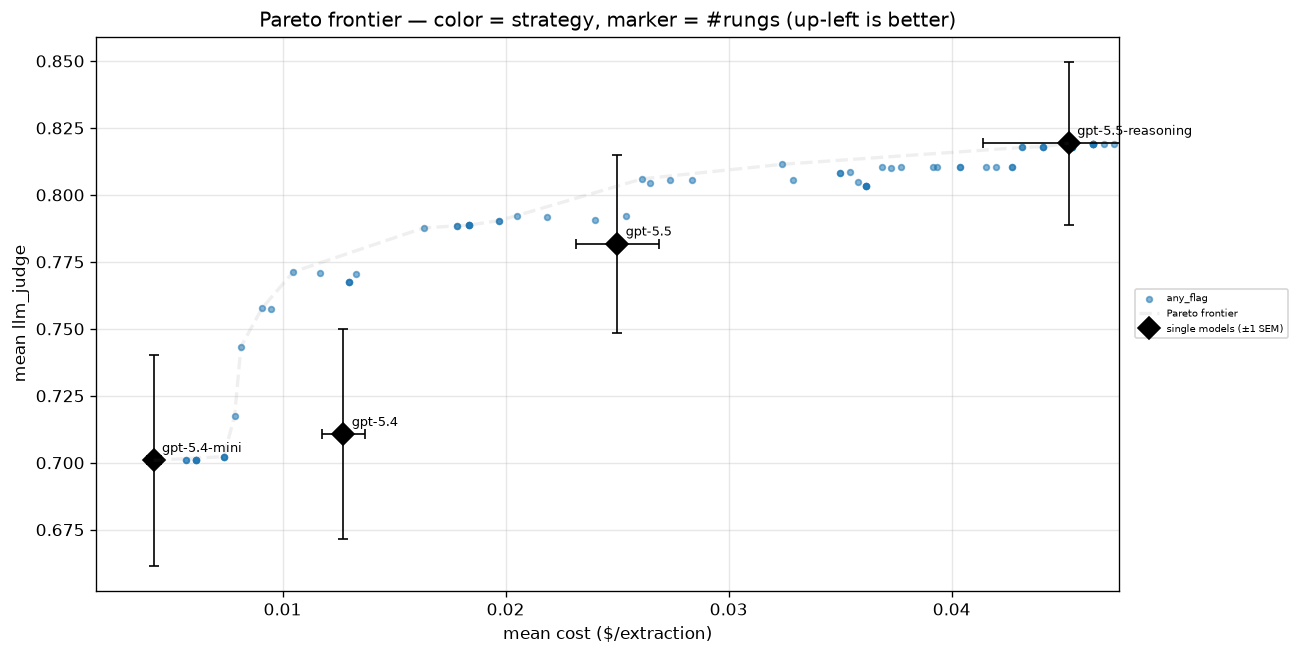
- comment le lire :
- losanges noirs = les quatre modèles exécutés seuls (le coût grimpe avec la capacité ;
le plus fort,
gpt-5.5-reasoning, se situe en haut à droite à ≈0,81 de qualité pour ≈$0,10/extraction) - points bleus = la cascade à de nombreux seuils de porte ; la ligne en pointillés est la frontière de Pareto
- la frontière de la cascade se situe en haut à gauche de chaque modèle : balayer la porte t’achète l’essentiel de la qualité du meilleur modèle à une fraction de son coût
- l’échelon bon marché traite les éléments faciles pour presque rien, et seuls les éléments signalés paient le modèle de raisonnement
- losanges noirs = les quatre modèles exécutés seuls (le coût grimpe avec la capacité ;
le plus fort,
Annexe A : ce qui fait un bon signal de vérificateur
- la cascade ne vaut que ce que vaut son vérificateur ; ce qui sépare un signal utile d’un
signal inutile :
- Étroit et ancré.
- un oui/non vérifiable sur un champ face à la source (p. ex. « cette valeur est-elle absente de la source ? »), pas un vague « cette extraction est-elle bonne ? »
- les questions vagues donnent des scores mous et non calibrés
- Mauvais = TRUE, avec des critères explicites.
- formule chaque question pour que le cas escalader soit le cas
true, et énonce ce que signifienttrue/false
- formule chaque question pour que le cas escalader soit le cas
- Par champ, puis agrégé avec
max.- un drapeau par champ localise l’erreur et reste rare et fort
max(« un drapeau se déclenche ») garantit qu’un seul drapeau rouge confiant escalade, au lieu d’être noyé dans une moyenne
- Indépendant et bon marché.
- un vérificateur dédié (ici, TypeSafe) qui juge la sortie attrape les angles morts de l’extracteur lui-même
- il doit être bon marché, sinon il ne reste aucune économie à capturer
- Séparant / calibré.
- un bon signal est élevé sur les vraies erreurs et bas sur les correctes, donc un seuil unique sépare proprement accepter et escalader
- c’est cette séparation qui pousse la courbe de Pareto en haut à gauche
- Étroit et ancré.