SDE-Kaskade
Nutzt eine zweistufige Kaskade zur Extraktion strukturierter Daten (mini → verifizieren → Reasoning), um den größten Teil der Qualität eines großen Reasoning-Modells zu einem Bruchteil der Kosten zu bekommen.
- Überblick
- große Reasoning-Modelle extrahieren strukturierte Daten gut, sind aber langsam und teuer
- kleine Modelle sind günstig, machen aber Fehler
- eine Kaskade holt den größten Teil der Qualität zu einem Bruchteil der Kosten
- die Modelle, die wir nutzen, und ihr Preis ($ pro 1M Token, Eingabe / Ausgabe; Standardtarife
geprüft am 15. September 2026):
- Stufe 0 (mini):
gpt-5.4-minizu $0.75 / $4.50 - Stufe 1 (Reasoning):
gpt-5.5zu $5.00 / $30.00 (ungefähr 7x das mini) - Verifizierer: TypeSafe
jev-1.12zu $0.042 / $0.00 (Ausgabe-Token sind gratis; veröffentlichte Jev-Preise)
- Stufe 0 (mini):
- Algorithmus
- Extrahieren mit einem günstigen/kleinen Modell.
- Verifizieren mit TypeSafe-Primitiven: eine Ja/Nein-Frage pro Feld („Noul-Frage“),
- (z. B. „fehlt dieser Wert in der Quelle?“, „wurde er aus unzusammenhängendem Text gehoben?“), die jeweils P(etwas stimmt nicht) zurückgibt.
- Eskalieren zu einem teuren Reasoning-Modell, wenn ein Verifizierer-Signal auslöst; sonst die günstige Antwort behalten.
- Dieses Cookbook
- führt ein echtes Beispiel von Anfang bis Ende durch, dann zeigt es den Tradeoff über 100 Prompts
- Hinweis: die beiden Extraktionsstufen nutzen OpenAI im Textmodus
- wir nutzen keine strukturierten Ausgaben, Tool-Aufrufe oder den JSON-Modus, weil:
- ein Fehler beim Schema-Befolgen nicht der Fehler ist, den wir von einem LLM erwarten (es ist leicht, synthetische Daten dafür zu erzeugen)
- wenn ein LLM das Schema tatsächlich nicht befolgt, ist es fast immer sehr verwirrt, also behebt constrained decoding das zugrunde liegende Problem nicht
- wir ermutigen dich aber, sie auszuprobieren!
Einrichtung
- installiere die Abhängigkeiten (der TypeSafe-Verifizierer-Client wird über TypeSafes Paketindex bereitgestellt):
pip install openai datasets jsonschema ipython 'cooksafe>=0.2.0,<0.3.0'- setze dann
OPENAI_API_KEYundTYPESAFE_API_KEYin deiner Umgebung
import json
import os
from pathlib import Path

import jsonschema
from cooksafe import JsonCache, make_playground_link
from datasets import load_dataset
from IPython.display import Markdown, display
from openai import OpenAI
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

MINI = "gpt-5.4-mini"  # rung 0: cheap + fast
REASONING = "gpt-5.5"  # rung 1: strong, run with reasoning_effort="high"
TS_MODEL = "jev-1.12"  # the TypeSafe verifier model
FIRE_T = 0.7  # escalate if any per-field P(wrong) exceeds this; also the "<== FIRES" display marker

oai = OpenAI()

ts = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"], timeout=30.0)
Schritt 1: Die Daten
Wir wählen einen Hugging-Face-Datensatz namens scrapegraphai
SCRAPEGRAPHAI_REVISION = "4bb9fba1dff9181c5acdb60a5a26fea62fa54fe9"
row = load_dataset(
    "scrapegraphai/scrapegraphai-100k",
    revision=SCRAPEGRAPHAI_REVISION,
    split="train",
)[516]
schema = json.loads(row["schema"])
prompt = row["prompt"]
content = row["content"]

print(
    f"""
PROMPT
===========
{prompt}

SCHEMA
===========
{json.dumps(schema, indent=2)}

CONTENT
===========
{content}
""".strip()
)
PROMPT
===========
Find registration open date fall semester for New York University in New York, NY for the 2024-2025 school year.
SCHEMA
===========
{
"properties": {
"registration_open_date": {
"description": "The date that registration opens for the fall semester. MUST be in the format mm/dd/yyyy. For example, for a college in the 2024-2025 school year, it might be something like 09/05/2024. Return a blank string if you are unsure.",
"title": "Registration Open Date",
"type": "string"
},
"description": {
"description": "A brief description of the registration open date. For example, 'Registration opens for the fall semester'.",
"title": "Description",
"type": "string"
}
},
"required": [
"registration_open_date",
"description"
],
"title": "RegistrationOpen",
"type": "object"
}
CONTENT
===========
Skip to content Skip to current page navigation
[ ](https://www.nyu.edu/)
Search Site
[ ](https://www.nyu.edu/)
* [ Academics](https://www.nyu.edu/academics.html)
* [ Admissions](https://www.nyu.edu/admissions.html)
* [ Research](https://www.nyu.edu/research.html)
* [ University Life](https://www.nyu.edu/life.html)
* [ About](https://www.nyu.edu/about.html)
All NYU
# Mobile Navigation
[ ](https://www.nyu.edu/)
Search Site
* [Academics](https://www.nyu.edu/academics.html)
* [Admissions](https://www.nyu.edu/admissions.html)
* [Research](https://www.nyu.edu/research.html)
* [University Life](https://www.nyu.edu/life.html)
* [About](https://www.nyu.edu/about.html)
All NYU
Info for
* Back to main menu
* Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](http://home.nyu.edu/)
Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](https://home.nyu.edu/)
Search Site Search
# Events Calendar
Search Events
Apply Reset
* [About the Events Calendar ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar.html)
* [Events Calendar Tutorial ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar/tutorials.html)
* [Report issue or provide feedback ](https://nyu.service-now.com/sp?id=sc_cat_item&sys_id=7698dd2a98bcf4004c8c03063d84e274)
Search Filters Calendar
New York University
Equal Opportunity and Non-Discrimination at NYU - New York University is committed to maintaining an environment that encourages and fosters respect for individual values and appropriate conduct among all persons. In all University spaces--physical and digital--programming, activities, and events are carried out in accordance with applicable law as well as University policy, which includes but is not limited to its Non-Discrimination and Anti-Harassment Policy.
Unless otherwise noted, all content copyright New York University. All rights reserved.
* [Search](https://search.nyu.edu/)
* [Campus Map](https://www.nyu.edu/map.html)
* [Events](https://events.nyu.edu/)
* [Contact Us](https://www.nyu.edu/contact-us.html)
* [Give](https://www.nyu.edu/about/giving.html)
* [Copyright & Fair Use](https://www.nyu.edu/copyright-and-fair-use.html)
* [Privacy](https://www.nyu.edu/privacy.html)
* [Accessibility](https://www.nyu.edu/accessibility.html)
* [Feedback](https://www.nyu.edu/#feedback.html)
* [New York Campus](https://www.nyu.edu/)
* [Abu Dhabi Campus](https://nyuad.nyu.edu/)
* [Shanghai Campus](https://shanghai.nyu.edu/)
* [](https://facebook.com/)
* [](https://linkedin.com/)
* [](https://x.com/)
* [](https://instagram.com/)
* [](https://youtube.com/)- Diese Zeile ist eine NYU-Veranstaltungskalender-Seite („Fall 2024 Census Date“):
- das Schema fragt nach nur zwei Feldern:
registration_open_dateunddescription - der Prompt-Scrape erfasste nur Kalendernavigation und Boilerplate: es gibt kein Anmeldedatum und keine Beschreibung
- beachte, dass das
description-Feld des Schemas sogar einen Beispielwert („Registration opens for the fall semester“) in seiner eigenen Feldbeschreibung mitliefert
- das Schema fragt nach nur zwei Feldern:
- also sollte ein wohlerzogener Extraktor es ablehnen, die Felder zu erfinden, die die Seite nicht enthält
- mal sehen, ob das kleine Modell das Richtige tut!
Schritt 2: Mit dem mini-Modell extrahieren (Textmodus)
- Hinweis:
gpt-5.4-miniist bei dieser Eingabe sehr stochastisch – selbst beitemperature=0erfindet es in fast jedem Lauf eine anderedescription. Für einen reproduzierbaren Durchlauf verdrahten wir die eine kanonische Erfindung fest, die der Rest dieses Notebooks erklärt (und die der Verifizierer bei P(wrong) > 0.8 markiert). Eine echte Pipeline würde einfach direktextract(MINI, prompt, schema, content, temperature=0)nehmen.
EXTRACT_SYSTEM = (
    "You extract structured data from documents. Return only values supported by the text. "
    "Follow any value format specified by the schema or its field descriptions."
)

# LLM and TypeSafe calls are cached to ``json_cache.json``, which ships with the cookbook, so
# re-rendering reproduces the published results with no API spend; delete the file to re-run live.
json_cache = JsonCache(Path("json_cache.json"))

@json_cache
def extract(
    model: str,
    prompt: str,
    schema: dict,
    content: str,
    *,
    reasoning_effort: str | None = None,
    temperature: float | None = None,
) -> dict:
    user = (
        f"{prompt}\n\nReturn ONLY a JSON object matching this JSON Schema:\n"
        f"{json.dumps(schema, indent=2)}\n\nDocument:\n{content}"
    )
    kwargs = {
        "model": model,
        "messages": [
            {"role": "system", "content": EXTRACT_SYSTEM},
            {"role": "user", "content": user},
        ],
    }
    if reasoning_effort:
        kwargs["reasoning_effort"] = reasoning_effort
    if temperature is not None:
        kwargs["temperature"] = temperature
    text = oai.chat.completions.create(**kwargs).choices[0].message.content
    # The prompt asks for ONLY a JSON object, so parse the reply as-is -- no regex fishing a
    # substring out of a malformed reply. If ``json.loads`` fails, treat it as an empty extraction
    # (the record-level analog of NaN): every field reads as absent, which the verifier flags and the
    # gate escalates -- the safe direction. Schema-following errors are rare here (see the overview).
    try:
        return json.loads(text)
    except (ValueError, json.JSONDecodeError):
        return {}

# Hard-coded canonical fabrication (see note above); a real pipeline would use extract(MINI, prompt, schema, content, temperature=0).
mini_record = {
    "registration_open_date": "",
    "description": "Registration opens for the fall semester",
}
print("mini extraction:\n", json.dumps(mini_record, indent=2))

# The record is a perfect fit for the JSON Schema -- and still wrong. Schema validation is necessary
# but not sufficient: it catches structural errors, never semantic ones. That gap is the whole point.
print("\nschema-valid:", jsonschema.Draft202012Validator(schema).is_valid(mini_record))
mini extraction:
{
"registration_open_date": "",
"description": "Registration opens for the fall semester"
}
schema-valid: True- Der Datensatz ist schema-gültig (die Zeile oben gibt
Trueaus), und trotzdem falsch:registration_open_datebleibt leer, was zur Seite passt: Sie nennt kein Datum- aber
descriptionist erfunden: Die Seite beschreibt nie ein Anmeldedatum, also erfindet mini ein plausibles. Es mag das eigene Beispiel des Schemas, „Registration opens for the fall semester“, nachplappern oder erzählen „…was not found in the document“ - eine JSON-Schema-Prüfung kann das nicht sehen. Ein günstiges Modell erzeugt selbstsichere, schema-erfüllende Erfindungen dieser Art, und sie zu fangen ist die Aufgabe eines semantischen Verifizierers
Schritt 3: Mit TypeSafe verifizieren
- der Verifizierer ist TypeSafe; für jedes Feld bauen wir eine
Noul-Frage:- ein enges Ja/Nein, so formuliert, dass
true= etwas stimmt nicht (eskalieren)
- ein enges Ja/Nein, so formuliert, dass
- TypeSafe gibt pro Frage ein kalibriertes
noul=P(true)zurück, in einem system_one-Aufruf - die Fragenmenge:
- ein holistischer
__overall__::judge-Kopf („sollte dieser Datensatz eskaliert werden?“). Wir berechnen und zeigen ihn, um ein Ganzdatensatz-Urteil den Pro-Feld-Köpfen gegenüberzustellen, aber das Gate in Schritt 4 nutzt ihn nicht – die Eskalation wird von der Pro-Feld- Batterie gesteuert. - eine Pro-Feld-Batterie
- nicht-leere Felder bekommen die volle Menge an Köpfen
- leere Felder (null / “” / []) bekommen nur den
absence_wrong-Kopf
- (die vollständige Pipeline hat außerdem einen
spurious-Kopf für ganze Container und einen übergreifendendifficulty-Score; hier nicht gezeigt, um diesen Durchlauf auf die beiden Gating-Köpfe zu beschränken)
- ein holistischer
- Der TypeSafe-Weg: Dekomposition
- Beachte, wie alles programmatisch dekomponiert wird; das ist der TypeSafe-Weg.
- Dekomposition maximiert die Intelligenz jedes Prompts und macht den Algorithmus einstellbar und interpretierbar.
-
# metric -> (question, NoulCriteria)
MAIN_QUESTIONS = {
    "name_desc_mismatch": (
        "Does the `extracted_field` fail to match the field at `path` or the `description` in the "
        "`field_spec`? If the `description` is empty, judge against the `path` alone.",
        NoulCriteria(
            true="the `extracted_field` does not match the field name or its `description`",
            false="the `extracted_field` matches the field name and `description`",
        ),
    ),
    "type_mismatch": (
        "Does the `extracted_field` violate the `type` declared in the `field_spec`?",
        NoulCriteria(
            true="the `extracted_field` violates the declared `type`",
            false="the `extracted_field` conforms to the declared `type`",
        ),
    ),
    "unreasonable": (
        "Is the `extracted_field` one that a reasonable person would not have extracted for this "
        "`field_spec`?",
        NoulCriteria(
            true="a reasonable person would not have extracted this value",
            false="the extraction is reasonable",
        ),
    ),
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    "off_target": (
        "Does the source text fail to genuinely report the thing the `field_spec` describes, so the "
        "value was pulled from incidental text?",
        NoulCriteria(
            true="the source does not genuinely provide this field -- the value was pulled "
            "from incidental text",
            false="the source genuinely reports this field",
        ),
    ),
    "incomplete": (
        "Does the `extracted_field` fail to capture a value the source supports (note whether the "
        "`field_spec` is `required`)?",
        NoulCriteria(
            true="the field is wrongly empty, null, or missing a value the source supports",
            false="the field captures the value the source supports",
        ),
    ),
    "format_violation": (
        "Does the `extracted_field` violate the format or constraints implied by the `description`, "
        "the schema `type`, and the extraction instructions (e.g. date format, units, enum membership)?",
        NoulCriteria(
            true="the `extracted_field` violates the implied format or constraints",
            false="the `extracted_field` satisfies the format and constraints",
        ),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text contain the "
    "information the `field_spec` describes, making the empty result wrong?"
)
ABSENCE_CRITERIA = NoulCriteria(
    true="a value was wrongly omitted", false="returning nothing is correct"
)

# The pipeline also asks one holistic, whole-record head: "should this be escalated?"
OVERALL_JUDGE = (
    "Is this extracted record an incorrect extraction -- some value unsupported by the source or "
    "not conforming to the schema, required information missing or wrong, or some field hallucinated -- "
    "so it should be escalated to a smarter model?"
)
OVERALL_JUDGE_CRITERIA = NoulCriteria(
    true="the record is an incorrect extraction",
    false="the record is a correct extraction",
)

def is_empty(v) -> bool:
    return v is None or (isinstance(v, (str, list, dict)) and len(v) == 0)

def field_spec(name: str) -> dict:
    """Minimal spec pulled from the schema (unwrapping anyOf/null for optional fields)."""
    p = schema["properties"][name]
    branches = p.get("anyOf") or []
    typ = p.get("type") or next(
        (b["type"] for b in branches if b.get("type") != "null"), "unknown"
    )
    return {
        "path": name,
        "type": typ,
        "description": p.get("description", ""),
        "required": name in schema.get("required", []),
    }

def build_questions(record: dict) -> dict[str, Noul]:
    """The verify question set: one holistic ``__overall__::judge`` head plus a per-field battery,
    keyed ``field::metric`` (mirrors build_verify_prompts)."""
    questions: dict[str, Noul] = {
        "__overall__::judge": Noul(
            instructions=OVERALL_JUDGE, criteria=OVERALL_JUDGE_CRITERIA
        ),
    }
    for name, value in record.items():
        spec = field_spec(name)
        if is_empty(value):
            questions[f"{name}::absence_wrong"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": ABSENCE_QUESTION,
                },
                criteria=ABSENCE_CRITERIA,
            )
            continue
        for metric, (question, criteria) in MAIN_QUESTIONS.items():
            if metric == "type_mismatch" and spec["type"] == "unknown":
                continue
            questions[f"{name}::{metric}"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": question,
                },
                criteria=criteria,
            )
    return questions

@json_cache
def verify(record: dict) -> dict[str, float | str]:
    """Run the whole Noul battery over a record in one TypeSafe call; return ``{field::metric: P(true)}``."""
    state = {
        "system_message": EXTRACT_SYSTEM,
        "instruction": "Extract the structured record from this document",
        "source_text": row["content"],
        "schema": schema,
        "extraction": record,
    }
    questions = build_questions(record)
    answers = ts.system_one(state=state, questions=questions, model=TS_MODEL).answers
    return {qid: ans.noul for qid, ans in answers.items()} | {
        "playground_link": make_playground_link(state, questions)
    }
Die ganze Batterie über die mini-Extraktion laufen lassen
checks = verify(mini_record)
playground_link = checks.pop("playground_link")
display(
    Markdown(
        f"🔗 [Open this verification in the TypeSafe playground]({playground_link})"
    )
)

print(f"{'qid':<40}{'P(wrong)':>9}")
print("-" * 50)
for fld, p in sorted(checks.items(), key=lambda c: -c[-1]):
    flag = "  <== FIRES" if p > FIRE_T else ""
    print(f"{fld:<40}{p:>9.2f}{flag}")
qid P(wrong)
--------------------------------------------------
description::hallucinated 0.95 <== FIRES
description::off_target 0.85 <== FIRES
description::unreasonable 0.58
__overall__::judge 0.56
description::incomplete 0.16
registration_open_date::absence_wrong 0.14
description::format_violation 0.10
description::name_desc_mismatch 0.08
description::type_mismatch 0.02- TypeSafe konzentriert das Signal auf die Felder, die tatsächlich falsch sind.
- Unsere Ergebnisse sind kalibriert: hoch beim falschen Feld, niedrig beim richtigen, mittel bei einem Feld, das verdächtig aussieht, ohne klar falsch zu sein
- Das ist es, was dir ein TypeSafe-Verifizierer gegenüber einem groben „ist das Ganze gut?“-Richter verschafft
Schritt 4: Das Eskalations-Gate
- jetzt gaten wir auf
any_flag: eskaliere, wenn irgendein Feld-FlagFIRE_Tübersteigt (0.7, oben gesetzt und geteilt mit der<== FIRES-Markierung in Schritt 3) - das ist ein
max-artiges Gate (eskaliere, wenn irgendein Feld auslöst), kein Mittel, also genügt ein selbstsicheres rotes Flag, statt in Stille hinein gemittelt zu werden
# any_flag is a per-field gate: the holistic __overall__ head is shown above but not part of it
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > FIRE_T
}
escalate = bool(fired)

print(
    f"any_flag gate (threshold {FIRE_T}): {'ESCALATE' if escalate else 'ACCEPT cheap result'}"
)
for qid, p in sorted(fired.items(), key=lambda c: -c[1]):
    print(f"  fired: {qid}  (P={p:.2f})")
any_flag gate (threshold 0.7): ESCALATE
fired: description::hallucinated (P=0.95)
fired: description::off_target (P=0.85)Schritt 5: Zum Reasoning-Modell eskalieren
Da ein Signal ausgelöst hat, zahlen wir für das starke Modell (gpt-5.5, reasoning_effort="high")
final_record = (
    extract(REASONING, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)

print("mini      :", json.dumps(mini_record))
print("reasoning :", json.dumps(final_record))
print("\nfield-level diff (mini -> final):")
for name in mini_record:
    if mini_record[name] != final_record.get(name):
        print(f"  {name}: {mini_record[name]!r}  ->  {final_record.get(name)!r}")
mini : {"registration_open_date": "", "description": "Registration opens for the fall semester"}
reasoning : {"description": "", "registration_open_date": ""}
field-level diff (mini -> final):
description: 'Registration opens for the fall semester' -> ''- Die Verbesserung
- Das Reasoning-Modell verwirft die erfundene
descriptionund gibt""zurück - Es erkannte, dass die Seite nie ein Anmeldedatum beschreibt, und lehnte es ab, eines zu erfinden
- Die Kaskade verwandelte eine selbstsichere, schema-gültige Erfindung in ein ehrliches leeres Feld
- Und es gab nur für diesen einen Eintrag Reasoning-Modell-Dollar aus, weil der Verifizierer es ihm sagte
- Das Reasoning-Modell verwirft die erfundene
Schritt 6: Wie das bei 100 Prompts aussieht
- Das sind interne TypeSafe-Ergebnisse, erzeugt mit der allgemeinen Methode oben:
- dieselbe Schleife
extract → verify → escalate,gpt-5.4-mini → gpt-5.5-reasoning,any_flag-Gate über den Pro-Feld-Köpfen, über 100 scrapegraphai-Prompts ausgeführt - die günstige Extraktion jedes Eintrags wird von TypeSafe bewertet; der Gate-Schwellenwert („cut“) wird von 0→1 durchgefahren, und jede resultierende Konfiguration wird im (Kosten, Qualität)-Raum aufgetragen
- das Diagramm ist eine historische Momentaufnahme; seine Kosten wurden nicht mit dem oben genannten aktuellen Jev-Tarif neu berechnet
- dieselbe Schleife
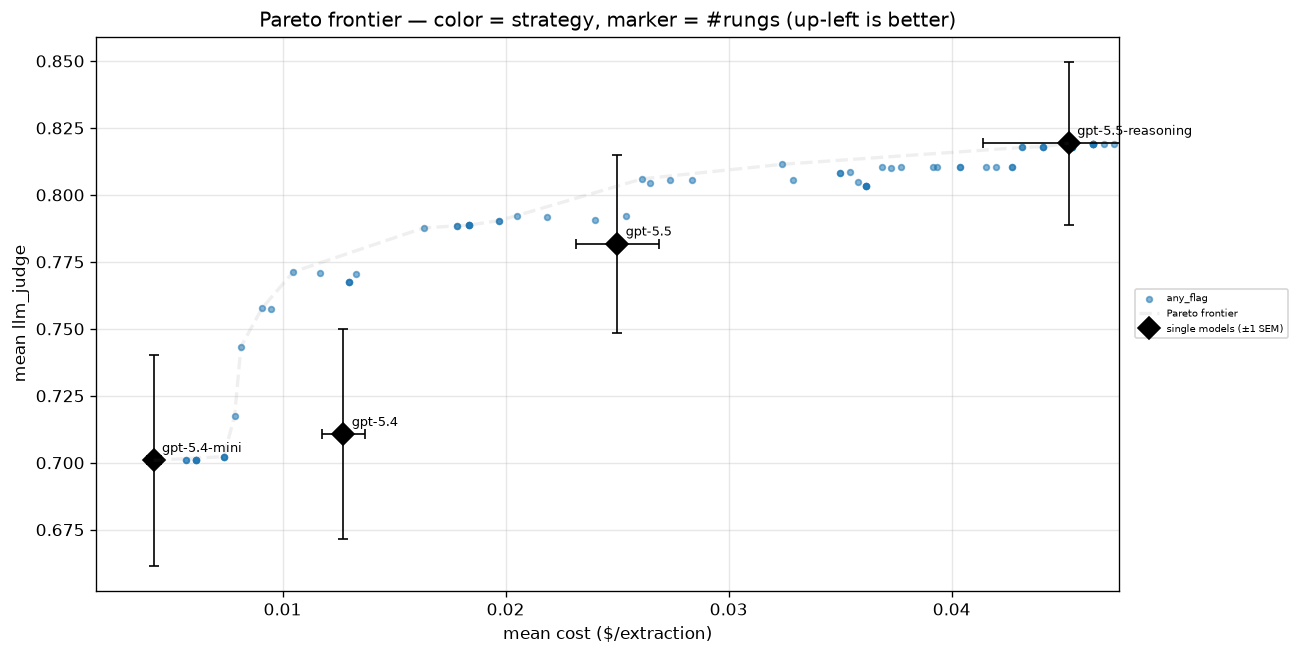
- wie man es liest:
- schwarze Rauten = die vier Modelle allein ausgeführt (die Kosten steigen mit der Fähigkeit;
das stärkste,
gpt-5.5-reasoning, sitzt oben rechts bei ≈0.81 Qualität für ≈$0.10/Extraktion) - blaue Punkte = die Kaskade bei vielen Gate-Schwellenwerten; die gestrichelte Linie ist die Pareto-Front
- die Kaskaden-Front liegt oben links von jedem einzelnen Modell: Das Durchfahren des Gates kauft dir den größten Teil der Qualität des Top-Modells zu einem Bruchteil seiner Kosten
- die günstige Stufe erledigt die einfachen Einträge fast kostenlos, und nur die markierten Einträge zahlen für das Reasoning-Modell
- schwarze Rauten = die vier Modelle allein ausgeführt (die Kosten steigen mit der Fähigkeit;
das stärkste,
Anhang A: Was ein gutes Verifizierer-Signal ausmacht
- die Kaskade ist nur so gut wie ihr Verifizierer; was ein nützliches von einem
nutzlosen Signal trennt:
- Eng und geerdet.
- ein überprüfbares Ja/Nein über ein Feld gegenüber der Quelle (z. B. „fehlt dieser Wert in der Quelle?“), kein vages „ist diese Extraktion gut?“
- vage Fragen liefern matschige, unkalibrierte Scores
- Schlecht = TRUE, mit expliziten Kriterien.
- formuliere jede Frage so, dass der Eskalations-Fall der
true-Fall ist, und gib an, wastrue/falsebedeuten
- formuliere jede Frage so, dass der Eskalations-Fall der
- Pro Feld, dann mit
maxaggregieren.- ein Pro-Feld-Flag lokalisiert den Fehler und bleibt spärlich und stark
max(„irgendein Flag löst aus“) stellt sicher, dass ein selbstsicheres rotes Flag eskaliert, statt in Stille hinein gemittelt zu werden
- Unabhängig und günstig.
- ein eigener Verifizierer (hier TypeSafe), der die Ausgabe beurteilt, fängt die eigenen blinden Flecken des Extraktors
- er muss günstig sein, sonst bleiben keine Einsparungen mehr zu holen
- Trennend / kalibriert.
- ein gutes Signal ist hoch bei echten Fehlern und niedrig bei richtigen, also trennt ein einzelner Schwellenwert sauber zwischen Akzeptieren und Eskalieren
- diese Trennung ist es, was die Pareto-Kurve nach oben links schiebt
- Eng und geerdet.