La arquitectura de Jev al descubierto
Sondeé Jev con 10,000 llamadas a la API para deducir a grandes rasgos cómo está construido, y por qué la mayoría de las opiniones de los charlatanes en X están completamente equivocadas. X está lleno de opiniones exaltadas sobre el lanzamiento de Jev, y la mayoría no da en el clavo: «¿12 millones de visitas por un clasificador JSON? Sí, estamos en una burbuja.» Un LLM corriente genera «90% de confianza» como texto; su probabilidad de producir esas palabras no establece una probabilidad del 90% de acertar. Y sin embargo construimos la detección de fraude, la moderación, el enrutamiento y la evaluación de riesgos justo alrededor de este patrón: pagamos por una generación token a token y luego tratamos una afirmación de confianza no validada como una probabilidad sobre la que nuestro software puede actuar.
La propuesta de Jev es conservar el conocimiento de un LLM preentrenado y, al mismo tiempo, sustituir las afirmaciones de confianza generadas por probabilidades de decisión leídas directamente de sus representaciones internas. Esas probabilidades se entrenan contra resultados. Dale un estado, unas preguntas y las respuestas permitidas compartidos; devuelve las distribuciones en paralelo, sin generar texto.1 Para toda esta clase de aplicaciones, eso resuelve ambos problemas: la fiabilidad de la señal de decisión y el cómputo innecesario que se gasta en producirla.
Hay un solo problema: no es de pesos abiertos, y TypeSafe se niega a compartir su investigación… Así que lo haré yo (con mis mejores esfuerzos).
Las pruebas apuntan a un transformer causal (probablemente con MoE disperso) reutilizado para tomar decisiones: codificación de estado compartido, ramas de preguntas aisladas y lecturas directas de probabilidad en lugar de generación de texto. Tras sondear la API de TypeSafe (buscando firmas en el escalado de latencia con distintas longitudes de contexto, la reordenación de preguntas, etc.), peinar toda la documentación y la investigación públicas con Astra, y buscar trabajos anteriores, creo que tengo un modelo bastante preciso de cómo funciona y de su arquitectura.
La columna vertebral dispersa es la parte menos segura, pero resulta especialmente beneficiosa para este dominio, con menos desventajas que los LLM autorregresivos, así que sería raro que no fuera así. El cómputo compartido y las salidas directas de probabilidad están mucho mejor respaldados, obviamente. Todo esto es claramente bastante especulativo, así que intentaré ser lo más claro posible sobre qué pruebas publicó TypeSafe, qué se observó en los experimentos y qué se infiere de ellos. Las API de caja negra hacen que sea asombrosamente fácil echar un manto sobre el fantasma y hacerse una idea aproximada de cómo es la arquitectura.
Por qué este diseño es útil
Considera una solicitud esquemática de enrutamiento de soporte. Ilustra la estructura de la API; las probabilidades de ejemplo que aparecen abajo son inventadas.
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}
Una respuesta útil podría asignar a payments una probabilidad de 0.91 y al escalado urgente solo 0.42. Son incertidumbres distintas. El software puede enrutar el ticket automáticamente y dejar el escalado a una política aparte.
Un transformer causal ya sabe construir una representación del texto de izquierda a derecha. Durante la inferencia ordinaria de un modelo de lenguaje, procesa el prompt, predice un token, reinyecta ese token y repite. Esto se apoya en la atención del decodificador y la proyección de salida presentadas en el Transformer original.3 Pero la etapa de procesamiento del prompt ya ha producido una representación rica. Si la tarea consiste en elegir entre tres colas, podemos acoplar una función pequeña que asigne esa representación directamente a tres números.
Un detalle resuelve aquí buena parte de la confusión sobre las respuestas en paralelo: la atención causal describe qué posiciones pueden usar qué información, no el orden en que deben ejecutarse los tokens de entrada. Durante el procesamiento del prompt, o prefill, todos los tokens de entrada ya se conocen. El modelo puede procesar sus posiciones juntas dentro de una capa mientras la máscara de atención bloquea el acceso a posiciones posteriores; las capas siguen ejecutándose en secuencia. La decodificación autorregresiva añade otra dependencia: el siguiente token no existe hasta que se ha elegido la predicción anterior. Nuestro modelo propuesto termina tras el prefill y la lectura, así que evita esa dependencia token a token.
Esto cambia la forma computacional de la tarea. La salida ya no necesita una secuencia de decisiones de escritura para "payments": 0.91. El formato JSON lo hace el código normal de la aplicación. La red neuronal aporta las probabilidades.
Supón ahora que el estado es un informe de incidente extenso y que hay cincuenta preguntas. La mayor parte de la entrada es compartida. Un transformer almacena la información intermedia sobre los tokens procesados en su caché de clave-valor, normalmente abreviada como caché KV. En el diseño propuesto, cada pregunta lee la misma caché de estado. Cada rama solo añade sus propias instrucciones y opciones de respuesta.
Para un estado de tokens y preguntas, las solicitudes separadas procesarían el estado unas veces. Compartirlo reduce el procesamiento repetido de los tokens del estado de a . Las preguntas siguen teniendo que atender al estado; ese trabajo no desaparece. Pero el modelo no necesita reconstruir una y otra vez las representaciones del estado.
El aislamiento también da un significado útil a la interfaz. Preguntar si el cliente está enfadado no debería cambiar qué cola recibe el ticket. Ambas preguntas pueden inspeccionar las mismas pruebas sin leer las instrucciones de la otra. Las ramas no tienen dependencia computacional entre sí, aunque sus respuestas estén relacionadas estadísticamente.
Por último, las probabilidades hacen explícita la política posterior. Si un escalado innecesario cuesta una unidad y un caso urgente omitido cuesta nueve, una regla de decisión simplificada escala cuando . Ese cálculo solo tiene sentido en la medida en que las probabilidades sean fiables para este flujo de trabajo. Entrenar y evaluar la distribución de probabilidad pasa así a formar parte del producto, en lugar de ser un campo de confianza puramente cosmético.
Nada de esto requiere difusión. La clasificación en paralelo existe desde hace décadas. La combinación interesante es un transformer ampliamente capaz, cómputo contextual compartido, una interfaz de salida con tipos y un entrenamiento que recompensa la incertidumbre útil.
1. Termina la inferencia con una lectura
El primer componente es el más simple: una cabeza de predicción en lugar de un bucle de decodificación.
Pruebas publicadas. El anuncio de lanzamiento de TypeSafe dice: «Jev emite todas las probabilidades en paralelo en lugar de generarlas de forma autorregresiva token a token». Su documentación expone opciones finitas, decisiones de sí/no y puntuaciones ordenadas. Todo ello se representa de forma natural con salidas numéricas fijas.12
Pruebas observadas. La API sigue informando de un campo output_tokens, que suena a un registro de generación. No lo es. Para las preguntas de sí/no, el recuento encaja exactamente: 4 tokens compartidos, más 15 por respuesta, más la longitud en tokens del identificador de cada pregunta. La documentación de TypeSafe dice que ese identificador «no se envía al modelo subyacente y no se usa en la inferencia». Un recuento que cambia con texto que el modelo nunca ve se calcula después de la inferencia, a partir de la respuesta serializada. Los valores devueltos tampoco lo afectan: una respuesta de 0.0 cuesta lo mismo que una de 0.01, aunque cada dígito, por lo demás, cuente como un token.224
El tokenizador que hay detrás del recuento no coincide con ninguno de los 192 tokenizadores públicos que probamos. Sí coincide con el propio contador de entrada de Jev para texto corriente, y solo difiere en secuencias largas de espacios en blanco y puntuación. output_tokens es una cifra de facturación. No nos dice nada sobre si Jev genera texto, y no mediría ese texto ni aunque lo hiciera. La latencia tampoco sigue esa cifra: una pregunta con 200 opciones (1,911 tokens de salida) se devolvió igual de rápido que una con dos, y el tiempo de servidor solo creció con la longitud de la entrada.2425
Una respuesta de 255 opciones informó de 2,714 tokens de salida.4 Sería un error dividir ese número por la duración de la solicitud y llamar al resultado velocidad de decodificación del modelo. Un servidor puede serializar miles de caracteres después de una sola evaluación del modelo. El campo de contabilidad no nos dice cuántos pasos neuronales de decodificación se produjeron.
La lectura propuesta toma un vector oculto final y produce logits:
Aquí es el número de respuestas permitidas. La matriz convierte una representación en puntuaciones de respuesta; softmax transforma esas puntuaciones en una distribución. Para una decisión de sí/no bastarían un escalar y una sigmoide.
Las clases no tienen por qué ser conceptos fijos como «payments». Pueden ser ranuras de opciones: primera opción, segunda opción, tercera opción. La rama aporta el significado de cada ranura; el código de la aplicación asigna su probabilidad de vuelta a la clave de opción del solicitante. Un Score ordenado puede predecir de forma similar probabilidades sobre niveles y devolver su promedio ponderado por probabilidad. Esto admite decisiones nuevas sin entrenar una cabeza nueva para las etiquetas de cada cliente. Un scorer de estilo puntero, comparado en la sección 4, es la principal alternativa: puntúa la representación de cada opción en lugar de una ranura numerada.
Esto no establece que Jev tenga un módulo clasificador con nombre propio. La cabeza de vocabulario de un modelo de lenguaje también es una matriz seguida de softmax. Seleccionar filas de etiquetas reservadas de esa matriz puede implementar el mismo cómputo que una cabeza dedicada de clases. Las filas podrían estar atadas a los embeddings de entrada o entrenadas de forma independiente; aquí no podemos distinguir esas configuraciones.
La distinción importante está entre leer probabilidades y generar texto que describe probabilidades. Un «91%» generado es una secuencia de tokens. El 0.91 de un clasificador es una entrada de su distribución predictiva. Cualquiera de los dos puede estar mal calibrado. Ninguno se vuelve fiable solo por su formato.
La decodificación de texto restringida sigue siendo una forma posible de construir una interfaz similar, pero TypeSafe describe explícitamente una ruta de salida distinta. Su afirmación es una prueba más sólida que un argumento de latencia. Las pruebas apuntan a una lectura numérica directa, uno de los dos diseños comparados en la sección 4. Los tokens de etiqueta reservados siguen siendo posibles, aunque el test de opciones falsas de allí juega en su contra.
2. Comparte el estado, aísla las preguntas
La siguiente decisión tiene que ver con dónde se reutiliza el cómputo.
Pruebas observadas. La contabilidad de tokens es exactamente aditiva en los pequeños ejemplos controlados. Una pregunta de sí/no mínima usó 268 tokens de entrada; dos usaron 276. Una solicitud con una pregunta de sí/no, un Choice de dos opciones y un Score de dos niveles usó 318, lo que coincide con la suma de sus contribuciones medidas por encima de la sobrecarga compartida. Esto encaja con un prefijo común más sufijos de pregunta, aunque la contabilidad por sí sola no identifica un grafo computacional.4
Un experimento más informativo mueve pruebas entre esas regiones. El estado decía inicialmente:
The weather is nice today and the park is full of people.Una pregunta hermana contenía:
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
La sonda preguntaba qué código mencionaba otra pregunta, con ZEBRA-7741, dos distractores y none como opciones. Con el secreto en la pregunta hermana, su probabilidad informada fue 0.00. Eliminar esa pregunta hermana produjo el mismo resultado. Poner la declaración en el estado en su lugar la elevó a 0.90–0.92. Fueron cinco repeticiones por condición (visibility en los registros de la sonda).5
Esta es una intervención útil: mover la declaración a través de una frontera de la API cambia su efecto. Respalda un aislamiento conductual entre preguntas y el acceso al estado compartido. No expone la máscara de atención exacta. Llamadas separadas al modelo, una máscara de árbol u otro mecanismo que restrinja el flujo de información podrían producir el mismo resultado. La redacción de la sonda además pregunta por «otra pregunta» incluso en la condición de estado, así que no es una prueba prístina de seguimiento literal de instrucciones.
Las mediciones de servicio añaden otra pieza. Hasta unas 100 preguntas, el tiempo de servidor apenas cambió. Más allá de eso subió de forma constante y, token por token, el texto de las preguntas costó aproximadamente el doble que el estado. Eso es coherente con calcular el estado una vez y agrupar el trabajo de las preguntas.6
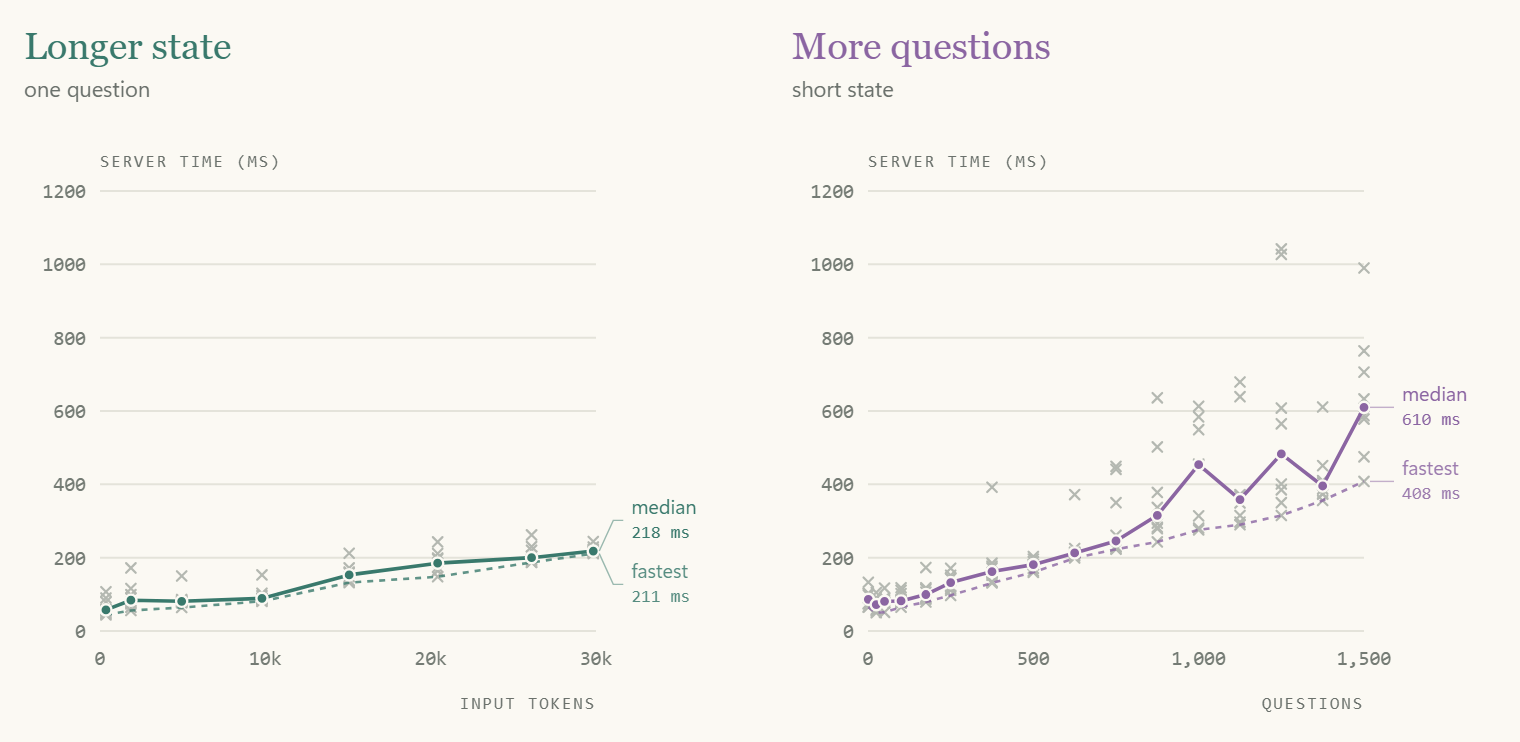
Estas son duraciones del servicio ascendente reportadas por el servidor, no cronometrajes de un portátil local. Incluyen cualquier trabajo y espera que incluya el servicio ascendente, y el servicio se compartía con otros usuarios.
Jev impone dos límites. Cada rama (el estado más una pregunta) está limitada a unos 32,768 tokens, y la solicitud completa a unos 65,536. El límite de la solicitud cuenta el estado una sola vez: un estado de 23k tokens con 5,000 preguntas cabe dentro de él. Si cada pregunta procesara su propia copia del estado, esa solicitud superaría los 100 millones de tokens. El par cabe en una única secuencia empaquetada de hasta 2¹⁶ tokens, que contiene el estado una vez y cada pregunta después, con cada rama limitada a una ventana de contexto de 2¹⁵.22
Una caché KV de prefijo con sufijos causales separados es la implementación natural. Hydragen describe atención eficiente para secuencias que comparten un prefijo; DeFT desarrolla atención para inferencia con estructura de árbol. Ambos establecen que el patrón de servicio es práctico. Son trabajos anteriores, no pruebas de que TypeSafe use ninguna de esas bibliotecas.78
Este diseño también aclara una contradicción aparente: las preguntas aisladas pueden seguir evaluándose juntas en el mismo acelerador. «Paralelo» describe su planificación y la ausencia de dependencias entre respuestas. No tiene por qué significar una GPU por pregunta.
3. Una columna vertebral causal
Los experimentos no pueden distinguir un decodificador causal de un codificador bidireccional: en ambos, la decisión final puede leer toda la entrada. Aun así, asumo un decodificador causal, por una buena razón. La amplitud de conocimiento de Jev (84.6% en MMLU-Pro) exige un preentrenamiento a escala de frontera, todo modelo a esa escala es un decodificador causal, y TypeSafe describe RLCD como el post-entrenamiento de un modelo de lenguaje preentrenado. Un Jev bidireccional significaría o bien una base mucho más débil, o bien convertir un decodificador a un coste adicional, renunciando al mismo tiempo a la caché de prefijo compartido que ofrece el servicio causal. Eso sería sorprendente, pero no puede descartarse desde fuera.1215
Qué modelo preentrenado es, se desconoce, y el tokenizador no revela ninguno. Los recuentos de tokens de Jev no coinciden con ninguno de los 192 tokenizadores públicos que probamos en 415 sondas. Divide cada dígito individualmente y busca fragmentos enteros antes de fusionar: 8 as cuentan como un token, pero 16 cuentan como cuatro. Su vocabulario sigue de cerca el o200k de OpenAI, ya que cada cadena que Jev cuenta como un solo token es también un solo token de o200k, pero la división de dígitos y varias fusiones descartan al propio o200k. La coincidencia pública más cercana, Qwen, concuerda en 348 de 415 sondas. Eso descarta un tokenizador público sin cambios, no un modelo base público: un vocabulario reemplazado, un preentrenamiento continuado o una destilación podrían explicarlo, igual que una API que cuente tokens de forma distinta al modelo.18
Los experimentos sí muestran qué puede leer la decisión. Coloqué una tarjeta de referencia entre las opciones de una pregunta y pedí a Jev que eligiera la opción cuya condición cumple la tarjeta. Aquí hay un conjunto de opciones exacto:
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.
La instrucción era: «Lee la tarjeta de referencia y selecciona la única opción cuya condición se cumple.» Cambiar el valor de referencia a indigo conmuta la respuesta correcta sin modificar las opciones seleccionables.
Probé ambos valores, las seis permutaciones de opciones y una segunda plantilla con route = east/west, con dos repeticiones. Un control emparejado puso la referencia en el estado compartido en su lugar. Eso dio 48 ensayos con referencia en opciones y 48 controles con referencia en el estado.20
| Posición de la opción de referencia | Respuestas correctas |
|---|---|
| Primera | 12 / 16 |
| En medio | 11 / 16 |
| Última | 16 / 16 |
| Referencia movida al estado | 48 / 48 |
Jev puede usar información colocada después de las descripciones de los candidatos. Con la referencia al final, seleccionó la opción correcta en todos los ensayos, con una probabilidad media de respuesta correcta de unos 0.88.
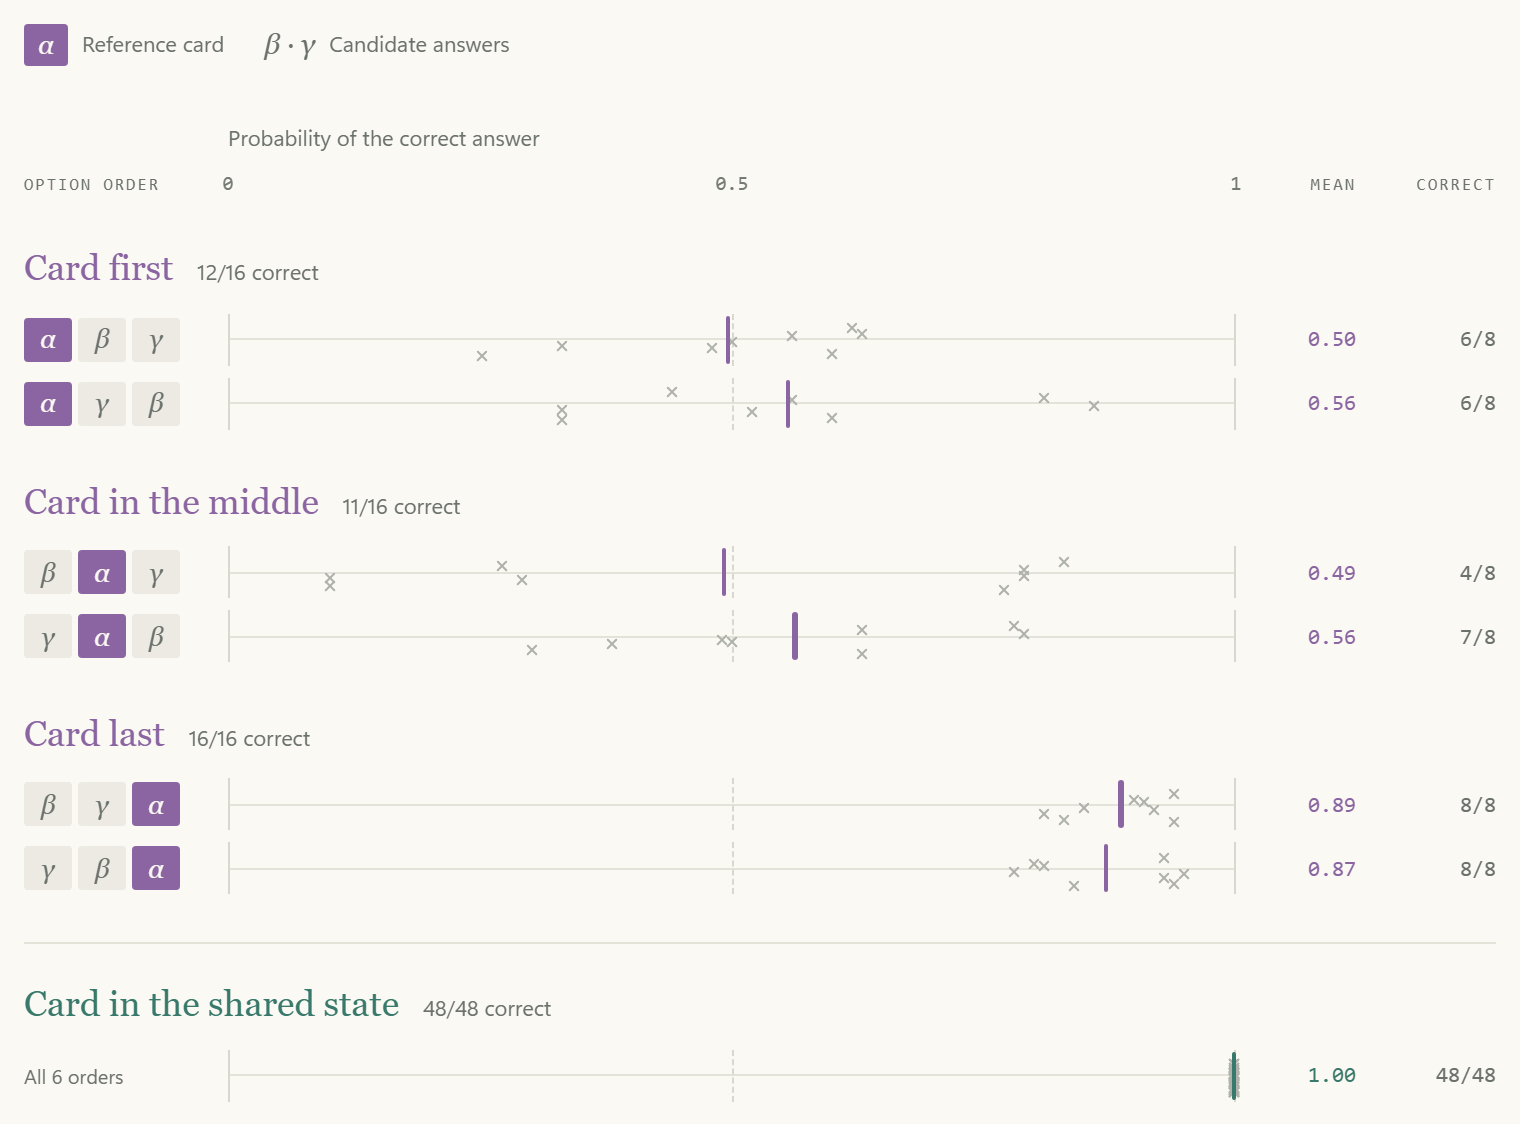
El control de cambio de valor importa tanto como la posición. Con la tarjeta al final, cambiar solo amber por indigo cambia qué opción anterior gana, aunque esas descripciones anteriores y el estado permanecen idénticos. Un modelo que puntúa cada opción de forma independiente a partir de su propio texto y del estado, y luego simplemente normaliza las puntuaciones, no tiene ninguna vía para que ese hecho cambie el orden relativo de las opciones anteriores. Los resultados respaldan una ruta por la que las opciones influyen en la decisión conjunta.20
Esto encaja con cualquier lectura calculada después de la lista completa, incluidos ambos diseños comparados en la sección 4, así como con una etapa separada de mezcla de opciones. Los errores restantes muestran un procesamiento sensible a la posición en estas dos plantillas; no identifican una causa única.
La difusión es innecesaria para este cómputo, y nada en estos experimentos requiere un desenfoque iterativo. La inferencia arquitectónica defendible es más estrecha: el cómputo de la respuesta tiene acceso a la lista completa de opciones. El siguiente experimento comprueba si realmente usa ese contexto conjunto.
4. Deja que las opciones interactúen antes de elegir
Dentro de una pregunta, las pruebas apuntan a una frontera de información distinta: las alternativas se leen juntas como una lista ordenada, seguidas de una única posición de decisión.
¿Por qué permitir esa interacción? Opciones como «ninguna de las anteriores» dependen de las demás alternativas. Incluso las alternativas corrientes pueden aclarar una pregunta. «Pagos», «acceso a la cuenta» y «otro» definen una decisión distinta de «banco», «proveedor de pagos» y «cliente». Una representación a nivel de lista permite al modelo interpretar esa distinción antes de producir la distribución.
La prueba más contundente es un experimento con una opción adicional irrelevante.
Empieza con cuatro causas posibles de un fallo de pago: bank, provider, customer y unknown. Luego añade weather: Bad weather caused it. Si cada opción original recibe un logit independiente y sin cambios y el servidor aplica la misma temperatura de softmax, añadir una quinta opción cambia la normalización pero no puede cambiar las probabilidades relativas entre dos opciones existentes:
El denominador común se cancela. Esto nos da una predicción concreta y falsable.
El estudio original encontró un cambio de aproximadamente +0.49 a +0.08.10 Para comprobar si esto sobrevivía a la variabilidad normal entre solicitudes, repetí el experimento en diez bloques aleatorizados. Cada bloque incluía la línea base de cuatro opciones, un control idéntico de cuatro opciones, una versión de cinco opciones con weather añadido, un control idéntico de cinco opciones y una versión de cinco opciones cuya descripción añadida cambiaba de «Bad weather caused it» a «Wild birds caused it». Cada solicitud contenía una pregunta.21
El resultado de la expansión se replicó. Agrupando las dos solicitudes idénticas para cada condición dentro de cada bloque, el log-odds medio cayó de +0.38 a +0.11. Todos los bloques mostraron un descenso; el cambio medio fue −0.28, con un intervalo t emparejado descriptivo del 95% de aproximadamente −0.36 a −0.19. El agrupamiento usa las solicitudes de control para reducir el ruido normal de las solicitudes, en lugar de tratar salidas duplicadas como experimentos independientes.21
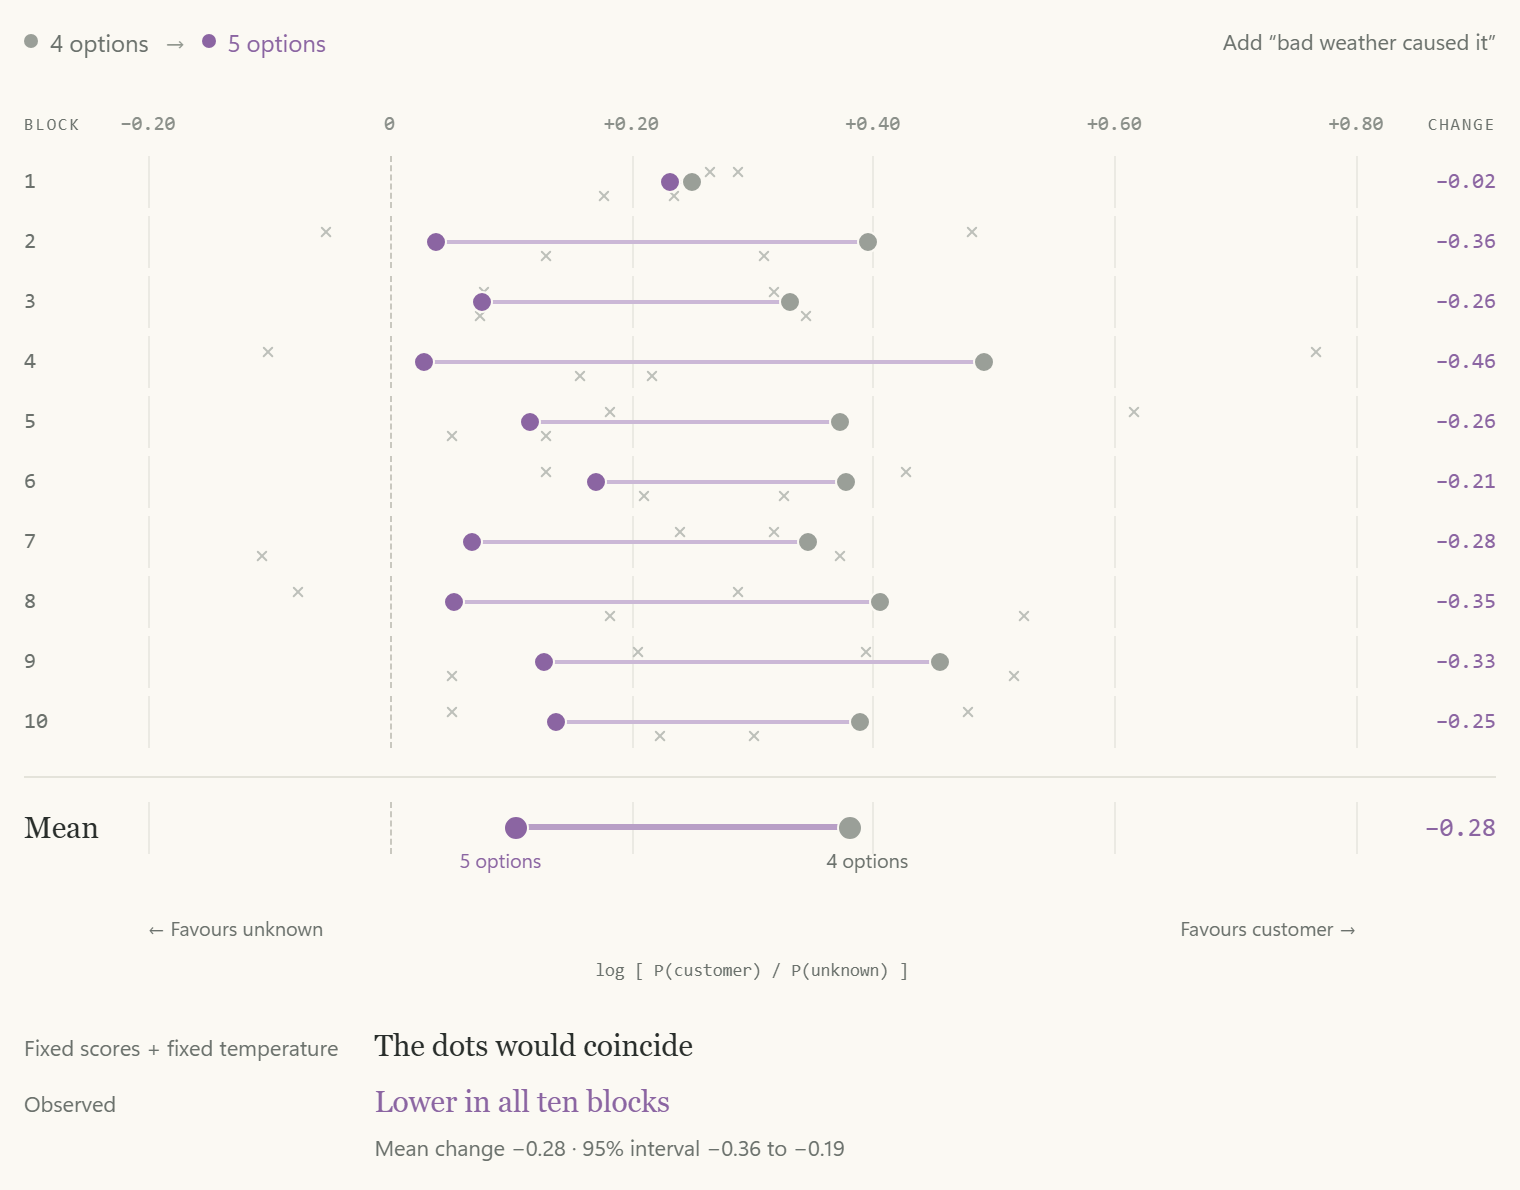
Esto es una prueba en contra de logits fijos e independientes seguidos de un softmax sin cambios. No identifica el mecanismo de forma única. Cambiar la descripción añadida manteniendo cinco opciones dio un cambio menor e inconcluyente: su intervalo emparejado incluía el cero. Una temperatura dependiente del conjunto sigue siendo posible, junto con una mezcla dependiente del contenido.
Una lectura que ve la lista completa lo explica de forma natural: añadir una opción cambia el contexto que lee. El método de ranking a nivel de lista FIRST funciona igual, extrayendo un ranking de los logits del primer token en lugar de generarlo token a token.11
Dos lecturas encajan con las pruebas. Una cabeza de posición final puntúa cada ranura de opción a partir de la representación del token de decisión; un scorer de estilo puntero compara esa representación con el estado oculto final de cada opción. Ambos dejan que las opciones se influyan entre sí. La API acepta como máximo 255 opciones (2⁸ − 1), lo que encaja con una cabeza fija de 256 ranuras, pero ese límite lo impone la validación de la solicitud, no el modelo. Con 200 opciones, una respuesta copiada puntuó 1.00 en todas las posiciones y los errores no se derramaron sobre las opciones vecinas, lo que encaja con un puntero. Ninguno de los dos resultados es decisivo.26
Las opciones falsas inyectadas nunca desplazaron a las reales, así que las fronteras entre opciones están marcadas de una forma que el texto no puede falsificar, y una opción cuya condición se duplica en otra parte de la lista pierde probabilidad frente a sus rivales.23
El compromiso también se ve en tareas corrientes: invertir las opciones desplazó la probabilidad de una clasificación de soporte técnico de aproximadamente 0.84–0.89 a 0.93–0.96. Esto vino de las sondas option_order.9 Para una política de decisión desplegada, eso importa. Un umbral cercano a 0.9 podría cambiar la acción aunque las etiquetas y las pruebas sean idénticas. Los test de permutación pertenecen a la evaluación de cualquier implementación de este diseño.
5. Entrena la distribución y luego calcula la confianza
El quinto componente es el objetivo de entrenamiento. Las salidas numéricas directas ahorran trabajo de decodificación, pero una probabilidad barata puede seguir siendo una mala probabilidad.
Imagina una colección de casos a los que se asigna una probabilidad de 0.8 de ser urgentes. La calibración pregunta si alrededor del 80% lo son de verdad. Es una propiedad de las predicciones a lo largo de los casos. No podemos determinar si una predicción está calibrada a partir de si ese caso concreto sale bien.
TypeSafe llama a su método de entrenamiento Reinforcement Learning for Calibrated Decisions, o RLCD. El anuncio dice que optimiza «respuestas con probabilidades epistémicamente honestas en tareas de System One»; la introducción de la empresa presenta RLCD como una ruta de post-entrenamiento a partir de modelos de lenguaje preentrenados.112 La receta exacta no está publicada. Mi receta de entrenamiento propuesta adapta el transformer y la lectura a tareas de decisión con tipos mediante un objetivo basado en resultados. Eso da a la columna vertebral la oportunidad de construir representaciones útiles para decisiones fiables, y no solo completados fluidos.
Un objetivo natural es la pérdida logarítmica, para el resultado observado . Otro es la pérdida de Brier, la distancia al cuadrado entre la distribución predicha y el resultado observado en one-hot. Ambas son reglas de puntuación propias: en esperanza, informar la verdadera distribución condicional minimiza la pérdida. Gneiting y Raftery dan la definición formal y la teoría.13 Esto explica qué intenta lograr ese entrenamiento. No establece qué pérdida usa TypeSafe, si su pipeline es aprendizaje por refuerzo en un sentido algorítmico estricto, ni si se actualiza cada peso de la columna vertebral.
Que sean propias tampoco es una garantía de despliegue. Datos finitos, limitaciones del modelo, error de optimización y cambio de distribución pueden dejar la calibración imperfecta. Guo et al. muestran tanto los problemas de calibración de las redes neuronales modernas como la utilidad de los ajustes a posteriori. El entrenamiento y la calibración a posteriori son mecanismos compatibles; la API no puede separar sus contribuciones.14
Pruebas observadas. Los registros de benchmark nos permiten comparar la probabilidad predicha con la exactitud observada, tanto en agregado como dentro de intervalos de probabilidad. El gráfico muestra esas comprobaciones. La coincidencia de las medias por sí sola es una prueba más débil que la coincidencia dentro de los intervalos: el exceso de confianza en un grupo puede cancelar el defecto de confianza en otro. En la muestra de 1,200 ítems de MMLU, el error de calibración esperado con diez intervalos fue 0.0313 (definiciones de los intervalos y predicciones a nivel de ítem). La mayoría de las predicciones se concentraron cerca de la certeza: 990 cayeron en el intervalo 0.9–1.0.15
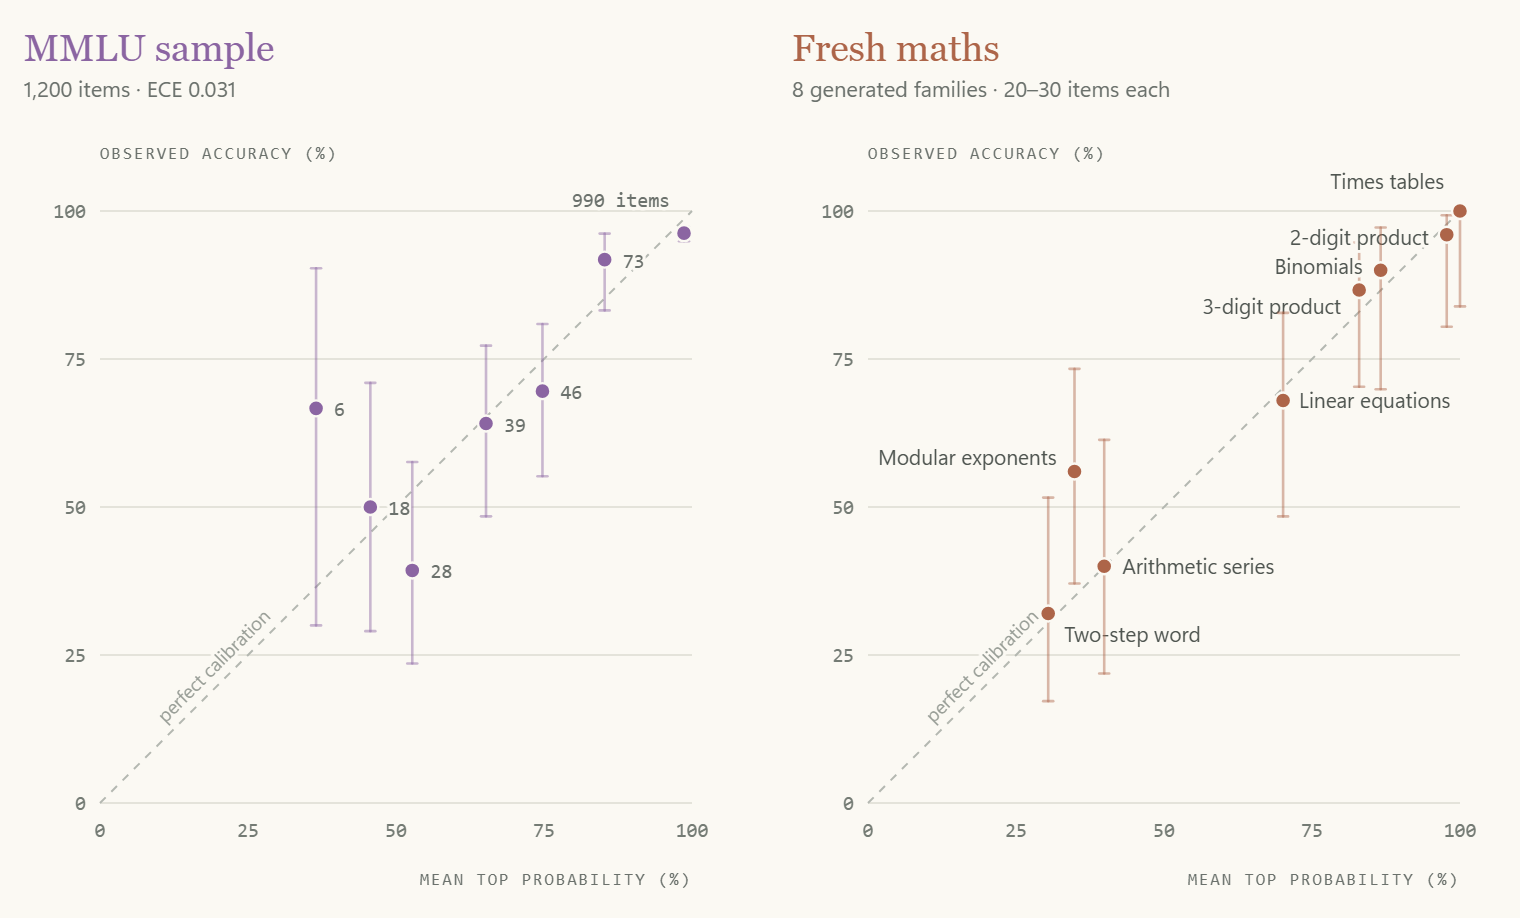
El pequeño estudio de matemáticas recién generadas añade una variación útil. En problemas generados de multiplicación de tres dígitos, la exactitud fue del 86.7% y la probabilidad superior media de 0.83. En problemas verbales de dos pasos, la exactitud cayó al 32% y la probabilidad superior media a 0.30. El modelo se mostró menos seguro en la tarea más difícil (fresh_math_results, con 30 ítems de multiplicación y 25 de problemas verbales).15 Eso es alentador, aunque medias pequeñas a nivel de categoría no pueden establecer la calibración para todo tipo de problema no visto.
Esos resultados también muestran por qué una puntuación de benchmark pública es una medida imperfecta de lo que sabe el modelo. La exactitud en MMLU-Pro fue del 84.6%; los problemas verbales recién generados eran mucho más difíciles.15 Las diferencias en la estructura de la tarea, los distractores, la dificultad y la exposición durante el entrenamiento podrían contribuir todas. Esa brecha no establece contaminación del benchmark. Una redacción nueva tampoco convierte en no vista la habilidad matemática o el conocimiento factual subyacentes.
Hay un hallazgo aparte, inusualmente claro, sobre el campo de la API llamado confidence. El adaptador oficial calcula la confianza de Choice a partir de una distribución normalizada, para , como:
Para tres opciones con una probabilidad máxima de 0.8, esto da 0.7. El adaptador trata el caso de una sola opción por separado, devolviendo 1. Mide cuánto se eleva la respuesta líder por encima de una distribución uniforme. No es otra estimación aprendida de que la respuesta sea correcta. El tipo Score usa una fórmula distinta que refleja la distancia al nivel modal.16
En el sistema propuesto, el entrenamiento produce la distribución predictiva; la aritmética corriente produce este campo de resumen. Mantener esos dos objetos separados evita un error conceptual común: una distribución concentrada puede seguir estando equivocada con confianza.
6. Capacidad dispersa
Espero que Jev use un transformer de mezcla de expertos dispersa. En capas seleccionadas, un enrutador envía cada token por un subconjunto pequeño de redes feed-forward, de modo que el modelo puede almacenar muchos parámetros y activar solo algunos de ellos para cada token: la idea de cómputo condicional demostrada por las capas MoE con compuerta dispersa de Shazeer et al.17
Los expertos dispersos no pueden observarse desde fuera, pero son la opción probable. Un modelo de solo prefill está limitado por el cómputo, que es justo lo que ahorra el enrutamiento disperso. Los costes habituales de servicio de un MoE casi desaparecen: no hay decodificación token a token, donde domina el ancho de banda de memoria y la mayoría de los expertos acaban activos de todos modos, y no hay una caché KV de larga vida compitiendo con los pesos de los expertos por la memoria. Las mediciones apuntan en la misma dirección. Jev procesó unos 30k tokens en aproximadamente 160 ms; un modelo denso de 70B en un nodo de 8×H100 necesitaría alrededor de un segundo, mientras que un MoE con unos 10B de parámetros activos encaja. Y la mayoría de los modelos base recientes más potentes (DeepSeek-V3, Qwen3, GLM-4.5, Kimi K2, gpt-oss) son MoE. Un hardware especializado podría permitir que un modelo denso igualara la velocidad, y las puntuaciones de benchmark pueden exagerar cuánto conocimiento retiene el modelo, así que esto sigue siendo una inferencia, no una medición.615
Nada más en la reconstrucción depende de ello. Sustituirlo por un transformer denso dejaría la interfaz, el estado compartido, las ramas aisladas y la lectura exactamente como se describen.
7. Programa las ramas como un lote, no como una conversación
El componente final es un motor de servicio que trata las ramas de preguntas como elementos de trabajo independientes. Sus sufijos pueden empaquetarse en lotes mientras leen las representaciones del estado compartido. El código de la aplicación asocia luego las salidas numéricas con los identificadores de pregunta y serializa la respuesta.
Las mediciones revelan pequeñas diferencias entre respuestas idénticas repetidas, incluidas las de preguntas duplicadas dentro de una misma solicitud. Esto significa que no debe darse por supuesto el determinismo a nivel de API (noise, dup y determinism).19 No implica que el modelo genere o muestree texto: los núcleos numéricos, el batching dinámico, el enrutamiento o una aleatoriedad deliberada pueden afectar a una lectura directa.
Los órdenes de las claves de respuesta también variaron en un pequeño número de patrones recurrentes.19 Varios workers con distinto orden de hash son una explicación plausible. Sin embargo, este canal lateral no identifica el número de workers, no establece dónde vive la caché KV ni nos dice qué precisión numérica se usa. Son detalles de implementación que las observaciones disponibles no pueden resolver.
Lo que importa para la arquitectura propuesta es la ausencia de una cadena de dependencia entre respuestas. El modelo no necesita terminar de escribir la clasificación de la cola antes de empezar la estimación de urgencia. Ambas dependen del estado; ninguna consume la respuesta generada por la otra.
Sigue habiendo un límite de dependencia. Si una pregunta posterior necesita realmente una respuesta anterior, la aplicación debe introducir otra etapa de decisión o expresar la decisión conjunta en una sola pregunta. Compartir el contexto no elimina la estructura lógica del flujo de trabajo.
¿Qué me haría cambiar de opinión?
Esta reconstrucción hace compromisos de distinto tipo. Las salidas directas de probabilidad están descritas públicamente. El aislamiento entre preguntas y los efectos del orden de las opciones son comportamientos observables. El uso compartido de la caché KV, la atención causal, las lecturas de posición final o de estilo puntero y los expertos dispersos son explicaciones progresivamente más específicas.
El experimento de la tarjeta de referencia zanja una pregunta: la decisión puede usar opciones colocadas al final. El test de opciones falsas muestra que los trucos en el formato de entrada no pueden falsificar las fronteras entre opciones. Tareas relacionales más amplias podrían restringir aún más la representación, aunque el éxito conductual por sí solo seguiría sin identificar de forma única una máscara de atención.
Para el manejo de opciones, el seguimiento aleatorizado replica un efecto del conjunto de opciones, pero la intervención sobre la descripción de tamaño fijo sigue siendo inconcluyente. Más plantillas y bloques de solicitudes independientes podrían distinguir un cambio de temperatura compartido de interacciones dependientes del contenido. Una tarea de dificultad media con 200 opciones podría separar la cabeza de ranuras del scorer puntero. Para la calibración, datos de flujo de trabajo reservados y evaluaciones repetidas bajo cambio importarían más que otra puntuación de benchmark agregada. Confirmar los expertos dispersos probablemente requeriría una revelación o pruebas más allá de esta API.
Mi mejor reconstrucción de Jev sigue siendo la del diagrama inicial: un transformer causal con un prefijo de estado compartido, sufijos de pregunta aislados, procesamiento de opciones a nivel de lista, lecturas numéricas con tipos y un entrenamiento orientado a distribuciones predictivas. Los expertos dispersos son la columna vertebral probable, aunque nada más en el diseño depende de ellos.
Su utilidad proviene de hacer coincidir el grafo computacional con el trabajo. Un servicio de decisión necesita leer pruebas, comparar resultados permitidos y exponer la incertidumbre. Un transformer puede hacer eso sin convertir antes cada decisión en una frase.
Métodos
Este ensayo se basa en una investigación del 17 de septiembre de 2026 sobre jev-1.13.0, con una cuenta de acceso anticipado y una región de servicio observada. El estudio original contiene 1,029 registros de sonda instrumentados (incluidos los 190 ítems de matemáticas generadas), 6,800 registros de benchmark y comprobaciones factuales aparte. Los estudios de seguimiento añadieron 146 solicitudes relacionales y de interacción entre opciones (ensayos, resumen), 311 solicitudes de contabilidad de tokens, 445 solicitudes de huella del tokenizador, 192 solicitudes de latencia, 148 solicitudes de latencia según el número de opciones, 181 solicitudes de posición de opción, 105 solicitudes de opciones falsas y 35 solicitudes de límite de contexto. Cada una está enlazada desde las referencias, con las solicitudes exactas y respuestas anonimizadas. Las configuraciones de benchmark repetidas comparten ítems subyacentes; estos recuentos no son recuentos de problemas independientes.
El paquete de pruebas descargable registra las observaciones usadas en este ensayo. Los ejemplos de API de la sección inicial son esquemáticos. Los prompts citados de visibility y de tarjeta de referencia provienen de los scripts de sonda y de las solicitudes de seguimiento guardadas. Las observaciones numéricas son específicas de esta versión del modelo y de esta campaña de pruebas.
Las cifras de latencia provienen de la cabecera de respuesta x-envoy-upstream-service-time. Son duraciones del servicio ascendente, con límites de cola y de ejecución desconocidos, en lugar de tiempos aislados del modelo. Los barridos de la figura de latencia se ejecutaron de una solicitud en una, en orden aleatorio; ninguno de los estudios controló la carga del servidor. Las mediciones locales de reloj de pared no se usan como prueba arquitectónica.
Las probabilidades se devolvían generalmente con dos decimales de precisión. Las preguntas duplicadas dentro de una solicitud comparten condiciones y pueden tener errores correlacionados. La figura de calibración de MMLU usa diez intervalos de igual anchura: [0, 0.1), [0.1, 0.2), y así sucesivamente, con 1.0 incluido en el último intervalo. El error de calibración esperado es la diferencia absoluta, ponderada por la muestra, entre la exactitud y la probabilidad superior media en cada intervalo. Las estimaciones dependen de la selección de la muestra, del agrupamiento en intervalos y del redondeo de las respuestas. Las pruebas respaldan afirmaciones sobre las distribuciones evaluadas, no una calibración garantizada en futuros flujos de trabajo de clientes.
Fuentes y trabajos relacionados
Las referencias experimentales identifican las etiquetas originales de los scripts para que cada observación pueda localizarse en el paquete de pruebas. Las citas de artículos establecen los mecanismos propuestos y sus precedentes; no establecen que Jev los use.
Fuentes
- TypeSafe (2026). Introducing System One Models and Jev. Fuente principal de la afirmación sobre la salida en paralelo y del objetivo RLCD declarado.
- TypeSafe. Documentación completa de la API, consultada el 17 de septiembre de 2026. Preguntas con tipos, distribuciones de respuesta y contrato de la API.
- Vaswani et al. (2017). Attention Is All You Need. Enmascaramiento del decodificador, atención y la capa de salida lineal/softmax.
- Experimentos de API: type_preamble y outputs. Aditividad de la contabilidad de tokens, cambios de identificador y la respuesta de 255 opciones.
- Experimento de API: visibility. Cinco repeticiones con el secreto en una pregunta hermana, ausente de esa hermana y en el estado.
- Barridos de latencia (192 solicitudes secuenciales). Longitud del estado y número de preguntas, 8 repeticiones en orden aleatorio cada uno; duraciones del servicio ascendente reportadas por el servidor.
- Juravsky et al. (2024). Hydragen: High-Throughput LLM Inference with Shared Prefixes.
- Yao et al. (2024). DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference.
- Experimento de API: option_order. Sensibilidad al orden en tickets corrientes.
- Experimento de API: iia. Tres solicitudes por condición, cada una con cuarenta preguntas duplicadas; conjuntos de opciones original, con opción añadida y con opción antepuesta.
- Reddy et al. (2024). FIRST: Faster Improved Listwise Reranking with Single Token Decoding.
- TypeSafe. Introducción al aprendizaje automático. Descripción principal de la ruta de post-entrenamiento RLCD y del contrato de calibración.
- Gneiting and Raftery (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association 102(477):359–378.
- Guo et al. (2017). On Calibration of Modern Neural Networks.
- Registros de benchmark y de matemáticas generadas: exactitud y probabilidades predichas medias. ; Análisis de fiabilidad de MMLU: definiciones de los intervalos, ECE, intervalos de Wilson y 1,200 predicciones a nivel de ítem.
- TypeSafe. Adaptador oficial de Python, confidence_metrics.py, revisión fb52b103. Fórmulas de confianza de Choice y Score (leído el 17 de septiembre de 2026).
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer.
- Experimento de huella del tokenizador (445 solicitudes). Sondas de longitud de secuencia, vocabulario y pre-tokenización, comparadas con 192 tokenizadores públicos.
- Experimentos de API: noise, dup y determinism. Probabilidades repetidas y órdenes de claves de respuesta.
- Experimento relacional de seguimiento (96 solicitudes). Dos plantillas, dos valores de referencia, seis permutaciones, dos ubicaciones y dos repeticiones; solicitudes exactas y respuestas anonimizadas.
- Experimento de interacción entre opciones de seguimiento (50 solicitudes). Diez bloques aleatorizados de base4, null4, append5, replace5 y null5; cambios emparejados y errores estándar.
- Experimento de límite de contexto (35 solicitudes secuenciales). Límites de tokens por rama y por solicitud completa, con casos límite aceptados y rechazados.
- Experimento de inyección de opciones falsas (105 solicitudes). Siete formatos de delimitador, tareas base saturadas y ambiguas, y vectores de probabilidad completos.
- Experimentos de contabilidad de tokens (311 solicitudes). Longitud del ID de pregunta, tamaño del lote, dificultad del estado, IDs de palabra y cadenas apareadas de estado frente a ID.
- Experimento de latencia según el número de opciones (148 solicitudes). Una o 20 preguntas con 2–200 opciones, etiquetas cortas y largas, más controles de desacoplamiento entrada/salida.
- Experimento de posición de opción (181 solicitudes). Límite del número de opciones, respuesta correcta desplazada por listas de 10, 50, 200 y 255 opciones.
Fuente: La arquitectura de Jev al descubierto — Archer, archerhume.com, 17 de septiembre de 2026.