Jev のアーキテクチャを暴く
10,000 回の API 呼び出しで Jev を探り、おおよその作りと、X にあふれる的外れな意見がなぜ間違っているのかを突き止めました。 X は Jev の発表についての思い付きで溢れていますが、そのほとんどは的を外しています。「JSON 分類器が 1,200 万回閲覧?ああ、これはもうバブルだ」。普通の LLM は「確信度 90%」という文字列を生成します。その語を出力する確率は、「正しい確率が 90% である」ことを何も意味しません。それなのに私たちは、まさにこのパターンの上に不正検知・モデレーション・ルーティング・リスク評価を築いています。トークン単位の生成に対価を払い、検証されていない確信度の主張を、ソフトウェアが行動の根拠にできる確率として扱っているのです。
Jev の提案はこうです。事前学習済み LLM の知識はそのままに、生成された確信度の主張を、内部表現から直接読み出した決定確率に置き換える。その確率は結果に対して訓練されています。共有された state と questions、そして許される答えを与えると、テキストを生成せずに分布を並列で返します。1 この種のアプリケーションにとって、これは二つの問題を同時に解決します。決定シグナルの信頼性と、それを生み出すために無駄にしていた計算です。
問題が一つだけあります。オープンウェイトではなく、TypeSafe は研究を公開しようとしない……ならば自分でやるまでです(できる範囲で)。
証拠は、因果的 transformer(おそらく疎な MoE)を決定タスクに転用したものを指しています。共有 state のエンコード、互いに独立した質問ブランチ、そしてテキスト生成ではなく確率の直接読み出しです。TypeSafe の API を探り(コンテキスト長を変えたときのレイテンシの伸び方や質問の並べ替えなど、痕跡を探しました)、Astra で公開ドキュメントと研究を洗い、先行事例を調べた結果、どう動いていてアーキテクチャがどんな形なのか、かなり正確なモデルが得られたと考えています。
疎なバックボーンが最も不確かな部分ですが、この領域では特に有利で、自己回帰 LLM より downside も小さいので、使っていないほうがむしろ奇妙です。共有計算と確率の直接出力については、証拠は明らかにはるかに強い。全体としてかなり推測的な話ですから、どこまでが TypeSafe の公表した証拠で、どこからが実験で観測したことで、どこからがそこからの推論なのか、できるだけ明確にしておきます。ブラックボックスの API は、幽霊に布をかけて大まかな輪郭を取ることさえ、驚くほど簡単にさせてくれます。
この設計が役に立つ理由
模式的なサポートルーティングのリクエストを考えます。API の構造を示すためのもので、以下の確率は私が作った例です。
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}有用な答えは、payments に 0.91、エスカレーション要否には 0.42 だけを割り当てるかもしれません。これは別種の不確かさです。ソフトウェアはチケットを自動で振り分けつつ、エスカレーションは別のポリシーに委ねられます。
因果的 transformer は、テキストの表現を左から右へ組み立てる方法をすでに知っています。通常の言語モデル推論では、プロンプトを処理し、次のトークンを一つ予測し、それを戻して、また繰り返します。これは原論文の Transformer が導入した decoder のアテンションと出力射影の上に成り立っています。3 しかしプロンプトを処理する段階そのものが、すでに豊かな表現を作り出しています。三つのキューのどれかを選ぶのが仕事なら、その表現を直接三つの数値に写す小さな関数をくっつければ済みます。
ここで一つの細部が、「並列に答えを返す」ことへの混乱の多くを解きます。因果的アテンションが述べているのは、どの位置がどの情報を使えるかであって、入力トークンを実行しなければならない順序ではありません。 プロンプト処理(prefill)の時点で、入力トークンはすべて既知です。モデルは同一層の中でそれらの位置をまとめて処理でき、アテンションマスクが後ろの位置へのアクセスを塞ぎます。層そのものは逐次実行されます。自己回帰デコーディングはもう一つ依存を足します。次のトークンは、前の予測が確定するまで存在しないのです。提案するモデルは prefill と読み出しで終わるので、このトークン単位の依存を避けられます。
これでタスクの計算の形が変わります。出力は "payments": 0.91 のために綴りの判断を延々と並べる必要がなくなります。JSON の整形は普通のアプリケーションコードが行います。ニューラルネットワークは確率を供給するだけです。
ここで state が長いインシデントレポートで、質問が五十個あるとします。入力の大部分は共有されています。transformer は処理済みトークンの途中情報をキー・バリューキャッシュ、ふつう KV cache と呼ぶ場所に保持します。この設計では、どの質問も同じ state キャッシュを読みます。各ブランチが足すのは、自分の instructions と回答候補だけです。
トークンの state と 個の質問があるとき、リクエストを分ければ state はおよそ 回処理されます。共有すれば、繰り返される state トークンの処理量は から に減ります。質問が state に attend する仕事は消えません。しかしモデルは state の表現を何度も作り直す必要がなくなります。
この分離はインターフェースにも意味を与えます。顧客が怒っているかを尋ねても、チケットがどのキューに行くかは変わらないべきです。両方の質問は同じ証拠を調べつつ、互いの instructions を読むことはありません。統計的に関連していても、ブランチ間に計算上の依存はありません。
最後に、確率は下流のポリシーを明示的にします。不要なエスカレーションのコストが 1、緊急案件の見落としが 9 なら、単純化した決定規則は のときにエスカレーションする、となります。この計算が意味を持つのは、その確率がこのワークフローに対して信頼できる範囲だけです。したがって確率分布の訓練と評価は、飾りの confidence フィールドではなく、製品の一部になります。
これらに diffusion は必要ありません。並列分類は何十年も前からあります。面白いのは、広く有能な transformer、共有された文脈計算、型付きの出力インターフェース、そして役に立つ不確かさを報いる訓練、という組み合わせです。
1. 生成ではなく読み出しで推論を終える
最初の要素は最も単純です。デコードループの代わりに予測ヘッドを置きます。
公表された証拠。 TypeSafe の発表はこう述べています。「Jev はトークンごとに自己回帰生成するのではなく、すべての確率を並列に出力する」。同社のドキュメントは有限の選択肢、はい/いいえの判断、順序付きスコアを提供します。これらは固定の数値出力で表すのが自然です。12
観測された証拠。 API はいまも output_tokens フィールドを返します。生成の記録のように聞こえますが、そうではありません。はい/いいえの質問では、この数がぴったり合います。共有 4 トークン、答えごとに 15、そこに各質問の識別子のトークン長。TypeSafe のドキュメントは、その識別子は「基盤モデルに送られず、推論にも使われない」と述べています。モデルが決して見ないテキストによって変わるカウントは、推論の後にシリアライズ済みレスポンスから計算されているはずです。返された値も影響しません。答えが 0.0 でも 0.01 でもコストは同じですが、それ以外では数字一桁が一トークンとして数えられます。224
このカウントの裏にあるトークナイザは、私たちが試した 192 個の公開トークナイザのどれとも一致しません。一方で、普通のテキストについては Jev 自身の入力カウンタと一致し、長い空白と約物の連続でのみ食い違います。output_tokens は課金用の数字です。Jev がテキストを生成するかどうかについては何も語りませんし、仮に生成していてもそのテキストを測ってはいません。レイテンシもこの数字には追随しません。200 個の候補を持つ質問(1,911 output tokens)は二つの候補のものと同じ速さで返り、サーバ時間は入力長によってのみ伸びました。2425
255 候補のレスポンスは 2,714 output tokens を報告しました。4 この数をリクエスト時間で割ってモデルのデコード速度と呼ぶのは誤りです。サーバは一度のモデル評価のあとに何千文字もシリアライズできます。課金フィールドは、ニューラルなデコードが何段あったかを語りません。
提案する読み出しは、最終の隠れベクトル から logits を作ります。
ここで は許される答えの数です。行列 が表現を答えのスコアに変え、softmax がそのスコアを分布にします。はい/いいえの判断なら、スカラー一つと sigmoid で足ります。
クラスは「payments」のような固定の概念である必要はありません。選択肢スロットでかまいません。第一の選択肢、第二の選択肢、第三の選択肢。各スロットの意味はブランチが与え、アプリケーションコードがその確率を呼び出し側の選択肢キーに戻します。順序付きの Score も同様に、段階ごとの確率を予測し、その確率による重み付き平均を返せます。こうすれば、顧客のラベルごとに新しいヘッドを訓練せずに新しい決定を支えられます。第 4 節で比較するポインタ型のスコアラが主な対案です。番号付きのスロットではなく、各選択肢自身の表現を採点します。
これは Jev に別名の分類器モジュールがあることの証明にはなりません。言語モデルの語彙ヘッドも、行列のあとに softmax が続く形です。その行列から 行の予約ラベルを選べば、専用の クラスヘッドと同じ計算になります。その行が入力埋め込みと共有されているのか、独立に訓練されているのかは、ここでは区別できません。
重要な区別は、確率を読み出すことと、確率を説明するテキストを生成することの間にあります。生成された「91%」はトークン列です。分類器の 0.91 は予測分布の一項目です。どちらもキャリブレーションがずれ得ますし、形式だけで信頼できるようになるわけでもありません。
制約付きテキストデコーディングで似たインターフェースを作る道も残っていますが、TypeSafe は別の出力経路を明示しています。彼ら自身の説明は、レイテンシの議論より強い証拠です。 証拠は直接の数値読み出しを指しており、それは第 4 節で比較する二つの設計の一方です。予約ラベル用トークンもあり得ますが、あちらの偽選択肢テストはそれに不利に働きます。
2. state を共有し、質問を分離する
次の決定は、計算をどこで再利用するかです。
観測された証拠。 小規模な統制例では、トークン課金は厳密に加算的です。最小のはい/いいえ質問は 268 入力トークン、二つなら 276。はい/いいえ一つ、二択の Choice 一つ、二段の Score 一つを含むリクエストは 318 で、共有オーバーヘッドを除いた各自の寄与の和に一致しました。これは共通プレフィックスと各質問のサフィックスという形に合いますが、課金だけでは計算グラフは特定できません。4
より情報量の多い実験は、証拠をその二つの領域の間で動かします。state は最初こうでした。
The weather is nice today and the park is full of people.兄弟の質問にはこう書かれていました。
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
プローブは「もう一方の質問が挙げたコードはどれか」を尋ね、選択肢は ZEBRA-7741、二つの妨害選択肢、そして none でした。秘密が兄弟の質問にあるとき、報告された確率は 0.00。その兄弟を外しても同じ結果でした。宣言を state に置くと 0.90–0.92 に上がります。各条件 5 回の繰り返しです(プローブ記録の visibility)。5
これは有用な介入です。宣言を API 境界の向こうに移すと、その効果が変わる。 質問間の振る舞い上の分離と、共有 state へのアクセスを支持します。正確なアテンションマスクを明かしてはいません。モデル呼び出しを分ける、木構造のマスクを使う、あるいは情報の流れを制限する別の仕組みでも、同じ結果は作れます。プローブの文言は state 条件でも「もう一方の質問」を尋ねているので、文字どおりの指示追従のきれいなテストではありません。
サービングの測定がもう一片を加えます。質問が 100 個くらいまではサーバ時間はほとんど変わりません。それを超えると着実に伸び、トークン当たりでは質問テキストのコストは state のおよそ二倍でした。これは state を一度だけ計算し、質問側をバッチ処理することと整合します。6
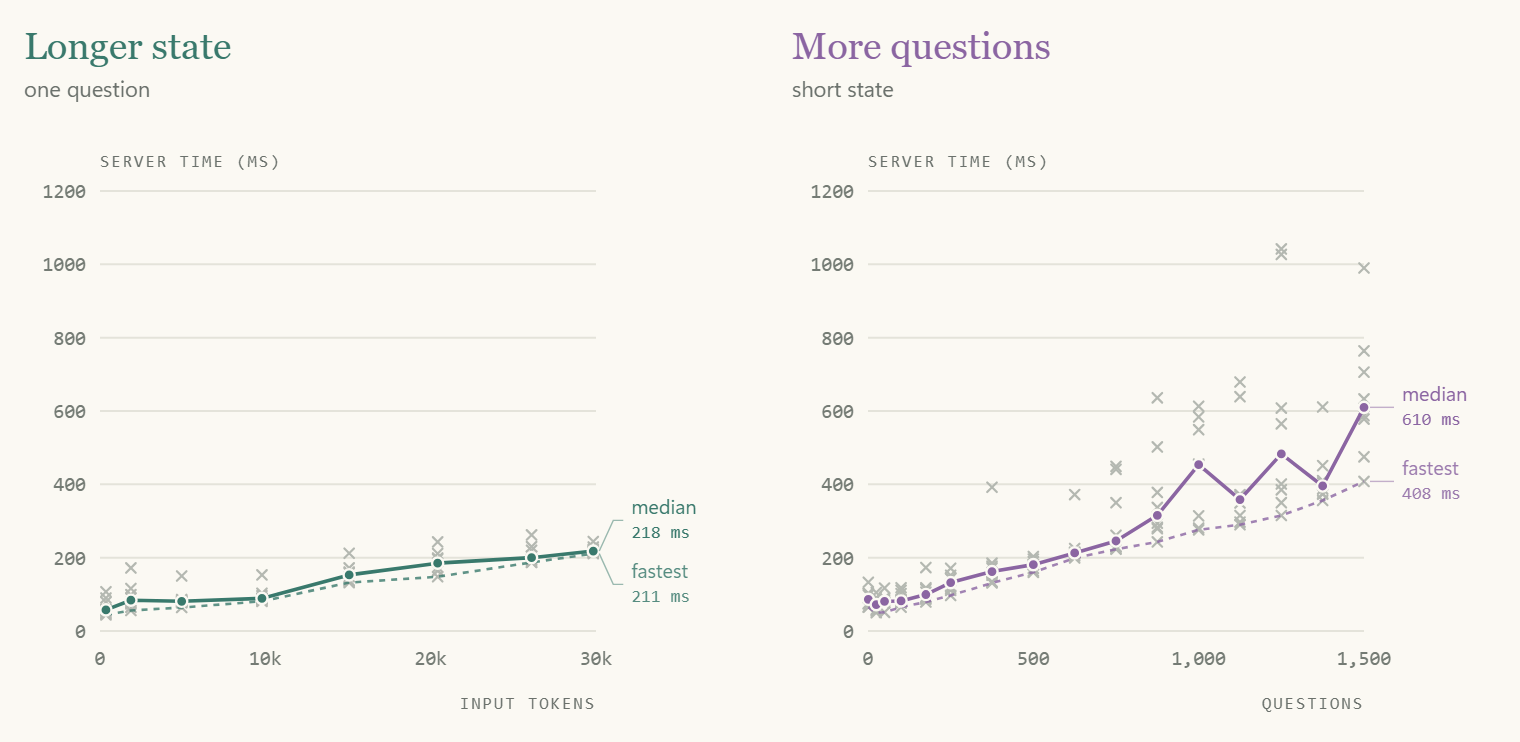
これらはサーバが報告したアップストリームの所要時間で、手元のノート PC の計測値ではありません。アップストリームサービスが含む作業と待ち時間を含み、しかもそのサービスは他の利用者と共有されていました。
Jev には二つの上限があります。各ブランチ(state と質問一つ)はおよそ 32,768 トークン、リクエスト全体はおよそ 65,536 トークンです。リクエスト上限では state は一度しか数えられません。23k トークンの state と 5,000 個の質問が収まります。もし各質問が state のコピーをそれぞれ処理するなら、そのリクエストは一億トークンを超えます。この二つは最大 2¹⁶ トークンの単一パック列にちょうど収まり、state を一度置いてそのあとに全質問を並べ、各ブランチは 2¹⁵ のコンテキストウィンドウに収める形になります。22
独立した因果サフィックスを持つプレフィックス KV キャッシュが自然な実装です。Hydragen はプレフィックスを共有する系列の効率的なアテンションを述べ、DeFT は木構造推論のアテンションを発展させました。これらはこのサービングパターンが実用的であることを示します。先行事例であって、TypeSafe がどちらかを使っている証拠ではありません。78
この設計は見かけの矛盾も解きます。分離された質問は、同じアクセラレータ上でまとめて評価できるのです。「並列」が述べているのはスケジューリングと答えの依存関係の不在であり、質問ごとに GPU が一つ必要という意味ではありません。
3. 因果的バックボーン
これらの実験では、因果的デコーダと双方向エンコーダを区別できません。どちらでも最終判断は入力全体を読めます。それでも因果的デコーダだと仮定します。理由は十分あります。Jev の知識の広さ(MMLU-Pro で 84.6%)はフロンティア規模の事前学習を要求し、その規模のモデルはすべて因果的デコーダで、TypeSafe は RLCD を事前学習済み言語モデルへの事後訓練と説明しています。双方向の Jev は、はるかに弱い土台か、コストを払ってデコーダを変換したもののどちらかで、しかも因果的サービングが与える共有プレフィックスのキャッシュを諦めることになります。驚きではありますが、外からは排除できません。1215
どの事前学習モデルかは不明で、トークナイザも明かしません。415 回のプローブで、Jev のトークン数は試した 192 個の公開トークナイザのどれとも一致しませんでした。数字は一桁ずつ分割し、一方でまとまった塊を先に引いてから統合します。a 8 個は 1 トークンですが、16 個は 4 トークンです。語彙は OpenAI の o200k に近く、Jev が 1 トークンと数える文字列は o200k でも 1 トークンですが、数字の分割と複数のマージ規則が o200k 自体を排除します。公開トークナイザで最も近いのは Qwen で、415 回のうち 348 回一致しました。これが排除するのは「改変されていない公開トークナイザ」であって、公開の土台モデルではありません。語彙の入れ替え、継続事前学習、蒸留のいずれでも説明できますし、モデルとは別の数え方をする API でも同じです。18
これらの実験が示すのは、判断が何を読めるかです。質問の選択肢のなかに「参照カード」を置き、カードの条件を満たす選択肢を一つ選ばせました。実際の選択肢の一つはこうです。
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.指示は「参照カードを読み、条件が満たされる一つの選択肢を選べ」でした。参照値を indigo に変えると、選べる選択肢は同じまま正解が切り替わります。
両方の値、六通りの並びすべて、そして route = east/west を使う二つ目のテンプレートを、各 2 回繰り返して試しました。対照として、参照を共有 state に置く版も用意しました。合わせて 48 回の選択肢内参照試行と 48 回の state 内参照対照になります。20
| 参照選択肢の位置 | 正解数 |
|---|---|
| 先頭 | 12 / 16 |
| 中央 | 11 / 16 |
| 末尾 | 16 / 16 |
| 参照カードを state に移動 | 48 / 48 |
Jev は候補の記述より後ろに置かれた情報を使えます。 参照が末尾にあるとき、毎回正しい選択肢を選び、正解の平均確率はおよそ 0.88 でした。
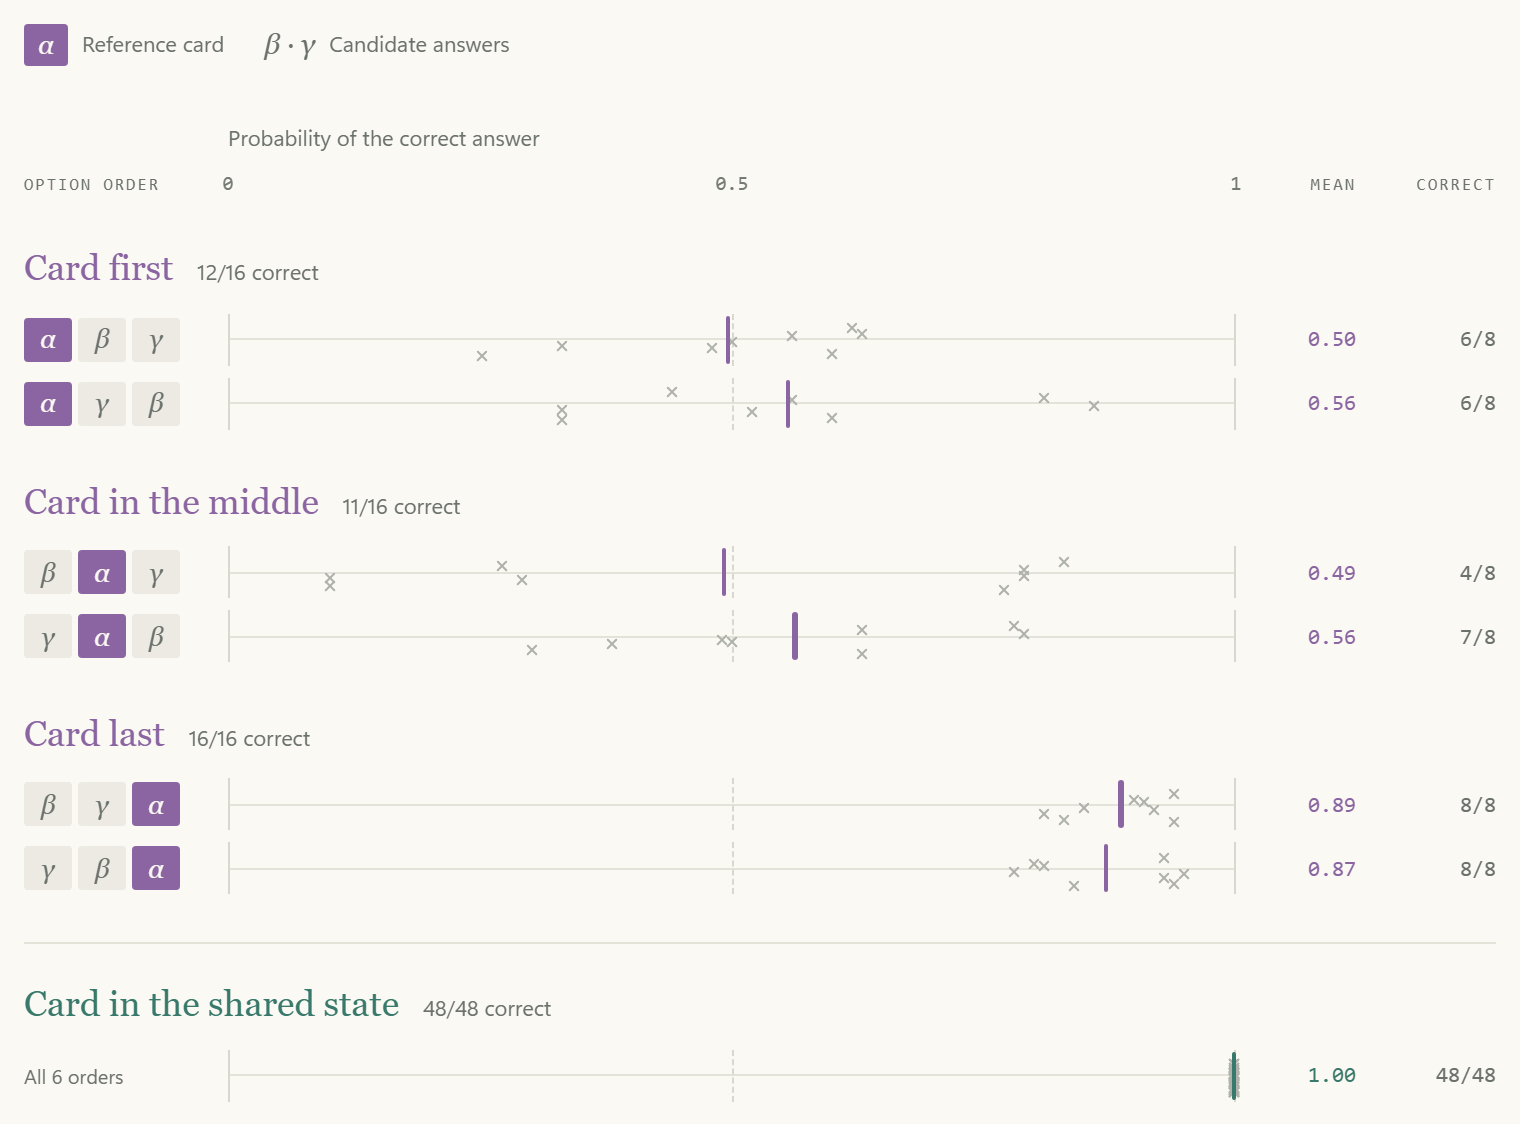
値の切り替え対照は、位置と同じくらい重要です。カードが末尾にあるとき、amber を indigo に変えるだけで、それより前の選択肢の勝敗が変わります。前の記述も state も同一のままです。各選択肢を独立に自分のテキストと state から採点し、あとで正規化するだけのモデルには、その事実が前の選択肢の相対順位を変える経路がありません。結果は、選択肢が共同の判断に影響する経路の存在を支持します。20
これはリスト全体のあとで計算される読み出しなら何でも当てはまります。第 4 節で比較する二つの設計も、独立した選択肢混合の段階も含みます。残った誤りは、この二つのテンプレートで位置に敏感な処理があることを示しますが、原因を一つに特定するものではありません。
この計算に diffusion は不要で、これらの実験のどこにも反復的なノイズ除去は必要ありません。擁護できるアーキテクチャ上の推論はもっと狭いものです。答えの計算は選択肢リスト全体にアクセスできる。次の実験は、それがその共同の文脈を実際に使っているかを試します。
4. 選ぶ前に選択肢を相互作用させる
一つの質問の内部では、証拠は別の情報境界を指します。候補は順序付きリストとしてまとめて読まれ、そのあとに判断の位置が一つ続きます。
なぜその相互作用を許すのか。「以上に該当なし」のような選択肢は、他の選択肢に依存します。普通の候補でも質問の意味を変えます。「支払い」「アカウントアクセス」「その他」が定義する判断は、「銀行」「決済事業者」「顧客」が定義するものとは別です。リスト全体の表現があれば、モデルは分布を出す前にその違いを解釈できます。
最も強い証拠は、無関係な選択肢を一つ足す実験から得られます。
支払い失敗の原因として四つを用意します。bank、provider、customer、unknown。そこに weather: Bad weather caused it を追加します。元の各選択肢が独立で不変の logit を受け取り、サーバが同じ softmax 温度を使うなら、五つ目の選択肢を足しても正規化が変わるだけで、既存二つの選択肢のオッズは変わりません。
共通の分母が消えます。ここから具体的で反証可能な予測が得られます。
元の研究はおよそ +0.49 から +0.08 への移動を報告しました。10 これが普通のリクエスト変動で説明できないかを確かめるため、実験を十のランダム化ブロックで繰り返しました。各ブロックには、四択のベースライン、同一の四択対照、weather を追加した五択、同一の五択対照、そして追加する記述を「Bad weather caused it」から「Wild birds caused it」に変えた五択が含まれます。各リクエストの質問は一つです。21
拡張の効果は再現しました。各ブロック内で同じ条件の二つの同一リクエストをまとめると、平均対数オッズは +0.38 から +0.11 に下がりました。十のブロックすべてで低下し、変化量の平均は −0.28、記述的な 95% 対応 t 区間はおよそ −0.36 から −0.19 です。このまとめ方は、重複した出力を独立な実験として扱うのではなく、対照リクエストで普通のリクエストノイズを抑えるために行っています。21
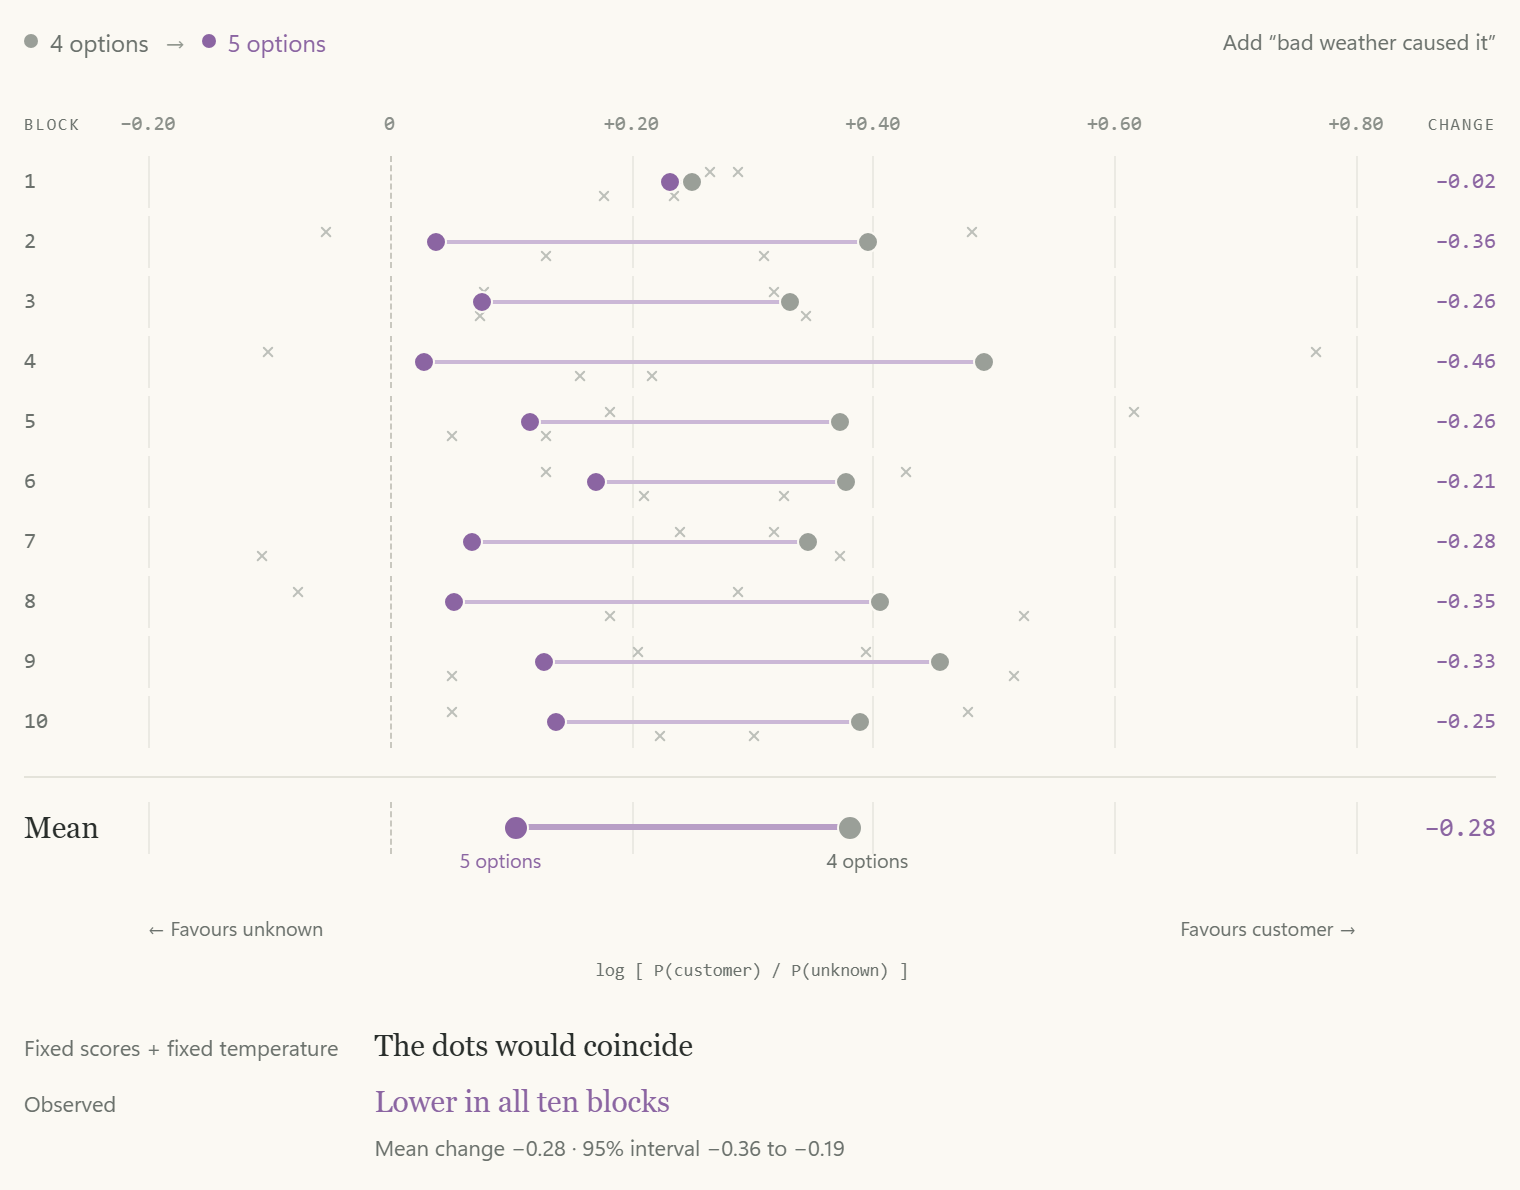
これは、固定された独立 logits と変わらない softmax に反する証拠です。機構を一意に特定するものではありません。五択のまま追加する記述だけを変えると、変化はより小さく結論は出ませんでした。対応区間がゼロを含みます。集合に依存する温度は依然としてあり得ますし、内容に依存する混合も同じです。
リスト全体が見える読み出しはこれを自然に説明します。選択肢を足せば、読む文脈が変わるのです。FIRST のリスト単位のランキング手法も同じ仕組みで、トークンごとに生成する代わりに最初のトークンの logits から順位を取り出します。11
証拠に合う読み出しは二つあります。最終位置ヘッドは判断トークンの表現から各選択肢スロットを採点します。ポインタ型のスコアラは、その表現と各選択肢自身の最終隠れ状態を比べます。どちらも選択肢同士が影響し合えます。API が受け付ける選択肢は最大 255(2⁸ − 1)で、固定 256 スロットのヘッドに合いますが、この上限はリクエスト検証が課すものでモデル自身のものではありません。200 個の選択肢では、コピーした答えがどの位置でも 1.00 を取り、誤りは隣の選択肢に漏れませんでした。これはポインタに合います。どちらの結果も決定的ではありません。26
注入した偽の選択肢が本物を押しのけることはなく、選択肢の境界はテキストでは偽造できない形で印が付けられています。条件がリスト内の別の場所で重複している選択肢は、確率を競合に奪われます。23
このトレードオフは普通のタスクでも見えます。選択肢を逆順にすると、ある技術サポート分類の確率がおよそ 0.84–0.89 から 0.93–0.96 へ動きました。option_order のプローブによるものです。9 運用中の決定ポリシーにとってこれは無視できません。ラベルも証拠も同一なのに、0.9 付近のしきい値では動作が変わり得ます。 この設計を実装するものの評価には、並べ替えテストが要ります。
5. 分布を訓練し、それから確信度を計算する
五つ目の要素は訓練目的です。数値を直接出力すればデコードの仕事は省けますが、安い確率が良い確率とは限りません。
緊急である確率を 0.8 とされた事例がたくさんあるとします。キャリブレーションが問うのは、そのうち本当に 80% ほどが緊急かどうかです。これは事例をまたいだ予測の性質です。ある一件がうまくいったかどうかから、その一つの予測がキャリブレーションされているかは判断できません。
TypeSafe は自社の訓練手法を Reinforcement Learning for Calibrated Decisions、略して RLCD と呼んでいます。発表では「System One タスクにおいて認識論的に正直な確率を伴う答え」を最適化すると述べ、同社の入門資料は RLCD を事前学習済み言語モデルからの事後訓練経路として示しています。112 正確なレシピは非公開です。私が提案する訓練レシピは、結果に基づく目的関数で transformer と読み出しを型付き決定タスクに適応させます。これによりバックボーンは、流暢な続きではなく、信頼できる判断に役立つ表現を構成する機会を得ます。
自然な目的関数の一つは log loss、観測された結果 に対する です。もう一つは Brier loss、予測分布と観測された one-hot 結果の二乗距離です。どちらも適正スコアリングルールです。期待値の意味で、真の条件付き分布をそのまま報告することが損失を最小にします。形式的な定義と理論は Gneiting と Raftery にあります。13 これはこうした訓練が何を目指すかを説明します。TypeSafe がどの損失を使っているか、そのパイプラインが狭いアルゴリズムの意味で強化学習かどうか、バックボーンの全重みが更新されるかどうかは特定しません。
適正であることは運用の保証でもありません。有限のデータ、モデルの限界、最適化誤差、分布シフトは、どれもキャリブレーションを不完全にします。Guo らは、現代のニューラルネットワークのキャリブレーション問題と、事後調整の有用性の両方を示しています。訓練と事後キャリブレーションは共存できる仕組みで、API はそれぞれの寄与を分けられません。14
観測された証拠。 ベンチマーク記録を使うと、予測確率と実測の正解率を、全体でも確率ビンの中でも比べられます。図 5 がその検査です。平均が一致することだけでは、ビンの中で一致するより弱い証拠です。ある集団の過信は、別の集団の自信不足を打ち消せます。 1,200 問の MMLU サンプルで、十分位ビンの期待キャリブレーション誤差は 0.0313 でした(ビン定義と問題単位の予測)。予測のほとんどは確実性の近くに集中しており、990 件が 0.9–1.0 のビンに入りました。15
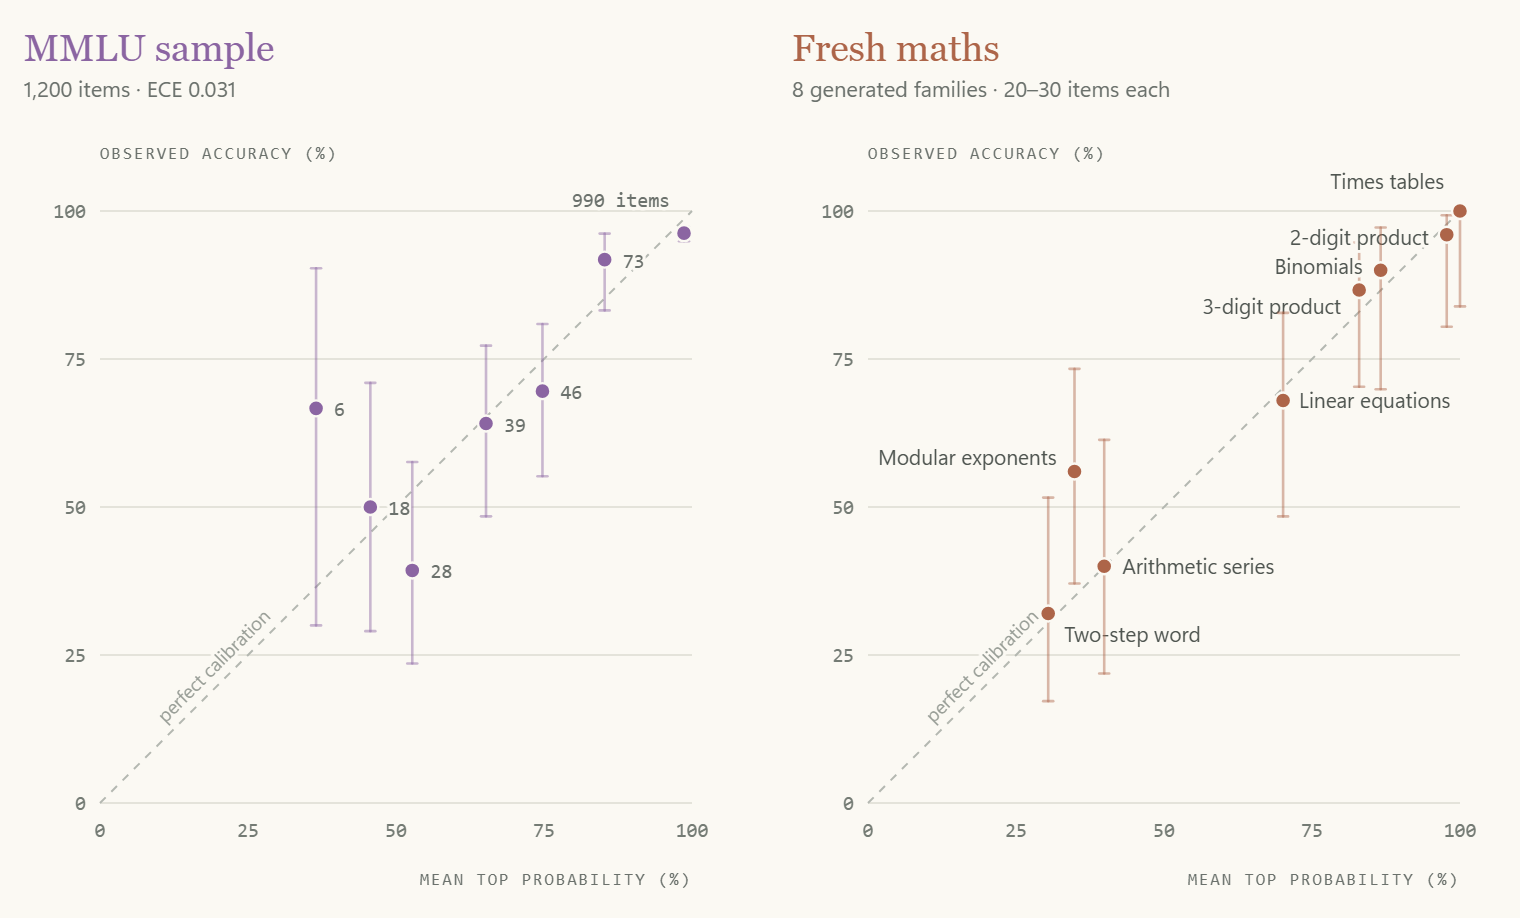
新しく作った数学の小規模研究は有用な変化を加えます。生成した三位数のかけ算では正解率 86.7%、平均最高確率 0.83。二段階の文章題では正解率が 32%、平均最高確率が 0.30 に落ちました。難しいタスクほど自信が低いわけです(fresh_math_results、かけ算 30 問と文章題 25 問)。15 心強い結果ですが、小さなカテゴリ単位の平均では、あらゆる未知の問題についてのキャリブレーションは示せません。
これらの結果は、公開ベンチマークのスコアが「モデルが何を知っているか」の不完全な尺度である理由も示します。MMLU-Pro の正解率は 84.6% でしたが、新しく生成した文章題はずっと難しいものでした。15 タスク構造、妨害選択肢、難易度、訓練での露出の違いがどれも寄与し得ます。この差はベンチマーク汚染の証明にはなりません。 文言を新しくしても、土台にある数学的技能や事実知識が見たことのないものになるわけではありません。
API の confidence というフィールドについては、別に、異常に明快な発見があります。公式アダプタは の Choice の確信度を、正規化された分布からこう計算します。
選択肢が三つで最大確率が 0.8 のとき、これは 0.7 になります。アダプタは選択肢が一つの場合を別に扱い、1 を返します。これは先頭の答えが一様分布よりどれだけ上にあるかを測っています。「この答えは正しい」という別の学習済み推定ではありません。Score 型は最頻の段階からの距離を反映する別の式を使います。16
提案する仕組みでは、予測分布は訓練が生み、この要約フィールドは普通の算術が生みます。この二つを分けておくと、よくある概念的な間違いを避けられます。集中した分布でも、自信をもって間違うことはできるのです。
6. 疎な容量
Jev は疎な mixture-of-experts transformer を使っていると予想します。選ばれた層で、ルータが各トークンを一部のフィードフォワードネットワークだけに通します。これにより、多数のパラメータを保持しつつ、トークンごとにその一部だけを活性化できます。Shazeer らが示した疎にゲートされた MoE 層の条件付き計算の考え方です。17
疎なエキスパートは外から観測できませんが、選ばれている可能性が高い選択です。prefill だけのモデルは計算量に律速され、疎なルーティングが節約するのはまさにそこです。MoE に通常つきまとうサービング費用もここではほとんど消えます。トークンごとのデコーディングがなく(そこではメモリ帯域が支配的で、結局ほとんどのエキスパートが活性化します)、長生きする KV キャッシュがエキスパートの重みとメモリを奪い合うこともありません。測定も同じ方向を指します。Jev は約 30k トークンをおよそ 160 ms で処理しました。8×H100 ノード上の密な 70B モデルなら一秒ほどかかるところで、活性パラメータ約 10B の MoE なら収まります。そして近年の最も強い土台モデルの多く(DeepSeek-V3、Qwen3、GLM-4.5、Kimi K2、gpt-oss)は MoE です。専用ハードウェアなら密なモデルでも同じ速度に届くかもしれませんし、ベンチマークのスコアはモデルが実際に保持する知識を過大評価しているかもしれません。したがってこれは推論であって測定ではありません。615
この再構成の他の部分はこれに依存しません。密な transformer に差し替えても、インターフェース、共有 state、分離されたブランチ、読み出しは記述どおりのままです。
7. ブランチは会話ではなくバッチとしてスケジュールする
最後の要素は、質問ブランチを独立した作業項目として扱うサービングエンジンです。そのサフィックスは、共有 state の表現を読みながらバッチに詰められます。あとはアプリケーションコードが数値出力を質問の識別子に対応づけ、レスポンスをシリアライズします。
測定は、繰り返した同一の答えの間に小さな差があることを示しました。同じリクエスト内の重複した質問の間にもです。つまり API レベルでの決定性は前提にできません(noise、dup、determinism)。19 これはモデルがテキストを生成・サンプリングしているという意味ではありません。数値カーネル、動的バッチ処理、ルーティング、意図的なランダム性のどれもが、直接の読み出しに影響し得ます。
レスポンスのキー順も、少数の繰り返し現れるパターンの中で変動しました。19 ハッシュ順の異なる複数のワーカーという説明がもっともらしいです。ただしこの側チャネルは、ワーカー数も KV キャッシュの置き場所も、使われている数値精度も特定しません。それらは手元の観測では解けない実装の詳細です。
提案するアーキテクチャにとって大事なのは、答えの間に依存の連鎖がないことです。キュー分類を書き終えてから緊急度の推定を始める必要はありません。どちらも state に依存し、どちらも相手が生成した答えを消費しません。
依存の限界は残ります。後ろの質問が本当に前の答えを必要とするなら、アプリケーションは別の決定段階を挟むか、共同の判断を一つの質問として表現しなければなりません。文脈を共有しても、ワークフローの論理構造が消えるわけではありません。
何があれば考えを変えるか
この再構成の中身は、性質の異なる約束事からできています。確率の直接出力は公開で説明されています。質問の分離と選択肢順の効果は観測できる振る舞いです。KV 共有、因果的アテンション、最終位置またはポインタ型の読み出し、疎なエキスパートは、より具体的な説明です。
参照カード実験は一つの問いに決着をつけました。判断は末尾に置かれた選択肢を使えます。偽選択肢テストは、入力形式の細工では選択肢の境界を偽造できないことを示しました。より広い関係的タスクは表現をさらに制約し得ますが、振る舞い上の成功だけではアテンションマスクを一意に特定できないままです。
選択肢の扱いについては、ランダム化した追試が選択集合の効果を再現しましたが、記述長を固定する介入は結論が出ていません。テンプレートと独立したリクエストブロックを増やせば、共有された温度の変化と、内容に依存する相互作用を区別できるでしょう。中程度の難易度で 200 選択肢のタスクは、スロットヘッドとポインタ型スコアラを分けられます。キャリブレーションについては、留保したワークフローのデータと、シフト下での繰り返し評価のほうが、もう一つの全体ベンチマークスコアより重要です。疎なエキスパートの確認には、おそらく開示か、この API の外側の証拠が要ります。
Jev についての私の最良の再構成は、冒頭の図のままです。共有 state をプレフィックスに持つ因果的 transformer、互いに分離された質問サフィックス、リスト単位の選択肢処理、型付きの数値読み出し、そして予測分布に向けられた訓練。疎なエキスパートはバックボーンの最有力候補ですが、設計のほかの部分はそれに依存していません。
その有用さは、計算グラフを仕事に合わせるところから来ます。決定サービスは、証拠を読み、許された結果を比べ、不確かさを提示する必要があります。transformer は、あらゆる判断をまず一文にすることをせずに、それができます。
方法
本稿は 2026 年 9 月 17 日の jev-1.13.0 の調査に基づきます。用いたのは early access のアカウント一つと、観測できたサービングリージョン一つです。元の研究には 1,029 件の計装プローブ記録(生成数学 190 問を含む)、6,800 件のベンチマーク記録、および別途の事実確認が含まれます。追試では、関係的・選択肢相互作用のリクエスト 146 件(trials、summary)、トークン課金 311 件、トークナイザ指紋 445 件、レイテンシ 192 件、選択肢数レイテンシ 148 件、選択肢位置 181 件、偽選択肢 105 件、コンテキスト上限 35 件が加わりました。いずれも参考文献からリンクされており、正確なリクエストとサニタイズ済みのレスポンスが付いています。繰り返されたベンチマーク構成は同じ問題を共有しており、これらの件数は独立した問題の数ではありません。
ダウンロード可能な証拠バンドルに、本稿で使った観測が記録されています。冒頭の API の例は模式的なものです。引用した visibility と参照カードのプロンプトは、プローブスクリプトと保存した追試リクエストによるものです。数値の観測はこのモデルバージョンとこのテストに固有のものです。
レイテンシの数値は x-envoy-upstream-service-time レスポンスヘッダによるものです。これはアップストリームサービスの所要時間で、キューイングと実行の境界が不明であり、切り出したモデルの計測ではありません。レイテンシ図の掃引は一度に一リクエスト、順序をランダムにして実行しました。サーバ負荷を統制した研究は一つもありません。ローカルの実時間計測はアーキテクチャの証拠には使っていません。
確率はおおむね小数二桁で返されました。同一リクエスト内の重複した質問は条件を共有し、誤差が相関する可能性があります。MMLU のキャリブレーション図は十個の等幅ビンを使います。[0, 0.1)、[0.1, 0.2)、…と続き、1.0 は最後のビンに入ります。期待キャリブレーション誤差は、各ビンにおける正解率と平均最高確率の差の絶対値を、そのビンのサンプル数で重み付けしたものです。推定値はサンプル選択、ビン分割、レスポンスの丸めに依存します。証拠が支えるのはテストした分布についての主張であり、将来の任意の顧客ワークフローに対するキャリブレーションの保証ではありません。
出典と関連研究
実験に関する参考文献は、各観測を証拠バンドルの中で見つけられるよう、元のスクリプトタグを示しています。論文の引用は、提案した機構とその先例を確立するものであって、Jev がそれらを使っていることを確立するものではありません。
出典
- TypeSafe(2026)。Introducing System One Models and Jev。並列出力の主張と宣言された RLCD 目的に関する一次資料。
- TypeSafe。API ドキュメント全文、2026 年 9 月 17 日閲覧。型付きの質問、レスポンス分布、API 契約。
- Vaswani ら(2017)。Attention Is All You Need。デコーダのマスク、アテンション、線形/softmax 出力層。
- API 実験:type_preamble と outputs。トークン課金の加法性、識別子の変化、255 候補のレスポンス。
- API 実験:visibility。秘密を兄弟の質問に置いた場合、その兄弟から外した場合、state に置いた場合を各 5 回。
- レイテンシ掃引(192 回の逐次リクエスト)。state 長と質問数、各 8 回のランダム順の繰り返し。サーバ報告のアップストリーム所要時間。
- Juravsky ら(2024)。Hydragen: High-Throughput LLM Inference with Shared Prefixes。
- Yao ら(2024)。DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference。
- API 実験:option_order。通常のチケットでの選択肢順への感受性。
- API 実験:iia。条件ごとに 3 リクエスト、各 40 個の重複した質問。元のまま、追加、先頭に挿入した選択集合。
- Reddy ら(2024)。FIRST: Faster Improved Listwise Reranking with Single Token Decoding。
- TypeSafe。機械学習入門資料。RLCD の事後訓練経路とキャリブレーション契約に関する一次的な説明。
- Gneiting と Raftery(2007)。Strictly Proper Scoring Rules, Prediction, and Estimation。Journal of the American Statistical Association 102(477):359–378。
- Guo ら(2017)。On Calibration of Modern Neural Networks。
- ベンチマークと生成数学の記録:正解率と平均予測確率。 ;MMLU 信頼性分析:ビン定義、ECE、Wilson 区間、1,200 件の問題単位の予測。
- TypeSafe。公式 Python アダプタ confidence_metrics.py、リビジョン fb52b103。Choice と Score の確信度の式(2026 年 9 月 17 日閲覧)。
- Shazeer ら(2017)。Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer。
- トークナイザ指紋実験(445 リクエスト)。ランレングス、語彙、事前トークン化のプローブを 192 個の公開トークナイザと比較。
- API 実験:noise、dup、determinism。繰り返した確率値とレスポンスのキー順。
- 追試の関係実験(96 リクエスト)。二つのテンプレート、二つの参照値、六つの順列、二つの位置、二回の繰り返し。正確なリクエストとサニタイズ済みレスポンス付き。
- 追試の選択肢相互作用実験(50 リクエスト)。base4、null4、append5、replace5、null5 からなる十のランダム化ブロック。対応のある変化量と標準誤差。
- コンテキスト上限実験(35 回の逐次リクエスト)。ブランチ単位とリクエスト全体のトークン上限、受理・拒否された境界事例付き。
- 偽選択肢注入実験(105 リクエスト)。七種類の区切り形式、飽和したベースタスクと曖昧なベースタスク、完全な確率ベクトル。
- トークン課金実験(311 リクエスト)。質問 ID の長さ、バッチサイズ、state の難易度、単語 ID、state と ID 文字列の対応付け。
- 選択肢数レイテンシ実験(148 リクエスト)。質問 1 個または 20 個に 2〜200 の選択肢、短いラベルと長いラベル、さらに入力/出力の分離対照。
- 選択肢位置実験(181 リクエスト)。選択肢数の上限、10・50・200・255 個のリストで正解を移動。
出典: Jev’s Architecture Unmasked —— Archer、archerhume.com、2026 年 9 月 17 日。