Jev 的架構揭秘
我用 10,000 次 API 呼叫探測 Jev,大致推斷出它是怎麼造出來的,以及為什麼 X 上那些蹭熱度的說法基本都是錯的。 X 上關於 Jev 釋出的說法鋪天蓋地,而絕大多數都沒抓住要點:“一個 JSON 分類器 1200 萬次瀏覽?好吧,我們確實在泡沫裡。” 普通的 LLM 是把“我有 90% 的把握”這句話當成文本生成出來的;它生成這幾個詞的機率,並不能構成“它說對了的機率是 90%”這個結論。可我們恰恰是在這個模式上搭起了欺詐篩查、內容稽核、路由和風險評估:花錢做逐 token 生成,然後把一句未經校驗的置信度宣告,當作軟體可以據以行動的機率。
Jev 的命題是:保留預訓練 LLM 的知識,同時把「生成的置信度宣告」換成直接從內部表示裡讀出的決策機率。這些機率是拿結果訓練出來的。給它共享的 state、若干個 question 和允許的答案,它並行地返回分佈,不生成文本。1 對這類應用來說,這一下同時解決了兩個問題:決策訊號的可信度,以及為了產出這個訊號而多花掉的算力。
只有一個問題:它不是開放權重,而 TypeSafe 不肯公開他們的研究……那我就自己來(盡力而為)。
證據指向一個因果 transformer(很可能用了稀疏 MoE),被改造成了做決策的模型:共享狀態編碼、彼此隔離的問題分支、以及直接讀出機率而不是生成文本。我探測了 TypeSafe 的 API(在不同上下文長度下找延遲伸縮的特徵、重排問題順序等),用 Astra 翻遍了公開文件與研究,又去查了已有的先例,現在我覺得自己對它怎麼運作、架構長什麼樣,已經有了一個相當接近的模型。
稀疏骨幹是其中最不確定的一環,但它在這個領域特別有利,代價比自迴歸 LLM 還小,所以如果沒用反而奇怪。共享計算和直接輸出機率這兩點,證據則充分得多。這整套東西顯然相當推測性,所以我會盡量講清楚:哪些是 TypeSafe 自己公佈的,哪些是實驗觀測到的,哪些是從前兩者推斷的。黑盒 API 讓「蒙上一層布去摸鬼的形狀」出奇地容易。
這個設計為什麼有用
設想一個示意性的客服路由請求。它用來說明 API 的結構;下面的示例機率是我編的。
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}
一個有用的回答可能給 payments 0.91 的機率,而只給「需要升級」0.42。這是兩種不同的不確定性。軟體可以自動把工單路由出去,同時把「是否升級」交給另一套策略。
因果 transformer 本來就知道怎麼從左到右構造一段文本的表示。在普通的語言模型推理裡,它處理 prompt,預測一個 token,把這個 token 喂回去,如此重複。這建立在原始 Transformer 提出的 decoder 注意力與輸出投影之上。3 但處理 prompt 這一步本身就已經產出了一份豐富的表示。如果任務是在三個佇列裡選一個,我們完全可以接一個小小的函式,把那份表示直接對映成三個數字。
這裡的一個細節能解開「並行回答」上的大部分困惑:因果注意力描述的是哪些位置能用哪些資訊,而不是輸入 token 必須以什麼順序被執行。 在處理 prompt(也就是 prefill)時,每個輸入 token 都已經知道了。模型可以在同一層裡同時處理它們各自的位置,而注意力掩碼擋住對後面位置的訪問;層與層之間仍然是順序執行的。自迴歸解碼多出來的那層依賴是:下一個 token 在上一個預測被定下來之前並不存在。而我們設想的模型在 prefill 和讀出之後就結束了,所以避開了這個逐 token 的依賴。
這改變了任務的計算形狀。輸出不再需要為 "payments": 0.91 做一長串拼寫決策。JSON 格式化交給普通的應用程式碼。神經網路只負責給出機率。
現在假設 state 是一份很長的故障報告,還有五十個問題。輸入裡絕大部分是共享的。transformer 把已處理 token 的中間資訊存在它的鍵值快取裡,通常簡稱 KV cache。在這個設計裡,每個問題讀的都是同一份 state 快取。每個分支只額外加上自己的 instructions 和答案選項。
對於一個 個 token 的 state 和 個問題,拆成獨立請求的話,state 大約要被處理 次。共享之後,重複的 state token 處理量從 降到 。問題仍然要去 attend state,這部分工作不會消失。但模型不必一遍遍重建 state 的表示。
這種隔離也讓介面有了一個有用的含義:問「這位客戶是不是生氣了」,不應該改變工單被分到哪個佇列。兩個問題可以檢視同樣的證據,而不會讀到彼此的 instructions。分支之間沒有計算上的依賴,哪怕它們的答案在統計上相關。
最後,機率讓下游策略變得顯式。如果一次多餘的升級代價是 1,而漏掉一個緊急案例的代價是 9,那麼一條簡化的決策規則就是:當 時升級。這個計算只有在「機率對這個工作流確實可靠」的前提下才有意義。因此,訓練和評測這個機率分佈本身就成了產品的一部分,而不是一個裝飾性的 confidence 欄位。
這些都不需要 diffusion。並行分類已經存在幾十年了。真正有意思的組合是:一個能力廣博的 transformer、共享的上下文計算、帶型別的輸出介面,以及一種訓練:獎勵「有用的不確定性」。
1. 用讀出取代生成來結束推理
第一個元件最簡單:用預測頭取代解碼迴圈。
公開證據。 TypeSafe 的釋出公告說:「Jev 並行輸出全部機率,而不是逐 token 自迴歸生成。」它的文件提供有限選項、是/否判斷和有序評分。這些天然就該用固定數值輸出來表示。12
觀測證據。 API 仍然報告一個 output_tokens 欄位,聽起來像是生成記錄。它不是。對是/否問題,這個數字嚴絲合縫:4 個共享 token,加上每個答案 15 個,再加上每個問題識別符號的 token 長度。TypeSafe 的文件說這個識別符號「不會發送給底層模型,也不參與推理」。一個隨模型從未見過的文本而變化的計數,只能是在推理之後、根據序列化後的響應算出來的。返回的數值也影響不了它:答案是 0.0 和答案是 0.01 花的錢一樣多,而其他情況下每位數字都算一個 token。224
這個計數背後的分詞器,和我們測過的 192 個公開分詞器都對不上。但它對普通文本的計數與 Jev 自己的輸入計數器一致,只在長串空白和標點上不同。output_tokens 是一個計費數字。它說明不了 Jev 是否生成文本,就算它真的生成,這個數字也量不了那些文本。延遲同樣跟它沒關係:一個有 200 個選項的問題(1,911 output tokens)返回得和只有兩個選項的一樣快,服務端耗時只隨輸入長度增長。2425
有一個 255 選項的響應報告了 2,714 output tokens。4 拿這個數除以請求耗時,把它叫作模型的解碼速度,是錯的。伺服器完全可以在一次模型求值之後序列化出幾千個字元。這個計費欄位說明不了發生過多少次神經解碼步驟。
這個讀出方案取最終的隱向量 ,產出 logits:
這裡 是允許的答案數。矩陣 把表示變成答案得分;softmax 把得分變成一個分佈。對於是/否決策,一個標量加一個 sigmoid 就夠了。
這些類別不必是「payments」這種固定概念。它們可以是選項槽位:第一個選項、第二個選項、第三個選項。分支提供每個槽位的含義;應用程式碼把它的機率映射回呼叫方給的選項鍵。有序的 Score 同理:在若干檔位上預測機率,再返回它們的機率加權平均。這樣就不必為每個客戶的標籤各訓一個新頭,也能支援新的決策。第 4 節會對比的指標式打分器是主要的替代方案:它給每個選項自己的表示打分,而不是給編號槽位打分。
這並不能證明 Jev 裡有一個單獨命名的分類器模組。語言模型的詞表頭也是一個矩陣接 softmax。從那個矩陣裡挑出 行保留的標籤,就能實現和一個專門的 分類頭相同的計算。這些行可能與輸入嵌入共享,也可能單獨訓練;在這裡我們區分不了這些安排。
關鍵的區別在於讀出機率和生成描述機率的文本。生成出來的「91%」是一串 token。分類器的 0.91 是它預測分佈裡的一個條目。兩者都可能失校準。誰也不會僅僅因為形式而變得可信。
受限文本解碼仍然是搭建類似介面的一條可能路徑,但 TypeSafe 明確描述了另一條輸出通路。他們自己的說法比一個延遲論證更有分量。 證據指向直接數值讀出,也就是第 4 節對比的兩種設計之一。保留標籤 token 仍然可能,不過那一節的假選項測試對它不利。
2. 共享 state,隔離問題
下一個決策是:在哪一層複用計算。
觀測證據。 在小規模受控例子裡,token 計費是精確可加的。一個最小的是/否問題用了 268 個輸入 token;兩個用了 276 個。一個包含一個是/否問題、一個兩選項 Choice 和一個兩檔 Score 的請求用了 318 個,正好等於它們各自在共享開銷之上的貢獻之和。這符合「一個公共字首 + 各問題字尾」的形態,雖然僅憑計費無法確定計算圖長什麼樣。4
一個資訊量更大的實驗是把證據在這兩個區域之間搬動。state 一開始寫的是:
The weather is nice today and the park is full of people.一個兄弟問題裡寫的是:
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
探測問的是「另一個問題裡提到了哪個密碼」,選項有 ZEBRA-7741、兩個干擾項和 none。密碼放在兄弟問題裡時,它報告的機率是 0.00;把那個兄弟問題刪掉,結果一樣。把宣告放到 state 裡,機率升到 0.90–0.92。每種條件重複五次(探測記錄裡的 visibility)。5
這是一個很有用的干預:把一個宣告移過一條 API 邊界,就改變了它的效果。 它支援「問題之間存在行為隔離」以及「可以訪問共享 state」。它沒有暴露確切的注意力掩碼 —— 拆成多次模型呼叫、使用樹形掩碼、或者其他限制資訊流動的機制,都能產生同樣的結果。探測的措辭即使在 state 條件下也問的是「另一個問題」,所以它不是一次乾淨的「字面指令遵循」測試。
服務端測量又補上一塊。問題數到 100 左右之前,服務端耗時幾乎不變;過了這個點就穩定上升,而且按 token 計,問題文本的代價大約是 state 的兩倍。這與「state 只算一次、問題部分批處理」一致。6
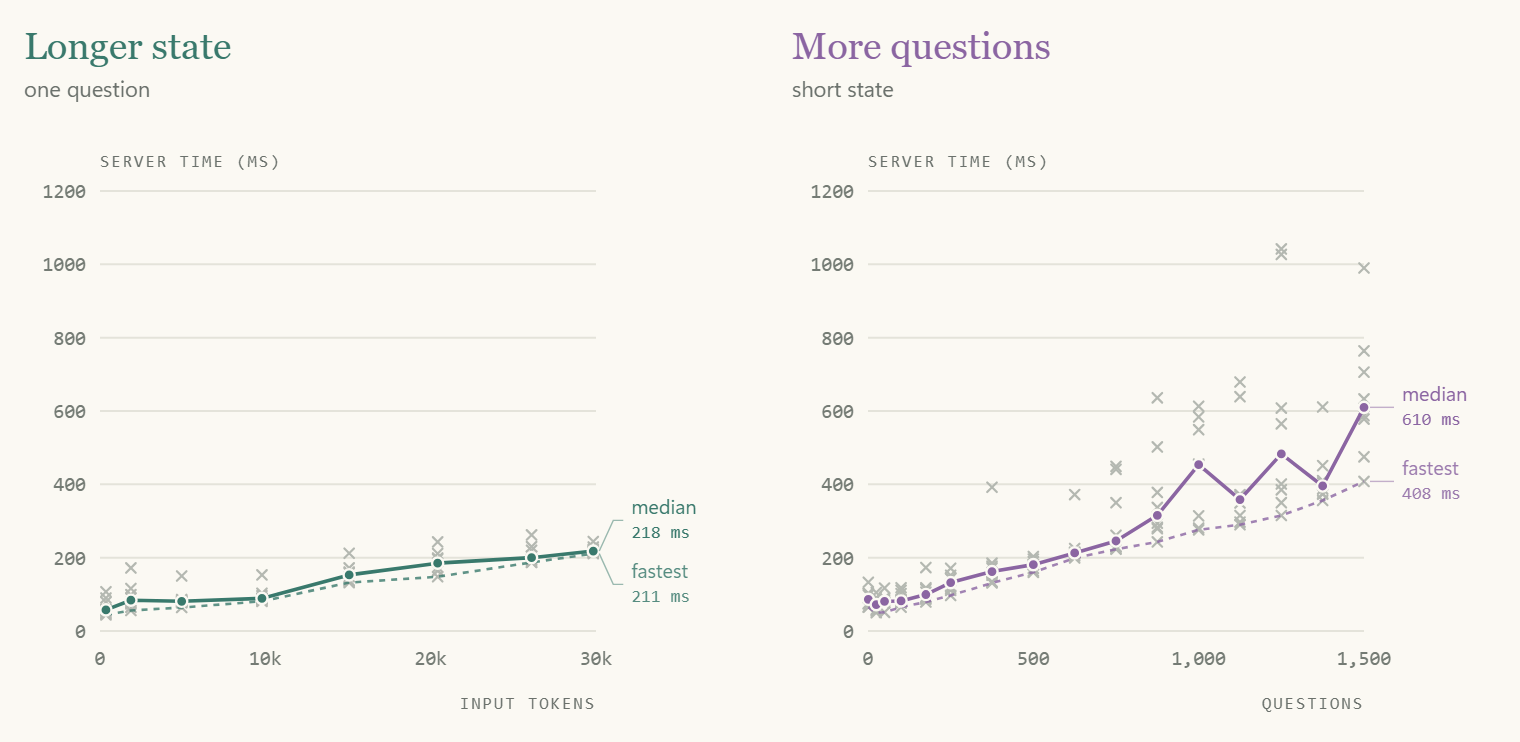
這些是服務端上報的上游耗時,不是本地筆記本上的計時。它們包含上游服務內部的工作與等待,而且那臺服務當時還和其他使用者共享。
Jev 有兩條限制。每個分支(state 加一個問題)上限約 32,768 個 token,整個請求上限約 65,536 個。請求上限裡 state 只算一次:一個有 23k token 的 state 加 5,000 個問題也塞得下。如果每個問題都各自處理一份 state 的副本,這個請求會超過一億個 token。這一對數字正好裝進一條最多 2¹⁶ token 的打包序列:state 放一次,之後接上所有問題,每個分支再限制在 2¹⁵ 的上下文視窗內。22
帶獨立因果字尾的字首 KV 快取是最自然的實現。Hydragen 描述了共享字首序列的高效注意力;DeFT 發展了樹形推理的注意力。這些說明這種服務模式是可行的。它們是先例,不是 TypeSafe 用了其中任何一個庫的證據。78
這個設計也澄清了一處表面矛盾:被隔離的問題仍然可以在同一塊加速器上一起來算。「並行」描述的是它們的排程方式以及彼此之間沒有答案依賴,不必意味著每個問題一塊 GPU。
3. 因果骨幹
這些實驗區分不了因果解碼器和雙向編碼器:兩者都能讓最終決策讀到整個輸入。我仍然假定是因果解碼器,理由很充分。Jev 的知識廣度(MMLU-Pro 84.6%)要求前沿規模預訓練,而那個規模上的模型全是因果解碼器;TypeSafe 又明確說 RLCD 是對預訓練語言模型的後期訓練。一個雙向的 Jev 要麼意味著底子弱得多,要麼意味著多花代價把一個解碼器轉過去,同時放棄因果服務方式提供的共享字首快取。那會很意外,但從外面無法排除。1215
用的是哪個預訓練模型,無從得知,分詞器也沒透露。在 415 次探測裡,Jev 的 token 計數和我們測過的 192 個公開分詞器沒有一個對得上。它把每個數字單獨切開,又會在合併之前先查整塊:8 個 a 算一個 token,16 個就變成四個。它的詞表與 OpenAI 的 o200k 很接近 —— 每個 Jev 算作單 token 的字串在 o200k 裡也是單 token —— 但數字切分和若干合併規則排除了 o200k 本身。公開分詞器裡最接近的是 Qwen,在 415 次探測中吻合 348 次。這排除的是「未經改動的公開分詞器」,而不是公開底座模型:換過詞表、繼續預訓練或蒸餾都能解釋它,一個計數方式和模型不同的 API 也能。18
這些實驗確實展示了決策能讀到什麼。我把一張「參考卡」放進問題的選項裡,讓 Jev 挑出條件被卡片滿足的那個選項。下面是一組確切的選項:
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.指令是:「讀參考卡,選出條件被滿足的那一個選項。」把參考值改成 indigo,正確答案隨之切換,而可選項本身完全沒變。
我測了兩個取值、全部六種選項排列,以及另一個用 route = east/west 的模板,各重複兩次。另設一組配對對照,把參考卡放進共享 state。合計得到 48 次「選項內參考」試驗和 48 次「state 內參考」對照。20
| 參考選項的位置 | 答對次數 |
|---|---|
| 最前 | 12 / 16 |
| 中間 | 11 / 16 |
| 最後 | 16 / 16 |
| 參考卡移入 state | 48 / 48 |
Jev 能用上放在候選描述之後的資訊。 參考卡在最後時,它在每一次試驗裡都選對了,正確答案的平均機率約 0.88。
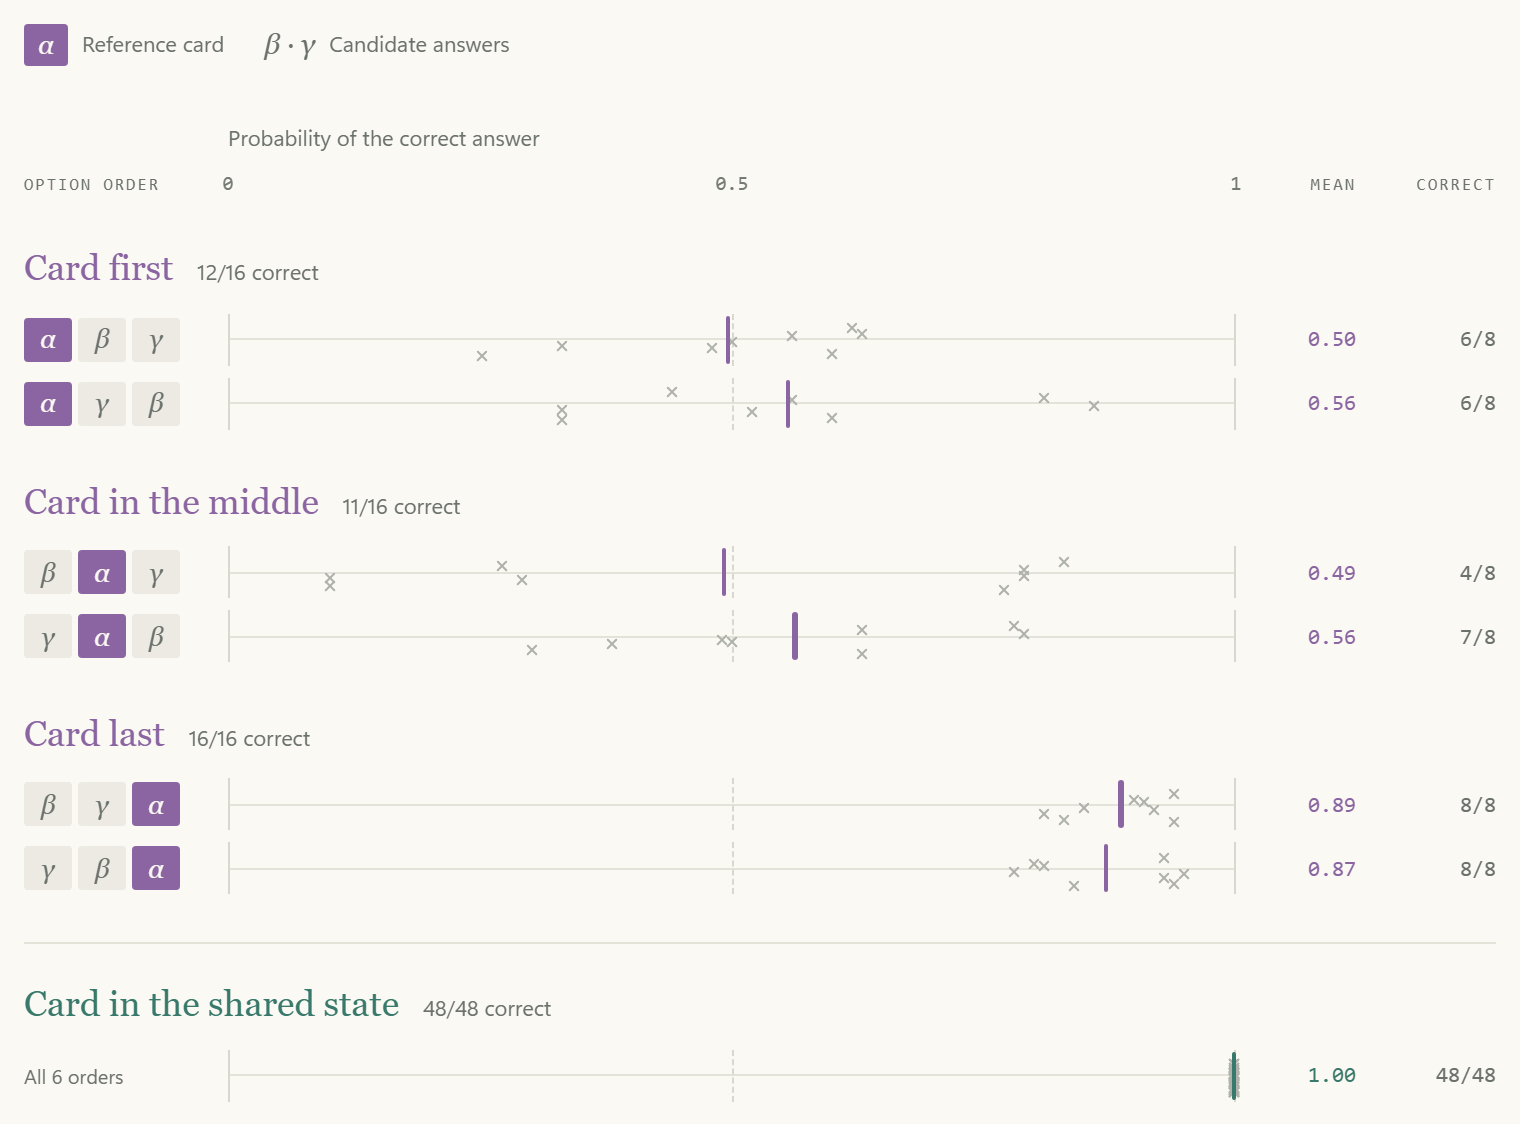
取值切換這一組對照和位置一樣重要。卡片在最後時,只把 amber 改成 indigo,就改變了前面某個選項的勝出結果 —— 而那些靠前的描述和 state 完全沒動。一個獨立地從自身文本和 state 給每個選項打分、然後僅僅做歸一化的模型,沒有任何途徑讓這件事改變前面選項的相對排序。結果支援「存在一條讓選項影響聯合決策的通路」。20
這符合任何在整個列表之後計算的讀出方式,包括第 4 節對比的兩種設計,也包括一個獨立的選項混合階段。剩下的錯誤說明這兩個模板上存在位置敏感的處理;它們指不出唯一的原因。
這個計算不需要 diffusion,這些實驗裡也沒有任何東西需要迭代去噪。站得住腳的架構推斷要窄得多:答案的計算能訪問完整的選項列表。下一個實驗檢驗它是否真的用上了那份聯合上下文。
4. 選擇之前,先讓選項互相影響
在一個問題內部,證據指向另一條資訊邊界:各個備選是作為一個有序列表被一起讀入的,後面才是那個決策位置。
為什麼要允許這種互動?像「以上都不是」這種選項本來就依賴其他選項。即便是普通的備選也會影響問題的含義。「付款」「賬號訪問」「其他」定義的決策,和「銀行」「支付服務商」「客戶」定義的並不是同一個。列表式的表示讓模型在產出分佈之前能解釋這個差別。
最強證據來自一個加入無關選項的實驗。
先有四種付款失敗的可能原因:bank、provider、customer、unknown。然後追加 weather: Bad weather caused it。如果每個原有選項拿到的 logit 獨立且不變,服務端用的 softmax 溫度也沒變,那麼加入第五個選項只會改變歸一化,無法改變兩個原有選項之間的賠率:
公共分母消掉了。這就給出一個具體、可被證偽的預測。
原始研究報告了一次從大約 +0.49 到 +0.08 的位移。10 為了確認這不是普通請求波動,我在十個隨機區組裡重做了這個實驗。每個區組包含:四選項基線、一個相同的四選項對照、追加了 weather 的五選項、一個相同的五選項對照,以及一個五選項版本 —— 其中追加的描述從「Bad weather caused it」改成「Wild birds caused it」。每次請求只含一個問題。21
擴張效應復現了。把每個區組內同一條件的兩次相同請求合併後,平均對數賠率從 +0.38 降到 +0.11。十個區組全部下降;平均變化為 −0.28,描述性的 95% 配對 t 區間約為 −0.36 到 −0.19。合併的做法是用對照請求壓低普通的請求噪聲,而不是把重複輸出當作獨立實驗。21
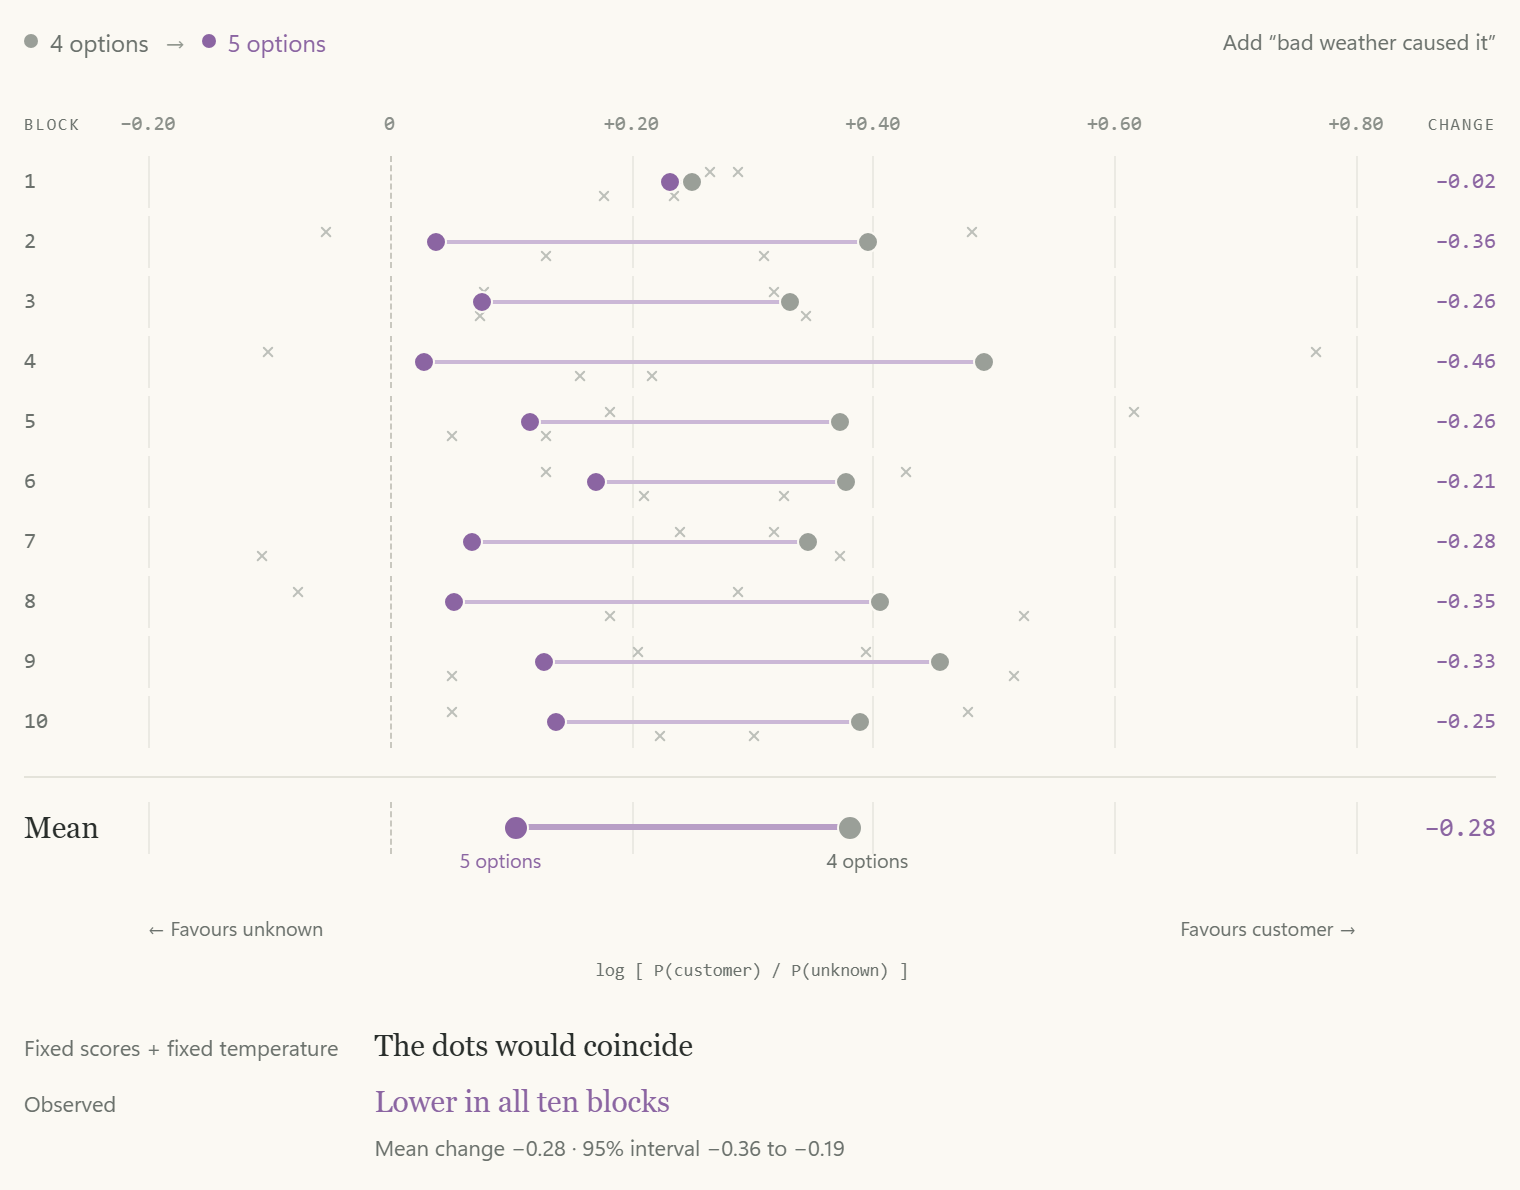
這是反對「固定獨立 logits + 不變 softmax」的證據。它沒有唯一地確定機制。保持五個選項、只改追加描述,得到的變化更小且不確定:它的配對區間包含零。隨集合而變的溫度仍然可能,與內容相關的混合也一樣。
一個能看到完整列表的讀出方式天然解釋了這件事:加入一個選項改變了它讀到的上下文。FIRST 那個列表式排序方法就是同樣的道理,它從首 token 的 logits 裡取出排序,而不是逐 token 生成排序。11
有兩種讀出方式都能解釋這些證據。一種是末位頭:用決策 token 的表示給每個選項槽位打分。另一種是指標式打分器:把這個表示與每個選項自己的最終隱狀態作比較。兩者都允許選項互相影響。API 最多接受 255 個選項(2⁸ − 1),這正好配一個固定 256 槽的頭 —— 但這個上限是請求校驗擋出來的,不是模型本身的。在 200 個選項下,一個被複制過去的答案在每個位置都得到 1.00,而且錯誤沒有溢到相鄰選項上,這更像指標。兩個結果都還不是決定性的。26
注入的假選項從來沒頂掉過真選項,所以選項邊界是用某種文本偽造不出來的方式標出的;一個條件在列表別處被重複的選項,其機率會被對手分走。23
這個取捨在普通任務上也看得見:把選項順序倒過來,一個技術支援分類的機率從大約 0.84–0.89 挪到了 0.93–0.96。資料來自 option_order 探測。9 對一個已上線的決策策略來說,這不是小事:閾值卡在 0.9 附近時,標籤和證據完全沒變,動作卻可能改變。 任何這套設計的實現,評測裡都該有排列測試。
5. 先訓練分佈,再計算置信度
第五個元件是訓練目標。直接輸出數值省掉了生成的工作,但便宜的機率仍然可能是壞的機率。
設想一批案例,每個都被賦予了「緊急」的 0.8 機率。校準要問的是:這些案例裡真的有大約 80% 緊急嗎。它是跨案例的性質。我們無法從「這一個個案後來結果不錯」來判斷「這一個預測是否校準」。
TypeSafe 把自己的訓練方法叫作 Reinforcement Learning for Calibrated Decisions,簡稱 RLCD。公告說它最佳化的目標是「在 System One 任務上給出認識論上誠實的機率」;公司的入門材料把 RLCD 呈現為一條從預訓練語言模型出發的後期訓練路徑。112 確切的配方沒有公開。我設想的訓練配方是:用一個基於結果的目標函式,讓 transformer 和讀出層去適配帶型別的決策任務。這給了骨幹一個機會,去構造對可靠決策有用的表示,而不只是流利的續寫。
一個自然的目標函式是 log loss,即觀測結果 的 。另一個是 Brier loss,即預測分佈與觀測到的一熱結果之間的平方距離。兩者都是恰當評分規則:在期望意義下,如實報告真實的條件分佈能使損失最小。Gneiting 和 Raftery 給出了形式定義與理論。13 這解釋了這類訓練想要達到什麼。它不能確定 TypeSafe 用的是哪個損失、它的流程在狹義的演算法意義上算不算強化學習、或者骨幹的每一個權重是否都被更新過。
「恰當」也不是上線保證。有限的資料、模型的侷限、最佳化誤差、分佈漂移,都會讓校準不完美。Guo 等人既展示了現代神經網路的校準問題,也展示了事後校正的用處。訓練與事後校準是可以共存的兩種機制;API 分不出各自貢獻了多少。14
觀測證據。 基準記錄讓我們可以把預測機率和實測正確率作比較,既看總量也看機率分箱內部。圖 5 就是這些檢查。僅總量吻合比箱內吻合弱得多:一組過度自信可以被另一組自信不足抵消掉。在 1,200 題的 MMLU 樣本上,十分箱的期望校準誤差是 0.0313(分箱定義與逐題預測)。大多數預測都擠在接近確定的位置:990 條落在 0.9–1.0 這一箱。15
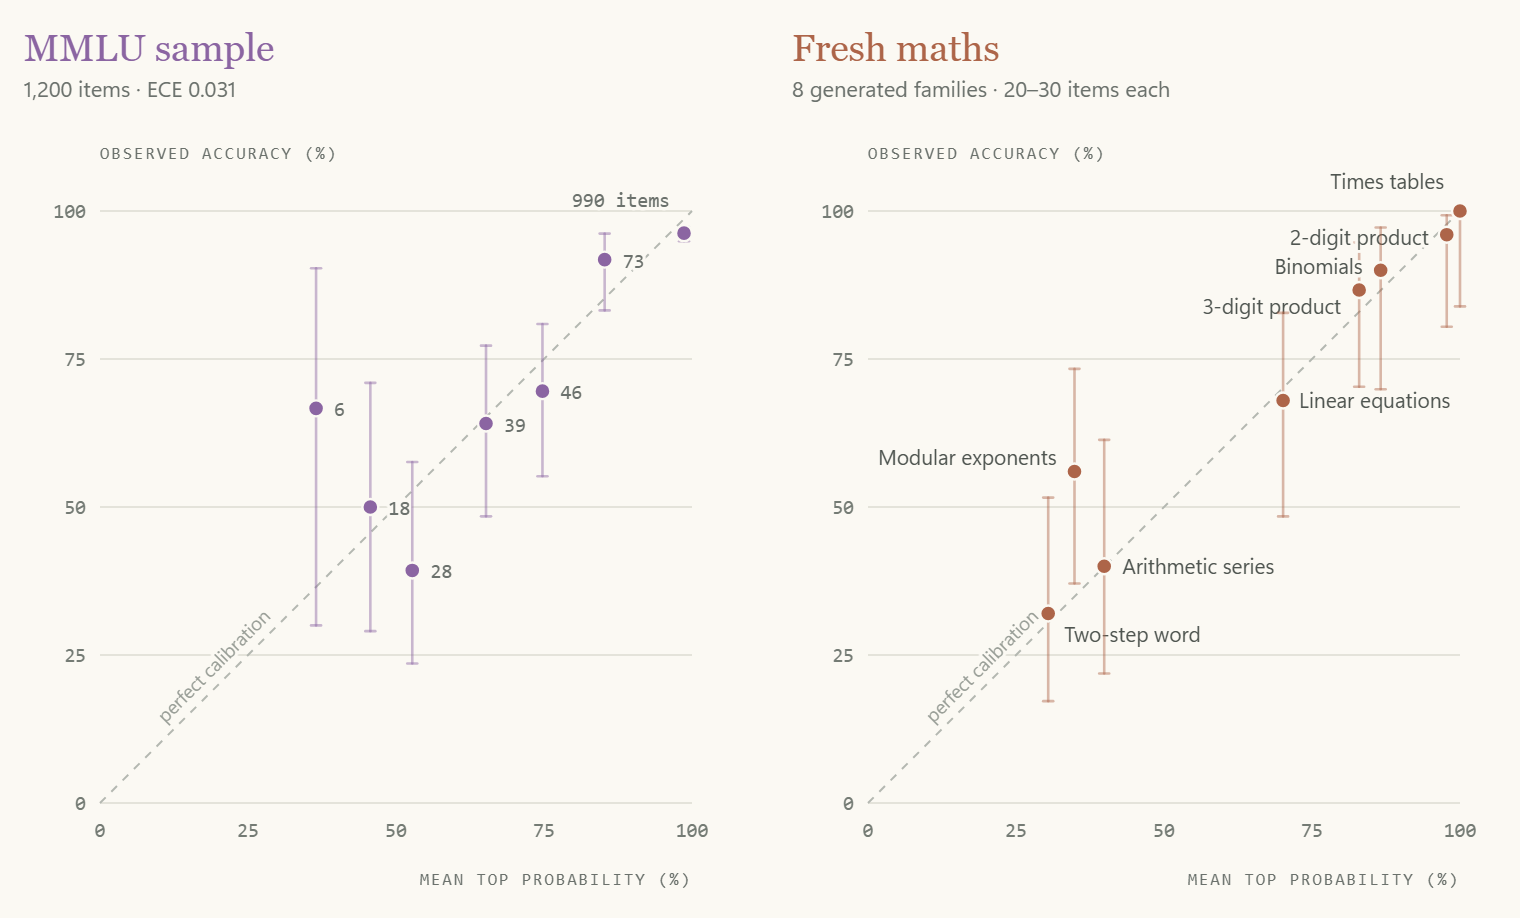
這個新做的數學小題研究提供了有用的變化。在生成的三位數乘法上,正確率 86.7%,平均最高機率 0.83;在兩步驟應用題上,正確率掉到 32%,平均最高機率掉到 0.30。模型在更難的任務上更沒把握(fresh_math_results,30 道乘法題加 25 道應用題)。15 這很讓人鼓舞,不過小的類別級均值無法確立「對每一種沒見過的問題都校準」。
這些結果也說明了為什麼公開基準分數是「模型知道多少」的一個不完美的度量。MMLU-Pro 正確率是 84.6%;新生成的應用題要難得多。15 任務結構、干擾項、難度、訓練曝光的差別都可能起作用。這個落差不能證明基準汙染。 換了措辭,也不等於底下的數學能力或事實知識就沒見過。
關於 API 裡那個名叫 confidence 的欄位,還有一條獨立且異常清楚的發現。官方介面卡對 的 Choice 置信度,是從歸一化分佈這麼算的:
三個選項、最大機率 0.8 時,這個式子給出 0.7。介面卡對只有一個選項的情況另作處理,返回 1。它度量的是領先答案比均勻分佈高出多少。它不是另一個「這個答案是對的」的學習估計。Score 型別用的是另一個公式,反映的是離眾數檔位的距離。16
在這個設想裡,訓練產出的是預測分佈,而這個彙總欄位是普通算術算出來的。把這兩個東西分開,能避免一個常見的概念錯誤:一個很集中的分佈仍然可以自信地錯。
6. 稀疏容量
我預計 Jev 用的是稀疏專家混合(MoE)transformer。在選定的層裡,一個路由器把每個 token 送進一小部分前饋網路,於是模型可以存下很多參數,而每個 token 只啟用其中一部分:這就是 Shazeer 等人的稀疏門控 MoE 層所展示的條件計算思想。17
從外面觀測不到稀疏專家,但它很可能是被選中的。一個只做 prefill 的模型受算力限制,而稀疏路由省下的正是算力。MoE 通常的服務開銷在這裡大多消失了:沒有逐 token 解碼(那種場景下視訊記憶體頻寬是瓶頸,而且大多數專家最終都被啟用),也沒有長期存活的 KV cache 去和專家權重搶視訊記憶體。測量也指向同一邊。Jev 處理約 30k token 用了大約 160 ms;一個稠密 70B 模型在 8×H100 節點上大約需要一秒,而一個啟用參數約 10B 的 MoE 正好放得下。而且近期最強的底座模型大多是 MoE(DeepSeek-V3、Qwen3、GLM-4.5、Kimi K2、gpt-oss)。專用硬體有可能讓稠密模型達到同樣的速度,基準分數也可能高估了模型實際掌握的知識量,所以這仍然是一個推斷,不是測量。615
這套重構裡沒有別的東西依賴它。換成稠密 transformer,介面、共享 state、隔離分支和讀出方式都還是原樣。
7. 把分支當批處理,而不是當對話
最後一個元件是服務引擎:它把問題分支當作獨立的工作項。它們的字尾可以和共享 state 的表示一起打包成批。應用程式碼再把數值輸出與問題識別符號對應起來,序列化響應。
測量顯示,重複的相同答案之間存在細小差異,包括同一次請求內的重複問題之間。這意味著不應假定 API 層是確定性的(noise、dup 和 determinism)。19 這並不意味著模型在生成或採樣文本:數值核心、動態批處理、路由,或者刻意的隨機性,都能影響一次直接讀出。
響應鍵的順序也在少數幾種模式裡變化過。19 多個雜湊順序不同的 worker 是個合理的解釋。不過這條側通道既不能確定 worker 數量,也不能確定 KV cache 存在哪裡,或者用了哪種數值精度。這些是實現細節,現有觀測解決不了。
對這個設想的架構來說,重要的是答案之間沒有依賴鏈。模型不需要先寫完佇列分類再開始估緊急度。兩者都依賴 state,誰也不用消費對方生成的答案。
依賴的上限仍然存在。如果後面某個問題真的需要前面的答案,應用就必須引入另一個決策階段,或者把聯合決策表達成一個問題。共享上下文並不會消除工作流的邏輯結構。
什麼能推翻我
這套重構裡的各個承諾,性質並不一樣。直接輸出機率是公開描述過的。問題隔離和選項順序效應是可觀測的行為。KV 共享、因果注意力、末位或指標式讀出、稀疏專家,則是越來越具體的解釋。
參考卡實驗解決了一個問題:決策能用上放在最後的選項。假選項測試說明,輸入格式上的花招偽造不出選項邊界。更廣的關係型任務可以把表示約束得更緊,不過僅憑行為上的成功,仍然無法唯一確定注意力掩碼。
在選項處理上,隨機化的跟進實驗復現了選項集合效應,但「固定描述長度」那個干預仍然不確定。更多模板和獨立請求區組,可以把「共享溫度變化」和「依賴內容的互動」區分開。一個難度中等的 200 選項任務,可以把槽位頭和指標式打分器分開。在校準方面,留出的工作流資料和漂移下的重複評測,比再多一個總量基準分數更有價值。要確認稀疏專家,大概需要公開披露,或者這個 API 之外的證據。
我對 Jev 最好的重構仍然是開頭那張圖:一個因果 transformer,共享 state 作字首,問題字尾彼此隔離,選項按列表處理,帶型別的數值讀出,訓練指向預測分佈。稀疏專家是最可能的骨幹,但設計裡其餘部分都不依賴它。
它的用處來自計算圖與任務相匹配。決策服務需要讀取證據、比較允許的結果、並暴露不確定性。transformer 能做到這些,而不必先把每個決策變成一句話。
方法
本文基於 2026 年 9 月 17 日對 jev-1.13.0 的一次調查,使用一個早期訪問賬號、觀測到一個服務區域。原始研究包含 1,029 條帶探針的記錄(其中含 190 道生成數學題)、6,800 條基準記錄,以及若干獨立的事實核查。跟進研究又增加了 146 次關係型與選項互動請求(trials、summary)、311 次 token 計費請求、445 次分詞器指紋請求、192 次延遲請求、148 次選項數延遲請求、181 次選項位置請求、105 次假選項請求和 35 次上下文上限請求。每一組都在參考文獻裡有連結,附確切的請求與脫敏後的響應。重複的基準配置共享底層題目;這些計數不是獨立問題的數量。
可下載的證據包記錄了本文用到的觀測。開頭一節的 API 示例是示意性的。引用的 visibility 與參考卡提示詞來自探針指令碼和儲存下來的跟進請求。數值觀測只對這個模型版本和這一次測試成立。
延遲數字來自 x-envoy-upstream-service-time 響應頭。它們是上游服務的耗時,排除了具體的排隊與執行邊界,是上游服務的耗時而不是孤立的模型計時。延遲圖裡的掃描是一次一個請求、亂序執行的;沒有任何一項研究控制了伺服器負載。本地牆鍾測量沒有被當作架構證據。
機率通常以兩位小數返回。同一次請求裡的重複問題共享條件,誤差可能相關。MMLU 校準圖用的是十個等寬箱:[0, 0.1)、[0.1, 0.2),依此類推,1.0 歸入最後一箱。期望校準誤差是每個箱內「正確率與平均最高機率之差的絕對值」按樣本量加權。估計值取決於樣本選擇、分箱方式和響應舍入。證據支援的是關於被測分佈的論斷,而不是對將來任意客戶工作流的校準保證。
來源與相關工作
實驗類參考文獻標出了原始的指令碼 tag,好讓每條觀測都能在證據包裡定位。論文引用確立的是所提機制及其先例;它們不證明 Jev 用了它們。
來源
- TypeSafe(2026)。Introducing System One Models and Jev。關於「並行輸出」的說法與所宣告的 RLCD 目標的第一手來源。
- TypeSafe。完整 API 文件,訪問於 2026 年 9 月 17 日。帶型別的問題、響應分佈與 API 契約。
- Vaswani 等(2017)。Attention Is All You Need。解碼器掩碼、注意力,以及線性/softmax 輸出層。
- API 實驗:type_preamble 與 outputs。token 計費的可加性、識別符號變化,以及 255 選項的響應。
- API 實驗:visibility。密碼分別放在兄弟問題裡、從兄弟問題中移除、以及放在 state 中,各重複五次。
- 延遲掃描(192 次順序請求)。state 長度與問題數,各 8 次亂序重複;服務端上報的上游耗時。
- Juravsky 等(2024)。Hydragen: High-Throughput LLM Inference with Shared Prefixes。
- Yao 等(2024)。DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference。
- API 實驗:option_order。普通工單的場景下的選項順序敏感性。
- API 實驗:iia。每種條件三次請求,每次含四十個重複問題;原始、追加和前置的選項集合。
- Reddy 等(2024)。FIRST: Faster Improved Listwise Reranking with Single Token Decoding。
- TypeSafe。機器學習入門材料。關於 RLCD 後期訓練路徑與校準契約的第一手描述。
- Gneiting 與 Raftery(2007)。Strictly Proper Scoring Rules, Prediction, and Estimation。Journal of the American Statistical Association 102(477):359–378。
- Guo 等(2017)。On Calibration of Modern Neural Networks。
- 基準與生成數學題記錄:正確率與平均預測機率。 ;MMLU 可靠性分析:分箱定義、ECE、Wilson 區間與 1,200 條逐題預測。
- TypeSafe。官方 Python 介面卡 confidence_metrics.py,revision fb52b103。Choice 與 Score 的置信度公式(閱讀於 2026 年 9 月 17 日)。
- Shazeer 等(2017)。Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer。
- 分詞器指紋實驗(445 次請求)。遊程、詞表與預分詞探針,與 192 個公開分詞器對比。
- API 實驗:noise、dup 與 determinism。重複的機率值與響應鍵順序。
- 跟進關係實驗(96 次請求)。兩個模板、兩個參考值、六種排列、兩個位置、兩次重複;附確切請求與脫敏響應。
- 跟進選項互動實驗(50 次請求)。十個隨機區組,含 base4、null4、append5、replace5 和 null5;配對變化與標準誤。
- 上下文上限實驗(35 次順序請求)。單分支與整請求的 token 上限,附被接受和被拒絕的邊界用例。
- 假選項注入實驗(105 次請求)。七種分隔符格式、飽和與有歧義的基線任務,以及完整機率向量。
- token 計費實驗(311 次請求)。問題 ID 長度、批大小、state 難度、詞 ID,以及 state 與 ID 字串的配對。
- 選項數延遲實驗(148 次請求)。1 個或 20 個問題,各配 2–200 個選項,長短標籤,外加輸入/輸出解耦對照。
- 選項位置實驗(181 次請求)。選項數上限,正確答案在 10、50、200 和 255 選項列表中移動。
出處: Jev’s Architecture Unmasked —— Archer,archerhume.com,2026 年 9 月 17 日。