Jevs Architektur entschlüsselt
Ich habe Jev mit 10.000 API-Aufrufen sondiert, um grob herauszufinden, wie es gebaut ist, und warum die meisten Scharlatan-Meinungen auf X völlig falsch liegen. X ist voll von heißen Takes zum Launch von Jev, und die meisten verfehlen den Punkt völlig: „12 Millionen Aufrufe für einen JSON-Klassifikator? Ja, wir sind in einer Blase.“ Ein gewöhnliches LLM generiert „90% sicher” als Text; seine Wahrscheinlichkeit, diese Wörter zu erzeugen, begründet keine 90%ige Wahrscheinlichkeit, richtig zu liegen. Und doch bauen wir Betrugsprüfung, Moderation, Routing und Risikobewertung genau um dieses Muster herum: Wir zahlen für Token-für-Token-Generierung und behandeln dann eine unvalidierte Konfidenzbehauptung als eine Wahrscheinlichkeit, auf die unsere Software reagieren kann.
Jevs Vorschlag ist, das Wissen eines vortrainierten LLM zu bewahren und zugleich generierte Konfidenzbehauptungen durch Entscheidungswahrscheinlichkeiten zu ersetzen, die direkt aus seinen internen Repräsentationen gelesen werden. Diese Wahrscheinlichkeiten werden gegen Ergebnisse trainiert. Gib ihm gemeinsamen Zustand, Fragen und erlaubte Antworten; es liefert die Verteilungen parallel zurück, ohne Text zu generieren.1 Für diese ganze Klasse von Anwendungen adressiert das beide Probleme: die Zuverlässigkeit des Entscheidungssignals und die unnötige Rechenzeit, die für seine Erzeugung aufgewendet wird.
Es gibt nur ein Problem: Es ist nicht Open-Weights, und TypeSafe weigert sich, seine Forschung zu teilen … Also werde ich es (nach bestem Bemühen) tun.
Die Evidenz deutet auf einen kausalen Transformer (wahrscheinlich mit sparsamem MoE) hin, der für Entscheidungen umfunktioniert wurde: gemeinsame Zustandskodierung, isolierte Fragenzweige und direkte Wahrscheinlichkeitsauslesungen statt Textgenerierung. Nachdem ich die TypeSafe-API sondiert (auf der Suche nach Signaturen im Latenz-Skalierungsverhalten bei verschiedenen Kontextlängen, Fragen-Umordnung usw.), jede öffentliche Dokumentation und Forschung mit Astra durchforstet und nach Prior Art gesucht habe, glaube ich, ein ziemlich genaues Modell davon zu haben, wie es funktioniert und wie seine Architektur aussieht.
Das sparsame Backbone ist der unsicherste Teil, aber es ist für diesen Bereich besonders vorteilhaft, mit weniger Nachteilen als AR-LLMs, also wäre es seltsam, wenn es nicht so wäre. Gemeinsame Berechnung und direkte Wahrscheinlichkeitsausgaben sind offensichtlich viel besser belegt. Das alles ist eindeutig ziemlich spekulativ, also versuche ich, so klar wie möglich zu sein darüber, was TypeSafe veröffentlicht hat, was in Experimenten beobachtet wurde und was daraus abgeleitet wird. Black-Box-APIs machen es erschreckend einfach, ein Tuch über den Geist zu werfen und eine grobe Form dessen zu bekommen, wie die Architektur aussieht.
Warum dieses Design nützlich ist
Betrachte eine schematische Support-Routing-Anfrage. Sie illustriert die Struktur der API; die Beispielwahrscheinlichkeiten unten sind erfunden.
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}
Eine nützliche Antwort könnte payments 0.91 Wahrscheinlichkeit zuweisen, während sie der dringenden Eskalation nur 0.42 zuweist. Das sind unterschiedliche Unsicherheiten. Software kann das Ticket automatisch routen und die Eskalation einer separaten Politik überlassen.
Ein kausaler Transformer weiß bereits, wie man von links nach rechts eine Repräsentation von Text konstruiert. Während der gewöhnlichen Sprachmodell-Inferenz verarbeitet er den Prompt, sagt ein Token voraus, speist dieses Token wieder ein und wiederholt. Das baut auf der Decoder-Aufmerksamkeit und der Ausgabeprojektion auf, die im ursprünglichen Transformer eingeführt wurden.3 Aber die Prompt-Verarbeitungsphase hat bereits eine reiche Repräsentation erzeugt. Wenn die Aufgabe darin besteht, unter drei Warteschlangen zu wählen, können wir eine kleine Funktion anhängen, die diese Repräsentation direkt auf drei Zahlen abbildet.
Ein Detail hier löst einen Großteil der Verwirrung über parallele Antworten auf: kausale Aufmerksamkeit beschreibt, welche Positionen welche Information nutzen können, nicht die Reihenfolge, in der Eingabetokens ausgeführt werden müssen. Während der Prompt-Verarbeitung, oder Prefill, ist jedes Eingabetoken bereits bekannt. Das Modell kann ihre Positionen innerhalb einer Schicht zusammen verarbeiten, während die Aufmerksamkeitsmaske den Zugriff auf spätere Positionen blockiert; die Schichten laufen weiterhin sequenziell. Autoregressive Dekodierung fügt eine weitere Abhängigkeit hinzu: Das nächste Token existiert nicht, bis die vorherige Vorhersage gewählt wurde. Unser vorgeschlagenes Modell endet nach dem Prefill und dem Readout, sodass es diese Token-für-Token-Abhängigkeit vermeidet.
Das ändert die rechnerische Form der Aufgabe. Die Ausgabe braucht keine Sequenz von Buchstabierentscheidungen mehr für "payments": 0.91. Die JSON-Formatierung geschieht in gewöhnlichem Anwendungscode. Das neuronale Netz liefert die Wahrscheinlichkeiten.
Nimm nun an, der Zustand ist ein langer Incident-Bericht und es gibt fünfzig Fragen. Der größte Teil der Eingabe ist gemeinsam. Ein Transformer speichert Zwischeninformationen über verarbeitete Tokens in seinem Key-Value-Cache, üblicherweise abgekürzt als KV-Cache. Im vorgeschlagenen Design liest jede Frage denselben Zustandscache. Jeder Zweig fügt nur seine eigenen Anweisungen und Antwortoptionen hinzu.
Für einen Zustand von Tokens und Fragen würden getrennte Anfragen den Zustand grob -mal verarbeiten. Das Teilen reduziert die wiederholte Verarbeitung der Zustandstokens von auf . Die Fragen müssen weiterhin auf den Zustand achten; diese Arbeit verschwindet nicht. Aber das Modell muss die Repräsentationen des Zustands nicht wiederholt rekonstruieren.
Die Isolation gibt der Schnittstelle außerdem eine nützliche Bedeutung. Zu fragen, ob der Kunde wütend ist, sollte nicht ändern, welche Warteschlange das Ticket erhält. Beide Fragen können dieselbe Evidenz prüfen, ohne die Anweisungen der jeweils anderen zu lesen. Die Zweige haben keine rechnerische Abhängigkeit voneinander, auch wenn ihre Antworten statistisch zusammenhängen.
Schließlich machen Wahrscheinlichkeiten die nachgelagerte Politik explizit. Wenn eine unnötige Eskalation eine Einheit kostet und ein verpasster dringender Fall neun, eskaliert eine vereinfachte Entscheidungsregel, wenn . Diese Berechnung ist nur in dem Maße sinnvoll, in dem die Wahrscheinlichkeiten für diesen Workflow zuverlässig sind. Das Trainieren und Evaluieren der Wahrscheinlichkeitsverteilung wird damit Teil des Produkts statt eines kosmetischen Konfidenzfelds.
Nichts davon erfordert Diffusion. Parallele Klassifikation existiert seit Jahrzehnten. Die interessante Kombination ist ein breit leistungsfähiger Transformer, gemeinsame kontextuelle Berechnung, eine typisierte Ausgabeschnittstelle und ein Training, das nützliche Unsicherheit belohnt.
1. Beende die Inferenz mit einem Readout
Die erste Komponente ist die einfachste: ein Vorhersagekopf statt einer Decode-Schleife.
Veröffentlichte Evidenz. TypeSafes Launch-Ankündigung sagt: „Jev gibt alle Wahrscheinlichkeiten parallel aus, statt autoregressiv Token für Token zu generieren.” Ihre Dokumentation legt endliche Auswahlmöglichkeiten, Ja/Nein-Entscheidungen und geordnete Scores offen. Diese werden auf natürliche Weise durch feste numerische Ausgaben repräsentiert.12
Beobachtete Evidenz. Die API berichtet weiterhin ein Feld output_tokens, das wie eine Aufzeichnung der Generierung klingt. Ist es nicht. Für Ja/Nein-Fragen passt die Zahl exakt: 4 gemeinsame Tokens, plus 15 pro Antwort, plus die Tokenlänge des Bezeichners jeder Frage. TypeSafes Dokumentation sagt, dass dieser Bezeichner „nicht an das zugrunde liegende Modell gesendet und nicht in der Inferenz verwendet wird”. Eine Zahl, die sich mit Text ändert, den das Modell nie sieht, wird nach der Inferenz aus der serialisierten Antwort berechnet. Auch die zurückgegebenen Werte beeinflussen sie nicht: Eine Antwort von 0.0 kostet dasselbe wie 0.01, obwohl jede Ziffer sonst als Token zählt.224
Der Tokenizer hinter der Zahl stimmt mit keinem der 192 öffentlichen Tokenizer überein, die wir getestet haben. Er stimmt mit Jevs eigenem Input-Zähler für gewöhnlichen Text überein und unterscheidet sich nur bei langen Folgen von Leerzeichen und Interpunktion. output_tokens ist eine Abrechnungszahl. Sie sagt uns nichts darüber, ob Jev Text generiert, und würde diesen Text nicht messen, selbst wenn es so wäre. Die Latenz folgt dieser Zahl ebenfalls nicht: Eine Frage mit 200 Optionen (1.911 Output-Tokens) kam genauso schnell zurück wie eine mit zwei, und die Serverzeit wuchs nur mit der Eingabelänge.2425
Eine Antwort mit 255 Optionen meldete 2.714 Output-Tokens.4 Es wäre ein Fehler, diese Zahl durch die Anfragedauer zu teilen und das Ergebnis die Dekodierungsgeschwindigkeit des Modells zu nennen. Ein Server kann Tausende Zeichen nach einer einzigen Modellevaluierung serialisieren. Das Abrechnungsfeld sagt uns nicht, wie viele neuronale Dekodierungsschritte stattgefunden haben.
Der vorgeschlagene Readout nimmt einen finalen verborgenen Vektor und erzeugt Logits:
Hier ist die Anzahl der erlaubten Antworten. Die Matrix wandelt eine Repräsentation in Antwort-Scores um; Softmax verwandelt diese Scores in eine Verteilung. Für eine Ja/Nein-Entscheidung würden ein Skalar und eine Sigmoid genügen.
Die Klassen müssen keine festen Konzepte wie „payments” sein. Sie können Options-Slots sein: erste Option, zweite Option, dritte Option. Der Zweig liefert die Bedeutung jedes Slots; Anwendungscode bildet seine Wahrscheinlichkeit zurück auf den Optionsschlüssel des Aufrufers. Ein geordneter Score kann auf ähnliche Weise Wahrscheinlichkeiten über Stufen vorhersagen und ihren wahrscheinlichkeitsgewichteten Durchschnitt zurückgeben. Dies unterstützt neue Entscheidungen, ohne für die Labels jedes Kunden einen neuen Kopf zu trainieren. Ein Scorer im Pointer-Stil, verglichen in Abschnitt 4, ist die Hauptalternative: Er bewertet die eigene Repräsentation jeder Option statt eines nummerierten Slots.
Dies beweist nicht, dass Jev ein separat benanntes Klassifikatormodul hat. Der Vokabular-Kopf eines Sprachmodells ist ebenfalls eine Matrix gefolgt von Softmax. reservierte Label-Zeilen aus dieser Matrix auszuwählen kann dieselbe Berechnung implementieren wie ein dedizierter -Klassen-Kopf. Die Zeilen könnten an Eingabe-Embeddings gebunden oder unabhängig trainiert sein; wir können diese Anordnungen hier nicht unterscheiden.
Die wichtige Unterscheidung ist die zwischen Wahrscheinlichkeiten auslesen und Text generieren, der Wahrscheinlichkeiten beschreibt. Ein generiertes „91%” ist eine Tokenfolge. Die 0.91 eines Klassifikators ist ein Eintrag in seiner prädiktiven Verteilung. Beides kann falsch kalibriert sein. Keines wird allein wegen seines Formats vertrauenswürdig.
Eingeschränkte Textdekodierung bleibt ein möglicher Weg, eine ähnliche Schnittstelle zu bauen, aber TypeSafe beschreibt ausdrücklich einen anderen Ausgabepfad. Dessen Aussage ist stärkere Evidenz als ein Latenzargument. Die Evidenz deutet auf ein direktes numerisches Readout hin, eines der beiden in Abschnitt 4 verglichenen Designs. Reservierte Label-Tokens bleiben möglich, obwohl der Fake-Option-Test dort gegen sie spricht.
2. Teile den Zustand, isoliere die Fragen
Die nächste Entscheidung betrifft, wo Berechnung wiederverwendet wird.
Beobachtete Evidenz. Die Token-Abrechnung ist in den kleinen kontrollierten Beispielen exakt additiv. Eine minimale Ja/Nein-Frage verbrauchte 268 Input-Tokens; zwei verbrauchten 276. Eine Anfrage mit einer Ja/Nein-Frage, einem Choice mit zwei Optionen und einem Score mit zwei Stufen verbrauchte 318, was der Summe ihrer gemessenen Beiträge über dem gemeinsamen Overhead entspricht. Das passt zu einem gemeinsamen Präfix plus Fragen-Suffixen, obwohl die Abrechnung allein keinen Berechnungsgraphen identifiziert.4
Ein informativeres Experiment verschiebt Evidenz zwischen diesen Regionen. Der Zustand lautete anfangs:
The weather is nice today and the park is full of people.Eine Schwesterfrage enthielt:
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
Die Sonde fragte, welchen Code eine andere Frage erwähnte, mit ZEBRA-7741, zwei Distraktoren und none als Optionen. Mit dem Geheimnis in der Schwesterfrage war seine berichtete Wahrscheinlichkeit 0.00. Das Entfernen dieser Schwesterfrage ergab dasselbe Ergebnis. Die Deklaration stattdessen in den Zustand zu legen, hob sie auf 0.90–0.92. Das waren fünf Wiederholungen pro Bedingung (visibility in den Sondenaufzeichnungen).5
Dies ist eine nützliche Intervention: Die Deklaration über eine API-Grenze zu bewegen, ändert ihre Wirkung. Es stützt eine verhaltensmäßige Isolation zwischen Fragen und den Zugriff auf den gemeinsamen Zustand. Es legt nicht die exakte Aufmerksamkeitsmaske offen. Getrennte Modellaufrufe, eine Baummaske oder ein anderer Mechanismus, der den Informationsfluss einschränkt, könnten dasselbe Ergebnis erzeugen. Der Wortlaut der Sonde fragt auch in der Zustandsbedingung nach „einer anderen Frage”, ist also kein unverfälschter Test wörtlicher Anweisungsbefolgung.
Die Serving-Messungen liefern ein weiteres Puzzlestück. Bis zu etwa 100 Fragen änderte sich die Serverzeit kaum. Darüber hinaus stieg sie stetig, und Token für Token kostete Fragetext etwa doppelt so viel wie Zustand. Das ist konsistent damit, den Zustand einmal zu berechnen und die Fragenarbeit zu batchen.6
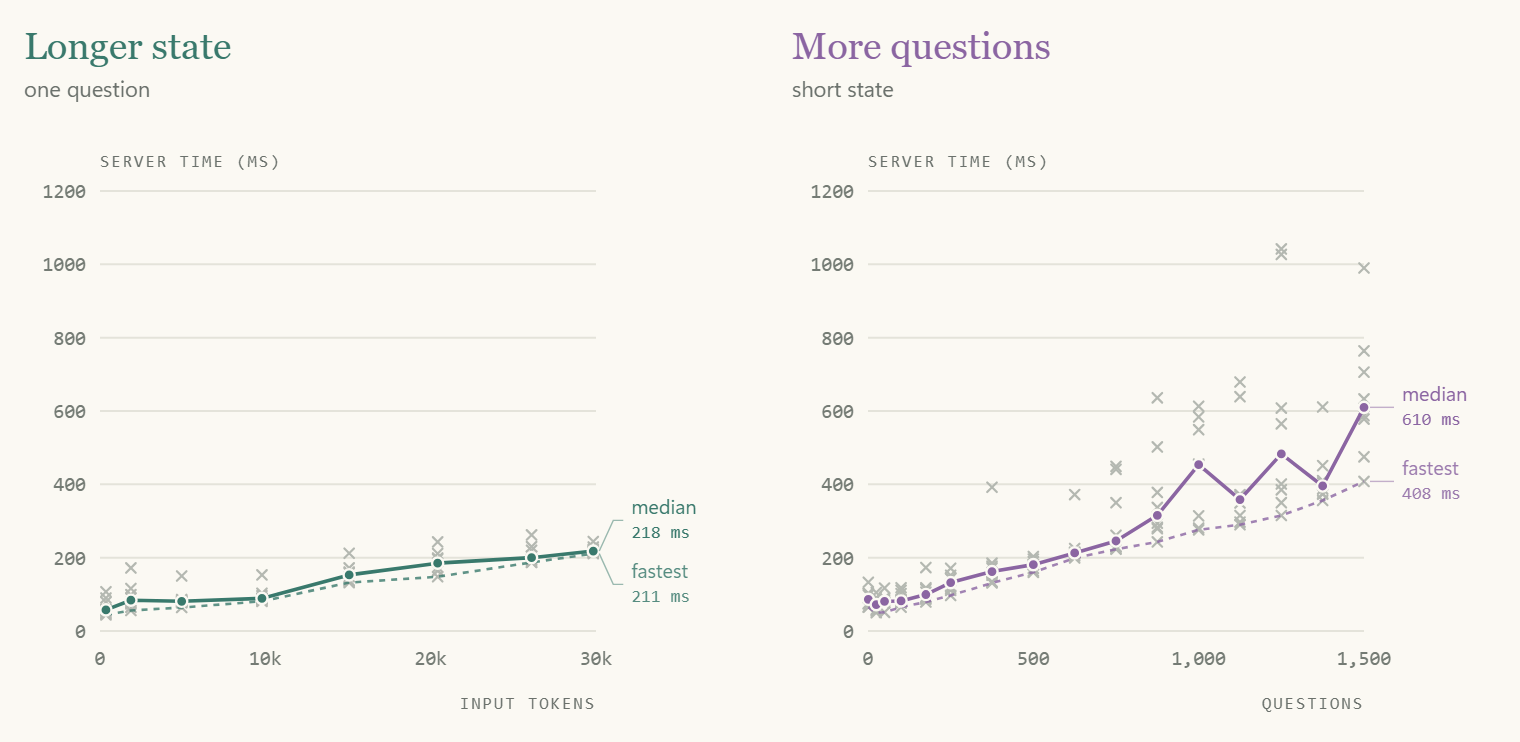
Das sind vom Server gemeldete Upstream-Dauern, keine lokalen Laptop-Messungen. Sie enthalten jede Arbeit und jedes Warten, die der Upstream-Dienst einschließt, und der Dienst wurde mit anderen Nutzern geteilt.
Jev erzwingt zwei Limits. Jeder Zweig (der Zustand plus eine Frage) ist auf etwa 32.768 Tokens begrenzt, und die gesamte Anfrage auf etwa 65.536. Das Anfragelimit zählt den Zustand einmal: Ein Zustand von 23k Tokens mit 5.000 Fragen passt hinein. Wenn jede Frage ihre eigene Kopie des Zustands verarbeiten würde, läge diese Anfrage über 100 Millionen Tokens. Das Paar passt in eine einzige gepackte Sequenz von bis zu 2¹⁶ Tokens, die den Zustand einmal und jede Frage danach enthält, wobei jeder Zweig auf ein Kontextfenster von 2¹⁵ begrenzt ist.22
Ein Präfix-KV-Cache mit separaten kausalen Suffixen ist die natürliche Implementierung. Hydragen beschreibt effiziente Aufmerksamkeit für Sequenzen, die ein Präfix teilen; DeFT entwickelt Aufmerksamkeit für baumstrukturierte Inferenz. Diese belegen, dass das Serving-Muster praktikabel ist. Sie sind Prior Art, kein Beweis, dass TypeSafe eine der beiden Bibliotheken verwendet.78
Dieses Design klärt auch einen scheinbaren Widerspruch: isolierte Fragen können trotzdem gemeinsam auf demselben Beschleuniger evaluiert werden. „Parallel” beschreibt ihre Planung und die Abwesenheit von Antwortabhängigkeiten. Es muss nicht eine GPU pro Frage bedeuten.
3. Ein kausales Backbone
Die Experimente können einen kausalen Decoder nicht von einem bidirektionalen Encoder unterscheiden: bei beiden kann die endgültige Entscheidung die gesamte Eingabe lesen. Ich nehme trotzdem einen kausalen Decoder an, aus gutem Grund. Jevs Wissensbreite (84.6% bei MMLU-Pro) erfordert ein Pretraining in Frontier-Größenordnung, jedes Modell in dieser Größenordnung ist ein kausaler Decoder, und TypeSafe beschreibt RLCD als Post-Training eines vortrainierten Sprachmodells. Ein bidirektionales Jev würde entweder eine weit schwächere Basis oder die Konvertierung eines Decoders zu zusätzlichen Kosten bedeuten, während das gemeinsame Präfix-Caching aufgegeben würde, das kausales Serving bietet. Das wäre überraschend, aber es kann von außen nicht ausgeschlossen werden.1215
Welches vortrainierte Modell es ist, ist unbekannt, und der Tokenizer verrät keines. Jevs Tokenzahlen stimmen mit keinem der 192 öffentlichen Tokenizer überein, die wir über 415 Sonden getestet haben. Es teilt jede Ziffer einzeln und schlägt ganze Chunks nach, bevor es zusammenführt: 8 as zählen als ein Token, aber 16 zählen als vier. Sein Vokabular folgt eng OpenAIs o200k, da jeder String, den Jev als einzelnes Token zählt, auch ein einzelnes o200k-Token ist, doch Zifferntrennung und mehrere Merges schließen o200k selbst aus. Die nächste öffentliche Übereinstimmung, Qwen, stimmt bei 348 von 415 Sonden überein. Das schließt einen unveränderten öffentlichen Tokenizer aus, nicht ein öffentliches Basismodell: ein ersetztes Vokabular, fortgesetztes Pretraining oder Destillation könnten es jeweils erklären, ebenso wie eine API, die Tokens anders als das Modell zählt.18
Die Experimente zeigen jedoch, was die Entscheidung lesen kann. Ich platzierte eine Referenzkarte unter den Optionen einer Frage und bat Jev, die Option zu wählen, deren Bedingung die Karte erfüllt. Hier ist ein exaktes Optionsset:
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.
Die Anweisung war: „Lies die Referenzkarte und wähle die eine Option, deren Bedingung erfüllt ist.” Den Referenzwert auf indigo zu ändern, wechselt die richtige Antwort, während die auswählbaren Optionen unverändert bleiben.
Ich testete beide Werte, alle sechs Optionspermutationen und eine zweite Vorlage mit route = east/west, mit zwei Wiederholungen. Eine gepaarte Kontrolle legte die Referenz stattdessen in den gemeinsamen Zustand. Das ergab 48 Options-Referenz-Versuche und 48 Zustands-Referenz-Kontrollen.20
| Position der Referenzoption | Richtige Antworten |
|---|---|
| Erste | 12 / 16 |
| Mitte | 11 / 16 |
| Letzte | 16 / 16 |
| Referenz in den Zustand verschoben | 48 / 48 |
Jev kann Informationen nutzen, die nach den Kandidatenbeschreibungen platziert sind. Mit der Referenz zuletzt wählte es in jedem Versuch die richtige Option, mit einer mittleren Wahrscheinlichkeit der richtigen Antwort von etwa 0.88.
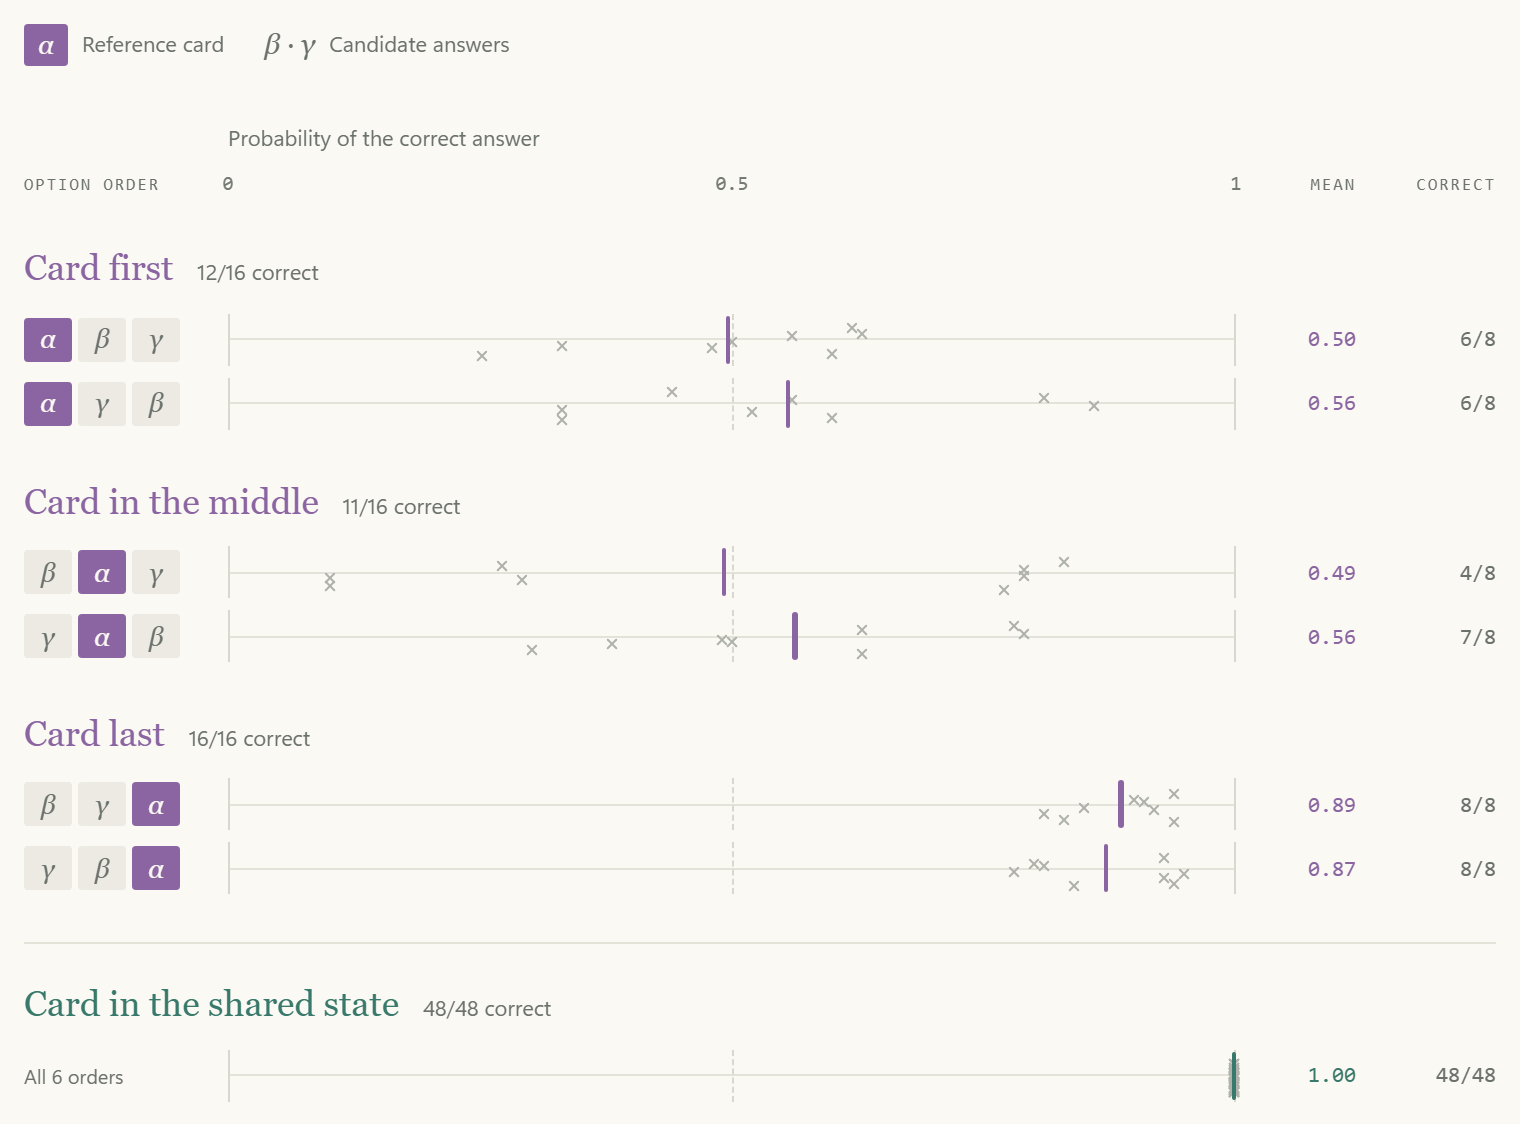
Die Wertwechsel-Kontrolle ist genauso wichtig wie die Position. Mit der Karte zuletzt ändert das alleinige Umstellen von amber auf indigo, welche frühere Option gewinnt, obwohl diese früheren Beschreibungen und der Zustand identisch bleiben. Ein Modell, das jede Option unabhängig aus ihrem eigenen Text und dem Zustand bewertet und die Scores dann bloß normalisiert, hat keinen Weg, durch den diese Tatsache das relative Ranking der früheren Optionen ändern könnte. Die Ergebnisse stützen einen Pfad, über den Optionen die gemeinsame Entscheidung beeinflussen.20
Das passt zu jedem Readout, der nach der ganzen Liste berechnet wird, einschließlich beider in Abschnitt 4 verglichenen Designs, sowie zu einer separaten Options-Mischstufe. Die verbleibenden Fehler zeigen positionsempfindliche Verarbeitung bei diesen beiden Vorlagen; sie identifizieren keine eindeutige Ursache.
Diffusion ist für diese Berechnung unnötig, und nichts in diesen Experimenten erfordert iteratives Denoising. Die verteidigungsfähige architektonische Schlussfolgerung ist enger: die Antwortberechnung hat Zugriff auf die vollständige Optionsliste. Das nächste Experiment prüft, ob sie diesen gemeinsamen Kontext tatsächlich nutzt.
4. Lass die Optionen interagieren, bevor gewählt wird
Innerhalb einer Frage deutet die Evidenz auf eine andere Informationsgrenze hin: Die Alternativen werden zusammen als geordnete Liste gelesen, gefolgt von einer einzigen Entscheidungsposition.
Warum diese Interaktion erlauben? Optionen wie „keine der oben genannten” hängen von den anderen Wahlmöglichkeiten ab. Selbst gewöhnliche Alternativen können eine Frage klären. „Payments”, „account access” und „other” definieren eine andere Entscheidung als „bank”, „payment provider” und „customer”. Eine listweise Repräsentation lässt das Modell diese Unterscheidung interpretieren, bevor es die Verteilung erzeugt.
Die stärkste Evidenz ist ein Experiment mit einer irrelevanten zusätzlichen Option.
Beginne mit vier möglichen Ursachen eines Auszahlungsfehlers: bank, provider, customer und unknown. Dann hänge weather: Bad weather caused it an. Wenn jede ursprüngliche Option ein unabhängiges, unverändertes Logit erhält und der Server dieselbe Softmax-Temperatur anwendet, ändert das Hinzufügen einer fünften Option die Normalisierung, kann aber die Odds zwischen zwei bestehenden Optionen nicht ändern:
Der gemeinsame Nenner kürzt sich. Das gibt uns eine spezifische, falsifizierbare Vorhersage.
Die ursprüngliche Studie fand eine Verschiebung von ungefähr +0.49 auf +0.08.10 Um zu prüfen, ob dies die gewöhnliche Anfragevariabilität überlebt, wiederholte ich das Experiment in zehn randomisierten Blöcken. Jeder Block enthielt die Vier-Optionen-Basislinie, eine identische Vier-Optionen-Kontrolle, eine Fünf-Optionen-Version mit angehängtem weather, eine identische Fünf-Optionen-Kontrolle und eine Fünf-Optionen-Version, deren hinzugefügte Beschreibung von „Bad weather caused it” zu „Wild birds caused it” wechselte. Jede Anfrage enthielt eine Frage.21
Das Expansionsergebnis replizierte. Fasst man die beiden identischen Anfragen pro Bedingung innerhalb jedes Blocks zusammen, fiel der mittlere Log-Odds von +0.38 auf +0.11. Jeder Block zeigte einen Rückgang; die durchschnittliche Änderung war −0.28, mit einem deskriptiven 95%-gepaarten-t-Intervall von ungefähr −0.36 bis −0.19. Die Zusammenfassung nutzt die Kontrollanfragen, um gewöhnliches Anfragrauschen zu reduzieren, statt doppelte Ausgaben als unabhängige Experimente zu behandeln.21
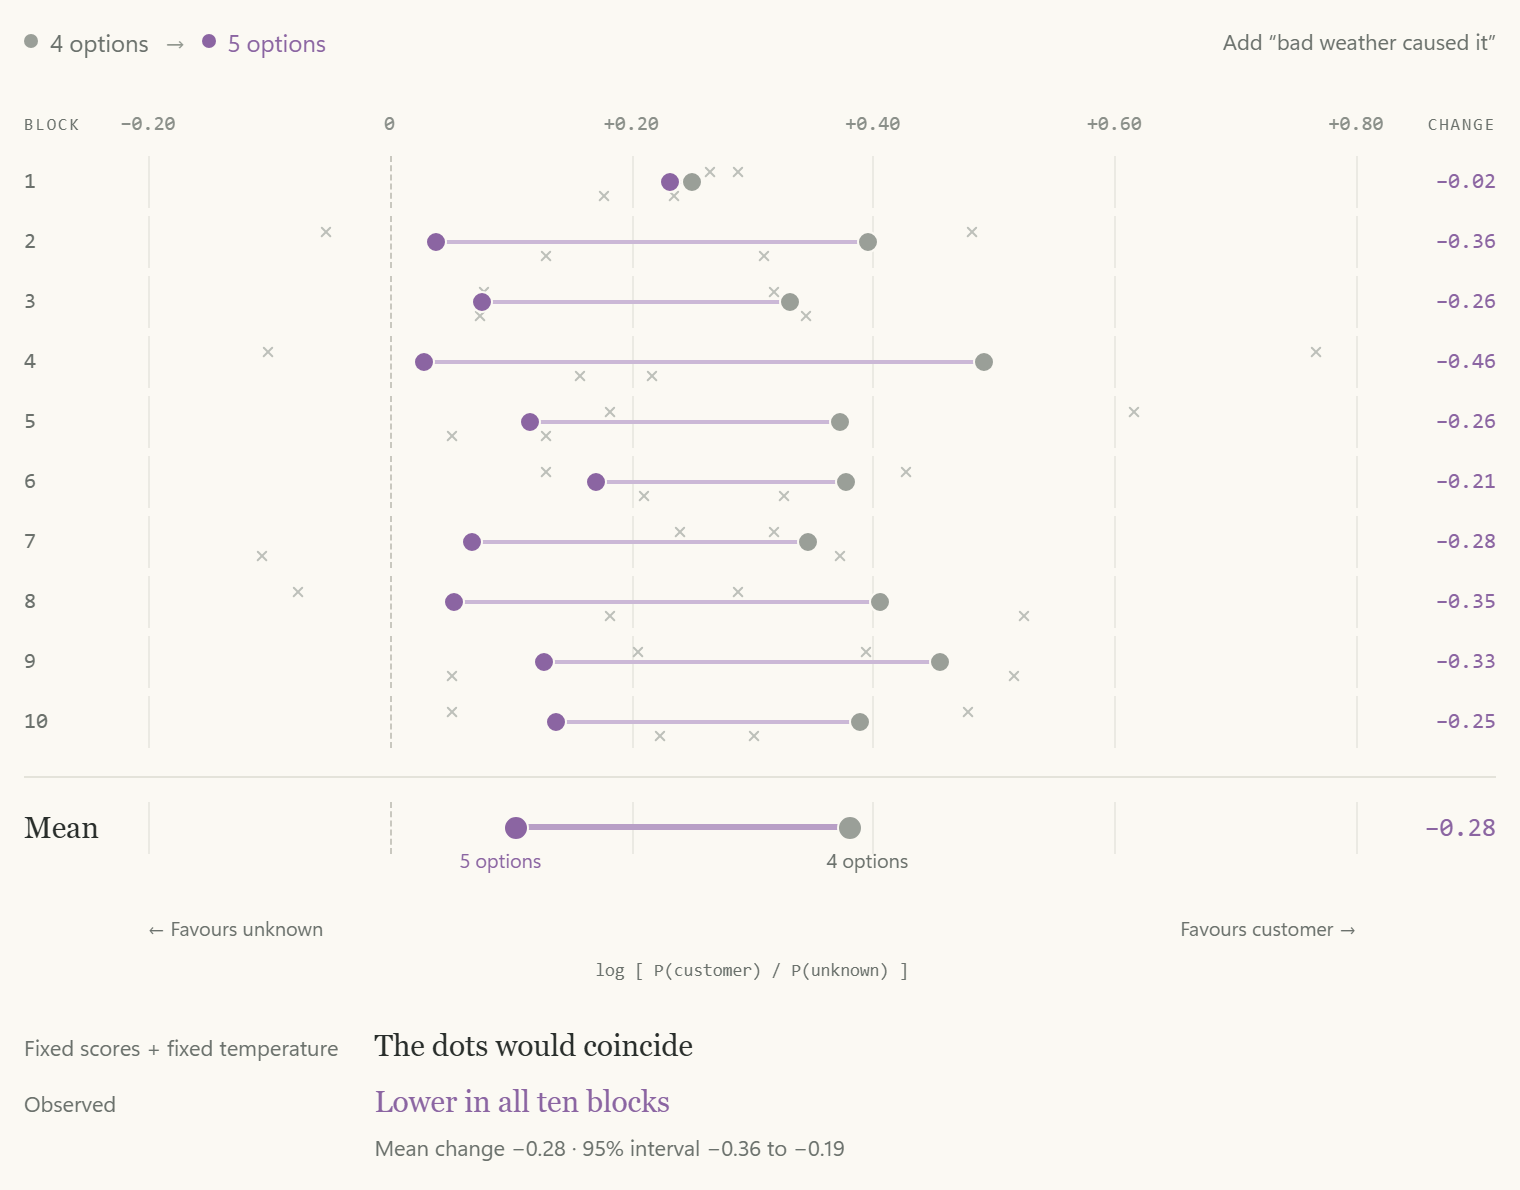
Dies ist Evidenz gegen feste unabhängige Logits gefolgt von einem unveränderten Softmax. Es identifiziert den Mechanismus nicht eindeutig. Die hinzugefügte Beschreibung zu ändern, während fünf Optionen beibehalten werden, ergab eine kleinere, nicht schlüssige Verschiebung: Ihr gepaartes Intervall enthielt die Null. Eine mengenabhängige Temperatur bleibt möglich, neben einem inhaltsabhängigen Mischen.
Ein Readout, der die vollständige Liste sieht, erklärt das auf natürliche Weise: Eine Option hinzuzufügen ändert den Kontext, den er liest. Die listweise Ranking-Methode FIRST funktioniert genauso und extrahiert ein Ranking aus den First-Token-Logits, statt es Token für Token zu generieren.11
Zwei Readouts passen zur Evidenz. Ein Final-Position-Kopf bewertet jeden Options-Slot aus der Repräsentation des Entscheidungstokens; ein Scorer im Pointer-Stil vergleicht diese Repräsentation mit dem eigenen finalen verborgenen Zustand jeder Option. Beide lassen Optionen einander beeinflussen. Die API akzeptiert höchstens 255 Optionen (2⁸ − 1), was zu einem festen 256-Slot-Kopf passt, aber dieses Limit wird durch die Anfragevalidierung erzwungen, nicht durch das Modell. Bei 200 Optionen erreichte eine kopierte Antwort 1.00 an jeder Position, und Fehler schwappten nicht auf benachbarte Optionen über, was zu einem Pointer passt. Keines der beiden Ergebnisse ist entscheidend.26
Injizierte Fake-Optionen verdrängten nie die echten, also sind Optionsgrenzen auf eine Weise markiert, die Text nicht fälschen kann, und eine Option, deren Bedingung anderswo in der Liste dupliziert wird, verliert Wahrscheinlichkeit an ihre Rivalen.23
Der Kompromiss ist auch bei gewöhnlichen Aufgaben sichtbar: Das Umkehren der Optionen verschob die Wahrscheinlichkeit einer technischen Support-Klassifikation von ungefähr 0.84–0.89 auf 0.93–0.96. Das kam aus den option_order-Sonden.9 Für eine eingesetzte Entscheidungspolitik ist das wichtig. Ein Schwellenwert nahe 0.9 könnte die Aktion ändern, obwohl die Labels und die Evidenz identisch sind. Permutationstests gehören in die Evaluierung jeder Implementierung dieses Designs.
5. Trainiere die Verteilung, dann berechne die Konfidenz
Die fünfte Komponente ist das Trainingsziel. Direkte numerische Ausgaben sparen Dekodierungsarbeit, aber eine billige Wahrscheinlichkeit kann trotzdem eine schlechte Wahrscheinlichkeit sein.
Stell dir eine Sammlung von Fällen vor, denen eine Wahrscheinlichkeit von 0.8 zugewiesen wird, dringend zu sein. Kalibrierung fragt, ob wirklich etwa 80% dringend sind. Es ist eine Eigenschaft von Vorhersagen über Fälle hinweg. Wir können nicht feststellen, ob eine einzelne Vorhersage kalibriert ist, daran, ob dieser bestimmte Fall gut ausgeht.
TypeSafe nennt seine Trainingsmethode Reinforcement Learning for Calibrated Decisions, oder RLCD. Der Launch sagt, sie optimiere auf „Antworten mit epistemisch ehrlichen Wahrscheinlichkeiten bei System-One-Aufgaben”; das Primer des Unternehmens stellt RLCD als einen Post-Training-Pfad von vortrainierten Sprachmodellen dar.112 Das genaue Rezept ist unveröffentlicht. Mein vorgeschlagenes Trainingsrezept passt den Transformer und den Readout mithilfe eines ergebnisbasierten Ziels an typisierte Entscheidungsaufgaben an. Das gibt dem Backbone die Möglichkeit, Repräsentationen zu konstruieren, die für zuverlässige Entscheidungen nützlich sind, nicht bloß für flüssige Vervollständigungen.
Ein natürliches Ziel ist Log Loss, für das beobachtete Ergebnis . Ein anderes ist Brier Loss, die quadrierte Distanz zwischen der vorhergesagten Verteilung und dem beobachteten One-Hot-Ergebnis. Beide sind proper scoring rules: In Erwartung minimiert das Melden der wahren bedingten Verteilung den Verlust. Gneiting und Raftery geben die formale Definition und Theorie.13 Das erklärt, was ein solches Training erreichen will. Es belegt nicht, welchen Verlust TypeSafe verwendet, ob seine Pipeline im engen algorithmischen Sinne Reinforcement Learning ist oder ob jedes Backbone-Gewicht aktualisiert wird.
Properness ist auch keine Deployment-Garantie. Endliche Daten, Modellgrenzen, Optimierungsfehler und Distribution Shift können die Kalibrierung alle unvollkommen lassen. Guo et al. zeigen sowohl die Kalibrierungsprobleme moderner neuronaler Netze als auch die Nützlichkeit von Post-hoc-Anpassungen. Training und Post-hoc-Kalibrierung sind kompatible Mechanismen; die API kann ihre Beiträge nicht trennen.14
Beobachtete Evidenz. Die Benchmark-Aufzeichnungen lassen uns die vorhergesagte Wahrscheinlichkeit mit der beobachteten Genauigkeit vergleichen, sowohl im Aggregat als auch innerhalb von Wahrscheinlichkeits-Bins. Das Diagramm zeigt diese Prüfungen. Die Übereinstimmung der Durchschnitte allein ist schwächere Evidenz als die Übereinstimmung innerhalb der Bins: Überkonfidenz in einer Gruppe kann Unterkonfidenz in einer anderen aufheben. Bei der MMLU-Stichprobe mit 1.200 Elementen betrug der Expected Calibration Error bei zehn Bins 0.0313 (Bin-Definitionen und Vorhersagen auf Elementebene). Die meisten Vorhersagen konzentrierten sich nahe der Gewissheit: 990 fielen in den Bin 0.9–1.0.15
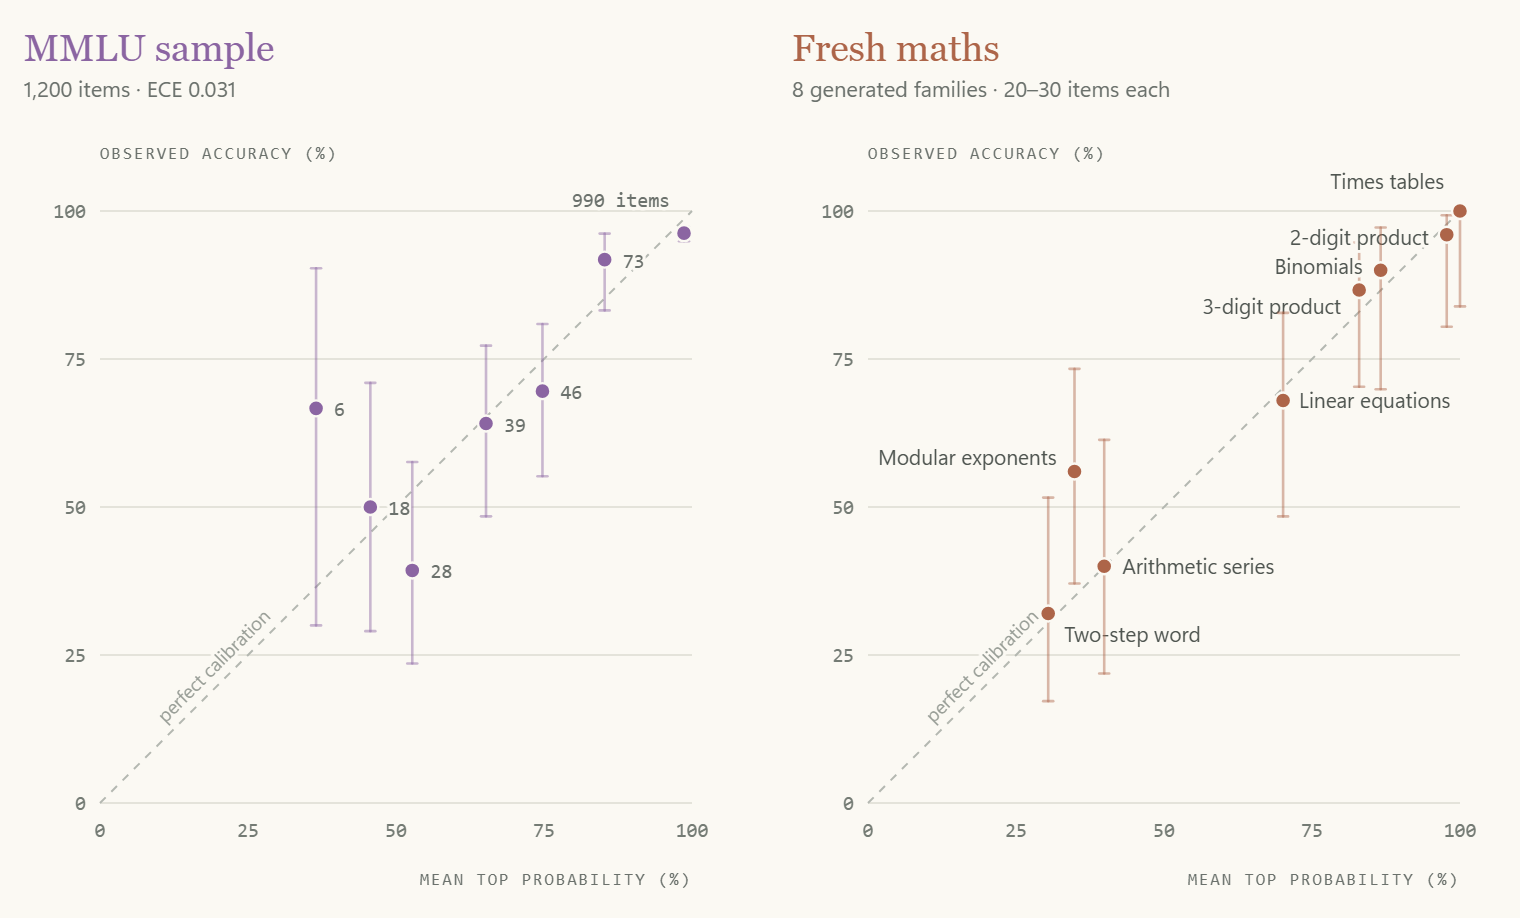
Die kleine Frisch-Mathe-Studie fügt nützliche Variation hinzu. Bei generierten dreistelligen Multiplikationsaufgaben betrug die Genauigkeit 86.7% und die durchschnittliche Top-Wahrscheinlichkeit 0.83. Bei zweischrittigen Textaufgaben fiel die Genauigkeit auf 32% und die durchschnittliche Top-Wahrscheinlichkeit auf 0.30. Das Modell war bei der schwierigeren Aufgabe weniger konfident (fresh_math_results, mit 30 Multiplikations- und 25 Textaufgaben-Elementen).15 Das ist ermutigend, obwohl kleine Durchschnitte auf Kategorieebene keine Kalibrierung für jede Art ungesehenen Problems belegen können.
Diese Ergebnisse zeigen auch, warum ein öffentlicher Benchmark-Score ein unvollkommenes Maß dafür ist, was das Modell weiß. Die MMLU-Pro-Genauigkeit betrug 84.6%; frisch generierte Textaufgaben waren viel schwieriger.15 Unterschiede in Aufgabenstruktur, Distraktoren, Schwierigkeit und Trainingsexposition könnten alle beitragen. Diese Lücke belegt keine Benchmark-Kontamination. Neue Formulierungen machen auch die zugrunde liegende mathematische Fähigkeit oder das Faktenwissen nicht ungesehen.
Es gibt einen separaten, ungewöhnlich klaren Befund über das API-Feld namens confidence. Der offizielle Adapter berechnet die Choice-Konfidenz aus einer normalisierten Verteilung für als:
Für drei Optionen mit einer maximalen Wahrscheinlichkeit von 0.8 ergibt das 0.7. Der Adapter behandelt den Ein-Option-Fall separat und gibt 1 zurück. Er misst, wie weit die führende Antwort über einer Gleichverteilung steht. Es ist keine weitere gelernte Schätzung, dass die Antwort richtig ist. Der Score-Typ verwendet eine andere Formel, die die Distanz zur modalen Stufe widerspiegelt.16
Im vorgeschlagenen System erzeugt das Training die prädiktive Verteilung; gewöhnliche Arithmetik erzeugt dieses Zusammenfassungsfeld. Diese beiden Objekte getrennt zu halten, verhindert einen häufigen konzeptionellen Fehler: Eine konzentrierte Verteilung kann trotzdem selbstbewusst falsch sein.
6. Sparsame Kapazität
Ich erwarte, dass Jev einen Transformer mit sparsamer Mixture-of-Experts verwendet. In ausgewählten Schichten schickt ein Router jedes Token durch eine kleine Teilmenge von Feed-Forward-Netzen, sodass das Modell viele Parameter speichern kann, während es nur einige davon pro Token aktiviert: die Idee der bedingten Berechnung, demonstriert durch Shazeer et al.s spärlich gegatete MoE-Schichten.17
Sparse Experts können von außen nicht beobachtet werden, aber sie sind die wahrscheinliche Wahl. Ein Prefill-only-Modell ist durch Rechenleistung begrenzt, und genau das spart sparsames Routing. Die üblichen Serving-Kosten von MoE verschwinden größtenteils: Es gibt keine Token-für-Token-Dekodierung, bei der Speicherbandbreite dominiert und die meisten Experten ohnehin aktiv werden, und keinen langlebigen KV-Cache, der mit den Expertengewichten um Speicher konkurriert. Die Messungen weisen in dieselbe Richtung. Jev verarbeitete etwa 30k Tokens in ungefähr 160 ms; ein dichtes 70B-Modell auf einem 8×H100-Knoten bräuchte etwa eine Sekunde, während ein MoE mit etwa 10B aktiven Parametern passt. Und die meisten der stärksten neueren Basismodelle (DeepSeek-V3, Qwen3, GLM-4.5, Kimi K2, gpt-oss) sind MoE. Spezialisierte Hardware könnte ein dichtes Modell die Geschwindigkeit erreichen lassen, und Benchmark-Scores könnten überzeichnen, wie viel Wissen das Modell hält, also bleibt dies eine Schlussfolgerung, keine Messung.615
Nichts anderes in der Rekonstruktion hängt davon ab. Ein dichtes Transformer einzutauschen würde die Schnittstelle, den gemeinsamen Zustand, die isolierten Zweige und den Readout genau so lassen, wie beschrieben.
7. Plane die Zweige als Batch, nicht als Konversation
Die letzte Komponente ist eine Serving-Engine, die Fragenzweige als unabhängige Arbeitselemente behandelt. Ihre Suffixe können in Batches gepackt werden, während sie die Repräsentationen des gemeinsamen Zustands lesen. Anwendungscode ordnet dann die numerischen Ausgaben den Fragenbezeichnern zu und serialisiert die Antwort.
Die Messungen zeigen kleine Unterschiede zwischen wiederholten identischen Antworten, auch zwischen doppelten Fragen innerhalb einer Anfrage. Das heißt, API-Level-Determinismus sollte nicht vorausgesetzt werden (noise, dup und determinism).19 Es impliziert nicht, dass das Modell Text generiert oder sampelt: numerische Kernel, dynamisches Batching, Routing oder bewusste Zufälligkeit können alle ein direktes Readout beeinflussen.
Die Reihenfolgen der Antwortschlüssel variierten ebenfalls in einer kleinen Zahl wiederkehrender Muster.19 Mehrere Worker mit unterschiedlicher Hash-Reihenfolge sind eine plausible Erklärung. Dieser Seitenkanal identifiziert jedoch nicht die Worker-Anzahl, belegt nicht, wo der KV-Cache lebt, und sagt uns nicht, welche numerische Präzision verwendet wird. Das sind Implementierungsdetails, die die verfügbaren Beobachtungen nicht auflösen können.
Was für die vorgeschlagene Architektur zählt, ist das Fehlen einer Abhängigkeitskette zwischen Antworten. Das Modell muss nicht die Warteschlangenklassifikation fertig schreiben, bevor es mit der Dringlichkeitsschätzung beginnt. Beide hängen vom Zustand ab; keines konsumiert die generierte Antwort des anderen.
Es gibt weiterhin ein Abhängigkeitslimit. Wenn eine spätere Frage wirklich eine frühere Antwort braucht, muss die Anwendung eine weitere Entscheidungsstufe einführen oder die gemeinsame Entscheidung in einer Frage ausdrücken. Kontext zu teilen entfernt nicht die logische Struktur des Workflows.
Was würde mich umstimmen?
Diese Rekonstruktion geht unterschiedliche Arten von Verpflichtungen ein. Direkte Wahrscheinlichkeitsausgaben werden öffentlich beschrieben. Fragenisolation und Optionsreihenfolge-Effekte sind beobachtbare Verhaltensweisen. KV-Sharing, kausale Aufmerksamkeit, Final-Position- oder Pointer-Readouts und sparsame Experten sind zunehmend spezifischere Erklärungen.
Das Referenzkarten-Experiment klärt eine Frage: Die Entscheidung kann zuletzt platzierte Optionen nutzen. Der Fake-Option-Test zeigt, dass Tricks im Eingabeformat Optionsgrenzen nicht fälschen können. Breitere relationale Aufgaben könnten die Repräsentation weiter einschränken, obwohl verhaltensmäßiger Erfolg allein immer noch keine Aufmerksamkeitsmaske eindeutig identifizieren würde.
Für die Optionsbehandlung repliziert die randomisierte Folgestudie einen Choice-Set-Effekt, aber die Intervention mit fester Größenbeschreibung bleibt nicht schlüssig. Mehr Vorlagen und unabhängige Anfrageblöcke könnten eine gemeinsame Temperaturänderung von inhaltsabhängigen Interaktionen unterscheiden. Eine Aufgabe mittlerer Schwierigkeit mit 200 Optionen könnte den Slot-Kopf vom Pointer-Scorer trennen. Für die Kalibrierung wären zurückgehaltene Workflow-Daten und wiederholte Evaluierungen unter Shift wichtiger als ein weiterer aggregierter Benchmark-Score. Sparsame Experten zu bestätigen, würde wahrscheinlich eine Offenlegung oder Evidenz jenseits dieser API erfordern.
Meine beste Rekonstruktion von Jev bleibt die im einleitenden Diagramm: ein kausaler Transformer mit einem gemeinsamen Zustandspräfix, isolierten Fragensuffixen, listweiser Optionsverarbeitung, typisierten numerischen Readouts und einem Training, das auf prädiktive Verteilungen gerichtet ist. Sparsame Experten sind das wahrscheinliche Backbone, obwohl nichts anderes im Design von ihnen abhängt.
Ihr Nutzen kommt daher, den Berechnungsgraphen an die Aufgabe anzupassen. Ein Entscheidungsdienst muss Evidenz lesen, erlaubte Ergebnisse vergleichen und Unsicherheit offenlegen. Ein Transformer kann das, ohne jede Entscheidung zuerst in einen Satz zu verwandeln.
Methoden
Dieser Essay basiert auf einer Untersuchung von jev-1.13.0 vom 17. September 2026, mit einem Early-Access-Konto und einer beobachteten Dienstregion. Die Quellstudie enthält 1.029 instrumentierte Sondenaufzeichnungen (einschließlich der 190 generierten Mathe-Elemente), 6.800 Benchmark-Aufzeichnungen und separate Faktenprüfungen. Folgestudien fügten 146 relationale und Optionsinteraktions-Anfragen hinzu (Versuche, Zusammenfassung), 311 Token-Abrechnungsanfragen, 445 Tokenizer-Fingerprint-Anfragen, 192 Latenzanfragen, 148 Latenzanfragen nach Optionsanzahl, 181 Optionspositions-Anfragen, 105 Fake-Option-Anfragen und 35 Kontextlimit-Anfragen. Jede ist aus den Referenzen verlinkt, mit exakten Anfragen und bereinigten Antworten. Wiederholte Benchmark-Konfigurationen teilen zugrunde liegende Elemente; diese Zahlen sind keine Zählungen unabhängiger Probleme.
Das herunterladbare Evidenz-Bundle zeichnet die in diesem Essay verwendeten Beobachtungen auf. Die API-Beispiele im einleitenden Abschnitt sind schematisch. Die zitierten visibility- und Referenzkarten-Prompts stammen aus den Sondenskripten und gespeicherten Folgeanfragen. Numerische Beobachtungen sind spezifisch für diese Modellversion und Testkampagne.
Latenzzahlen stammen aus dem Antwort-Header x-envoy-upstream-service-time. Es sind Upstream-Dienstdauern mit unbekannten Queueing- und Ausführungsgrenzen, keine isolierten Modellmessungen. Die Sweeps der Latenzabbildung wurden eine Anfrage nach der anderen in gemischter Reihenfolge ausgeführt; keine der Studien kontrollierte die Serverlast. Lokale Wall-Clock-Messungen werden nicht als architektonische Evidenz verwendet.
Wahrscheinlichkeiten wurden im Allgemeinen mit zwei Dezimalstellen Genauigkeit zurückgegeben. Doppelte Fragen innerhalb einer Anfrage teilen Bedingungen und können korrelierte Fehler haben. Die MMLU-Kalibrierungsabbildung verwendet zehn gleich breite Bins: [0, 0.1), [0.1, 0.2) und so weiter, wobei 1.0 im letzten Bin enthalten ist. Der Expected Calibration Error ist die stichprobengewichtete absolute Differenz zwischen Genauigkeit und durchschnittlicher Top-Wahrscheinlichkeit in jedem Bin. Schätzungen hängen von Stichprobenauswahl, Binning und Antwortrundung ab. Die Evidenz stützt Aussagen über die getesteten Verteilungen, nicht eine garantierte Kalibrierung über zukünftige Kunden-Workflows hinweg.
Quellen und verwandte Arbeiten
Experimentelle Referenzen identifizieren die ursprünglichen Skript-Tags, sodass jede Beobachtung im Evidenz-Bundle lokalisiert werden kann. Papierzitate belegen die vorgeschlagenen Mechanismen und ihre Präzedenzfälle; sie belegen nicht, dass Jev sie verwendet.
Quellen
- TypeSafe (2026). Introducing System One Models and Jev. Primärquelle für die Behauptung der parallelen Ausgabe und das erklärte RLCD-Ziel.
- TypeSafe. Vollständige API-Dokumentation, abgerufen am 17. September 2026. Typisierte Fragen, Antwortverteilungen und API-Vertrag.
- Vaswani et al. (2017). Attention Is All You Need. Decoder-Masking, Aufmerksamkeit und die lineare/Softmax-Ausgabeschicht.
- API-Experimente: type_preamble und outputs. Additivität der Token-Abrechnung, Bezeichneränderungen und die 255-Optionen-Antwort.
- API-Experiment: visibility. Fünf Wiederholungen jeweils mit dem Geheimnis in einer Schwesterfrage, abwesend aus dieser Schwester und im Zustand.
- Latenz-Sweeps (192 sequenzielle Anfragen). Zustandslänge und Fragenanzahl, je 8 gemischte Wiederholungen; vom Server gemeldete Upstream-Dauern.
- Juravsky et al. (2024). Hydragen: High-Throughput LLM Inference with Shared Prefixes.
- Yao et al. (2024). DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference.
- API-Experiment: option_order. Reihenfolgeempfindlichkeit bei gewöhnlichen Tickets.
- API-Experiment: iia. Drei Anfragen pro Bedingung, jede mit vierzig doppelten Fragen; ursprüngliche, angehängte und vorangestellte Optionssets.
- Reddy et al. (2024). FIRST: Faster Improved Listwise Reranking with Single Token Decoding.
- TypeSafe. Machine-Learning-Primer. Primärbeschreibung des RLCD-Post-Training-Pfads und des Kalibrierungsvertrags.
- Gneiting and Raftery (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association 102(477):359–378.
- Guo et al. (2017). On Calibration of Modern Neural Networks.
- Benchmark- und Mathe-Generierungs-Aufzeichnungen: Genauigkeit und durchschnittliche vorhergesagte Wahrscheinlichkeiten. ; MMLU-Reliabilitätsanalyse: Bin-Definitionen, ECE, Wilson-Intervalle und 1.200 Vorhersagen auf Elementebene.
- TypeSafe. Offizieller Python-Adapter, confidence_metrics.py, Revision fb52b103. Choice- und Score-Konfidenzformeln (gelesen am 17. September 2026).
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer.
- Tokenizer-Fingerprint-Experiment (445 Anfragen). Run-Length-, Vokabular- und Pre-Tokenisierungs-Sonden, verglichen mit 192 öffentlichen Tokenizern.
- API-Experimente: noise, dup und determinism. Wiederholte Wahrscheinlichkeiten und Antwortschlüsselreihenfolgen.
- Relationales Folgeexperiment (96 Anfragen). Zwei Vorlagen, zwei Referenzwerte, sechs Permutationen, zwei Positionen und zwei Wiederholungen; exakte Anfragen und bereinigte Antworten.
- Optionsinteraktions-Folgeexperiment (50 Anfragen). Zehn randomisierte Blöcke aus base4, null4, append5, replace5 und null5; gepaarte Änderungen und Standardfehler.
- Kontextlimit-Experiment (35 sequenzielle Anfragen). Tokenlimits pro Zweig und pro gesamter Anfrage, mit akzeptierten und abgelehnten Grenzfällen.
- Fake-Option-Injection-Experiment (105 Anfragen). Sieben Delimiter-Formate, gesättigte und mehrdeutige Basisaufgaben und vollständige Wahrscheinlichkeitsvektoren.
- Token-Abrechnungsexperimente (311 Anfragen). Länge der Fragen-ID, Batchgröße, Zustandsschwierigkeit, Wort-IDs und abgeglichene Zustands- vs. ID-Strings.
- Latenzexperiment nach Optionsanzahl (148 Anfragen). Eine oder 20 Fragen mit 2–200 Optionen, kurze und lange Labels, plus Kontrollen zur Entkopplung von Input/Output.
- Optionspositions-Experiment (181 Anfragen). Obergrenze der Optionsanzahl, richtige Antwort über 10-, 50-, 200- und 255-Optionslisten verschoben.
Quelle: Jevs Architektur entschlüsselt — Archer, archerhume.com, 17. September 2026.