Jev 的架构揭秘
我用 10,000 次 API 调用探测 Jev,大致推断出它是怎么造出来的,以及为什么 X 上那些蹭热度的说法基本都是错的。 X 上关于 Jev 发布的说法铺天盖地,而绝大多数都没抓住要点:“一个 JSON 分类器 1200 万次浏览?好吧,我们确实在泡沫里。” 普通的 LLM 是把“我有 90% 的把握”这句话当成文本生成出来的;它生成这几个词的概率,并不能构成“它说对了的概率是 90%”这个结论。可我们恰恰是在这个模式上搭起了欺诈筛查、内容审核、路由和风险评估:花钱做逐 token 生成,然后把一句未经校验的置信度声明,当作软件可以据以行动的概率。
Jev 的命题是:保留预训练 LLM 的知识,同时把「生成的置信度声明」换成直接从内部表示里读出的决策概率。这些概率是拿结果训练出来的。给它共享的 state、若干个 question 和允许的答案,它并行地返回分布,不生成文本。1 对这类应用来说,这一下同时解决了两个问题:决策信号的可信度,以及为了产出这个信号而多花掉的算力。
只有一个问题:它不是开放权重,而 TypeSafe 不肯公开他们的研究……那我就自己来(尽力而为)。
证据指向一个因果 transformer(很可能用了稀疏 MoE),被改造成了做决策的模型:共享状态编码、彼此隔离的问题分支、以及直接读出概率而不是生成文本。我探测了 TypeSafe 的 API(在不同上下文长度下找延迟伸缩的特征、重排问题顺序等),用 Astra 翻遍了公开文档与研究,又去查了已有的先例,现在我觉得自己对它怎么运作、架构长什么样,已经有了一个相当接近的模型。
稀疏骨干是其中最不确定的一环,但它在这个领域特别有利,代价比自回归 LLM 还小,所以如果没用反而奇怪。共享计算和直接输出概率这两点,证据则充分得多。这整套东西显然相当推测性,所以我会尽量讲清楚:哪些是 TypeSafe 自己公布的,哪些是实验观测到的,哪些是从前两者推断的。黑盒 API 让「蒙上一层布去摸鬼的形状」出奇地容易。
这个设计为什么有用
设想一个示意性的客服路由请求。它用来说明 API 的结构;下面的示例概率是我编的。
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}
一个有用的回答可能给 payments 0.91 的概率,而只给「需要升级」0.42。这是两种不同的不确定性。软件可以自动把工单路由出去,同时把「是否升级」交给另一套策略。
因果 transformer 本来就知道怎么从左到右构造一段文本的表示。在普通的语言模型推理里,它处理 prompt,预测一个 token,把这个 token 喂回去,如此重复。这建立在原始 Transformer 提出的 decoder 注意力与输出投影之上。3 但处理 prompt 这一步本身就已经产出了一份丰富的表示。如果任务是在三个队列里选一个,我们完全可以接一个小小的函数,把那份表示直接映射成三个数字。
这里的一个细节能解开「并行回答」上的大部分困惑:因果注意力描述的是哪些位置能用哪些信息,而不是输入 token 必须以什么顺序被执行。 在处理 prompt(也就是 prefill)时,每个输入 token 都已经知道了。模型可以在同一层里同时处理它们各自的位置,而注意力掩码挡住对后面位置的访问;层与层之间仍然是顺序执行的。自回归解码多出来的那层依赖是:下一个 token 在上一个预测被定下来之前并不存在。而我们设想的模型在 prefill 和读出之后就结束了,所以避开了这个逐 token 的依赖。
这改变了任务的计算形状。输出不再需要为 "payments": 0.91 做一长串拼写决策。JSON 格式化交给普通的应用代码。神经网络只负责给出概率。
现在假设 state 是一份很长的故障报告,还有五十个问题。输入里绝大部分是共享的。transformer 把已处理 token 的中间信息存在它的键值缓存里,通常简称 KV cache。在这个设计里,每个问题读的都是同一份 state 缓存。每个分支只额外加上自己的 instructions 和答案选项。
对于一个 个 token 的 state 和 个问题,拆成独立请求的话,state 大约要被处理 次。共享之后,重复的 state token 处理量从 降到 。问题仍然要去 attend state,这部分工作不会消失。但模型不必一遍遍重建 state 的表示。
这种隔离也让接口有了一个有用的含义:问「这位客户是不是生气了」,不应该改变工单被分到哪个队列。两个问题可以查看同样的证据,而不会读到彼此的 instructions。分支之间没有计算上的依赖,哪怕它们的答案在统计上相关。
最后,概率让下游策略变得显式。如果一次多余的升级代价是 1,而漏掉一个紧急案例的代价是 9,那么一条简化的决策规则就是:当 时升级。这个计算只有在「概率对这个工作流确实可靠」的前提下才有意义。因此,训练和评测这个概率分布本身就成了产品的一部分,而不是一个装饰性的 confidence 字段。
这些都不需要 diffusion。并行分类已经存在几十年了。真正有意思的组合是:一个能力广博的 transformer、共享的上下文计算、带类型的输出接口,以及一种训练:奖励「有用的不确定性」。
1. 用读出取代生成来结束推理
第一个组件最简单:用预测头取代解码循环。
公开证据。 TypeSafe 的发布公告说:「Jev 并行输出全部概率,而不是逐 token 自回归生成。」它的文档提供有限选项、是/否判断和有序评分。这些天然就该用固定数值输出来表示。12
观测证据。 API 仍然报告一个 output_tokens 字段,听起来像是生成记录。它不是。对是/否问题,这个数字严丝合缝:4 个共享 token,加上每个答案 15 个,再加上每个问题标识符的 token 长度。TypeSafe 的文档说这个标识符「不会发送给底层模型,也不参与推理」。一个随模型从未见过的文本而变化的计数,只能是在推理之后、根据序列化后的响应算出来的。返回的数值也影响不了它:答案是 0.0 和答案是 0.01 花的钱一样多,而其他情况下每位数字都算一个 token。224
这个计数背后的分词器,和我们测过的 192 个公开分词器都对不上。但它对普通文本的计数与 Jev 自己的输入计数器一致,只在长串空白和标点上不同。output_tokens 是一个计费数字。它说明不了 Jev 是否生成文本,就算它真的生成,这个数字也量不了那些文本。延迟同样跟它没关系:一个有 200 个选项的问题(1,911 output tokens)返回得和只有两个选项的一样快,服务端耗时只随输入长度增长。2425
有一个 255 选项的响应报告了 2,714 output tokens。4 拿这个数除以请求耗时,把它叫作模型的解码速度,是错的。服务器完全可以在一次模型求值之后序列化出几千个字符。这个计费字段说明不了发生过多少次神经解码步骤。
这个读出方案取最终的隐向量 ,产出 logits:
这里 是允许的答案数。矩阵 把表示变成答案得分;softmax 把得分变成一个分布。对于是/否决策,一个标量加一个 sigmoid 就够了。
这些类别不必是「payments」这种固定概念。它们可以是选项槽位:第一个选项、第二个选项、第三个选项。分支提供每个槽位的含义;应用代码把它的概率映射回调用方给的选项键。有序的 Score 同理:在若干档位上预测概率,再返回它们的概率加权平均。这样就不必为每个客户的标签各训一个新头,也能支持新的决策。第 4 节会对比的指针式打分器是主要的替代方案:它给每个选项自己的表示打分,而不是给编号槽位打分。
这并不能证明 Jev 里有一个单独命名的分类器模块。语言模型的词表头也是一个矩阵接 softmax。从那个矩阵里挑出 行保留的标签,就能实现和一个专门的 分类头相同的计算。这些行可能与输入嵌入共享,也可能单独训练;在这里我们区分不了这些安排。
关键的区别在于读出概率和生成描述概率的文本。生成出来的「91%」是一串 token。分类器的 0.91 是它预测分布里的一个条目。两者都可能失校准。谁也不会仅仅因为形式而变得可信。
受限文本解码仍然是搭建类似接口的一条可能路径,但 TypeSafe 明确描述了另一条输出通路。他们自己的说法比一个延迟论证更有分量。 证据指向直接数值读出,也就是第 4 节对比的两种设计之一。保留标签 token 仍然可能,不过那一节的假选项测试对它不利。
2. 共享 state,隔离问题
下一个决策是:在哪一层复用计算。
观测证据。 在小规模受控例子里,token 计费是精确可加的。一个最小的是/否问题用了 268 个输入 token;两个用了 276 个。一个包含一个是/否问题、一个两选项 Choice 和一个两档 Score 的请求用了 318 个,正好等于它们各自在共享开销之上的贡献之和。这符合「一个公共前缀 + 各问题后缀」的形态,虽然仅凭计费无法确定计算图长什么样。4
一个信息量更大的实验是把证据在这两个区域之间搬动。state 一开始写的是:
The weather is nice today and the park is full of people.一个兄弟问题里写的是:
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
探测问的是「另一个问题里提到了哪个密码」,选项有 ZEBRA-7741、两个干扰项和 none。密码放在兄弟问题里时,它报告的概率是 0.00;把那个兄弟问题删掉,结果一样。把声明放到 state 里,概率升到 0.90–0.92。每种条件重复五次(探测记录里的 visibility)。5
这是一个很有用的干预:把一个声明移过一条 API 边界,就改变了它的效果。 它支持「问题之间存在行为隔离」以及「可以访问共享 state」。它没有暴露确切的注意力掩码 —— 拆成多次模型调用、使用树形掩码、或者其他限制信息流动的机制,都能产生同样的结果。探测的措辞即使在 state 条件下也问的是「另一个问题」,所以它不是一次干净的「字面指令遵循」测试。
服务端测量又补上一块。问题数到 100 左右之前,服务端耗时几乎不变;过了这个点就稳定上升,而且按 token 计,问题文本的代价大约是 state 的两倍。这与「state 只算一次、问题部分批处理」一致。6
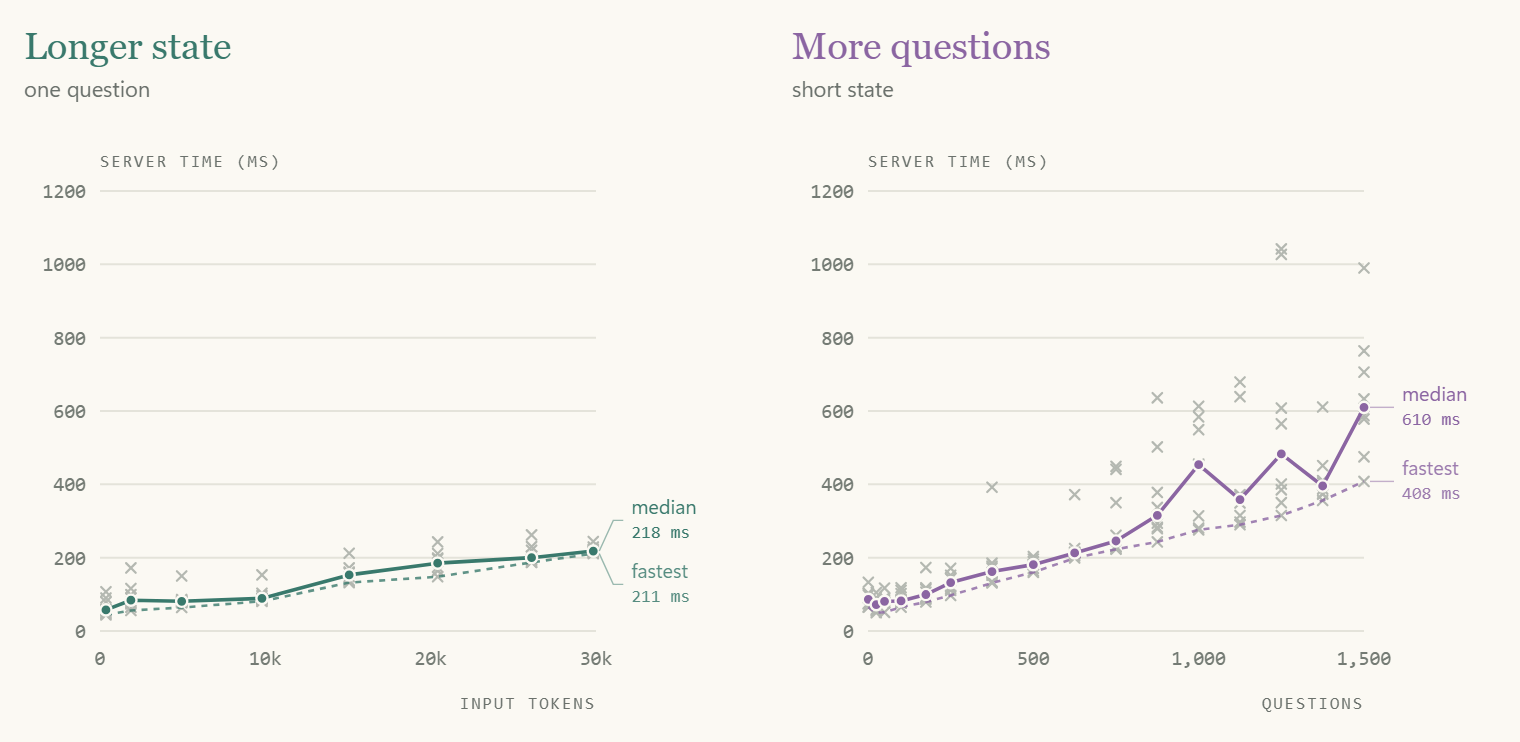
这些是服务端上报的上游耗时,不是本地笔记本上的计时。它们包含上游服务内部的工作与等待,而且那台服务当时还和其他用户共享。
Jev 有两条限制。每个分支(state 加一个问题)上限约 32,768 个 token,整个请求上限约 65,536 个。请求上限里 state 只算一次:一个有 23k token 的 state 加 5,000 个问题也塞得下。如果每个问题都各自处理一份 state 的副本,这个请求会超过一亿个 token。这一对数字正好装进一条最多 2¹⁶ token 的打包序列:state 放一次,之后接上所有问题,每个分支再限制在 2¹⁵ 的上下文窗口内。22
带独立因果后缀的前缀 KV 缓存是最自然的实现。Hydragen 描述了共享前缀序列的高效注意力;DeFT 发展了树形推理的注意力。这些说明这种服务模式是可行的。它们是先例,不是 TypeSafe 用了其中任何一个库的证据。78
这个设计也澄清了一处表面矛盾:被隔离的问题仍然可以在同一块加速器上一起来算。「并行」描述的是它们的调度方式以及彼此之间没有答案依赖,不必意味着每个问题一块 GPU。
3. 因果骨干
这些实验区分不了因果解码器和双向编码器:两者都能让最终决策读到整个输入。我仍然假定是因果解码器,理由很充分。Jev 的知识广度(MMLU-Pro 84.6%)要求前沿规模预训练,而那个规模上的模型全是因果解码器;TypeSafe 又明确说 RLCD 是对预训练语言模型的后期训练。一个双向的 Jev 要么意味着底子弱得多,要么意味着多花代价把一个解码器转过去,同时放弃因果服务方式提供的共享前缀缓存。那会很意外,但从外面无法排除。1215
用的是哪个预训练模型,无从得知,分词器也没透露。在 415 次探测里,Jev 的 token 计数和我们测过的 192 个公开分词器没有一个对得上。它把每个数字单独切开,又会在合并之前先查整块:8 个 a 算一个 token,16 个就变成四个。它的词表与 OpenAI 的 o200k 很接近 —— 每个 Jev 算作单 token 的字符串在 o200k 里也是单 token —— 但数字切分和若干合并规则排除了 o200k 本身。公开分词器里最接近的是 Qwen,在 415 次探测中吻合 348 次。这排除的是「未经改动的公开分词器」,而不是公开底座模型:换过词表、继续预训练或蒸馏都能解释它,一个计数方式和模型不同的 API 也能。18
这些实验确实展示了决策能读到什么。我把一张「参考卡」放进问题的选项里,让 Jev 挑出条件被卡片满足的那个选项。下面是一组确切的选项:
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.指令是:「读参考卡,选出条件被满足的那一个选项。」把参考值改成 indigo,正确答案随之切换,而可选项本身完全没变。
我测了两个取值、全部六种选项排列,以及另一个用 route = east/west 的模板,各重复两次。另设一组配对对照,把参考卡放进共享 state。合计得到 48 次「选项内参考」试验和 48 次「state 内参考」对照。20
| 参考选项的位置 | 答对次数 |
|---|---|
| 最前 | 12 / 16 |
| 中间 | 11 / 16 |
| 最后 | 16 / 16 |
| 参考卡移入 state | 48 / 48 |
Jev 能用上放在候选描述之后的信息。 参考卡在最后时,它在每一次试验里都选对了,正确答案的平均概率约 0.88。
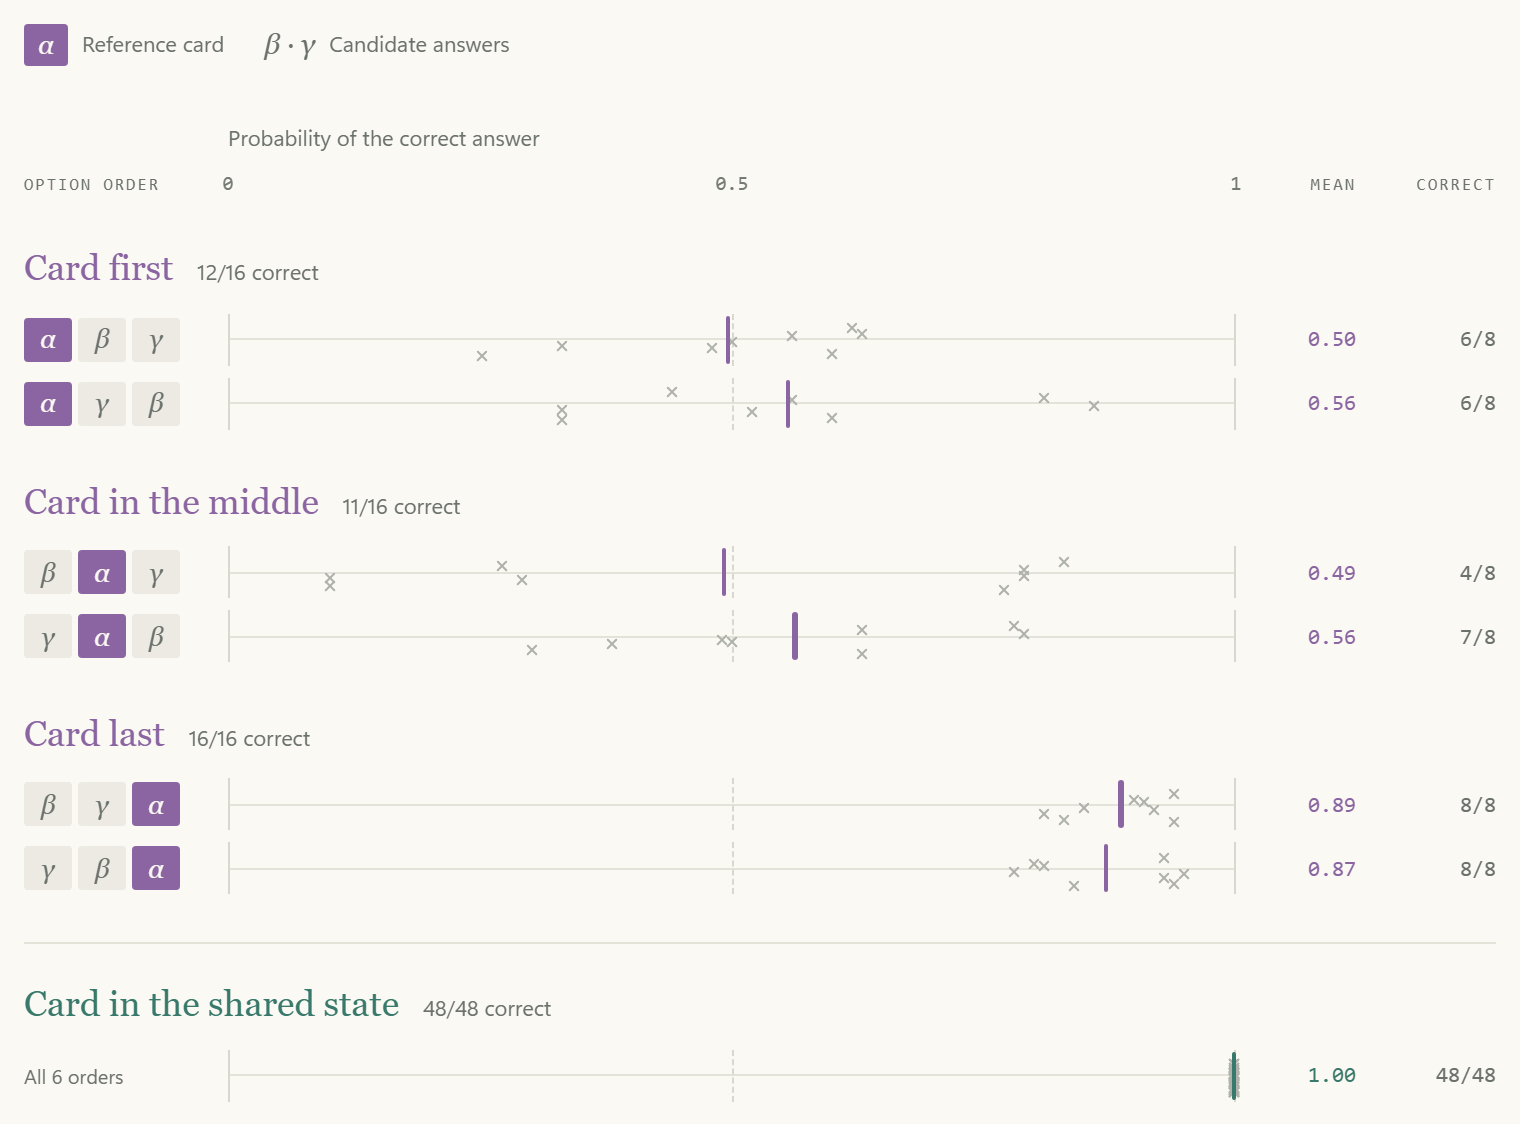
取值切换这一组对照和位置一样重要。卡片在最后时,只把 amber 改成 indigo,就改变了前面某个选项的胜出结果 —— 而那些靠前的描述和 state 完全没动。一个独立地从自身文本和 state 给每个选项打分、然后仅仅做归一化的模型,没有任何途径让这件事改变前面选项的相对排序。结果支持「存在一条让选项影响联合决策的通路」。20
这符合任何在整个列表之后计算的读出方式,包括第 4 节对比的两种设计,也包括一个独立的选项混合阶段。剩下的错误说明这两个模板上存在位置敏感的处理;它们指不出唯一的原因。
这个计算不需要 diffusion,这些实验里也没有任何东西需要迭代去噪。站得住脚的架构推断要窄得多:答案的计算能访问完整的选项列表。下一个实验检验它是否真的用上了那份联合上下文。
4. 选择之前,先让选项互相影响
在一个问题内部,证据指向另一条信息边界:各个备选是作为一个有序列表被一起读入的,后面才是那个决策位置。
为什么要允许这种交互?像「以上都不是」这种选项本来就依赖其他选项。即便是普通的备选也会影响问题的含义。「付款」「账号访问」「其他」定义的决策,和「银行」「支付服务商」「客户」定义的并不是同一个。列表式的表示让模型在产出分布之前能解释这个差别。
最强证据来自一个加入无关选项的实验。
先有四种付款失败的可能原因:bank、provider、customer、unknown。然后追加 weather: Bad weather caused it。如果每个原有选项拿到的 logit 独立且不变,服务端用的 softmax 温度也没变,那么加入第五个选项只会改变归一化,无法改变两个原有选项之间的赔率:
公共分母消掉了。这就给出一个具体、可被证伪的预测。
原始研究报告了一次从大约 +0.49 到 +0.08 的位移。10 为了确认这不是普通请求波动,我在十个随机区组里重做了这个实验。每个区组包含:四选项基线、一个相同的四选项对照、追加了 weather 的五选项、一个相同的五选项对照,以及一个五选项版本 —— 其中追加的描述从「Bad weather caused it」改成「Wild birds caused it」。每次请求只含一个问题。21
扩张效应复现了。把每个区组内同一条件的两次相同请求合并后,平均对数赔率从 +0.38 降到 +0.11。十个区组全部下降;平均变化为 −0.28,描述性的 95% 配对 t 区间约为 −0.36 到 −0.19。合并的做法是用对照请求压低普通的请求噪声,而不是把重复输出当作独立实验。21
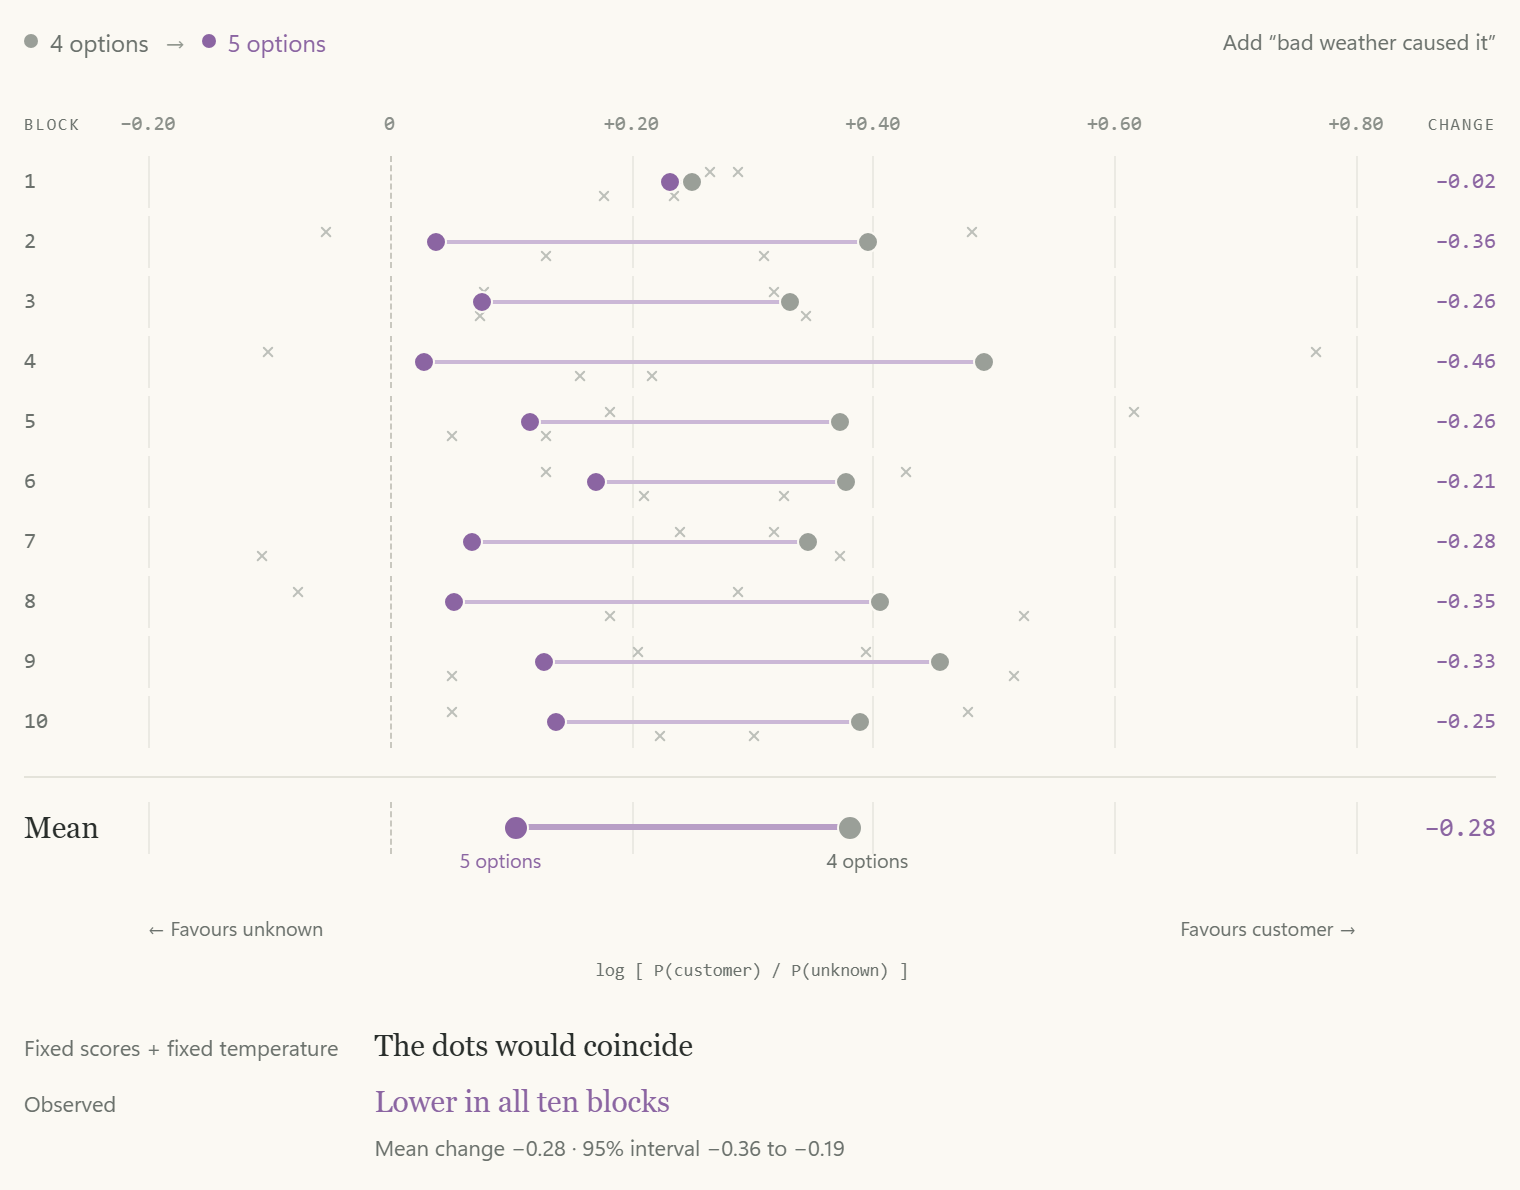
这是反对「固定独立 logits + 不变 softmax」的证据。它没有唯一地确定机制。保持五个选项、只改追加描述,得到的变化更小且不确定:它的配对区间包含零。随集合而变的温度仍然可能,与内容相关的混合也一样。
一个能看到完整列表的读出方式天然解释了这件事:加入一个选项改变了它读到的上下文。FIRST 那个列表式排序方法就是同样的道理,它从首 token 的 logits 里取出排序,而不是逐 token 生成排序。11
有两种读出方式都能解释这些证据。一种是末位头:用决策 token 的表示给每个选项槽位打分。另一种是指针式打分器:把这个表示与每个选项自己的最终隐状态作比较。两者都允许选项互相影响。API 最多接受 255 个选项(2⁸ − 1),这正好配一个固定 256 槽的头 —— 但这个上限是请求校验挡出来的,不是模型本身的。在 200 个选项下,一个被复制过去的答案在每个位置都得到 1.00,而且错误没有溢到相邻选项上,这更像指针。两个结果都还不是决定性的。26
注入的假选项从来没顶掉过真选项,所以选项边界是用某种文本伪造不出来的方式标出的;一个条件在列表别处被重复的选项,其概率会被对手分走。23
这个取舍在普通任务上也看得见:把选项顺序倒过来,一个技术支持分类的概率从大约 0.84–0.89 挪到了 0.93–0.96。数据来自 option_order 探测。9 对一个已上线的决策策略来说,这不是小事:阈值卡在 0.9 附近时,标签和证据完全没变,动作却可能改变。 任何这套设计的实现,评测里都该有排列测试。
5. 先训练分布,再计算置信度
第五个组件是训练目标。直接输出数值省掉了生成的工作,但便宜的概率仍然可能是坏的概率。
设想一批案例,每个都被赋予了「紧急」的 0.8 概率。校准要问的是:这些案例里真的有大约 80% 紧急吗。它是跨案例的性质。我们无法从「这一个个案后来结果不错」来判断「这一个预测是否校准」。
TypeSafe 把自己的训练方法叫作 Reinforcement Learning for Calibrated Decisions,简称 RLCD。公告说它优化的目标是「在 System One 任务上给出认识论上诚实的概率」;公司的入门材料把 RLCD 呈现为一条从预训练语言模型出发的后期训练路径。112 确切的配方没有公开。我设想的训练配方是:用一个基于结果的目标函数,让 transformer 和读出层去适配带类型的决策任务。这给了骨干一个机会,去构造对可靠决策有用的表示,而不只是流利的续写。
一个自然的目标函数是 log loss,即观测结果 的 。另一个是 Brier loss,即预测分布与观测到的一热结果之间的平方距离。两者都是恰当评分规则:在期望意义下,如实报告真实的条件分布能使损失最小。Gneiting 和 Raftery 给出了形式定义与理论。13 这解释了这类训练想要达到什么。它不能确定 TypeSafe 用的是哪个损失、它的流程在狭义的算法意义上算不算强化学习、或者骨干的每一个权重是否都被更新过。
「恰当」也不是上线保证。有限的数据、模型的局限、优化误差、分布漂移,都会让校准不完美。Guo 等人既展示了现代神经网络的校准问题,也展示了事后校正的用处。训练与事后校准是可以共存的两种机制;API 分不出各自贡献了多少。14
观测证据。 基准记录让我们可以把预测概率和实测正确率作比较,既看总量也看概率分箱内部。图 5 就是这些检查。仅总量吻合比箱内吻合弱得多:一组过度自信可以被另一组自信不足抵消掉。在 1,200 题的 MMLU 样本上,十分箱的期望校准误差是 0.0313(分箱定义与逐题预测)。大多数预测都挤在接近确定的位置:990 条落在 0.9–1.0 这一箱。15
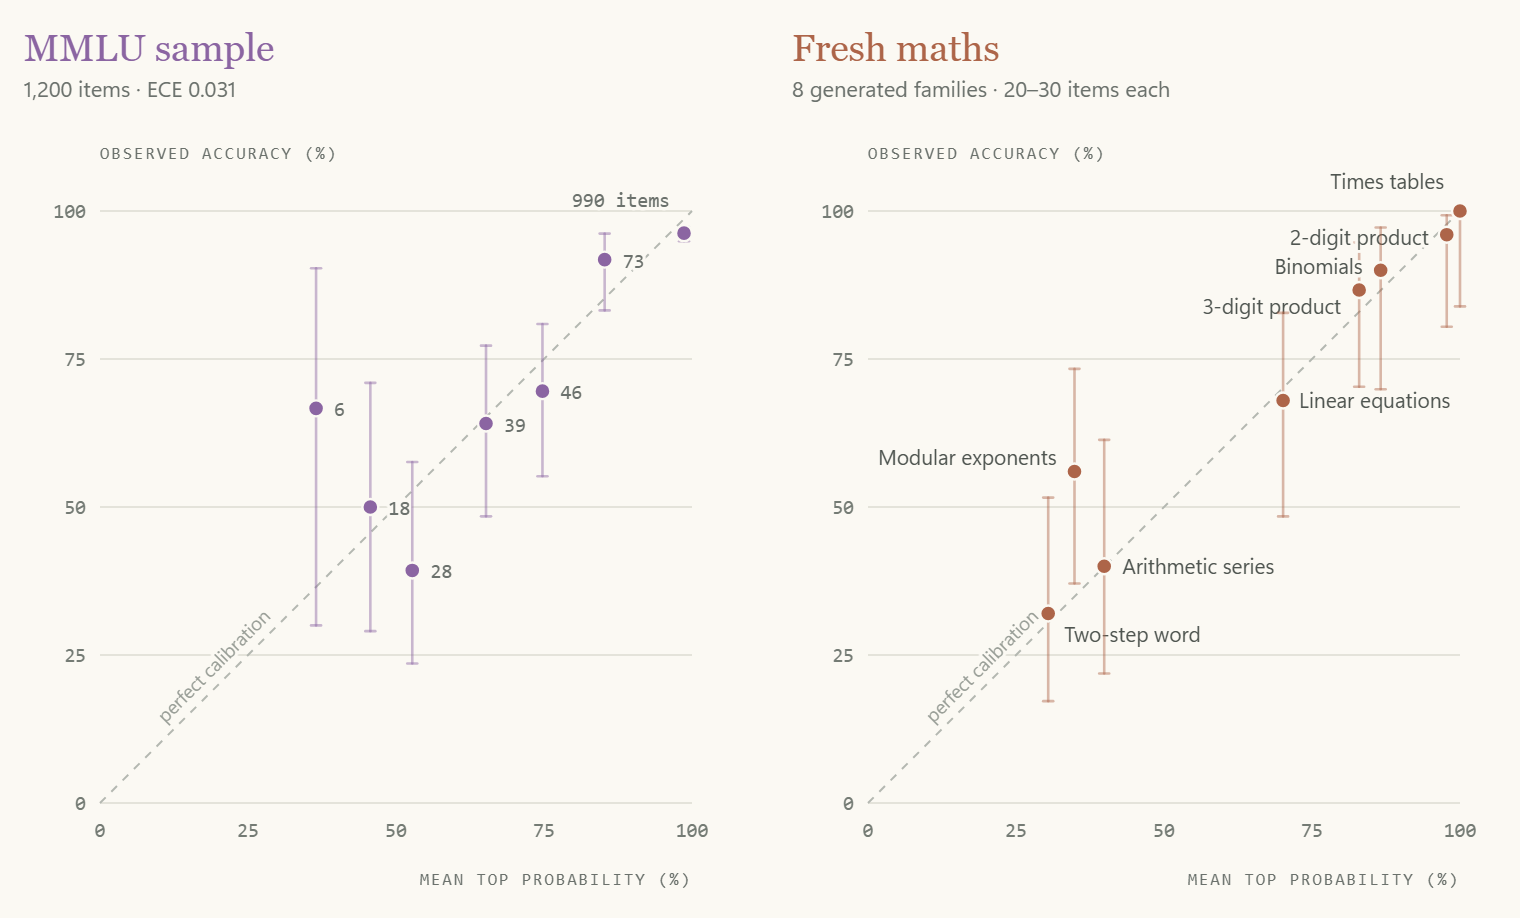
这个新做的数学小题研究提供了有用的变化。在生成的三位数乘法上,正确率 86.7%,平均最高概率 0.83;在两步骤应用题上,正确率掉到 32%,平均最高概率掉到 0.30。模型在更难的任务上更没把握(fresh_math_results,30 道乘法题加 25 道应用题)。15 这很让人鼓舞,不过小的类别级均值无法确立「对每一种没见过的问题都校准」。
这些结果也说明了为什么公开基准分数是「模型知道多少」的一个不完美的度量。MMLU-Pro 正确率是 84.6%;新生成的应用题要难得多。15 任务结构、干扰项、难度、训练曝光的差别都可能起作用。这个落差不能证明基准污染。 换了措辞,也不等于底下的数学能力或事实知识就没见过。
关于 API 里那个名叫 confidence 的字段,还有一条独立且异常清楚的发现。官方适配器对 的 Choice 置信度,是从归一化分布这么算的:
三个选项、最大概率 0.8 时,这个式子给出 0.7。适配器对只有一个选项的情况另作处理,返回 1。它度量的是领先答案比均匀分布高出多少。它不是另一个「这个答案是对的」的学习估计。Score 类型用的是另一个公式,反映的是离众数档位的距离。16
在这个设想里,训练产出的是预测分布,而这个汇总字段是普通算术算出来的。把这两个东西分开,能避免一个常见的概念错误:一个很集中的分布仍然可以自信地错。
6. 稀疏容量
我预计 Jev 用的是稀疏专家混合(MoE)transformer。在选定的层里,一个路由器把每个 token 送进一小部分前馈网络,于是模型可以存下很多参数,而每个 token 只激活其中一部分:这就是 Shazeer 等人的稀疏门控 MoE 层所展示的条件计算思想。17
从外面观测不到稀疏专家,但它很可能是被选中的。一个只做 prefill 的模型受算力限制,而稀疏路由省下的正是算力。MoE 通常的服务开销在这里大多消失了:没有逐 token 解码(那种场景下显存带宽是瓶颈,而且大多数专家最终都被激活),也没有长期存活的 KV cache 去和专家权重抢显存。测量也指向同一边。Jev 处理约 30k token 用了大约 160 ms;一个稠密 70B 模型在 8×H100 节点上大约需要一秒,而一个激活参数约 10B 的 MoE 正好放得下。而且近期最强的底座模型大多是 MoE(DeepSeek-V3、Qwen3、GLM-4.5、Kimi K2、gpt-oss)。专用硬件有可能让稠密模型达到同样的速度,基准分数也可能高估了模型实际掌握的知识量,所以这仍然是一个推断,不是测量。615
这套重构里没有别的东西依赖它。换成稠密 transformer,接口、共享 state、隔离分支和读出方式都还是原样。
7. 把分支当批处理,而不是当对话
最后一个组件是服务引擎:它把问题分支当作独立的工作项。它们的后缀可以和共享 state 的表示一起打包成批。应用代码再把数值输出与问题标识符对应起来,序列化响应。
测量显示,重复的相同答案之间存在细小差异,包括同一次请求内的重复问题之间。这意味着不应假定 API 层是确定性的(noise、dup 和 determinism)。19 这并不意味着模型在生成或采样文本:数值内核、动态批处理、路由,或者刻意的随机性,都能影响一次直接读出。
响应键的顺序也在少数几种模式里变化过。19 多个哈希顺序不同的 worker 是个合理的解释。不过这条侧信道既不能确定 worker 数量,也不能确定 KV cache 存在哪里,或者用了哪种数值精度。这些是实现细节,现有观测解决不了。
对这个设想的架构来说,重要的是答案之间没有依赖链。模型不需要先写完队列分类再开始估紧急度。两者都依赖 state,谁也不用消费对方生成的答案。
依赖的上限仍然存在。如果后面某个问题真的需要前面的答案,应用就必须引入另一个决策阶段,或者把联合决策表达成一个问题。共享上下文并不会消除工作流的逻辑结构。
什么能推翻我
这套重构里的各个承诺,性质并不一样。直接输出概率是公开描述过的。问题隔离和选项顺序效应是可观测的行为。KV 共享、因果注意力、末位或指针式读出、稀疏专家,则是越来越具体的解释。
参考卡实验解决了一个问题:决策能用上放在最后的选项。假选项测试说明,输入格式上的花招伪造不出选项边界。更广的关系型任务可以把表示约束得更紧,不过仅凭行为上的成功,仍然无法唯一确定注意力掩码。
在选项处理上,随机化的跟进实验复现了选项集合效应,但「固定描述长度」那个干预仍然不确定。更多模板和独立请求区组,可以把「共享温度变化」和「依赖内容的交互」区分开。一个难度中等的 200 选项任务,可以把槽位头和指针式打分器分开。在校准方面,留出的工作流数据和漂移下的重复评测,比再多一个总量基准分数更有价值。要确认稀疏专家,大概需要公开披露,或者这个 API 之外的证据。
我对 Jev 最好的重构仍然是开头那张图:一个因果 transformer,共享 state 作前缀,问题后缀彼此隔离,选项按列表处理,带类型的数值读出,训练指向预测分布。稀疏专家是最可能的骨干,但设计里其余部分都不依赖它。
它的用处来自计算图与任务相匹配。决策服务需要读取证据、比较允许的结果、并暴露不确定性。transformer 能做到这些,而不必先把每个决策变成一句话。
方法
本文基于 2026 年 9 月 17 日对 jev-1.13.0 的一次调查,使用一个早期访问账号、观测到一个服务区域。原始研究包含 1,029 条带探针的记录(其中含 190 道生成数学题)、6,800 条基准记录,以及若干独立的事实核查。跟进研究又增加了 146 次关系型与选项交互请求(trials、summary)、311 次 token 计费请求、445 次分词器指纹请求、192 次延迟请求、148 次选项数延迟请求、181 次选项位置请求、105 次假选项请求和 35 次上下文上限请求。每一组都在参考文献里有链接,附确切的请求与脱敏后的响应。重复的基准配置共享底层题目;这些计数不是独立问题的数量。
可下载的证据包记录了本文用到的观测。开头一节的 API 示例是示意性的。引用的 visibility 与参考卡提示词来自探针脚本和保存下来的跟进请求。数值观测只对这个模型版本和这一次测试成立。
延迟数字来自 x-envoy-upstream-service-time 响应头。它们是上游服务的耗时,排除了具体的排队与执行边界,是上游服务的耗时而不是孤立的模型计时。延迟图里的扫描是一次一个请求、乱序执行的;没有任何一项研究控制了服务器负载。本地墙钟测量没有被当作架构证据。
概率通常以两位小数返回。同一次请求里的重复问题共享条件,误差可能相关。MMLU 校准图用的是十个等宽箱:[0, 0.1)、[0.1, 0.2),依此类推,1.0 归入最后一箱。期望校准误差是每个箱内「正确率与平均最高概率之差的绝对值」按样本量加权。估计值取决于样本选择、分箱方式和响应舍入。证据支持的是关于被测分布的论断,而不是对将来任意客户工作流的校准保证。
来源与相关工作
实验类参考文献标出了原始的脚本 tag,好让每条观测都能在证据包里定位。论文引用确立的是所提机制及其先例;它们不证明 Jev 用了它们。
来源
- TypeSafe(2026)。Introducing System One Models and Jev。关于「并行输出」的说法与所声明的 RLCD 目标的第一手来源。
- TypeSafe。完整 API 文档,访问于 2026 年 9 月 17 日。带类型的问题、响应分布与 API 契约。
- Vaswani 等(2017)。Attention Is All You Need。解码器掩码、注意力,以及线性/softmax 输出层。
- API 实验:type_preamble 与 outputs。token 计费的可加性、标识符变化,以及 255 选项的响应。
- API 实验:visibility。密码分别放在兄弟问题里、从兄弟问题中移除、以及放在 state 中,各重复五次。
- 延迟扫描(192 次顺序请求)。state 长度与问题数,各 8 次乱序重复;服务端上报的上游耗时。
- Juravsky 等(2024)。Hydragen: High-Throughput LLM Inference with Shared Prefixes。
- Yao 等(2024)。DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference。
- API 实验:option_order。普通工单的场景下的选项顺序敏感性。
- API 实验:iia。每种条件三次请求,每次含四十个重复问题;原始、追加和前置的选项集合。
- Reddy 等(2024)。FIRST: Faster Improved Listwise Reranking with Single Token Decoding。
- TypeSafe。机器学习入门材料。关于 RLCD 后期训练路径与校准契约的第一手描述。
- Gneiting 与 Raftery(2007)。Strictly Proper Scoring Rules, Prediction, and Estimation。Journal of the American Statistical Association 102(477):359–378。
- Guo 等(2017)。On Calibration of Modern Neural Networks。
- 基准与生成数学题记录:正确率与平均预测概率。 ;MMLU 可靠性分析:分箱定义、ECE、Wilson 区间与 1,200 条逐题预测。
- TypeSafe。官方 Python 适配器 confidence_metrics.py,revision fb52b103。Choice 与 Score 的置信度公式(阅读于 2026 年 9 月 17 日)。
- Shazeer 等(2017)。Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer。
- 分词器指纹实验(445 次请求)。游程、词表与预分词探针,与 192 个公开分词器对比。
- API 实验:noise、dup 与 determinism。重复的概率值与响应键顺序。
- 跟进关系实验(96 次请求)。两个模板、两个参考值、六种排列、两个位置、两次重复;附确切请求与脱敏响应。
- 跟进选项交互实验(50 次请求)。十个随机区组,含 base4、null4、append5、replace5 和 null5;配对变化与标准误。
- 上下文上限实验(35 次顺序请求)。单分支与整请求的 token 上限,附被接受和被拒绝的边界用例。
- 假选项注入实验(105 次请求)。七种分隔符格式、饱和与有歧义的基线任务,以及完整概率向量。
- token 计费实验(311 次请求)。问题 ID 长度、批大小、state 难度、词 ID,以及 state 与 ID 字符串的配对。
- 选项数延迟实验(148 次请求)。1 个或 20 个问题,各配 2–200 个选项,长短标签,外加输入/输出解耦对照。
- 选项位置实验(181 次请求)。选项数上限,正确答案在 10、50、200 和 255 选项列表中移动。
出处: Jev’s Architecture Unmasked —— Archer,archerhume.com,2026 年 9 月 17 日。