L’architecture de Jev démasquée
J’ai sondé Jev avec 10,000 appels à l’API pour déduire à peu près comment il est construit, et pourquoi la plupart des analyses d’arnaqueurs sur X sont complètement fausses. X est plein d’avis à chaud sur le lancement de Jev, et la plupart passent complètement à côté : « 12 millions de vues pour un classifieur JSON ? Ouais, on est dans une bulle. » Un LLM ordinaire génère « sûr à 90% » sous forme de texte ; sa probabilité de produire ces mots n’établit pas une probabilité de 90% d’avoir raison. Pourtant nous bâtissons la détection de fraude, la modération, le routage et l’évaluation des risques autour de précisément ce schéma : payer une génération jeton par jeton, puis traiter une affirmation de confiance non validée comme une probabilité sur laquelle notre logiciel peut agir.
La proposition de Jev est de conserver les connaissances d’un LLM préentraîné tout en remplaçant les affirmations de confiance générées par des probabilités de décision lues directement dans ses représentations internes. Ces probabilités sont entraînées contre des résultats. Donne-lui un état, des questions et des réponses autorisées partagés ; il renvoie les distributions en parallèle, sans générer de texte.1 Pour toute cette classe d’applications, cela résout les deux problèmes : la fiabilité du signal de décision et le calcul inutile dépensé à le produire.
Il n’y a qu’un seul problème : il n’est pas à poids ouverts, et TypeSafe refuse de partager ses recherches… Donc je vais le faire (au mieux).
Les preuves pointent vers un transformer causal (probablement avec un MoE creux) réaffecté aux décisions : encodage d’état partagé, branches de questions isolées, et lectures directes de probabilité au lieu d’une génération de texte. Après avoir sondé l’API TypeSafe (en cherchant des signatures dans la mise à l’échelle de la latence selon la longueur du contexte, la réorganisation des questions, etc.), passé au peigne fin toute la documentation et la recherche publiques avec Astra, et cherché des travaux antérieurs, je pense avoir un modèle assez précis de son fonctionnement et de son architecture.
La colonne vertébrale creuse est la partie la moins certaine, mais elle est particulièrement bénéfique pour ce domaine avec moins d’inconvénients que les LLM autorégressifs, donc ce serait étrange que ce ne soit pas le cas. Le calcul partagé et les sorties directes de probabilité sont bien mieux étayés, évidemment. Tout cela est clairement assez spéculatif, donc je vais essayer d’être aussi clair que possible sur ce que TypeSafe a publié comme preuves, ce qui a été observé dans les expériences, et ce qui en est inféré. Les API de boîte noire rendent incroyablement facile de jeter un voile sur le fantôme et d’obtenir une forme approximative de l’architecture.
Pourquoi cette conception est utile
Considère une requête schématique de routage de support. Elle illustre la structure de l’API ; les probabilités d’exemple ci-dessous sont inventées.
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}
Une réponse utile pourrait attribuer à payments une probabilité de 0.91 tandis qu’elle n’attribuerait qu’une probabilité de 0.42 à l’escalade urgente. Ce sont des incertitudes différentes. Le logiciel peut router le ticket automatiquement tout en laissant l’escalade à une politique distincte.
Un transformer causal sait déjà construire une représentation d’un texte de gauche à droite. Pendant l’inférence ordinaire d’un modèle de langage, il traite le prompt, prédit un jeton, réinjecte ce jeton, et recommence. Cela s’appuie sur l’attention du décodeur et la projection de sortie introduites dans le Transformer original.3 Mais l’étape de traitement du prompt a déjà produit une représentation riche. Si la tâche consiste à choisir parmi trois files, nous pouvons attacher une petite fonction qui projette cette représentation directement sur trois nombres.
Un détail ici dissipe une bonne partie de la confusion sur les réponses parallèles : l’attention causale décrit quelles positions peuvent utiliser quelle information, pas l’ordre dans lequel les jetons d’entrée doivent être exécutés. Pendant le traitement du prompt, ou prefill, tous les jetons d’entrée sont déjà connus. Le modèle peut traiter leurs positions ensemble dans une couche tandis que le masque d’attention bloque l’accès aux positions suivantes ; les couches s’exécutent toujours séquentiellement. Le décodage autorégressif ajoute une autre dépendance : le jeton suivant n’existe pas tant que la prédiction précédente n’a pas été choisie. Notre modèle proposé se termine après le prefill et la lecture, il évite donc cette dépendance jeton par jeton.
Cela change la forme computationnelle de la tâche. La sortie n’a plus besoin d’une séquence de décisions d’épellation pour "payments": 0.91. Le formatage JSON se fait dans du code d’application ordinaire. Le réseau de neurones fournit les probabilités.
Supposons maintenant que l’état est un long rapport d’incident, et qu’il y a cinquante questions. La majeure partie de l’entrée est partagée. Un transformer stocke l’information intermédiaire sur les jetons traités dans son cache clé–valeur, habituellement abrégé en cache KV. Dans la conception proposée, chaque question lit le même cache d’état. Chaque branche n’ajoute que ses propres instructions et options de réponse.
Pour un état de jetons et questions, des requêtes séparées traiteraient l’état environ fois. Le partager réduit le traitement répété des jetons d’état de à . Les questions doivent toujours prêter attention à l’état ; ce travail ne disparaît pas. Mais le modèle n’a pas besoin de reconstruire sans cesse les représentations de l’état.
L’isolation donne aussi un sens utile à l’interface. Demander si le client est en colère ne devrait pas changer quelle file reçoit le ticket. Les deux questions peuvent inspecter les mêmes preuves sans lire les instructions de l’autre. Les branches n’ont aucune dépendance computationnelle entre elles, même quand leurs réponses sont statistiquement liées.
Enfin, les probabilités rendent explicite la politique en aval. Si une escalade inutile coûte une unité et un cas urgent manqué en coûte neuf, une règle de décision simplifiée escalade quand . Ce calcul n’a de sens que dans la mesure où les probabilités sont fiables pour ce flux de travail. Entraîner et évaluer la distribution de probabilité fait donc partie du produit, plutôt que d’être un champ de confiance purement cosmétique.
Rien de tout cela ne nécessite de diffusion. La classification en parallèle existe depuis des décennies. La combinaison intéressante est un transformer largement capable, un calcul contextuel partagé, une interface de sortie typée, et un entraînement qui récompense une incertitude utile.
1. Terminer l’inférence par une lecture
Le premier composant est le plus simple : une tête de prédiction au lieu d’une boucle de décodage.
Preuves publiées. L’annonce de lancement de TypeSafe dit : « Jev produit toutes les probabilités en parallèle au lieu de les générer autorégressivement jeton par jeton. » Sa documentation expose des choix finis, des décisions oui/non et des scores ordonnés. Ceux-ci se représentent naturellement par des sorties numériques fixes.12
Preuves observées. L’API rapporte encore un champ output_tokens, qui sonne comme un enregistrement de génération. Ce n’en est pas un. Pour les questions oui/non, le compte tombe exactement juste : 4 jetons partagés, plus 15 par réponse, plus la longueur en jetons de l’identifiant de chaque question. La documentation de TypeSafe dit que cet identifiant « n’est pas envoyé au modèle sous-jacent et n’est pas utilisé dans l’inférence ». Un compte qui varie avec du texte que le modèle ne voit jamais est calculé après l’inférence, à partir de la réponse sérialisée. Les valeurs renvoyées ne l’affectent pas non plus : une réponse de 0.0 coûte autant qu’une de 0.01, alors que chaque chiffre compte sinon comme un jeton.224
Le tokenizer derrière le compte ne correspond à aucun des 192 tokenizers publics que nous avons testés. Il correspond en revanche au propre compteur d’entrée de Jev pour le texte ordinaire, ne différant que sur les longues séquences d’espaces et de ponctuation. output_tokens est un chiffre de facturation. Il ne nous dit rien sur la question de savoir si Jev génère du texte, et ne mesurerait pas ce texte même s’il le faisait. La latence ne suit pas ce chiffre non plus : une question avec 200 options (1,911 jetons de sortie) est revenue aussi vite qu’une avec deux, et le temps serveur n’a cru qu’avec la longueur de l’entrée.2425
Une réponse à 255 options a rapporté 2,714 jetons de sortie.4 Ce serait une erreur de diviser ce nombre par la durée de la requête et d’appeler le résultat vitesse de décodage du modèle. Un serveur peut sérialiser des milliers de caractères après une seule évaluation du modèle. Le champ de comptabilité ne nous dit pas combien d’étapes neuronales de décodage ont eu lieu.
La lecture proposée prend un dernier vecteur caché et produit des logits :
Ici est le nombre de réponses autorisées. La matrice convertit une représentation en scores de réponse ; le softmax transforme ces scores en une distribution. Pour une décision oui/non, un scalaire et une sigmoïde suffiraient.
Les classes n’ont pas besoin d’être des concepts fixes comme « payments ». Elles peuvent être des emplacements d’options : première option, deuxième option, troisième option. La branche fournit le sens de chaque emplacement ; le code d’application renvoie sa probabilité vers la clé d’option de l’appelant. Un Score ordonné peut de même prédire des probabilités sur des niveaux et renvoyer leur moyenne pondérée par les probabilités. Cela prend en charge de nouvelles décisions sans entraîner une nouvelle tête pour les étiquettes de chaque client. Un scorer de style pointeur, comparé à la section 4, est la principale alternative : il note la représentation propre de chaque option plutôt qu’un emplacement numéroté.
Cela n’établit pas que Jev a un module classifieur nommé séparément. La tête de vocabulaire d’un modèle de langage est elle aussi une matrice suivie d’un softmax. Sélectionner lignes d’étiquettes réservées dans cette matrice peut mettre en œuvre le même calcul qu’une tête dédiée à classes. Les lignes peuvent être liées aux embeddings d’entrée ou entraînées indépendamment ; nous ne pouvons pas distinguer ces agencements ici.
La distinction importante est entre lire des probabilités et générer du texte qui décrit des probabilités. Un « 91% » généré est une séquence de jetons. Le 0.91 d’un classifieur est une entrée de sa distribution prédictive. L’un comme l’autre peut être mal calibré. Ni l’un ni l’autre ne devient digne de confiance uniquement à cause de son format.
Le décodage de texte contraint reste un moyen possible de construire une interface similaire, mais TypeSafe décrit explicitement un chemin de sortie différent. Sa déclaration est une preuve plus solide qu’un argument de latence. Les preuves pointent vers une lecture numérique directe, l’une des deux conceptions comparées à la section 4. Les jetons d’étiquettes réservés restent possibles, bien que le test d’options fausses de cette section plaide contre eux.
2. Partager l’état, isoler les questions
La décision suivante concerne l’endroit où le calcul est réutilisé.
Preuves observées. La comptabilité des jetons est exactement additive dans les petits exemples contrôlés. Une question oui/non minimale a utilisé 268 jetons d’entrée ; deux en ont utilisé 276. Une requête contenant une question oui/non, un Choice à deux options et un Score à deux niveaux a utilisé 318, ce qui correspond à la somme de leurs contributions mesurées au-dessus des frais partagés. Cela correspond à un préfixe commun suivi de suffixes de question, bien que la comptabilité seule n’identifie pas un graphe computationnel.4
Une expérience plus informative déplace des preuves entre ces régions. L’état disait initialement :
The weather is nice today and the park is full of people.Une question sœur contenait :
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
La sonde demandait quel code mentionnait une autre question, avec ZEBRA-7741, deux distracteurs et none comme choix. Avec le secret dans la question sœur, sa probabilité rapportée était de 0.00. Retirer cette question sœur a produit le même résultat. Mettre la déclaration dans l’état à la place l’a élevée à 0.90–0.92. C’était cinq répétitions par condition (visibility dans les enregistrements des sondes).5
C’est une intervention utile : déplacer la déclaration à travers une frontière de l’API change son effet. Cela étaye une isolation comportementale entre les questions et l’accès à l’état partagé. Cela n’expose pas le masque d’attention exact. Des appels distincts au modèle, un masque en arbre, ou un autre mécanisme qui restreint le flux d’information pourraient produire le même résultat. La formulation de la sonde demande aussi à propos d’« une autre question » même dans la condition d’état, ce n’est donc pas un test pur de suivi littéral d’instructions.
Les mesures de service ajoutent une pièce. Jusqu’à environ 100 questions, le temps serveur n’a presque pas changé. Au-delà, il a augmenté régulièrement, et jeton pour jeton, le texte des questions a coûté environ deux fois plus que l’état. Cela est cohérent avec le fait de calculer l’état une fois et de grouper le travail des questions.6
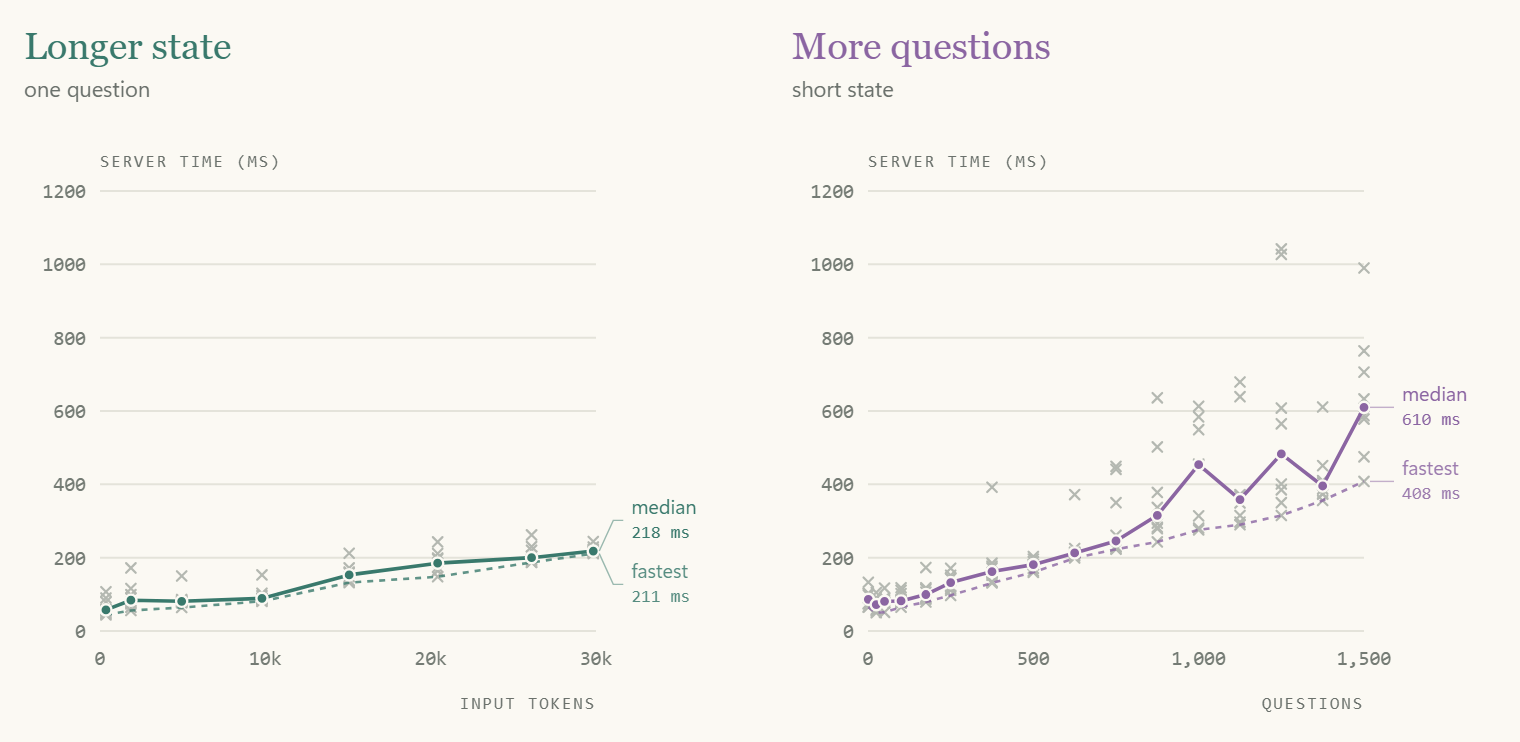
Ce sont des durées amont rapportées par le serveur, pas des chronométrages d’un ordinateur portable local. Elles incluent tout travail et toute attente que le service amont inclut, et le service était partagé avec d’autres utilisateurs.
Jev impose deux limites. Chaque branche (l’état plus une question) est plafonnée à environ 32,768 jetons, et la requête entière à environ 65,536. La limite de requête compte l’état une seule fois : un état de 23k jetons avec 5,000 questions tient dedans. Si chaque question traitait sa propre copie de l’état, cette requête dépasserait 100 millions de jetons. La paire tient dans une seule séquence empaquetée allant jusqu’à 2¹⁶ jetons, contenant l’état une fois et chaque question ensuite, chaque branche étant limitée à une fenêtre de contexte de 2¹⁵.22
Un cache KV de préfixe avec des suffixes causaux séparés est l’implémentation naturelle. Hydragen décrit une attention efficace pour des séquences partageant un préfixe ; DeFT développe une attention pour l’inférence structurée en arbre. Ces travaux établissent que le schéma de service est praticable. Ils constituent des travaux antérieurs, pas la preuve que TypeSafe utilise l’une ou l’autre bibliothèque.78
Cette conception éclaircit aussi une contradiction apparente : des questions isolées peuvent encore être évaluées ensemble sur le même accélérateur. « Parallèle » décrit leur ordonnancement et l’absence de dépendances entre réponses. Cela ne signifie pas nécessairement un GPU par question.
3. Une colonne vertébrale causale
Les expériences ne peuvent pas distinguer un décodeur causal d’un encodeur bidirectionnel : dans les deux, la décision finale peut lire toute l’entrée. Je suppose quand même un décodeur causal, pour une bonne raison. L’étendue des connaissances de Jev (84.6% sur MMLU-Pro) exige un préentraînement à l’échelle de la frontière, tout modèle à cette échelle est un décodeur causal, et TypeSafe décrit RLCD comme le post-entraînement d’un modèle de langage préentraîné. Un Jev bidirectionnel signifierait soit une base bien plus faible, soit convertir un décodeur à un coût supplémentaire, tout en renonçant à la mise en cache par préfixe partagé qu’offre le service causal. Ce serait surprenant, mais on ne peut pas l’écarter de l’extérieur.1215
Quel modèle préentraîné c’est, on l’ignore, et le tokenizer n’en révèle aucun. Les comptes de jetons de Jev ne correspondent à aucun des 192 tokenizers publics que nous avons testés sur 415 sondes. Il sépare chaque chiffre individuellement et cherche des morceaux entiers avant de fusionner : 8 a comptent comme un jeton, mais 16 comptent comme quatre. Son vocabulaire suit de près l’o200k d’OpenAI, puisque chaque chaîne que Jev compte comme un seul jeton est aussi un seul jeton o200k, mais la séparation des chiffres et plusieurs fusions écartent o200k lui-même. La correspondance publique la plus proche, Qwen, concorde sur 348 des 415 sondes. Cela écarte un tokenizer public inchangé, pas un modèle de base public : un vocabulaire remplacé, un préentraînement continué ou une distillation pourraient chacun l’expliquer, tout comme une API qui compte les jetons différemment du modèle.18
Les expériences montrent en revanche ce que la décision peut lire. J’ai placé une carte de référence parmi les options d’une question et demandé à Jev de choisir l’option dont la condition est satisfaite par la carte. Voici un ensemble exact d’options :
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.
L’instruction était : « Lis la carte de référence et sélectionne l’unique option dont la condition est satisfaite. » Changer la valeur de référence pour indigo commute la bonne réponse tout en laissant les options sélectionnables inchangées.
J’ai testé les deux valeurs, les six permutations d’options, et un second gabarit utilisant route = east/west, avec deux répétitions. Un contrôle apparié plaçait la référence dans l’état partagé à la place. Cela a donné 48 essais avec référence dans les options et 48 contrôles avec référence dans l’état.20
| Position de l’option de référence | Réponses correctes |
|---|---|
| Première | 12 / 16 |
| Milieu | 11 / 16 |
| Dernière | 16 / 16 |
| Référence déplacée dans l’état | 48 / 48 |
Jev peut utiliser une information placée après les descriptions des candidats. Avec la référence en dernier, il a sélectionné la bonne option à chaque essai, avec une probabilité moyenne de bonne réponse d’environ 0.88.
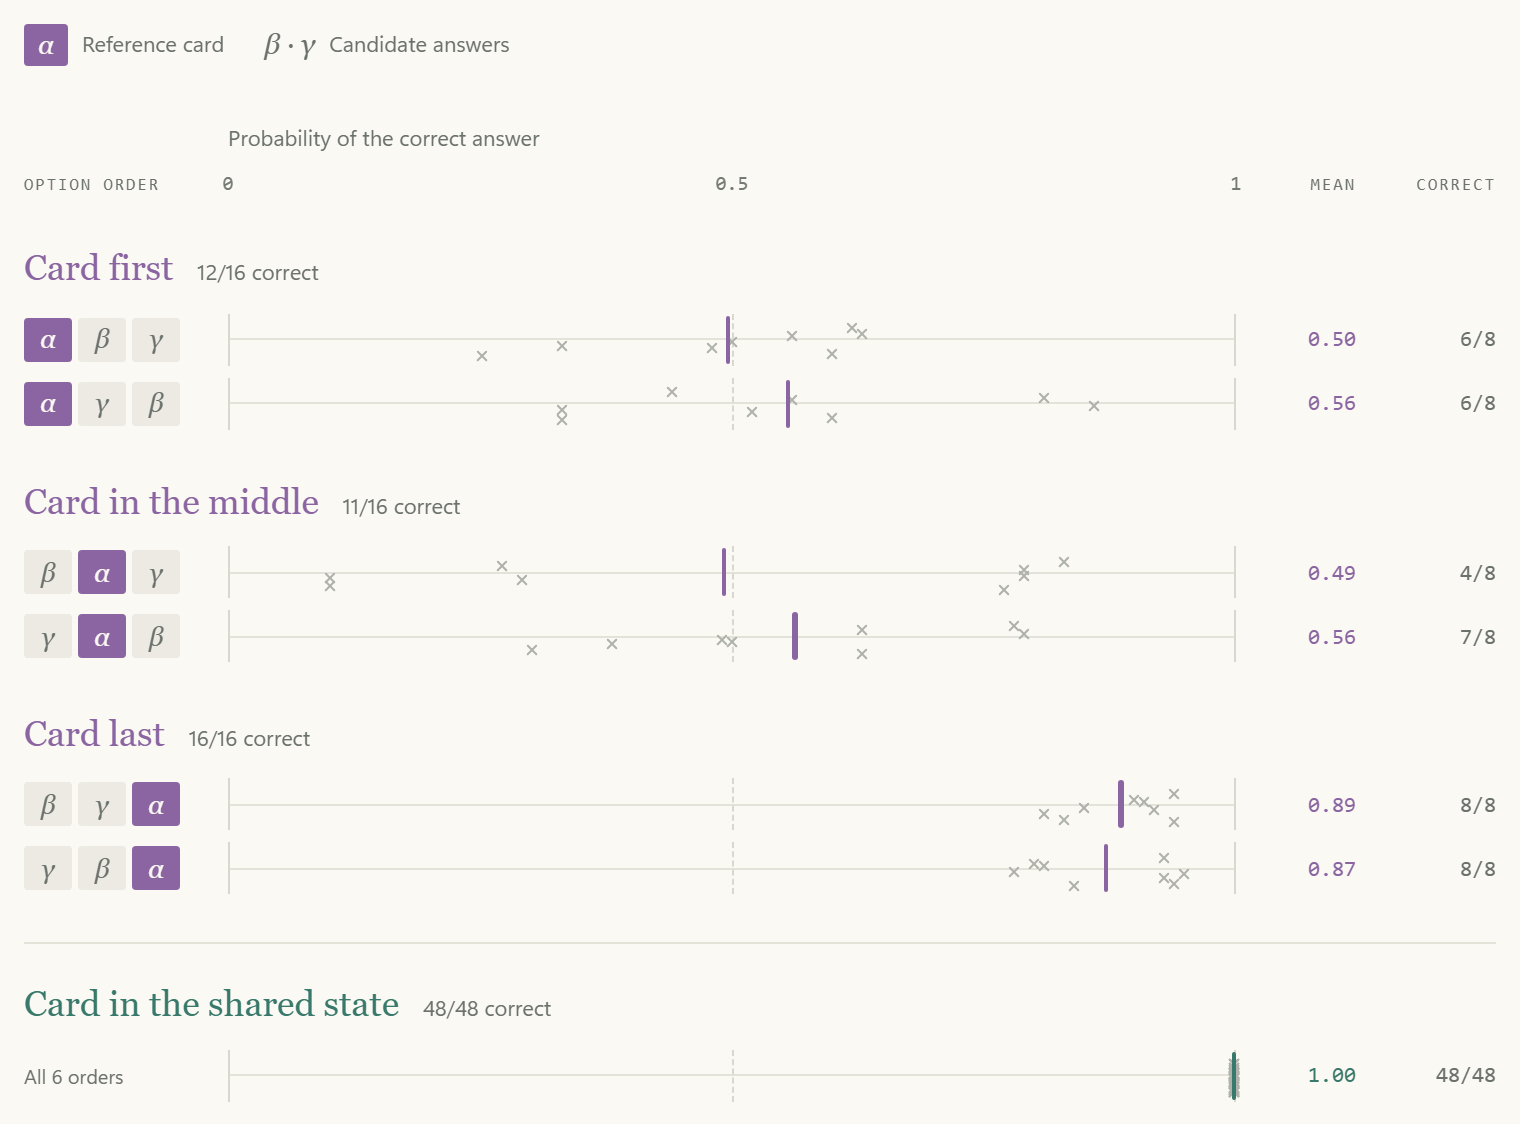
Le contrôle de changement de valeur compte autant que la position. Avec la carte en dernier, changer uniquement amber pour indigo change quelle option antérieure gagne, alors que ces descriptions antérieures et l’état restent identiques. Un modèle qui note indépendamment chaque option à partir de son propre texte et de l’état, puis normalise simplement les scores, n’a aucune voie par laquelle ce fait pourrait changer le classement relatif des options antérieures. Les résultats étayent un chemin par lequel les options influencent la décision conjointe.20
Cela correspond à toute lecture calculée après la liste complète, y compris les deux conceptions comparées à la section 4, ainsi qu’à une étape distincte de mélange des options. Les erreurs restantes montrent un traitement sensible à la position sur ces deux gabarits ; elles n’identifient pas une cause unique.
La diffusion est inutile pour ce calcul, et rien dans ces expériences n’exige un débruitage itératif. L’inférence architecturale défendable est plus étroite : le calcul de la réponse a accès à la liste complète des options. L’expérience suivante teste s’il utilise réellement ce contexte conjoint.
4. Laisser les options interagir avant de choisir
Au sein d’une question, les preuves pointent vers une frontière d’information différente : les alternatives sont lues ensemble comme une liste ordonnée, suivie d’une unique position de décision.
Pourquoi autoriser cette interaction ? Des options comme « aucune de ces réponses » dépendent des autres choix. Même des alternatives ordinaires peuvent clarifier une question. « Payments », « accès au compte » et « autre » définissent une décision différente de « banque », « fournisseur de paiement » et « client ». Une représentation au niveau de la liste permet au modèle d’interpréter cette distinction avant de produire la distribution.
La preuve la plus forte est une expérience avec une option supplémentaire non pertinente.
Commence avec quatre causes possibles d’un échec de paiement : bank, provider, customer, et unknown. Puis ajoute weather: Bad weather caused it. Si chaque option d’origine reçoit un logit indépendant et inchangé et que le serveur applique la même température de softmax, ajouter une cinquième option change la normalisation mais ne peut pas changer les cotes entre deux options existantes :
Le dénominateur commun s’annule. Cela nous donne une prédiction précise et falsifiable.
L’étude d’origine a trouvé un glissement d’environ +0.49 à +0.08.10 Pour vérifier si cela survivait à la variabilité ordinaire des requêtes, j’ai répété l’expérience en dix blocs randomisés. Chaque bloc comprenait la ligne de base à quatre options, un contrôle identique à quatre options, une version à cinq options avec weather ajouté, un contrôle identique à cinq options, et une version à cinq options dont la description ajoutée passait de « Bad weather caused it » à « Wild birds caused it ». Chaque requête contenait une question.21
Le résultat de l’expansion s’est reproduit. En regroupant les deux requêtes identiques de chaque condition au sein de chaque bloc, la cote logarithmique moyenne est tombée de +0.38 à +0.11. Chaque bloc a montré une baisse ; le changement moyen était de −0.28, avec un intervalle t apparié descriptif à 95% d’environ −0.36 à −0.19. Le regroupement utilise les requêtes de contrôle pour réduire le bruit ordinaire des requêtes plutôt que de traiter des sorties dupliquées comme des expériences indépendantes.21
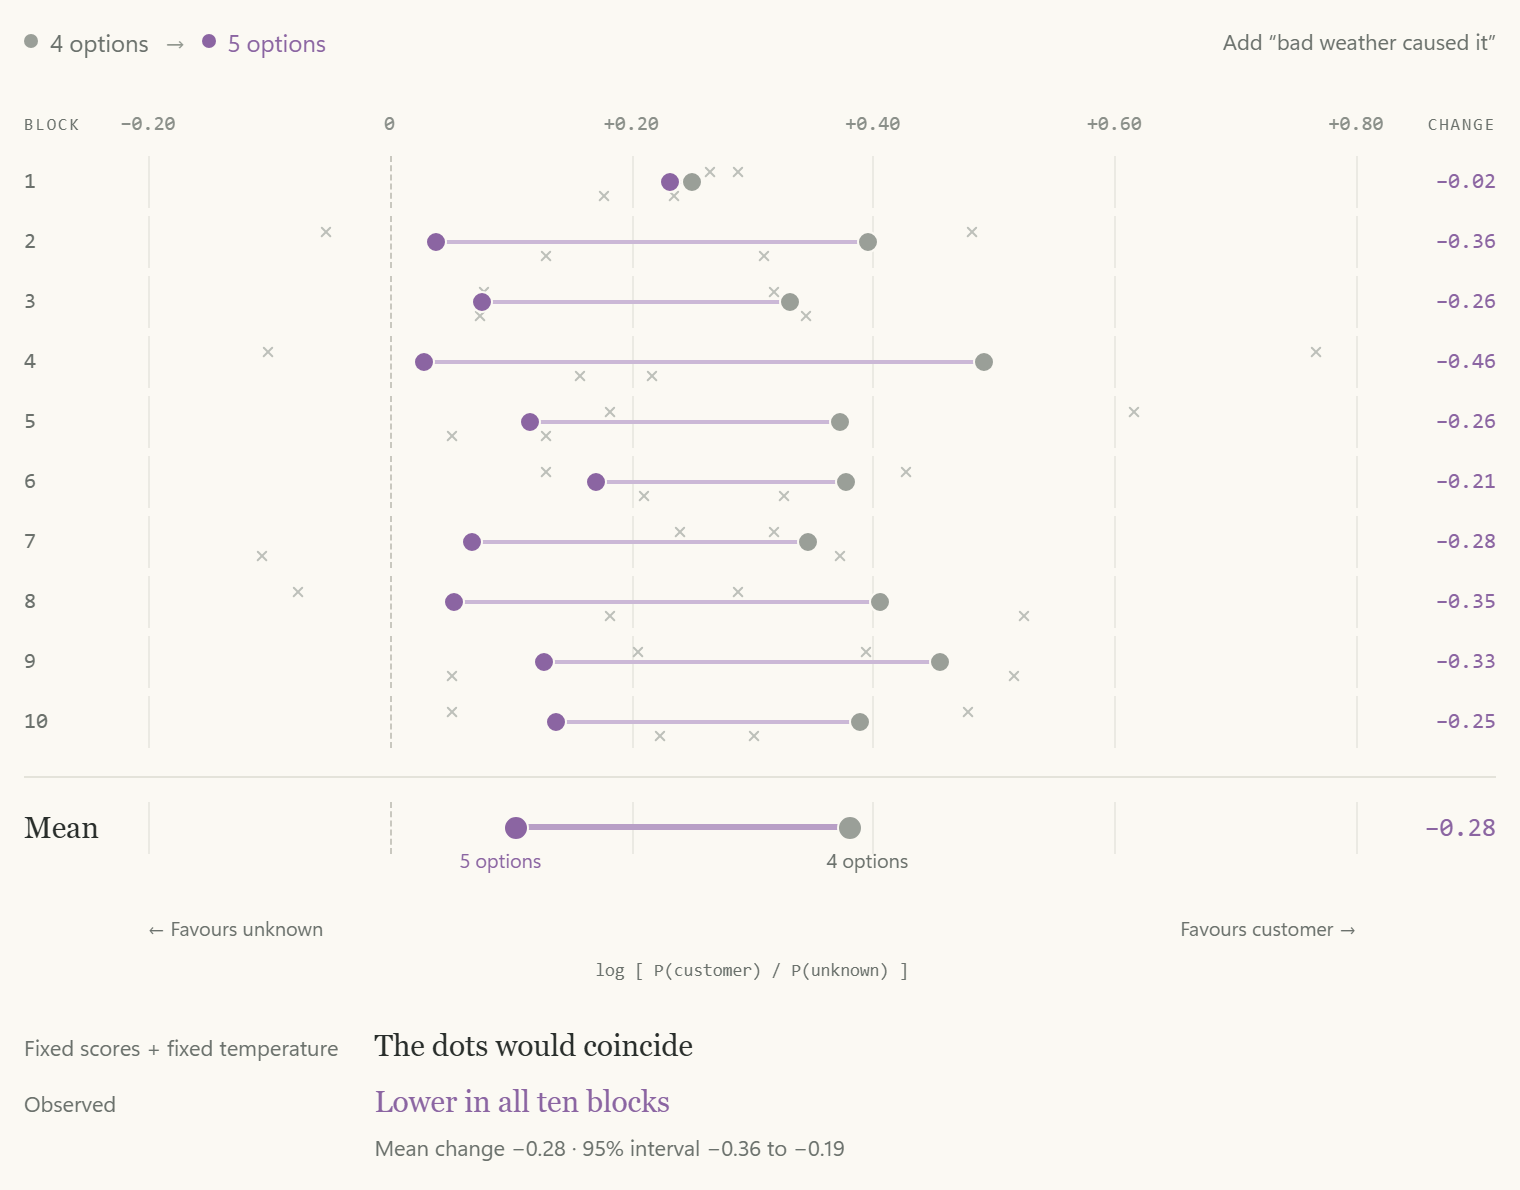
C’est une preuve contre des logits fixes et indépendants suivis d’un softmax inchangé. Cela n’identifie pas le mécanisme de façon unique. Changer la description ajoutée tout en gardant cinq options a donné un glissement plus petit et non concluant : son intervalle apparié incluait zéro. Une température dépendante de l’ensemble reste possible, aux côtés d’un mélange dépendant du contenu.
Une lecture qui voit la liste complète explique cela naturellement : ajouter une option change le contexte qu’elle lit. La méthode de classement au niveau de la liste FIRST fonctionne de la même façon, en extrayant un classement à partir des logits du premier jeton au lieu de le générer jeton par jeton.11
Deux lectures correspondent aux preuves. Une tête de position finale note chaque emplacement d’option à partir de la représentation du jeton de décision ; un scorer de style pointeur compare cette représentation à l’état caché final de chaque option. Les deux laissent les options s’influencer mutuellement. L’API accepte au maximum 255 options (2⁸ − 1), ce qui convient à une tête fixe à 256 emplacements, mais cette limite est imposée par la validation de la requête, pas par le modèle. Avec 200 options, une réponse copiée a obtenu 1.00 à toutes les positions et les erreurs n’ont pas débordé sur les options voisines, ce qui convient à un pointeur. Aucun des deux résultats n’est décisif.26
Les options fausses injectées n’ont jamais déplacé les vraies, donc les frontières entre options sont marquées d’une manière que le texte ne peut pas falsifier, et une option dont la condition est dupliquée ailleurs dans la liste perd de la probabilité face à ses rivales.23
Le compromis est aussi visible dans des tâches ordinaires : inverser les options a déplacé la probabilité d’une classification de support technique d’environ 0.84–0.89 à 0.93–0.96. Cela vient des sondes option_order.9 Pour une politique de décision déployée, cela compte. Un seuil proche de 0.9 pourrait changer l’action alors même que les étiquettes et les preuves sont identiques. Les tests de permutation appartiennent à l’évaluation de toute implémentation de cette conception.
5. Entraîner la distribution, puis calculer la confiance
Le cinquième composant est l’objectif d’entraînement. Des sorties numériques directes économisent du travail de décodage, mais une probabilité bon marché peut rester une mauvaise probabilité.
Imagine une collection de cas auxquels on attribue une probabilité de 0.8 d’être urgents. La calibration demande si environ 80% le sont vraiment. C’est une propriété des prédictions sur l’ensemble des cas. On ne peut pas déterminer si une prédiction est calibrée à partir du fait que ce cas précis se passe bien.
TypeSafe appelle sa méthode d’entraînement Reinforcement Learning for Calibrated Decisions, ou RLCD. L’annonce dit qu’il optimise « des réponses aux probabilités épistémiquement honnêtes sur les tâches System One » ; l’introduction de l’entreprise présente RLCD comme une voie de post-entraînement à partir de modèles de langage préentraînés.112 La recette exacte n’est pas publiée. Ma recette d’entraînement proposée adapte le transformer et la lecture à des tâches de décision typées à l’aide d’un objectif fondé sur les résultats. Cela donne à la colonne vertébrale l’occasion de construire des représentations utiles à des décisions fiables, et pas seulement des complétions fluides.
Un objectif naturel est la perte logarithmique, pour le résultat observé . Un autre est la perte de Brier, la distance au carré entre la distribution prédite et le résultat observé en one-hot. Les deux sont des règles de score propres : en espérance, déclarer la vraie distribution conditionnelle minimise la perte. Gneiting et Raftery donnent la définition formelle et la théorie.13 Cela explique ce qu’un tel entraînement cherche à accomplir. Cela n’établit pas quelle perte TypeSafe utilise, si son pipeline est de l’apprentissage par renforcement au sens algorithmique strict, ni si chaque poids de la colonne vertébrale est mis à jour.
La propreté n’est pas non plus une garantie de déploiement. Des données finies, des limites du modèle, une erreur d’optimisation et un décalage de distribution peuvent tous laisser la calibration imparfaite. Guo et al. montrent à la fois les problèmes de calibration des réseaux de neurones modernes et l’utilité des ajustements post-hoc. L’entraînement et la calibration post-hoc sont des mécanismes compatibles ; l’API ne peut pas séparer leurs contributions.14
Preuves observées. Les enregistrements de benchmark nous permettent de comparer la probabilité prédite à la précision observée, à la fois en agrégé et à l’intérieur d’intervalles de probabilité. Le graphique montre ces vérifications. L’accord des moyennes seules est une preuve plus faible que l’accord à l’intérieur des intervalles : le trop de confiance dans un groupe peut annuler le manque de confiance dans un autre. Sur l’échantillon MMLU de 1,200 items, l’erreur de calibration attendue à dix intervalles était de 0.0313 (définitions des intervalles et prédictions au niveau item). La plupart des prédictions se concentraient près de la certitude : 990 tombaient dans l’intervalle 0.9–1.0.15
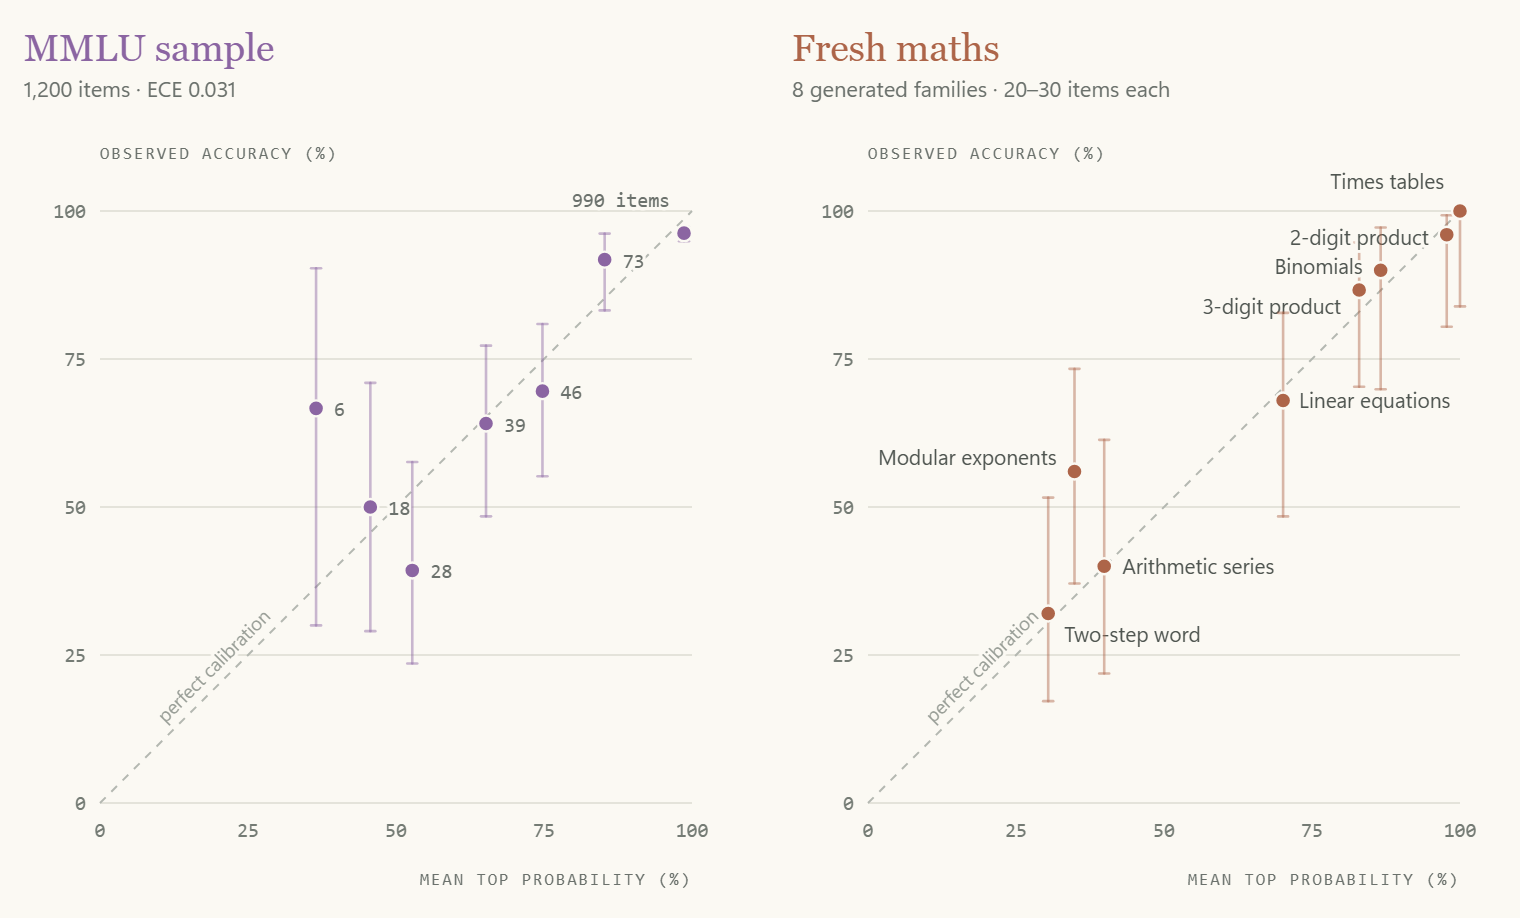
La petite étude sur les maths fraîchement générées ajoute une variation utile. Sur des problèmes générés de multiplication à trois chiffres, la précision était de 86.7% et la probabilité supérieure moyenne de 0.83. Sur des problèmes verbaux à deux étapes, la précision est tombée à 32% et la probabilité supérieure moyenne à 0.30. Le modèle était moins confiant sur la tâche plus difficile (fresh_math_results, avec 30 items de multiplication et 25 de problèmes verbaux).15 C’est encourageant, bien que de petites moyennes au niveau des catégories ne puissent pas établir la calibration pour tout type de problème non vu.
Ces résultats montrent aussi pourquoi un score de benchmark public est une mesure imparfaite de ce que sait le modèle. La précision sur MMLU-Pro était de 84.6% ; les problèmes verbaux fraîchement générés étaient bien plus difficiles.15 Des différences de structure de tâche, de distracteurs, de difficulté et d’exposition à l’entraînement pourraient toutes y contribuer. Cet écart n’établit pas une contamination du benchmark. Une formulation fraîche ne rend pas non plus inédite la compétence mathématique ou la connaissance factuelle sous-jacentes.
Il y a un constat distinct, inhabituellement clair, à propos du champ d’API nommé confidence. L’adaptateur officiel calcule la confiance d’un Choice à partir d’une distribution normalisée, pour , comme :
Pour trois options avec une probabilité maximale de 0.8, cela donne 0.7. L’adaptateur traite le cas à une seule option séparément, en renvoyant 1. Il mesure de combien la réponse en tête se hisse au-dessus d’une distribution uniforme. Ce n’est pas une autre estimation apprise que la réponse soit correcte. Le type Score utilise une formule différente reflétant la distance au niveau modal.16
Dans le système proposé, l’entraînement produit la distribution prédictive ; l’arithmétique ordinaire produit ce champ récapitulatif. Garder ces deux objets séparés évite une erreur conceptuelle courante : une distribution concentrée peut encore être confiante à tort.
6. Capacité creuse
Je m’attends à ce que Jev utilise un transformer à mélange d’experts creux. À certaines couches, un routeur envoie chaque jeton à travers un petit sous-ensemble de réseaux feed-forward, de sorte que le modèle peut stocker beaucoup de paramètres tout en n’en activant que quelques-uns pour chaque jeton : l’idée de calcul conditionnel démontrée par les couches MoE à porte creuse de Shazeer et al.17
Les experts creux ne peuvent pas être observés de l’extérieur, mais ils sont le choix probable. Un modèle à prefill seul est limité par le calcul, ce que le routage creux économise précisément. Les coûts de service habituels d’un MoE disparaissent presque : il n’y a pas de décodage jeton par jeton, où la bande passante mémoire domine et où la plupart des experts finissent actifs de toute façon, ni de cache KV de longue durée rivalisant avec les poids des experts pour la mémoire. Les mesures pointent dans la même direction. Jev a traité environ 30k jetons en à peu près 160 ms ; un modèle dense de 70B sur un nœud 8×H100 aurait besoin d’environ une seconde, tandis qu’un MoE d’environ 10B de paramètres actifs convient. Et la plupart des modèles de base récents les plus puissants (DeepSeek-V3, Qwen3, GLM-4.5, Kimi K2, gpt-oss) sont des MoE. Un matériel spécialisé pourrait permettre à un modèle dense d’égaler la vitesse, et les scores de benchmark peuvent surestimer la quantité de connaissances que détient le modèle, donc cela reste une inférence, pas une mesure.615
Rien d’autre dans la reconstruction n’en dépend. Remplacer par un transformer dense laisserait l’interface, l’état partagé, les branches isolées et la lecture exactement tels que décrits.
7. Ordonnancer les branches comme un lot, pas comme une conversation
Le composant final est un moteur de service qui traite les branches de questions comme des éléments de travail indépendants. Leurs suffixes peuvent être empaquetés en lots tout en lisant les représentations d’état partagées. Le code d’application associe ensuite les sorties numériques aux identifiants de question et sérialise la réponse.
Les mesures révèlent de petites différences entre des réponses identiques répétées, y compris entre des questions dupliquées au sein d’une même requête. Cela signifie qu’il ne faut pas présumer le déterminisme au niveau de l’API (noise, dup, et determinism).19 Cela n’implique pas que le modèle génère ou échantillonne du texte : les noyaux numériques, le batching dynamique, le routage, ou un caractère aléatoire délibéré peuvent tous affecter une lecture directe.
Les ordres des clés de réponse variaient aussi selon un petit nombre de motifs récurrents.19 Plusieurs workers avec un ordre de hachage différent sont une explication plausible. Cependant, ce canal latéral n’identifie pas le nombre de workers, n’établit pas où vit le cache KV, ni ne nous dit quelle précision numérique est utilisée. Ce sont des détails d’implémentation que les observations disponibles ne peuvent pas résoudre.
Ce qui importe pour l’architecture proposée, c’est l’absence de chaîne de dépendance entre les réponses. Le modèle n’a pas besoin de finir d’écrire la classification de la file avant de commencer l’estimation d’urgence. Les deux dépendent de l’état ; aucune ne consomme la réponse générée par l’autre.
Il reste une limite de dépendance. Si une question ultérieure a réellement besoin d’une réponse antérieure, l’application doit introduire une autre étape de décision ou exprimer la décision conjointe en une seule question. Partager le contexte ne supprime pas la structure logique du flux de travail.
Qu’est-ce qui me ferait changer d’avis ?
Cette reconstruction prend des engagements de différents types. Les sorties directes de probabilité sont décrites publiquement. L’isolation entre questions et les effets de l’ordre des options sont des comportements observables. Le partage du cache KV, l’attention causale, les lectures de position finale ou de style pointeur, et les experts creux sont des explications progressivement plus spécifiques.
L’expérience de la carte de référence tranche une question : la décision peut utiliser des options placées en dernier. Le test d’options fausses montre que des astuces de format d’entrée ne peuvent pas falsifier les frontières entre options. Des tâches relationnelles plus larges pourraient contraindre davantage la représentation, bien qu’un succès comportemental seul n’identifie toujours pas de façon unique un masque d’attention.
Pour le traitement des options, le suivi randomisé reproduit un effet de l’ensemble de choix, mais l’intervention à taille fixe sur la description reste non concluante. Davantage de gabarits et de blocs de requêtes indépendants pourraient distinguer un changement de température partagé d’interactions dépendantes du contenu. Une tâche de difficulté moyenne à 200 options pourrait séparer la tête à emplacements du scorer pointeur. Pour la calibration, des données de flux de travail réservées et des évaluations répétées sous décalage compteraient plus qu’un autre score de benchmark agrégé. Confirmer les experts creux exigerait probablement une divulgation ou des preuves au-delà de cette API.
Ma meilleure reconstruction de Jev reste celle du diagramme d’ouverture : un transformer causal avec un préfixe d’état partagé, des suffixes de question isolés, un traitement des options au niveau de la liste, des lectures numériques typées, et un entraînement orienté vers des distributions prédictives. Les experts creux sont la colonne vertébrale probable, bien que rien d’autre dans la conception n’en dépende.
Son utilité vient de l’adéquation entre le graphe computationnel et la tâche. Un service de décision doit lire des preuves, comparer des résultats autorisés, et exposer l’incertitude. Un transformer peut le faire sans transformer d’abord chaque décision en une phrase.
Méthodes
Cet essai repose sur une enquête du 17 septembre 2026 sur jev-1.13.0, avec un compte en accès anticipé et une région de service observée. L’étude source contient 1,029 enregistrements de sonde instrumentés (y compris les 190 items de maths générées), 6,800 enregistrements de benchmark, et des vérifications factuelles distinctes. Les études de suivi ont ajouté 146 requêtes relationnelles et d’interaction entre options (essais, résumé), 311 requêtes de comptabilité de jetons, 445 requêtes d’empreinte de tokenizer, 192 requêtes de latence, 148 requêtes de latence selon le nombre d’options, 181 requêtes de position d’option, 105 requêtes d’options fausses et 35 requêtes de limite de contexte. Chacune est liée depuis les références, avec les requêtes exactes et des réponses anonymisées. Les configurations de benchmark répétées partagent des items sous-jacents ; ces comptes ne sont pas des comptes de problèmes indépendants.
Le paquet de preuves téléchargeable consigne les observations utilisées dans cet essai. Les exemples d’API de la section d’ouverture sont schématiques. Les prompts cités de visibility et de carte de référence proviennent des scripts de sonde et des requêtes de suivi enregistrées. Les observations numériques sont spécifiques à cette version du modèle et à cette campagne de tests.
Les chiffres de latence proviennent de l’en-tête de réponse x-envoy-upstream-service-time. Ce sont des durées de service en amont, avec des frontières de file d’attente et d’exécution inconnues, plutôt que des temps isolés du modèle. Les balayages de la figure de latence ont été exécutés une requête à la fois, dans un ordre mélangé ; aucune des études ne contrôlait la charge du serveur. Les mesures locales d’horloge murale ne sont pas utilisées comme preuve architecturale.
Les probabilités étaient généralement renvoyées avec une précision de deux décimales. Les questions dupliquées dans une requête partagent des conditions et peuvent avoir des erreurs corrélées. La figure de calibration MMLU utilise dix intervalles de largeur égale : [0, 0.1), [0.1, 0.2), et ainsi de suite, 1.0 étant inclus dans le dernier intervalle. L’erreur de calibration attendue est la différence absolue, pondérée par l’échantillon, entre la précision et la probabilité supérieure moyenne de chaque intervalle. Les estimations dépendent de la sélection de l’échantillon, du découpage en intervalles et de l’arrondi des réponses. Les preuves étayent des affirmations sur les distributions testées, pas une calibration garantie sur les futurs flux de travail des clients.
Sources et travaux liés
Les références expérimentales identifient les étiquettes de script d’origine afin que chaque observation puisse être localisée dans le paquet de preuves. Les citations d’articles établissent les mécanismes proposés et leurs précédents ; elles n’établissent pas que Jev les utilise.
Sources
- TypeSafe (2026). Introducing System One Models and Jev. Source principale de l’affirmation sur la sortie en parallèle et de l’objectif RLCD déclaré.
- TypeSafe. Documentation complète de l’API, consultée le 17 septembre 2026. Questions typées, distributions de réponse et contrat d’API.
- Vaswani et al. (2017). Attention Is All You Need. Masquage du décodeur, attention, et la couche de sortie linéaire/softmax.
- Expériences d’API : type_preamble et outputs. Additivité de la comptabilité des jetons, changements d’identifiant et la réponse à 255 options.
- Expérience d’API : visibility. Cinq répétitions chacune avec le secret dans une question sœur, absent de cette sœur, et dans l’état.
- Balayages de latence (192 requêtes séquentielles). Longueur de l’état et nombre de questions, 8 répétitions mélangées chacune ; durées amont rapportées par le serveur.
- Juravsky et al. (2024). Hydragen: High-Throughput LLM Inference with Shared Prefixes.
- Yao et al. (2024). DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference.
- Expérience d’API : option_order. Sensibilité à l’ordre des tickets ordinaires.
- Expérience d’API : iia. Trois requêtes par condition, chacune avec quarante questions dupliquées ; ensembles de choix d’origine, ajouté et préfixé.
- Reddy et al. (2024). FIRST: Faster Improved Listwise Reranking with Single Token Decoding.
- TypeSafe. Introduction à l’apprentissage automatique. Description principale de la voie de post-entraînement RLCD et du contrat de calibration.
- Gneiting and Raftery (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association 102(477):359–378.
- Guo et al. (2017). On Calibration of Modern Neural Networks.
- Enregistrements de benchmark et de maths générées : précision et probabilités prédites moyennes. ; Analyse de fiabilité MMLU : définitions des intervalles, ECE, intervalles de Wilson et 1,200 prédictions au niveau item.
- TypeSafe. Adaptateur Python officiel, confidence_metrics.py, révision fb52b103. Formules de confiance de Choice et Score (lu le 17 septembre 2026).
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer.
- Expérience d’empreinte de tokenizer (445 requêtes). Sondes de longueur de séquence, de vocabulaire et de pré-tokenisation, comparées à 192 tokenizers publics.
- Expériences d’API : noise, dup, et determinism. Probabilités répétées et ordres des clés de réponse.
- Expérience relationnelle de suivi (96 requêtes). Deux gabarits, deux valeurs de référence, six permutations, deux emplacements et deux répétitions ; requêtes exactes et réponses anonymisées.
- Expérience d’interaction entre options de suivi (50 requêtes). Dix blocs randomisés de base4, null4, append5, replace5 et null5 ; changements appariés et erreurs standard.
- Expérience de limite de contexte (35 requêtes séquentielles). Limites de jetons par branche et par requête entière, avec cas limites acceptés et rejetés.
- Expérience d’injection d’options fausses (105 requêtes). Sept formats de délimiteur, tâches de base saturées et ambiguës, et vecteurs de probabilité complets.
- Expériences de comptabilité de jetons (311 requêtes). Longueur d’ID de question, taille de lot, difficulté de l’état, IDs de mot, et chaînes état contre ID appariées.
- Expérience de latence selon le nombre d’options (148 requêtes). Une ou 20 questions avec 2–200 options, étiquettes courtes et longues, plus contrôles de découplage entrée/sortie.
- Expérience de position d’option (181 requêtes). Plafond du nombre d’options, bonne réponse déplacée sur des listes de 10, 50, 200 et 255 options.
Source : L’architecture de Jev démasquée — Archer, archerhume.com, 17 septembre 2026.