Jev의 아키텍처 해부
저는 10,000번의 API 호출로 Jev를 탐침하여 그것이 대략 어떻게 만들어졌는지, 그리고 X에서 떠도는 대부분의 사기성 주장이 왜 완전히 틀렸는지 알아냈습니다. X는 Jev의 출시에 관한 즉흥적인 논평으로 넘쳐나며, 그 대부분은 핵심을 완전히 놓치고 있습니다: “JSON 분류기가 1,200만 뷰? 그래, 우리는 거품 속에 있다.” 보통의 LLM은 “90% 확신한다”를 텍스트로 생성합니다. 그 단어를 출력할 확률이 맞을 확률 90%를 뜻하지는 않습니다. 그런데도 우리는 바로 이 패턴 위에 사기 탐지, 모더레이션, 라우팅과 위험 평가를 세웁니다. 토큰 단위 생성에 값을 치르고, 검증되지 않은 신뢰도 주장을 소프트웨어가 행동 근거로 삼을 수 있는 확률처럼 다루는 것입니다.
Jev의 제안은 사전 학습된 LLM의 지식을 유지하면서, 생성된 신뢰도 주장을 내부 표현에서 직접 읽어낸 결정 확률로 바꾸는 것입니다. 그 확률은 결과에 대해 훈련됩니다. 공유된 상태, 질문, 그리고 허용된 답을 주면, 텍스트를 생성하지 않고 분포를 병렬로 반환합니다.1 이 부류의 응용 전체에서 이는 두 문제를 동시에 해결합니다: 결정 신호의 신뢰성과, 그 신호를 만드는 데 낭비되던 계산입니다.
문제가 하나 있습니다. 그것은 오픈 가중치가 아니고, TypeSafe는 연구를 공개하기를 거부합니다…… 그래서 제가 (최선을 다해) 해보겠습니다.
증거는 인과적 트랜스포머(아마도 sparse MoE를 사용)를 결정용으로 개조한 쪽을 가리킵니다: 공유 상태 인코딩, 서로 격리된 질문 분기, 그리고 텍스트 생성 대신 확률을 직접 읽어내는 방식입니다. TypeSafe API를 탐침하고(컨텍스트 길이를 바꿀 때의 지연 시간 스케일링, 질문 재정렬 등에서 특징을 찾았습니다), Astra로 공개된 문서와 연구를 훑고, 선행 사례를 조사한 끝에, 저는 그것이 어떻게 동작하고 아키텍처가 어떤 모습인지에 대해 꽤 정확한 모델을 얻었다고 생각합니다.
sparse 백본은 가장 불확실한 부분이지만, 이 영역에서 특히 유리하고 자기회귀(AR) LLM보다 단점이 적어서, 쓰지 않았다면 오히려 이상할 것입니다. 공유 계산과 직접 확률 출력은 물론 훨씬 뒷받침이 잘 됩니다. 이것은 분명히 모두 상당히 추측성인 이야기이므로, 어떤 증거가 TypeSafe에 의해 공개되었고, 무엇이 실험에서 관측되었으며, 무엇이 그것들로부터 추론된 것인지를 가능한 한 분명히 밝히려고 합니다. 블랙박스 API는 유령 위에 담요를 덮어 아키텍처가 어떤 모양인지 대략적인 윤곽을 잡는 일을 놀랄 만큼 쉽게 해줍니다.
이 설계가 유용한 이유
지원 요청 라우팅의 도식적인 예를 생각해 봅시다. 이것은 API의 구조를 보여 주며, 아래의 예시 확률은 지어낸 값입니다.
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}
유용한 답은 payments에 0.91의 확률을, 긴급 에스컬레이션에는 0.42만을 부여할 수 있습니다. 이 둘은 서로 다른 불확실성입니다. 소프트웨어는 티켓을 자동으로 라우팅하면서 에스컬레이션은 별도의 정책에 맡길 수 있습니다.
인과적 트랜스포머는 텍스트를 왼쪽에서 오른쪽으로 표현해 나가는 방법을 이미 알고 있습니다. 보통의 언어 모델 추론에서는 프롬프트를 처리하고, 토큰 하나를 예측하고, 그 토큰을 다시 입력으로 넣고, 이를 반복합니다. 이는 최초의 Transformer에서 도입된 디코더 어텐션과 출력 투영을 기반으로 합니다.3 하지만 프롬프트 처리 단계는 이미 풍부한 표현을 만들어 냈습니다. 세 개의 큐 중 하나를 고르는 작업이라면, 그 표현을 곧바로 세 개의 숫자로 매핑하는 작은 함수를 붙일 수 있습니다.
여기서 한 가지 세부가 병렬 답변에 관한 혼란의 상당 부분을 해소해 줍니다: 인과적 어텐션은 어느 위치가 어느 정보를 쓸 수 있는지를 규정할 뿐, 입력 토큰이 반드시 실행되어야 하는 순서를 규정하지 않습니다. 프롬프트 처리, 즉 prefill 단계에서는 모든 입력 토큰이 이미 알려져 있습니다. 모델은 한 레이어 안에서 그 위치들을 함께 처리할 수 있으며, 어텐션 마스크는 뒤쪽 위치에 대한 접근을 막습니다. 레이어는 여전히 순차적으로 실행됩니다. 자기회귀 디코딩은 또 다른 의존성을 더합니다: 이전 예측이 선택되기 전에는 다음 토큰이 존재하지 않습니다. 우리가 제안하는 모델은 prefill과 readout에서 끝나므로, 그 토큰 단위 의존성을 피합니다.
이것은 작업의 계산 형태를 바꿉니다. 출력은 더 이상 "payments": 0.91을 위한 일련의 철자 결정을 필요로 하지 않습니다. JSON 형식화는 평범한 응용 코드에서 이루어집니다. 신경망은 확률을 공급할 뿐입니다.
이제 상태가 긴 인시던트 보고서이고 질문이 50개라고 가정해 봅시다. 입력의 대부분은 공유됩니다. 트랜스포머는 처리된 토큰에 관한 중간 정보를 키–값 캐시, 보통 줄여서 KV cache에 저장합니다. 제안된 설계에서는 모든 질문이 같은 상태 캐시를 읽습니다. 각 분기는 자기 자신의 지시문과 답 선택지만을 더합니다.
상태가 개 토큰이고 질문이 개일 때, 요청을 따로 보내면 상태를 대략 번 처리하게 됩니다. 공유하면 반복되는 상태 토큰 처리를 에서 로 줄입니다. 질문은 여전히 상태를 주시해야 하며, 그 작업이 사라지지는 않습니다. 다만 모델이 상태의 표현을 반복해서 재구성할 필요는 없습니다.
격리는 인터페이스에도 유용한 의미를 부여합니다. 고객이 화났는지를 묻는 것이 티켓을 받을 큐를 바꾸어서는 안 됩니다. 두 질문은 서로의 지시문을 읽지 않고도 같은 증거를 검토할 수 있습니다. 답이 통계적으로 관련되어 있더라도, 분기들은 서로에 대해 계산적 의존성을 갖지 않습니다.
마지막으로, 확률은 하위 정책을 명시적으로 만듭니다. 불필요한 에스컬레이션이 1단위의 비용이고 놓친 긴급 사례가 9단위의 비용이라면, 단순화한 결정 규칙은 일 때 에스컬레이션합니다. 그 계산은 확률이 이 워크플로에 대해 신뢰할 만한 만큼만 의미가 있습니다. 따라서 확률 분포를 훈련하고 평가하는 일은 겉치레용 신뢰도 필드가 아니라 제품의 일부가 됩니다.
이 중 어느 것도 diffusion을 필요로 하지 않습니다. 병렬 분류는 수십 년 전부터 존재했습니다. 흥미로운 조합은 폭넓게 유능한 트랜스포머, 공유 컨텍스트 계산, 타입이 지정된 출력 인터페이스, 그리고 유용한 불확실성에 보상을 주는 훈련입니다.
1. 추론을 readout으로 끝내기
첫 번째 구성 요소는 가장 단순합니다: 디코드 루프 대신 예측 헤드입니다.
공개된 증거. TypeSafe의 출시 발표는 이렇게 말합니다: “Jev는 토큰 단위로 자기회귀 생성하는 대신 모든 확률을 병렬로 출력합니다.” 그 문서는 유한한 선택지, 예/아니오 결정, 순서가 있는 점수를 노출합니다. 이것들은 고정된 수치 출력으로 자연스럽게 표현됩니다.12
관측된 증거. API는 여전히 output_tokens 필드를 보고하는데, 이는 생성 기록처럼 들립니다. 그렇지 않습니다. 예/아니오 질문의 경우 그 수는 정확히 들어맞습니다: 공유 토큰 4개에, 답마다 15개, 그리고 각 질문 식별자의 토큰 길이를 더한 값입니다. TypeSafe의 문서는 그 식별자가 “기반 모델에 전송되지 않고 추론에도 사용되지 않는다”고 말합니다. 모델이 결코 보지 못하는 텍스트에 따라 달라지는 수는 추론 이후에 직렬화된 응답으로부터 계산된 것입니다. 반환값도 영향을 주지 않습니다: 0.0이라는 답은 0.01과 같은 비용을 치르는데, 다른 경우라면 각 숫자가 토큰으로 세어지기 때문입니다.224
그 수 뒤에 있는 tokenizer는 우리가 테스트한 192개의 공개 tokenizer 중 어느 것과도 일치하지 않습니다. 평범한 텍스트에 대해서는 Jev 자체의 입력 계수기와 일치하며, 긴 공백과 문장 부호 연속에서만 다릅니다. output_tokens는 청구 수치입니다. 그것은 Jev가 텍스트를 생성하는지에 대해 아무것도 알려주지 않으며, 설령 생성하더라도 그 텍스트를 측정하지도 못합니다. 지연 시간도 그 수치를 따라가지 않습니다: 선택지가 200개인 질문(출력 토큰 1,911개)은 선택지가 두 개인 질문만큼 빠르게 반환되었고, 서버 시간은 입력 길이에 따라서만 늘었습니다.2425
선택지 255개짜리 응답은 출력 토큰 2,714개를 보고했습니다.4 그 수를 요청 시간으로 나눠 결과를 모델의 디코딩 속도라고 부르는 것은 실수입니다. 서버는 단 한 번의 모델 평가 후에도 수천 자를 직렬화할 수 있습니다. 그 회계 필드는 신경망 디코딩 단계가 몇 번 일어났는지 알려주지 않습니다.
제안된 readout은 최종 은닉 벡터 를 받아 logits를 만들어 냅니다:
여기서 는 허용된 답의 개수입니다. 행렬 는 표현을 답 점수로 변환하고, softmax가 그 점수를 분포로 바꿉니다. 예/아니오 결정이라면 스칼라 하나와 sigmoid로 충분합니다.
그 클래스들은 “payments” 같은 고정된 개념일 필요가 없습니다. 선택지 슬롯, 즉 첫 번째 선택지, 두 번째 선택지, 세 번째 선택지일 수 있습니다. 분기가 각 슬롯의 의미를 공급하고, 응용 코드가 그 확률을 호출자의 선택지 키로 되돌려 매핑합니다. 순서가 있는 Score도 마찬가지로 단계들에 대한 확률을 예측하고 그 확률 가중 평균을 반환할 수 있습니다. 이는 고객마다 라벨에 맞춘 새 헤드를 훈련하지 않고도 새로운 결정을 지원합니다. 4절에서 비교하는 포인터 방식 scorer가 주요 대안입니다: 번호가 매겨진 슬롯이 아니라 각 선택지 자체의 표현에 점수를 매깁니다.
이것은 Jev에 따로 이름 붙은 분류기 모듈이 있다는 것을 증명하지 않습니다. 언어 모델의 어휘 헤드도 행렬 뒤에 softmax를 붙인 것입니다. 그 행렬에서 예약된 라벨 행 개를 선택하면 전용 -클래스 헤드와 같은 계산을 구현할 수 있습니다. 그 행들은 입력 임베딩과 묶여 있을 수도 있고 독립적으로 훈련되었을 수도 있으며, 여기서는 어느 배치인지 구별할 수 없습니다.
중요한 구분은 확률을 읽어내는 것과 확률을 서술하는 텍스트를 생성하는 것 사이에 있습니다. 생성된 “91%”는 토큰 시퀀스입니다. 분류기의 0.91은 예측 분포의 한 항목입니다. 어느 쪽이든 캘리브레이션이 어긋날 수 있습니다. 어느 것도 형식만으로 신뢰할 만해지지는 않습니다.
제약된 텍스트 디코딩은 비슷한 인터페이스를 만드는 한 가지 가능한 방법으로 남아 있지만, TypeSafe는 명시적으로 다른 출력 경로를 서술합니다. 그 진술은 지연 시간 논증보다 강한 증거입니다. 증거는 4절에서 비교하는 두 설계 중 하나인 직접 수치 readout을 가리킵니다. 예약된 라벨 토큰의 가능성도 남아 있지만, 그 절의 가짜 선택지 테스트는 그것에 반하는 무게를 더합니다.
2. 상태를 공유하고 질문을 격리하기
다음 결정은 계산을 어디에서 재사용하는가에 관한 것입니다.
관측된 증거. 작은 통제 예제들에서 토큰 회계는 정확히 가산적입니다. 최소한의 예/아니오 질문 하나는 입력 토큰 268개를 썼고, 둘은 276개를 썼습니다. 예/아니오 질문 하나, 선택지 두 개의 Choice 하나, 두 단계 Score 하나를 담은 요청은 318개를 썼는데, 이는 공유 오버헤드 위의 측정된 기여분들의 합과 일치합니다. 이는 공통 접두사와 질문 접미사에 들어맞지만, 회계만으로 계산 그래프를 특정하지는 못합니다.4
더 많은 정보를 주는 실험은 그 영역들 사이로 증거를 옮깁니다. 상태는 처음에 이렇게 적혀 있었습니다:
The weather is nice today and the park is full of people.형제 질문에는 이런 내용이 들어 있었습니다:
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
탐침은 다른 질문이 언급한 코드가 무엇인지 물었고, ZEBRA-7741, 방해 항목 둘, 그리고 none을 선택지로 주었습니다. 비밀이 형제 질문에 있을 때 보고된 확률은 0.00이었습니다. 그 형제를 제거해도 같은 결과가 나왔습니다. 대신 그 선언을 상태에 넣으니 0.90–0.92로 올라갔습니다. 조건마다 다섯 번 반복했습니다(탐침 기록의 visibility).5
이것은 유용한 개입입니다: 선언을 API 경계 너머로 옮기면 그 효과가 달라집니다. 이는 질문 사이의 행동적 격리와 공유 상태에 대한 접근을 뒷받침합니다. 정확한 어텐션 마스크를 드러내지는 않습니다. 별도의 모델 호출, 트리 마스크, 또는 정보 흐름을 제한하는 다른 메커니즘도 같은 결과를 낼 수 있습니다. 탐침의 문구는 상태 조건에서도 “다른 질문”에 대해 묻기 때문에, 문자 그대로의 지시 따르기를 순수하게 시험한 것은 아닙니다.
서빙 측정은 또 하나의 조각을 더합니다. 약 100개 질문까지는 서버 시간이 거의 변하지 않았습니다. 그 이상에서는 꾸준히 늘었고, 토큰 대 토큰으로 질문 텍스트는 상태보다 대략 두 배의 비용이 들었습니다. 이는 상태를 한 번 계산하고 질문 작업을 배치로 처리하는 것과 일관됩니다.6
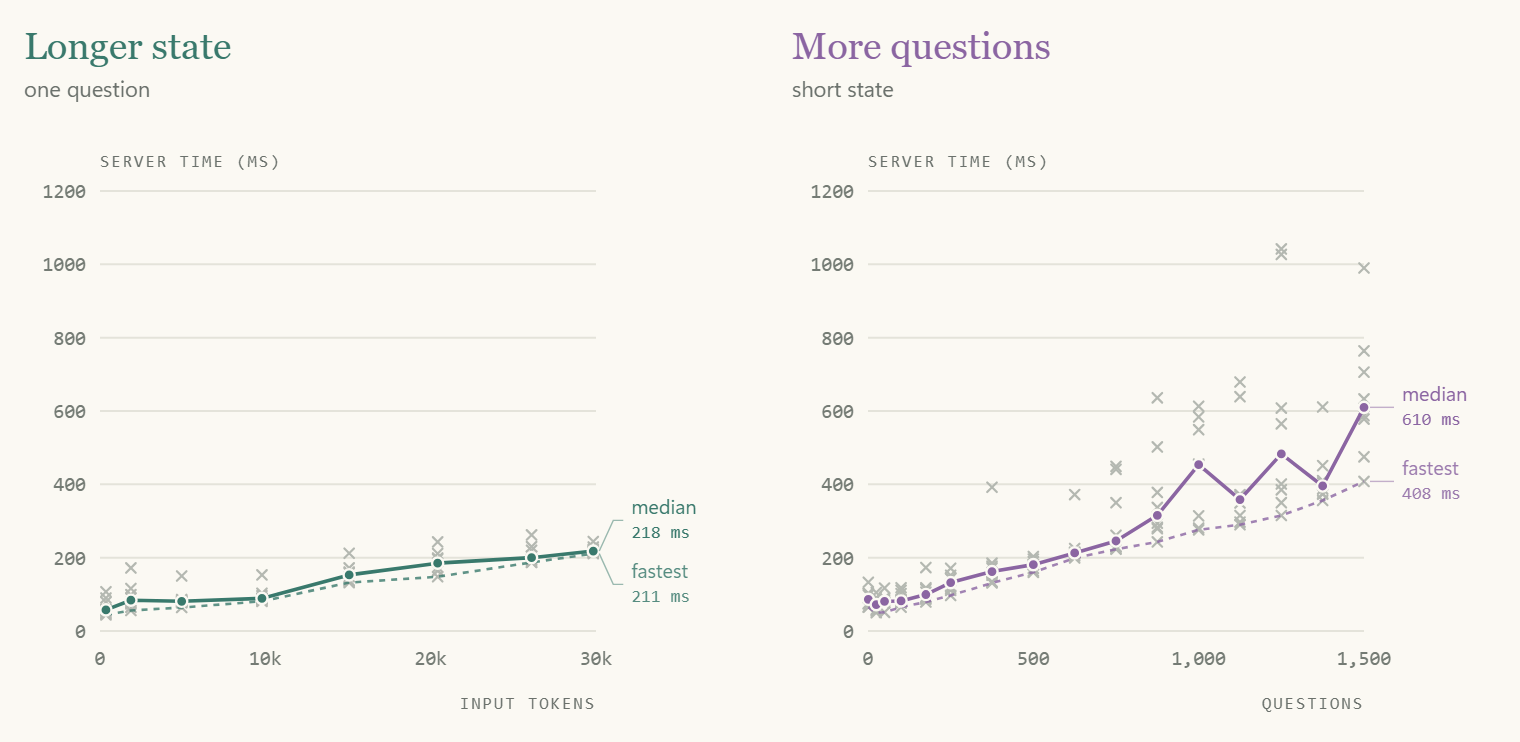
이것들은 서버가 보고한 업스트림 소요 시간이며, 로컬 노트북에서 측정한 시간이 아닙니다. 업스트림 서비스가 포함하는 모든 작업과 대기를 포함하며, 그 서비스는 다른 사용자들과 공유되었습니다.
Jev는 두 가지 한도를 적용합니다. 각 분기(상태에 질문 하나)는 대략 32,768 토큰으로 제한되고, 요청 전체는 대략 65,536으로 제한됩니다. 요청 한도는 상태를 한 번만 셉니다: 23k 토큰의 상태에 질문 5,000개라면 그 안에 들어갑니다. 각 질문이 상태의 자기 사본을 처리한다면, 그 요청은 1억 토큰을 넘을 것입니다. 이 쌍은 최대 2¹⁶ 토큰의 단일 패킹 시퀀스에 들어맞으며, 상태를 한 번 두고 그 뒤에 모든 질문을 두고, 각 분기는 2¹⁵ 컨텍스트 윈도로 제한됩니다.22
접두사 KV cache에 분리된 causal 접미사를 붙이는 것이 자연스러운 구현입니다. Hydragen은 접두사를 공유하는 시퀀스를 위한 효율적인 어텐션을 설명하고, DeFT는 트리 구조 추론을 위한 어텐션을 발전시킵니다. 이것들은 이 서빙 패턴이 실용적임을 보여 줍니다. 선행 기술일 뿐, TypeSafe가 어느 라이브러리를 쓴다는 증거는 아닙니다.78
이 설계는 겉보기 모순도 해소합니다: 격리된 질문들은 그래도 같은 가속기에서 함께 평가될 수 있습니다. “병렬”은 그들의 스케줄링과 답 의존성의 부재를 서술할 뿐입니다. 질문마다 GPU 하나를 뜻할 필요는 없습니다.
3. 인과적 백본
실험은 인과적 디코더와 양방향 인코더를 구별하지 못합니다: 둘 다 최종 결정이 입력 전체를 읽을 수 있기 때문입니다. 그래도 저는 타당한 이유로 인과적 디코더라고 가정합니다. Jev의 지식 폭(MMLU-Pro에서 84.6%)은 최전선 규모의 사전 학습을 요구하고, 그 규모의 모든 모델은 인과적 디코더이며, TypeSafe는 RLCD를 사전 학습된 언어 모델의 사후 학습이라고 설명합니다. 양방향 Jev라면 훨씬 약한 기반 모델이거나 추가 비용을 들여 디코더를 변환한 것이 되며, 그 대가로 causal 서빙이 제공하는 공유 접두사 캐싱을 포기하게 됩니다. 그것은 놀라운 일이겠지만, 외부에서 배제할 수는 없습니다.1215
어떤 사전 학습 모델인지는 알 수 없고, tokenizer도 그것을 드러내지 않습니다. Jev의 토큰 수는 415개 탐침에 걸쳐 테스트한 192개 공개 tokenizer 중 어느 것과도 일치하지 않습니다. 그것은 모든 숫자를 개별적으로 쪼개고, 병합하기 전에 전체 청크를 조회합니다: a 8개는 토큰 하나로 세지만 16개는 네 개로 셉니다. 그 어휘는 OpenAI의 o200k를 밀접하게 따르는데, Jev가 단일 토큰으로 세는 모든 문자열이 o200k에서도 단일 토큰이기 때문입니다. 그러나 숫자 쪼개기와 몇몇 병합이 o200k 자체를 배제합니다. 가장 가까운 공개 일치는 Qwen으로, 415개 탐침 중 348개에서 일치합니다. 이것은 변경되지 않은 공개 tokenizer를 배제할 뿐, 공개 기반 모델을 배제하지는 않습니다: 어휘 교체, 지속 사전 학습, 증류가 각각 설명이 될 수 있고, 모델과 다르게 토큰을 세는 API도 마찬가지입니다.18
실험은 결정이 무엇을 읽을 수 있는지는 보여 줍니다. 저는 질문의 선택지들 사이에 참조 카드를 놓고, 그 카드가 만족시키는 조건의 선택지를 고르라고 Jev에게 요청했습니다. 정확한 선택지 집합 하나는 이렇습니다:
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.
지시문은 이러했습니다: “참조 카드를 읽고, 그 조건이 만족되는 선택지 하나를 고르시오.” 참조 값을 indigo로 바꾸면 선택 가능한 선택지들은 그대로 둔 채 정답이 뒤바뀝니다.
저는 두 값, 여섯 가지 선택지 순열 전부, 그리고 route = east/west를 쓰는 두 번째 템플릿을 각각 두 번 반복해 테스트했습니다. 짝지은 대조군은 참조를 대신 공유 상태에 넣었습니다. 그 결과 선택지 참조 시행 48회와 상태 참조 대조 48회가 나왔습니다.20
| 참조 선택지의 위치 | 정답 수 |
|---|---|
| 처음 | 12 / 16 |
| 중간 | 11 / 16 |
| 마지막 | 16 / 16 |
| 참조를 상태로 이동 | 48 / 48 |
Jev는 후보 설명 뒤에 놓인 정보를 사용할 수 있습니다. 참조가 마지막일 때, 모든 시행에서 올바른 선택지를 골랐으며 평균 정답 확률은 약 0.88이었습니다.
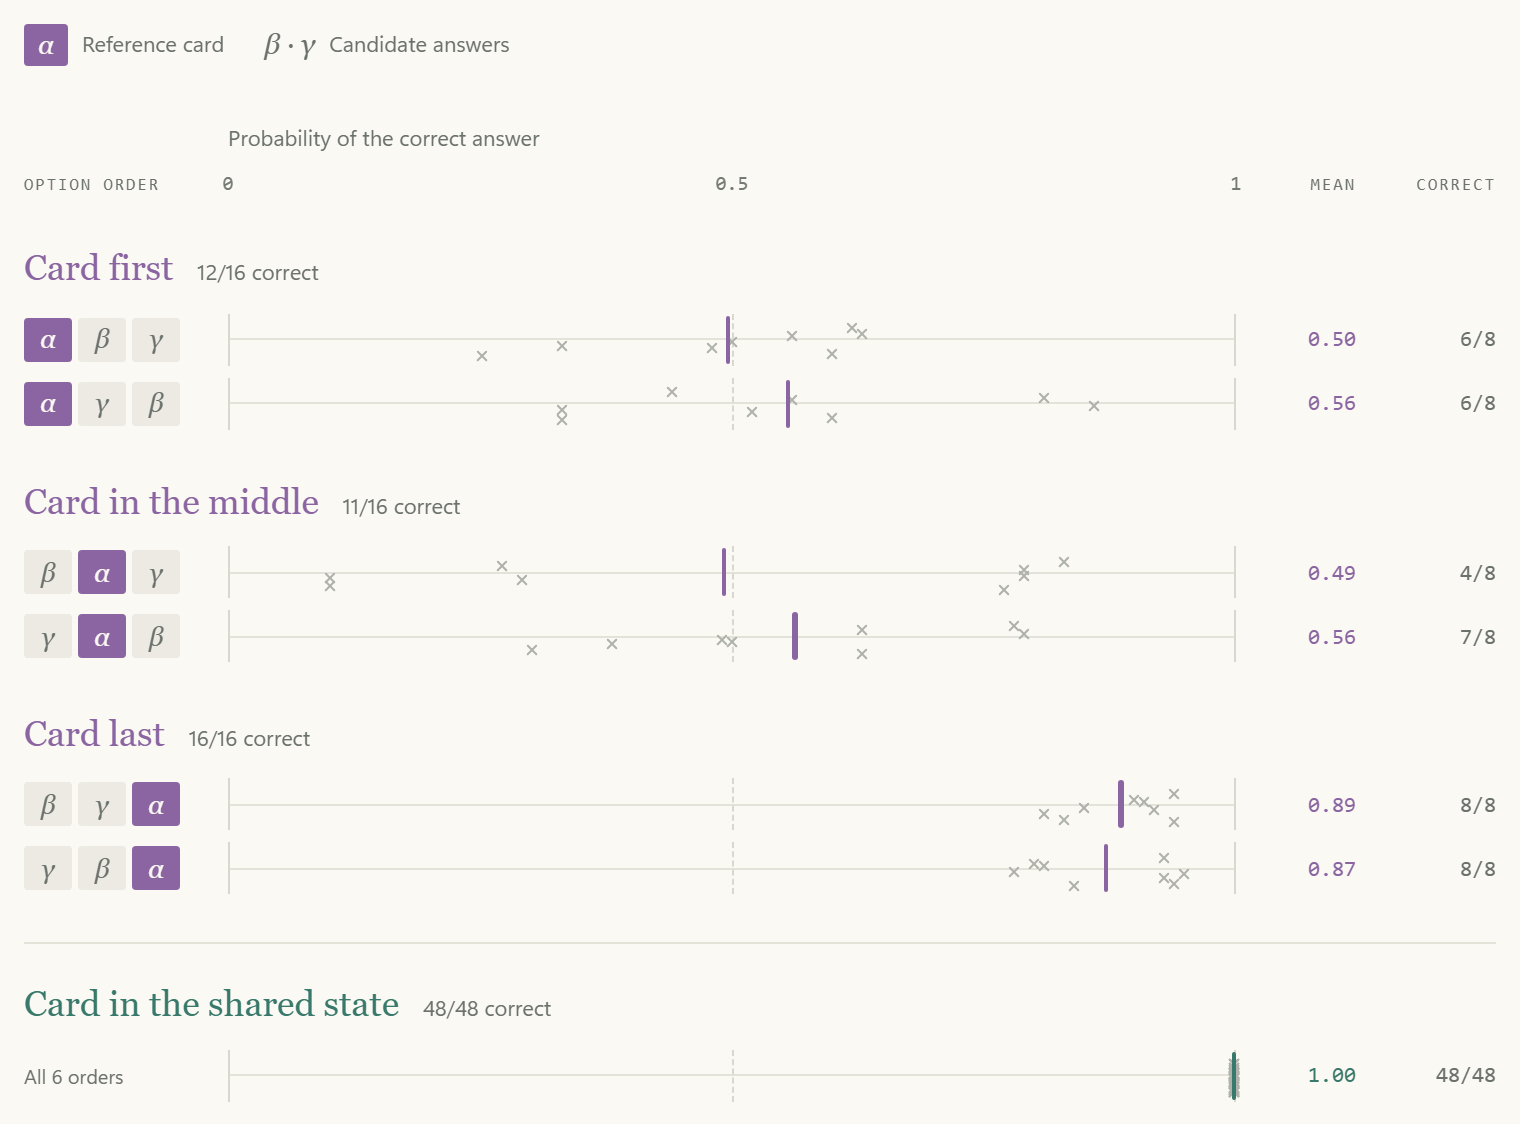
값 전환 대조는 위치만큼이나 중요합니다. 카드가 마지막일 때 amber만 indigo로 바꿔도 어느 앞쪽 선택지가 이기는지가 달라집니다. 그 앞쪽 설명들과 상태는 그대로인데도 그렇습니다. 각 선택지를 자기 텍스트와 상태로부터 독립적으로 채점한 뒤 점수만 정규화하는 모델에는 그 사실이 앞쪽 선택지들의 상대 순위를 바꿀 경로가 없습니다. 결과는 선택지들이 공동 결정에 영향을 미치는 경로를 뒷받침합니다.20
이는 전체 목록 뒤에 계산되는 모든 readout, 즉 4절에서 비교하는 두 설계와 별도의 선택지 혼합 단계 모두에 들어맞습니다. 남은 오류들은 이 두 템플릿에서 위치에 민감한 처리를 보여 줄 뿐, 유일한 원인을 특정하지는 않습니다.
이 계산에 diffusion은 불필요하며, 이 실험들 중 어느 것도 반복적 디노이징을 필요로 하지 않습니다. 방어 가능한 아키텍처적 추론은 더 좁습니다: 답 계산이 전체 선택지 목록에 접근할 수 있다는 것입니다. 다음 실험은 그것이 실제로 그 공동 컨텍스트를 사용하는지 시험합니다.
4. 고르기 전에 선택지들이 상호작용하게 하기
질문 안에서 증거는 다른 정보 경계를 가리킵니다: 대안들이 순서가 있는 목록으로 함께 읽히고, 그 뒤에 하나의 결정 위치가 옵니다.
왜 그 상호작용을 허용할까요? “위 항목 중 없음” 같은 선택지는 다른 선택지들에 의존합니다. 평범한 대안들조차 질문을 명확히 할 수 있습니다. “Payments”, “account access”, “other”는 “bank”, “payment provider”, “customer”와는 다른 결정을 정의합니다. listwise 표현은 모델이 분포를 산출하기 전에 그 구별을 해석하게 해줍니다.
가장 강한 증거는 관련 없는 추가 선택지를 넣은 실험입니다.
지급 실패의 네 가지 가능한 원인으로 시작합니다: bank, provider, customer, unknown. 그런 다음 weather: Bad weather caused it를 덧붙입니다. 모든 원래 선택지가 독립적이고 변하지 않은 logit을 받고 서버가 같은 softmax 온도를 적용한다면, 다섯 번째 선택지를 더하는 것은 정규화를 바꾸지만 기존 두 선택지 사이의 오즈는 바꿀 수 없습니다:
공통 분모가 상쇄됩니다. 이것은 우리에게 구체적이고 반증 가능한 예측을 줍니다.
원래 연구는 대략 +0.49에서 +0.08로의 이동을 발견했습니다.10 이것이 평범한 요청 변동성 속에서도 살아남는지 확인하기 위해, 저는 실험을 열 개의 무작위 블록으로 반복했습니다. 각 블록에는 선택지 네 개의 기준선, 동일한 선택지 네 개의 대조, weather를 덧붙인 선택지 다섯 개 버전, 동일한 선택지 다섯 개의 대조, 그리고 추가 설명이 “Bad weather caused it”에서 “Wild birds caused it”으로 바뀐 선택지 다섯 개 버전이 포함되었습니다. 각 요청은 질문 하나를 담았습니다.21
확장 결과는 재현되었습니다. 각 블록 안에서 각 조건의 동일한 두 요청을 합치면, 평균 로그 오즈는 +0.38에서 +0.11로 떨어졌습니다. 모든 블록이 감소를 보였고, 평균 변화는 −0.28이었으며, 서술적 95% 짝지은 t 구간은 대략 −0.36에서 −0.19였습니다. 이 합치기는 중복 출력을 독립 실험으로 취급하는 대신, 대조 요청을 사용해 평범한 요청 잡음을 줄입니다.21
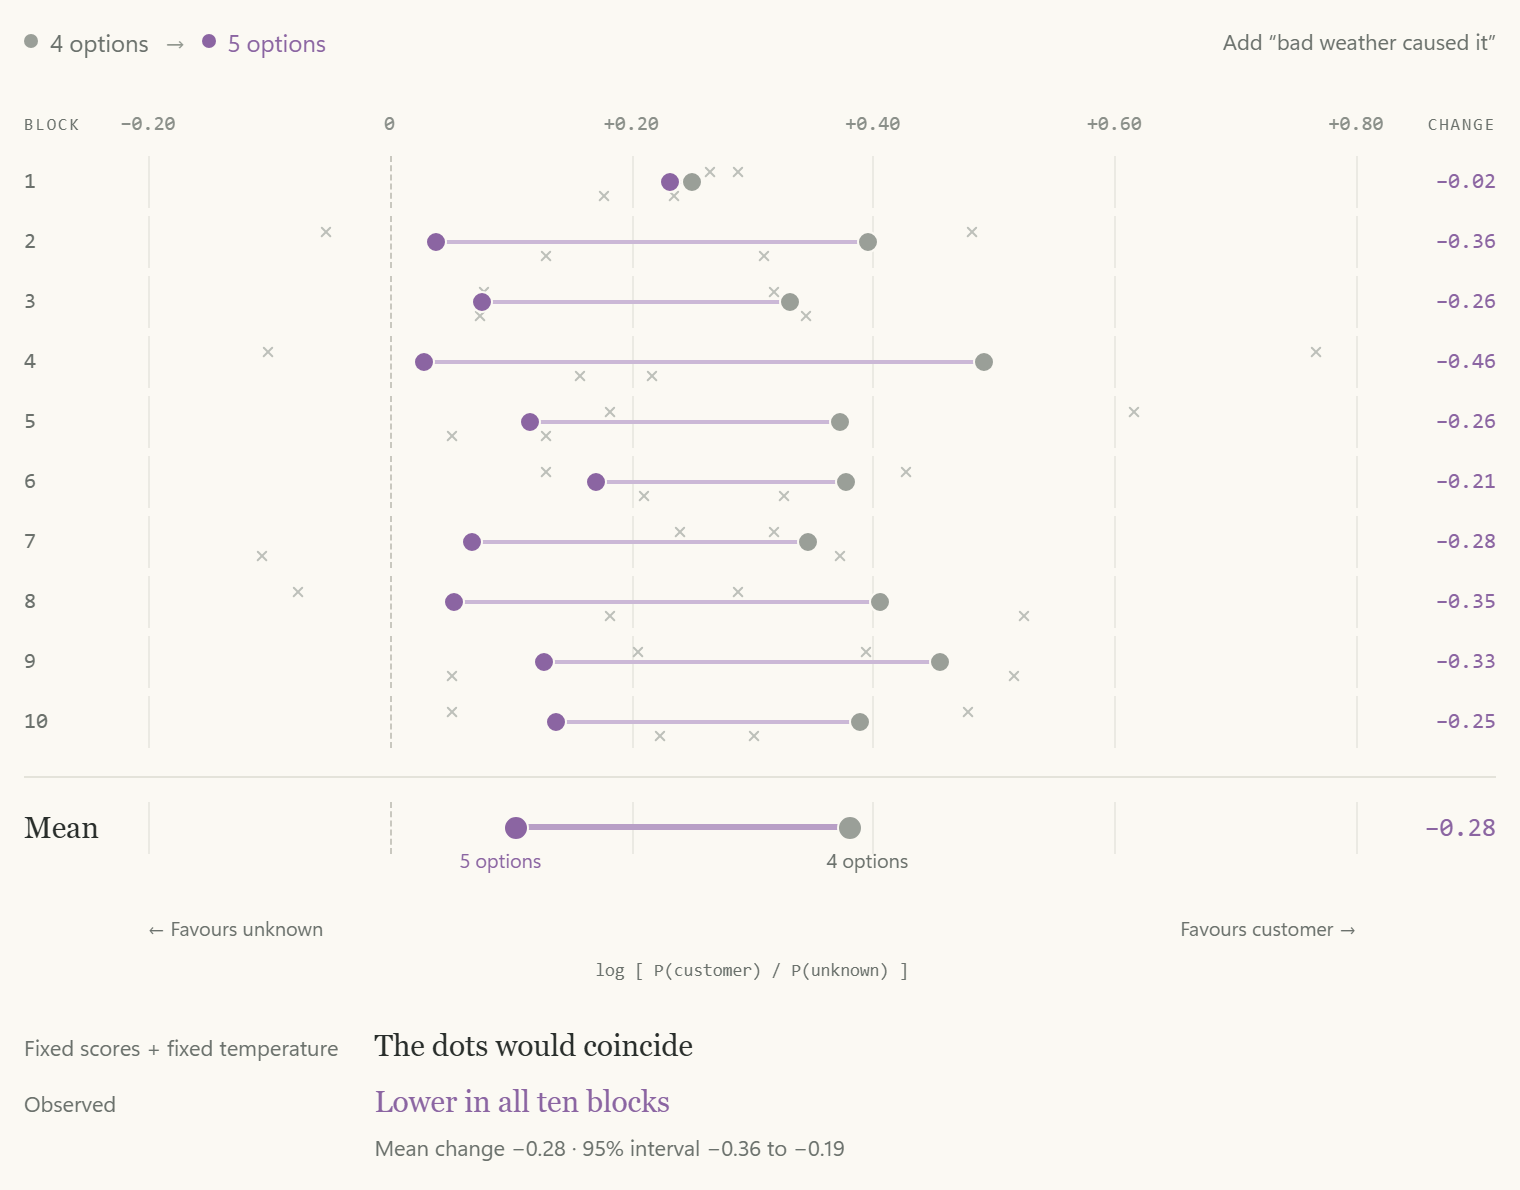
이것은 고정된 독립 logit 뒤에 변하지 않은 softmax가 온다는 것에 반하는 증거입니다. 메커니즘을 유일하게 특정하지는 않습니다. 선택지 다섯 개를 유지한 채 추가 설명만 바꾸면 더 작고 결론이 나지 않는 이동이 나왔습니다: 그 짝지은 구간이 0을 포함했습니다. 집합 의존적 온도는 내용 의존적 혼합과 함께 여전히 가능합니다.
전체 목록을 보는 readout은 이것을 자연스럽게 설명합니다: 선택지를 더하면 그것이 읽는 컨텍스트가 바뀝니다. FIRST listwise 순위 매기기 방법도 같은 방식으로 동작하며, 토큰 단위로 생성하는 대신 첫 토큰 logit에서 순위를 추출합니다.11
두 가지 readout이 증거에 들어맞습니다. 최종 위치 헤드는 결정 토큰의 표현으로부터 각 선택지 슬롯을 채점하고, 포인터 방식 scorer는 그 표현을 각 선택지 자체의 최종 은닉 상태와 비교합니다. 둘 다 선택지들이 서로에게 영향을 미치게 합니다. API는 최대 255개(2⁸ − 1)의 선택지를 받는데, 이는 고정된 256 슬롯 헤드에 맞습니다. 그러나 그 한도는 모델이 아니라 요청 검증에 의해 강제됩니다. 선택지가 200개일 때, 복사된 답은 모든 위치에서 1.00을 받았고 오류가 이웃 선택지로 번지지 않았는데, 이는 포인터에 맞습니다. 어느 결과도 결정적이지 않습니다.26
주입된 가짜 선택지는 실제 선택지를 밀어내지 못했습니다. 따라서 선택지 경계는 텍스트가 위조할 수 없는 방식으로 표시되며, 조건이 목록 다른 곳에 중복된 선택지는 경쟁자들에게 확률을 빼앗깁니다.23
그 트레이드오프는 평범한 작업에서도 보입니다: 선택지 순서를 뒤집자 기술 지원 분류의 확률이 대략 0.84–0.89에서 0.93–0.96으로 이동했습니다. 이는 option_order 탐침에서 나왔습니다.9 배포된 결정 정책에서는 이것이 중요합니다. 라벨과 증거가 동일하더라도 0.9 근처의 임계값이 행동을 바꿀 수 있습니다. 순열 테스트는 이 설계를 구현하는 모든 시스템의 평가에 포함되어야 합니다.
5. 분포를 훈련하고, 그다음 신뢰도를 계산하기
다섯 번째 구성 요소는 훈련 목표입니다. 직접 수치 출력은 디코딩 작업을 절약하지만, 값싼 확률이 여전히 나쁜 확률일 수 있습니다.
긴급할 확률 0.8을 부여받은 사례들의 모음을 상상해 봅시다. 캘리브레이션은 그중 약 80%가 실제로 긴급한지를 묻습니다. 그것은 사례 전반에 걸친 예측의 성질입니다. 특정 사례가 잘 끝났는지로부터 그 하나의 예측이 캘리브레이션되었는지를 판단할 수는 없습니다.
TypeSafe는 자신의 훈련 방법을 Reinforcement Learning for Calibrated Decisions, 줄여서 RLCD라고 부릅니다. 출시 발표는 “System One 작업에서 인식론적으로 정직한 확률을 가진 답”을 최적화한다고 말하며, 회사의 입문 자료는 RLCD를 사전 학습된 언어 모델로부터의 사후 학습 경로로 제시합니다.112 정확한 레시피는 공개되지 않았습니다. 제가 제안하는 훈련 레시피는 결과 기반 목표를 사용해 트랜스포머와 readout을 타입이 지정된 결정 작업에 맞게 개조합니다. 이는 백본에 유창한 완성문이 아니라 신뢰할 만한 결정에 유용한 표현을 구성할 기회를 줍니다.
자연스러운 목표는 관측된 결과 에 대한 log loss, 즉 입니다. 또 다른 것은 예측 분포와 관측된 one-hot 결과 사이의 제곱 거리인 Brier loss입니다. 둘 다 proper scoring rule입니다: 기대값에서 참 조건부 분포를 보고하면 손실이 최소화됩니다. Gneiting과 Raftery가 형식적 정의와 이론을 제공합니다.13 이는 그런 훈련이 무엇을 달성하려는지 설명합니다. TypeSafe가 어느 손실을 쓰는지, 그 파이프라인이 좁은 알고리즘적 의미의 강화 학습인지, 백본 가중치가 전부 갱신되는지는 증명하지 않습니다.
properness는 배포 보증도 아닙니다. 유한한 데이터, 모델의 한계, 최적화 오류, 분포 이동이 모두 캘리브레이션을 불완전하게 남길 수 있습니다. Guo et al.은 현대 신경망의 캘리브레이션 문제와 사후 조정의 유용성을 모두 보여 줍니다. 훈련과 사후 캘리브레이션은 양립 가능한 메커니즘이며, API는 그 기여를 분리할 수 없습니다.14
관측된 증거. 벤치마크 기록을 통해 예측 확률과 관측 정확도를 전체적으로도, 확률 구간 내에서도 비교할 수 있습니다. 차트가 그 점검들을 보여 줍니다. 평균의 일치만으로는 구간 내 일치보다 약한 증거입니다: 한 집단의 과신이 다른 집단의 과소신을 상쇄할 수 있습니다. 1,200개 항목의 MMLU 표본에서 열 구간 기대 캘리브레이션 오차는 0.0313이었습니다(구간 정의와 항목별 예측). 대부분의 예측이 확실성 근처에 집중되었습니다: 990개가 0.9–1.0 구간에 들어갔습니다.15
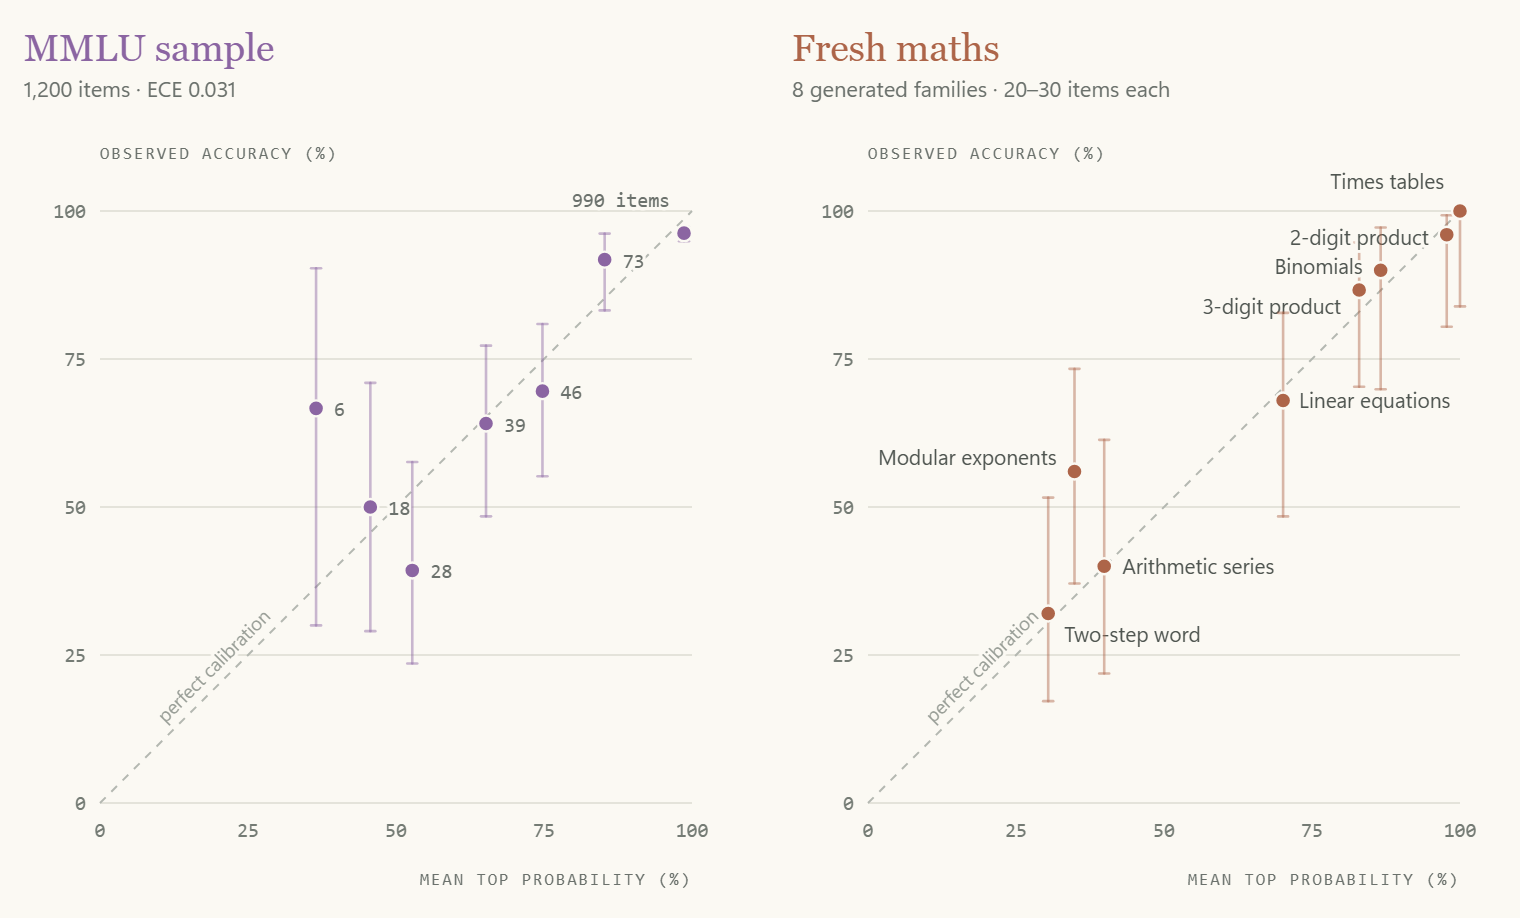
작은 신선한 수학 연구는 유용한 변이를 더합니다. 생성된 세 자리 곱셈 문제에서 정확도는 86.7%, 평균 최고 확률은 0.83이었습니다. 두 단계 문장제 문제에서는 정확도가 32%로, 평균 최고 확률이 0.30으로 떨어졌습니다. 모델은 더 어려운 작업에서 덜 확신했습니다(fresh_math_results, 곱셈 30개와 문장제 25개 항목).15 고무적이지만, 작은 범주 수준 평균으로 모든 종류의 보지 못한 문제에 대한 캘리브레이션을 입증할 수는 없습니다.
그 결과들은 공개 벤치마크 점수가 모델이 아는 것에 대한 불완전한 척도인 이유도 보여 줍니다. MMLU-Pro 정확도는 84.6%였고, 새로 생성한 문장제 문제는 훨씬 어려웠습니다.15 작업 구조, 방해 항목, 난이도, 훈련 노출의 차이가 모두 기여할 수 있습니다. 그 격차가 벤치마크 오염을 증명하지는 않습니다. 새로운 문구라고 해서 기저의 수학적 기술이나 사실 지식이 보지 못한 것이 되는 것도 아닙니다.
API의 confidence라는 필드에 관해 별개로, 유난히 분명한 발견이 있습니다. 공식 어댑터는 정규화된 분포로부터, 일 때 Choice 신뢰도를 이렇게 계산합니다:
최대 확률이 0.8인 선택지 세 개에 대해 이는 0.7을 줍니다. 어댑터는 선택지가 하나인 경우를 따로 처리해 1을 반환합니다. 이것은 선두 답이 균등 분포보다 얼마나 위에 서 있는지를 측정합니다. 답이 옳다는 또 하나의 학습된 추정치는 아닙니다. Score 타입은 최빈 단계로부터의 거리를 반영하는 다른 공식을 사용합니다.16
제안된 시스템에서 훈련은 예측 분포를 만들고, 평범한 산술이 이 요약 필드를 만듭니다. 그 두 대상을 분리해 두면 흔한 개념적 실수를 막습니다: 집중된 분포도 여전히 확신에 차서 틀릴 수 있습니다.
6. Sparse 용량
저는 Jev가 sparse mixture-of-experts 트랜스포머를 사용한다고 예상합니다. 선택된 레이어에서 라우터가 각 토큰을 소수의 피드포워드 네트워크 부분집합으로 보내므로, 모델은 많은 파라미터를 저장하면서 각 토큰마다 그중 일부만 활성화할 수 있습니다. Shazeer et al.의 sparsely gated MoE 레이어가 보여 준 조건부 계산 아이디어입니다.17
sparse expert는 외부에서 관측할 수 없지만, 유력한 선택입니다. prefill만 하는 모델은 계산량에 제약을 받는데, 이는 바로 sparse 라우팅이 절약해 주는 것입니다. MoE의 통상적인 서빙 비용은 대부분 사라집니다: 메모리 대역폭이 지배하고 대부분의 expert가 어차피 활성화되는 토큰 단위 디코딩이 없고, expert 가중치와 메모리를 다투는 장수명 KV cache도 없습니다. 측정도 같은 방향을 가리킵니다. Jev는 약 30k 토큰을 대략 160 ms에 처리했습니다. 8×H100 노드에서 dense 70B 모델이라면 1초 정도가 필요하겠지만, 활성 파라미터가 약 10B인 MoE라면 들어맞습니다. 그리고 최근 가장 강력한 기반 모델 대부분(DeepSeek-V3, Qwen3, GLM-4.5, Kimi K2, gpt-oss)이 MoE입니다. 특화 하드웨어라면 dense 모델도 그 속도를 낼 수 있고, 벤치마크 점수는 모델이 지닌 지식을 과대평가할 수 있으므로, 이것은 여전히 측정이 아니라 추론입니다.615
복원에서 다른 어떤 것도 이것에 의존하지 않습니다. dense 트랜스포머로 바꿔 넣어도 인터페이스, 공유 상태, 격리된 분기, readout은 서술한 그대로 남습니다.
7. 분기를 대화가 아니라 배치로 스케줄하기
마지막 구성 요소는 질문 분기를 독립적인 작업 항목으로 취급하는 서빙 엔진입니다. 그 접미사들은 공유 상태 표현을 읽으면서 배치로 패킹될 수 있습니다. 그런 다음 응용 코드가 수치 출력을 질문 식별자와 연결하고 응답을 직렬화합니다.
측정은 반복된 동일 답변 사이의 작은 차이를 드러내며, 한 요청 안의 중복 질문 사이에서도 그렇습니다. 이는 API 수준의 결정성을 가정해서는 안 된다는 뜻입니다(noise, dup, determinism).19 모델이 텍스트를 생성하거나 샘플링한다는 뜻은 아닙니다: 수치 커널, 동적 배칭, 라우팅, 또는 의도적 무작위성이 모두 직접 readout에 영향을 줄 수 있습니다.
응답 키 순서도 소수의 반복되는 패턴으로 달라졌습니다.19 서로 다른 해시 순서를 가진 여러 워커가 그럴듯한 설명입니다. 그러나 이 부채널은 워커 수를 특정하지도, KV cache가 어디에 있는지 밝히지도, 어떤 수치 정밀도를 쓰는지 알려 주지도 않습니다. 그것들은 가용한 관측으로 해결할 수 없는 구현 세부 사항입니다.
제안된 아키텍처에 중요한 것은 답들 사이에 의존성 사슬이 없다는 점입니다. 모델은 긴급도 추정을 시작하기 전에 큐 분류 작성을 끝낼 필요가 없습니다. 둘 다 상태에 의존하며, 어느 쪽도 상대가 생성한 답을 소비하지 않습니다.
여전히 의존성 한계는 있습니다. 뒤의 질문이 앞의 답을 진짜로 필요로 한다면, 응용은 또 하나의 결정 단계를 도입하거나 공동 결정을 질문 하나로 표현해야 합니다. 컨텍스트를 공유한다고 해서 워크플로의 논리적 구조가 사라지지는 않습니다.
무엇이 제 생각을 바꿀까요?
이 복원은 서로 다른 종류의 주장을 합니다. 직접 확률 출력은 공개적으로 서술되어 있습니다. 질문 격리와 선택지 순서 효과는 관측 가능한 행동입니다. KV 공유, 인과적 어텐션, 최종 위치 또는 포인터 방식 readout, sparse expert는 점점 더 구체적인 설명입니다.
참조 카드 실험은 한 가지 질문을 매듭짓습니다: 결정은 마지막에 놓인 선택지를 사용할 수 있습니다. 가짜 선택지 테스트는 입력 형식의 속임수가 선택지 경계를 위조할 수 없음을 보여 줍니다. 더 넓은 관계적 작업은 표현을 더 제약할 수 있지만, 행동적 성공만으로는 여전히 어텐션 마스크를 유일하게 특정하지 못합니다.
선택지 처리에 관해서는, 무작위 후속 실험이 선택 집합 효과를 재현했지만, 크기를 고정한 설명 개입은 여전히 결론이 나지 않습니다. 더 많은 템플릿과 독립적 요청 블록은 공유 온도 변화와 내용 의존적 상호작용을 구별할 수 있을 것입니다. 선택지 200개에서 중간 정도 난이도의 작업이라면 슬롯 헤드와 포인터 scorer를 분리할 수 있을 것입니다. 캘리브레이션에 관해서는, 홀드아웃 워크플로 데이터와 분포 이동 하의 반복 평가가 또 하나의 집계 벤치마크 점수보다 중요할 것입니다. sparse expert를 확인하려면 아마도 이 API를 넘어서는 공개나 증거가 필요할 것입니다.
Jev에 대한 제 최선의 복원은 여전히 서두의 그림에 있는 것입니다: 공유 상태 접두사, 격리된 질문 접미사, listwise 선택지 처리, 타입이 지정된 수치 readout, 예측 분포를 겨냥한 훈련을 갖춘 인과적 트랜스포머입니다. sparse expert가 유력한 백본이지만, 설계의 다른 어떤 것도 그것에 의존하지 않습니다.
그 유용성은 계산 그래프를 작업에 맞추는 데서 나옵니다. 결정 서비스는 증거를 읽고, 허용된 결과를 비교하고, 불확실성을 드러내야 합니다. 트랜스포머는 모든 결정을 먼저 문장으로 바꾸지 않고도 그것을 할 수 있습니다.
방법
이 글은 2026년 9월 17일 jev-1.13.0에 대한 조사를 바탕으로 하며, 얼리 액세스 계정 하나와 관측된 서비스 리전 하나를 사용했습니다. 원 연구에는 1,029개의 계측된 탐침 기록(생성 수학 항목 190개 포함), 6,800개의 벤치마크 기록, 그리고 별도의 사실 점검이 들어 있습니다. 후속 연구는 관계 및 선택지 상호작용 요청 146개(시험, 요약), 토큰 회계 요청 311개, tokenizer 지문 요청 445개, 지연 시간 요청 192개, 선택지 수 지연 시간 요청 148개, 선택지 위치 요청 181개, 가짜 선택지 요청 105개, 컨텍스트 한도 요청 35개를 더했습니다. 각각은 정확한 요청과 정제된 응답과 함께 참고 문헌에서 링크되어 있습니다. 반복된 벤치마크 구성은 기저 항목을 공유하므로, 이 수는 독립적인 문제의 수가 아닙니다.
다운로드 가능한 증거 묶음은 이 글에서 사용한 관측을 기록합니다. 서두의 API 예시는 도식적입니다. 인용된 visibility와 참조 카드 프롬프트는 탐침 스크립트와 저장된 후속 요청에서 가져온 것입니다. 수치 관측은 이 모델 버전과 테스트 캠페인에 특정됩니다.
지연 시간 수치는 x-envoy-upstream-service-time 응답 헤더에서 옵니다. 그것은 고립된 모델 타이밍이 아니라, 큐잉과 실행 경계가 알려지지 않은 업스트림 서비스 소요 시간입니다. 지연 시간 그림의 스윕은 뒤섞은 순서로 한 번에 하나씩 실행했습니다. 어느 연구도 서버 부하를 통제하지 않았습니다. 로컬 벽시계 측정은 아키텍처적 증거로 사용하지 않습니다.
확률은 대체로 소수 둘째 자리 정밀도로 반환되었습니다. 한 요청 안의 중복 질문은 조건을 공유하며 상관된 오류를 가질 수 있습니다. MMLU 캘리브레이션 그림은 폭이 같은 열 구간, 즉 [0, 0.1), [0.1, 0.2) 등을 사용하며 1.0은 마지막 구간에 포함됩니다. 기대 캘리브레이션 오차는 각 구간에서 정확도와 평균 최고 확률 사이의 표본 가중 절대 차이입니다. 추정은 표본 선택, 구간 나누기, 응답 반올림에 의존합니다. 증거는 테스트한 분포에 대한 주장을 뒷받침할 뿐, 미래 고객 워크플로 전반의 보장된 캘리브레이션을 뒷받침하지 않습니다.
출처와 관련 연구
실험 참고 문헌은 각 관측을 증거 묶음에서 찾을 수 있도록 원래 스크립트 태그를 밝힙니다. 논문 인용은 제안된 메커니즘과 그 선례를 뒷받침할 뿐, Jev가 그것들을 사용한다는 것을 증명하지는 않습니다.
출처
- TypeSafe (2026). Introducing System One Models and Jev. 병렬 출력 주장과 명시된 RLCD 목표의 일차 출처.
- TypeSafe. 전체 API 문서, 2026년 9월 17일 접속. 타입이 지정된 질문, 응답 분포, API 계약.
- Vaswani et al. (2017). Attention Is All You Need. 디코더 마스킹, 어텐션, 선형/softmax 출력 레이어.
- API 실험: type_preamble과 outputs. 토큰 회계 가산성, 식별자 변경, 255 선택지 응답.
- API 실험: visibility. 비밀이 형제 질문에 있을 때, 그 형제에 없을 때, 상태에 있을 때를 각각 다섯 번 반복.
- 지연 시간 스윕(순차 요청 192개). 상태 길이와 질문 수, 각각 뒤섞어 8회 반복; 서버가 보고한 업스트림 소요 시간.
- Juravsky et al. (2024). Hydragen: High-Throughput LLM Inference with Shared Prefixes.
- Yao et al. (2024). DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference.
- API 실험: option_order. 평범한 티켓 순서 민감성.
- API 실험: iia. 조건마다 요청 세 개, 각각 중복 질문 마흔 개; 원래, 덧붙인, 앞에 붙인 선택 집합.
- Reddy et al. (2024). FIRST: Faster Improved Listwise Reranking with Single Token Decoding.
- TypeSafe. 머신러닝 입문. RLCD 사후 학습 경로와 캘리브레이션 계약에 대한 일차 서술.
- Gneiting and Raftery (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association 102(477):359–378.
- Guo et al. (2017). On Calibration of Modern Neural Networks.
- 벤치마크 및 생성 수학 기록: 정확도와 평균 예측 확률. ; MMLU 신뢰성 분석: 구간 정의, ECE, Wilson 구간, 1,200개 항목별 예측.
- TypeSafe. 공식 Python 어댑터, confidence_metrics.py, 리비전 fb52b103. Choice와 Score 신뢰도 공식(2026년 9월 17일 확인).
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer.
- Tokenizer 지문 실험(요청 445개). 런렝스, 어휘, 사전 토큰화 탐침을 192개 공개 tokenizer와 비교.
- API 실험: noise, dup, determinism. 반복된 확률과 응답 키 순서.
- 후속 관계 실험(요청 96개). 템플릿 둘, 참조 값 둘, 순열 여섯, 위치 둘, 반복 둘; 정확한 요청과 정제된 응답.
- 후속 선택지 상호작용 실험(요청 50개). base4, null4, append5, replace5, null5의 무작위 블록 열 개; 짝지은 변화와 표준 오차.
- 컨텍스트 한도 실험(순차 요청 35개). 분기별 및 요청 전체 토큰 한도, 수용·거부 경계 사례 포함.
- 가짜 선택지 주입 실험(요청 105개). 구분자 형식 일곱, 포화·모호 기본 작업, 전체 확률 벡터.
- 토큰 회계 실험(요청 311개). 질문 ID 길이, 배치 크기, 상태 난이도, 단어 ID, 상태 대 ID 문자열 매칭.
- 선택지 수 지연 실험(요청 148개). 2–200개 선택지로 질문 하나 또는 20개, 짧은·긴 라벨, 입출력 분리 대조 포함.
- 선택지 위치 실험(요청 181개). 선택지 수 상한, 10·50·200·255 선택지 목록에서 정답 이동.
출처: Jev’s Architecture Unmasked — Archer, archerhume.com, 2026년 9월 17일.