Архитектура Jev без прикрас
Я зондировал Jev 10,000 вызовами API, чтобы приблизительно понять, как он устроен, и почему большинство мнений ловкачей в X полностью неверны. X полон горячих мнений о запуске Jev, и большинство промахивается мимо сути: «12 миллионов просмотров ради JSON-классификатора? Да, мы в пузыре.» Обычная LLM генерирует «уверена на 90%» как текст; её вероятность произвести эти слова не устанавливает 90%-ную вероятность оказаться правой. И всё же мы строим обнаружение мошенничества, модерацию, маршрутизацию и оценку рисков ровно вокруг этого паттерна: платим за генерацию токен за токеном, а затем обращаемся с невалидированным заявлением об уверенности как с вероятностью, на которую наш софт может действовать.
Предложение Jev — сохранить знание предобученной LLM, заменив сгенерированные заявления об уверенности вероятностями решений, считанными напрямую из его внутренних представлений. Эти вероятности обучаются против исходов. Дайте ему общие состояние, вопросы и разрешённые ответы; он возвращает распределения параллельно, не генерируя текст.1 Для всего этого класса приложений это решает обе проблемы: надёжность сигнала решения и лишние вычисления, потраченные на его производство.
Есть только одна проблема: это не открытые веса, и TypeSafe отказывается делиться своими исследованиями… Так что я (попробую сделать всё, что смогу).
Данные указывают на причинный transformer (вероятно, использующий разреженный MoE), перепрофилированный для решений: кодирование общего состояния, изолированные ветки вопросов и прямые считывания вероятностей вместо генерации текста. После зондирования API TypeSafe (в поисках сигнатур в масштабировании задержки при разных длинах контекста, переупорядочивании вопросов и т. д.), прочёсывания публичной документации и исследований с Astra и поиска предшествующих работ, я думаю, у меня есть довольно точная модель того, как это работает, и его архитектуры.
Разреженная основа — наименее определённая часть, но она особенно выгодна для этой области, с меньшими недостатками, чем у авторегрессионных LLM, так что было бы странно, если бы её не было. Общие вычисления и прямые вероятностные выходы, очевидно, подтверждены гораздо лучше. Всё это явно весьма умозрительно, так что я постараюсь быть как можно яснее насчёт того, какие данные опубликовал TypeSafe, что наблюдалось в экспериментах и что из них выведено. Чёрные ящики API делают до смешного лёгким накинуть покрывало на призрака и получить грубую форму того, как выглядит архитектура.
Почему этот дизайн полезен
Рассмотрим схематичный запрос маршрутизации поддержки. Он иллюстрирует структуру API; примеры вероятностей ниже выдуманы.
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}
Полезный ответ мог бы назначить payments вероятность 0.91, а срочной эскалации — только 0.42. Это разные неопределённости. Софт может маршрутизировать тикет автоматически, оставив эскалацию отдельной политике.
Причинный transformer уже умеет строить представление текста слева направо. При обычном инференсе языковой модели он обрабатывает промпт, предсказывает один токен, подаёт этот токен обратно и повторяет. Это опирается на внимание декодера и выходную проекцию из оригинального Transformer.3 Но этап обработки промпта уже произвёл богатое представление. Если задача — выбрать одну из трёх очередей, мы можем прикрепить небольшую функцию, отображающую это представление напрямую в три числа.
Одна деталь снимает большую часть путаницы вокруг параллельных ответов: причинное внимание описывает, какие позиции могут использовать какую информацию, а не порядок, в котором должны исполняться входные токены. Во время обработки промпта, или prefill, все входные токены уже известны. Модель может обрабатывать их позиции вместе внутри слоя, пока маска внимания блокирует доступ к более поздним позициям; слои по-прежнему идут последовательно. Авторегрессионное декодирование добавляет ещё одну зависимость: следующего токена не существует, пока не выбрано предыдущее предсказание. Наша предлагаемая модель заканчивается после prefill и считывания, поэтому избегает этой зависимости токен за токеном.
Это меняет вычислительную форму задачи. Выходу больше не нужна последовательность решений о написании для "payments": 0.91. Форматирование JSON происходит в обычном коде приложения. Нейросеть поставляет вероятности.
Теперь предположим, что состояние — это длинный отчёт об инциденте, и есть пятьдесят вопросов. Большая часть входа общая. Transformer хранит промежуточную информацию об обработанных токенах в своём кэше ключ–значение, обычно сокращаемом до KV cache. В предлагаемом дизайне каждый вопрос читает один и тот же кэш состояния. Каждая ветка добавляет только свои инструкции и варианты ответов.
Для состояния из токенов и вопросов отдельные запросы обработали бы состояние примерно раз. Совместное использование сокращает повторную обработку токенов состояния с до . Вопросам всё ещё нужно внимать состоянию; эта работа не исчезает. Но модели не нужно многократно реконструировать представления состояния.
Изоляция также придаёт интерфейсу полезный смысл. Вопрос о том, злится ли клиент, не должен менять, какая очередь получает тикет. Оба вопроса могут изучать одни и те же свидетельства, не читая инструкции друг друга. Ветки не имеют вычислительной зависимости друг от друга, даже когда их ответы статистически связаны.
Наконец, вероятности делают последующую политику явной. Если ненужная эскалация стоит одну единицу, а пропущенный срочный случай — девять, упрощённое правило решения эскалирует когда . Этот расчёт осмыслен лишь в той мере, в какой вероятности надёжны для этого рабочего процесса. Обучение и оценка распределения вероятностей таким образом становится частью продукта, а не косметическим полем уверенности.
Ничто из этого не требует диффузии. Параллельная классификация существует десятилетиями. Интересна комбинация: широко способный transformer, общие контекстные вычисления, типизированный выходной интерфейс и обучение, вознаграждающее полезную неопределённость.
1. Завершайте инференс чтением
Первый компонент самый простой: голова предсказания вместо цикла декодирования.
Опубликованные данные. В анонсе запуска TypeSafe сказано: «Jev выводит все вероятности параллельно вместо авторегрессионной генерации по токенам». Его документация предоставляет конечные варианты, решения да/нет и упорядоченные оценки. Их естественно представляют фиксированные числовые выходы.12
Наблюдаемые данные. API всё ещё сообщает поле output_tokens, которое звучит как запись генерации. Это не она. Для вопросов да/нет счёт сходится точно: 4 общих токена плюс 15 на ответ плюс длина в токенах идентификатора каждого вопроса. В документации TypeSafe сказано, что этот идентификатор «не отправляется в нижележащую модель и не используется при инференсе». Счёт, меняющийся от текста, которого модель никогда не видит, вычисляется после инференса, из сериализованного ответа. Возвращаемые значения тоже на него не влияют: ответ 0.0 стоит столько же, сколько 0.01, хотя каждая цифра иначе считается за токен.224
Токенизатор за этим счётом не совпадает ни с одним из 192 публичных токенизаторов, которые мы тестировали. Он совпадает с собственным счётчиком входа Jev для обычного текста, отличаясь только на длинных последовательностях пробелов и пунктуации. output_tokens — это биллинговая величина. Она ничего не говорит о том, генерирует ли Jev текст, и не измерила бы этот текст, даже если бы он это делал. Задержка тоже не следует за этой величиной: вопрос с 200 вариантами (1,911 выходных токенов) вернулся так же быстро, как вопрос с двумя, и серверное время росло только с длиной входа.2425
Ответ с 255 вариантами сообщил 2,714 выходных токенов.4 Было бы ошибкой разделить это число на длительность запроса и назвать результат скоростью декодирования модели. Сервер может сериализовать тысячи символов после одной оценки модели. Учётное поле не говорит нам, сколько нейросетевых шагов декодирования произошло.
Предлагаемое считывание берёт финальный скрытый вектор и производит логиты:
Здесь — число разрешённых ответов. Матрица превращает представление в оценки ответов; softmax превращает эти оценки в распределение. Для решения да/нет хватило бы одного скаляра и сигмоиды.
Классы не обязаны быть фиксированными понятиями вроде «payments». Они могут быть слотами вариантов: первый вариант, второй вариант, третий вариант. Ветка задаёт смысл каждого слота; код приложения отображает его вероятность обратно в ключ варианта вызывающей стороны. Упорядоченный Score аналогично может предсказывать вероятности по уровням и возвращать их взвешенное по вероятностям среднее. Это поддерживает новые решения без обучения новой головы под метки каждого клиента. Pointer-подход к оцениванию, сравнимый в разделе 4, — основная альтернатива: он оценивает собственное представление каждого варианта, а не нумерованный слот.
Это не доказывает, что у Jev есть отдельно названный модуль классификатора. Словарная голова языковой модели — тоже матрица, за которой следует softmax. Выбор зарезервированных строк меток из этой матрицы может реализовать то же вычисление, что и выделенная голова на классов. Строки могут быть связаны с входными эмбеддингами или обучены независимо; здесь мы не можем различить эти варианты.
Важное различие — между считыванием вероятностей и генерацией текста, описывающего вероятности. Сгенерированное «91%» — это последовательность токенов. 0.91 классификатора — запись в его предсказательном распределении. И то и другое может быть плохо калибровано. Ни одно из них не становится надёжным лишь благодаря своему формату.
Ограниченное текстовое декодирование остаётся возможным способом построить похожий интерфейс, но TypeSafe явно описывает другой путь вывода. Его заявление — более сильное доказательство, чем аргумент от задержки. Данные указывают на прямое числовое считывание — один из двух дизайнов, сравнимых в разделе 4. Зарезервированные токены меток остаются возможными, хотя тамошний тест с поддельными вариантами говорит против них.
2. Общее состояние, изолированные вопросы
Следующее решение касается того, где переиспользуются вычисления.
Наблюдаемые данные. Учёт токенов точно аддитивен в малых контролируемых примерах. Один минимальный вопрос да/нет использовал 268 входных токенов; два — 276. Запрос, содержащий один вопрос да/нет, один Choice с двумя вариантами и один Score с двумя уровнями, использовал 318, что совпадает с суммой их измеренных вкладов сверх общей накладной стоимости. Это согласуется с общим префиксом плюс суффиксами вопросов, хотя один учёт не выявляет вычислительный граф.4
Более информативный эксперимент перемещает свидетельство между этими областями. Изначально состояние гласило:
The weather is nice today and the park is full of people.Соседний вопрос содержал:
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
Проба спрашивала, какой код упомянул другой вопрос, с ZEBRA-7741, двумя отвлекающими и none в качестве вариантов. Когда секрет был в соседнем вопросе, его сообщённая вероятность составила 0.00. Удаление этого соседа дало тот же результат. Помещение объявления в состояние вместо этого подняло её до 0.90–0.92. Это были пять повторов на условие (visibility в записях пробы).5
Это полезное вмешательство: перенос объявления через границу API меняет его эффект. Это подтверждает поведенческую изоляцию между вопросами и доступ к общему состоянию. Это не раскрывает точную маску внимания. Отдельные вызовы модели, древовидная маска или другой механизм, ограничивающий поток информации, могли бы дать тот же результат. Формулировка пробы также спрашивает о «другом вопросе» даже в условии состояния, так что это не безупречный тест буквального следования инструкциям.
Измерения сервинга добавляют ещё одну деталь. До примерно 100 вопросов серверное время почти не менялось. Сверх этого оно устойчиво росло, и токен за токеном текст вопроса стоил примерно вдвое дороже состояния. Это согласуется с вычислением состояния один раз и пакетной обработкой работы над вопросами.6
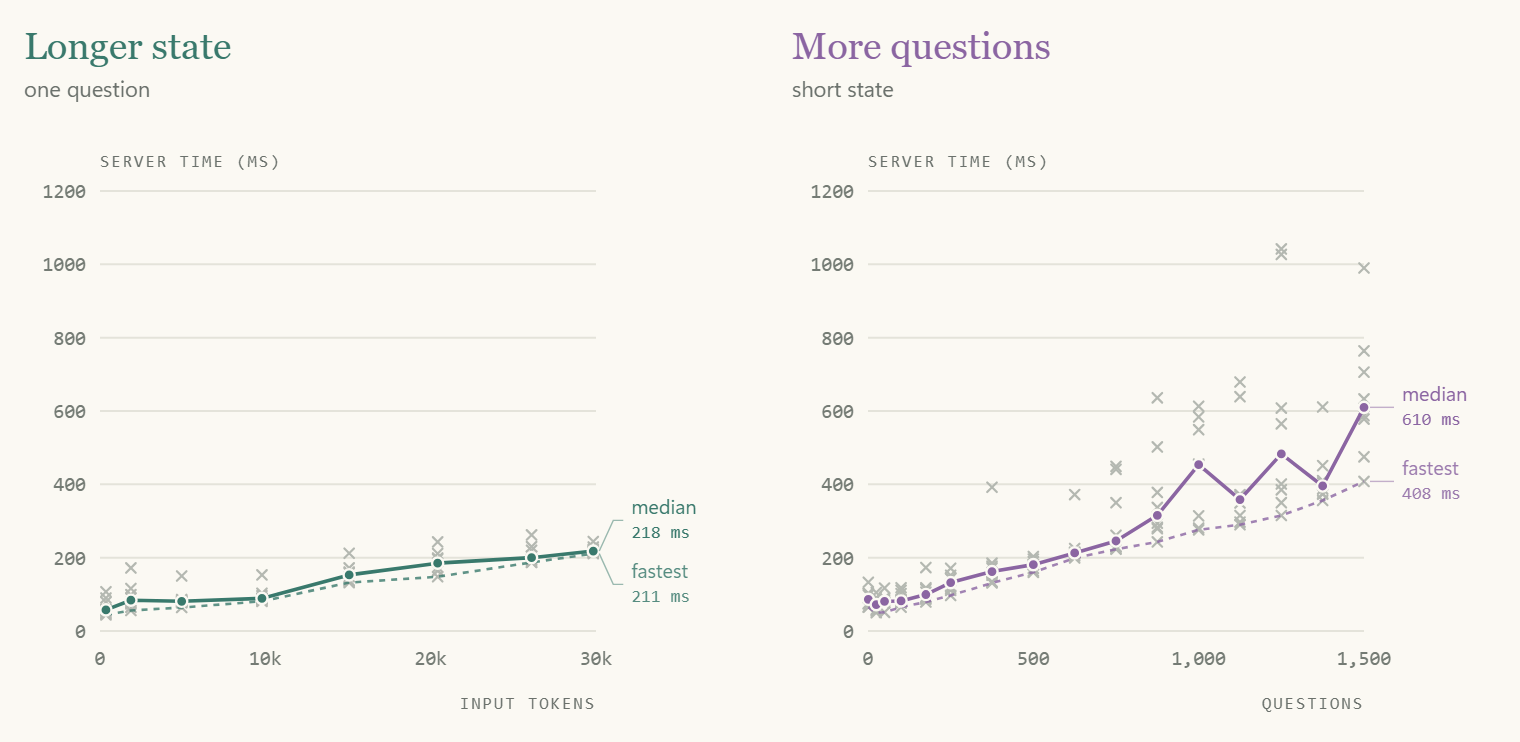
Это сообщённые сервером длительности восходящего сервиса, а не локальные замеры на ноутбуке. Они включают всю работу и ожидание, которые включает восходящий сервис, а сервис был общим с другими пользователями.
Jev устанавливает два лимита. Каждая ветка (состояние плюс один вопрос) ограничена примерно 32,768 токенами, а весь запрос — примерно 65,536. Лимит запроса считает состояние один раз: состояние на 23k токенов с 5,000 вопросов укладывается в него. Если бы каждый вопрос обрабатывал свою копию состояния, этот запрос превысил бы 100 миллионов токенов. Пара укладывается в одну упакованную последовательность до 2¹⁶ токенов, содержащую состояние один раз и каждый вопрос после него, при этом каждая ветка ограничена контекстным окном в 2¹⁵.22
Естественная реализация — префиксный KV-кэш с отдельными причинными суффиксами. Hydragen описывает эффективное внимание для последовательностей с общим префиксом; DeFT разрабатывает внимание для вывода по древовидной структуре. Они устанавливают, что паттерн сервинга практичен. Это предшествующие работы, а не доказательство, что TypeSafe использует какую-либо из этих библиотек.78
Этот дизайн также проясняет кажущееся противоречие: изолированные вопросы всё ещё можно оценивать вместе на одном ускорителе. «Параллельный» описывает их планирование и отсутствие зависимостей по ответам. Это не обязательно означает один GPU на вопрос.
3. Причинная основа
Эксперименты не могут отличить причинный декодер от двунаправленного энкодера: в обоих финальное решение может прочитать весь вход. Я всё равно предполагаю причинный декодер, и не без причины. Широта знаний Jev (84.6% на MMLU-Pro) требует предобучения масштаба фронтира, каждая модель такого масштаба — причинный декодер, а TypeSafe описывает RLCD как пост-обучение предобученной языковой модели. Двунаправленный Jev означал бы либо гораздо более слабую базу, либо конвертацию декодера с дополнительными затратами, с отказом от кэширования общего префикса, которое даёт причинный сервинг. Это было бы удивительно, но снаружи исключить нельзя.1215
Какая предобученная модель — неизвестно, и токенизатор не выдаёт её. Счётчики токенов Jev не совпадают ни с одним из 192 публичных токенизаторов, которые мы тестировали в 415 пробах. Он разбивает каждую цифру по отдельности и ищет целые куски перед слиянием: 8 a считаются за один токен, а 16 — за четыре. Его словарь близко следует за o200k от OpenAI, поскольку каждая строка, которую Jev считает одним токеном, также является одним токеном o200k, но разбиение цифр и несколько слияний исключают сам o200k. Ближайшее публичное совпадение, Qwen, согласуется в 348 из 415 проб. Это исключает неизменённый публичный токенизатор, но не публичную базовую модель: заменённый словарь, продолженное предобучение или дистилляция могли бы объяснить это — как и API, считающий токены не так, как модель.18
Эксперименты всё же показывают, что решение может прочитать. Я поместил справочную карточку среди вариантов вопроса и попросил Jev выбрать вариант, условие которого карточка удовлетворяет. Вот один точный набор вариантов:
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.
Инструкция была: «Прочитай справочную карточку и выбери тот вариант, условие которого выполнено». Смена значения карточки на indigo переключает правильный ответ, оставляя выбираемые варианты неизменными.
Я протестировал оба значения, все шесть перестановок вариантов и второй шаблон с route = east/west, с двумя повторами. Парный контроль помещал справочную карточку в общее состояние вместо этого. Это дало 48 испытаний с карточкой среди вариантов и 48 контролей с карточкой в состоянии.20
| Позиция варианта с карточкой | Правильные ответы |
|---|---|
| Первая | 12 / 16 |
| В середине | 11 / 16 |
| Последняя | 16 / 16 |
| Карточка перенесена в состояние | 48 / 48 |
Jev может использовать информацию, размещённую после описаний кандидатов. Когда карточка была последней, он выбирал правильный вариант в каждом испытании, со средней вероятностью правильного ответа около 0.88.
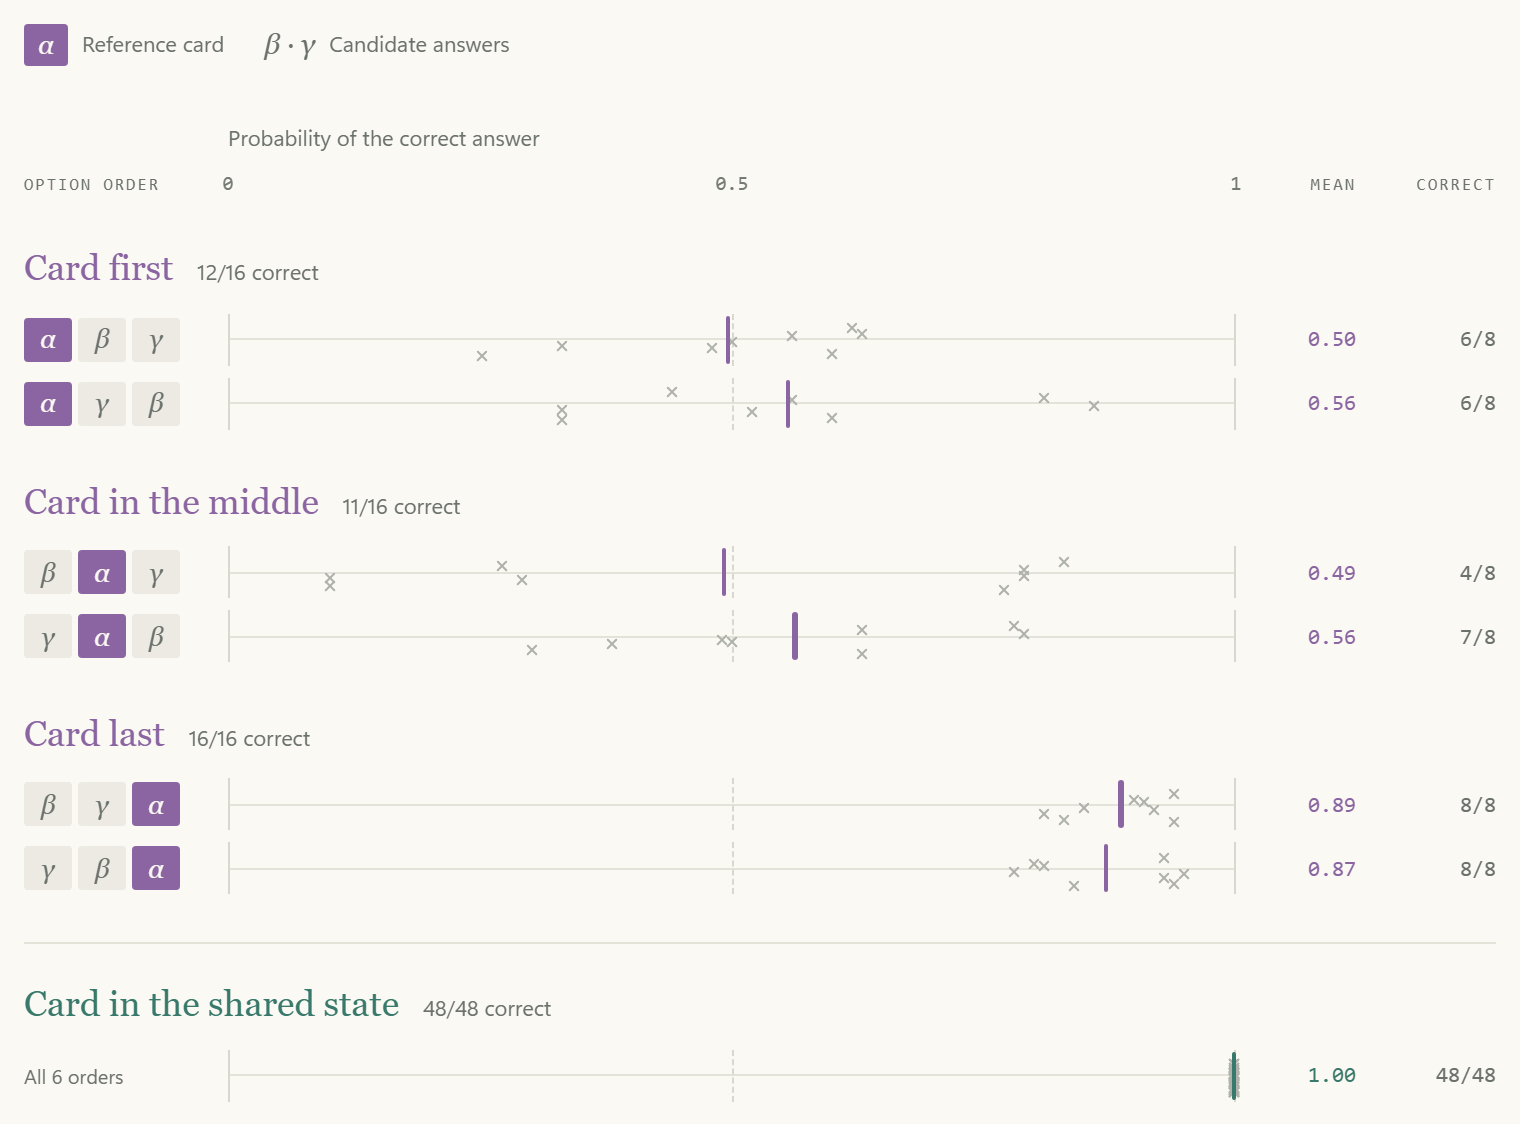
Контроль со сменой значения важен не меньше позиции. Когда карточка последняя, смена только amber на indigo меняет, какой более ранний вариант побеждает, хотя те более ранние описания и состояние остаются идентичными. У модели, которая независимо оценивает каждый вариант по его собственному тексту и состоянию, а затем лишь нормализует оценки, нет пути, по которому этот факт изменил бы относительное ранжирование более ранних вариантов. Результаты поддерживают путь, по которому варианты влияют на совместное решение.20
Это согласуется с любым считыванием, вычисленным после всего списка, включая оба дизайна, сравнимых в разделе 4, а также с отдельной стадией смешивания вариантов. Оставшиеся ошибки показывают чувствительную к позиции обработку на этих двух шаблонах; они не выявляют единственную причину.
Диффузия для этого вычисления не нужна, и ничто в этих экспериментах не требует итеративного шумоподавления. Защитимое архитектурное умозаключение уже: вычисление ответа имеет доступ ко всему списку вариантов. Следующий эксперимент проверяет, действительно ли оно использует этот совместный контекст.
4. Пусть варианты взаимодействуют до выбора
Внутри вопроса данные указывают на другую информационную границу: альтернативы читаются вместе как упорядоченный список, за которым следует одна позиция решения.
Зачем допускать это взаимодействие? Варианты вроде «ничего из перечисленного» зависят от других вариантов. Даже обычные альтернативы могут прояснить вопрос. «Платежи», «доступ к аккаунту» и «другое» определяют иное решение, чем «банк», «платёжный провайдер» и «клиент». Listwise-представление позволяет модели истолковать это различие до порождения распределения.
Сильнейшее доказательство — эксперимент с нерелевантным лишним вариантом.
Начните с четырёх возможных причин сбоя выплаты: bank, provider, customer и unknown. Затем добавьте weather: Bad weather caused it. Если каждый исходный вариант получает независимый, неизменный логит, а сервер применяет ту же температуру softmax, добавление пятого варианта меняет нормировку, но не может изменить шансы между двумя существующими вариантами:
Общий знаменатель сокращается. Это даёт нам конкретное, опровержимое предсказание.
Исходное исследование обнаружило сдвиг примерно с +0.49 до +0.08.10 Чтобы проверить, переживёт ли это обычную изменчивость запросов, я повторил эксперимент в десяти рандомизированных блоках. Каждый блок включал базовую четырёхвариантную версию, идентичный четырёхвариантный контроль, пятивариантную версию с добавленным weather, идентичный пятивариантный контроль и пятивариантную версию, добавленное описание которой менялось с «Bad weather caused it» на «Wild birds caused it». Каждый запрос содержал один вопрос.21
Результат расширения воспроизвёлся. Объединяя два идентичных запроса для каждого условия внутри каждого блока, средние лог-шансы упали с +0.38 до +0.11. Каждый блок показал уменьшение; среднее изменение составило −0.28, с описательным парным t-интервалом 95% примерно от −0.36 до −0.19. Объединение использует контрольные запросы, чтобы уменьшить обычный шум запросов, а не трактует дублирующиеся выходы как независимые эксперименты.21
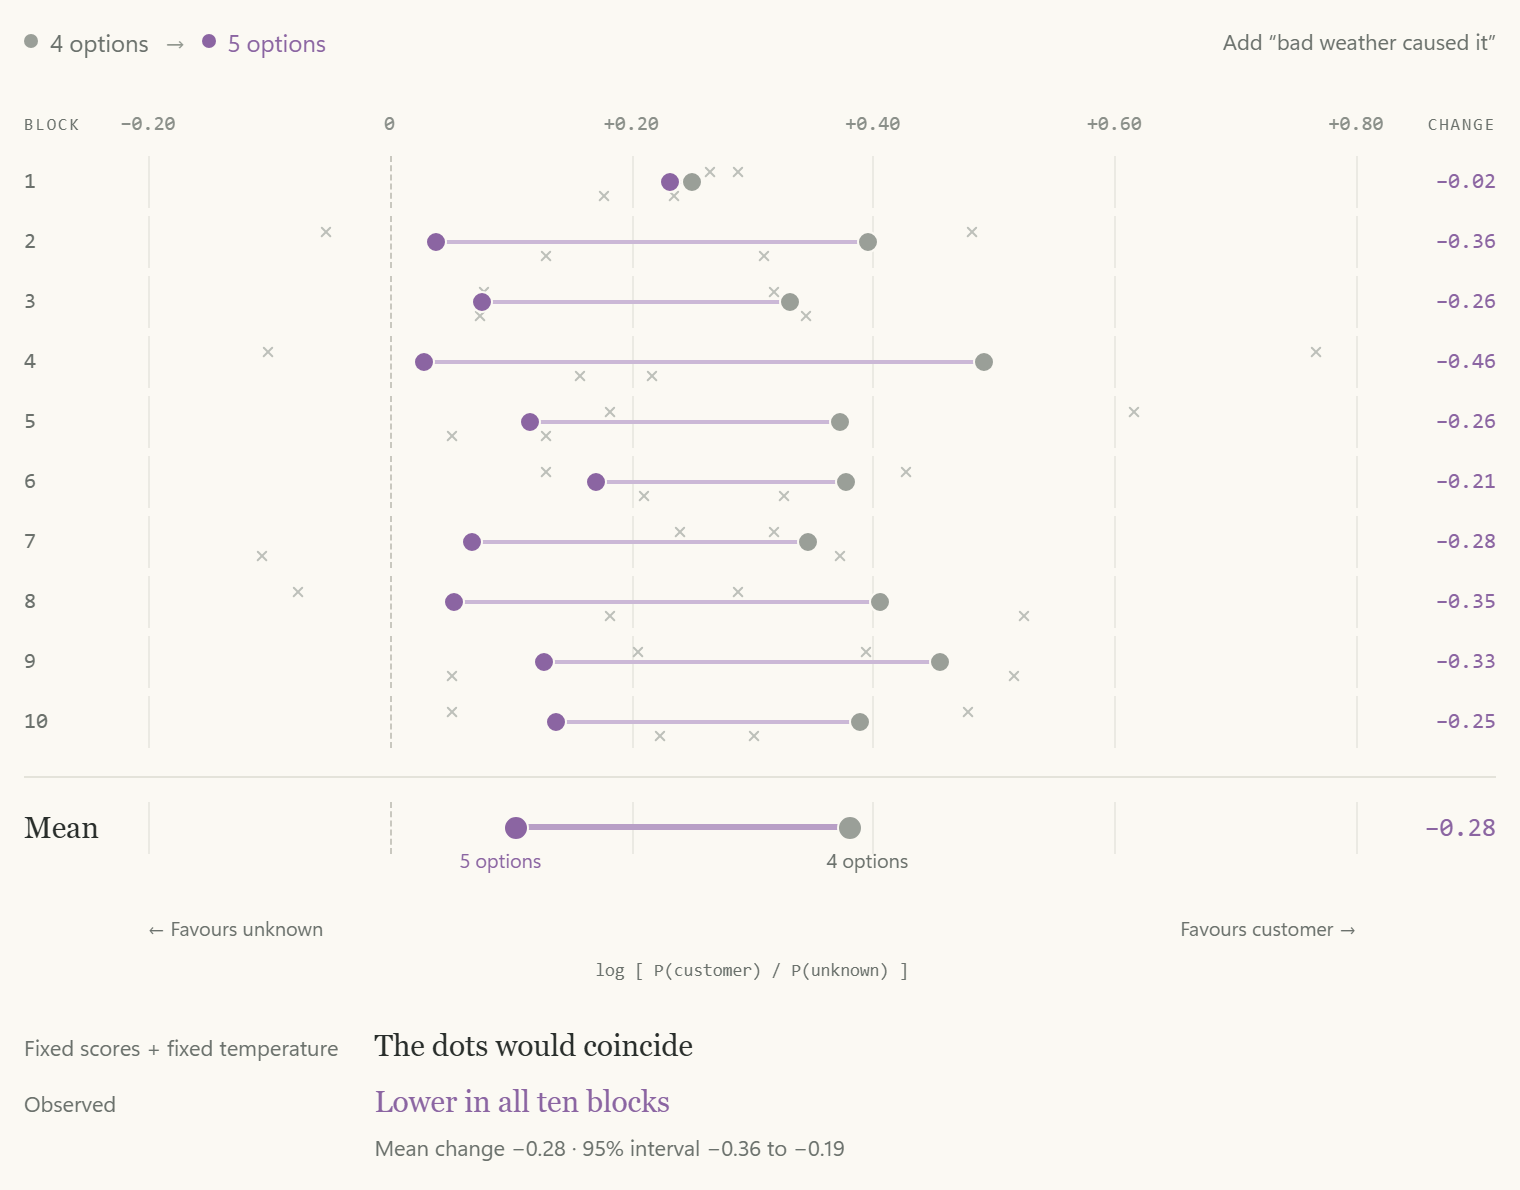
Это доказательство против фиксированных независимых логитов, за которыми следует неизменённый softmax. Оно не выявляет механизм однозначно. Смена добавленного описания при сохранении пяти вариантов дала меньший, неубедительный сдвиг: его парный интервал включал ноль. Зависящая от набора температура остаётся возможной наряду со смешиванием, зависящим от содержания.
Считывание, видящее полный список, естественно это объясняет: добавление варианта меняет читаемый им контекст. Listwise-метод ранжирования FIRST работает так же, извлекая ранжирование из логитов первого токена вместо генерации его токен за токеном.11
Два считывания соответствуют данным. Голова на финальной позиции оценивает каждый слот варианта по представлению токена решения; pointer-подход сравнивает это представление с собственным финальным скрытым состоянием каждого варианта. Оба позволяют вариантам влиять друг на друга. API принимает максимум 255 вариантов (2⁸ − 1), что подходит фиксированной голове на 256 слотов, но этот лимит навязывается валидацией запроса, а не моделью. С 200 вариантами скопированный ответ набрал 1.00 на каждой позиции, а ошибки не перетекали на соседние варианты, что подходит pointer-подходу. Ни один результат не решающ.26
Внедрённые поддельные варианты никогда не вытесняли настоящие, так что границы вариантов помечены способом, который текст не может подделать, а вариант, условие которого дублируется в другом месте списка, теряет вероятность в пользу соперников.23
Компромисс виден и в обычных задачах: обращение вариантов сдвинуло вероятность классификации технической поддержки примерно с 0.84–0.89 до 0.93–0.96. Это вышло из проб option_order.9 Для развёрнутой политики решений это важно. Порог около 0.9 мог бы изменить действие, хотя метки и свидетельства идентичны. Тесты перестановок принадлежат оценке любой реализации этого дизайна.
5. Обучите распределение, потом вычисляйте confidence
Пятый компонент — цель обучения. Прямые числовые выходы экономят работу декодирования, но дешёвая вероятность всё ещё может быть плохой вероятностью.
Представьте набор случаев, которым назначена вероятность 0.8 быть срочными. Калибровка спрашивает, действительно ли примерно 80% из них срочные. Это свойство предсказаний по всем случаям. Мы не можем определить, калибровано ли одно предсказание, по тому, хорошо ли обернулся именно этот случай.
TypeSafe называет свой метод обучения Reinforcement Learning for Calibrated Decisions, или RLCD. В анонсе сказано, что он оптимизирует «ответы с эпистемически честными вероятностями на задачах System One»; букварь компании представляет RLCD как путь пост-обучения из предобученных языковых моделей.112 Точный рецепт не опубликован. Мой предлагаемый рецепт обучения адаптирует transformer и считывание к типизированным задачам решений, используя цель, основанную на исходах. Это даёт основе возможность строить представления, полезные для надёжных решений, а не просто беглых завершений.
Естественная цель — log loss, для наблюдаемого исхода . Другая — Brier loss, квадрат расстояния между предсказанным распределением и наблюдаемым one-hot исходом. Обе — proper scoring rules: в ожидании сообщение истинного условного распределения минимизирует потери. Gneiting и Raftery дают формальное определение и теорию.13 Это объясняет, чего такое обучение пытается достичь. Оно не устанавливает, какую потерю использует TypeSafe, является ли его пайплайн обучением с подкреплением в узком алгоритмическом смысле или обновляется ли каждый вес основы.
Properness — тоже не гарантия развёртывания. Конечные данные, ограничения модели, ошибка оптимизации и сдвиг распределения могут оставить калибровку несовершенной. Guo et al. показывают и проблемы калибровки современных нейросетей, и полезность постфактум-поправок. Обучение и постфактум-калибровка — совместимые механизмы; API не может разделить их вклады.14
Наблюдаемые данные. Записи бенчмарка позволяют сравнить предсказанную вероятность с наблюдаемой точностью — и в агрегате, и внутри бинов вероятностей. График показывает эти проверки. Согласие одних только средних — более слабое доказательство, чем согласие внутри бинов: переуверенность в одной группе может компенсировать неуверенность в другой. На выборке MMLU из 1,200 элементов десятибиновая ожидаемая ошибка калибровки составила 0.0313 (определения бинов и предсказания на уровне элементов). Большинство предсказаний были сосредоточены около уверенности: 990 попали в бин 0.9–1.0.15
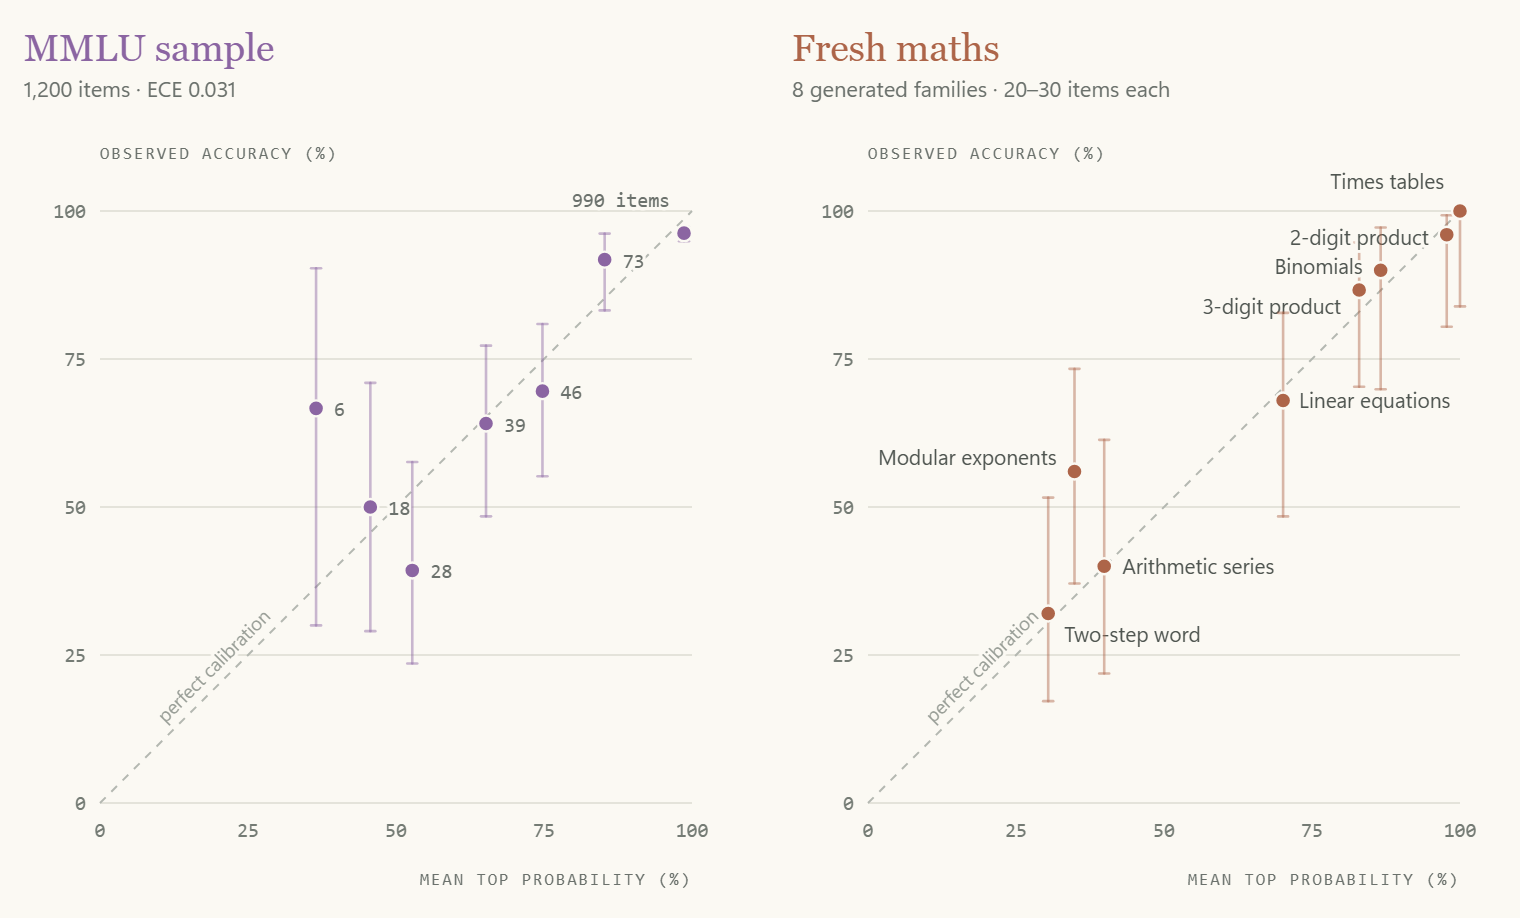
Небольшое исследование на свежей математике добавляет полезную вариацию. На сгенерированных задачах на умножение трёхзначных чисел точность составила 86.7%, а средняя топовая вероятность — 0.83. На двухшаговых текстовых задачах точность упала до 32%, а средняя топовая вероятность — до 0.30. Модель была менее уверена на более трудной задаче (fresh_math_results, с 30 задачами на умножение и 25 текстовыми задачами).15 Это обнадёживает, хотя малые средние по категориям не могут установить калибровку для каждого вида невиданной задачи.
Эти результаты также показывают, почему публичная оценка бенчмарка — несовершенная мера того, что модель знает. Точность на MMLU-Pro составила 84.6%; заново сгенерированные текстовые задачи были гораздо труднее.15 Различия в структуре задачи, отвлекающих, трудности и подверженности обучению могли внести вклад. Этот разрыв не доказывает загрязнение бенчмарка. Свежая формулировка также не делает лежащий в основе математический навык или фактическое знание невиданными.
Есть отдельная, необычно ясная находка о поле API под названием confidence. Официальный адаптер вычисляет уверенность Choice из нормализованного распределения, для , как:
Для трёх вариантов с максимальной вероятностью 0.8 это даёт 0.7. Адаптер обрабатывает случай одного варианта отдельно, возвращая 1. Оно измеряет, насколько лидирующий ответ выделяется над равномерным распределением. Это не ещё одна обученная оценка того, что ответ верен. Тип Score использует другую формулу, отражающую расстояние от модального уровня.16
В предлагаемой системе обучение производит предсказательное распределение; обычная арифметика производит это сводное поле. Разделение этих двух объектов предотвращает распространённую концептуальную ошибку: концентрированное распределение всё ещё может быть уверенно неверным.
6. Разреженная ёмкость
Я ожидаю, что Jev использует разреженный transformer со смесью экспертов. На отдельных слоях роутер пропускает каждый токен через небольшое подмножество сетей прямого распространения, так что модель может хранить много параметров, активируя лишь часть из них для каждого токена: идея условных вычислений, продемонстрированная разреженно-гейтированными слоями MoE от Shazeer et al.17
Разреженных экспертов нельзя наблюдать снаружи, но они — вероятный выбор. Модель только с prefill ограничена вычислениями, а именно их и экономит разреженная маршрутизация. Обычные издержки сервинга MoE в основном исчезают: нет декодирования токен за токеном, где доминирует пропускная способность памяти и большинство экспертов всё равно оказываются активными, и нет долгоживущего KV-кэша, конкурирующего с весами экспертов за память. Измерения указывают туда же. Jev обработал около 30k токенов примерно за 160 мс; плотной модели на 70B на узле 8×H100 понадобилась бы примерно секунда, тогда как MoE с примерно 10B активных параметров укладывается. И большинство сильнейших недавних базовых моделей (DeepSeek-V3, Qwen3, GLM-4.5, Kimi K2, gpt-oss) — это MoE. Специализированное железо могло бы позволить плотной модели сравняться по скорости, а оценки бенчмарков могут завышать, сколько знаний держит модель, так что это остаётся умозаключением, а не измерением.615
Ничто другое в реконструкции от этого не зависит. Замена на плотный transformer оставила бы интерфейс, общее состояние, изолированные ветки и считывание ровно такими, как описано.
7. Планируйте ветки как батч, а не как беседу
Финальный компонент — движок сервинга, который трактует ветки вопросов как независимые единицы работы. Их суффиксы можно упаковать в батчи при чтении общих представлений состояния. Код приложения затем сопоставляет числовые выходы с идентификаторами вопросов и сериализует ответ.
Измерения выявляют небольшие различия между повторными идентичными ответами, в том числе между дублирующимися вопросами внутри одного запроса. Это значит, что детерминизм на уровне API не следует предполагать (noise, dup и determinism).19 Это не подразумевает, что модель генерирует или сэмплирует текст: числовые ядра, динамическое пакетирование, маршрутизация или намеренная случайность могут влиять на прямое считывание.
Порядок ключей в ответах тоже варьировался в небольшом числе повторяющихся паттернов.19 Несколько воркеров с разным порядком хеширования — правдоподобное объяснение. Однако этот побочный канал не выявляет число воркеров, не устанавливает, где живёт KV-кэш, и не говорит, какая числовая точность используется. Это детали реализации, которые имеющиеся наблюдения не могут разрешить.
Для предлагаемой архитектуры важно отсутствие цепочки зависимостей между ответами. Модели не нужно закончить запись классификации очереди, прежде чем начать оценку срочности. Оба зависят от состояния; ни один не потребляет сгенерированный ответ другого.
Ограничение по зависимостям всё же есть. Если более позднему вопросу действительно нужен более ранний ответ, приложение должно ввести ещё одну стадию решения или выразить совместное решение в одном вопросе. Совместное использование контекста не убирает логическую структуру рабочего процесса.
Что заставило бы меня передумать?
Эта реконструкция делает разные по типу допущения. Прямые вероятностные выходы публично описаны. Изоляция вопросов и эффекты порядка вариантов — наблюдаемое поведение. Совместное использование KV, причинное внимание, считывания на финальной позиции или pointer-подхода и разреженные эксперты — это всё более конкретные объяснения.
Эксперимент со справочной карточкой решает один вопрос: решение может использовать варианты, размещённые последними. Тест с поддельными вариантами показывает, что трюки формата входа не могут подделать границы вариантов. Более широкие реляционные задачи могли бы сильнее ограничить представление, хотя один лишь поведенческий успех всё равно не выявил бы маску внимания однозначно.
Что касается обработки вариантов, рандомизированное продолжение воспроизводит эффект набора выбора, но вмешательство с описанием фиксированного размера остаётся неубедительным. Больше шаблонов и независимых блоков запросов могли бы отличить общее изменение температуры от зависящих от содержания взаимодействий. Задача средней трудности с 200 вариантами могла бы отделить слотовую голову от pointer-оценщика. Для калибровки отложенные данные рабочего процесса и повторные оценки при сдвиге значили бы больше, чем ещё одна агрегатная оценка бенчмарка. Подтверждение разреженных экспертов, вероятно, потребовало бы раскрытия или доказательств за пределами этого API.
Моя лучшая реконструкция Jev остаётся той, что на вступительной диаграмме: причинный transformer с общим префиксом состояния, изолированными суффиксами вопросов, listwise-обработкой вариантов, типизированными числовыми считываниями и обучением, направленным на предсказательные распределения. Разреженные эксперты — вероятная основа, хотя ничто другое в дизайне от них не зависит.
Его полезность происходит из соответствия вычислительного графа задаче. Сервису решений нужно читать свидетельства, сравнивать допустимые исходы и выставлять неопределённость. Transformer может это делать, не превращая каждое решение сначала в предложение.
Методы
Это эссе основано на исследовании jev-1.13.0 от 17 сентября 2026 года, с использованием одной учётной записи раннего доступа и одного наблюдаемого региона сервиса. Исходное исследование содержит 1,029 инструментированных записей проб (включая 190 элементов сгенерированной математики), 6,800 записей бенчмарка и отдельные фактические проверки. Продолжающие исследования добавили 146 реляционных запросов и запросов взаимодействия вариантов (испытания, сводка), 311 запросов учёта токенов, 445 запросов отпечатка токенизатора, 192 запроса задержки, 148 запросов задержки по числу вариантов, 181 запрос позиции варианта, 105 запросов поддельных вариантов и 35 запросов лимита контекста. Каждый связан из ссылок, с точными запросами и очищенными ответами. Повторяющиеся конфигурации бенчмарка делят лежащие в основе элементы; эти числа — не число независимых задач.
Загружаемый пакет доказательств фиксирует наблюдения, использованные в этом эссе. Примеры API во вступительном разделе схематичны. Приведённые промпты visibility и справочной карточки взяты из скриптов проб и сохранённых последующих запросов. Числовые наблюдения специфичны для этой версии модели и кампании тестирования.
Числа задержки берутся из заголовка ответа x-envoy-upstream-service-time. Это длительности восходящего сервиса с неизвестными границами очереди и исполнения, а не изолированные замеры модели. Прогоны графика задержки выполнялись по одному запросу за раз в перемешанном порядке; ни одно из исследований не контролировало серверную нагрузку. Локальные измерения настенных часов не используются как архитектурное доказательство.
Вероятности, как правило, возвращались с точностью до двух знаков. Дублирующиеся вопросы в одном запросе делят условия и могут иметь коррелированные ошибки. График калибровки MMLU использует десять бинов равной ширины: [0, 0.1), [0.1, 0.2) и так далее, причём 1.0 включён в последний бин. Ожидаемая ошибка калибровки — взвешенная по выборке абсолютная разница между точностью и средней топовой вероятностью в каждом бине. Оценки зависят от отбора выборки, бинирования и округления ответов. Данные поддерживают утверждения о протестированных распределениях, а не гарантированную калибровку в будущих рабочих процессах клиентов.
Источники и связанные работы
Экспериментальные ссылки указывают исходные теги скриптов, чтобы каждое наблюдение можно было найти в пакете доказательств. Ссылки на статьи устанавливают предлагаемые механизмы и их прецеденты; они не устанавливают, что Jev их использует.
Источники
- TypeSafe (2026). Introducing System One Models and Jev. Первоисточник для утверждения о параллельном выводе и заявленной цели RLCD.
- TypeSafe. Полная документация API, по состоянию на 17 сентября 2026. Типизированные вопросы, распределения ответов и контракт API.
- Vaswani et al. (2017). Attention Is All You Need. Маскирование декодера, внимание и выходной линейно/softmax слой.
- Эксперименты API: type_preamble и outputs. Аддитивность учёта токенов, изменения идентификатора и ответ с 255 вариантами.
- Эксперимент API: visibility. Пять повторов с секретом в соседнем вопросе, вне этого соседа и в состоянии.
- Прогоны задержки (192 последовательных запроса). Длина состояния и число вопросов, по 8 перемешанных повторов; сообщённые сервером длительности восходящего сервиса.
- Juravsky et al. (2024). Hydragen: High-Throughput LLM Inference with Shared Prefixes.
- Yao et al. (2024). DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference.
- Эксперимент API: option_order. Чувствительность к порядку на обычных тикетах.
- Эксперимент API: iia. Три запроса на условие, каждый с сорока дублирующимися вопросами; исходный, с добавленным и с предварённым наборами выбора.
- Reddy et al. (2024). FIRST: Faster Improved Listwise Reranking with Single Token Decoding.
- TypeSafe. Введение в машинное обучение. Основное описание пути пост-обучения RLCD и контракта калибровки.
- Gneiting and Raftery (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association 102(477):359–378.
- Guo et al. (2017). On Calibration of Modern Neural Networks.
- Записи бенчмарка и сгенерированной математики: точность и средние предсказанные вероятности. ; Анализ надёжности MMLU: определения бинов, ECE, интервалы Уилсона и 1,200 предсказаний на уровне элементов.
- TypeSafe. Официальный адаптер для Python, confidence_metrics.py, ревизия fb52b103. Формулы уверенности Choice и Score (прочитано 17 сентября 2026).
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer.
- Эксперимент отпечатка токенизатора (445 запросов). Пробы длины последовательностей, словаря и предтокенизации в сравнении с 192 публичными токенизаторами.
- Эксперименты API: noise, dup и determinism. Повторные вероятности и порядок ключей ответа.
- Продолжающий реляционный эксперимент (96 запросов). Два шаблона, два справочных значения, шесть перестановок, две локации и два повтора; точные запросы и очищенные ответы.
- Продолжающий эксперимент взаимодействия вариантов (50 запросов). Десять рандомизированных блоков base4, null4, append5, replace5 и null5; парные изменения и стандартные ошибки.
- Эксперимент лимита контекста (35 последовательных запросов). Лимиты токенов на ветку и на весь запрос, с принятыми и отклонёнными граничными случаями.
- Эксперимент инъекции поддельных вариантов (105 запросов). Семь форматов разделителей, насыщенные и неоднозначные базовые задачи и полные векторы вероятностей.
- Эксперименты учёта токенов (311 запросов). Длина ID вопроса, размер батча, трудность состояния, ID слов и сопоставленные строки состояния и ID.
- Эксперимент задержки по числу вариантов (148 запросов). Один или 20 вопросов с 2–200 вариантами, короткими и длинными метками, плюс контроли развязки входа/выхода.
- Эксперимент позиции варианта (181 запросов). Ограничение числа вариантов, правильный ответ перемещён по спискам из 10, 50, 200 и 255 вариантов.
Источник: Архитектура Jev без прикрас — Archer, archerhume.com, 17 сентября 2026.