A arquitetura da Jev desvendada
Sondei a Jev com 10,000 chamadas à API para deduzir a grosso modo como ela é construída, e por que a maioria das opiniões de charlatães no X está completamente errada. O X está cheio de opiniões inflamadas sobre o lançamento da Jev, e a maioria erra o ponto completamente: “12 milhões de visualizações por um classificador JSON? Sim, estamos numa bolha.” Um LLM comum gera “90% de confiança” como texto; sua probabilidade de produzir essas palavras não estabelece uma probabilidade de 90% de acertar. E, no entanto, construímos triagem de fraude, moderação, roteamento e avaliação de risco exatamente em torno desse padrão: pagamos por uma geração token a token e depois tratamos uma alegação de confiança não validada como uma probabilidade sobre a qual nosso software pode agir.
A proposta da Jev é conservar o conhecimento de um LLM pré-treinado e, ao mesmo tempo, substituir alegações de confiança geradas por probabilidades de decisão lidas diretamente de suas representações internas. Essas probabilidades são treinadas contra resultados. Dê a ela um estado, perguntas e respostas permitidas compartilhados; ela retorna as distribuições em paralelo, sem gerar texto.1 Para toda essa classe de aplicações, isso resolve os dois problemas: a confiabilidade do sinal de decisão e o cálculo desnecessário gasto para produzi-lo.
Há só um problema: ela não é de pesos abertos, e a TypeSafe se recusa a compartilhar sua pesquisa… Então eu vou (tentar o meu melhor).
As evidências apontam para um transformer causal (provavelmente usando MoE esparso) reaproveitado para decisões: codificação de estado compartilhado, ramos de perguntas isolados e leituras diretas de probabilidade em vez de geração de texto. Depois de sondar a API da TypeSafe (procurando assinaturas no escalonamento de latência sob diferentes comprimentos de contexto, reordenação de perguntas etc.), vasculhar qualquer documentação e pesquisa públicas com o Astra e procurar arte anterior, acho que tenho um modelo razoavelmente preciso de como ela funciona e de sua arquitetura.
A espinha dorsal esparsa é a parte menos certa, mas é particularmente benéfica para este domínio, com menos desvantagens do que LLMs autorregressivos, então seria estranho se não fosse. Computação compartilhada e saídas diretas de probabilidade são obviamente muito melhor sustentadas. Tudo isso é claramente bastante especulativo, então vou tentar ser o mais claro possível sobre o que foi publicado pela TypeSafe, o que foi observado em experimentos e o que é inferido deles. APIs de caixa-preta tornam incrivelmente fácil jogar um lençol sobre o fantasma e obter uma forma aproximada de como a arquitetura se parece.
Por que este projeto é útil
Considere uma requisição esquemática de roteamento de suporte. Isso ilustra a estrutura da API; as probabilidades de exemplo abaixo são inventadas.
{
  "state": "My payouts have failed three times. The bank says everything is fine. Can someone please fix this?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "payments": "Payout failures and payment processing",
        "account": "Login and account access",
        "other": "Something else"
      }
    },
    "escalate": {
      "type": "noul",
      "instructions": "Does this message require urgent human attention?"
    }
  }
}
Uma resposta útil pode atribuir payments 0.91 de probabilidade enquanto atribui escalonamento urgente apenas 0.42. Essas são incertezas diferentes. O software pode encaminhar o ticket automaticamente enquanto deixa o escalonamento para uma política separada.
Um transformer causal já sabe como construir uma representação de texto da esquerda para a direita. Durante a inferência normal de um modelo de linguagem, ele processa o prompt, prevê um token, realimenta esse token e repete. Isso se baseia na atenção do decodificador e na projeção de saída introduzidas no Transformer original.3 Mas o estágio de processamento do prompt já produziu uma representação rica. Se a tarefa é escolher entre três filas, podemos anexar uma pequena função que mapeia essa representação diretamente para três números.
Um detalhe aqui resolve boa parte da confusão sobre respostas em paralelo: a atenção causal descreve quais posições podem usar quais informações, não a ordem em que os tokens de entrada devem ser executados. Durante o processamento do prompt, ou prefill, todo token de entrada já é conhecido. O modelo pode processar suas posições juntas dentro de uma camada enquanto a máscara de atenção bloqueia o acesso a posições posteriores; as camadas ainda rodam sequencialmente. A decodificação autorregressiva adiciona outra dependência: o próximo token não existe até a previsão anterior ter sido escolhida. Nosso modelo proposto termina após o prefill e a leitura, então evita essa dependência token a token.
Isso muda a forma computacional da tarefa. A saída não precisa mais de uma sequência de decisões de escrita para "payments": 0.91. A formatação JSON acontece em código de aplicação comum. A rede neural fornece as probabilidades.
Agora suponha que o estado seja um relatório de incidente longo, e que haja cinquenta perguntas. A maior parte da entrada é compartilhada. Um transformer armazena informações intermediárias sobre os tokens processados em seu cache de chaves e valores, normalmente abreviado como cache KV. No projeto proposto, cada pergunta lê o mesmo cache de estado. Cada ramo adiciona apenas suas próprias instruções e opções de resposta.
Para um estado de tokens e perguntas, requisições separadas processariam o estado aproximadamente vezes. O compartilhamento reduz o processamento repetido de tokens de estado de para . As perguntas ainda têm que atender ao estado; esse trabalho não desaparece. Mas o modelo não precisa reconstruir repetidamente as representações do estado.
O isolamento também dá um significado útil à interface. Perguntar se o cliente está irritado não deveria mudar qual fila recebe o ticket. Ambas as perguntas podem inspecionar a mesma evidência sem ler as instruções uma da outra. Os ramos não têm dependência computacional entre si, mesmo quando suas respostas estão estatisticamente relacionadas.
Por fim, as probabilidades tornam explícita a política a jusante. Se um escalonamento desnecessário custa uma unidade e um caso urgente perdido custa nove, uma regra de decisão simplificada escala quando . Esse cálculo só é significativo na medida em que as probabilidades são confiáveis para este fluxo de trabalho. Treinar e avaliar a distribuição de probabilidade passa, portanto, a fazer parte do produto, em vez de um campo de confiança cosmético.
Nada disso exige difusão. A classificação paralela existe há décadas. A combinação interessante é um transformer amplamente capaz, computação contextual compartilhada, uma interface de saída tipada e um treinamento que recompensa incerteza útil.
1. Termine a inferência com uma leitura
O primeiro componente é o mais simples: uma cabeça de previsão em vez de um laço de decodificação.
Evidência publicada. O anúncio de lançamento da TypeSafe diz: “A Jev produz todas as probabilidades em paralelo em vez de gerar autorregressivamente por token.” Sua documentação expõe escolhas finitas, decisões de sim/não e pontuações ordenadas. Estes são naturalmente representados por saídas numéricas fixas.12
Evidência observada. A API ainda relata um campo output_tokens, que soa como um registro de geração. Não é. Para perguntas de sim/não, a contagem se encaixa exatamente: 4 tokens compartilhados, mais 15 por resposta, mais o comprimento em tokens do identificador de cada pergunta. A documentação da TypeSafe diz que esse identificador “não é enviado ao modelo subjacente e não é usado na inferência”. Uma contagem que muda com texto que o modelo nunca vê é calculada após a inferência, a partir da resposta serializada. Os valores retornados também não a afetam: uma resposta de 0.0 custa o mesmo que 0.01, embora cada dígito, de resto, conte como um token.224
O tokenizer por trás da contagem não corresponde a nenhum dos 192 tokenizers públicos que testamos. Ele corresponde ao próprio contador de entrada da Jev para texto comum, diferindo apenas em longas sequências de espaços em branco e pontuação. output_tokens é uma cifra de cobrança. Não nos diz nada sobre se a Jev gera texto, e não mediria esse texto mesmo se gerasse. A latência também não acompanha essa cifra: uma pergunta com 200 opções (1,911 tokens de saída) retornou tão rápido quanto uma com duas, e o tempo do servidor cresceu apenas com o comprimento da entrada.2425
Uma resposta de 255 opções relatou 2,714 tokens de saída.4 Seria um erro dividir esse número pela duração da requisição e chamar o resultado de velocidade de decodificação do modelo. Um servidor pode serializar milhares de caracteres após uma única avaliação do modelo. O campo de contabilidade não nos diz quantos passos de decodificação neural ocorreram.
A leitura proposta pega um vetor oculto final e produz logits:
Aqui é o número de respostas permitidas. A matriz converte uma representação em pontuações de resposta; a softmax transforma essas pontuações numa distribuição. Para uma decisão de sim/não, um escalar e uma sigmoide bastariam.
As classes não precisam ser conceitos fixos como “payments”. Elas podem ser slots de opção: primeira opção, segunda opção, terceira opção. O ramo fornece o significado de cada slot; o código de aplicação mapeia sua probabilidade de volta para a chave de opção do chamador. Um Score ordenado pode, de forma semelhante, prever probabilidades sobre níveis e retornar sua média ponderada pelas probabilidades. Isso permite novas decisões sem treinar uma nova cabeça para os rótulos de cada cliente. Um pontuador estilo ponteiro, comparado na seção 4, é a principal alternativa: ele pontua a própria representação de cada opção em vez de um slot numerado.
Isto não estabelece que a Jev tenha um módulo classificador com nome separado. A cabeça de vocabulário de um modelo de linguagem também é uma matriz seguida de softmax. Selecionar linhas de rótulo reservadas dessa matriz pode implementar o mesmo cálculo que uma cabeça dedicada de classes. As linhas podem estar atadas a embeddings de entrada ou treinadas de forma independente; não conseguimos distinguir esses arranjos aqui.
A distinção importante é entre ler probabilidades e gerar texto que descreve probabilidades. Um “91%” gerado é uma sequência de tokens. O 0.91 de um classificador é uma entrada em sua distribuição preditiva. Qualquer um dos dois pode estar mal calibrado. Nenhum se torna confiável apenas pelo formato.
A decodificação de texto restrita continua sendo uma forma possível de construir uma interface semelhante, mas a TypeSafe descreve explicitamente um caminho de saída diferente. A declaração dela é evidência mais forte do que um argumento de latência. As evidências apontam para uma leitura numérica direta, um dos dois projetos comparados na seção 4. Tokens de rótulo reservados continuam possíveis, embora o teste de opções falsas ali pese contra eles.
2. Compartilhe o estado, isole as perguntas
A próxima decisão diz respeito a onde a computação é reutilizada.
Evidência observada. A contabilidade de tokens é exatamente aditiva nos pequenos exemplos controlados. Uma pergunta mínima de sim/não usou 268 tokens de entrada; duas usaram 276. Uma requisição contendo uma pergunta de sim/não, um Choice de duas opções e um Score de dois níveis usou 318, correspondendo à soma de suas contribuições medidas acima do overhead compartilhado. Isso se encaixa num prefixo comum mais sufixos de pergunta, embora a contabilidade sozinha não identifique um grafo computacional.4
Um experimento mais informativo move evidência entre essas regiões. O estado inicialmente dizia:
The weather is nice today and the park is full of people.Uma pergunta irmã continha:
The secret code for this request is ZEBRA-7741.
Is the weather described as nice?
A sondagem perguntou qual código outra pergunta mencionava, com ZEBRA-7741, dois distratores e none como opções. Com o segredo na pergunta irmã, sua probabilidade relatada foi 0.00. Remover essa pergunta irmã produziu o mesmo resultado. Colocar a declaração no estado em vez disso elevou-a para 0.90–0.92. Foram cinco repetições por condição (visibility nos registros da sondagem).5
Esta é uma intervenção útil: mover a declaração através de uma fronteira da API muda seu efeito. Isso sustenta isolamento comportamental entre perguntas e acesso ao estado compartilhado. Não expõe a máscara de atenção exata. Chamadas de modelo separadas, uma máscara de árvore ou outro mecanismo que restrinja o fluxo de informação poderiam produzir o mesmo resultado. A formulação da sondagem também pergunta sobre “outra pergunta” mesmo na condição de estado, então não é um teste puro de seguimento literal de instruções.
As medições de serviço acrescentam outra peça. Até cerca de 100 perguntas, o tempo do servidor quase não mudou. Além disso, subiu de forma constante, e token por token, o texto da pergunta custou aproximadamente o dobro do estado. Isso é consistente com calcular o estado uma vez e agrupar o trabalho das perguntas.6
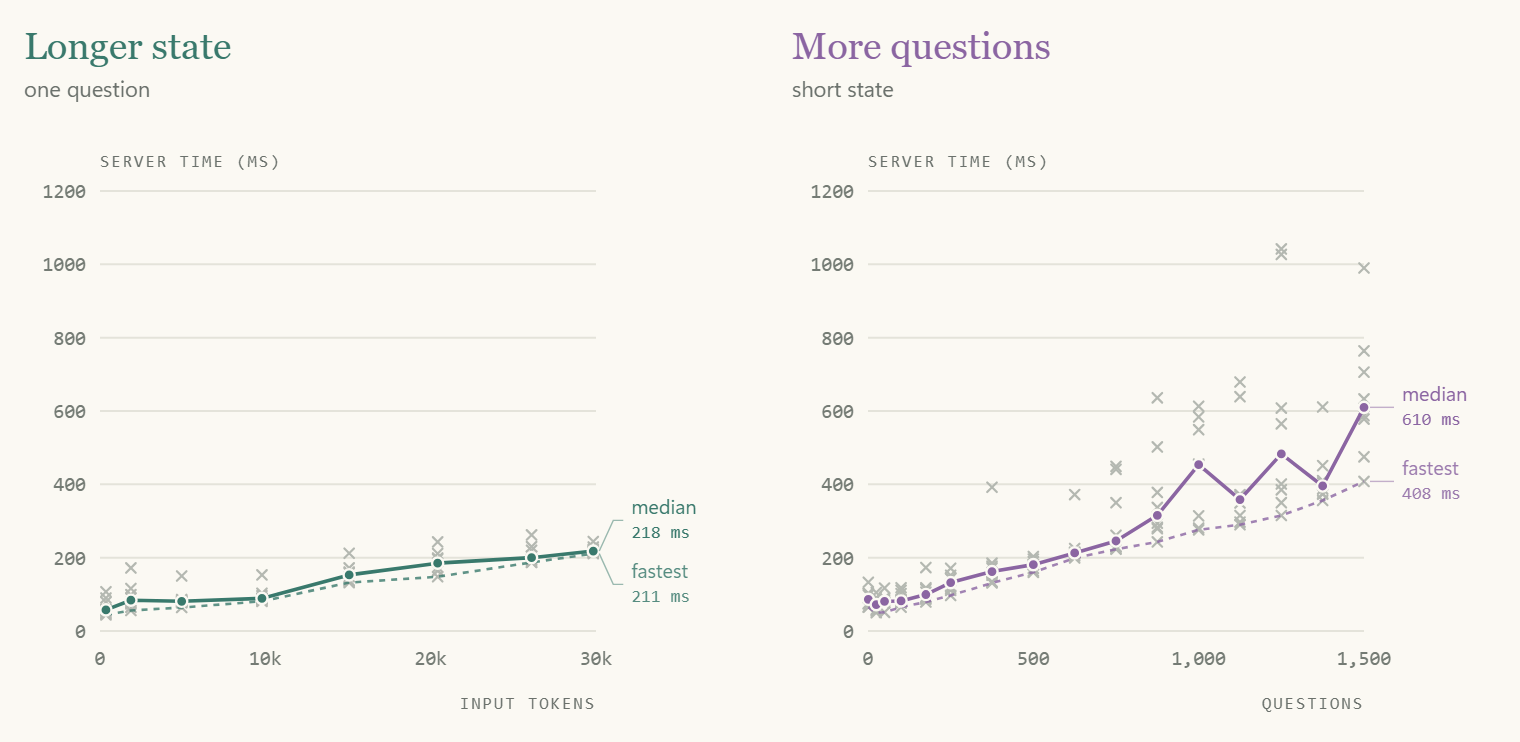
Estes são tempos a montante relatados pelo servidor, não medições de um laptop local. Eles incluem todo o trabalho e a espera que o serviço a montante inclui, e o serviço era compartilhado com outros usuários.
A Jev impõe dois limites. Cada ramo (o estado mais uma pergunta) é limitado a cerca de 32,768 tokens, e a requisição inteira a cerca de 65,536. O limite da requisição conta o estado uma vez: um estado de 23 mil tokens com 5,000 perguntas cabe dentro dele. Se cada pergunta processasse sua própria cópia do estado, essa requisição passaria de 100 milhões de tokens. O par cabe numa única sequência empacotada de até 2¹⁶ tokens, mantendo o estado uma vez e cada pergunta depois dele, com cada ramo limitado a uma janela de contexto de 2¹⁵.22
Um cache KV de prefixo com sufixos causais separados é a implementação natural. Hydragen descreve atenção eficiente para sequências que compartilham um prefixo; DeFT desenvolve atenção para inferência com estrutura de árvore. Esses trabalhos estabelecem que o padrão de serviço é prático. São arte anterior, não evidência de que a TypeSafe usa qualquer uma das duas bibliotecas.78
Este projeto também esclarece uma aparente contradição: perguntas isoladas ainda podem ser avaliadas juntas no mesmo acelerador. “Paralelo” descreve seu agendamento e a ausência de dependências entre respostas. Não precisa significar uma GPU por pergunta.
3. Uma espinha dorsal causal
Os experimentos não conseguem distinguir um decodificador causal de um codificador bidirecional: em ambos, a decisão final pode ler toda a entrada. Eu suponho um decodificador causal de qualquer forma, por um bom motivo. A amplitude de conhecimento da Jev (84.6% no MMLU-Pro) exige pré-treinamento em escala de fronteira, todo modelo nessa escala é um decodificador causal, e a TypeSafe descreve o RLCD como pós-treinamento de um modelo de linguagem pré-treinado. Uma Jev bidirecional significaria ou uma base muito mais fraca ou converter um decodificador a um custo extra, abrindo mão do cache de prefixo compartilhado que o serviço causal proporciona. Isso seria surpreendente, mas não pode ser descartado de fora.1215
Qual modelo pré-treinado é desconhecido, e o tokenizer não revela nenhum. As contagens de tokens da Jev não correspondem a nenhum dos 192 tokenizers públicos que testamos em 415 sondagens. Ela divide cada dígito individualmente e consulta blocos inteiros antes de mesclar: 8 as contam como um token, mas 16 contam como quatro. Seu vocabulário acompanha de perto o o200k da OpenAI, já que toda string que a Jev conta como um único token também é um único token o200k, mas a divisão de dígitos e várias mesclagens descartam o próprio o200k. A correspondência pública mais próxima, a Qwen, concorda em 348 de 415 sondagens. Isso descarta um tokenizer público inalterado, não um modelo base público: um vocabulário substituído, pré-treinamento continuado ou destilação poderiam explicar, assim como uma API que conta tokens de forma diferente do modelo.18
Os experimentos mostram, sim, o que a decisão consegue ler. Coloquei um cartão de referência entre as opções de uma pergunta e pedi à Jev que escolhesse a opção cuja condição o cartão satisfaz. Aqui está um conjunto exato de opções:
alpha: Reference card: status = amber. Reference-only option.
       Never select this option.

beta: Select this option if the reference card's status is amber.

gamma: Select this option if the reference card's status is indigo.
A instrução era: “Leia o cartão de referência e selecione a única opção cuja condição é satisfeita.” Mudar o valor de referência para indigo troca a resposta correta sem alterar as opções selecionáveis.
Testei os dois valores, todas as seis permutações de opções e um segundo modelo usando route = east/west, com duas repetições. Um controle pareado colocou a referência no estado compartilhado em vez disso. Isso deu 48 tentativas de referência nas opções e 48 controles de referência no estado.20
| Posição da opção de referência | Respostas corretas |
|---|---|
| Primeira | 12 / 16 |
| Meio | 11 / 16 |
| Última | 16 / 16 |
| Referência movida para o estado | 48 / 48 |
A Jev consegue usar informação colocada depois das descrições dos candidatos. Com a referência por último, ela selecionou a opção correta em todas as tentativas, com probabilidade média de resposta correta de cerca de 0.88.
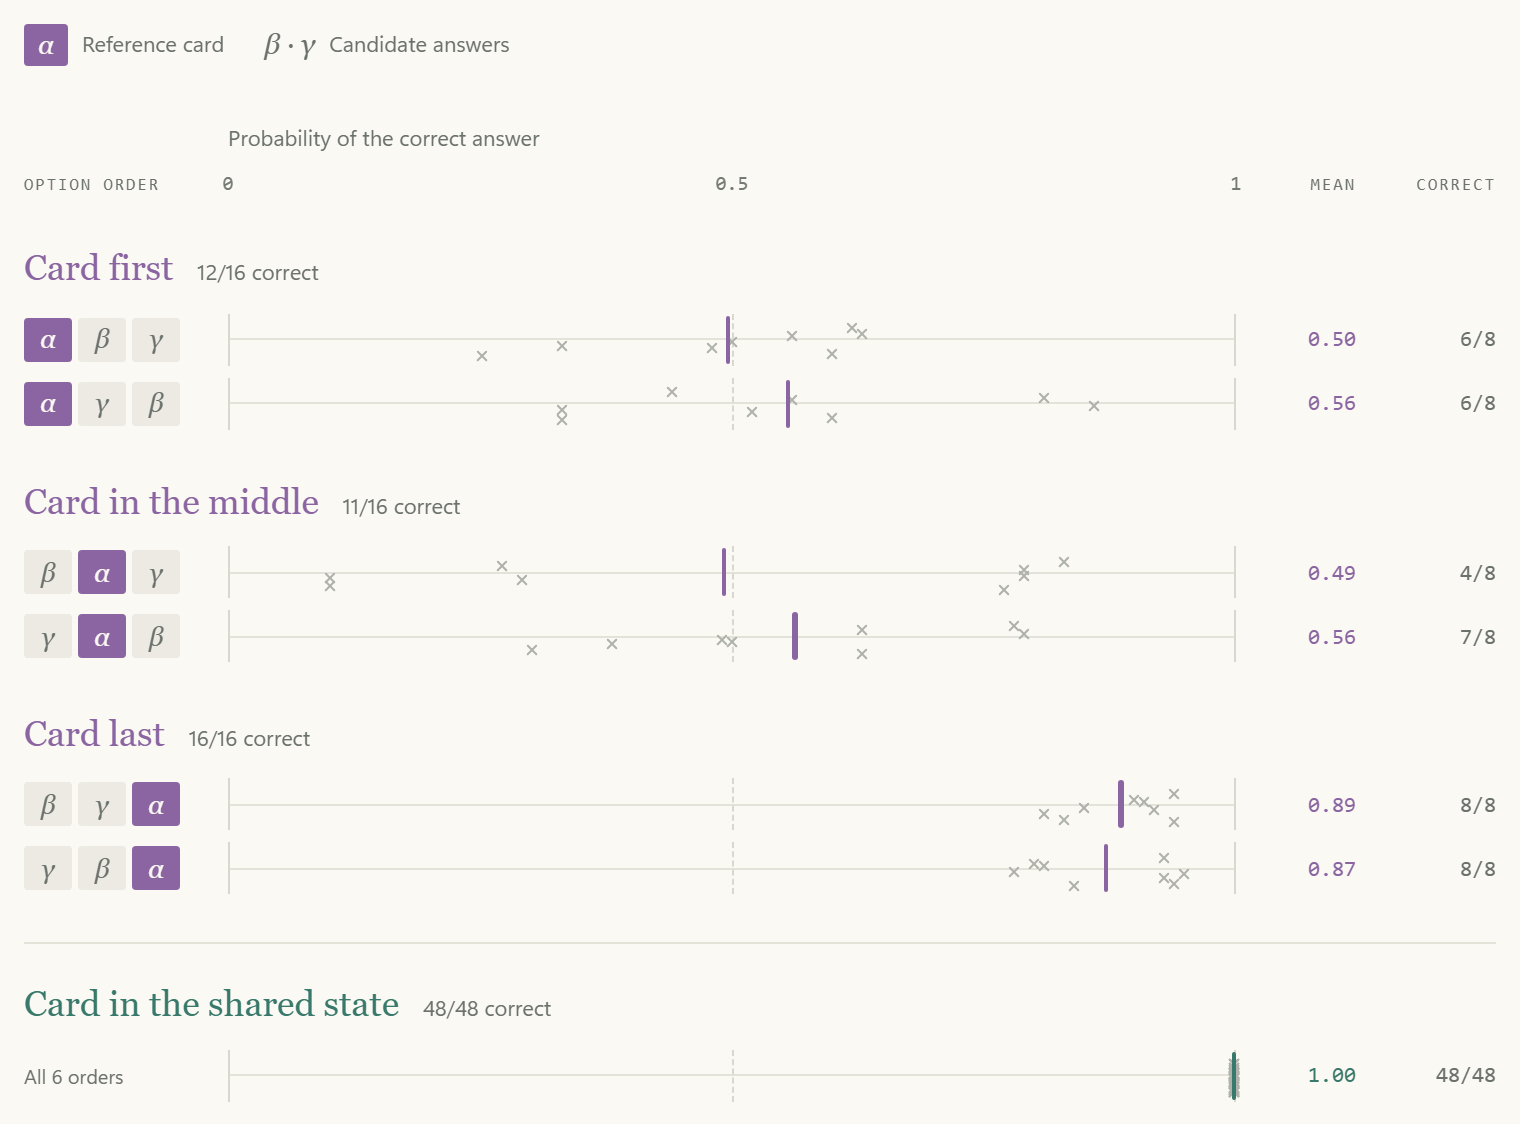
O controle de troca de valor importa tanto quanto a posição. Com o cartão por último, mudar apenas amber para indigo muda qual opção anterior vence, embora essas descrições anteriores e o estado permaneçam idênticos. Um modelo que pontua cada opção de forma independente a partir de seu próprio texto e do estado, e depois apenas normaliza as pontuações, não tem caminho para que esse fato altere a ordenação relativa das opções anteriores. Os resultados sustentam um caminho pelo qual as opções influenciam a decisão conjunta.20
Isso se encaixa em qualquer leitura calculada após a lista inteira, incluindo os dois projetos comparados na seção 4, bem como num estágio separado de mistura de opções. Os erros restantes mostram processamento sensível à posição nesses dois modelos; não identificam uma causa única.
A difusão é desnecessária para este cálculo, e nada nesses experimentos exige desruído iterativo. A inferência arquitetural defensável é mais estreita: o cálculo da resposta tem acesso à lista completa de opções. O próximo experimento testa se ela de fato usa esse contexto conjunto.
4. Deixe as opções interagirem antes de escolher
Dentro de uma pergunta, as evidências apontam para uma fronteira de informação diferente: as alternativas são lidas juntas como uma lista ordenada, seguidas por uma única posição de decisão.
Por que permitir essa interação? Opções como “nenhuma das anteriores” dependem das outras escolhas. Mesmo alternativas comuns podem esclarecer uma pergunta. “Payments”, “account access” e “other” definem uma decisão diferente de “bank”, “payment provider” e “customer”. Uma representação listwise permite ao modelo interpretar essa distinção antes de produzir a distribuição.
A evidência mais forte é um experimento com uma opção extra irrelevante.
Comece com quatro causas possíveis de uma falha de pagamento: bank, provider, customer e unknown. Depois acrescente weather: Bad weather caused it. Se cada opção original recebe um logit independente e inalterado e o servidor aplica a mesma temperatura softmax, acrescentar uma quinta opção muda a normalização mas não pode mudar as chances entre duas opções existentes:
O denominador comum se cancela. Isso nos dá uma previsão específica e falseável.
O estudo original encontrou uma mudança de aproximadamente +0.49 para +0.08.10 Para verificar se isso sobrevivia à variabilidade normal das requisições, repeti o experimento em dez blocos aleatorizados. Cada bloco incluía a linha de base de quatro opções, um controle idêntico de quatro opções, uma versão de cinco opções com weather acrescentado, um controle idêntico de cinco opções e uma versão de cinco opções cuja descrição adicionada mudava de “Bad weather caused it” para “Wild birds caused it”. Cada requisição continha uma pergunta.21
O resultado da expansão se replicou. Agregando as duas requisições idênticas para cada condição dentro de cada bloco, a média dos log-odds caiu de +0.38 para +0.11. Todo bloco mostrou uma redução; a mudança média foi −0.28, com um intervalo t pareado de 95% descritivo de aproximadamente −0.36 a −0.19. A agregação usa as requisições de controle para reduzir o ruído comum das requisições, em vez de tratar saídas duplicadas como experimentos independentes.21
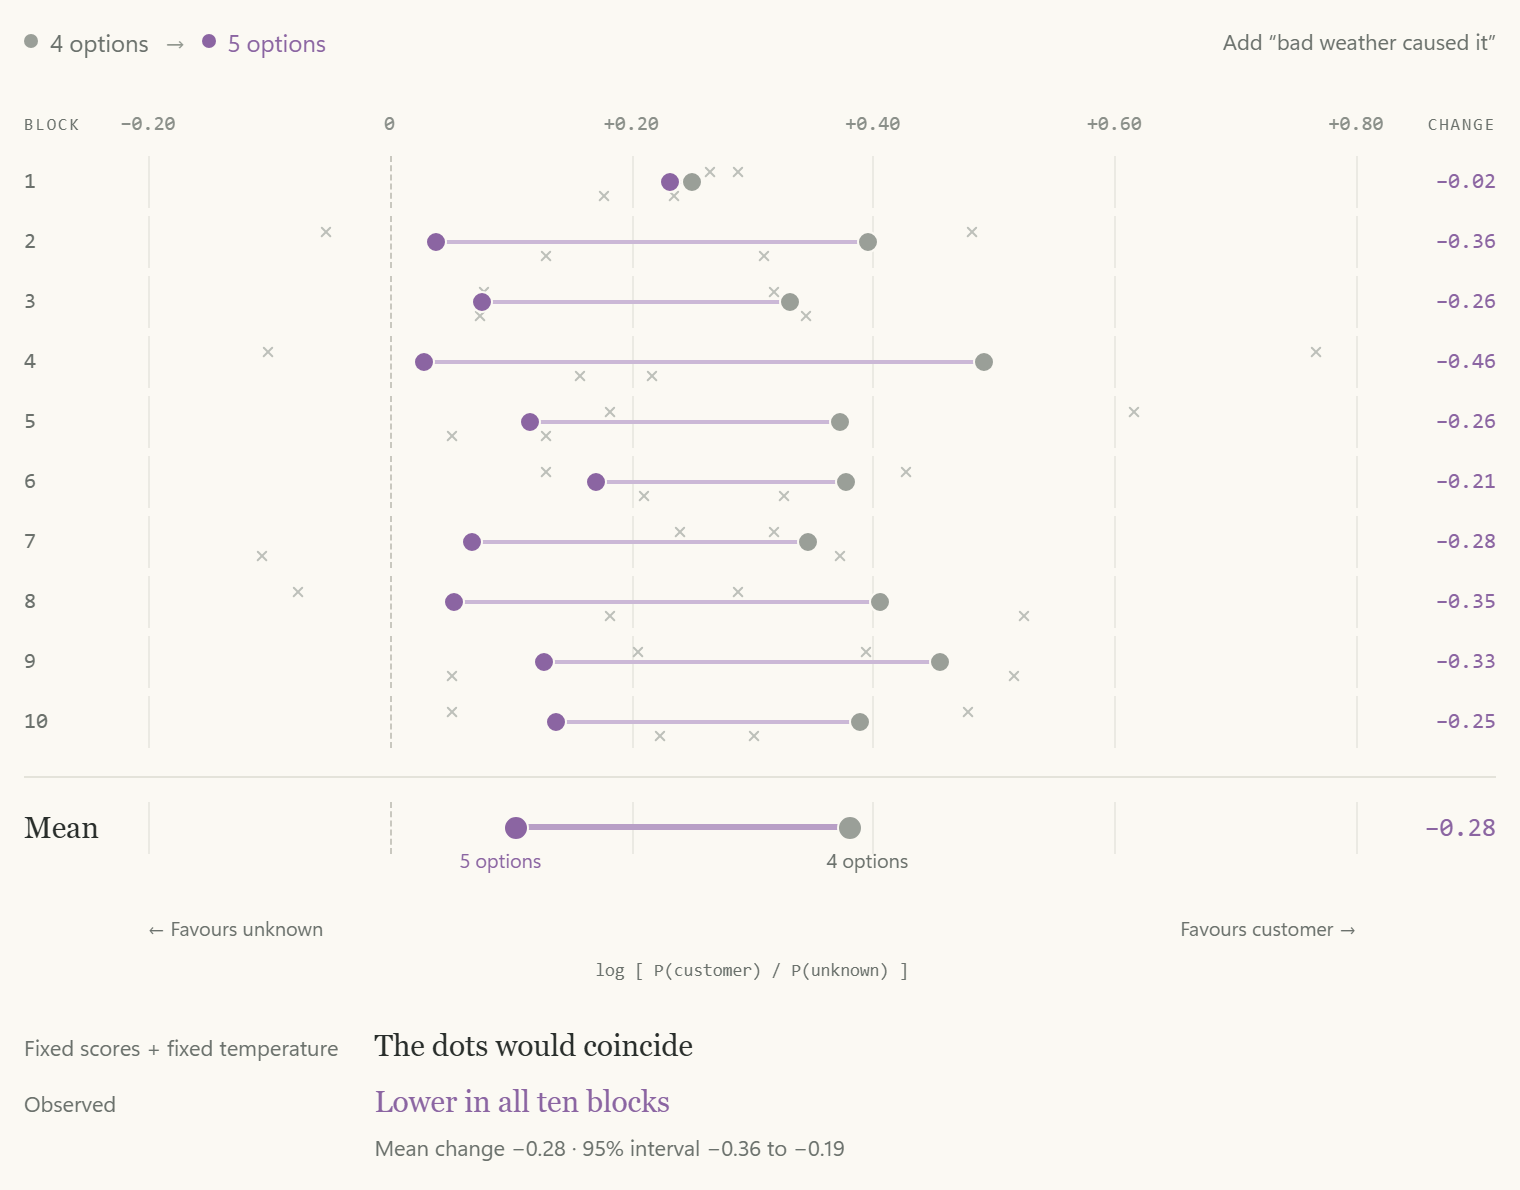
Isto é evidência contra logits fixos e independentes seguidos por uma softmax inalterada. Não identifica unicamente o mecanismo. Mudar a descrição adicionada mantendo cinco opções deu uma mudança menor e inconclusiva: seu intervalo pareado incluía zero. Uma temperatura dependente do conjunto continua possível, ao lado de mistura dependente do conteúdo.
Uma leitura que vê a lista completa explica isso naturalmente: acrescentar uma opção muda o contexto que ela lê. O método de ranking listwise FIRST funciona do mesmo jeito, extraindo um ranking dos logits do primeiro token em vez de gerá-lo token a token.11
Duas leituras se encaixam nas evidências. Uma cabeça de posição final pontua cada slot de opção a partir da representação do token de decisão; um pontuador estilo ponteiro compara essa representação com o estado oculto final de cada opção. Ambos permitem que as opções influenciem umas às outras. A API aceita no máximo 255 opções (2⁸ − 1), o que se adequa a uma cabeça fixa de 256 slots, mas esse limite é imposto pela validação da requisição, não pelo modelo. Com 200 opções, uma resposta copiada pontuou 1.00 em todas as posições e os erros não transbordaram para opções vizinhas, o que se adequa a um ponteiro. Nenhum dos resultados é decisivo.26
Opções falsas injetadas nunca deslocaram as reais, então as fronteiras de opção são marcadas de um jeito que o texto não consegue forjar, e uma opção cuja condição é duplicada em outro lugar da lista perde probabilidade para suas rivais.23
O trade-off também é visível em tarefas comuns: inverter as opções deslocou a probabilidade de uma classificação de suporte técnico de aproximadamente 0.84–0.89 para 0.93–0.96. Isso veio das sondagens option_order.9 Para uma política de decisão implantada, isso importa. Um limiar perto de 0.9 poderia mudar a ação mesmo com os rótulos e as evidências idênticos. Testes de permutação pertencem à avaliação de qualquer implementação deste projeto.
5. Treine a distribuição e depois calcule a confiança
O quinto componente é o objetivo de treinamento. Saídas numéricas diretas economizam trabalho de decodificação, mas uma probabilidade barata ainda pode ser uma probabilidade ruim.
Imagine uma coleção de casos aos quais foi atribuída probabilidade 0.8 de serem urgentes. A calibração pergunta se cerca de 80% realmente são urgentes. É uma propriedade das previsões ao longo dos casos. Não podemos determinar se uma previsão está calibrada a partir de se aquele caso específico acaba bem.
A TypeSafe chama seu método de treinamento de Reinforcement Learning for Calibrated Decisions, ou RLCD. O lançamento diz que ele otimiza para “respostas com probabilidades epistemicamente honestas em tarefas System One”; o primer da empresa apresenta o RLCD como um caminho de pós-treinamento a partir de modelos de linguagem pré-treinados.112 A receita exata não é publicada. Minha receita de treinamento proposta adapta o transformer e a leitura a tarefas de decisão tipadas usando um objetivo baseado em resultados. Isso dá à espinha dorsal a oportunidade de construir representações úteis para decisões confiáveis, não apenas conclusões fluentes.
Um objetivo natural é a log loss, para o resultado observado . Outro é a Brier loss, a distância ao quadrado entre a distribuição prevista e o resultado one-hot observado. Ambas são regras de pontuação próprias: em expectativa, relatar a verdadeira distribuição condicional minimiza a perda. Gneiting e Raftery dão a definição formal e a teoria.13 Isso explica o que esse treinamento tenta alcançar. Não estabelece qual perda a TypeSafe usa, se seu pipeline é aprendizado por reforço num sentido algorítmico estrito, ou se todo peso da espinha dorsal é atualizado.
A propriedade também não é uma garantia de implantação. Dados finitos, limitações do modelo, erro de otimização e mudança de distribuição podem todos deixar a calibração imperfeita. Guo et al. mostram tanto os problemas de calibração das redes neurais modernas quanto a utilidade de ajustes post-hoc. Treinamento e calibração post-hoc são mecanismos compatíveis; a API não consegue separar suas contribuições.14
Evidência observada. Os registros do benchmark nos permitem comparar a probabilidade prevista com a precisão observada, tanto no agregado quanto dentro de faixas de probabilidade. O gráfico mostra essas verificações. A concordância das médias sozinha é evidência mais fraca do que a concordância dentro das faixas: superconfiança num grupo pode cancelar subconfiança em outro. Na amostra de 1,200 itens do MMLU, o erro de calibração esperado de dez faixas foi 0.0313 (definições das faixas e previsões por item). A maioria das previsões se concentrou perto da certeza: 990 caíram na faixa 0.9–1.0.15
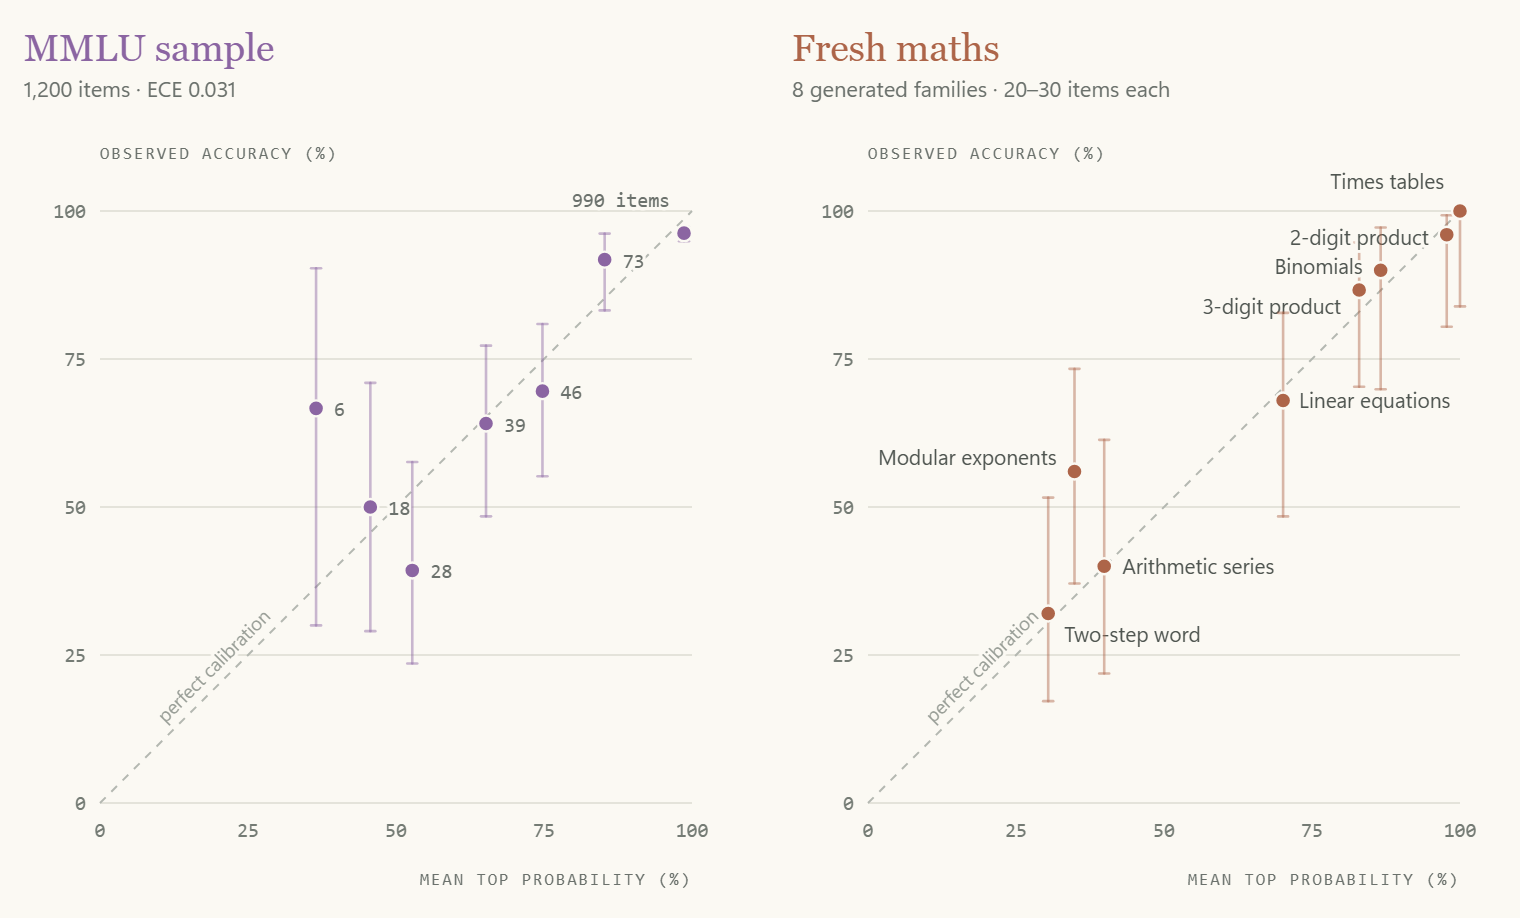
O pequeno estudo de matemática recém-gerada acrescenta variação útil. Em problemas gerados de multiplicação de três dígitos, a precisão foi 86.7% e a probabilidade máxima média 0.83. Em problemas de palavras de dois passos, a precisão caiu para 32% e a probabilidade máxima média para 0.30. O modelo ficou menos confiante na tarefa mais difícil (fresh_math_results, com 30 itens de multiplicação e 25 de problemas de palavras).15 Isso é encorajador, embora médias pequenas no nível de categoria não possam estabelecer calibração para todo tipo de problema não visto.
Esses resultados também mostram por que uma pontuação de benchmark pública é uma medida imperfeita do que o modelo sabe. A precisão no MMLU-Pro foi 84.6%; problemas de palavras recém-gerados foram bem mais difíceis.15 Diferenças na estrutura da tarefa, nos distratores, na dificuldade e na exposição ao treinamento podem todas contribuir. Essa lacuna não estabelece contaminação do benchmark. Uma formulação nova também não torna a habilidade matemática ou o conhecimento factual subjacente inéditos.
Há um achado separado e incomumente claro sobre o campo da API chamado confidence. O adaptador oficial calcula a confiança de Choice a partir de uma distribuição normalizada, para , como:
Para três opções com probabilidade máxima de 0.8, isso dá 0.7. O adaptador trata o caso de uma opção separadamente, retornando 1. Ele mede o quanto a resposta líder se destaca acima de uma distribuição uniforme. Não é outra estimativa aprendida de que a resposta está correta. O tipo Score usa uma fórmula diferente, refletindo a distância do nível modal.16
No sistema proposto, o treinamento produz a distribuição preditiva; a aritmética comum produz esse campo de resumo. Manter esses dois objetos separados evita um erro conceitual comum: uma distribuição concentrada ainda pode estar confiantemente errada.
6. Capacidade esparsa
Espero que a Jev use um transformer de mistura de especialistas esparsa. Em camadas selecionadas, um roteador envia cada token por um pequeno subconjunto de redes feed-forward, de modo que o modelo pode armazenar muitos parâmetros enquanto ativa apenas alguns deles para cada token: a ideia de computação condicional demonstrada pelas camadas MoE com portões esparsos de Shazeer et al.17
Especialistas esparsos não podem ser observados de fora, mas são a escolha provável. Um modelo somente prefill é limitado por computação, que é exatamente o que o roteamento esparso economiza. Os custos usuais de serviço de MoE praticamente desaparecem: não há decodificação token a token, onde a largura de banda de memória domina e a maioria dos especialistas acaba ativa de qualquer forma, e não há cache KV de longa duração competindo com os pesos dos especialistas por memória. As medições apontam na mesma direção. A Jev processou cerca de 30 mil tokens em aproximadamente 160 ms; um modelo denso de 70B num nó 8×H100 precisaria de cerca de um segundo, enquanto uma MoE com cerca de 10B de parâmetros ativos se encaixa. E a maioria dos modelos base recentes mais fortes (DeepSeek-V3, Qwen3, GLM-4.5, Kimi K2, gpt-oss) é MoE. Hardware especializado poderia permitir que um modelo denso igualasse a velocidade, e as pontuações de benchmark podem exagerar quanto conhecimento o modelo detém, então isso continua sendo uma inferência, não uma medição.615
Nada mais na reconstrução depende disso. Trocar por um transformer denso deixaria a interface, o estado compartilhado, os ramos isolados e a leitura exatamente como descritos.
7. Agende os ramos como um lote, não como uma conversa
O componente final é um motor de serviço que trata os ramos de perguntas como itens de trabalho independentes. Seus sufixos podem ser empacotados em lotes enquanto leem as representações do estado compartilhado. O código de aplicação então associa as saídas numéricas aos identificadores de pergunta e serializa a resposta.
As medições revelam pequenas diferenças entre respostas idênticas repetidas, inclusive entre perguntas duplicadas dentro de uma mesma requisição. Isso significa que o determinismo no nível da API não deve ser presumido (noise, dup e determinism).19 Não implica que o modelo gere ou amostre texto: kernels numéricos, batching dinâmico, roteamento ou aleatoriedade deliberada podem todos afetar uma leitura direta.
A ordem das chaves de resposta também variou num pequeno número de padrões recorrentes.19 Múltiplos workers com ordenação de hash diferente são uma explicação plausível. No entanto, esse canal lateral não identifica o número de workers, não estabelece onde vive o cache KV, nem nos diz qual precisão numérica é usada. Esses são detalhes de implementação que as observações disponíveis não conseguem resolver.
O que importa para a arquitetura proposta é a ausência de uma cadeia de dependências entre respostas. O modelo não precisa terminar de escrever a classificação da fila antes de começar a estimativa de urgência. Ambas dependem do estado; nenhuma consome a resposta gerada pela outra.
Ainda há um limite de dependência. Se uma pergunta posterior realmente precisa de uma resposta anterior, a aplicação deve introduzir outro estágio de decisão ou expressar a decisão conjunta numa única pergunta. Compartilhar contexto não remove a estrutura lógica do fluxo de trabalho.
O que me faria mudar de opinião?
Esta reconstrução faz diferentes tipos de compromissos. Saídas diretas de probabilidade são descritas publicamente. Isolamento de perguntas e efeitos de ordem das opções são comportamentos observáveis. Compartilhamento de KV, atenção causal, leituras de posição final ou estilo ponteiro e especialistas esparsos são explicações progressivamente mais específicas.
O experimento do cartão de referência resolve uma questão: a decisão consegue usar opções colocadas por último. O teste de opções falsas mostra que truques no formato da entrada não conseguem forjar fronteiras de opção. Tarefas relacionais mais amplas poderiam restringir mais a representação, embora o sucesso comportamental sozinho ainda não identificaria unicamente uma máscara de atenção.
Para o tratamento de opções, o acompanhamento aleatorizado replica um efeito de conjunto de escolhas, mas a intervenção de descrição de tamanho fixo continua inconclusiva. Mais modelos e blocos de requisição independentes poderiam distinguir uma mudança de temperatura compartilhada de interações dependentes do conteúdo. Uma tarefa de dificuldade mediana com 200 opções poderia separar a cabeça de slots do pontuador estilo ponteiro. Para a calibração, dados de fluxo de trabalho separados e avaliações repetidas sob mudança importariam mais do que outra pontuação de benchmark agregada. Confirmar especialistas esparsos provavelmente exigiria uma divulgação ou evidência além desta API.
Minha melhor reconstrução da Jev continua sendo a do diagrama de abertura: um transformer causal com um prefixo de estado compartilhado, sufixos de pergunta isolados, processamento listwise das opções, leituras numéricas tipadas e treinamento voltado para distribuições preditivas. Especialistas esparsos são a espinha dorsal provável, embora nada mais no projeto dependa deles.
Sua utilidade vem de casar o grafo computacional com a tarefa. Um serviço de decisão precisa ler evidências, comparar resultados permitidos e expor incerteza. Um transformer consegue fazer isso sem transformar cada decisão numa frase primeiro.
Métodos
Este ensaio se baseia numa investigação de 17 de setembro de 2026 da jev-1.13.0, usando uma conta de acesso antecipado e uma região de serviço observada. O estudo de origem contém 1,029 registros de sondagem instrumentados (incluindo os 190 itens de matemática gerada), 6,800 registros de benchmark e verificações factuais separadas. Estudos de acompanhamento adicionaram 146 requisições relacionais e de interação de opções (tentativas, resumo), 311 requisições de contabilidade de tokens, 445 requisições de impressão digital de tokenizer, 192 requisições de latência, 148 requisições de latência por contagem de opções, 181 requisições de posição de opção, 105 requisições de opções falsas e 35 requisições de limite de contexto. Cada uma está linkada a partir das referências, com requisições exatas e respostas higienizadas. Configurações de benchmark repetidas compartilham itens subjacentes; essas contagens não são contagens de problemas independentes.
O pacote de evidências para download registra as observações usadas neste ensaio. Os exemplos de API na seção de abertura são esquemáticos. Os prompts citados de visibilidade e de cartão de referência vêm dos scripts de sondagem e das requisições de acompanhamento salvas. As observações numéricas são específicas desta versão do modelo e desta campanha de teste.
Os números de latência vêm do cabeçalho de resposta x-envoy-upstream-service-time. São durações do serviço a montante, com limites de enfileiramento e execução desconhecidos, e não medições isoladas do modelo. As varreduras da figura de latência foram executadas uma requisição por vez, em ordem embaralhada; nenhum dos estudos controlou a carga do servidor. Medições locais de relógio de parede não são usadas como evidência arquitetural.
As probabilidades eram geralmente retornadas com precisão de duas casas decimais. Perguntas duplicadas numa requisição compartilham condições e podem ter erros correlacionados. A figura de calibração do MMLU usa dez faixas de largura igual: [0, 0.1), [0.1, 0.2) e assim por diante, com 1.0 incluído na última faixa. O erro de calibração esperado é a diferença absoluta ponderada pela amostra entre a precisão e a probabilidade máxima média em cada faixa. As estimativas dependem da seleção da amostra, do agrupamento e do arredondamento das respostas. As evidências sustentam afirmações sobre as distribuições testadas, não uma calibração garantida em futuros fluxos de trabalho de clientes.
Fontes e trabalhos relacionados
As referências experimentais identificam as tags de script originais para que cada observação possa ser localizada no pacote de evidências. As citações de artigos estabelecem os mecanismos propostos e seus precedentes; não estabelecem que a Jev os usa.
Fontes
- TypeSafe (2026). Introducing System One Models and Jev. Fonte primária da afirmação sobre saída em paralelo e do objetivo RLCD declarado.
- TypeSafe. Documentação completa da API, acessada em 17 de setembro de 2026. Perguntas tipadas, distribuições de resposta e contrato da API.
- Vaswani et al. (2017). Attention Is All You Need. Mascaramento do decodificador, atenção e a camada de saída linear/softmax.
- Experimentos de API: type_preamble e outputs. Aditividade da contabilidade de tokens, mudanças de identificador e a resposta de 255 opções.
- Experimento de API: visibility. Cinco repetições, cada uma com o segredo numa pergunta irmã, ausente dessa irmã e no estado.
- Varreduras de latência (192 requisições sequenciais). Comprimento do estado e contagem de perguntas, 8 repetições embaralhadas cada; durações a montante relatadas pelo servidor.
- Juravsky et al. (2024). Hydragen: High-Throughput LLM Inference with Shared Prefixes.
- Yao et al. (2024). DeFT: Decoding with Flash Tree-attention for Efficient Tree-structured LLM Inference.
- Experimento de API: option_order. Sensibilidade comum à ordem dos tickets.
- Experimento de API: iia. Três requisições por condição, cada uma com quarenta perguntas duplicadas; conjuntos de escolha original, com acréscimo e com prefixo.
- Reddy et al. (2024). FIRST: Faster Improved Listwise Reranking with Single Token Decoding.
- TypeSafe. Primer de aprendizado de máquina. Descrição primária do caminho de pós-treinamento RLCD e do contrato de calibração.
- Gneiting and Raftery (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association 102(477):359–378.
- Guo et al. (2017). On Calibration of Modern Neural Networks.
- Registros de benchmark e de matemática gerada: precisão e probabilidades preditas médias. ; Análise de confiabilidade do MMLU: definições de faixas, ECE, intervalos de Wilson e 1,200 previsões por item.
- TypeSafe. Adaptador Python oficial, confidence_metrics.py, revisão fb52b103. Fórmulas de confiança de Choice e Score (lidas em 17 de setembro de 2026).
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer.
- Experimento de impressão digital de tokenizer (445 requisições). Sondagens de comprimento de execução, vocabulário e pré-tokenização, comparadas com 192 tokenizers públicos.
- Experimentos de API: noise, dup e determinism. Probabilidades repetidas e ordens de chave de resposta.
- Experimento relacional de acompanhamento (96 requisições). Dois modelos, dois valores de referência, seis permutações, dois locais e duas repetições; requisições exatas e respostas higienizadas.
- Experimento de interação de opções de acompanhamento (50 requisições). Dez blocos aleatorizados de base4, null4, append5, replace5 e null5; mudanças pareadas e erros padrão.
- Experimento de limite de contexto (35 requisições sequenciais). Limites de tokens por ramo e por requisição inteira, com casos de fronteira aceitos e rejeitados.
- Experimento de injeção de opções falsas (105 requisições). Sete formatos de delimitador, tarefas base saturadas e ambíguas, e vetores de probabilidade completos.
- Experimentos de contabilidade de tokens (311 requisições). Comprimento do ID da pergunta, tamanho do lote, dificuldade do estado, IDs de palavra e comparações entre strings de estado e de ID.
- Experimento de latência por contagem de opções (148 requisições). Uma ou 20 perguntas com 2–200 opções, rótulos curtos e longos, mais controles de desacoplamento de entrada/saída.
- Experimento de posição de opção (181 requisições). Limite de contagem de opções, resposta correta movida em listas de 10, 50, 200 e 255 opções.
Fonte: A arquitetura da Jev desvendada — Archer, archerhume.com, 17 de setembro de 2026.