オープンウェイトの型付き意思決定を、Apple Silicon 上でネイティブに実行。
短い英語の型付き意思決定におけるエンドツーエンドの中央値は 13.4 ms。多言語チェックポイントを使えば 7.4 ms。出力トークンは 0。 PyTorch も Transformers ランタイムもクラウド API も使わない、ローカルな MLX 推論です。
中国語 · ベンチマーク · Snake デモ · Hugging Face の重み
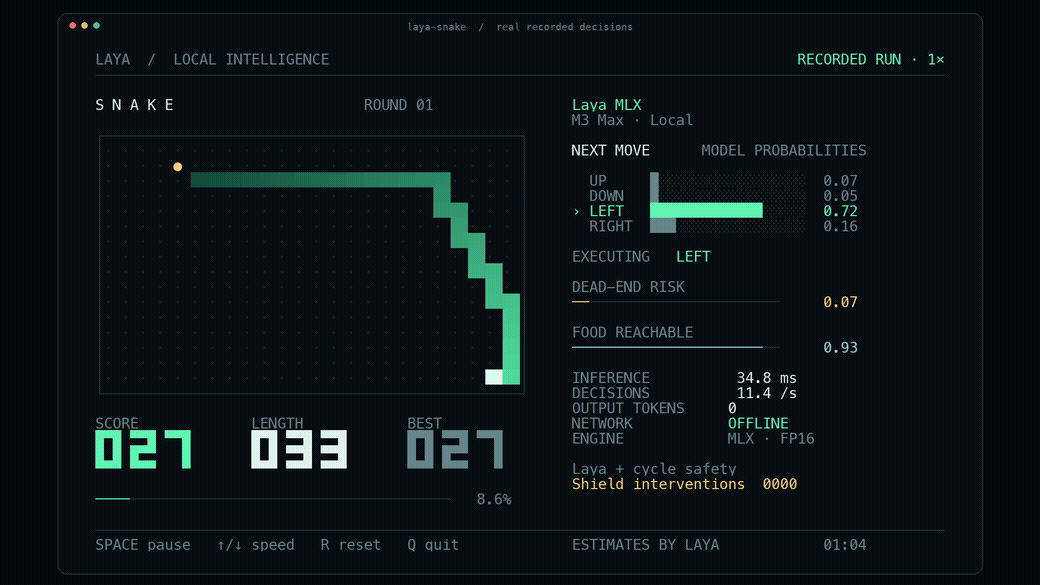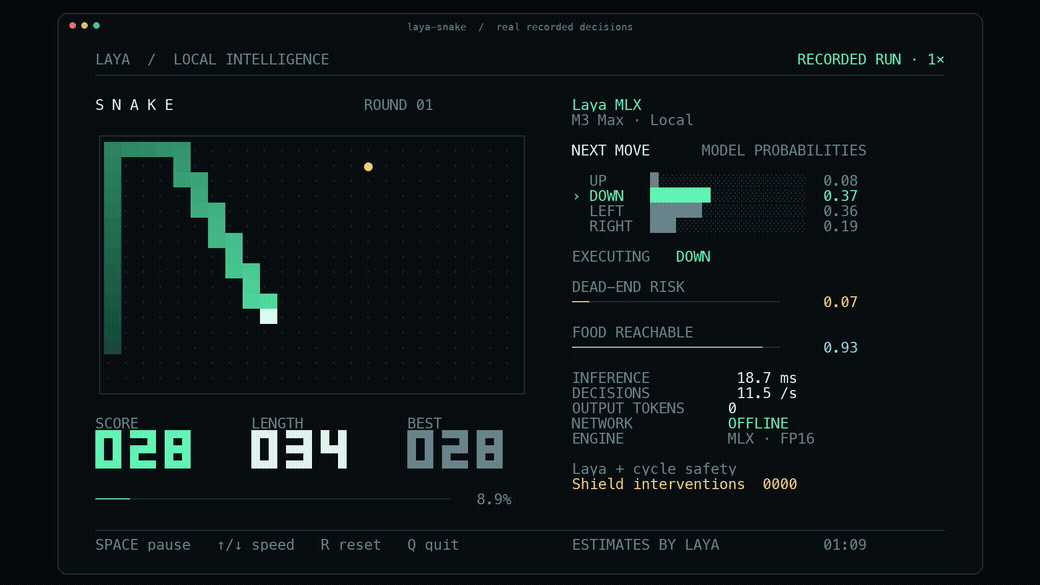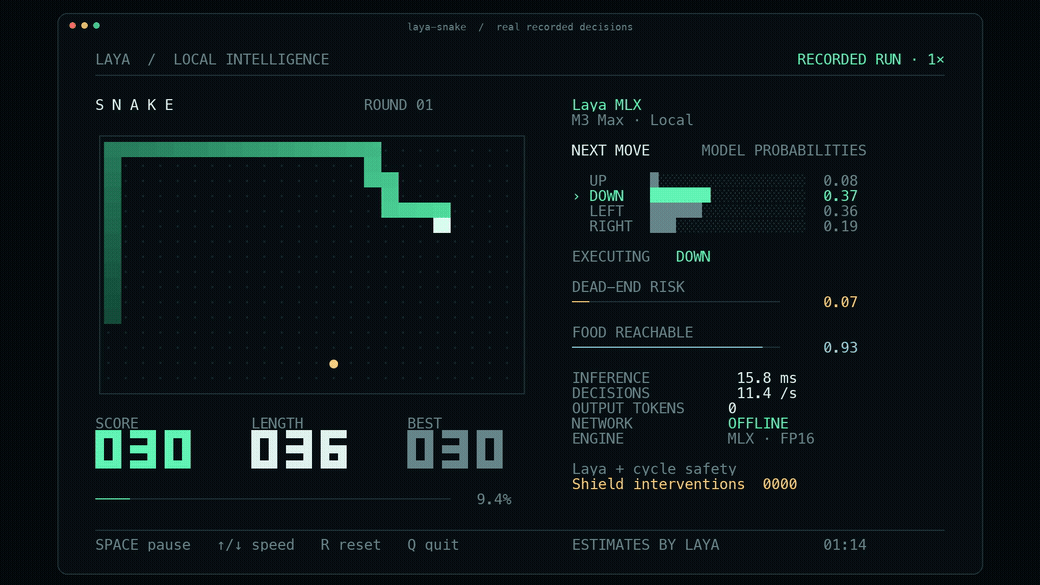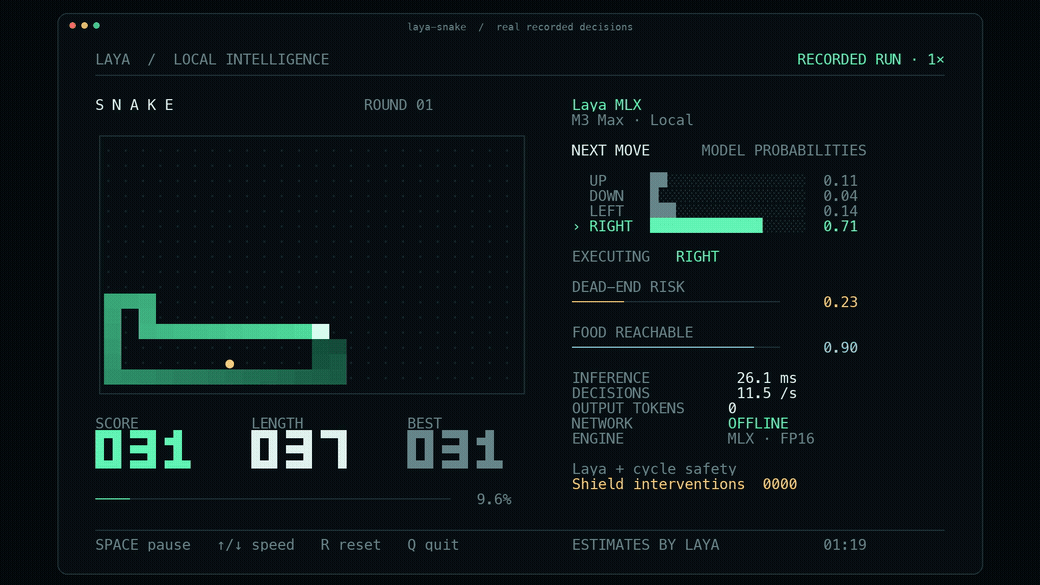
この GIF は、実際のローカル Snake 実行を元の速度でレンダリングしたものです。着手のたびに Laya を呼び出し、目に見えるサイクル安全層が危険な提案を修正できます。上のレイテンシ値は、3 問の Snake ループのフレーム時間ではなく、別途計測した 1 問の API ベンチマークです。30 秒の MP4 を見る · Snake の速度と安定性。
クイックスタート
pip install laya-mlximport laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
"I was billed twice. Please refund the duplicate.",
{
"department": {
"type": "choice",
"instructions": "Who should handle this?",
"criteria": ["billing", "technical", "sales"],
}
},
)
print(result["answers"]["department"])Apple Silicon、Python 3.11 以上、macOS 14 以上が必要です。初回ロード時にチェックポイントをダウンロードし、以降の推論は完全にローカルで行われます。計測環境は macOS 27.2、Python 3.12.13、MLX 0.32.2 です。この MLX リリースは macOS 14、15、26 用のホイールを提供しており、ローカルのインストーラは 26 のホイールを選びました。対応する古い macOS バージョンは、このマシンではテストしていません。
ターミナルデモを実行します:
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
オフラインデモの前に一度ダウンロードしておいてください。ターミナルは 104 × 35 セル以上を使います。Space で一時停止、↑/↓ で速度変更、R でリセット、Q で終了します。laya-snake --max-speed は、ペーシングなしで着手のたびに新しい判断を下します。録画、操作、各指標の正確な意味。
laya-snake --optimize --max-speed は、テスト済みのコンパイルとプレフィックス再利用の経路を有効にします。ペア M3 Max テストでは 2,400 手で 75.40 手/秒、死亡ゼロ、目に見える安全介入が 2 回でした。同じ実行の eager 対照より約 6.5% 高速でした。ゲームプレイ、性能、正しさの根拠。
M3 Max での性能
| FP16、エンドツーエンド | Laya 421M | 多言語 322M |
|---|---|---|
| 短い質問 1 件、P50 | 13.42 ms | 7.39 ms |
| 短い質問 1 件、P95 | 13.92 ms | 7.79 ms |
| 50 問のスループット | 146.8 q/s | 395.0 q/s |
| 短い質問 1 件での MLX ピーク割り当て | 943.6 MiB | 687.6 MiB |
M3 Max、GPU コア 40、メモリ 128 GiB。計測時間にはプロンプト準備、トークナイズ、テンソル、同期推論、較正、結果の整形が含まれ、モデルのロードは除きます。50 問の計測は batch_size=64 を使い、API の既定は 16 です。長さ、質問数、実行環境が変わればレイテンシも変わります。手法の全体とすべての計測サンプル。
移植の忠実性: 3 つのチェックポイントはいずれも、FP32 と FP16 の両方で 63/63 の検証質問について上流が選んだ答えと一致しました —— 378/378 の比較です。各構成はさらに、有限で決定的な呼び出しを 100 回繰り返しても、計測上のアクティブメモリ増加がゼロでした。これはそれらのフィクスチャ上での忠実性を測るものであり、あらゆる質問での精度ではありません。確率誤差と検証。
なぜ型付き意思決定なのか
ソフトウェアはしばしば、choice、ルーブリックの score、あるいは確率を必要とします。Laya はそうした制約された質問に、トークン単位のデコーディングや生成された JSON なしで、双方向のフォワードパスで答えます。
state + typed question → bidirectional encoder → decision heads → probabilitieschoice:名前付きの選択肢に対する確率。score:順序づけられたルーブリックのレベルに対する確率と、それらの期待スコア。noul:ある命題が真である確率 P(true)。
質問の行は独立にバッチ処理されます。それらの双方向エンコーダ表現は状態と質問の両方に依存します。このランタイムは、状態を一度だけエンコードしてその隠れ状態を任意の質問間で再利用する、とは主張しません。
エンコーダ、意思決定 Transformer、スコアリングヘッド、アクションヘッドはすべて MLX で動作します。トークナイズには Hugging Face の Rust トークナイザを使います。元の事前学習済み重み、質問のフォーマット、較正、出力スキーマはそのまま保持されています。これは独立した MLX 移植であり、Convai Innovations の公式リリースではありません。
対応チェックポイント
| モデル | エンコーダ | パラメータ数 | コンテキスト上限 | 用途 |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | 英語 |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | 多言語入力 |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | 上流の typed-decisions ワークフロー |
コンテキストには指示、選択肢、状態が含まれます。3 つとも元の重み、プロンプトのフォーマット、温度較正、出力スキーマを使います。このリポジトリが提供するのは推論と変換であり、RLCD の訓練とファインチューニングは上流のプロジェクトに残ります。これは独立した移植であり、Convai Innovations の公式リリースではありません。
変換済みの FP16 チェックポイントは Hugging Face で公開されています:
これらは laya.load("aac6fef/laya-mlx") で直接ロードするか、上の元のチェックポイント ID を使います。公開された各チェックポイントには、モデルカード、検証結果、来歴、ライセンス、ファイルのチェックサムが含まれます。公開された 36 ファイルはすべて厳格なリモートチェックサム検証に合格し、固定したリビジョンと重みハッシュは hub-publication.json に記録されています。
開発用インストール
gh repo clone mizorewww/laya-mlx
cd laya-mlx
uv sync --extra demo
uv run --extra demo laya-snake
あるいは最新の GitHub リビジョンを pip install 'git+https://github.com/mizorewww/laya-mlx.git' でインストールします。モデルの重みは別途ダウンロードされ、Git には含まれません。
Python API
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx", dtype="float16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate today.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs and outages",
                "sales": "new purchases",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": ["not urgent", "soon", "critical"],
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"])
system_one は predict の別名です。状態はテキスト、JSON 辞書、または会話リストで渡せます。choice は辞書か一意なラベルのリストを受け付け、score は 0 起点のルーブリックレベルの期待値を返し、noul は P(true) を返します。結果は上流の小数 4 桁への丸め、action.act_probability、トークン使用量フィールドを保持します。
既定の精度は FP16 です。数値の一致をより厳密にしたい場合は dtype="float32" を使います。選ばれたラベルが一致していても、精度によって確率がわずかに変わることがあります。計測された誤差は BENCHMARKS.md を参照してください。BF16 も要求できますが、公開された検証マトリクスには含まれません。
上流 v0.3.5 に従い、フィット済みの較正温度は使用前に [0.5, 5.0] へクランプされます。同梱の choice:11+ バケットは 0.1006 で、そのままではロジットを約 10 倍に先鋭化し、コイントスをほぼ確実であるかのように報告してしまいます。チェックポイントの生の値は agent.temperature_raw と agent.temperature_by_options_raw として引き続き参照でき、ロード時に RuntimeWarning がクランプされたすべてのバケットを名指しします。
batch_size=16 は 1 回のフォワードパスあたりの質問数を上限づけます。より大きなリクエストはチャンクに分けて処理されます。メモリが許すなら増やしてください。device="gpu" または device="cpu" でデバイスを明示的に選べます。指定しなければ MLX の既定デバイスが使われます。
繰り返しのワークロードでは、Agent のロード時に compile=True、pad_to_multiple=16、cache_prompts=True を選べます。プレフィックスキャッシュは 128 問に制限され、CPU 側の状態トークナイズを共有しますが、どの質問も依然として独自のエンコーダ計算を受けます。コンパイルには初回利用のコストと形状の特殊化があり、パディングが一部のワークロードを遅くすることもあります。3 つのオプションは既定で無効です。計測済みの Snake アブレーションと使い方。
agent = laya.load("./models/laya", dtype="float32", batch_size=32)
# Select one checkpoint inside upstream's bundled repository:
multi = laya.load("convaiinnovations/laya", subfolder="multilingual")
# Pin a Hub revision for reproducibility:
agent = laya.load(
    "convaiinnovations/laya",
    revision="c5d78730f3493e4fe16d61507ef4b78eef7318cf",
)
ロード時にはすべてのパラメータ名と形状が検証されます。対応しないエンコーダと既定以外の RoPE スケーリングは明示的に失敗します。ModernBERT のグローバル/ローカル注意パターン、境界を含むスライディングウィンドウ、ローカルとグローバルで異なる RoPE 基底、第 1 層の正規化の挙動は保持されています。
言語ルーティングとプリセット
from laya_mlx import Router, triage_questions

router = Router(dtype="float16", max_loaded=2)
result = router.predict({"message": "发票被重复扣款,请退款。"}, triage_questions())
print(result["routing"])  # multilingual

# Choose the specialized checkpoint explicitly:
result = router.predict(state, questions, task="typed_decisions")ルーター、言語ヒューリスティック、メールヘルパー、アプリケーションプリセットは上流から適応したものです。Router(preload=True) は 3 つのチェックポイントをすべて常駐させます。attach、preload、unload、明示的な lang=、明示的な model= に対応します。モデルのライフサイクルは再入可能ロックで保護されるため、並行スレッドは重複を構築せず 1 つのロード済み Agent を共有します。推論そのものは直列化されません。typed-decisions ワークフローの検出はオプトインのままです。この移植はモデルの限界をそのまま保ちます。英語チェックポイントは多言語チェックポイントの代わりにはならず、confidence は精度を保証しません。
未同定のラテン文字言語(ルーマニア語、ポーランド語、チェコ語、トルコ語など)は、英語と黙ってみなされるのではなく、非英語の文字だけを根拠に多言語チェックポイントへルーティングされます。detect_language(state) はその根拠を報告します:language と is_english に加えて language_undecided と diacritic_rate です。
大規模な choice 集合の絞り込み
choice の選択肢は 1 つの head_max_len トークン予算を共有するため、ラベルが何百もある質問ではラベル 1 つあたり数トークンしか残りません。predict_shortlist は状態と各ラベルを埋め込み、コサイン類似度で上位 k を残し、絞り込んだ集合に対して 1 回の predict を実行します。これはオプトインです:Agent.predict は与えられたすべての基準を依然としてスコアリングします。
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
embed_fn = laya.embed_fn_from_agent(agent)  # mean-pools the loaded encoder; no extra weights
result = laya.predict_shortlist(agent, state, questions, embed_fn, k=20)
print(result["shortlist"])  # which labels were kept, with cosine scores
embed_fn として渡す専用のバイエンコーダは、通常、意思決定チェックポイント自身のエンコーダよりもうまく絞り込めます。絞り込まれた choice 上の確率は、残したラベルのみに対するものです。
コマンドライン
uv run laya-mlx predict \
  --model aac6fef/laya-mlx \
  --state-file examples/state.json \
  --questions examples/questions.json

uv run laya-mlx predict \
  --model aac6fef/laya-multilingual-mlx \
  --state '发票被重复扣款,请退款。' \
  --questions examples/questions.json
v0.3.5 以降に取り込んだ上流の修正
ランタイムは、上流 4aa6761(v0.3.23 のソースツリー)から入力、ルーティング、メールの修正を選択的に取り込んでいます。これにより上流のバッチ、長文書、フック、サーバーの各 API が追加されるわけではありません。ニューラルアーキテクチャの等価性は 573e5b6 に対して引き続きテストされています。
- 時系列の会話リストは、コンテキストが埋まると最も新しいトークンを保持し、 文字列と辞書は先頭を保持します。プレフィックスキャッシュも同じ規則を使います。
noulの criteria はfalse/trueのキー(Python の真偽値キーを含む)のみを受け付けます。 省略可能なlabels={"false": "no", "true": "yes"}はモデルに見せる語を変えますが、 答えは P(true) のままです。不正なキーは無視されず、例外を送出するようになりました。- 文字列以外の instructions は Unicode を保持します。空の instructions、null の score レベル、
Noneの状態は呼び出し側のエラーとなり、質問のエラーはどの質問かを名指しします。 - すべての答えに
answer_confidenceが加わります。これは較正済みの選択肢確率の最大値です。 既存のconfidenceは choice/score ではエントロピー由来の意味を、noul では最大確率を保ちます。 どちらのフィールドも新しいタスクでの精度を保証しません。 usageにstate_tokens、state_tokens_dropped(質問間で最大の減少)、truncated、truncated_questionsが加わります。usage.optionsは選択肢のトークン区間が衝突した質問にのみ現れ、total、distinct、tokens_per_optionを報告します。これは失われた区別を報告するものであり、 回復したり位置バイアスを取り除いたりはしません。- 増分
Router.preload()は常駐モデルを保持し、preload([])は何もしません。 空または言語中立のヒントは検出へフォールスルーし、判定不能なラテン文字テキストはRouter(default=...)に従います。検出はネストした文字列値と混在テキストも調べます。 - メールのクリーニングは、機密性に触れる通常の依頼、宛先への感謝、
From:で始まるものを 保持しつつ、多言語のメールフッターを認識します。
MLX チェックポイントの書き出し
uv run laya-mlx convert \
  --model convaiinnovations/laya \
  --dtype float16 \
  --output models/laya-mlx-fp16

uv run laya-mlx predict \
  --model models/laya-mlx-fp16 \
  --state-file examples/state.json \
  --questions examples/questions.json
書き出しには model.safetensors、エンコーダとエージェントの設定、トークナイザのファイル、mlx_config.json が含まれます。既存の出力ディレクトリは決して上書きされません。これはパラメータ名と dtype の変換であり、量子化や再訓練ではありません。元のチェックポイントはすでに FP16 の重みを格納しており、FP32 を選ぶと算術精度が上がるのであって、元の重みの精度が上がるわけではありません。
テストとベンチマーク
uv sync --extra dev --extra reference --extra benchmark --extra demo
source .venv/bin/activate
gh repo clone NandhaKishorM/laya .upstream
git -C .upstream checkout 573e5b62696ba441230cd6be71d593331b5d23af
pytest -q
python -m benchmarks.download
python -m benchmarks.validate --repeats 100
python -m benchmarks.run --iterations 50 --warmup 5
python -m benchmarks.accuracy --per-class 64
python -m benchmarks.report
GPU 計測は順番に実行してください。ユニットテストは小さなランダムモデルを使い、Transformers および固定した上流の decision head との直接比較を含みます。実チェックポイントの検証は、トークナイズ、ロジット、較正済み確率、繰り返し出力、アクティブメモリの増加をテストします。ベンチマークはバックエンドとチェックポイントの組み合わせごとに新しいプロセスで実行し、すべての計測サンプルを benchmarks/results に保存します。完全なレポートが計測の境界と精度差を説明しています。
GitHub Actions は macOS arm64 ランナー上で小規模モデルの CPU テストを実行します。実チェックポイントの GPU ベンチマークはローカルで計測され、ホスト型 CI には含まれません。
性能調査
性能調査には、数学的な解析と独立したローカル実験の両方が含まれます:
- 初期の性能調査:実装上のボトルネック、MLX カーネルのディスパッチ、統制された実験計画。
- さらなる 10× 高速化の数学的調査:演算予算、条件付き帯域幅の限界、実測の重みスペクトル、厳密な再利用、より小さなモデルの設計。
- エンジニアリング調査:計測済みのコンパイル、量子化、最終ヘッドの選択、自作 Metal カーネル、代表的な行列積。
experiments/ には調査用スクリプトとその生の計測値が入っています。公開されたランタイムの性能と検証結果は BENCHMARKS.md にあり、実験的な各変種にはそれぞれ独自の計測と正しさの結果があります。
現在の調査は、同じチェックポイントでさらに普遍的な 10× 高速化を支持しません。選んだケースでは約 1.03–1.08× のペア中央値の高速化が見られます。エンジニアリングレポートには不確実性区間、量子化の忠実性の結果、自作 Metal カーネルの計測値があります。
モデルカードと検証済みの書き出しを公開用に準備するには、reference の extras をインストールして次を実行します:
python -m scripts.prepare_hub --account YOUR_HF_USERNAME
hf upload YOUR_HF_USERNAME/laya-mlx models/hub/laya-mlx . --exclude '.cache/*'
準備スクリプトは、書き出したすべてのテンソルを元の FP16 ソースと照合します。残り 2 つの準備済みフォルダも同じようにアップロードし、hf cache verify REPO_ID --local-dir EXPORT_PATH でリモートのファイルを確認します。
帰属とライセンス
Apache-2.0 です。LICENSE と NOTICE を参照してください。Laya とその事前学習済み重みは Convai Innovations と上流のコントリビュータによるものです。プロンプトの構築、出力の整形、言語ルーティング、メールユーティリティ、プリセットは、コミット 573e5b62696ba441230cd6be71d593331b5d23af の NandhaKishorM/laya から適応したものです。ニューラルアーキテクチャは、Laya と Hugging Face ModernBERT に従って MLX で再実装されています。
メンテナンスとリリース
このプロジェクトは、ネイティブな MLX 実装を通じて上流 Laya の挙動に従います。上流と互換性のある修正は、独立したモデル変種、サービス API、追加のデモより優先されます。これは選択的な移植であり、上流 API との完全な等価性を主張するものではありません。
リリースするには、pyproject.toml、laya_mlx/__init__.py、uv.lock のバージョンを更新し、対応する vX.Y.Z タグをプッシュします。GitHub Actions は macOS のテストスイートを実行し、バージョンの一貫性を検証し、ホイールとソース配布物をビルドして検査し、リポジトリの PYPI_API_TOKEN シークレットを使って PyPI に公開し、GitHub リリースを作成します。テストやビルドが失敗すると公開は止まります。