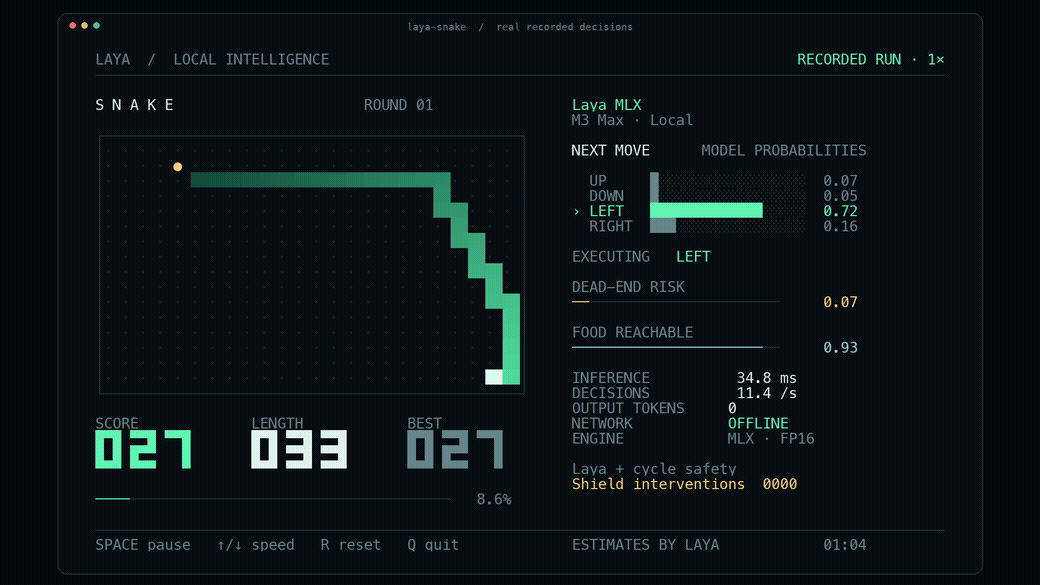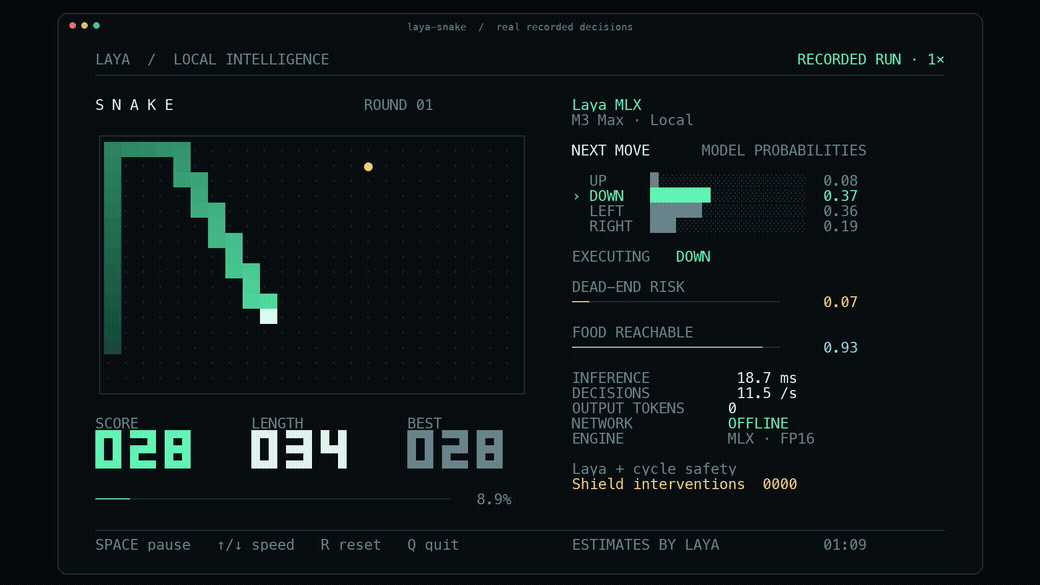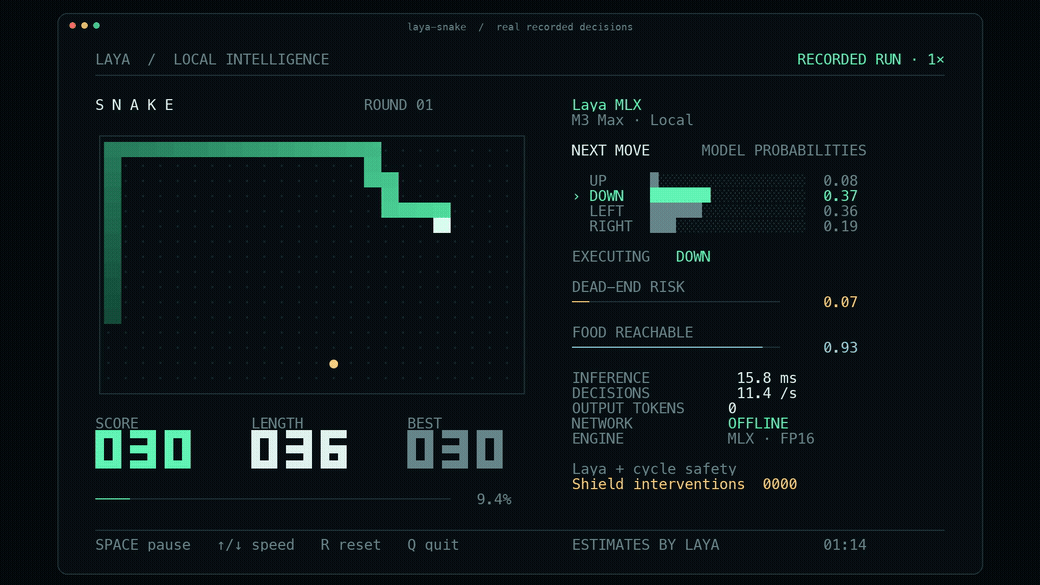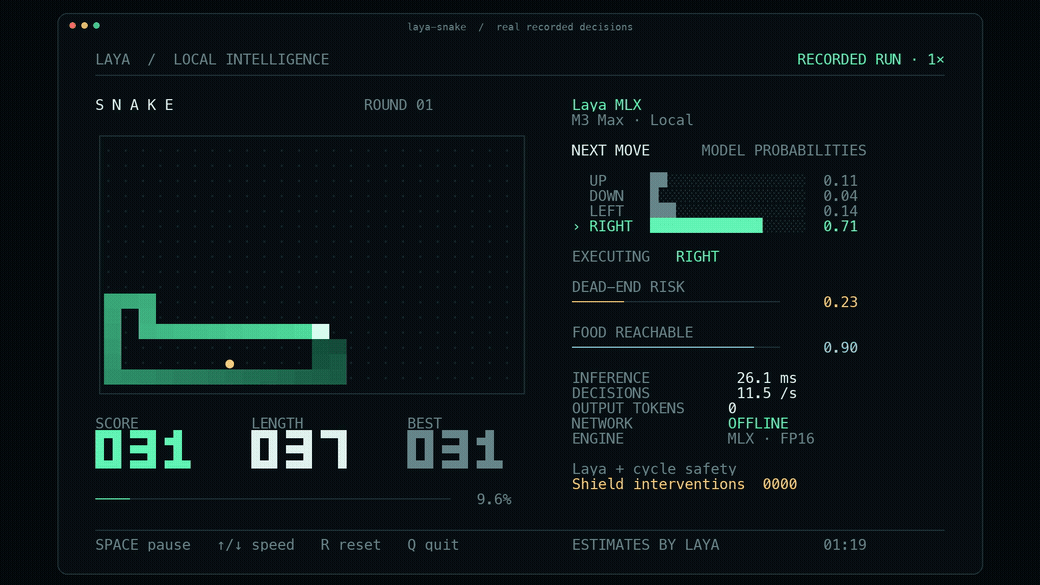
Des décisions typées à poids ouverts, exécutées nativement sur Apple Silicon.
13.4 ms en médiane de bout en bout pour une courte décision typée en anglais. 7.4 ms avec le checkpoint multilingue. 0 token de sortie. Inférence MLX locale, sans PyTorch, sans runtime Transformers ni API cloud.
中文 · Benchmarks · Démo Snake · Poids Hugging Face
Le GIF est un rendu à vitesse d’origine d’une vraie partie de Snake locale. Chaque coup appelle Laya ; la couche de sécurité de cycle visible peut corriger les propositions dangereuses. Les chiffres de latence ci-dessus proviennent du benchmark d’API à une question, distinct du temps par image de la boucle Snake à trois questions. Regarder le MP4 de 30 secondes · Vitesse et stabilité de Snake.
Démarrage rapide
pip install laya-mlximport laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
"I was billed twice. Please refund the duplicate.",
{
"department": {
"type": "choice",
"instructions": "Who should handle this?",
"criteria": ["billing", "technical", "sales"],
}
},
)
print(result["answers"]["department"])Apple Silicon, Python 3.11+, macOS 14+. Le premier chargement télécharge le checkpoint ; les inférences suivantes sont entièrement locales. L’environnement mesuré est macOS 27.2, Python 3.12.13 et MLX 0.32.2. Cette version de MLX fournit des wheels pour macOS 14, 15 et 26 ; l’installateur local a sélectionné la wheel 26. Les versions macOS plus anciennes prises en charge n’ont pas été testées sur cette machine.
Lancer la démo dans le terminal :
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
Télécharge une fois avant la démo hors ligne. Utilise un terminal d’au moins 104 × 35 cellules. Espace met en pause, ↑/↓ change la vitesse, R réinitialise et Q quitte. laya-snake --max-speed prend une décision neuve à chaque coup, sans cadence. Enregistrement, commandes et signification exacte des métriques.
laya-snake --optimize --max-speed active le chemin de compilation et de réutilisation de préfixe testé : 75.40 coups/s sur 2,400 coups, zéro mort et 2 interventions de sécurité visibles dans le test apparié sur M3 Max. C’était environ 6.5% plus rapide que le témoin eager de la même exécution. Preuves de jeu, de performance et de correction.
Performance sur M3 Max
| FP16, de bout en bout | Laya 421M | Multilingue 322M |
|---|---|---|
| Une question courte, P50 | 13.42 ms | 7.39 ms |
| Une question courte, P95 | 13.92 ms | 7.79 ms |
| Débit sur 50 questions | 146.8 q/s | 395.0 q/s |
| Allocation MLX maximale, une question courte | 943.6 MiB | 687.6 MiB |
M3 Max, 40 cœurs GPU, 128 GiB de mémoire. La mesure du temps inclut la préparation du prompt, la tokenisation, les tenseurs, l’inférence synchronisée, la calibration et le formatage du résultat ; le chargement du modèle est exclu. La mesure sur 50 questions utilise batch_size=64 ; l’API est par défaut à 16. Des longueurs, des nombres de questions et des conditions d’exécution différents modifient la latence. Méthode complète et chaque échantillon de temps.
Fidélité du portage : les trois checkpoints correspondaient à la réponse sélectionnée en amont sur 63/63 questions de validation, en FP32 comme en FP16 — 378/378 comparaisons. Chaque configuration a aussi passé 100 appels répétés finis et déterministes, avec une croissance mesurée de la mémoire active nulle. Cela mesure la fidélité sur ces jeux de test, pas l’exactitude sur toutes les questions possibles. Erreurs de probabilité et validation.
Pourquoi des décisions typées ?
Un logiciel a souvent besoin d’un choix, d’un score de grille ou d’une probabilité. Laya répond à ces questions contraintes en une passe avant bidirectionnelle, sans décodage token par token ni JSON généré.
state + typed question → bidirectional encoder → decision heads → probabilitieschoice: des probabilités sur des options nommées.score: des probabilités sur des niveaux de grille ordonnés et leur score attendu.noul: P(vrai) pour une proposition.
Les lignes de question sont mises en lots indépendamment. Leurs représentations par l’encodeur bidirectionnel dépendent à la fois de l’état et de la question ; ce runtime ne prétend pas encoder l’état une fois pour réutiliser ses états cachés sur des questions arbitraires.
L’encodeur, le Transformer de décision, la tête de scoring et la tête d’action tournent tous dans MLX. La tokenisation utilise le tokenizer Rust de Hugging Face. Les poids pré-entraînés d’origine, le formatage des questions, la calibration et le schéma de sortie sont conservés. C’est un portage MLX indépendant, pas une version officielle de Convai Innovations.
Checkpoints pris en charge
| Modèle | Encodeur | Paramètres | Limite de contexte | Usage |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | Anglais |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | Entrée multilingue |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | Workflows typed-decisions en amont |
Le contexte inclut les instructions, les options et l’état. Les trois utilisent les poids d’origine, le formatage des prompts, la calibration de température et le schéma de sortie. Ce dépôt fournit l’inférence et la conversion ; l’entraînement RLCD et le fine-tuning restent dans le projet en amont. C’est un portage indépendant, pas une version officielle de Convai Innovations.
Des checkpoints FP16 pré-convertis sont publiés sur Hugging Face :
Charge-les directement avec laya.load("aac6fef/laya-mlx"), ou utilise les identifiants de checkpoint d’origine ci-dessus. Chaque checkpoint publié inclut sa fiche modèle, ses résultats de validation, sa provenance, sa licence et les sommes de contrôle des fichiers. Les 36 fichiers publiés ont passé une vérification stricte des sommes de contrôle distantes ; les révisions épinglées et les hachages de poids sont consignés dans hub-publication.json.
Installation pour le développement
gh repo clone mizorewww/laya-mlx
cd laya-mlx
uv sync --extra demo
uv run --extra demo laya-snake
Ou installe la dernière révision GitHub avec pip install 'git+https://github.com/mizorewww/laya-mlx.git'. Les poids du modèle sont téléchargés séparément et exclus de Git.
API Python
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx", dtype="float16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate today.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs and outages",
                "sales": "new purchases",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": ["not urgent", "soon", "critical"],
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"])
system_one est un alias de predict. Les états peuvent être du texte, des dictionnaires JSON ou des listes de conversation. choice accepte un dictionnaire ou une liste de libellés uniques ; score renvoie le niveau de grille attendu, indexé à partir de zéro ; noul renvoie P(vrai). Les résultats conservent l’arrondi à quatre décimales en amont, action.act_probability et les champs d’utilisation de tokens.
La précision par défaut est FP16. Utilise dtype="float32" pour un accord numérique plus étroit. Les probabilités peuvent différer légèrement selon la précision, même quand le libellé sélectionné concorde ; voir les erreurs mesurées dans BENCHMARKS.md. BF16 peut être demandé mais ne fait pas partie de la matrice de validation publiée.
À la suite de la v0.3.5 en amont, les températures de calibration ajustées sont bornées à [0.5, 5.0] avant utilisation : le bucket livré choice:11+ vaut 0.1006, ce qui aiguiserait les logits d’environ 10x et rapporterait un pile ou face comme une quasi-certitude. Les valeurs brutes du checkpoint restent disponibles via agent.temperature_raw et agent.temperature_by_options_raw, et un RuntimeWarning nomme chaque bucket borné au chargement.
batch_size=16 plafonne le nombre de questions par passe avant ; les requêtes plus grandes sont traitées par blocs. Augmente-le quand la mémoire le permet. device="gpu" ou device="cpu" sélectionne explicitement un appareil ; sinon, l’appareil par défaut de MLX est utilisé.
Pour les charges de travail répétées, active compile=True, pad_to_multiple=16 et cache_prompts=True au chargement d’un Agent. Le cache de préfixes est borné à 128 questions et partage la tokenisation de l’état côté CPU, tandis que chaque question reçoit encore son propre calcul d’encodeur. La compilation a un coût de première utilisation et une spécialisation de forme ; le padding peut ralentir certaines charges. Les trois options sont désactivées par défaut. Ablation Snake mesurée et utilisation.
agent = laya.load("./models/laya", dtype="float32", batch_size=32)
# Select one checkpoint inside upstream's bundled repository:
multi = laya.load("convaiinnovations/laya", subfolder="multilingual")
# Pin a Hub revision for reproducibility:
agent = laya.load(
    "convaiinnovations/laya",
    revision="c5d78730f3493e4fe16d61507ef4b78eef7318cf",
)
Le chargement valide chaque nom et chaque forme de paramètre. Les encodeurs non pris en charge et les mises à l’échelle RoPE non par défaut échouent explicitement. Le motif d’attention global/local de ModernBERT, la frontière inclusive de la fenêtre glissante, les bases RoPE locale/globale distinctes et le comportement de normalisation de la première couche sont préservés.
Routage de langue et presets
from laya_mlx import Router, triage_questions

router = Router(dtype="float16", max_loaded=2)
result = router.predict({"message": "发票被重复扣款,请退款。"}, triage_questions())
print(result["routing"])  # multilingual

# Choose the specialized checkpoint explicitly:
result = router.predict(state, questions, task="typed_decisions")
Le routeur, les heuristiques de langue, les utilitaires d’e-mail et les presets d’application sont adaptés de l’amont. Router(preload=True) garde les trois checkpoints résidents ; attach, preload, unload, un lang= explicite et un model= explicite sont pris en charge. Le cycle de vie du modèle est protégé par un verrou réentrant, de sorte que des threads concurrents partagent un seul Agent chargé au lieu d’en construire des doublons ; l’inférence elle-même n’est pas sérialisée. La détection des workflows typed-decisions reste optionnelle. Le portage préserve les limites du modèle : les checkpoints anglais ne remplacent pas le checkpoint multilingue, et la confiance ne garantit pas l’exactitude.
Les langues à écriture latine non identifiées (roumain, polonais, tchèque, turc, …) sont routées vers le checkpoint multilingue sur leurs seules lettres non anglaises, plutôt que d’être silencieusement supposées anglaises. detect_language(state) rapporte les preuves : language_undecided et diacritic_rate aux côtés de language et is_english.
Présélection de grands ensembles de choix
Les options d’un choice partagent un même budget de tokens head_max_len, donc une question avec des centaines de libellés ne laisse que quelques tokens par libellé. predict_shortlist encode l’état et chaque libellé, garde les k premiers par similarité cosinus et exécute un seul predict sur l’ensemble réduit. C’est optionnel : Agent.predict note encore chaque critère qu’on lui donne.
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
embed_fn = laya.embed_fn_from_agent(agent)  # mean-pools the loaded encoder; no extra weights
result = laya.predict_shortlist(agent, state, questions, embed_fn, k=20)
print(result["shortlist"])  # which labels were kept, with cosine scores
Un bi-encodeur dédié passé comme embed_fn présélectionne généralement mieux que l’encodeur propre du checkpoint de décision. Les probabilités d’un choice présélectionné ne portent que sur les libellés conservés.
Ligne de commande
uv run laya-mlx predict \
  --model aac6fef/laya-mlx \
  --state-file examples/state.json \
  --questions examples/questions.json

uv run laya-mlx predict \
  --model aac6fef/laya-multilingual-mlx \
  --state '发票被重复扣款,请退款。' \
  --questions examples/questions.json
Correctifs amont sélectionnés après la v0.3.5
Le runtime intègre sélectivement des correctifs d’entrée, de routage et d’e-mail venus de l’amont
4aa6761 (arborescence source v0.3.23). Cela n’ajoute pas les API amont de batch, de documents
longs, de hooks ou de serveur. La parité d’architecture neuronale reste testée contre 573e5b6.
- Les listes de conversation chronologiques conservent leurs tokens les plus récents quand le contexte se remplit ; les chaînes et les dictionnaires conservent leur début. Le cache de préfixes suit la même règle.
- Les critères
nouln’acceptent que les clésfalse/true(y compris les clés booléennes Python). Le paramètre optionnellabels={"false": "no", "true": "yes"}change les mots montrés au modèle, tandis que la réponse reste P(vrai). Les clés invalides lèvent désormais une erreur au lieu d’être ignorées. - Les instructions qui ne sont pas des chaînes préservent l’Unicode. Des instructions vides, des niveaux
de score nuls et un état
Nonelèvent une erreur côté appelant ; les erreurs de question nomment la question. - Chaque réponse ajoute
answer_confidence, la probabilité d’option calibrée maximale. Leconfidenceexistant conserve son sens fondé sur l’entropie pour choice/score et la probabilité maximale pour noul. Aucun des deux champs ne garantit l’exactitude sur une nouvelle tâche. usageajoutestate_tokens,state_tokens_dropped(la plus grande perte parmi les questions),truncatedettruncated_questions.usage.optionsn’apparaît que pour les questions dont les intervalles de tokens d’option se chevauchent, et rapportetotal,distinctettokens_per_option. Cela signale des distinctions perdues ; cela ne les récupère pas et ne supprime pas le biais de position.- Le
Router.preload()incrémental préserve les modèles résidents ;preload([])ne fait rien. Les indices vides ou neutres quant à la langue retombent sur la détection, et le texte latin indécis respecteRouter(default=...). La détection examine les valeurs de chaîne imbriquées et le texte mixte. - Le nettoyage des e-mails préserve les demandes ordinaires qui mentionnent la confidentialité, remercient le
destinataire ou commencent par
From:, tout en reconnaissant les pieds de message multilingues.
Exporter un checkpoint MLX
uv run laya-mlx convert \
  --model convaiinnovations/laya \
  --dtype float16 \
  --output models/laya-mlx-fp16

uv run laya-mlx predict \
  --model models/laya-mlx-fp16 \
  --state-file examples/state.json \
  --questions examples/questions.json
L’export contient model.safetensors, les configurations de l’encodeur et de l’agent, les fichiers du tokenizer et mlx_config.json. Les répertoires de sortie existants ne sont jamais écrasés. C’est une conversion de nom de paramètre/de dtype, pas une quantization ni un réentraînement. Les checkpoints sources stockent déjà des poids FP16 ; choisir FP32 augmente la précision arithmétique, pas la précision des poids sources.
Tests et benchmarks
uv sync --extra dev --extra reference --extra benchmark --extra demo
source .venv/bin/activate
gh repo clone NandhaKishorM/laya .upstream
git -C .upstream checkout 573e5b62696ba441230cd6be71d593331b5d23af
pytest -q
python -m benchmarks.download
python -m benchmarks.validate --repeats 100
python -m benchmarks.run --iterations 50 --warmup 5
python -m benchmarks.accuracy --per-class 64
python -m benchmarks.report
Exécute les mesures GPU séquentiellement. Les tests unitaires utilisent de petits modèles aléatoires et incluent des comparaisons directes avec Transformers et la tête de décision amont épinglée. La validation sur checkpoint réel teste la tokenisation, les logits, les probabilités calibrées, les sorties répétées et la croissance de la mémoire active. Le benchmark exécute chaque backend/checkpoint dans un processus neuf et stocke chaque échantillon de temps dans benchmarks/results. Le rapport complet explique les frontières de mesure et les différences de précision.
GitHub Actions exécute les tests CPU sur petit modèle sur un runner macOS arm64. Les benchmarks GPU sur checkpoint complet sont mesurés localement et ne font pas partie de la CI hébergée.
Recherche sur la performance
Les investigations de performance comprennent à la fois une analyse mathématique et des expériences locales indépendantes :
- Recherche initiale sur la performance : goulots d’étranglement de l’implémentation, dispatch des kernels MLX et plan d’expérience contrôlée.
- Investigation mathématique d’un gain de vitesse supplémentaire de 10× : budgets arithmétiques, bornes de bande passante conditionnelles, spectres de poids réels, réutilisation exacte et conceptions de modèles plus petits.
- Investigation d’ingénierie : compilation mesurée, quantization, sélection de la tête finale, kernels Metal personnalisés et multiplications matricielles représentatives.
experiments/ contient les scripts de recherche et leurs mesures brutes. Les résultats de performance et de validation du runtime publié se trouvent dans BENCHMARKS.md ; chaque variante expérimentale a ses propres résultats de temps et de correction.
L’investigation actuelle ne soutient pas un gain de vitesse universel supplémentaire de 10× avec les mêmes checkpoints. Des cas sélectionnés montrent des gains appariés en médiane d’environ 1.03–1.08× ; le rapport d’ingénierie donne les intervalles d’incertitude, les résultats de fidélité de la quantization et les mesures du kernel Metal personnalisé.
Pour préparer les fiches modèle et des exports vérifiés en vue de la publication, installe les extras de référence et exécute :
python -m scripts.prepare_hub --account YOUR_HF_USERNAME
hf upload YOUR_HF_USERNAME/laya-mlx models/hub/laya-mlx . --exclude '.cache/*'
Le script de préparation vérifie chaque tenseur exporté contre sa source FP16 d’origine. Téléverse les deux autres dossiers préparés de la même manière, puis utilise hf cache verify REPO_ID --local-dir EXPORT_PATH pour vérifier les fichiers distants.
Attribution et licence
Apache-2.0 ; voir LICENSE et NOTICE. Laya et ses poids pré-entraînés sont de Convai Innovations et des contributeurs en amont. La construction des prompts, le formatage de sortie, le routage de langue, les utilitaires d’e-mail et les presets sont adaptés de NandhaKishorM/laya au commit 573e5b62696ba441230cd6be71d593331b5d23af. L’architecture neuronale est réimplémentée dans MLX en suivant Laya et Hugging Face ModernBERT.
Maintenance et versions
Ce projet suit le comportement de Laya en amont au moyen d’une implémentation MLX native. Les correctifs compatibles avec l’amont ont la priorité sur les variantes de modèle indépendantes, les API de service et les démos supplémentaires. Cela reste un portage sélectif, non une revendication de parité complète avec l’API amont.
Pour publier, mets à jour la version dans pyproject.toml, laya_mlx/__init__.py et uv.lock,
puis pousse un tag vX.Y.Z correspondant. GitHub Actions exécute la suite de tests macOS, valide
la cohérence de version, construit et vérifie la wheel et la distribution source, les publie
sur PyPI à l’aide du secret PYPI_API_TOKEN du dépôt, et crée une release GitHub.
Un test ou une build en échec empêche la publication.