Decisiones tipadas de pesos abiertos, ejecutándose de forma nativa en Apple Silicon.
13.4 ms de mediana de extremo a extremo para una decisión tipada breve en inglés. 7.4 ms con el checkpoint multilingüe. 0 tokens de salida. Inferencia MLX local, sin PyTorch, sin runtime de Transformers y sin API en la nube.
Chino · Benchmarks · Demo de Snake · Pesos en Hugging Face
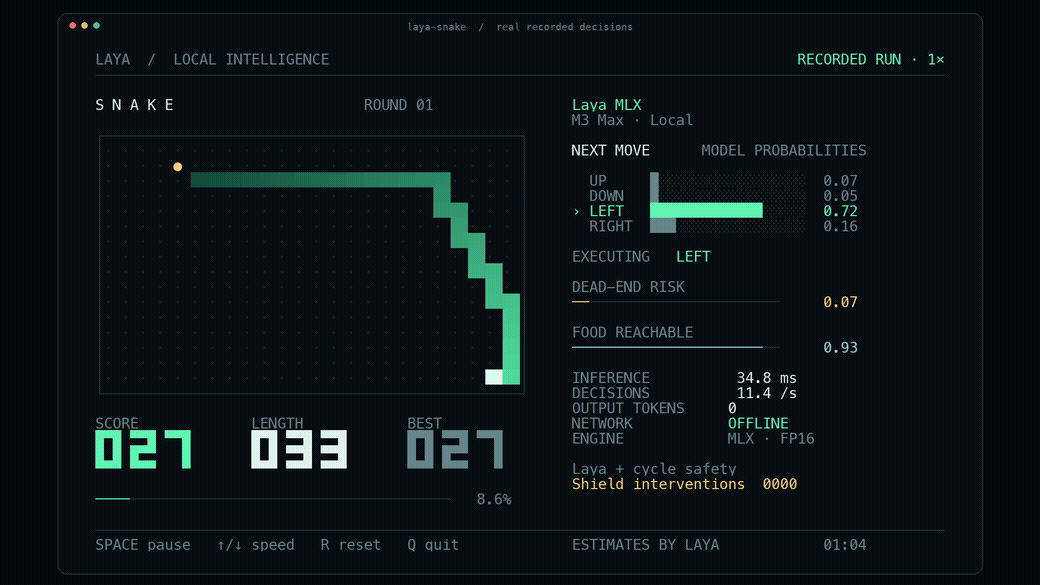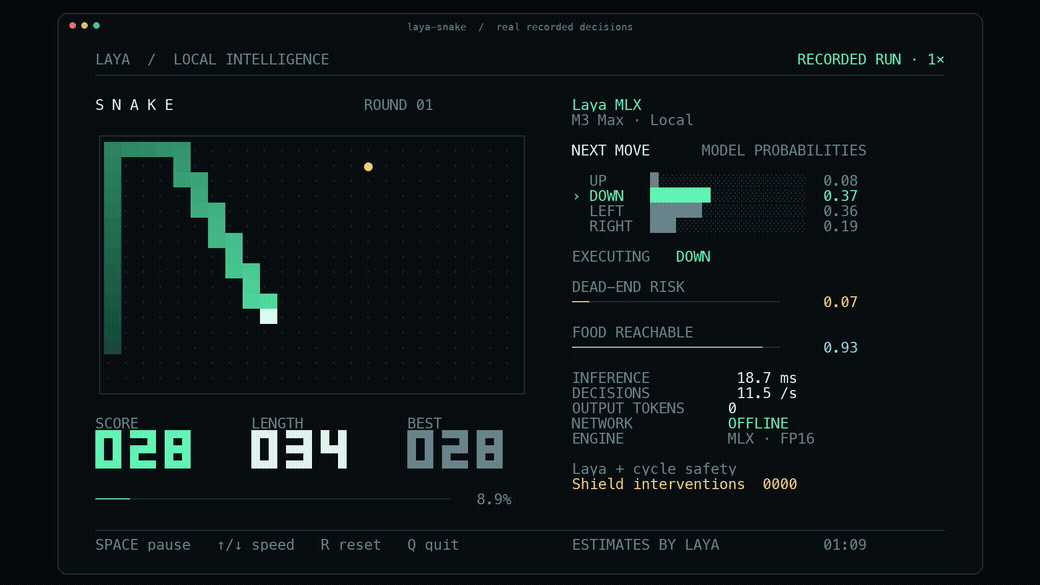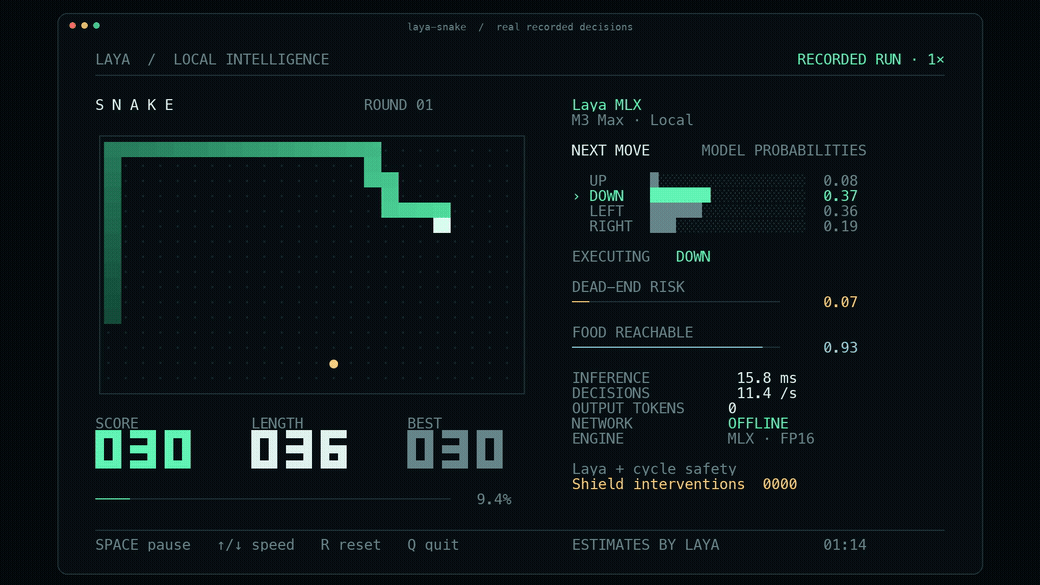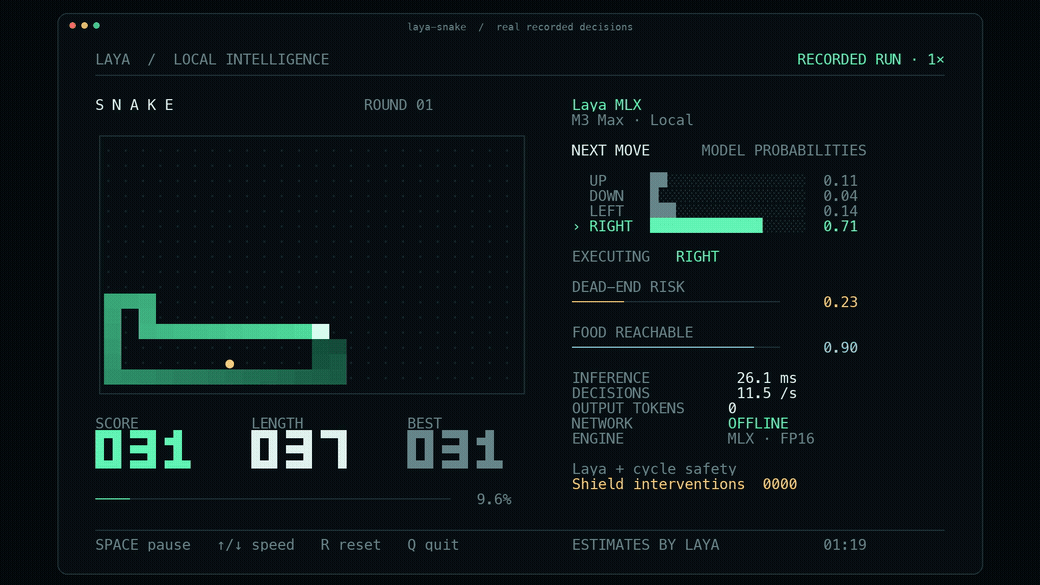
El GIF es una renderización a velocidad original de una partida real de Snake en local. Cada movimiento llama a Laya; la capa visible de seguridad del ciclo puede corregir propuestas inseguras. Las cifras de latencia anteriores corresponden al benchmark independiente de la API de una sola pregunta, no al tiempo por fotograma del bucle de Snake de tres preguntas. Ver el MP4 de 30 segundos · Velocidad y estabilidad de Snake.
Inicio rápido
pip install laya-mlximport laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
"I was billed twice. Please refund the duplicate.",
{
"department": {
"type": "choice",
"instructions": "Who should handle this?",
"criteria": ["billing", "technical", "sales"],
}
},
)
print(result["answers"]["department"])Apple Silicon, Python 3.11+, macOS 14+. La primera carga descarga el checkpoint; la inferencia posterior es totalmente local. El entorno medido es macOS 27.2, Python 3.12.13 y MLX 0.32.2. Esa versión de MLX proporciona wheels para macOS 14, 15 y 26; el instalador local seleccionó la wheel de 26. Las versiones anteriores de macOS compatibles no se probaron en esta máquina.
Ejecuta la demo de terminal:
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
Descarga los pesos una vez antes de la demo sin conexión. Usa una terminal de al menos 104 × 35 celdas. Espacio pausa, ↑/↓ cambia la velocidad, R reinicia y Q sale. laya-snake --max-speed toma una decisión nueva para cada movimiento sin marcar el ritmo. Grabación, controles y significado exacto de las métricas.
laya-snake --optimize --max-speed habilita la ruta probada de compilación y reutilización de prefijos: 75.40 movimientos/s en 2,400 movimientos, cero muertes y 2 intervenciones de seguridad visibles en la prueba emparejada en M3 Max. Fue alrededor de 6.5% más rápido que su control eager de la misma ejecución. Evidencia de juego, rendimiento y corrección.
Rendimiento en M3 Max
| FP16, de extremo a extremo | Laya 421M | Multilingüe 322M |
|---|---|---|
| Una pregunta breve, P50 | 13.42 ms | 7.39 ms |
| Una pregunta breve, P95 | 13.92 ms | 7.79 ms |
| Rendimiento de 50 preguntas | 146.8 q/s | 395.0 q/s |
| Asignación máxima de MLX, una pregunta breve | 943.6 MiB | 687.6 MiB |
M3 Max, 40 núcleos de GPU, 128 GiB de memoria. La medición de tiempos incluye la preparación del prompt, la tokenización, los tensores, la inferencia sincronizada, la calibración y el formateo de resultados; la carga del modelo queda excluida. La medición de 50 preguntas usa batch_size=64; la API usa 16 por defecto. Distintas longitudes, recuentos de preguntas y condiciones de ejecución cambian la latencia. Método completo y todas las muestras de tiempos.
Fidelidad del port: los tres checkpoints coincidieron con la respuesta seleccionada upstream en 63/63 preguntas de validación, tanto en FP32 como en FP16 — 378/378 comparaciones. Cada configuración también superó 100 llamadas repetidas, finitas y deterministas con cero crecimiento medido de memoria activa. Esto mide la fidelidad en esos fixtures, no la exactitud en cualquier pregunta posible. Errores de probabilidad y validación.
¿Por qué decisiones tipadas?
El software a menudo necesita una elección, una puntuación de rúbrica o una probabilidad. Laya responde esas preguntas restringidas en una pasada hacia adelante bidireccional, sin decodificación token por token ni JSON generado.
state + typed question → bidirectional encoder → decision heads → probabilitieschoice: probabilidades sobre opciones con nombre.score: probabilidades sobre niveles de rúbrica ordenados y su puntuación esperada.noul: P(true) para una proposición.
Las filas de preguntas se agrupan por lotes de forma independiente. Sus representaciones del codificador bidireccional dependen tanto del estado como de la pregunta; este runtime no afirma codificar el estado una sola vez y reutilizar sus estados ocultos entre preguntas arbitrarias.
El codificador, el Transformer de decisión, la cabeza de puntuación y la cabeza de acción se ejecutan todos en MLX. La tokenización usa el tokenizador Rust de Hugging Face. Se conservan los pesos preentrenados originales, el formato de las preguntas, la calibración y el esquema de salida. Este es un port independiente a MLX, no una versión oficial de Convai Innovations.
Checkpoints compatibles
| Modelo | Codificador | Parámetros | Límite de contexto | Propósito |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | Inglés |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | Entrada multilingüe |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | Flujos de trabajo de decisiones tipadas upstream |
El contexto incluye las instrucciones, las opciones y el estado. Los tres usan los pesos originales, el formato del prompt, la calibración de temperatura y el esquema de salida. Este repositorio proporciona la inferencia y la conversión; el entrenamiento RLCD y el ajuste fino siguen en el proyecto upstream. Es un port independiente, no una versión oficial de Convai Innovations.
Los checkpoints FP16 preconvertidos se publican en Hugging Face:
Cárgalos directamente con laya.load("aac6fef/laya-mlx"), o usa los IDs de checkpoint originales de arriba. Cada checkpoint publicado incluye su model card, sus resultados de validación, su procedencia, su licencia y las sumas de comprobación de sus archivos. Los 36 archivos publicados superaron una verificación estricta de sumas de comprobación remotas; las revisiones fijadas y los hashes de pesos se registran en hub-publication.json.
Instalación de desarrollo
gh repo clone mizorewww/laya-mlx
cd laya-mlx
uv sync --extra demo
uv run --extra demo laya-snake
O instala la última revisión de GitHub con pip install 'git+https://github.com/mizorewww/laya-mlx.git'. Los pesos del modelo se descargan por separado y quedan excluidos de Git.
API de Python
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx", dtype="float16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate today.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs and outages",
                "sales": "new purchases",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": ["not urgent", "soon", "critical"],
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"])
system_one es un alias de predict. Los estados pueden ser texto, diccionarios JSON o listas de conversación. choice acepta un diccionario o una lista de etiquetas únicas; score devuelve el nivel de rúbrica esperado basado en cero; noul devuelve P(true). Los resultados conservan el redondeo a cuatro decimales de upstream, action.act_probability y los campos de uso de tokens.
La precisión por defecto es FP16. Usa dtype="float32" para una concordancia numérica más cercana. Las probabilidades pueden diferir ligeramente entre precisiones incluso cuando la etiqueta seleccionada coincide; consulta los errores medidos en BENCHMARKS.md. Se puede solicitar BF16, pero no forma parte de la matriz de validación publicada.
Siguiendo upstream v0.3.5, las temperaturas de calibración ajustadas se limitan a [0.5, 5.0] antes de usarse: el bucket choice:11+ incluido es 0.1006, que agudizaría los logits ~10x y reportaría una moneda al aire como casi certeza. Los valores brutos del checkpoint siguen disponibles como agent.temperature_raw y agent.temperature_by_options_raw, y un RuntimeWarning nombra cada bucket limitado al cargar.
batch_size=16 limita el número de preguntas por pasada hacia adelante; las solicitudes más grandes se procesan en fragmentos. Auméntalo cuando la memoria lo permita. device="gpu" o device="cpu" selecciona un dispositivo de forma explícita; de lo contrario, se usa el dispositivo por defecto de MLX.
Para cargas de trabajo repetidas, opta por compile=True, pad_to_multiple=16 y cache_prompts=True al cargar un Agent. La caché de prefijos está limitada a 128 preguntas y comparte la tokenización del estado en CPU, mientras que cada pregunta sigue recibiendo su propia computación de codificador. La compilación tiene un coste de primer uso y una especialización por forma; el padding puede hacer más lentas algunas cargas de trabajo. Las tres opciones están desactivadas por defecto. Ablación y uso medidos con Snake.
agent = laya.load("./models/laya", dtype="float32", batch_size=32)
# Select one checkpoint inside upstream's bundled repository:
multi = laya.load("convaiinnovations/laya", subfolder="multilingual")
# Pin a Hub revision for reproducibility:
agent = laya.load(
    "convaiinnovations/laya",
    revision="c5d78730f3493e4fe16d61507ef4b78eef7318cf",
)
La carga valida el nombre y la forma de cada parámetro. Los codificadores no compatibles y el escalado RoPE distinto del predeterminado fallan de forma explícita. Se conservan el patrón de atención global/local de ModernBERT, el límite inclusivo de la ventana deslizante, las bases RoPE local/global distintas y el comportamiento de normalización de la primera capa.
Enrutamiento de idioma y presets
from laya_mlx import Router, triage_questions

router = Router(dtype="float16", max_loaded=2)
result = router.predict({"message": "发票被重复扣款,请退款。"}, triage_questions())
print(result["routing"])  # multilingual

# Choose the specialized checkpoint explicitly:
result = router.predict(state, questions, task="typed_decisions")
El router, las heurísticas de idioma, los asistentes de correo y los presets de aplicación están adaptados de upstream. Router(preload=True) mantiene los tres checkpoints residentes; se admiten attach, preload, unload, lang= explícito y model= explícito. El ciclo de vida del modelo está protegido por un lock reentrante, de modo que los hilos concurrentes comparten un único Agent cargado en lugar de construir duplicados; la inferencia en sí no se serializa. La detección de flujos de trabajo de decisiones tipadas sigue siendo opt-in. El port conserva las limitaciones del modelo: los checkpoints en inglés no sustituyen al checkpoint multilingüe, y la confianza no garantiza la exactitud.
Los idiomas de escritura latina no identificados (rumano, polaco, checo, turco, …) se enrutan al checkpoint multilingüe solo por sus letras no inglesas, en lugar de darse por supuesto silenciosamente que son inglés. detect_language(state) informa de la evidencia: language_undecided y diacritic_rate junto con language y is_english.
Preselección de conjuntos grandes de opciones
Las opciones de choice comparten un único presupuesto de tokens head_max_len, así que una pregunta con cientos de etiquetas deja solo unos pocos tokens por etiqueta. predict_shortlist incrusta el estado y cada etiqueta, conserva las k mejores por similitud del coseno y ejecuta un único predict sobre el conjunto reducido. Esto es opt-in: Agent.predict sigue puntuando cada criterio que se le da.
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
embed_fn = laya.embed_fn_from_agent(agent)  # mean-pools the loaded encoder; no extra weights
result = laya.predict_shortlist(agent, state, questions, embed_fn, k=20)
print(result["shortlist"])  # which labels were kept, with cosine scores
Un bi-encoder dedicado pasado como embed_fn suele preseleccionar mejor que el propio codificador del checkpoint de decisión. Las probabilidades de un choice preseleccionado son solo sobre las etiquetas conservadas.
Línea de comandos
uv run laya-mlx predict \
  --model aac6fef/laya-mlx \
  --state-file examples/state.json \
  --questions examples/questions.json

uv run laya-mlx predict \
  --model aac6fef/laya-multilingual-mlx \
  --state '发票被重复扣款,请退款。' \
  --questions examples/questions.json
Correcciones upstream seleccionadas después de v0.3.5
El runtime incorpora de forma selectiva correcciones de entrada, enrutamiento y correo del upstream
4aa6761 (árbol de fuentes v0.3.23). Esto no añade las API upstream de lotes, documentos largos,
hooks ni servidor. La paridad de la arquitectura neuronal sigue probándose contra 573e5b6.
- Las listas de conversación cronológicas conservan sus tokens más recientes cuando el contexto se llena; las cadenas y los diccionarios conservan su comienzo. La caché de prefijos usa la misma regla.
- Los criterios
noulaceptan solo clavesfalse/true(incluidas las claves booleanas de Python).labels={"false": "no", "true": "yes"}opcional cambia las palabras que se muestran al modelo, mientras que la respuesta sigue siendo P(true). Las claves no válidas ahora lanzan en lugar de ignorarse. - Las instrucciones que no son cadenas preservan Unicode. Las instrucciones vacías, los niveles score nulos
y un estado
Nonelanzan un error del llamador; los errores de pregunta nombran la pregunta. - Cada respuesta añade
answer_confidence, la máxima probabilidad de opción calibrada. Laconfidenceexistente conserva su significado basado en entropía para choice/score y la máxima probabilidad para noul. Ninguno de los dos campos garantiza la exactitud en una tarea nueva. usageañadestate_tokens,state_tokens_dropped(la mayor pérdida entre preguntas),truncatedytruncated_questions.usage.optionsaparece solo para preguntas cuyos tramos de tokens de opciones chocan, e informa detotal,distinctytokens_per_option. Esto informa de distinciones perdidas; no las recupera ni elimina el sesgo de posición.Router.preload()incremental conserva los modelos residentes;preload([])no hace nada. Las pistas en blanco o neutrales respecto al idioma recaen en la detección, y el texto latino indeciso respetaRouter(default=...). La detección examina valores de cadena anidados y texto mixto.- La limpieza de correo preserva las solicitudes ordinarias que mencionan la confidencialidad, agradecen al
destinatario o empiezan por
From:, a la vez que reconoce los pies de correo multilingües.
Exportar un checkpoint MLX
uv run laya-mlx convert \
  --model convaiinnovations/laya \
  --dtype float16 \
  --output models/laya-mlx-fp16

uv run laya-mlx predict \
  --model models/laya-mlx-fp16 \
  --state-file examples/state.json \
  --questions examples/questions.json
La exportación contiene model.safetensors, las configuraciones del codificador y del agente, los archivos del tokenizador y mlx_config.json. Los directorios de salida existentes nunca se sobrescriben. Es una conversión de nombre de parámetro/dtype, no cuantización ni reentrenamiento. Los checkpoints de origen ya almacenan pesos FP16; elegir FP32 aumenta la precisión aritmética, no la precisión de los pesos de origen.
Pruebas y benchmarks
uv sync --extra dev --extra reference --extra benchmark --extra demo
source .venv/bin/activate
gh repo clone NandhaKishorM/laya .upstream
git -C .upstream checkout 573e5b62696ba441230cd6be71d593331b5d23af
pytest -q
python -m benchmarks.download
python -m benchmarks.validate --repeats 100
python -m benchmarks.run --iterations 50 --warmup 5
python -m benchmarks.accuracy --per-class 64
python -m benchmarks.report
Ejecuta las mediciones de GPU de forma secuencial. Las pruebas unitarias usan modelos aleatorios pequeños e incluyen comparaciones directas con Transformers y con la cabeza de decisión upstream fijada. La validación con checkpoints reales prueba la tokenización, los logits, las probabilidades calibradas, las salidas repetidas y el crecimiento de memoria activa. El benchmark ejecuta cada backend/checkpoint en un proceso nuevo y almacena cada muestra de tiempos en benchmarks/results. El informe completo explica los límites de las mediciones de tiempos y las diferencias de precisión.
GitHub Actions ejecuta pruebas de CPU con modelos pequeños en un runner macOS arm64. Los benchmarks completos de GPU con checkpoints se miden en local y no forman parte de la CI alojada.
Investigación de rendimiento
Las investigaciones de rendimiento incluyen tanto análisis matemático como experimentos locales independientes:
- Investigación inicial de rendimiento: cuellos de botella de implementación, despacho de kernels de MLX y un plan de experimentos controlados.
- Investigación matemática de una mejora adicional de 10×: presupuestos aritméticos, límites condicionales de ancho de banda, espectros de pesos reales, reutilización exacta y diseños de modelos más pequeños.
- Investigación de ingeniería: compilación medida, cuantización, selección de la cabeza final, kernels Metal personalizados y multiplicaciones de matrices representativas.
experiments/ contiene los scripts de investigación y sus mediciones en bruto. El rendimiento y los resultados de validación del runtime publicado están en BENCHMARKS.md; cada variante experimental tiene sus propios resultados de tiempos y corrección.
La investigación actual no respalda una mejora universal adicional de 10× con los mismos checkpoints. Casos seleccionados muestran mejoras de aproximadamente 1.03–1.08× en la mediana emparejada; el informe de ingeniería ofrece los intervalos de incertidumbre, los resultados de fidelidad de la cuantización y las mediciones del kernel Metal personalizado.
Para preparar model cards y exportaciones verificadas para su publicación, instala los extras de referencia y ejecuta:
python -m scripts.prepare_hub --account YOUR_HF_USERNAME
hf upload YOUR_HF_USERNAME/laya-mlx models/hub/laya-mlx . --exclude '.cache/*'
El script de preparación comprueba cada tensor exportado contra su fuente FP16 original. Sube las otras dos carpetas preparadas de la misma forma, y luego usa hf cache verify REPO_ID --local-dir EXPORT_PATH para comprobar los archivos remotos.
Atribución y licencia
Apache-2.0; consulta LICENSE y NOTICE. Laya y sus pesos preentrenados son de Convai Innovations y de los colaboradores upstream. La construcción del prompt, el formateo de salida, el enrutamiento de idioma, las utilidades de correo y los presets están adaptados de NandhaKishorM/laya en el commit 573e5b62696ba441230cd6be71d593331b5d23af. La arquitectura neuronal se reimplementa en MLX siguiendo a Laya y a Hugging Face ModernBERT.
Mantenimiento y versiones
Este proyecto sigue el comportamiento de Laya upstream mediante una implementación nativa en MLX. Las correcciones compatibles con upstream tienen prioridad sobre las variantes de modelo independientes, las API de servicio y las demos adicionales. Sigue siendo un port selectivo, no una afirmación de paridad total con la API upstream.
Para publicar una versión, actualiza la versión en pyproject.toml, laya_mlx/__init__.py y uv.lock,
luego envía una etiqueta vX.Y.Z correspondiente. GitHub Actions ejecuta la suite de pruebas de macOS, valida
la consistencia de versiones, construye y comprueba la wheel y la distribución de código fuente, las publica
en PyPI usando el secreto PYPI_API_TOKEN del repositorio y crea una release de GitHub.
Un test o una compilación fallidos impiden la publicación.