Apple Silicon에서 네이티브로 실행되는, 오픈 가중치 타입 지정 결정.
짧은 영어 타입 지정 결정 하나에 엔드투엔드 중앙값 13.4 ms. 다국어 체크포인트로는 7.4 ms. 출력 토큰 0개. PyTorch도, Transformers 런타임도, 클라우드 API도 없이 로컬 MLX 추론으로 처리합니다.
중국어 · 벤치마크 · Snake 데모 · Hugging Face 가중치
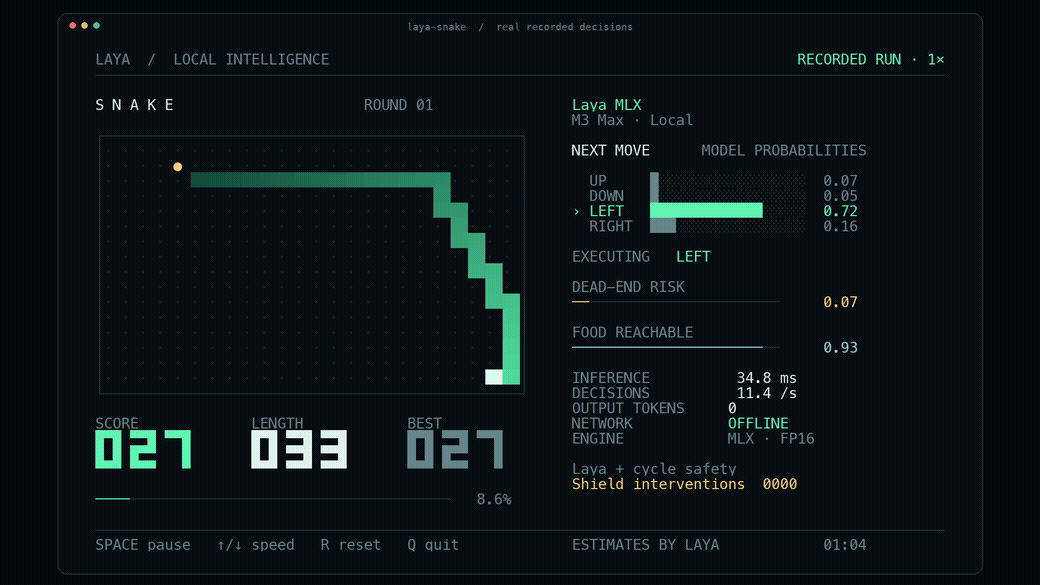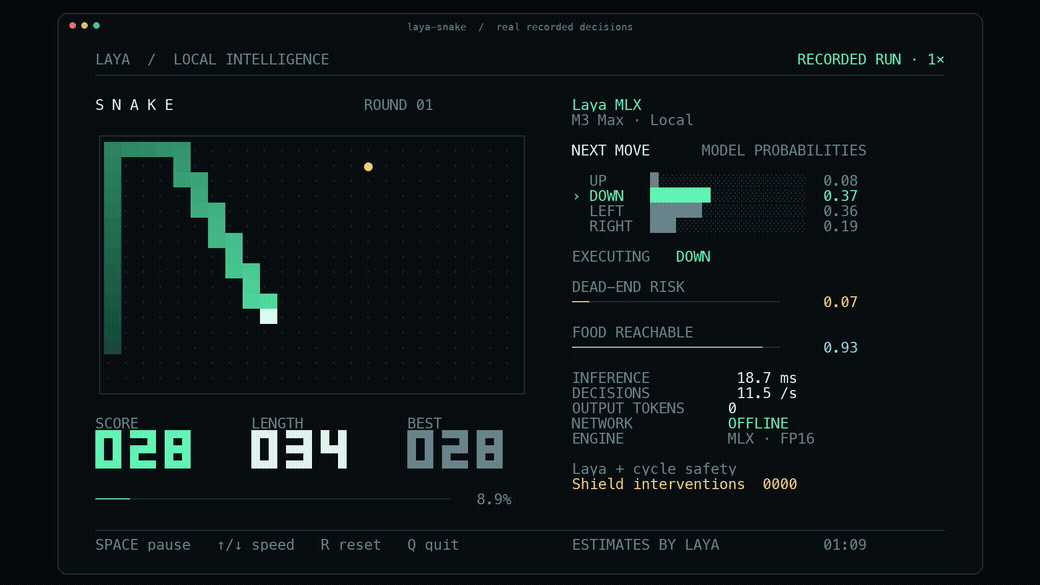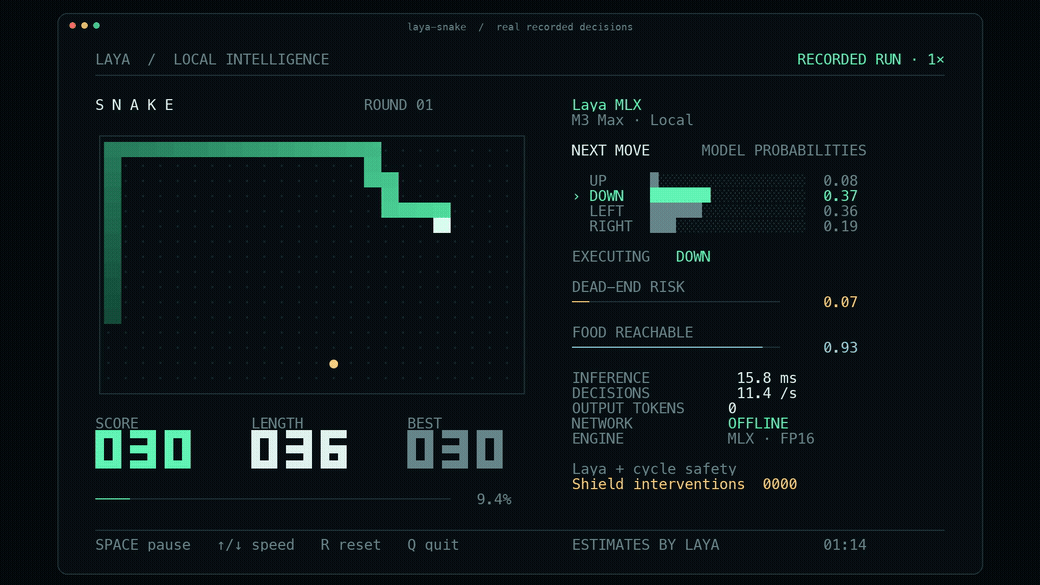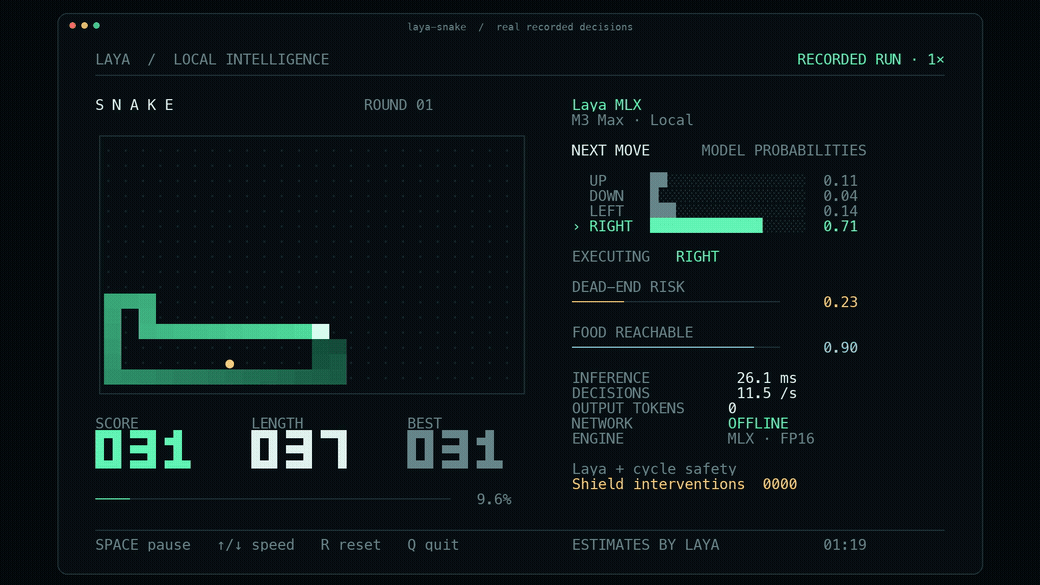
이 GIF는 실제 로컬 Snake 실행을 원래 속도로 렌더링한 것입니다. 매 이동마다 Laya를 호출하며, 화면에 보이는 사이클 안전 레이어가 안전하지 않은 제안을 바로잡을 수 있습니다. 위의 지연 시간 수치는 별도의 질문 1개 API 벤치마크이며, 질문 3개짜리 Snake 루프의 프레임 시간이 아닙니다. 30초 MP4 보기 · Snake 속도와 안정성.
빠른 시작
pip install laya-mlximport laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
"I was billed twice. Please refund the duplicate.",
{
"department": {
"type": "choice",
"instructions": "Who should handle this?",
"criteria": ["billing", "technical", "sales"],
}
},
)
print(result["answers"]["department"])Apple Silicon, Python 3.11+, macOS 14+가 필요합니다. 첫 로딩 때 체크포인트를 내려받고, 이후 추론은 전부 로컬에서 이뤄집니다. 측정 환경은 macOS 27.2, Python 3.12.13, MLX 0.32.2였습니다. 해당 MLX 릴리스는 macOS 14·15·26용 wheel을 제공하며, 로컬 설치 프로그램은 26 wheel을 골랐습니다. 더 오래된 지원 macOS 버전은 이 머신에서 테스트하지 않았습니다.
터미널 데모를 실행하십시오:
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
오프라인 데모 전에 한 번 내려받으십시오. 최소 104 × 35 칸의 터미널을 사용하십시오. Space는 일시정지, ↑/↓는 속도 변경, R은 재시작, Q는 종료입니다. laya-snake --max-speed는 페이싱 없이 매 이동마다 새로 결정합니다. 기록, 조작법, 정확한 지표 의미.
laya-snake --optimize --max-speed는 검증된 컴파일 및 프리픽스 재사용 경로를 켭니다. 짝지은 M3 Max 테스트에서 이동 2,400회 동안 75.40 moves/s, 사망 0회, 눈에 보이는 안전 개입 2회를 기록했습니다. 같은 실행의 eager 대조군보다 약 6.5% 빨랐습니다. 게임플레이, 성능, 정확성 근거.
M3 Max 성능
| FP16, 엔드투엔드 | Laya 421M | Multilingual 322M |
|---|---|---|
| 짧은 질문 1개, P50 | 13.42 ms | 7.39 ms |
| 짧은 질문 1개, P95 | 13.92 ms | 7.79 ms |
| 질문 50개 처리량 | 146.8 q/s | 395.0 q/s |
| 짧은 질문 1개, MLX 최대 할당량 | 943.6 MiB | 687.6 MiB |
M3 Max, GPU 코어 40개, 메모리 128 GiB. 타이밍에는 프롬프트 준비, 토크나이즈, 텐서, 동기화된 추론, 캘리브레이션, 결과 포매팅이 포함되며 모델 로딩은 제외됩니다. 질문 50개 측정은 batch_size=64를 쓰고, API 기본값은 16입니다. 길이, 질문 수, 런타임 조건이 다르면 지연 시간도 달라집니다. 전체 방법과 모든 타이밍 샘플.
포팅 충실도: 세 체크포인트 모두 FP32와 FP16 양쪽에서 검증 질문 63/63에 대해 업스트림이 선택한 답과 일치했습니다 — 총 378/378 비교. 각 구성은 측정된 활성 메모리 증가가 0인 상태에서 유한하고 결정적인 호출을 100회 반복해 통과하기도 했습니다. 이는 해당 픽스처에 대한 충실도를 측정한 것이지, 가능한 모든 질문에 대한 정확도가 아닙니다. 확률 오차와 검증.
왜 타입 지정 결정인가?
소프트웨어는 흔히 선택, 루브릭 점수, 확률을 필요로 합니다. Laya는 그런 제약된 질문에 양방향 포워드 패스 한 번으로 답하며, 토큰 단위 디코딩이나 생성된 JSON을 쓰지 않습니다.
state + typed question → bidirectional encoder → decision heads → probabilitieschoice: 이름이 붙은 선택지에 대한 확률.score: 순서가 있는 루브릭 단계에 대한 확률과 그 기대 점수.noul: 명제가 참일 확률 P(true).
질문 행은 독립적으로 배치 처리됩니다. 각 질문의 양방향 인코더 표현은 상태와 질문 양쪽에 의존하며, 이 런타임은 상태를 한 번 인코딩해 그 은닉 상태를 임의의 질문들 사이에서 재사용한다고 주장하지 않습니다.
인코더, 결정 Transformer, 스코어링 헤드, 액션 헤드는 모두 MLX에서 실행됩니다. 토크나이즈는 Hugging Face의 Rust 토크나이저를 씁니다. 원래의 사전 학습 가중치, 질문 포매팅, 캘리브레이션, 출력 스키마는 그대로 유지됩니다. 이것은 독립적인 MLX 포트이며, 공식 Convai Innovations 릴리스가 아닙니다.
지원 체크포인트
| 모델 | 인코더 | 파라미터 | 컨텍스트 한도 | 용도 |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | 영어 |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | 다국어 입력 |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | 업스트림 타입 지정 결정 워크플로 |
컨텍스트에는 지시문, 선택지, 상태가 포함됩니다. 세 체크포인트 모두 원래의 가중치, 프롬프트 포매팅, 온도 캘리브레이션, 출력 스키마를 씁니다. 이 저장소는 추론과 변환을 제공하며, RLCD 훈련과 파인튜닝은 업스트림 프로젝트에 남아 있습니다. 독립적인 포트이며 공식 Convai Innovations 릴리스가 아닙니다.
사전 변환된 FP16 체크포인트가 Hugging Face에 공개되어 있습니다:
이들은 laya.load("aac6fef/laya-mlx")로 바로 불러오거나, 위의 원래 체크포인트 ID를 쓸 수 있습니다. 공개된 각 체크포인트에는 모델 카드, 검증 결과, 출처, 라이선스, 파일 체크섬이 포함됩니다. 공개된 파일 36개 전부가 엄격한 원격 체크섬 검증을 통과했으며, 고정된 리비전과 가중치 해시는 hub-publication.json에 기록되어 있습니다.
개발용 설치
gh repo clone mizorewww/laya-mlx
cd laya-mlx
uv sync --extra demo
uv run --extra demo laya-snake
또는 pip install 'git+https://github.com/mizorewww/laya-mlx.git'로 최신 GitHub 리비전을 설치할 수 있습니다. 모델 가중치는 별도로 내려받으며 Git에서 제외됩니다.
Python API
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx", dtype="float16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate today.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs and outages",
                "sales": "new purchases",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": ["not urgent", "soon", "critical"],
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"])system_one은 predict의 별칭입니다. 상태는 텍스트, JSON 딕셔너리, 대화 리스트가 될 수 있습니다. choice는 딕셔너리나 중복 없는 레이블 리스트를 받고, score는 0부터 시작하는 루브릭 기대 단계를 돌려주며, noul은 P(true)를 돌려줍니다. 결과에는 업스트림의 소수점 네 자리 반올림, action.act_probability, 토큰 사용량 필드가 유지됩니다.
기본 정밀도는 FP16입니다. 수치 일치도를 더 높이려면 dtype="float32"를 쓰십시오. 선택된 레이블이 같아도 정밀도에 따라 확률이 조금씩 달라질 수 있습니다. 측정된 오차는 BENCHMARKS.md를 참고하십시오. BF16도 요청할 수 있지만 공개된 검증 매트릭스에는 들어 있지 않습니다.
업스트림 v0.3.5에 따라, 적합된 캘리브레이션 온도는 사용 전에 [0.5, 5.0]로 클램프됩니다. 배포된 choice:11+ 버킷은 0.1006인데, 그대로 두면 로짓을 약 10배로 예리하게 만들어 동전 던지기를 거의 확실한 것으로 보고하게 됩니다. 체크포인트의 원시 값은 agent.temperature_raw와 agent.temperature_by_options_raw로 계속 쓸 수 있으며, 로딩 시 클램프된 버킷마다 RuntimeWarning이 이름을 밝힙니다.
batch_size=16은 포워드 패스당 질문 수를 제한합니다. 더 큰 요청은 청크로 나뉘어 처리됩니다. 메모리가 허락하면 이 값을 늘리십시오. device="gpu"나 device="cpu"로 장치를 명시적으로 고를 수 있고, 그렇지 않으면 MLX의 기본 장치를 씁니다.
반복되는 작업 부하에서는 Agent를 로딩할 때 compile=True, pad_to_multiple=16, cache_prompts=True를 선택적으로 켜십시오. 프리픽스 캐시는 질문 128개로 제한되며 CPU 상태 토크나이즈를 공유하지만, 각 질문은 여전히 자기 자신의 인코더 연산을 거칩니다. 컴파일에는 첫 사용 비용과 형상 특화가 따르고, 패딩 때문에 일부 작업 부하는 더 느려질 수 있습니다. 세 옵션 모두 기본값은 꺼짐입니다. 측정된 Snake ablation과 사용법.
agent = laya.load("./models/laya", dtype="float32", batch_size=32)
# Select one checkpoint inside upstream's bundled repository:
multi = laya.load("convaiinnovations/laya", subfolder="multilingual")
# Pin a Hub revision for reproducibility:
agent = laya.load(
    "convaiinnovations/laya",
    revision="c5d78730f3493e4fe16d61507ef4b78eef7318cf",
)
로딩은 모든 파라미터 이름과 형상을 검증합니다. 지원하지 않는 인코더와 기본값이 아닌 RoPE 스케일링은 명시적으로 실패합니다. ModernBERT의 전역/지역 어텐션 패턴, 양끝을 포함하는 슬라이딩 윈도 경계, 지역/전역 RoPE 기저의 구분, 첫 레이어 정규화 동작이 그대로 보존됩니다.
언어 라우팅과 프리셋
from laya_mlx import Router, triage_questions

router = Router(dtype="float16", max_loaded=2)
result = router.predict({"message": "发票被重复扣款,请退款。"}, triage_questions())
print(result["routing"])  # multilingual

# Choose the specialized checkpoint explicitly:
result = router.predict(state, questions, task="typed_decisions")
라우터, 언어 휴리스틱, 이메일 헬퍼, 애플리케이션 프리셋은 업스트림에서 가져왔습니다. Router(preload=True)는 세 체크포인트를 모두 상주시킵니다. attach, preload, unload, 명시적 lang=, 명시적 model=이 지원됩니다. 모델 수명 주기는 재진입 락으로 보호되어, 동시 스레드가 중복 생성 대신 하나의 로딩된 Agent를 공유합니다. 추론 자체는 직렬화되지 않습니다. 타입 지정 결정 워크플로 감지는 선택 사항으로 남습니다. 이 포트는 모델의 한계도 그대로 유지합니다. 영어 체크포인트는 다국어 체크포인트의 대체물이 아니며, 신뢰도가 정확도를 보장하지 않습니다.
식별되지 않은 라틴 문자 언어(루마니아어, 폴란드어, 체코어, 터키어, …)는 조용히 영어로 가정되지 않고, 비영어 문자만으로 다국어 체크포인트로 라우팅됩니다. detect_language(state)는 근거를 보고합니다. language와 is_english와 함께 language_undecided와 diacritic_rate를 냅니다.
큰 선택지 집합 추리기
choice 선택지는 하나의 head_max_len 토큰 예산을 공유하므로, 레이블이 수백 개인 질문에서는 레이블마다 토큰이 몇 개 남지 않습니다. predict_shortlist는 상태와 각 레이블을 임베딩하고, 코사인 유사도로 상위 k개만 남긴 뒤 줄어든 집합에 predict를 한 번 돌립니다. 이는 선택 사항입니다. Agent.predict는 주어진 모든 기준을 여전히 채점합니다.
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
embed_fn = laya.embed_fn_from_agent(agent)  # mean-pools the loaded encoder; no extra weights
result = laya.predict_shortlist(agent, state, questions, embed_fn, k=20)
print(result["shortlist"]) # which labels were kept, with cosine scoresembed_fn으로 전달한 전용 바이인코더(bi-encoder)는 보통 결정 체크포인트 자체의 인코더보다 더 잘 추려냅니다. 추려진 choice의 확률은 남겨진 레이블만을 대상으로 합니다.
명령줄
uv run laya-mlx predict \
  --model aac6fef/laya-mlx \
  --state-file examples/state.json \
  --questions examples/questions.json

uv run laya-mlx predict \
  --model aac6fef/laya-multilingual-mlx \
  --state '发票被重复扣款,请退款。' \
  --questions examples/questions.json
v0.3.5 이후 선택적으로 반영한 업스트림 수정
이 런타임은 업스트림 4aa6761(v0.3.23 소스 트리)의 입력, 라우팅, 이메일 수정을 선택적으로 반영합니다. 업스트림의 배치, 장문, 훅, 서버 API를 추가하지는 않습니다. 신경망 아키텍처의 동등성은 여전히 573e5b6을 기준으로 테스트합니다.
- 시간순 대화 리스트는 컨텍스트가 차면 최신 토큰을 남기고, 문자열과 딕셔너리는 앞부분을 남깁니다. 프리픽스 캐싱도 같은 규칙을 씁니다.
noul기준은false/true키만 받습니다(Python 불리언 키 포함). 선택적인labels={"false": "no", "true": "yes"}는 모델에 보이는 단어를 바꾸지만 답은 여전히 P(true)입니다. 잘못된 키는 이제 무시되지 않고 예외를 발생시킵니다.- 문자열이 아닌 지시문도 유니코드를 보존합니다. 빈 지시문, null 점수 단계,
None상태는 호출자 오류를 발생시키며, 질문 오류는 해당 질문의 이름을 밝힙니다. - 모든 답에는 캘리브레이션된 선택지 확률의 최댓값인
answer_confidence가 추가됩니다. 기존confidence는 choice/score에서는 엔트로피 기반 의미를, noul에서는 최대 확률을 유지합니다. 어느 필드도 새 작업에서의 정확도를 보장하지 않습니다. usage에는state_tokens,state_tokens_dropped(질문들 가운데 가장 큰 손실),truncated,truncated_questions가 추가됩니다.usage.options는 선택지 토큰 구간이 충돌하는 질문에만 나타나며total,distinct,tokens_per_option을 보고합니다. 이는 잃어버린 구분을 알려줄 뿐, 되살리거나 위치 편향을 없애지는 않습니다.- 증분식
Router.preload()는 상주 모델을 보존하고,preload([])는 아무것도 하지 않습니다. 비어 있거나 언어 중립적인 힌트는 감지로 넘어가며, 판단되지 않은 라틴 문자 텍스트는Router(default=...)를 따릅니다. 감지는 중첩된 문자열 값과 혼합 텍스트를 살핍니다. - 이메일 정리는 기밀을 언급하거나, 수신자에게 감사하거나,
From:으로 시작하는 평범한 요청을 보존하면서 다국어 메일 꼬리말을 인식합니다.
MLX 체크포인트 내보내기
uv run laya-mlx convert \
  --model convaiinnovations/laya \
  --dtype float16 \
  --output models/laya-mlx-fp16

uv run laya-mlx predict \
  --model models/laya-mlx-fp16 \
  --state-file examples/state.json \
  --questions examples/questions.json
내보내기 결과에는 model.safetensors, 인코더와 에이전트 구성, 토크나이저 파일, mlx_config.json이 들어 있습니다. 기존 출력 디렉터리는 절대 덮어쓰지 않습니다. 이는 파라미터 이름/dtype 변환이며, 양자화나 재학습이 아닙니다. 원본 체크포인트는 이미 FP16 가중치를 저장하고 있으므로, FP32를 고르면 산술 정밀도가 올라갈 뿐 원본 가중치의 정밀도가 올라가는 것은 아닙니다.
테스트와 벤치마크
uv sync --extra dev --extra reference --extra benchmark --extra demo
source .venv/bin/activate
gh repo clone NandhaKishorM/laya .upstream
git -C .upstream checkout 573e5b62696ba441230cd6be71d593331b5d23af
pytest -q
python -m benchmarks.download
python -m benchmarks.validate --repeats 100
python -m benchmarks.run --iterations 50 --warmup 5
python -m benchmarks.accuracy --per-class 64
python -m benchmarks.report
GPU 측정은 순차적으로 실행하십시오. 단위 테스트는 작은 무작위 모델을 쓰며 Transformers 및 고정된 업스트림 결정 헤드와의 직접 비교를 포함합니다. 실제 체크포인트 검증은 토크나이즈, 로짓, 캘리브레이션된 확률, 반복 출력, 활성 메모리 증가를 테스트합니다. 벤치마크는 각 백엔드/체크포인트를 새 프로세스에서 실행하고 모든 타이밍 샘플을 benchmarks/results에 저장합니다. 전체 보고서는 타이밍 경계와 정밀도 차이를 설명합니다.
GitHub Actions는 macOS arm64 러너에서 소형 모델 CPU 테스트를 돌립니다. 전체 체크포인트 GPU 벤치마크는 로컬에서 측정하며 호스팅 CI에는 포함되지 않습니다.
성능 연구
성능 조사에는 수학적 분석과 독립적인 로컬 실험이 모두 포함됩니다:
- 최초 성능 연구: 구현 병목, MLX 커널 디스패치, 통제된 실험 계획.
- 추가 10× 속도 향상에 대한 수학적 조사: 산술 예산, 조건부 대역폭 한계, 실제 가중치 스펙트럼, 정확한 재사용, 소형 모델 설계.
- 엔지니어링 조사: 측정된 컴파일, 양자화, 최종 헤드 선택, 맞춤형 Metal 커널, 대표 행렬 곱셈.
experiments/에는 연구 스크립트와 원시 측정값이 들어 있습니다. 공개된 런타임의 성능과 검증 결과는 BENCHMARKS.md에 있으며, 각 실험 변형은 자체적인 타이밍과 정확성 결과를 가집니다.
현재 조사는 같은 체크포인트로 보편적인 추가 10× 속도 향상을 뒷받침하지 않습니다. 일부 사례는 약 1.03–1.08×의 짝지은 중앙값 속도 향상을 보였습니다. 불확실성 구간, 양자화 충실도 결과, 맞춤형 Metal 커널 측정치는 엔지니어링 보고서에 있습니다.
모델 카드와 검증된 내보내기를 공개용으로 준비하려면 reference extras를 설치하고 다음을 실행하십시오:
python -m scripts.prepare_hub --account YOUR_HF_USERNAME
hf upload YOUR_HF_USERNAME/laya-mlx models/hub/laya-mlx . --exclude '.cache/*'
준비 스크립트는 내보낸 모든 텐서를 원본 FP16 소스와 대조합니다. 나머지 두 준비 폴더도 같은 방식으로 업로드한 뒤, hf cache verify REPO_ID --local-dir EXPORT_PATH로 원격 파일을 검사하십시오.
출처 표기와 라이선스
Apache-2.0이며 LICENSE와 NOTICE를 참고하십시오. Laya와 그 사전 학습 가중치는 Convai Innovations와 업스트림 기여자가 만들었습니다. 프롬프트 구성, 출력 포매팅, 언어 라우팅, 이메일 유틸리티, 프리셋은 커밋 573e5b62696ba441230cd6be71d593331b5d23af의 NandhaKishorM/laya에서 가져왔습니다. 신경망 아키텍처는 Laya와 Hugging Face ModernBERT를 따라 MLX로 재구현했습니다.
유지 관리와 릴리스
이 프로젝트는 네이티브 MLX 구현을 통해 업스트림 Laya의 동작을 따릅니다. 업스트림 호환 수정이 독자적 모델 변형, 서비스 API, 추가 데모보다 우선합니다. 이것은 여전히 선택적 포트이며, 업스트림 API 전체의 동등성을 주장하지 않습니다.
릴리스하려면 pyproject.toml, laya_mlx/__init__.py, uv.lock의 버전을 갱신한 뒤 일치하는 vX.Y.Z 태그를 푸시하십시오. GitHub Actions가 macOS 테스트 스위트를 돌리고, 버전 일관성을 검증하고, wheel과 소스 배포판을 빌드·검사하고, 저장소의 PYPI_API_TOKEN 시크릿으로 PyPI에 게시하고, GitHub 릴리스를 만듭니다. 테스트나 빌드가 실패하면 게시가 중단됩니다.