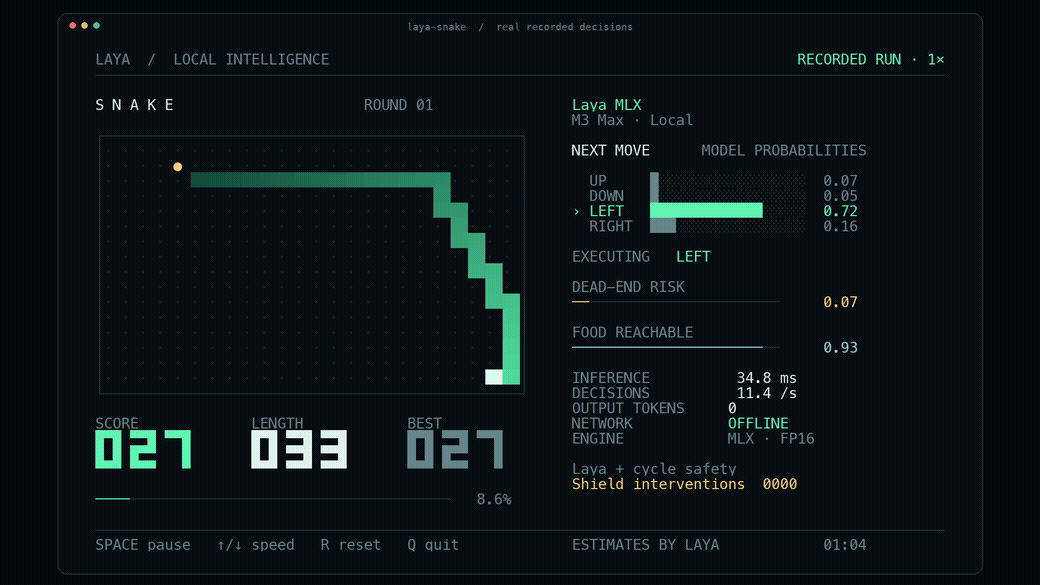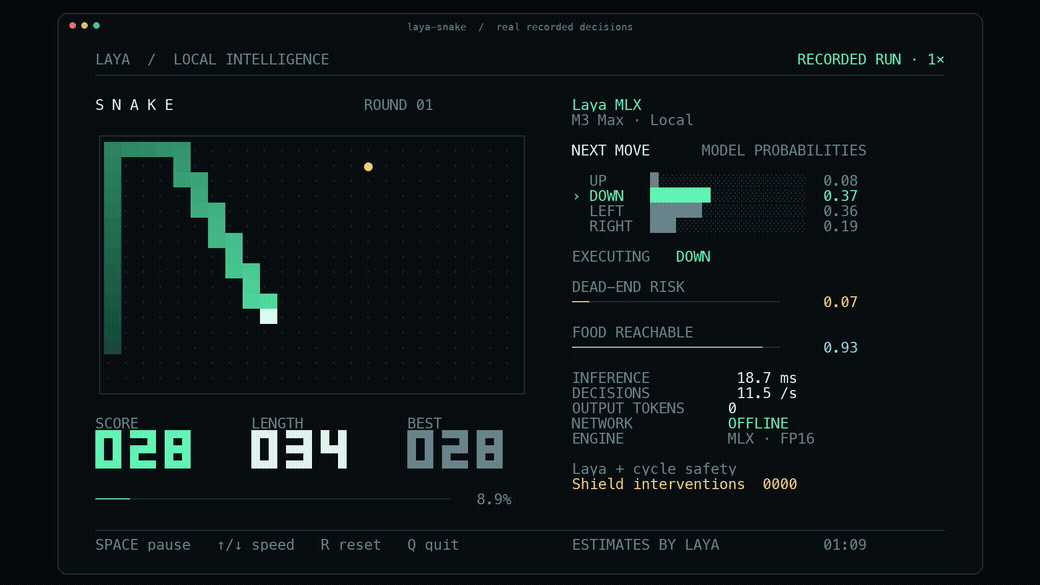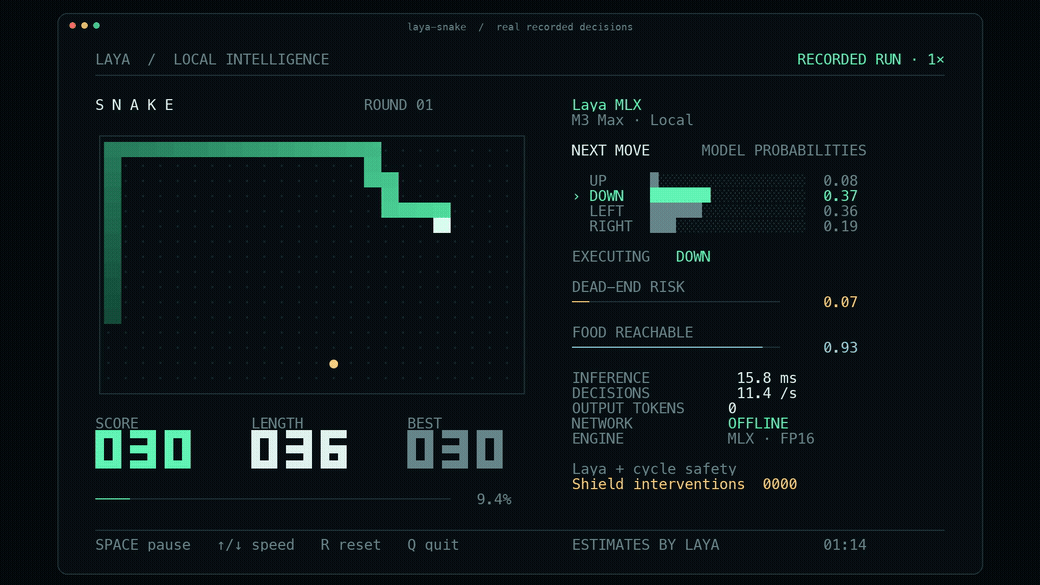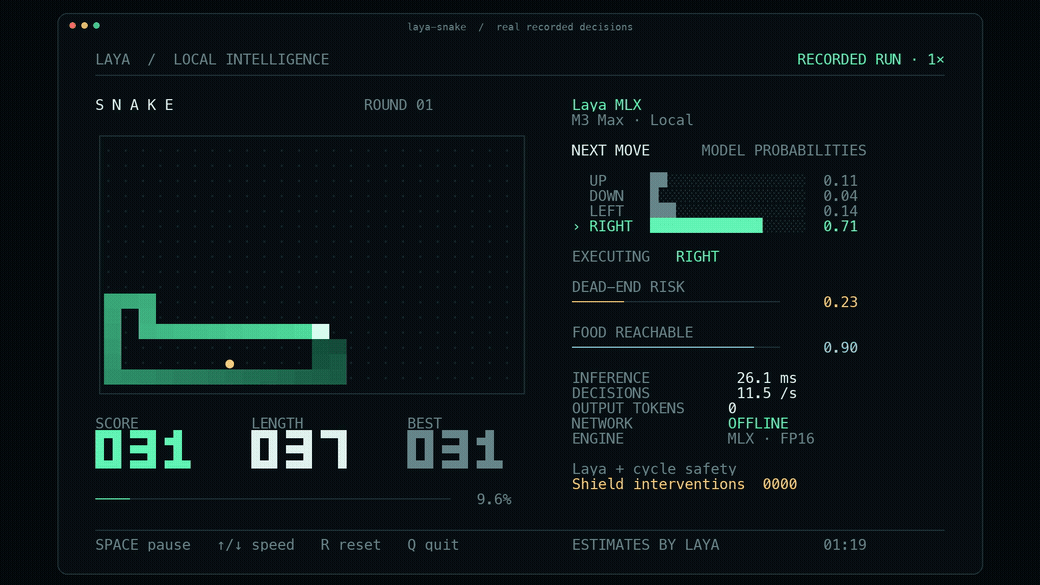
Открытые типизированные решения, работающие нативно на Apple Silicon.
13.4 ms — медиана сквозного времени для короткого типизированного решения на английском. 7.4 ms с многоязычным чекпойнтом. 0 выходных токенов. Локальный вывод MLX, без PyTorch, среды выполнения Transformers или облачного API.
Китайский · Бенчмарки · Демо Snake · Веса Hugging Face
GIF — это рендер реального локального запуска Snake в оригинальной скорости. Каждый ход вызывает Laya; видимый слой безопасности цикла может исправлять небезопасные предложения. Приведённые выше значения задержки — это отдельный бенчмарк API с одним вопросом, а не время кадра цикла Snake с тремя вопросами. Смотреть 30-секундный MP4 · Скорость и стабильность Snake.
Быстрый старт
pip install laya-mlximport laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
"I was billed twice. Please refund the duplicate.",
{
"department": {
"type": "choice",
"instructions": "Who should handle this?",
"criteria": ["billing", "technical", "sales"],
}
},
)
print(result["answers"]["department"])Apple Silicon, Python 3.11+, macOS 14+. Первая загрузка скачивает чекпойнт; последующий вывод полностью локальный. Измеренное окружение — macOS 27.2, Python 3.12.13 и MLX 0.32.2. Этот релиз MLX поставляет колёса для macOS 14, 15 и 26; локальный установщик выбрал колесо для 26. Более старые поддерживаемые версии macOS на этой машине не тестировались.
Запустите терминальное демо:
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
Скачайте один раз перед офлайн-демо. Используйте терминал размером не менее 104 × 35 ячеек. Пробел ставит на паузу, ↑/↓ меняет скорость, R сбрасывает, Q выходит. laya-snake --max-speed принимает новое решение на каждый ход без заданного темпа. Запись, управление и точные значения метрик.
laya-snake --optimize --max-speed включает проверенный путь компиляции и переиспользования префиксов: 75.40 ходов/с на 2 400 ходах, ноль смертей и 2 видимых вмешательства безопасности в парном тесте на M3 Max. Это примерно на 6.5% быстрее, чем его же eager-контроль в том запуске. Геймплей, производительность и доказательства корректности.
Производительность на M3 Max
| FP16, сквозной | Laya 421M | Multilingual 322M |
|---|---|---|
| Один короткий вопрос, P50 | 13.42 ms | 7.39 ms |
| Один короткий вопрос, P95 | 13.92 ms | 7.79 ms |
| Пропускная способность на 50 вопросов | 146.8 q/s | 395.0 q/s |
| Пиковое выделение MLX, один короткий вопрос | 943.6 MiB | 687.6 MiB |
M3 Max, 40 ядер GPU, 128 GiB памяти. Хронометраж включает подготовку промпта, токенизацию, тензоры, синхронизированный вывод, калибровку и форматирование результата; загрузка модели исключена. Измерение на 50 вопросов использует batch_size=64; API по умолчанию использует 16. Другая длина, число вопросов и условия выполнения меняют задержку. Полный метод и каждый замер времени.
Точность переноса: все три чекпойнта совпали с выбранным ответом апстрима на 63/63 проверочных вопросах и в FP32, и в FP16 — 378/378 сравнений. Каждая конфигурация также прошла 100 повторных конечных детерминированных вызовов с нулевым измеренным ростом активной памяти. Это измеряет точность на этих фикстурах, а не точность на любом возможном вопросе. Ошибки вероятностей и валидация.
Почему типизированные решения?
Программному обеспечению часто нужен выбор, балл по рубрике или вероятность. Laya отвечает на такие ограниченные вопросы за один двунаправленный прямой проход, без посимвольного декодирования и без сгенерированного JSON.
state + typed question → bidirectional encoder → decision heads → probabilitieschoice: вероятности по именованным вариантам.score: вероятности по упорядоченным уровням рубрики и их ожидаемый балл.noul: P(true) для утверждения.
Строки вопросов обрабатываются пакетами независимо. Их представления от двунаправленного энкодера зависят и от состояния, и от вопроса; эта среда выполнения не утверждает, что кодирует состояние один раз и переиспользует его скрытые состояния для произвольных вопросов.
Энкодер, решающий Transformer, голова оценивания и голова действий — всё работает в MLX. Токенизация использует Rust-токенизатор Hugging Face. Исходные предобученные веса, форматирование вопросов, калибровка и схема вывода сохранены. Это независимый порт на MLX, а не официальный релиз Convai Innovations.
Поддерживаемые чекпойнты
| Модель | Энкодер | Параметров | Ограничение контекста | Назначение |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | Английский |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | Многоязычный ввод |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | Рабочие процессы typed-decisions из апстрима |
Контекст включает инструкции, варианты и состояние. Все три используют исходные веса, форматирование промпта, температурную калибровку и схему вывода. Этот репозиторий предоставляет вывод и конвертацию; обучение RLCD и дообучение остаются в проекте апстрима. Это независимый порт, а не официальный релиз Convai Innovations.
Предварительно сконвертированные FP16-чекпойнты опубликованы на Hugging Face:
Загружайте их напрямую через laya.load("aac6fef/laya-mlx") или используйте исходные ID чекпойнтов выше. Каждый опубликованный чекпойнт включает свою карточку модели, результаты валидации, происхождение, лицензию и контрольные суммы файлов. Все 36 опубликованных файлов прошли строгую удалённую проверку контрольных сумм; закреплённые ревизии и хеши весов записаны в hub-publication.json.
Установка для разработки
gh repo clone mizorewww/laya-mlx
cd laya-mlx
uv sync --extra demo
uv run --extra demo laya-snake
Или установите последнюю ревизию GitHub через pip install 'git+https://github.com/mizorewww/laya-mlx.git'. Веса модели скачиваются отдельно и исключены из Git.
Python API
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx", dtype="float16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate today.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs and outages",
                "sales": "new purchases",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": ["not urgent", "soon", "critical"],
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"])
system_one — это псевдоним для predict. Состояния могут быть текстом, словарями JSON или списками разговоров. choice принимает словарь или список уникальных меток; score возвращает ожидаемый уровень рубрики с нулевым индексом; noul возвращает P(true). Результаты сохраняют округление до четырёх знаков апстрима, action.act_probability и поля использования токенов.
Точность по умолчанию — FP16. Используйте dtype="float32" для более близкого численного совпадения. Вероятности могут немного различаться между точностями, даже когда выбранная метка совпадает; см. измеренные ошибки в BENCHMARKS.md. BF16 можно запросить, но он не входит в опубликованную матрицу валидации.
Следуя апстриму v0.3.5, подогнанные температуры калибровки перед использованием ограничиваются диапазоном [0.5, 5.0]: поставляемый бакет choice:11+ равен 0.1006, что усилило бы логиты примерно в 10 раз и сообщило бы о подбрасывании монеты как о почти полной уверенности. Исходные значения чекпойнта остаются доступны как agent.temperature_raw и agent.temperature_by_options_raw, а RuntimeWarning при загрузке называет каждый ограниченный бакет.
batch_size=16 ограничивает число вопросов на прямой проход; более крупные запросы обрабатываются частями. Увеличивайте его, когда позволяет память. device="gpu" или device="cpu" выбирает устройство явно; иначе используется устройство MLX по умолчанию.
Для повторяющихся нагрузок включите compile=True, pad_to_multiple=16 и cache_prompts=True при загрузке Agent. Кэш префиксов ограничен 128 вопросами и разделяет токенизацию состояния на CPU, при этом каждый вопрос всё равно получает собственный проход энкодера. Компиляция имеет стоимость первого использования и специализацию по форме; дополнение может замедлить некоторые нагрузки. Все три опции по умолчанию отключены. Измеренный абляционный анализ Snake и использование.
agent = laya.load("./models/laya", dtype="float32", batch_size=32)
# Select one checkpoint inside upstream's bundled repository:
multi = laya.load("convaiinnovations/laya", subfolder="multilingual")
# Pin a Hub revision for reproducibility:
agent = laya.load(
    "convaiinnovations/laya",
    revision="c5d78730f3493e4fe16d61507ef4b78eef7318cf",
)
Загрузка проверяет каждое имя и форму параметра. Неподдерживаемые энкодеры и нестандартное масштабирование RoPE явно завершаются ошибкой. Сохранены глобальный/локальный паттерн внимания ModernBERT, включая инклюзивную границу скользящего окна, различные базы RoPE для локального/глобального внимания и поведение нормализации первого слоя.
Языковая маршрутизация и пресеты
from laya_mlx import Router, triage_questions

router = Router(dtype="float16", max_loaded=2)
result = router.predict({"message": "发票被重复扣款,请退款。"}, triage_questions())
print(result["routing"])  # multilingual

# Choose the specialized checkpoint explicitly:
result = router.predict(state, questions, task="typed_decisions")
Маршрутизатор, языковые эвристики, почтовые помощники и прикладные пресеты адаптированы из апстрима. Router(preload=True) держит все три чекпойнта резидентными; поддерживаются attach, preload, unload, явный lang= и явный model=. Жизненным циклом модели управляет повторно входимый замок, поэтому параллельные потоки используют один загруженный Agent вместо создания дубликатов; сам вывод не сериализуется. Обнаружение рабочих процессов typed-decisions остаётся опциональным. Порт сохраняет ограничения модели: английские чекпойнты не заменяют многоязычный чекпойнт, а уверенность не гарантирует точность.
Неопознанные языки на латинице (румынский, польский, чешский, турецкий, …) маршрутизируются на многоязычный чекпойнт только по своим неанглийским буквам, а не молчаливо считаются английским. detect_language(state) сообщает доказательства: language_undecided и diacritic_rate наряду с language и is_english.
Отбор из больших наборов вариантов
Варианты choice делят один бюджет токенов head_max_len, поэтому вопрос с сотнями меток оставляет всего несколько токенов на метку. predict_shortlist встраивает состояние и каждую метку, оставляет верхние k по косинусному сходству и запускает один predict на уменьшенном наборе. Это опционально: Agent.predict по-прежнему оценивает каждую заданную метку.
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
embed_fn = laya.embed_fn_from_agent(agent)  # mean-pools the loaded encoder; no extra weights
result = laya.predict_shortlist(agent, state, questions, embed_fn, k=20)
print(result["shortlist"])  # which labels were kept, with cosine scores
Выделенный биэнкодер, переданный как embed_fn, обычно отбирает лучше, чем собственный энкодер решающего чекпойнта. Вероятности на отобранном choice — только по оставленным меткам.
Командная строка
uv run laya-mlx predict \
  --model aac6fef/laya-mlx \
  --state-file examples/state.json \
  --questions examples/questions.json

uv run laya-mlx predict \
  --model aac6fef/laya-multilingual-mlx \
  --state '发票被重复扣款,请退款。' \
  --questions examples/questions.json
Избранные исправления апстрима после v0.3.5
Среда выполнения выборочно включает исправления ввода, маршрутизации и почты из апстрима
4aa6761 (исходное дерево v0.3.23). Это не добавляет пакетный API, API длинных документов,
хуков или серверных API апстрима. Паритет нейронной архитектуры по-прежнему тестируется против 573e5b6.
- Хронологические списки разговоров сохраняют свои новейшие токены, когда контекст заполняется; строки и словари сохраняют начало. Кэширование префиксов использует то же правило.
- Критерии
noulпринимают только ключиfalse/true(включая булевы ключи Python). Необязательныйlabels={"false": "no", "true": "yes"}меняет слова, показываемые модели, тогда как ответ остаётся P(true). Недопустимые ключи теперь вызывают ошибку вместо игнорирования. - Нестроковые инструкции сохраняют Unicode. Пустые инструкции, уровни score со значением null
и состояние
Noneвызывают ошибку вызывающего; ошибки вопросов называют вопрос. - Каждый ответ добавляет
answer_confidence— максимальную калиброванную вероятность варианта. Существующийconfidenceсохраняет своё энтропийное значение для choice/score и максимальную вероятность для noul. Ни одно из полей не гарантирует точность на новой задаче. usageдобавляетstate_tokens,state_tokens_dropped(наибольшее падение по вопросам),truncatedиtruncated_questions.usage.optionsпоявляется только для вопросов, у которых диапазоны токенов вариантов пересекаются, сообщаяtotal,distinctиtokens_per_option. Это сообщает о потерянных различиях; оно не восстанавливает их и не убирает позиционное смещение.- Инкрементальный
Router.preload()сохраняет резидентные модели;preload([])не делает ничего. Пустые или языково-нейтральные подсказки переходят к определению, а неопределённый латинский текст уважаетRouter(default=...). Определение исследует вложенные строковые значения и смешанный текст. - Очистка почты сохраняет обычные запросы, упоминающие конфиденциальность, благодарность
получателю или начинающиеся с
From:, при этом распознавая многоязычные нижние колонтитулы писем.
Экспорт чекпойнта MLX
uv run laya-mlx convert \
  --model convaiinnovations/laya \
  --dtype float16 \
  --output models/laya-mlx-fp16

uv run laya-mlx predict \
  --model models/laya-mlx-fp16 \
  --state-file examples/state.json \
  --questions examples/questions.json
Экспорт содержит model.safetensors, конфигурации энкодера и агента, файлы токенизатора и mlx_config.json. Существующие выходные каталоги никогда не перезаписываются. Это конвертация имён параметров и типа данных, а не квантование или переобучение. Исходные чекпойнты уже хранят веса FP16; выбор FP32 повышает арифметическую точность, а не точность исходных весов.
Тесты и бенчмарки
uv sync --extra dev --extra reference --extra benchmark --extra demo
source .venv/bin/activate
gh repo clone NandhaKishorM/laya .upstream
git -C .upstream checkout 573e5b62696ba441230cd6be71d593331b5d23af
pytest -q
python -m benchmarks.download
python -m benchmarks.validate --repeats 100
python -m benchmarks.run --iterations 50 --warmup 5
python -m benchmarks.accuracy --per-class 64
python -m benchmarks.report
Запускайте измерения на GPU последовательно. Модульные тесты используют небольшие случайные модели и включают прямые сравнения с Transformers и закреплённой головой решений апстрима. Валидация реального чекпойнта тестирует токенизацию, логиты, калиброванные вероятности, повторные выходы и рост активной памяти. Бенчмарк запускает каждый бэкенд/чекпойнт в свежем процессе и сохраняет каждый замер времени в benchmarks/results. Полный отчёт объясняет границы хронометража и различия точностей.
GitHub Actions запускает CPU-тесты на малых моделях на раннере macOS arm64. Полные GPU-бенчмарки чекпойнтов измеряются локально и не входят в хостируемый CI.
Исследование производительности
Исследования производительности включают как математический анализ, так и независимые локальные эксперименты:
- Начальное исследование производительности: узкие места реализации, диспетчеризация ядер MLX и план контролируемого эксперимента.
- Математическое исследование дальнейшего ускорения в 10×: арифметические бюджеты, условные границы пропускной способности, реальные спектры весов, точное переиспользование и проекты меньших моделей.
- Инженерное исследование: измеренная компиляция, квантование, выбор финальной головы, пользовательские ядра Metal и представительные умножения матриц.
experiments/ содержит исследовательские скрипты и их сырые измерения. Производительность и результаты валидации опубликованной среды выполнения — в BENCHMARKS.md; каждый экспериментальный вариант имеет собственные результаты по времени и корректности.
Текущее исследование не поддерживает дальнейшее универсальное ускорение в 10× на тех же чекпойнтах. Отдельные случаи показывают примерно 1.03–1.08× парного медианного ускорения; инженерный отчёт даёт интервалы неопределённости, результаты точности квантования и измерения пользовательских ядер Metal.
Чтобы подготовить карточки моделей и проверенные экспорты для публикации, установите reference-дополнения и запустите:
python -m scripts.prepare_hub --account YOUR_HF_USERNAME
hf upload YOUR_HF_USERNAME/laya-mlx models/hub/laya-mlx . --exclude '.cache/*'
Скрипт подготовки проверяет каждый экспортированный тензор против его исходного источника FP16. Загрузите две другие подготовленные папки тем же способом, затем используйте hf cache verify REPO_ID --local-dir EXPORT_PATH для проверки удалённых файлов.
Атрибуция и лицензия
Apache-2.0; см. LICENSE и NOTICE. Laya и её предобученные веса принадлежат Convai Innovations и участникам апстрима. Построение промптов, форматирование вывода, языковая маршрутизация, почтовые утилиты и пресеты адаптированы из NandhaKishorM/laya на коммите 573e5b62696ba441230cd6be71d593331b5d23af. Нейронная архитектура перереализована в MLX по Laya и ModernBERT от Hugging Face.
Сопровождение и релизы
Этот проект следует поведению апстрима Laya через нативную реализацию на MLX. Совместимые с апстримом исправления имеют приоритет над независимыми вариантами модели, сервисными API и дополнительными демо. Это остаётся выборочным портом, а не заявлением о полном паритете API с апстримом.
Для выпуска обновите версию в pyproject.toml, laya_mlx/__init__.py и uv.lock,
затем отправьте соответствующий тег vX.Y.Z. GitHub Actions запускает набор тестов macOS, проверяет
согласованность версий, собирает и проверяет wheel и исходный дистрибутив, публикует
их на PyPI с помощью секрета PYPI_API_TOKEN репозитория и создаёт релиз GitHub.
Проваленный тест или сборка блокирует публикацию.