Decisões tipadas de pesos abertos, a correr nativamente em Apple Silicon.
13.4 ms de mediana ponta a ponta para uma decisão tipada curta em inglês. 7.4 ms com o checkpoint multilingue. 0 tokens de saída. Inferência MLX local, sem PyTorch, runtime de Transformers nem API na nuvem.
中文 · Benchmarks · Demo Snake · Pesos no Hugging Face
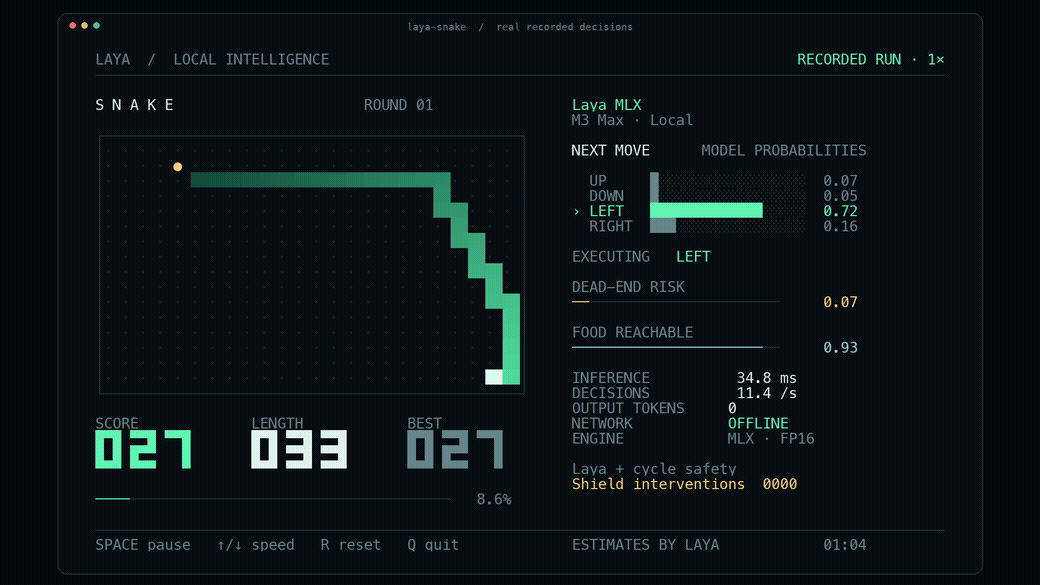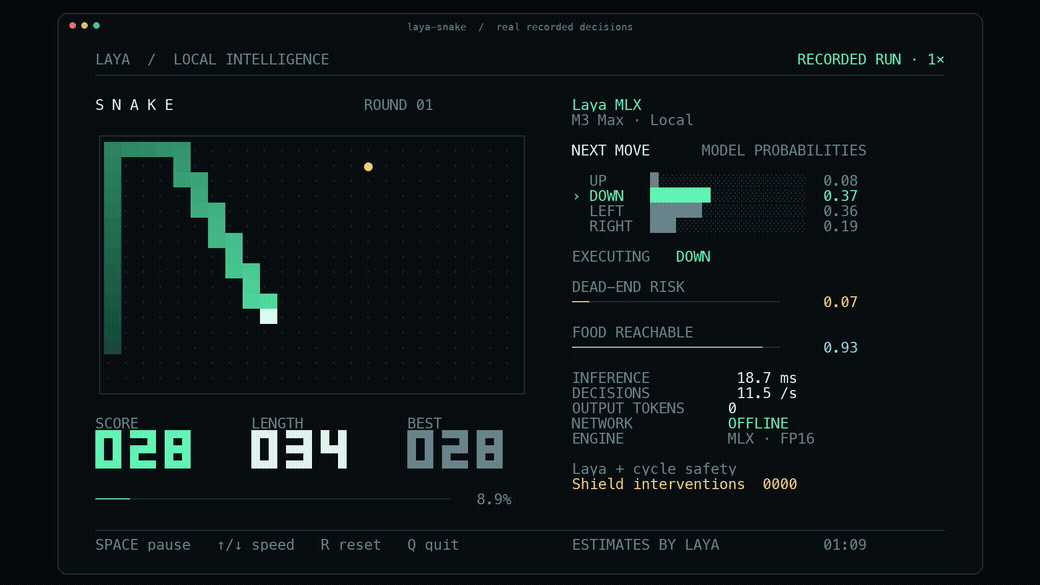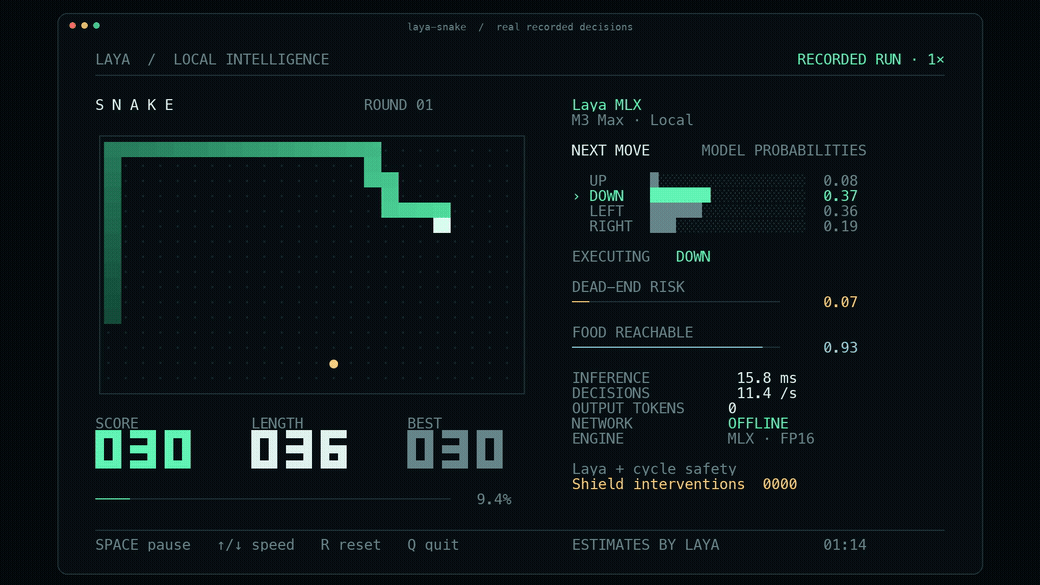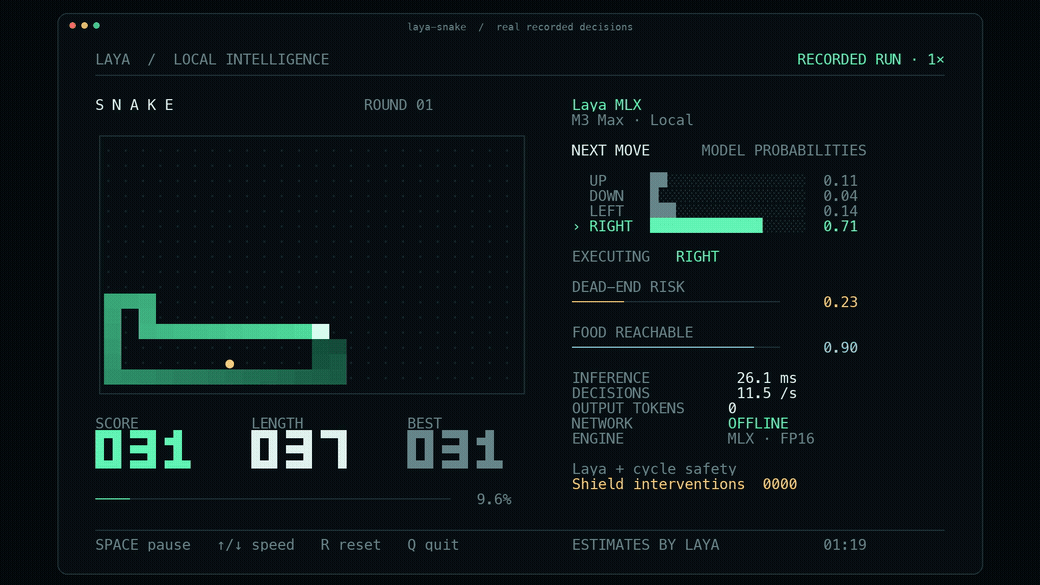
O GIF é uma renderização à velocidade original de uma execução Snake local real. Cada movimento chama o Laya; a camada visível de segurança de ciclo pode corrigir propostas inseguras. Os valores de latência acima são o benchmark separado da API de uma pergunta, não o tempo de fotograma do ciclo Snake de três perguntas. Ver o MP4 de 30 segundos · Velocidade e estabilidade do Snake.
Início rápido
pip install laya-mlximport laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
"I was billed twice. Please refund the duplicate.",
{
"department": {
"type": "choice",
"instructions": "Who should handle this?",
"criteria": ["billing", "technical", "sales"],
}
},
)
print(result["answers"]["department"])Apple Silicon, Python 3.11+, macOS 14+. A primeira carga descarrega o checkpoint; a inferência seguinte é totalmente local. O ambiente medido é macOS 27.2, Python 3.12.13 e MLX 0.32.2. Essa versão do MLX fornece wheels para macOS 14, 15 e 26; o instalador local escolheu o wheel 26. Não foram testadas nesta máquina versões mais antigas de macOS suportadas.
Executa a demonstração no terminal:
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
Descarrega uma vez antes da demonstração offline. Usa um terminal com pelo menos 104 × 35 células. A barra de espaços pausa, ↑/↓ altera a velocidade, R reinicia e Q sai. laya-snake --max-speed toma uma nova decisão a cada movimento, sem ritmo imposto. Gravação, controlos e significado exato das métricas.
laya-snake --optimize --max-speed ativa o caminho testado de compilação e reutilização de prefixo: 75.40 movimentos/s ao longo de 2,400 movimentos, zero mortes e 2 intervenções de segurança visíveis no teste emparelhado no M3 Max. Foi cerca de 6.5% mais rápido do que o controlo eager da mesma execução. Evidência de jogabilidade, desempenho e correção.
Desempenho no M3 Max
| FP16, ponta a ponta | Laya 421M | Multilingual 322M |
|---|---|---|
| Uma pergunta curta, P50 | 13.42 ms | 7.39 ms |
| Uma pergunta curta, P95 | 13.92 ms | 7.79 ms |
| Débito de 50 perguntas | 146.8 q/s | 395.0 q/s |
| Alocação máxima do MLX, uma pergunta curta | 943.6 MiB | 687.6 MiB |
M3 Max, 40 núcleos de GPU, 128 GiB de memória. A medição de tempo inclui a preparação do prompt, a tokenização, os tensores, a inferência sincronizada, a calibração e a formatação do resultado; o carregamento do modelo está excluído. A medição de 50 perguntas usa batch_size=64; a API usa 16 por predefinição. Diferentes comprimentos, números de perguntas e condições de execução alteram a latência. Método completo e todas as amostras de tempos.
Fidelidade do port: os três checkpoints corresponderam à resposta selecionada do upstream em 63/63 perguntas de validação, tanto em FP32 como em FP16 — 378/378 comparações. Cada configuração também passou 100 chamadas repetidas, finitas e determinísticas, com crescimento zero da memória ativa medida. Isto mede a fidelidade nesses fixtures, não a exatidão em todas as perguntas possíveis. Erros de probabilidade e validação.
Porquê decisões tipadas?
O software precisa frequentemente de uma escolha, uma pontuação de rubrica ou uma probabilidade. O Laya responde a essas perguntas restringidas numa passagem direta bidirecional, sem descodificação token a token nem JSON gerado.
state + typed question → bidirectional encoder → decision heads → probabilitieschoice: probabilidades sobre opções nomeadas.score: probabilidades sobre níveis de rubrica ordenados e a sua pontuação esperada.noul: P(true) para uma proposição.
As linhas de perguntas são agrupadas em lotes de forma independente. As suas representações no codificador bidirecional dependem tanto do estado como da pergunta; este runtime não afirma codificar o estado uma vez e reutilizar os seus estados ocultos em perguntas arbitrárias.
O codificador, o Transformer de decisão, a cabeça de pontuação e a cabeça de ação correm todos em MLX. A tokenização usa o tokenizer Rust da Hugging Face. Os pesos pré-treinados originais, a formatação das perguntas, a calibração e o esquema de saída são mantidos. Este é um port independente para MLX, não um lançamento oficial da Convai Innovations.
Checkpoints suportados
| Modelo | Codificador | Parâmetros | Limite de contexto | Finalidade |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | Inglês |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | Entrada multilingue |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | Fluxos de trabalho de decisões tipadas do upstream |
O contexto inclui instruções, opções e estado. Os três usam os pesos originais, a formatação do prompt, a calibração de temperatura e o esquema de saída. Este repositório fornece inferência e conversão; o treino RLCD e o ajuste fino permanecem no projeto upstream. É um port independente, não um lançamento oficial da Convai Innovations.
Os checkpoints FP16 pré-convertidos estão publicados no Hugging Face:
Carrega estes diretamente com laya.load("aac6fef/laya-mlx"), ou usa os IDs de checkpoint originais acima. Cada checkpoint publicado inclui o seu model card, resultados de validação, proveniência, licença e somas de verificação dos ficheiros. Todos os 36 ficheiros publicados passaram uma verificação estrita de soma de verificação remota; as revisões fixadas e os hashes dos pesos estão registados em hub-publication.json.
Instalação para desenvolvimento
gh repo clone mizorewww/laya-mlx
cd laya-mlx
uv sync --extra demo
uv run --extra demo laya-snake
Ou instala a revisão mais recente do GitHub com pip install 'git+https://github.com/mizorewww/laya-mlx.git'. Os pesos do modelo são descarregados à parte e estão excluídos do Git.
API Python
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx", dtype="float16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate today.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs and outages",
                "sales": "new purchases",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": ["not urgent", "soon", "critical"],
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"])
system_one é um alias de predict. Os estados podem ser texto, dicionários JSON ou listas de conversa. choice aceita um dicionário ou uma lista de etiquetas únicas; score devolve o nível de rubrica esperado, com base zero; noul devolve P(true). Os resultados mantêm o arredondamento a quatro casas decimais do upstream, action.act_probability e os campos de utilização de tokens.
A precisão predefinida é FP16. Usa dtype="float32" para uma concordância numérica mais próxima. As probabilidades podem diferir ligeiramente entre precisões mesmo quando a etiqueta selecionada coincide; vê os erros medidos em BENCHMARKS.md. O BF16 pode ser pedido, mas não faz parte da matriz de validação publicada.
Seguindo o upstream v0.3.5, as temperaturas de calibração ajustadas são limitadas a [0.5, 5.0] antes de serem usadas: o bucket choice:11+ fornecido é 0.1006, o que aguçaria os logits ~10x e reportaria uma moeda ao ar como quase-certeza. Os valores em bruto do checkpoint continuam disponíveis como agent.temperature_raw e agent.temperature_by_options_raw, e um RuntimeWarning nomeia cada bucket limitado ao carregar.
batch_size=16 limita o número de perguntas por passagem direta; os pedidos maiores são processados em blocos. Aumenta-o quando a memória o permitir. device="gpu" ou device="cpu" selecionam um dispositivo explicitamente; caso contrário, é usado o dispositivo predefinido do MLX.
Para cargas de trabalho repetidas, opta por compile=True, pad_to_multiple=16 e cache_prompts=True ao carregar um Agent. A cache de prefixos está limitada a 128 perguntas e partilha a tokenização do estado na CPU, enquanto cada pergunta continua a ter a sua própria computação do codificador. A compilação tem um custo de primeiro uso e especialização de forma; o padding pode tornar algumas cargas de trabalho mais lentas. As três opções estão desativadas por predefinição. Ablação e utilização medidas do Snake.
agent = laya.load("./models/laya", dtype="float32", batch_size=32)
# Select one checkpoint inside upstream's bundled repository:
multi = laya.load("convaiinnovations/laya", subfolder="multilingual")
# Pin a Hub revision for reproducibility:
agent = laya.load(
    "convaiinnovations/laya",
    revision="c5d78730f3493e4fe16d61507ef4b78eef7318cf",
)
O carregamento valida cada nome e forma de parâmetro. Os codificadores não suportados e o escalonamento RoPE não predefinido falham explicitamente. O padrão de atenção global/local do ModernBERT, o limite inclusivo da janela deslizante, as bases RoPE local/global distintas e o comportamento de normalização da primeira camada são preservados.
Encaminhamento por língua e predefinições
from laya_mlx import Router, triage_questions

router = Router(dtype="float16", max_loaded=2)
result = router.predict({"message": "发票被重复扣款,请退款。"}, triage_questions())
print(result["routing"])  # multilingual

# Choose the specialized checkpoint explicitly:
result = router.predict(state, questions, task="typed_decisions")
O router, as heurísticas de língua, os auxiliares de e-mail e as predefinições de aplicação são adaptados do upstream. Router(preload=True) mantém os três checkpoints residentes; attach, preload, unload, lang= explícito e model= explícito são suportados. O ciclo de vida do modelo está protegido por um lock reentrante, por isso threads concorrentes partilham um Agent carregado em vez de criarem duplicados; a inferência em si não é serializada. A deteção de fluxos de trabalho de decisões tipadas continua a ser opt-in. O port preserva as limitações do modelo: os checkpoints em inglês não substituem o checkpoint multilingue, e a confiança não garante exatidão.
As línguas de escrita latina não identificadas (romeno, polaco, checo, turco, …) são encaminhadas para o checkpoint multilingue apenas com base nas suas letras não inglesas, em vez de serem silenciosamente assumidas como inglês. detect_language(state) reporta a evidência: language_undecided e diacritic_rate a par de language e is_english.
Pré-seleção de grandes conjuntos de escolha
As opções de escolha partilham um único orçamento de tokens head_max_len, por isso uma pergunta com centenas de etiquetas deixa apenas alguns tokens por etiqueta. predict_shortlist gera embeddings do estado e de cada etiqueta, mantém os k melhores por similaridade de cosseno e corre um único predict no conjunto reduzido. Isto é opt-in: Agent.predict continua a pontuar todos os critérios que recebe.
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
embed_fn = laya.embed_fn_from_agent(agent)  # mean-pools the loaded encoder; no extra weights
result = laya.predict_shortlist(agent, state, questions, embed_fn, k=20)
print(result["shortlist"])  # which labels were kept, with cosine scores
Um bi-encoder dedicado passado como embed_fn normalmente faz uma melhor pré-seleção do que o próprio codificador do checkpoint de decisão. As probabilidades numa escolha pré-selecionada são apenas sobre as etiquetas mantidas.
Linha de comandos
uv run laya-mlx predict \
  --model aac6fef/laya-mlx \
  --state-file examples/state.json \
  --questions examples/questions.json

uv run laya-mlx predict \
  --model aac6fef/laya-multilingual-mlx \
  --state '发票被重复扣款,请退款。' \
  --questions examples/questions.json
Correções selecionadas do upstream após a v0.3.5
O runtime incorpora seletivamente correções de entrada, encaminhamento e e-mail do upstream 4aa6761 (árvore de código-fonte v0.3.23). Isto não acrescenta as APIs de lote, de documentos longos, de hooks ou de servidor do upstream. A paridade da arquitetura neural continua a ser testada contra 573e5b6.
- As listas de conversa cronológicas mantêm os tokens mais recentes quando o contexto enche; as strings e os dicionários mantêm o início. A cache de prefixos usa a mesma regra.
- Os critérios de
noulaceitam apenas chavesfalse/true(incluindo chaves booleanas do Python). Olabels={"false": "no", "true": "yes"}opcional muda as palavras mostradas ao modelo, enquanto a resposta continua a ser P(true). As chaves inválidas agora geram erro em vez de serem ignoradas. - As instruções que não são strings preservam Unicode. Instruções vazias, níveis de pontuação nulos e um estado
Nonegeram um erro do chamador; os erros de pergunta nomeiam a pergunta. - Cada resposta acrescenta
answer_confidence, a probabilidade calibrada máxima da opção. Oconfidenceexistente mantém o seu significado baseado na entropia para choice/score e a probabilidade máxima para noul. Nenhum dos campos garante exatidão numa tarefa nova. usageacrescentastate_tokens,state_tokens_dropped(a maior perda entre perguntas),truncatedetruncated_questions.usage.optionsaparece apenas para perguntas cujos intervalos de tokens de opção colidem, reportandototal,distinctetokens_per_option. Isto reporta distinções perdidas; não as recupera nem remove o enviesamento de posição.- O
Router.preload()incremental preserva os modelos residentes;preload([])não faz nada. As dicas em branco ou neutras em termos de língua passam para a deteção, e o texto latino indecidido respeitaRouter(default=...). A deteção examina valores de string aninhados e texto misto. - A limpeza de e-mail preserva pedidos comuns que mencionam confidencialidade, agradecem ao destinatário ou começam com
From:, ao mesmo tempo que reconhece rodapés de correio multilingues.
Exportar um checkpoint MLX
uv run laya-mlx convert \
  --model convaiinnovations/laya \
  --dtype float16 \
  --output models/laya-mlx-fp16

uv run laya-mlx predict \
  --model models/laya-mlx-fp16 \
  --state-file examples/state.json \
  --questions examples/questions.json
A exportação contém model.safetensors, as configurações do codificador e do agent, os ficheiros do tokenizer e mlx_config.json. Os diretórios de saída existentes nunca são substituídos. Isto é uma conversão de nomes de parâmetros/dtype, não quantização nem re-treino. Os checkpoints de origem já armazenam pesos FP16; escolher FP32 aumenta a precisão aritmética, não a precisão dos pesos de origem.
Testes e benchmarks
uv sync --extra dev --extra reference --extra benchmark --extra demo
source .venv/bin/activate
gh repo clone NandhaKishorM/laya .upstream
git -C .upstream checkout 573e5b62696ba441230cd6be71d593331b5d23af
pytest -q
python -m benchmarks.download
python -m benchmarks.validate --repeats 100
python -m benchmarks.run --iterations 50 --warmup 5
python -m benchmarks.accuracy --per-class 64
python -m benchmarks.report
Executa as medições da GPU sequencialmente. Os testes unitários usam modelos aleatórios pequenos e incluem comparações diretas com o Transformers e com a cabeça de decisão fixada do upstream. A validação com checkpoints reais testa a tokenização, os logits, as probabilidades calibradas, as saídas repetidas e o crescimento da memória ativa. O benchmark corre cada backend/checkpoint num processo novo e guarda todas as amostras de tempos em benchmarks/results. O relatório completo explica os limites das medições e as diferenças de precisão.
O GitHub Actions corre testes de CPU com modelos pequenos num runner macOS arm64. Os benchmarks de GPU com checkpoints completos são medidos localmente e não fazem parte do CI alojado.
Investigação de desempenho
As investigações de desempenho incluem tanto análise matemática como experiências locais independentes:
- Investigação inicial de desempenho: estrangulamentos da implementação, despacho de kernels do MLX e um plano de experiência controlada.
- Investigação matemática de um novo aumento de velocidade de 10×: orçamentos aritméticos, limites condicionais de largura de banda, espetros reais dos pesos, reutilização exata e designs de modelos mais pequenos.
- Investigação de engenharia: compilação medida, quantização, seleção da cabeça final, kernels Metal personalizados e multiplicações de matrizes representativas.
experiments/ contém os scripts de investigação e as suas medições em bruto. Os resultados de desempenho e validação do runtime publicado estão em BENCHMARKS.md; cada variante experimental tem os seus próprios resultados de tempos e de correção.
A investigação atual não sustenta um novo aumento universal de velocidade de 10× com os mesmos checkpoints. Casos selecionados mostram aumentos de velocidade medianos emparelhados de aproximadamente 1.03–1.08×; o relatório de engenharia apresenta os intervalos de incerteza, os resultados de fidelidade da quantização e as medições do kernel Metal personalizado.
Para preparar model cards e exportações verificadas para publicação, instala os extras de referência e corre:
python -m scripts.prepare_hub --account YOUR_HF_USERNAME
hf upload YOUR_HF_USERNAME/laya-mlx models/hub/laya-mlx . --exclude '.cache/*'
O script de preparação verifica cada tensor exportado contra a sua origem FP16 original. Carrega as outras duas pastas preparadas da mesma forma e depois usa hf cache verify REPO_ID --local-dir EXPORT_PATH para verificar os ficheiros remotos.
Atribuição e licença
Apache-2.0; vê LICENSE e NOTICE. O Laya e os seus pesos pré-treinados são da Convai Innovations e dos contribuidores do upstream. A construção de prompts, a formatação da saída, o encaminhamento por língua, os utilitários de e-mail e as predefinições são adaptados de NandhaKishorM/laya no commit 573e5b62696ba441230cd6be71d593331b5d23af. A arquitetura neural está reimplementada em MLX seguindo o Laya e o ModernBERT da Hugging Face.
Manutenção e lançamentos
Este projeto segue o comportamento do Laya upstream através de uma implementação MLX nativa. As correções compatíveis com o upstream têm prioridade sobre variantes de modelo independentes, APIs de serviço e demonstrações adicionais. Continua a ser um port seletivo, não uma afirmação de paridade total com a API do upstream.
Para lançar, atualiza a versão em pyproject.toml, laya_mlx/__init__.py e uv.lock, depois envia uma tag vX.Y.Z correspondente. O GitHub Actions corre a suite de testes do macOS, valida a consistência das versões, constrói e verifica o wheel e a distribuição de código-fonte, publica-os no PyPI usando o segredo PYPI_API_TOKEN do repositório e cria um lançamento no GitHub. Um teste ou uma construção falhada impede a publicação.