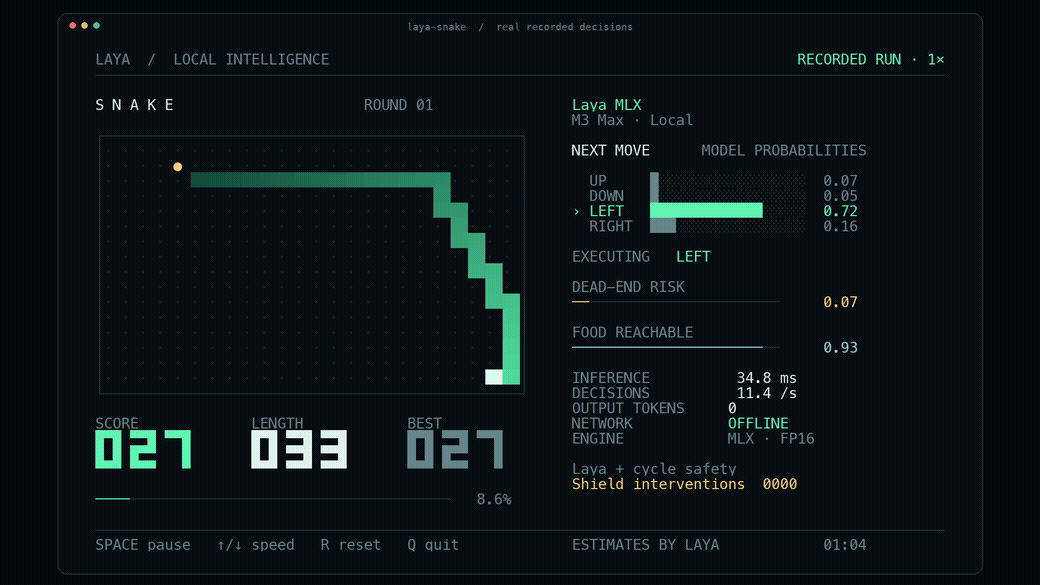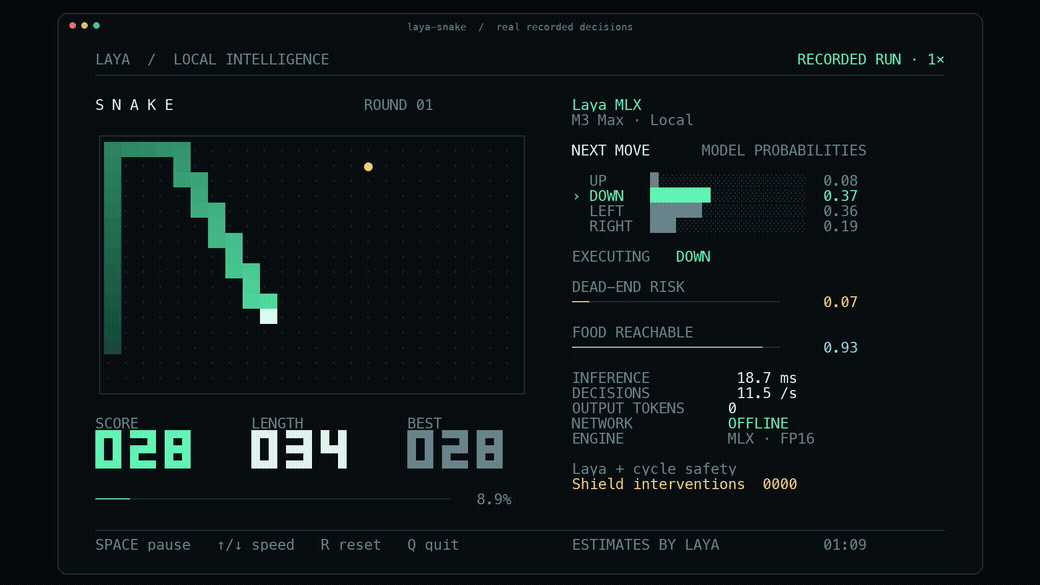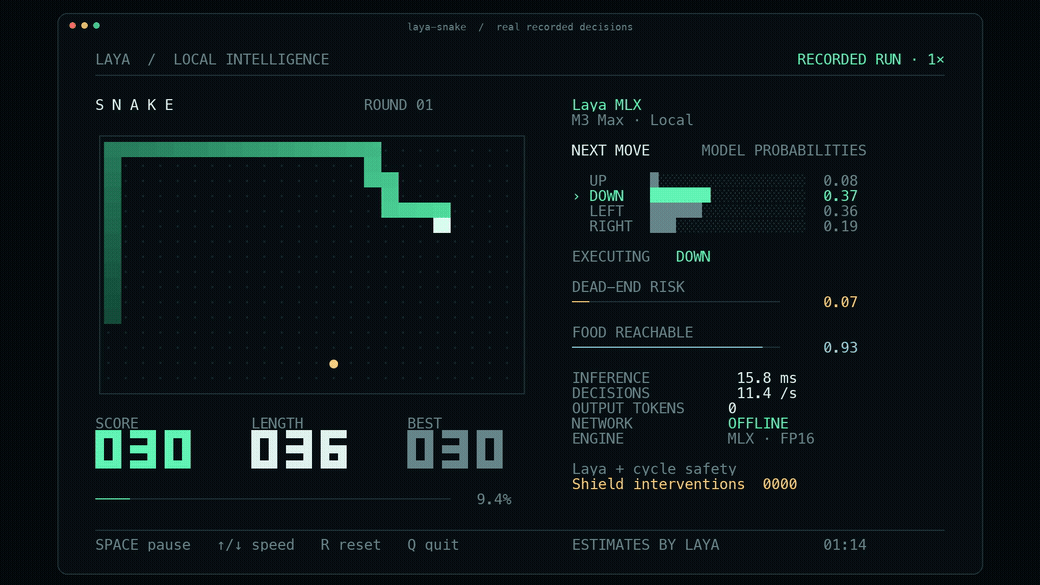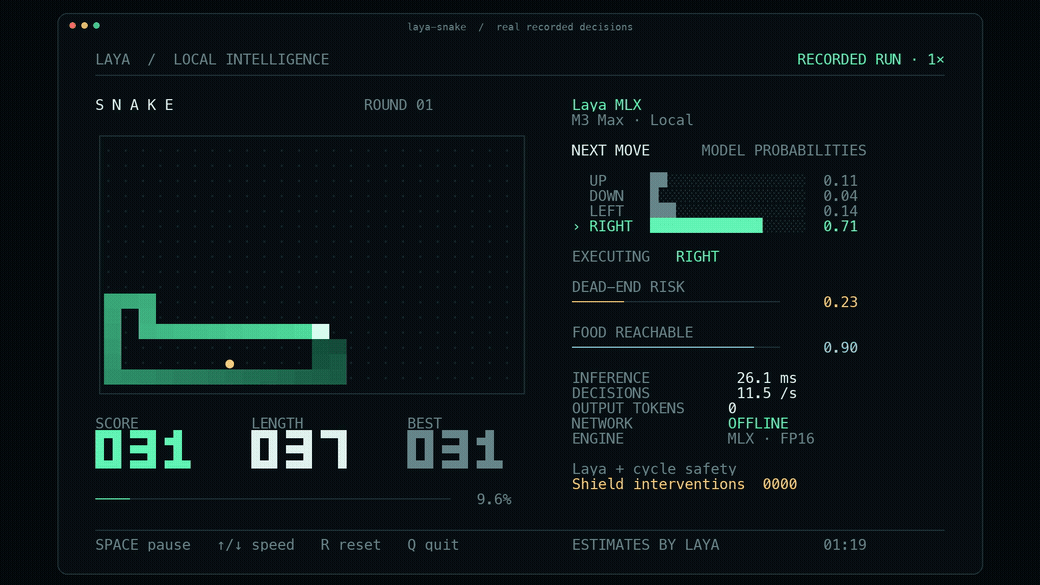
开放权重的类型化决策,在 Apple Silicon 上原生运行。
英文短类型化决策端到端的中位延迟为 13.4 ms;使用 multilingual checkpoint 时是 7.4 ms。0 个输出 token。 本地 MLX 推理,不需要 PyTorch、Transformers 运行时或云端 API。
中文 · 基准 · Snake 演示 · Hugging Face 权重
这段 GIF 是一次真实本地 Snake 运行的原速渲染。每一步都会调用 Laya;可见的循环安全层可以纠正不安全的提议。上面的延迟数字来自单独的单问题 API 基准,不是三问题 Snake 循环的帧时间。观看 30 秒 MP4 · Snake 速度与稳定性。
快速开始
pip install laya-mlximport laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
"I was billed twice. Please refund the duplicate.",
{
"department": {
"type": "choice",
"instructions": "Who should handle this?",
"criteria": ["billing", "technical", "sales"],
}
},
)
print(result["answers"]["department"])Apple Silicon,Python 3.11+,macOS 14+。首次加载会下载 checkpoint;之后的推理完全在本地。测量环境是 macOS 27.2、Python 3.12.13 和 MLX 0.32.2。该 MLX 版本提供 macOS 14、15 和 26 的 wheel;本地安装器选的是 26 的 wheel。这台机器上没有测试更早的支持 macOS 版本。
运行终端 demo:
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
离线 demo 前先下载一次。使用至少 104 × 35 格的终端。空格暂停,↑/↓ 改变速度,R 重置,Q 退出。laya-snake --max-speed 让每一步都重新决策、不做节流。录制、操作与各指标的准确含义。
laya-snake --optimize --max-speed 启用经过测试的编译与前缀复用路径:在成对 M3 Max 测试中,2,400 步达到 75.40 步/秒,零死亡、2 次可见的安全干预。这比同一轮次中的 eager 对照快约 6.5%。玩法、性能与正确性证据。
在 M3 Max 上的性能
| FP16,端到端 | Laya 421M | Multilingual 322M |
|---|---|---|
| 单个短问题,P50 | 13.42 ms | 7.39 ms |
| 单个短问题,P95 | 13.92 ms | 7.79 ms |
| 50 问题吞吐 | 146.8 q/s | 395.0 q/s |
| 单个短问题的 MLX 峰值分配 | 943.6 MiB | 687.6 MiB |
M3 Max,40 个 GPU 核心,128 GiB 内存。计时包含提示准备、分词、张量、同步推理、校准与结果格式化;模型加载不计入。50 问题的测量使用 batch_size=64;API 默认是 16。不同的长度、问题数量和运行时条件会改变延迟。完整方法与每一个计时样本。
端口保真度: 三个 checkpoint 在 FP32 和 FP16 下各 63/63 个验证问题上都与上游选出的答案一致 —— 378/378 次比较。每种配置还通过了 100 次重复的有限、确定性调用,测得的活动内存增长为零。这衡量的是这些固定样本上的保真度,不是每一个可能问题上的准确率。概率误差与验证。
为什么用类型化决策?
软件常常需要一个选择、一个评分或一个概率。Laya 在一次双向前向传播里回答这些受约束的问题,无需逐 token 解码,也不生成 JSON。
state + typed question → bidirectional encoder → decision heads → probabilitieschoice:在具名选项上的概率。score:在有序评分档位上的概率及其期望分值。noul:某个命题为真的概率 P(true)。
问题行相互独立地批处理。它们的双向编码器表示同时取决于 state 和 question;这个运行时并不声称把 state 编码一次就能在任意问题之间复用其隐藏状态。
编码器、决策 Transformer、评分头与动作头全部在 MLX 中运行。分词使用 Hugging Face 的 Rust tokenizer。原始的预训练权重、问题格式、校准与输出 schema 都保留。这是独立的 MLX 端口,不是 Convai Innovations 的官方发布。
支持的 checkpoint
| 模型 | 编码器 | 参数量 | 上下文上限 | 用途 |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | 英文 |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | 多语言输入 |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | 上游的 typed-decisions 工作流 |
上下文包含指令、选项和 state。三者都使用原始权重、提示格式、温度校准和输出 schema。本仓库提供推理与转换;RLCD 训练与微调仍在上游项目里。这是独立端口,不是 Convai Innovations 的官方发布。
预转换的 FP16 checkpoint 发布在 Hugging Face 上:
用 laya.load("aac6fef/laya-mlx") 直接加载它们,或使用上面的原始 checkpoint ID。每个已发布的 checkpoint 都包含其模型卡、验证结果、来源、许可和文件校验和。全部 36 个已发布文件都通过了严格的远程校验和验证;固定的 revision 与权重哈希记录在 hub-publication.json 中。
开发版安装
gh repo clone mizorewww/laya-mlx
cd laya-mlx
uv sync --extra demo
uv run --extra demo laya-snake
或者用 pip install 'git+https://github.com/mizorewww/laya-mlx.git' 安装最新的 GitHub revision。模型权重单独下载,不包含在 Git 中。
Python API
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx", dtype="float16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate today.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs and outages",
                "sales": "new purchases",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": ["not urgent", "soon", "critical"],
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"])
system_one 是 predict 的别名。state 可以是文本、JSON 字典或对话列表。choice 接受一个字典或一个唯一标签列表;score 返回基于零的期望评分档位;noul 返回 P(true)。结果保留下游的四位小数舍入、action.act_probability 和 token 用量字段。
默认精度是 FP16。使用 dtype="float32" 可获得更接近的数值一致性。即使所选标签一致,不同精度下的概率也可能略有差异;实测误差见 BENCHMARKS.md。可以请求 BF16,但它不在已发布的验证矩阵内。
跟随上游 v0.3.5,拟合出的校准温度在使用前被夹紧到 [0.5, 5.0]:已发布的 choice:11+ 桶是 0.1006,它会将 logits 锐化约 10 倍,把一个掷硬币报告成接近确定。checkpoint 的原始值仍可通过 agent.temperature_raw 和 agent.temperature_by_options_raw 获得,加载时会有 RuntimeWarning 命名每一个被夹紧的桶。
batch_size=16 限制每次前向传播的问题数;更大的请求会分块处理。内存允许时可以提高它。device="gpu" 或 device="cpu" 显式选择设备;否则使用 MLX 的默认设备。
对于重复性工作负载,加载 Agent 时可选择启用 compile=True、pad_to_multiple=16 和 cache_prompts=True。前缀缓存上限为 128 个问题,并共享 CPU 侧的 state 分词,而每个问题仍各自做一次编码器计算。编译有首次使用成本和形状特化;填充可能让某些工作负载变慢。这三个选项默认都关闭。实测的 Snake 消融与用法。
agent = laya.load("./models/laya", dtype="float32", batch_size=32)
# Select one checkpoint inside upstream's bundled repository:
multi = laya.load("convaiinnovations/laya", subfolder="multilingual")
# Pin a Hub revision for reproducibility:
agent = laya.load(
    "convaiinnovations/laya",
    revision="c5d78730f3493e4fe16d61507ef4b78eef7318cf",
)
加载时会校验每一个参数名和形状。不支持的编码器和非默认的 RoPE 缩放会显式报错。ModernBERT 的全局/局部注意力模式、包含边界的滑动窗口、局部与全局不同的 RoPE 基,以及第一层的归一化行为都被保留。
语言路由与预设
from laya_mlx import Router, triage_questions

router = Router(dtype="float16", max_loaded=2)
result = router.predict({"message": "发票被重复扣款,请退款。"}, triage_questions())
print(result["routing"])  # multilingual

# Choose the specialized checkpoint explicitly:
result = router.predict(state, questions, task="typed_decisions")路由、语言启发式、邮件辅助函数和应用预设都改编自上游。Router(preload=True) 让三个 checkpoint 全部常驻;支持 attach、preload、unload、显式 lang= 和显式 model=。模型生命周期由可重入锁保护,因此并发线程共享一个已加载的 Agent,而不是各自构建副本;推理本身并不串行化。typed-decisions 工作流检测保持 opt-in。这个端口保留了模型的局限:英文 checkpoint 不能替代 multilingual checkpoint,置信度也不保证准确率。
无法识别的拉丁字母语言(罗马尼亚语、波兰语、捷克语、土耳其语……)仅凭其非英文字母就会路由到 multilingual checkpoint,而不是被默默假定为英文。detect_language(state) 报告依据:language_undecided 和 diacritic_rate,以及 language 和 is_english。
大型选项集的初筛
choice 选项共享一份 head_max_len token 预算,所以一个带数百个标签的问题只会给每个标签留下几个 token。predict_shortlist 会分别嵌入 state 和每个标签,按余弦相似度保留前 k 个,然后在缩减后的集合上跑一次 predict。这是 opt-in:Agent.predict 仍会给它的每一个 criterion 打分。
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
embed_fn = laya.embed_fn_from_agent(agent)  # mean-pools the loaded encoder; no extra weights
result = laya.predict_shortlist(agent, state, questions, embed_fn, k=20)
print(result["shortlist"])  # which labels were kept, with cosine scores
作为 embed_fn 传入的专用双编码器通常比决策 checkpoint 自带的编码器筛得更好。初筛后 choice 上的概率只覆盖被保留的标签。
命令行
uv run laya-mlx predict \
  --model aac6fef/laya-mlx \
  --state-file examples/state.json \
  --questions examples/questions.json

uv run laya-mlx predict \
  --model aac6fef/laya-multilingual-mlx \
  --state '发票被重复扣款,请退款。' \
  --questions examples/questions.json
v0.3.5 之后选用的上游修复
运行时选择性地引入上游 4aa6761(v0.3.23 源码树)中的输入、路由和邮件修复。这不会加入上游的 batch、长文档、hooks 或 server API。神经架构的保真度仍针对 573e5b6 测试。
- 按时间顺序的对话列表在上下文填满时保留最新的 token;字符串和字典保留开头。前缀缓存使用相同的规则。
noul的 criteria 只接受false/true键(包括 Python 布尔键)。可选的labels={"false": "no", "true": "yes"}会改变展示给模型的词,而答案仍是 P(true)。非法键现在会报错,而不是被忽略。- 非字符串指令保留 Unicode。空指令、null 评分档位和
Nonestate 会触发调用方错误;问题相关的错误会指出是哪个问题。 - 每个答案都新增
answer_confidence,即校准后的最大选项概率。现有的confidence保留其基于熵的含义(对 choice/score)和最大概率(对 noul)。这两个字段都不保证新任务上的准确率。 usage新增state_tokens、state_tokens_dropped(各问题中最大的丢弃量)、truncated和truncated_questions。usage.options只在某些问题的选项 token 跨度发生碰撞时出现,报告total、distinct和tokens_per_option。这报告的是丢失的区分度;它不会找回这些区分度,也不移除位置偏差。- 增量的
Router.preload()保留已常驻的模型;preload([])什么都不做。空白或语言中立的提示会落到检测环节,无法确定的拉丁文本遵循Router(default=...)。检测会检查嵌套的字符串值和混合文本。 - 邮件清洗会保留提及保密、致谢收件人或以
From:开头的普通请求,同时识别多语言邮件页脚。
导出 MLX checkpoint
uv run laya-mlx convert \
  --model convaiinnovations/laya \
  --dtype float16 \
  --output models/laya-mlx-fp16

uv run laya-mlx predict \
  --model models/laya-mlx-fp16 \
  --state-file examples/state.json \
  --questions examples/questions.json
导出内容包含 model.safetensors、编码器和 agent 配置、tokenizer 文件以及 mlx_config.json。已有的输出目录绝不会被覆盖。这是参数名/精度转换,不是量化或重训练。源 checkpoint 已经存储 FP16 权重;选择 FP32 提高的是算术精度,不是源权重的精度。
测试与基准
uv sync --extra dev --extra reference --extra benchmark --extra demo
source .venv/bin/activate
gh repo clone NandhaKishorM/laya .upstream
git -C .upstream checkout 573e5b62696ba441230cd6be71d593331b5d23af
pytest -q
python -m benchmarks.download
python -m benchmarks.validate --repeats 100
python -m benchmarks.run --iterations 50 --warmup 5
python -m benchmarks.accuracy --per-class 64
python -m benchmarks.report
按顺序运行 GPU 测量。单元测试使用小型随机模型,并包含与 Transformers 和固定上游决策头的直接比较。真实 checkpoint 验证会测试分词、logits、校准概率、重复输出和活动内存增长。基准在每次运行时都用全新的进程跑每个后端/checkpoint,并把每一个计时样本存到 benchmarks/results。完整报告 解释了计时的边界和精度差异。
GitHub Actions 在 macOS arm64 runner 上运行小模型 CPU 测试。完整的 checkpoint GPU 基准在本地测量,不属于托管的 CI。
性能研究
性能调查同时包含数学分析和独立的本地实验:
- 初步性能研究:实现瓶颈、MLX kernel 调度,以及一个受控实验计划。
- 关于再快 10× 的数学调查:算术预算、条件带宽下界、真实权重谱、精确复用,以及更小的模型设计。
- 工程调查:实测的编译、量化、末头选择、自定义 Metal kernel,以及有代表性的矩阵乘法。
experiments/ 包含研究脚本及其原始测量。已发布运行时的性能与验证结果在 BENCHMARKS.md 中;每个实验性变体都有自己的计时与正确性结果。
当前调查不支持用相同 checkpoint 再获得普遍的 10× 加速。选定的用例显示约 1.03–1.08× 的成对中位加速;工程报告给出了不确定区间、量化保真度结果和自定义 Metal kernel 测量。
要准备模型卡和经过验证的导出以供发布,安装 reference extras 并运行:
python -m scripts.prepare_hub --account YOUR_HF_USERNAME
hf upload YOUR_HF_USERNAME/laya-mlx models/hub/laya-mlx . --exclude '.cache/*'
准备脚本会把每一个导出的张量与其原始 FP16 源逐一核对。用同样的方式上传另外两个准备好的文件夹,然后用 hf cache verify REPO_ID --local-dir EXPORT_PATH 检查远程文件。
署名与许可
Apache-2.0;见 LICENSE 与 NOTICE。Laya 及其预训练权重由 Convai Innovations 和上游贡献者完成。提示构造、输出格式化、语言路由、邮件工具和预设改编自 NandhaKishorM/laya 的 573e5b62696ba441230cd6be71d593331b5d23af 提交。神经架构在 MLX 中依据 Laya 和 Hugging Face ModernBERT 重新实现。
维护与发布
这个项目通过原生 MLX 实现,跟随上游 Laya 的行为。兼容上游的修复优先于独立的模型变体、服务 API 和额外 demo。这仍然是一个选择性的端口,不声称与上游 API 完全对齐。
发布时,更新 pyproject.toml、laya_mlx/__init__.py 和 uv.lock 中的版本,然后推送匹配的 vX.Y.Z tag。GitHub Actions 会运行 macOS 测试套件、校验版本一致性、构建并检查 wheel 和源码分发包、用仓库的 PYPI_API_TOKEN secret 把它们发布到 PyPI,并创建 GitHub release。测试或构建失败会阻止发布。