Typisierte Entscheidungen mit offenen Gewichten, nativ auf Apple Silicon.
13.4 ms Median Ende-zu-Ende für eine kurze englische typisierte Entscheidung. 7.4 ms mit dem mehrsprachigen Checkpoint. 0 Ausgabe-Tokens. Lokale MLX-Inferenz, ohne PyTorch, Transformers-Runtime oder Cloud-API.
Chinesisch · Benchmarks · Snake-Demo · Hugging Face-Gewichte
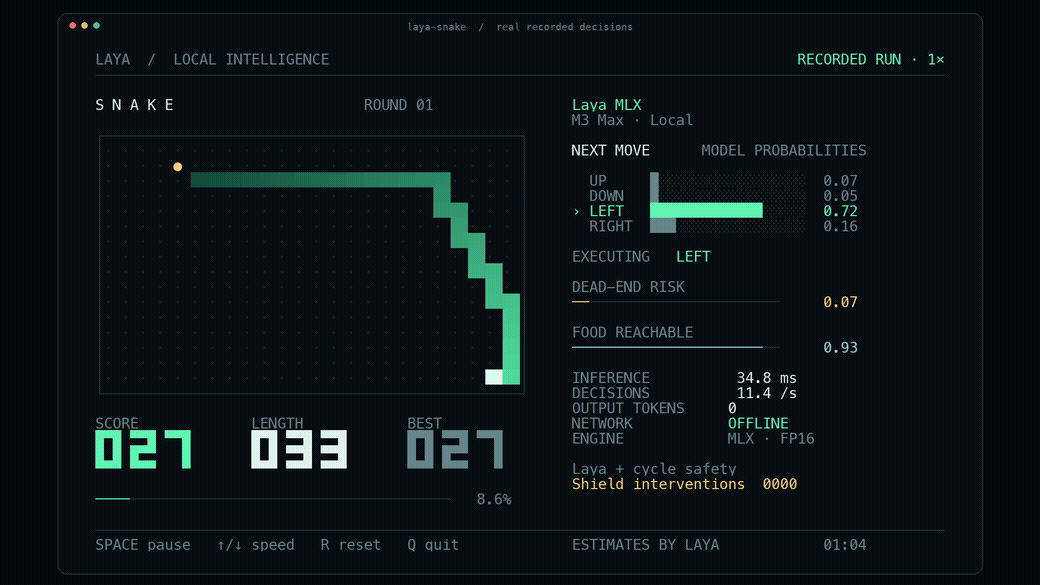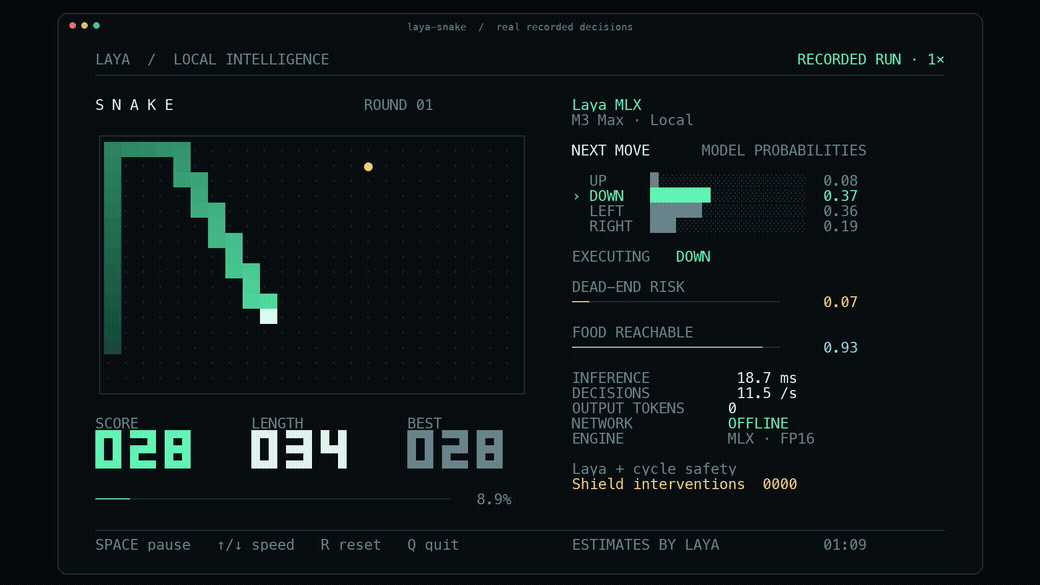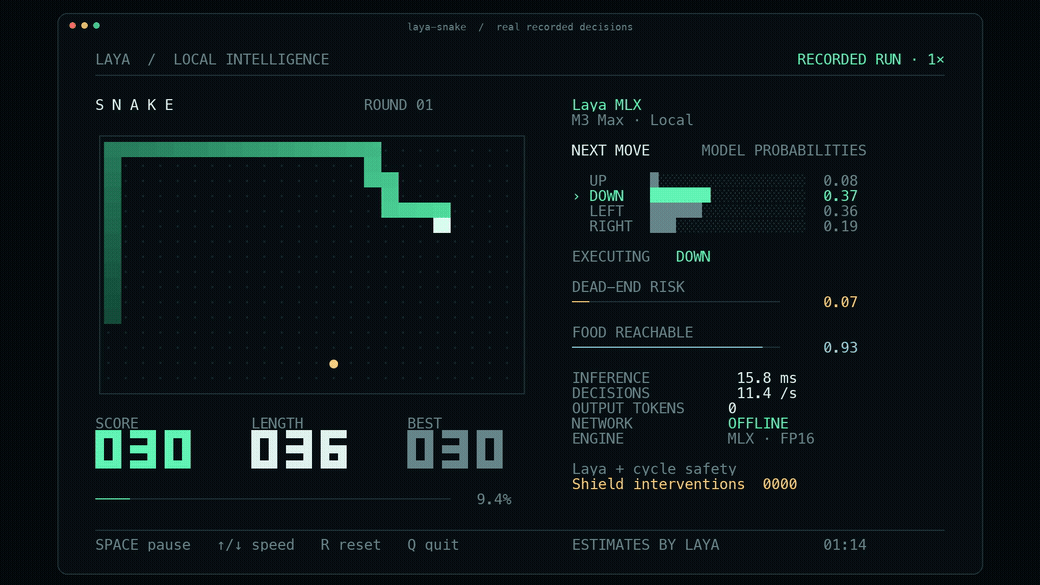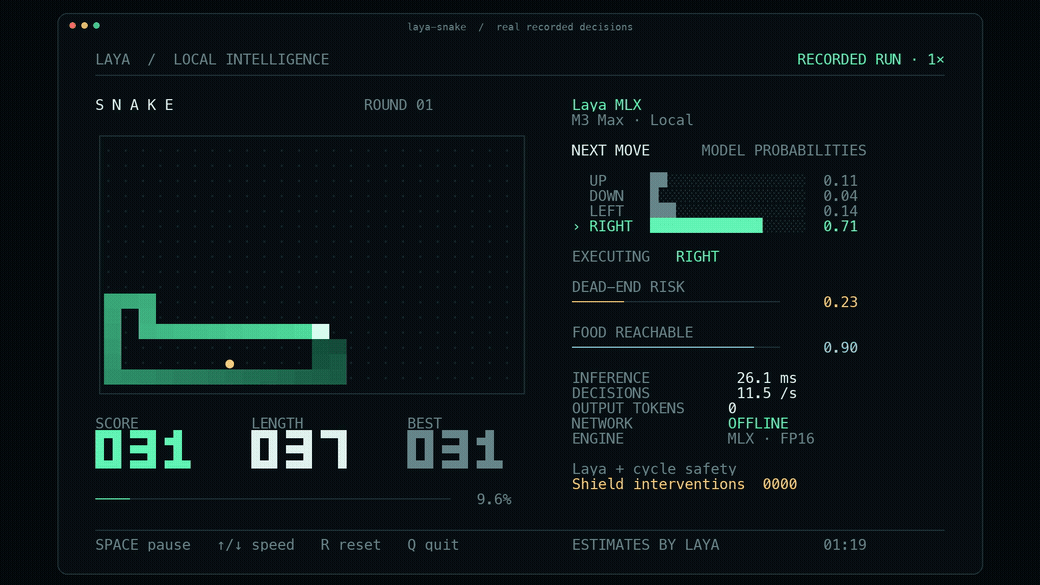
Das GIF ist ein Rendering in Originalgeschwindigkeit eines echten lokalen Snake-Laufs. Jeder Zug ruft Laya auf; die sichtbare Zyklus-Sicherheitsschicht kann unsichere Vorschläge korrigieren. Die obigen Latenzwerte stammen aus dem separaten Ein-Frage-API-Benchmark, nicht aus der Frame-Zeit der Drei-Fragen-Snake-Schleife. Das 30-sekündige MP4 ansehen · Snake-Geschwindigkeit und -Stabilität.
Schnellstart
pip install laya-mlximport laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
"I was billed twice. Please refund the duplicate.",
{
"department": {
"type": "choice",
"instructions": "Who should handle this?",
"criteria": ["billing", "technical", "sales"],
}
},
)
print(result["answers"]["department"])Apple Silicon, Python 3.11+, macOS 14+. Der erste Ladevorgang lädt den Checkpoint herunter; spätere Inferenz ist vollständig lokal. Die gemessene Umgebung ist macOS 27.2, Python 3.12.13 und MLX 0.32.2. Diese MLX-Version liefert Wheels für macOS 14, 15 und 26; der lokale Installer wählte das 26er-Wheel. Ältere unterstützte macOS-Versionen wurden auf dieser Maschine nicht getestet.
Führe die Terminal-Demo aus:
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
Lade einmal vor der Offline-Demo herunter. Verwende ein Terminal mit mindestens 104 × 35 Zellen. Leertaste pausiert, ↑/↓ ändert die Geschwindigkeit, R setzt zurück und Q beendet. laya-snake --max-speed trifft für jeden Zug eine frische Entscheidung ohne Taktung. Aufzeichnung, Steuerung und genaue Bedeutung der Metriken.
laya-snake --optimize --max-speed aktiviert den getesteten Kompilierungs- und Prefix-Wiederverwendungspfad: 75.40 Züge/s über 2,400 Züge, null Tode und 2 sichtbare Sicherheitseingriffe im gepaarten M3 Max-Test. Das war etwa 6.5% schneller als die Eager-Kontrolle im selben Lauf. Belege zu Spielverlauf, Leistung und Korrektheit.
Leistung auf M3 Max
| FP16, Ende-zu-Ende | Laya 421M | Mehrsprachig 322M |
|---|---|---|
| Eine kurze Frage, P50 | 13.42 ms | 7.39 ms |
| Eine kurze Frage, P95 | 13.92 ms | 7.79 ms |
| Durchsatz bei 50 Fragen | 146.8 q/s | 395.0 q/s |
| Spitzen-MLX-Allokation, eine kurze Frage | 943.6 MiB | 687.6 MiB |
M3 Max, 40 GPU-Kerne, 128 GiB Speicher. Die Zeitmessung umfasst Prompt-Vorbereitung, Tokenisierung, Tensoren, synchronisierte Inferenz, Kalibrierung und Ergebnisformatierung; das Laden des Modells ist ausgeschlossen. Die 50-Fragen-Messung verwendet batch_size=64; die API verwendet standardmäßig 16. Unterschiedliche Längen, Fragenzahlen und Laufzeitbedingungen verändern die Latenz. Vollständige Methode und jeder Zeitmesswert.
Port-Treue: Alle drei Checkpoints stimmten mit der ausgewählten Upstream-Antwort bei 63/63 Validierungsfragen sowohl in FP32 als auch in FP16 überein — 378/378 Vergleiche. Jede Konfiguration bestand außerdem 100 wiederholte endliche, deterministische Aufrufe mit null gemessenem Wachstum des aktiven Speichers. Dies misst die Treue auf diesen Fixtures, nicht die Genauigkeit bei jeder möglichen Frage. Wahrscheinlichkeitsfehler und Validierung.
Warum typisierte Entscheidungen?
Software braucht oft eine Auswahl, eine Rubrik-Punktzahl oder eine Wahrscheinlichkeit. Laya beantwortet diese eingeschränkten Fragen in einem bidirektionalen Vorwärtspass, ohne Token-für-Token-Dekodierung oder generiertes JSON.
state + typed question → bidirectional encoder → decision heads → probabilitieschoice: Wahrscheinlichkeiten über benannte Optionen.score: Wahrscheinlichkeiten über geordnete Rubrik-Stufen und deren erwartete Punktzahl.noul: P(true) für eine Aussage.
Fragezeilen werden unabhängig gebündelt. Ihre bidirektionalen Encoder-Repräsentationen hängen sowohl vom Zustand als auch von der Frage ab; diese Runtime behauptet nicht, den Zustand einmal zu kodieren und seine Hidden States über beliebige Fragen hinweg wiederzuverwenden.
Der Encoder, der Decision-Transformer, der Scoring-Head und der Action-Head laufen alle in MLX. Die Tokenisierung verwendet Hugging Faces Rust-Tokenizer. Die ursprünglichen vortrainierten Gewichte, die Frageformatierung, die Kalibrierung und das Ausgabeschema bleiben erhalten. Dies ist ein unabhängiger MLX-Port, keine offizielle Veröffentlichung von Convai Innovations.
Unterstützte Checkpoints
| Modell | Encoder | Parameter | Kontextlimit | Zweck |
|---|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 | Englisch |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 | Mehrsprachige Eingabe |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | Upstream-Workflows für typisierte Entscheidungen |
Der Kontext umfasst Instruktionen, Optionen und Zustand. Alle drei verwenden die ursprünglichen Gewichte, die Prompt-Formatierung, die Temperaturkalibrierung und das Ausgabeschema. Dieses Repository bietet Inferenz und Konvertierung; RLCD-Training und Fine-Tuning verbleiben im Upstream-Projekt. Es ist ein unabhängiger Port, keine offizielle Veröffentlichung von Convai Innovations.
Vorkonvertierte FP16-Checkpoints sind auf Hugging Face veröffentlicht:
Lade diese direkt mit laya.load("aac6fef/laya-mlx") oder verwende die ursprünglichen Checkpoint-IDs oben. Jeder veröffentlichte Checkpoint enthält seine Modellkarte, Validierungsergebnisse, Herkunft, Lizenz und Datei-Prüfsummen. Alle 36 veröffentlichten Dateien bestanden die strikte Remote-Prüfsummenverifikation; fixierte Revisionen und Gewichtshashes sind in hub-publication.json festgehalten.
Entwicklungsinstallation
gh repo clone mizorewww/laya-mlx
cd laya-mlx
uv sync --extra demo
uv run --extra demo laya-snake
Oder installiere die neueste GitHub-Revision mit pip install 'git+https://github.com/mizorewww/laya-mlx.git'. Modellgewichte werden separat heruntergeladen und sind von Git ausgeschlossen.
Python-API
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx", dtype="float16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate today.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs and outages",
                "sales": "new purchases",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": ["not urgent", "soon", "critical"],
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"])
system_one ist ein Alias für predict. Zustände können Text, JSON-Dictionaries oder Konversationslisten sein. choice akzeptiert ein Dictionary oder eine Liste eindeutiger Labels; score gibt die erwartete nullbasierte Rubrik-Stufe zurück; noul gibt P(true) zurück. Ergebnisse behalten die auf vier Dezimalstellen gerundete Darstellung von Upstream, action.act_probability und die Token-Nutzungsfelder bei.
Die Standardpräzision ist FP16. Verwende dtype="float32" für eine engere numerische Übereinstimmung. Wahrscheinlichkeiten können sich zwischen Präzisionen leicht unterscheiden, selbst wenn das ausgewählte Label übereinstimmt; siehe die gemessenen Fehler in BENCHMARKS.md. BF16 kann angefordert werden, ist aber nicht Teil der veröffentlichten Validierungsmatrix.
Gemäß Upstream v0.3.5 werden angepasste Kalibrierungstemperaturen vor der Verwendung auf [0.5, 5.0] begrenzt: Der mitgelieferte choice:11+-Bucket ist 0.1006, was Logits um ~10x schärfen und einen Münzwurf als nahezu sicher melden würde. Die Rohwerte des Checkpoints bleiben als agent.temperature_raw und agent.temperature_by_options_raw verfügbar, und ein RuntimeWarning benennt beim Laden jeden begrenzten Bucket.
batch_size=16 begrenzt die Anzahl der Fragen pro Vorwärtspass; größere Anfragen werden in Blöcken verarbeitet. Erhöhe ihn, wenn der Speicher es zulässt. device="gpu" oder device="cpu" wählt explizit ein Gerät aus; andernfalls wird das Standardgerät von MLX verwendet.
Für wiederkehrende Workloads entscheide dich beim Laden eines Agent für compile=True, pad_to_multiple=16 und cache_prompts=True. Der Prefix-Cache ist auf 128 Fragen begrenzt und teilt die CPU-Tokenisierung des Zustands, während jede Frage weiterhin ihre eigene Encoder-Berechnung erhält. Die Kompilierung hat einen Erstnutzungskostenaufwand und eine Shape-Spezialisierung; das Padding kann einige Workloads langsamer machen. Alle drei Optionen sind standardmäßig deaktiviert. Gemessene Snake-Ablation und Nutzung.
agent = laya.load("./models/laya", dtype="float32", batch_size=32)
# Select one checkpoint inside upstream's bundled repository:
multi = laya.load("convaiinnovations/laya", subfolder="multilingual")
# Pin a Hub revision for reproducibility:
agent = laya.load(
    "convaiinnovations/laya",
    revision="c5d78730f3493e4fe16d61507ef4b78eef7318cf",
)
Das Laden validiert jeden Parameternamen und jede Shape. Nicht unterstützte Encoder und nicht standardmäßige RoPE-Skalierung schlagen explizit fehl. ModernBERTs globales/lokales Attention-Muster, die inklusive Sliding-Window-Grenze, die unterschiedlichen lokalen/globalen RoPE-Basen und das Normalisierungsverhalten der ersten Schicht bleiben erhalten.
Sprach-Routing und Presets
from laya_mlx import Router, triage_questions

router = Router(dtype="float16", max_loaded=2)
result = router.predict({"message": "发票被重复扣款,请退款。"}, triage_questions())
print(result["routing"])  # multilingual

# Choose the specialized checkpoint explicitly:
result = router.predict(state, questions, task="typed_decisions")
Der Router, die Sprachheuristiken, die E-Mail-Helfer und die Anwendungs-Presets sind von Upstream übernommen. Router(preload=True) hält alle drei Checkpoints resident; attach, preload, unload, explizites lang= und explizites model= werden unterstützt. Der Modell-Lebenszyklus wird durch einen re-entrant Lock geschützt, sodass nebenläufige Threads einen geladenen Agent teilen, statt Duplikate zu erzeugen; die Inferenz selbst wird nicht serialisiert. Die Erkennung von Typed-Decisions-Workflows bleibt opt-in. Der Port bewahrt die Grenzen des Modells: Englische Checkpoints sind kein Ersatz für den mehrsprachigen Checkpoint, und Konfidenz garantiert keine Genauigkeit.
Nicht identifizierte Sprachen in lateinischer Schrift (Rumänisch, Polnisch, Tschechisch, Türkisch, …) werden allein aufgrund ihrer nicht-englischen Buchstaben zum mehrsprachigen Checkpoint geleitet, statt stillschweigend als Englisch angenommen zu werden. detect_language(state) meldet die Belege: language_undecided und diacritic_rate zusammen mit language und is_english.
Shortlisting großer Auswahlmengen
Choice-Optionen teilen sich ein einziges head_max_len-Token-Budget, sodass eine Frage mit Hunderten von Labels nur wenige Tokens pro Label übrig lässt. predict_shortlist bettet den Zustand und jedes Label ein, behält die Top k nach Kosinus-Ähnlichkeit und führt ein einzelnes predict auf der reduzierten Menge aus. Dies ist opt-in: Agent.predict bewertet weiterhin jedes Kriterium, das ihm gegeben wird.
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
embed_fn = laya.embed_fn_from_agent(agent)  # mean-pools the loaded encoder; no extra weights
result = laya.predict_shortlist(agent, state, questions, embed_fn, k=20)
print(result["shortlist"])  # which labels were kept, with cosine scores
Ein dedizierter Bi-Encoder, der als embed_fn übergeben wird, erstellt das Shortlisting meist besser als der eigene Encoder des Decision-Checkpoints. Wahrscheinlichkeiten bei einer shortlisteten Choice beziehen sich nur auf die beibehaltenen Labels.
Kommandozeile
uv run laya-mlx predict \
  --model aac6fef/laya-mlx \
  --state-file examples/state.json \
  --questions examples/questions.json

uv run laya-mlx predict \
  --model aac6fef/laya-multilingual-mlx \
  --state '发票被重复扣款,请退款。' \
  --questions examples/questions.json
Ausgewählte Upstream-Fixes nach v0.3.5
Die Runtime übernimmt selektiv Eingabe-, Routing- und E-Mail-Fixes aus Upstream
4aa6761 (v0.3.23 Quellbaum). Dies fügt nicht die Upstream-Batch-, Langdokument-,
Hooks- oder Server-APIs hinzu. Die Parität der neuronalen Architektur wird weiterhin gegen 573e5b6 getestet.
- Chronologische Konversationslisten behalten ihre neuesten Tokens, wenn der Kontext voll wird; Strings und Dictionaries behalten ihren Anfang. Das Prefix-Caching verwendet dieselbe Regel.
noul-Kriterien akzeptieren nurfalse/true-Schlüssel (einschließlich Python-Boolean-Schlüsseln). Das optionalelabels={"false": "no", "true": "yes"}ändert die dem Modell gezeigten Wörter, während die Antwort P(true) bleibt. Ungültige Schlüssel lösen jetzt einen Fehler aus, statt ignoriert zu werden.- Nicht-String-Instruktionen bewahren Unicode. Leere Instruktionen, null Score-Stufen,
und ein
None-Zustand lösen einen Aufruferfehler aus; Fragefehler benennen die Frage. - Jede Antwort ergänzt
answer_confidence, die maximale kalibrierte Optionswahrscheinlichkeit. Das bestehendeconfidencebehält seine entropiebasierte Bedeutung für choice/score und die maximale Wahrscheinlichkeit für noul. Keines der beiden Felder garantiert Genauigkeit bei einer neuen Aufgabe. usageergänztstate_tokens,state_tokens_dropped(den größten Verlust über alle Fragen),truncatedundtruncated_questions.usage.optionserscheint nur bei Fragen, deren Options-Token-Spans kollidieren, und meldettotal,distinctundtokens_per_option. Dies meldet verlorene Unterscheidungen; es stellt sie nicht wieder her und beseitigt keinen Positionsbias.- Inkrementelles
Router.preload()bewahrt residente Modelle;preload([])bewirkt nichts. Leere oder sprachneutrale Hinweise fallen auf die Erkennung durch, und nicht entschiedener lateinischer Text respektiertRouter(default=...). Die Erkennung untersucht verschachtelte String-Werte und gemischten Text. - Die E-Mail-Bereinigung bewahrt gewöhnliche Anfragen, die Vertraulichkeit erwähnen, dem
Empfänger danken oder mit
From:beginnen, während sie mehrsprachige Mail-Fußzeilen erkennt.
Einen MLX-Checkpoint exportieren
uv run laya-mlx convert \
  --model convaiinnovations/laya \
  --dtype float16 \
  --output models/laya-mlx-fp16

uv run laya-mlx predict \
  --model models/laya-mlx-fp16 \
  --state-file examples/state.json \
  --questions examples/questions.json
Der Export enthält model.safetensors, Encoder- und Agent-Konfigurationen, Tokenizer-Dateien und mlx_config.json. Bestehende Ausgabeverzeichnisse werden niemals überschrieben. Dies ist eine Konvertierung von Parameternamen/dtype, keine Quantisierung oder Neuschulung. Die Quell-Checkpoints speichern bereits FP16-Gewichte; die Wahl von FP32 erhöht die Rechenpräzision, nicht die Präzision der Quellgewichte.
Tests und Benchmarks
uv sync --extra dev --extra reference --extra benchmark --extra demo
source .venv/bin/activate
gh repo clone NandhaKishorM/laya .upstream
git -C .upstream checkout 573e5b62696ba441230cd6be71d593331b5d23af
pytest -q
python -m benchmarks.download
python -m benchmarks.validate --repeats 100
python -m benchmarks.run --iterations 50 --warmup 5
python -m benchmarks.accuracy --per-class 64
python -m benchmarks.report
Führe GPU-Messungen sequenziell aus. Unit-Tests verwenden kleine Zufallsmodelle und enthalten direkte Vergleiche mit Transformers und dem fixierten Upstream-Decision-Head. Die Validierung echter Checkpoints testet Tokenisierung, Logits, kalibrierte Wahrscheinlichkeiten, wiederholte Ausgaben und das Wachstum des aktiven Speichers. Der Benchmark führt jedes Backend/jeden Checkpoint in einem frischen Prozess aus und speichert jeden Zeitmesswert in benchmarks/results. Der vollständige Bericht erklärt die Zeitmessgrenzen und Präzisionsunterschiede.
GitHub Actions führt CPU-Tests mit kleinen Modellen auf einem macOS-arm64-Runner aus. Vollständige Checkpoint-GPU-Benchmarks werden lokal gemessen und sind nicht Teil der gehosteten CI.
Performance-Forschung
Die Performance-Untersuchungen umfassen sowohl mathematische Analysen als auch unabhängige lokale Experimente:
- Erste Performance-Untersuchung: Implementierungsengpässe, MLX-Kernel-Dispatch und ein kontrollierter Versuchsplan.
- Mathematische Untersuchung einer weiteren 10×-Beschleunigung: Arithmetik-Budgets, bedingte Bandbreitengrenzen, echte Gewichtsspektren, exakte Wiederverwendung und Designs kleinerer Modelle.
- Engineering-Untersuchung: gemessene Kompilierung, Quantisierung, Final-Head-Auswahl, eigene Metal-Kernels und repräsentative Matrixmultiplikationen.
experiments/ enthält die Forschungs-Skripte und ihre Rohmessungen. Die Performance- und Validierungsergebnisse der veröffentlichten Runtime stehen in BENCHMARKS.md; jede experimentelle Variante hat ihre eigenen Zeit- und Korrektheitsergebnisse.
Die aktuelle Untersuchung stützt keine weitere universelle 10×-Beschleunigung mit denselben Checkpoints. Ausgewählte Fälle zeigen gepaarte Median-Beschleunigungen von etwa 1.03–1.08×; der Engineering-Bericht liefert die Unsicherheitsintervalle, Quantisierungstreue-Ergebnisse und Messungen eigener Metal-Kernels.
Um Modellkarten und verifizierte Exporte für die Veröffentlichung vorzubereiten, installiere die Referenz-Extras und führe aus:
python -m scripts.prepare_hub --account YOUR_HF_USERNAME
hf upload YOUR_HF_USERNAME/laya-mlx models/hub/laya-mlx . --exclude '.cache/*'
Das Vorbereitungsskript prüft jeden exportierten Tensor gegen seine ursprüngliche FP16-Quelle. Lade die anderen beiden vorbereiteten Ordner auf dieselbe Weise hoch, und verwende dann hf cache verify REPO_ID --local-dir EXPORT_PATH, um die Remote-Dateien zu prüfen.
Namensnennung und Lizenz
Apache-2.0; siehe LICENSE und NOTICE. Laya und seine vortrainierten Gewichte stammen von Convai Innovations und Upstream-Mitwirkenden. Prompt-Konstruktion, Ausgabeformatierung, Sprach-Routing, E-Mail-Dienstprogramme und Presets sind von NandhaKishorM/laya beim Commit 573e5b62696ba441230cd6be71d593331b5d23af übernommen. Die neuronale Architektur ist in MLX nach Laya und Hugging Face ModernBERT neu implementiert.
Wartung und Releases
Dieses Projekt folgt dem Verhalten von Upstream Laya durch eine native MLX-Implementierung. Upstream-kompatible Fixes haben Vorrang vor unabhängigen Modellvarianten, Service-APIs und zusätzlichen Demos. Dies bleibt ein selektiver Port, keine Behauptung vollständiger Upstream-API-Parität.
Für ein Release aktualisiere die Version in pyproject.toml, laya_mlx/__init__.py und uv.lock,
und pushe dann ein passendes vX.Y.Z-Tag. GitHub Actions führt die macOS-Testsuite aus, validiert
die Versionskonsistenz, baut und prüft das Wheel und die Quellverteilung, veröffentlicht
sie auf PyPI mit dem PYPI_API_TOKEN-Secret des Repositories und erstellt ein GitHub-Release.
Ein fehlgeschlagener Test oder Build verhindert die Veröffentlichung.