自分で訓練して動かせる、Jev に似た小さな意思決定モデル。
Kev は Qwen3.5 と Qwen3.8 上に構築され、Jev’s Architecture Unmasked で説明されているアーキテクチャに基づく、小さな意思決定モデルのファミリーです。事前訓練済みの重みを使うことも、自分で訓練することもできます。API は TypeSafe の System One と一致するので、TypeSafe の Python SDK をローカルサーバーに向けられます。
ハイライト
- はい/いいえ(
noul)、多肢選択(choice)、評価(score)の質問を 1 つのリクエストで。質問はテキストを共有しますが、互いを読めません。 - 既定で較正された確率: 各チェックポイントはフィット済みの温度を同梱します。
- Jev への drop-in: TypeSafe Python SDK が、変更なしに Kev サーバーに対して動きます。
- Kev 1.0 として一緒にバージョン付けされた 4 つのサイズ: ノート PC で動く 0.8B から、データセンターの単一 GPU 向けの 27B まで。
- 最大 65,536 トークンの文書を、CUDA と、MLX 経由の Apple Silicon で。精度が落ちる前に文書をどこまで長くできるかは、各モデルカードに書かれています。
- 自分のラベル付き例でファインチューニングできます。コーディングエージェントのスキルが、質問の発見から結果の提供まで、ループ全体を Modal 上で実行します。
- 自分の HTTPS エンドポイントを 1 コマンドでデプロイできます。アイドル時はゼロにスケールします。
- まずブラウザで試せます: huggingface.co/spaces/jaredpalmer/kev。
モデル
まず Kev-4B から始めてください。より大きな GPU があれば Kev-9B、80 GB の GPU があり最も精度の高い Kev を求めるなら Kev-27B に進んでください。精度よりサイズが重要なときは Kev-0.8B を使ってください。
| モデル | ベース(ライセンス) | 動作: CUDA | 動作: Mac (MLX) | 検証済みコンテキスト | ホールドアウトデータセット: 指数 | カード |
|---|---|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base(Apache-2.0) | L4、任意の 4 GB GPU | 任意の Apple Silicon Mac。65k トークンまで測定 | 8,192 | 23.3 | 詳細 |
| Kev-4B | Qwen3.5-4B-Base(Apache-2.0) | L40S、H100 | 32 GB Mac。65k トークンまで測定 | 8,192 | 38.0 | 詳細 |
| Kev-9B | Qwen3.5-9B-Base(Apache-2.0) | L40S、H100 | 32 GB Mac 以上(見込み、未測定) | 8,192 | 41.0 | 詳細 |
| Kev-27B | Qwen3.8-27B、post-trained(Apache-2.0) | B200、H200、H100 80 GB | 96–128 GB Mac(見込み、未測定) | 65,536 | 52.3 | 詳細 |
| Jev | ホスト型 | TypeSafe の API | – | – | 54.0 | – |
「ホールドアウトデータセット」は、コミュニティ Decision Index のチャンス補正指数で、breadth-v1 のテスト分割で採点したものです。どの Kev も訓練していない、5 領域 14 の公開データセットです。「検証済みコンテキスト」は、実契約(CUAD)での精度が 8k トークンの同じモデルの精度に対して 95 % 下限で 3 ポイント以内に収まる、トークン単位の最長文書です。長さごとの測定は各モデルカードにあります。
| モデル | 精度: 新規ソース | 精度: 訓練済みソース | Brier: 新規ソース |
|---|---|---|---|
| Kev-0.8B | 0.648 / 0.697 | 0.827 / 0.838 | 0.481 / 0.416 |
| Kev-4B | 0.817 / 0.838 | 0.873 / 0.865 | 0.269 / 0.242 |
| Kev-9B | 0.820 / 0.852 | 0.874 / 0.873 | 0.289 / 0.217 |
| Kev-27B | 0.851 / 0.889 | 0.865 / 0.866 | 0.225 / 0.156 |
| Jev | 0.857 / – | 0.845 / – | 0.211 / – |
各セルは 開発 / テスト です。「新規ソース」は、Kev が訓練中に一度も見なかったデータセットとポリシールールを意味します。ここで自分の質問に最も近いものです。「訓練済みソース」は、Kev が訓練したデータセットのホールドアウト例を意味します。私たちは開発セットでチェックポイントを選び、各テストセットはリリースしたモデルごとに一度だけ読みます。Jev はこれら 2 つのスイートの開発セットでしか実行されていません。Brier は最上位の答えだけでなく確率分布全体を採点します。低いほど良いです。
新規ソースでは、Kev-27B は Jev まで 1 ポイント以内(0.851 対 0.857)、Kev-4B と Kev-9B は 4 ポイント以内です。Jev が何で訓練されたかは分からないので、これは 2 つのアーキテクチャの管理された比較ではありません。What to Expect に、Kev が Jev と同等なところとそうでないところを書いています。
Kev-0.8B、4B、9B は Qwen のベースモデルから始まり、1 つの訓練レシピを共有します: 凍結したベース上の小さなアダプタです。Kev-27B は Qwen の post-trained リリースから始まり、それが何で訓練されたかは分かっていません。その重みはすべてファインチューニングされているので、アダプタではなく 51 GB の完全な重みとして出荷されます。各モデルカードに完全なレシピ、すべての結果、そして Hub タグとして保持された以前のバージョンがあります。
Kev 1.0
上の 4 つのモデルは、Kev 1.0 として一緒にリリースされています。各 Hub リポジトリには v1.0 タグがあるので、--run jaredpalmer/kev-4b@v1.0 は常に同じ重みを読み込み、GitHub リリース kev-1.0 には 0.8B、4B、9B のチェックポイントが SHA-256 チェックサム付きであります。Kev-27B の 51 GB の重みはリリースアセットには大きすぎるため、Hub にのみあります。
| モデル | 重みの Hub リビジョン | 温度 | 訓練した状態の上限 |
|---|---|---|---|
| Kev-0.8B | 9a45d25e |
2.35 | 7,552 トークン |
| Kev-4B | 139fdd94 |
2.41 | 7,552 トークン |
| Kev-9B | b5d8c18e (v2) |
2.19 | 7,552 トークン |
| Kev-27B | 28be62e9 (v2, full weights) |
1.32 | 32,768 トークン |
Kev 1.0 は新しく何も訓練していません。次の世代の Kev が比較される対象となるチェックポイント、カード、評価スイート、提供コードを固定します。リリースノート に、前回のファミリーリリースからの変更点と、うまく動かないと分かっていることが挙げられています。
クイックスタート
ブラウザで試す
Hugging Face Space は Kev-4B と Kev-0.8B を動かし、インストールは何も要りません。
ローカルで動かす
Python 3.12 または 3.13 と uv が必要です。リポジトリの .python-version により uv sync は 3.13 を使います。torch にはまだ 3.14 のホイールがありません。
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
これで自分のマシン上で Kev-4B が起動します。GPU があれば CUDA か ROCm、Apple Silicon では MLX です。初回実行ではアダプタとベースモデルをダウンロードします。--run はローカルのチェックポイントディレクトリや、jaredpalmer/kev-4b@qwen3 のような Hub リビジョンも受け付けます。
別のターミナルで、チケットを送ってください:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
Apple M5 で bf16 で動作している Kev-4B からの応答例:
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.34,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
}
チケットは返品、遅延配送、請求の問題に触れており、department の確率もそう言っています。だから Kev は単一のラベルではなく確率を返します: コードが確信のあるケースを振り分け、残りを人に送れます。
Python から使う
すでに Jev を呼んでいるなら、クライアントを Kev に向けて、残りのコードはそのままにできます。TypeSafe SDK は uv sync --extra serve に含まれています:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
自分のデータでファインチューニング
リリースされたモデルは公開データセットと生成されたポリシー例で訓練されています。あなたの質問が違って見えるなら —— 自分のルーティングカテゴリ、自分のエスカレーションルール、別の言語など —— 短いファインチューニングはたいていプロンプトの変更より効きます。データに温度もフィットさせるので、しきい値を設定する信頼度は自分のラベルで測定されたものになります。
期待できること: あるサポート業務の例(3 つの質問、生成レコード 1,050、H100 で 15 分)では、ファインチューニングは Kev-4B を精度 67.7% から 73.6% に、5% の誤り予算で自動化できる決定を 34% から 48% に上げました(詳細)。実データでは、5,219 件のラベル付き消費者金融苦情で 1 エポックが Kev-4B を、一度も見たことのない苦情での精度 0.804 から 0.904 に上げました。このような利得は分布内です: それは Kev があなたのタスクをどれだけ学ぶかを示し、それ以外すべてでどうかを示すものではありません。まずデータセットのサイズを見積もってください。400 レコードでは、例の業務での利得はノイズの範囲内でした。
コーディングエージェントで
npx skills add jaredpalmer/kev@kev-finetuneその後、エージェントに「私のサポートチケットで Kev をファインチューニングして」と頼みます。kev-finetune スキル は、あなたに聞き取り、あなたのコードがすでに Jev や TypeSafe に投げている質問を見つけ、手持ちのラベルを変換するか任意の LLM で利得を測れるだけ生成し、リリース済みチェックポイントから Modal 上でファインチューニングし、ホールドアウトのスライスで温度をフィットし、手つかずのモデルに対して結果を採点し、エンドポイントをデプロイし、最後にすべてを片付けます。ローカルの GPU もこのリポジトリのクローンも不要です。Kev-4B の訓練 1 回は H100 で約 1 ドルかかります。
手作業で
スキルの README は、人向けの同じレシピです: 6 つの短い標準ライブラリスクリプトと 1 つの Modal アプリです。代わりにこのリポジトリから訓練するには、例を JSONL ファイルに、1 行に 1 リクエストで入れてください。API リクエストと同じ形で、各質問に label が付きます:
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
   "priority": {"type": "score",  "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}
choice ではラベルは選択肢名、noul では true か false、score では 0 から始まる段階の位置です。ファイルの 10–20% を評価用に取っておいてください。
次に、リリース済みチェックポイントから --init_from で始めます:
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine

uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
uv run --extra serve python -m kev.serve --run runs/mine --port 8009
--init_from は訓練前にリリース済みモデルからアダプタとポインタヘッドを読み込むので、Kev がすでに知っていることを保ち、その上に自分のドメインを足せます。代わりにベースモデルから始めるとそれを捨てます。あるユーザーの 836 件のサポートツール決定でのテストでは、ベースからのファインチューニングは Kev 自身の評価セットで 0.33 を記録し、リリース済みモデルは 0.84 でした。同じデータで --init_from を使うとそこで 0.83 を保ち、新しいドメインで 0.88 に達しました。ゼロからのレシピより小さい学習率を使ってください(2e-5 が良い出発点です)。そして --base は開始するチェックポイントに合わせて選んでください。トレーナーは、何かを読み込む前にベース、リビジョン、LoRA ランク、ヘッドサイズが一致することを確認します。
bf16 での --batch 1 --accum 8 は、0.8B モデルを 4 GB の GPU に収めます。ベンチマークは質問種別ごとに精度、Brier スコア、較正を報告するので、ファインチューニングがどの質問に効いたか分かります。開始したチェックポイントは runs/mine/training_config.json に記録されます。Mac では訓練ジョブを一度に 1 つ実行してください。同じ Apple GPU 上の 2 つのジョブはずっと遅くなります。
自分のエンドポイントをデプロイ
ローカルサーバーではなく HTTPS エンドポイントを得るには、このリポジトリは不要で、Modal アカウントだけが必要です:
pip install modal && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
これで Kev-4B が L40S 上で https://<your-workspace>--kev-api.modal.run に提供され、上と同じ API が Authorization: Bearer <key> の背後に置かれます。アイドル時はゼロにスケールするので、使われないエンドポイントは何もコストがかかりません。アイドル後の最初のリクエストは、コンテナの起動に約 35 秒待ちます。KEV_MODEL=jaredpalmer/kev-9b は、それに合った GPU 上で別のモデルを提供します。Kev-27B は B200 に行き、H200 か H100 にフォールバックします。コーディングエージェントを使うなら、npx skills add jaredpalmer/kev@kev-deploy が同じことをして、URL をあなたのコードに配線します。skills/kev-deploy に GPU とコストの表があります。
kev-finetune スキルでファインチューニングしたモデルは、それ自身の Modal アプリから同じようにデプロイされます(KEV_SERVE_SECRET=kev-serve-key KEV_SERVE_RUN=<run> modal deploy scripts/kev_modal.py。そのデプロイガイドを参照)。代わりに自分のマシンで Kev をホストするには、Run It Locally の kev.serve を --host 0.0.0.0 付きで GPU マシン上で実行し、自分のプロキシの背後に置いてください。Serving Performance にどの GPU を選ぶべきかが書かれています。
期待できること
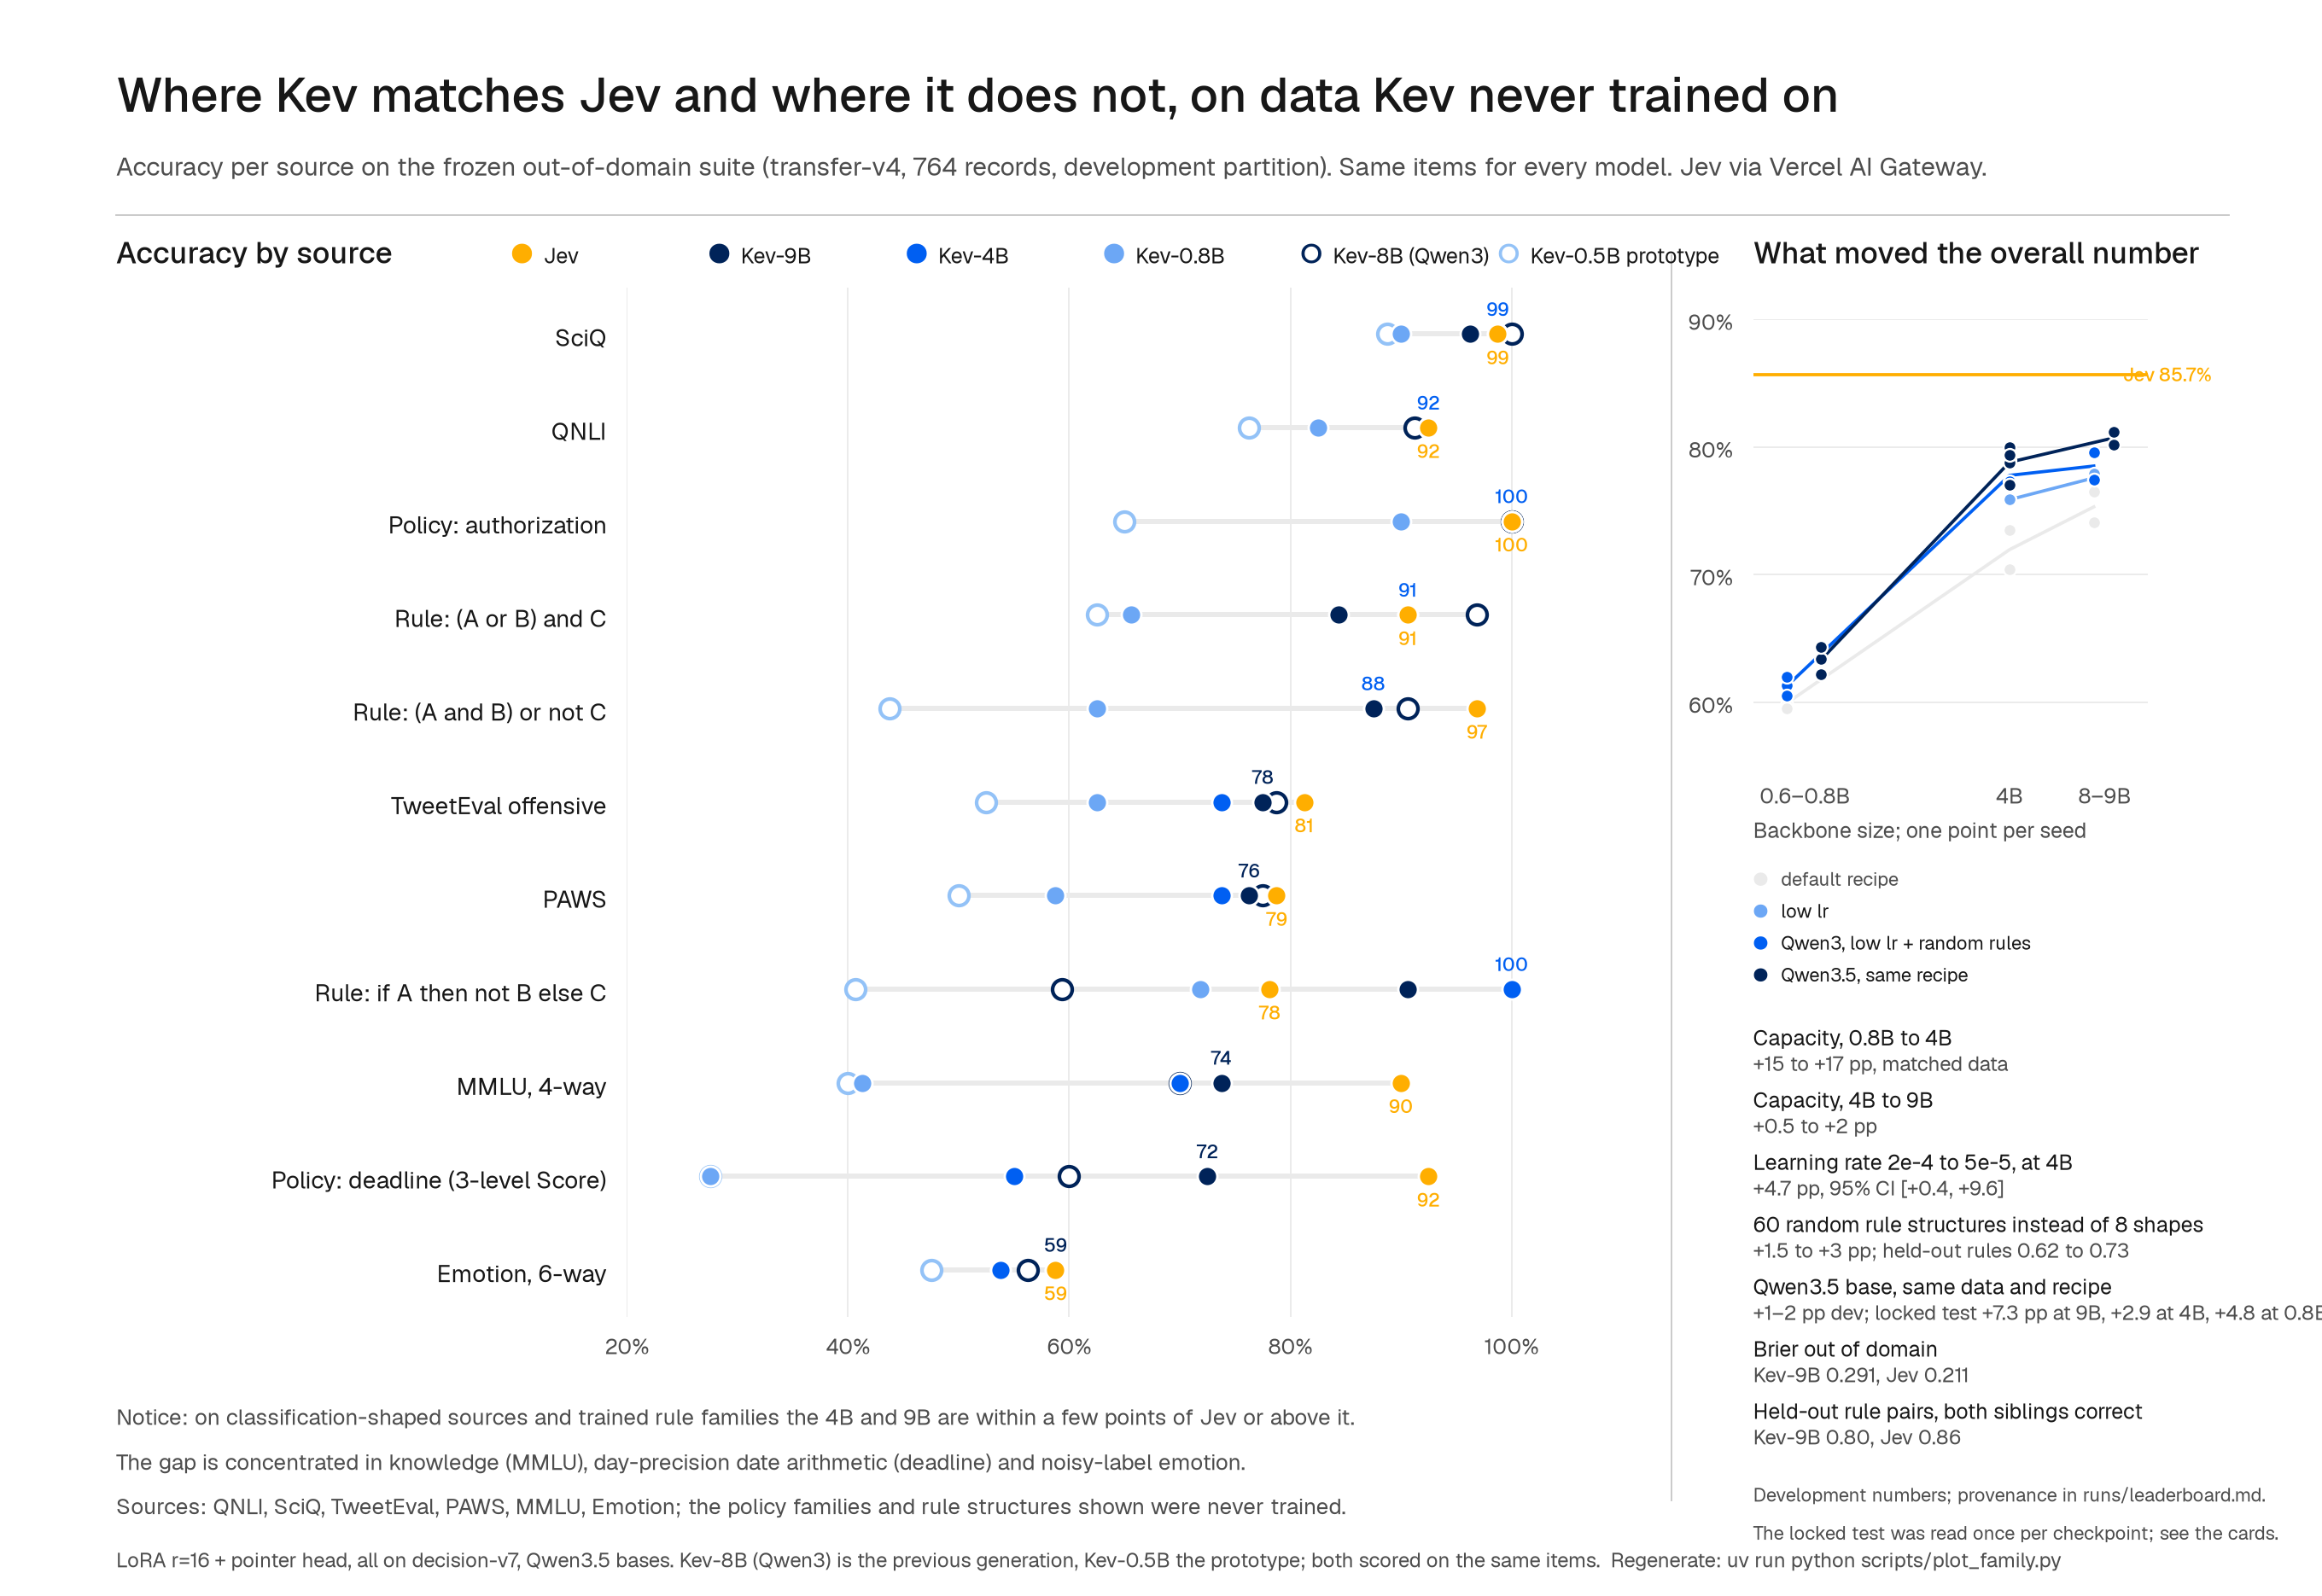
精度。 Kev-27B は、下のチャートの新規ソース 11 カテゴリのうち 9 つで、Jev まで 3 ポイント以内か、それより上です。Kev-4B と Kev-9B は、ルーティング、含意、科学の質問のような分類形のソースで同程度に近いです。知識の質問は主にベースモデルが決めます: MMLU で Kev-9B は 0.73、Kev-27B は Jev と並んで 0.90 ですが、より難しい MMLU-Pro では Kev-27B は 0.675 で Jev の 0.840 に対してです。小さいモデルは日単位精度の日付演算でも劣ります。
信頼度。 各チェックポイントはフィット済みの温度を同梱するので、その確率は既定で較正されています。提供されたままでは、Kev-9B は新規ソースの質問の 2.4% で、誤った答えに少なくとも 0.9 の確率を置きます。Jev は 3.7% です。Jev はまだ答えの順位付けが上手です: 5% の誤り予算で、Kev-4B、9B、27B は新規ソース決定の 0.52–0.69 を自動化でき、Kev-0.8B は 0.14、Jev は 0.70 です。頼る前に自分のデータでしきい値を確認してください。
速度。 Kev-4B は、新しい短いテキストについての 6 つの質問に、H100 で 18.1 ms、L40S で 41.5 ms のモデル時間で答え、コンテナは H100 で毎秒約 101 リクエストを提供します。Apple M5 では、Kev-4B は 5 つの質問に 721 ms、テキストが繰り返しでキャッシュから来る場合は 136 ms です。Serving Performance にすべての GPU とバッチサイズがあります。
長さ。 Kev-0.8B、4B、9B は主に最大 384 トークンの状態で訓練され、より長いものが文書とスキルのファインチューニングにあります(最大 7,552 トークン)。Kev-27B は最大 32,768 の状態で訓練されました。サーバーは最大 65,536 トークンの状態と、質問ごとにさらに 8,192 を受け付け、より長いものは切るのではなく 422 で拒否します。各モデルが訓練長を超えてどこまで精度を保つかが、Models の「検証済みコンテキスト」列です。Kev-0.8B、4B、9B ではそれは 8,192 トークンです: 16k では実契約での測定が 3 ポイント超の低下を排除できなくなり、32k では 3 つとも 8k より測定可能なほど不正確です。Kev-27B は 65,536 トークン上限まで保ちます。最大 64k トークンの実契約(CUAD)で Kev-27B は 0.874 を記録し、そこでの信頼度は短いテキストより信頼できません。長さごとの数値はモデルカードにあります。
プレイグラウンド
サーバーを実行したまま、別のターミナルを開いてください。Node 20.9+ が必要です:
cd playground
npm install
npm run dev -- -p 3001
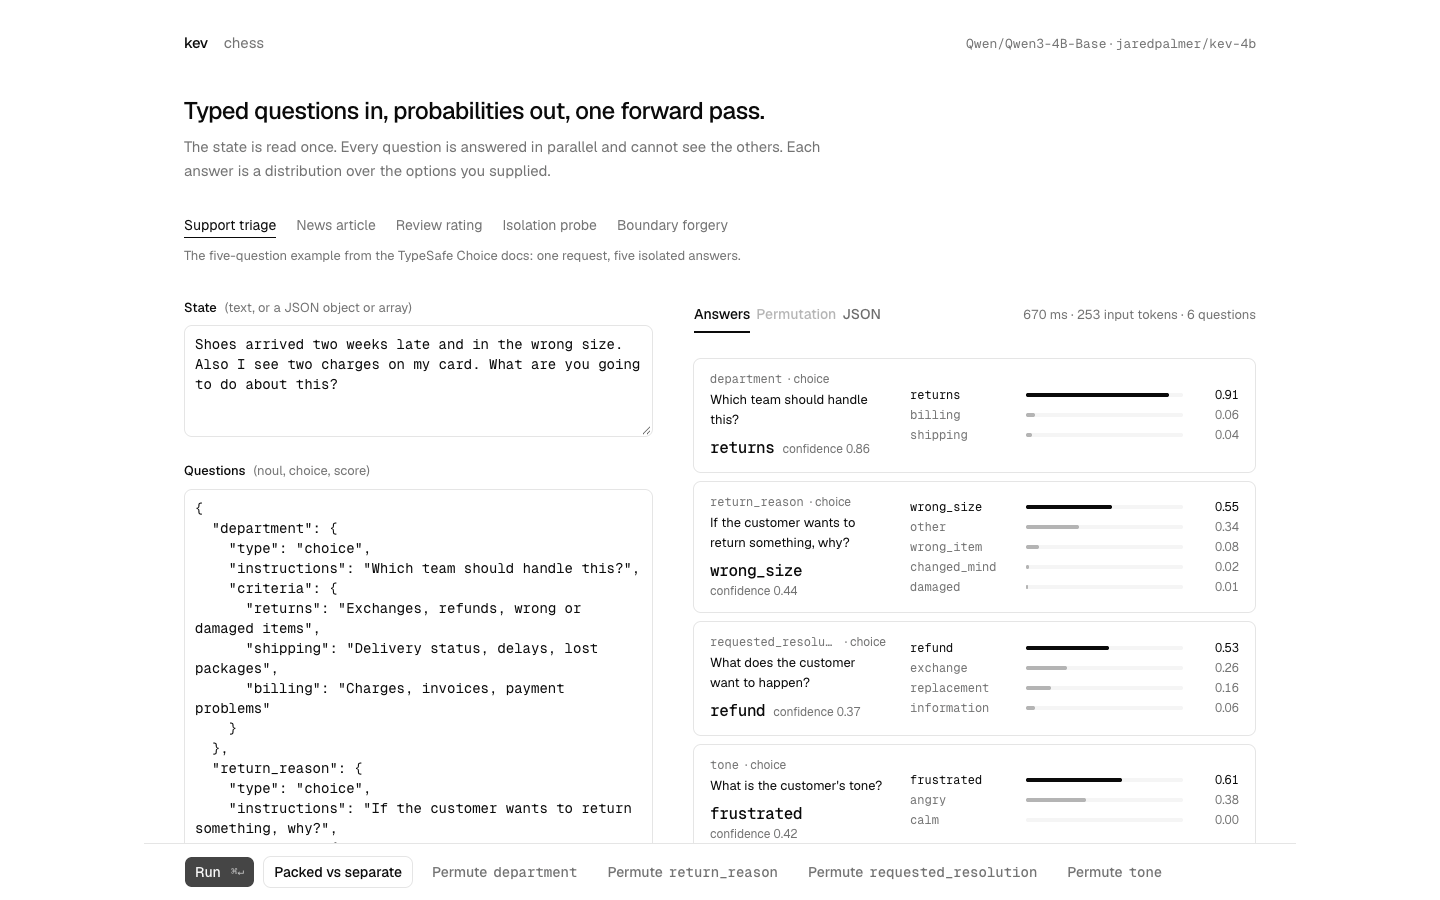
localhost:3001 を開き、プリセットを読み込み、テキストと質問を編集してください。⌘↵ を押すと実行します。「Packed vs separate」は、すべての質問を一度に尋ねるのと 1 つずつ尋ねるのを比較します。「Permute」は 6 つの選択肢順序で Choice 質問を実行します。質問の独立性と偽の区切り文字トークンをテストするプリセットもあります。
チェスのデモもあります。盤面が入力で、合法手が Choice の選択肢、Score 質問が局面を評価します。Kev と対局するか、それ自身に指させられます。ゲームは localStorage に保存されます。
API
POST /v1/systemone
state は評価するテキストです。各質問は instructions を持ち、必要に応じて選ぶ答えの集合を持ちます。
{
  "state": "…",                          // string | object | array — the content to evaluate
  "model": "kev-latest",
  "questions": {
    "<id>": {                            // you choose the id; the model never sees it
      "type": "noul" | "choice" | "score",
      "instructions": "…",               // string | object | array, optional
      "criteria": …                      // noul: {true?, false?}  choice: {option: description|null}  score: [level, …]
    }
  }
}| 種別 | 条件 | 答え |
|---|---|---|
noul |
true と false の任意の説明 |
noul: はいの確率 |
choice |
1–255 の選択肢名、それぞれ説明か null 付き |
choice: 最も可能性の高い選択肢。probabilities と confidence |
score |
1–255 の説明、低い順から高い順 | score: 平均段階指数(0 から始まる)。legend、probabilities、confidence |
K > 1 個の選択肢を持つ Choice では、confidence は (p_max − 1/K) / (1 − 1/K) です。選択肢が 1 つなら confidence は 1 です。Score の confidence は max(0, 1 − E|level − mode| / D) です: mode は最も可能性の高い段階で、D は段階上の一様分布の中央からの平均距離です(3 段階なら 2/3)。したがって 1 つの段階にすべての確率が乗れば 1、一様かそれより広がれば 0 です。どちらの式も TypeSafe の参照アダプタ(system-one-adapter 0.2.1)のものです。どちらのフィールドも測定された精度率ではありません。
オブジェクトと配列はラベル付きテキストに変換されます。ユーザー入力中の区切り文字に似た文字列は、トークン化の前にエスケープされます。無効なリクエストは 422 を返し、65,536 トークンを超える状態も同様です: サーバーは文書の一部を無言で捨てることはなく、エラーはその状態のトークン数と上限を与えます。usage.output_tokens は、生成されたトークンではなく、シリアライズされた答えのトークンを数えます。
| メソッド | パス | 用途 |
|---|---|---|
GET |
/v1/models |
モデルカード(name、description、release_date)と読み込み済みチェックポイントの詳細 |
POST |
/v1/systemone/permute |
1 つの Choice 質問を異なる選択肢順序で実行(n_perm は 1 から 64、既定 6) |
POST |
/v1/systemone/separate |
各質問をそれぞれのフォワードパスで実行 |
リクエストは任意の数の質問を運べます。サーバーはそれらをトークン予算ごとに実行するので(1 フォワードパスあたり最大 16,384 トークンの 1 行で、そのパスで質問ごとにキャッシュ済み文書を 1 回数えます)、メモリは質問数とともに増えず、答えは分割に依存しません。すべての応答は x-typesafe-request-id ヘッダーを持ちます。サーバーは 127.0.0.1 にバインドし(他のマシンを受け入れるには --host 0.0.0.0)、既定で開いています。TypeSafe クライアントが常に送るように /v1/* で Authorization: Bearer <key> を要求するには KEV_API_KEY を設定してください。
| 変数 | 効果 |
|---|---|
KEV_TEMPERATURE=1.0 |
較正された確率ではなく生の確率を返す |
KEV_DATE_FACTS=1 |
状態内の任意の 2 つの日付の間の日数を追加する(Benchmarks を参照) |
KEV_TRUNCATE_STATES=1 |
より長い状態を拒否する代わりに最初の 65,536 トークンを読む。すべての応答が truncated と usage.state_tokens / state_tokens_used を持つ |
KEV_DTYPE=fp32 |
評価が使う正確な fp32 経路を提供する(GPU では bf16 が既定) |
KEV_API_KEY |
ベアラキーを要求する |
仕組み
各チェックポイントは、Qwen ベースモデル上のランク 16 の LoRA アダプタと小さなポインタヘッドです。attention のみのベース(Qwen3)では、状態と質問が 1 つのトークン列に入ります:
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
attention マスクにより、トークンは状態と自分の質問を読めますが、他の質問や未来のトークンは読めません。各質問の位置 ID は状態の直後で再開します。これにより、モデルは状態を一度だけ処理し、各質問に独立に答えられます。
Qwen3.5 と Qwen3.8 は attention 層と Gated DeltaNet 層を混ぜており、後者はリカレントで attention マスクを無視します。それらのモデル(現行のすべての Kev)では、各質問は自分の行として実行されます: 状態の後にその質問が続き、位置は上と同じです。行は独立なので、独立性は正確で、サーバーと DecisionModel.probs() は状態を一度だけ計算し、そのキャッシュをすべての行で再利用します。kev.benchmark が採点し、公表されたすべての数値の出所である forward() は、素の行を保ち、質問ごとに状態を一度実行します。両者は fp32 の丸めまで一致します。attention のみのモデルでは、行と上のマスクは同一の確率を与えます(tests/test_model.py)。
Kev-27B は Qwen/Qwen3.8-27B で同じ設計を使い、2 点だけ違います。そのベースは -Base チェックポイントではなく Qwen の post-trained リリースで、何で post-train されたかは分かっていません。そしてアダプタだけでなく、すべてのバックボーンの重みが訓練され、bf16 で保たれるので、チェックポイントはモデル全体です: 51 GB の bf16 重みとポインタヘッド。bf16 でのみ提供され(提供バッファを含めて約 66 GB 常駐)、だから 80 GB のカードが必要です。Apple Silicon では MLX バックエンドがそれらの重みをそのまま読み込み、マージしません(Serving Performance を参照)。96–128 GB の Mac に収まると見込まれますが、測定はしていません。提供時の確率は、H200 で評価経路から 0.022 以内に収まります(runs/serving-27b-r23)。
ポインタヘッドは、各選択肢の </opt> 隠れ状態を、質問の <decide> 隠れ状態に対して採点します。softmax がそれらのスコアを確率に変えます。<decide> が最後に来るので、選択肢リスト全体に attend できます。
訓練は正解に対する交差エントロピーを使います。アダプタとヘッドは一緒に訓練され、残りのベース重みは固定されます(Kev-27B はすべてを訓練します)。訓練例と API リクエストは同じテキスト形式を使います。訓練に Jev の出力は使用していません。
質問を一緒に尋ねても分けて尋ねても、fp32 テストでは 4e-6 以内の確率になります。これは選択肢の順序が無関係であることを意味しません: 質問内の選択肢は依然として互いに影響し合えます。モデルコードとパリティテストを参照してください。
訓練
リリースされたモデルは、1 つのベース訓練セット decision-v7 を共有します: 10 の公開データセットからの 10,000 例、生成されたポリシー例 896、生成されたルール構造 60 件からの例 1,680 です。Kev-0.8B、4B、9B はそれを 2 エポック、LoRA ランク 16 と交差エントロピーで訓練します。学習率は 0.8B が 1e-4、4B と 9B が 5e-5 です。これらのハイブリッドベースでは、アダプタが attention、MLP、DeltaNet の射影を覆います。kev.train はモデル設定から適切な対象を選びます。
Kev-0.8B、4B、9B はその後、リリースされたチェックポイントから短い後続のファインチューニングを受けます。自分のデータに使うのと同じ --init_from 経路を通ります: 日数を述べた、あるいは決め手の証拠を除いた生成ケース(3 つとも)、その後、実文書と生成スキルデータ(3 つとも。Kev-9B は v2 以降、2026-09-30)。Kev-27B は違うふうに訓練されます。ベースのすべての重みが、145,840 レコードのコーパスで 8 台の H200 上 1 エポックファインチューニングされます(--full_ft 1、学習率 2e-6): Kev 自身のデータ、文書・スキル・開発者ツールのスイート、公開データセット、ライセンス済みタスクファミリー、そして生成された長文書・ツールルーティング・エージェントログ・ガードレールのレコードで、状態は最大 32,768 トークン。その結果はその後、以前のアダプタ訓練済み Kev-27B と 0.85 対 0.15 で平均されます。モデルカードに各段階がそのデータとコストとともに挙げられています。
# sanity run, ~1 minute
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# the first stage of Kev-0.8B (~20 min on one H100; the Mac path works but is slow for Qwen3.5 bases)
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base --base_revision dc7cdfe2ee4154fa7e30f5b51ca41bfa40174e68 \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b

# the first stage of Kev-4B (one H100 via Modal, ~1 h; see below). Swap in Qwen/Qwen3-4B-Base for the previous generation.
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base --base_revision 1001bb4d826a52d1f399e183466143f4da7b741b \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
すべての訓練オプションには uv run python -m kev.train --help を使ってください。リリースされたモデルは省略可能な --perm_kl や --ord_w の損失を使いません。PLAN.md に何を試し、何が効き、何が効かなかったかが記録されています。
Modal
各トライアルは自分の H100 を持ちます。研究は切断しても走り続け、終わったら結果をダウンロードできます:
uv run modal token new                                    # once; opens the browser
KEV_GPU=T4 uv run modal run modal_app.py::smoke           # end-to-end check, ~1 minute of GPU

uv run modal deploy modal_app.py                          # once; studies run on the deployed app and survive disconnects
uv run modal run modal_app.py::study \
    --suite evals/v7/decision-v7 --plan experiments/v7-final.json \
    --name my-study --transfer evals/v4/transfer-v4 --budget 30 --timeout 7200
uv run modal run modal_app.py::pull --name my-study # results -> runs/my-study, ranked研究計画は訓練設定を列挙します。各トライアルは設定、コードハッシュ、データセットハッシュ、結果を保存します。ロック済みテストではなく、開発結果を使ってモデルを選んでください。最終候補を選んだ後、そのテスト結果を一度だけ読めます:
uv run modal run modal_app.py::locked_test --trial my-study/00-trial-0 --name my-candidate # one read, everベンチマーク
evals/ の下の評価データは凍結されています: データセットのバージョンとファイルのチェックサムが各 manifest に記録されています。大きいファイルは Hub ミラーからダウンロードされ、それらのハッシュと照合されます。上の表のどのモデルも同じ項目で採点されます。この README とモデルカードの数値は、CI で、その出所であるコミット済みレポート(docs/claims.json、uv run python scripts/verify_claims.py)と照合されます。
| スイート | 測るもの |
|---|---|
decision-v7 |
10 の訓練データセット、生成ポリシー、ルール構造からのホールドアウト例(「訓練済みソース」) |
transfer-v4 |
Kev が一度も訓練していないデータセットとポリシー・ルール種別からの 764 レコード: QNLI、SciQ、PAWS、MMLU、Emotion、TweetEval、ホールドアウトのポリシーとルール(「新規ソース」) |
transfer-v9 |
transfer-v4 に、10 択の MMLU-Pro、無関係なテキストに埋もれたレコード、決め手の証拠を除いた「知りようのない」レコードを加えたもの |
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v4/transfer-v4 --out runs/my-eval      # new sources
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v9/transfer-v9 --out runs/my-eval-v9   # + MMLU-Pro, buried states, unknowable items
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v7/decision-v7 --out runs/my-eval-id   # trained sources
uv run python -m kev.benchmark --remote http://127.0.0.1:8009 --suite evals/v4/transfer-v4 --out runs/my-remote   # any System One endpoint, Jev included
これらのコマンドは開発データを使います。テストデータには --allow-test が必要です。ベンチマークは、精度、Brier スコア、較正誤差、5% の誤り予算で自動化できる決定の割合、選択肢順序の変化、質問独立性を報告します。知りようのないレコードでは、モデルがなお 0.9 以上の確信で答える頻度を報告します(Kev-9B 0%、Jev 9%)。公表された精度数値は fp32 評価を使い、bf16 の提供経路ではありません。kev.jev は Vercel AI Gateway 経由で同じ質問を Jev に対して実行し、kev.compare は 2 つの保存済み実行をペア付きブートストラップ信頼区間で比較します。
較正。 各チェックポイントは温度を保存し、モデルの読み込み時にポインタヘッドがそれを適用します。Kev-4B(2.41)と Kev-0.8B(2.35)は自分の分布内開発セットでフィットしました。Kev-27B(1.32)と Kev-9B(2.19)は、一度も訓練していないホールドアウトデータセットでフィットしました。2 つの小さいモデルをそれらのホールドアウトデータセットで再フィットすることを試しましたが、どちらも採用しませんでした: Kev-4B を改善せず、Kev-0.8B をその文書とスキルのスイートで較正悪化させました(数値はモデルカードにあります)。温度はどの答えが勝つかは決して変えません。新規ソースでは、Kev-9B の較正誤差を 0.103 から 0.041 に、確信ある誤り(確率 ≥ 0.9 の誤答)を 8.2% から 2.4% にし、Jev の 3.7% を下回ります。上の精度数値はどちらでも同じです。Brier の数値は生の確率に対するものです。scripts/calibrate_checkpoint.py はアウトオブフォールド推定も報告するので、インサンプルのフィットを、それが見なかったレコードと照合できます。
日付。 Kev は日付を確実には引き算できませんが、与えられた日数は使えます。KEV_DATE_FACTS=1 は、状態内の日付の各ペアにつき 1 文を追加します(「June 26, 2026 is 8 days before July 4, 2026」)。deadline ポリシーの質問では、これが Kev-9B を 0.80 から 0.90 にします(Jev 0.93)。どの表もこれを使っていません。
他人のテストセット。 evals/external/ には他プロジェクトのテストセットが、この形式に変換され、公表されたライブ Jev 結果とともに置かれています。いくつかは以前のバージョンの Kev 重みで採点されており、それを Kev 列が名指しします。3 つはゲートとして使えないため削除され、モデルカードはそれらのリリースが判断の根拠とした数値を保っています: scienthoon の合成サポートチケット(2026-09-27、テンプレート化されたテキスト。3 つの質問のうち 1 つはテキストが述べていないルールに依存します)、そして 2026-09-30 の WANLI(wanli-v1、wanli-v2: ペアの 4 分の 1 は WANLI の 2 人の注釈者が別々にラベル付けしたもので、gold はその一方に設定)と TypeSafe の公開 eval(typesafe-v1: gold は 2 つのクローズドなフロンティアモデルの平均回答で、89 の質問ではチェックポイントを区別できません)。
| スイート | 内容 | Jev | Kev |
|---|---|---|---|
| SemIf | 著者作成の 144 の決定 | 0.965 | 0.917(v7-base の Kev-9B) |
SemIf のラベルは持ちこたえますが、飽和に近いです: すべての Kev-27B チェックポイントが 144 のうち 130 に正しく答えるので、これは健全性チェックであり、モデルを順位付ける方法ではありません。
提供パフォーマンス
モデルごとに GPU を選んでください:
| モデル | GPU ($/h) | 6 問、短いテキスト | 5 問、2,200 トークンのテキスト | リクエスト/秒、64 クライアント |
|---|---|---|---|---|
| Kev-0.8B | L4 (0.80) | 22.7 / 16.1 ms | 108.6 / 32.3 ms | 62.8 |
| Kev-4B | L40S (1.95) | 41.5 / 27.7 ms | 145.2 / 43.0 ms | 51.4 |
| Kev-4B | H100 (3.95) | 18.1 / 12.9 ms | 89.4 / 22.5 ms | 100.8 |
| Kev-9B | L40S (1.95) | 66.4 / 42.7 ms | 235.6 / 57.5 ms | 32.7 |
| Kev-9B | H100 (3.95) | 24.0 / 16.6 ms | 88.5 / 26.4 ms | 79.5 |
| Kev-27B | B200 (6.25) | 46.5 / 32.2 ms | 178.0 / 52.1 ms | 44.2 |
| Kev-27B | H200 (4.54) | 67.2 / 50.0 ms | 274.8 / 73.8 ms | 28.6 |
| Kev-27B | H100 (3.95) | 75.0 / 52.0 ms | 277.5 / 79.3 ms | 28.9 |
時間はリクエストあたりのモデル時間(API が返す latency_ms)で、20 回の中央値、新しいテキスト / 同じテキストをもう一度、です。サーバーはテキストをキャッシュするので、すでに送った文書についてさらに質問すると、質問の分だけ払います。リクエスト/秒は、64 の同時クライアントが新しい短いテキストについて 6 問ずつ送る場合です。サーバーはそれらをまとめます。Kev-27B の B200 と H100 の行は、その以前のバージョン(同じアーキテクチャを bf16 で提供、runs/fused-27b-*)で測定しました。H200 の行が現行チェックポイントです(runs/serving-27b-r23)。ネットワーク時間は別です: 同じリージョンの Modal web エンドポイント経由で往復あたり約 65 ms。
L4 は Kev-0.8B には十分ですが Kev-4B には遅すぎます。A100 はここでは L40S より遅く、コストは高いです。Kev-9B は約 17 GB の GPU メモリを、Kev-27B は 51 GB の重み(バッチングバッファ込みで約 66 GB)を必要とします。負荷時、Kev-27B は計算律速で、B200、H200、H100 はリクエストあたりほぼ同じコストです。CUDA では、Qwen3.5 モデル用に flash-linear-attention をインストールしてください(kev_serve.py と Modal イメージはすでにそうしています)。
Apple Silicon では、uv sync --extra serve が MLX をインストールし、サーバーが自動でそれを使います。M5(32 GB)で約 270 トークンのテキストについての 5 問:
| モデル | 新しいテキスト | 同じテキストをもう一度 |
|---|---|---|
| Kev-0.8B | 149 ms | 28 ms |
| Kev-4B | 721 ms | 136 ms |
長い文書はキャッシュに 1,024 トークンずつ読まれるので、メモリは重みに近いままです。65,000 トークンの文書で、Kev-0.8B は最初が 21.2 秒、その後が 202 ms で、ピーク 3.8 GB。Kev-4B は 84.5 秒と 716 ms で 13.0 GB です(runs/mlx-long-states。長さごとの数値はモデルカードにあります)。Kev-9B はこの方法ではまだ測定されていません。
アダプタのチェックポイントは読み込み時にベースに畳み込まれるので、一時的に重みのコピーをもう 1 つ持ちます。Kev-27B のような完全重みチェックポイントは保存されたまま読み込まれ、何もマージされないので、読み込みには重みだけが必要です。これを Kev-4B を完全な bf16 重みとして書き出して確認しました: 読み込みのピークは 8.4 GB の重みに対して 8.4 GB で、アダプタ経路の 15.9 GB に対してです。その答えは、両者が同じ bf16 値を持つときアダプタ経路と完全に一致し、60 の質問で fp32 経路から 0.015 以内にとどまりました(runs/mlx-full-4b)。Kev-27B の重みは 51 GB です。同じ測定から、約 51 GB と作業メモリが必要なので、64 GB の Mac はぎりぎりで、96–128 GB の Mac なら収まるはずです。その大きさの Mac ではまだ実行していません。Kev-27B の最初のバージョン(アダプタ)は、128 GB の M5 Max でこの方法で実際に動き、公表された精度に一致しました(Sean Connelly に感謝、#175)。
サーバーは GPU と Mac で bf16 で動きます。その確率は、公表された評価が使う fp32 経路と、GPU で最大約 0.03、Mac で 0.05 異なり、最上位の答えは約 300 問に 1 問変わります。正確な経路には KEV_DTYPE=fp32 を設定してください。/v1/models は使用中のバックエンドと精度を報告します。uv run modal run modal_app.py::serving --run jaredpalmer/kev-4b --gpu L40S --name <name> は自分のアカウントで表の 1 行を測定します(上の行: runs/serve-*、runs/grouping-4b-h100、runs/fused-27b-*、runs/serving-27b-r23)。
限界
- 較正は 1 つの温度です。信頼度を並べ替えられないので、5% の誤り予算で自動化できる新規ソース決定の割合(Kev-4B、9B、27B で 0.52–0.69)は、なお Jev の 0.70 を下回ります。頼る前に自分のデータで確率のしきい値を試してください。
- 知識の質問はベースモデルが決めます。MMLU は Kev-9B で 0.73、Jev の 0.90 に対して。MMLU-Pro は 0.59 対 0.84 です。
- ファインチューニングは、個々のタスクでベースモデルを悪化させうる。日付演算が最も明確な例でした(issue #8)。述べられた日数での訓練に
KEV_DATE_FACTS=1を加えると回復します。 - 選択肢の順序を変えると答えが変わりうる。質問独立性はこれを防ぎません。
- Kev-0.8B、4B、9B は主に最大 384 の状態トークン、状態と 1 つの質問で 1,024 トークン(文書とスキルのファインチューニングでは最大 7,552 トークンの状態)で訓練され、Kev-27B は最大 32,768 トークンの状態で訓練されました。提供は 65,536 トークンの状態を許します。各モデルの検証済みコンテキスト長は Models にあります。
- Mac では、答えは数十ではなく数百ミリ秒かかります。Kev-27B は 80 GB の GPU を必要とします。Mac では約 51 GB と作業メモリが必要です。96–128 GB の Mac なら収まると見込まれますが、測定はしていません。
- Kev-27B は、訓練データが分からない post-trained モデルから始まります。
開発
uv run --extra serve python -m pytest tests/test_unit.py tests/test_research.py tests/test_generators.py tests/test_conventions.py \
    tests/test_documents_tools.py tests/test_hard_v1.py tests/test_devtools_v1.py tests/test_breadth_v1.py tests/test_rounds.py tests/test_skill_scripts.py -q   # no weights, no server; what CI runs
KEV_BASE_URL=http://127.0.0.1:8009 uv run --extra serve python -m pytest tests/test_api.py -q   # against a running server
cd playground && npm run lint && npx next typegen && npx tsc --noEmit -p .
API テストは、TypeSafe のサンプルリクエストと公式 SDK をローカルサーバーに対して実行します。PLAN.md は研究計画です: 何を学んだか、すべての実験が従うルール、ラウンドごとに 1 行。完全なログ(すべての実験、実行前に設定した基準、そしてその結果)は git タグ research-archive-2026-09-24 にあります。
前世代(Qwen3)とプロトタイプ
最初の Kev ファミリーは Qwen3 ベースを、同じデータと設定で使いました。それらの重みは公開されたままで、Mac 上の素の PyTorch で動きますが、もう開発されていません。
| モデル | ベース | 精度: 訓練済みソース | 精度: 新規ソース | Brier: 新規ソース | モデルカード |
|---|---|---|---|---|---|
Kev-0.6B (Qwen3) — jaredpalmer/kev-0.6b |
Qwen3-0.6B-Base | 0.801 / 0.808 | 0.620 / 0.642 | 0.536 / 0.483 | 詳細 |
Kev-4B (Qwen3) — jaredpalmer/kev-4b@qwen3 |
Qwen3-4B-Base | 0.854 / 0.856 | 0.790 / 0.806 | 0.328 / 0.294 | 詳細 |
Kev-8B (Qwen3) — jaredpalmer/kev-8b |
Qwen3-8B-Base | 0.863 / 0.870 | 0.796 / 0.780 | 0.337 / 0.327 | 詳細 |
元の Kev-0.5B は Qwen2.5-0.5B を使い、参照用に残されています。そのモデルカードを参照してください。
トラブルシューティング
- 訓練中に MPS がメモリを使い果たすなら、ジョブを 1 つだけ実行しているか確認してください。
output_hidden_statesを有効にしたり、peft のtrainable_token_indicesでトークンを足したりしないでください。どちらもここでメモリ問題を起こしたことがあります。 - プレイグラウンドは読み込めるのにボタンが動かないなら、
localhost:3001を使ってください。Next.js は開発ホスト名を検査します。他のホストはplayground/next.config.tsのallowedDevOriginsにエントリが必要です。 - データセットの読み込みが
Dataset scripts are no longer supportedを報告するなら、legacy-datasets/banking77を使ってください。このリポジトリはすでにそうしています。
著者
- Jared Palmer(@jaredpalmer)
Devin で構築。アーキテクチャの記事に Archer Hume、API 設計に TypeSafe、ベースモデルに Qwen に感謝します。
ライセンス
Apache-2.0。Qwen3、Qwen3.5、Qwen3.8 のベースモデルも Apache-2.0 です。訓練データセットはそれぞれ独自のライセンスを持ちます。モデルカードを参照してください。