Небольшие модели принятия решений в духе Jev, которые можно обучать и запускать самостоятельно.
Kev — это семейство небольших моделей принятия решений, построенных на Qwen3.5 и Qwen3.8 и основанных на архитектуре, описанной в Jev’s Architecture Unmasked. Можно использовать предобученные веса или обучить собственные. API совпадает с System One от TypeSafe, поэтому их Python SDK можно направить на ваш локальный сервер.
Ключевые особенности
- Вопросы да/нет (
noul), с выбором из нескольких вариантов (choice) и оценкой (score) в одном запросе. Вопросы делят текст, но не могут читать друг друга. - Калиброванные вероятности по умолчанию: каждый чекпойнт поставляется с подогнанной температурой.
- Замена Jev без изменений кода: TypeSafe Python SDK работает с сервером Kev без изменений.
- Четыре размера, версионированные вместе как Kev 1.0: от 0.8B, работающей на ноутбуке, до 27B для одной GPU дата-центра.
- Документы до 65 536 токенов, на CUDA и на Apple Silicon через MLX. Каждая карточка модели говорит, насколько длинным может стать документ, прежде чем точность упадёт.
- Дообучение на собственных размеченных примерах. Навык coding-agent прогоняет весь цикл на Modal — от поиска ваших вопросов до обслуживания результата.
- Разверните собственный HTTPS-эндпоинт одной командой. В простое он масштабируется до нуля.
- Сначала попробуйте в браузере: huggingface.co/spaces/jaredpalmer/kev.
Модели
Начните с Kev-4B. Переходите на Kev-9B, если у вас больше GPU, или на Kev-27B, если у вас GPU на 80 ГБ и вы хотите самый точный Kev. Используйте Kev-0.8B, когда размер важнее точности.
| Модель | База (лицензия) | Работает на: CUDA | Работает на: Mac (MLX) | Проверенный контекст | Отложенные наборы данных: индекс | Карточка |
|---|---|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base (Apache-2.0) | L4, любая GPU на 4 ГБ | Любой Apple Silicon Mac; измерено до 65k токенов | 8 192 | 23.3 | Подробнее |
| Kev-4B | Qwen3.5-4B-Base (Apache-2.0) | L40S, H100 | 32 ГБ Mac; измерено до 65k токенов | 8 192 | 38.0 | Подробнее |
| Kev-9B | Qwen3.5-9B-Base (Apache-2.0) | L40S, H100 | 32 ГБ Mac или больше (ожидается, не измерено) | 8 192 | 41.0 | Подробнее |
| Kev-27B | Qwen3.8-27B, после дообучения (Apache-2.0) | B200, H200, H100 80 ГБ | 96–128 ГБ Mac (ожидается, не измерено) | 65 536 | 52.3 | Подробнее |
| Jev | Хостируется | API от TypeSafe | – | – | 54.0 | – |
«Отложенные наборы данных» — это индекс со случайной поправкой из community Decision Index, оценённый на тестовом сплите breadth-v1: 14 публичных наборов данных в пяти областях, на которых ни один Kev не обучался. «Проверенный контекст» — это самый длинный документ в токенах, на котором точность на реальных контрактах (CUAD) остаётся в пределах 3 пунктов от точности той же модели при 8k токенов, при 95 % нижней границе; каждая карточка модели содержит измерение по длине.
| Модель | Точность: новые источники | Точность: обученные источники | Brier: новые источники |
|---|---|---|---|
| Kev-0.8B | 0.648 / 0.697 | 0.827 / 0.838 | 0.481 / 0.416 |
| Kev-4B | 0.817 / 0.838 | 0.873 / 0.865 | 0.269 / 0.242 |
| Kev-9B | 0.820 / 0.852 | 0.874 / 0.873 | 0.289 / 0.217 |
| Kev-27B | 0.851 / 0.889 | 0.865 / 0.866 | 0.225 / 0.156 |
| Jev | 0.857 / – | 0.845 / – | 0.211 / – |
Каждая ячейка — это разработка / тест. «Новые источники» означают наборы данных и правила политик, которых Kev никогда не видел при обучении. Это здесь самое близкое к вашим собственным вопросам. «Обученные источники» — это отложенные примеры из наборов данных, на которых обучался Kev. Мы выбираем чекпойнты по девелоперским наборам и читаем каждый тестовый набор только один раз на выпущенную модель. Jev запускался только на девелоперских наборах этих двух наборов. Brier оценивает всё распределение вероятностей, а не только верхний ответ; меньше — лучше.
На новых источниках Kev-27B отстаёт от Jev в пределах пункта (0.851 против 0.857), а Kev-4B и Kev-9B — в пределах четырёх пунктов. Мы не знаем, на чём обучался Jev, так что это не контролируемое сравнение двух архитектур. Что ожидать говорит, где Kev так же хорош, как Jev, а где нет.
Kev-0.8B, 4B и 9B стартуют с базовых моделей Qwen и делят один рецепт обучения: небольшой адаптер на замороженной базе. Kev-27B стартует с релиза Qwen после дообучения, и мы не знаем, на чём он обучался; каждый его вес дообучен, поэтому он поставляется как 51 ГБ полных весов, а не адаптер. Каждая карточка модели содержит полный рецепт, все результаты и более ранние версии, сохранённые как теги Hub.
Kev 1.0
Четыре модели выше выпущены вместе как Kev 1.0. В каждом репозитории Hub есть тег v1.0, поэтому --run jaredpalmer/kev-4b@v1.0 всегда загружает одни и те же веса, а в GitHub-релизе kev-1.0 лежат чекпойнты 0.8B, 4B и 9B с контрольными суммами SHA-256. 51 ГБ весов Kev-27B слишком велики для ассета релиза и находятся только на Hub.
| Модель | Ревизия весов на Hub | Температура | Обучен на состояниях до |
|---|---|---|---|
| Kev-0.8B | 9a45d25e |
2.35 | 7 552 токена |
| Kev-4B | 139fdd94 |
2.41 | 7 552 токена |
| Kev-9B | b5d8c18e (v2) |
2.19 | 7 552 токена |
| Kev-27B | 28be62e9 (v2, полные веса) |
1.32 | 32 768 токенов |
Kev 1.0 не обучает ничего нового. Он фиксирует чекпойнты, карточки, оценочные наборы и код обслуживания, с которыми будет сравниваться следующее поколение Kev. Заметки о релизе перечисляют, что изменилось с прошлого релиза семейства и что, как известно, работает плохо.
Быстрый старт
Попробовать в браузере
Hugging Face Space запускает Kev-4B и Kev-0.8B, ничего устанавливать не нужно.
Запустить локально
Вам понадобятся Python 3.12 или 3.13 и uv. Файл .python-version репозитория заставляет uv sync использовать 3.13; для torch ещё нет колёс под 3.14.
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
Это запускает Kev-4B на вашей машине: CUDA или ROCm, если у вас есть GPU, MLX на Apple Silicon. Первый запуск скачивает адаптер и базовую модель. --run также принимает каталог локального чекпойнта или ревизию Hub вроде jaredpalmer/kev-4b@qwen3.
В другом терминале отправьте ему тикет:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
Пример ответа от Kev-4B, работающей в bf16 на Apple M5:
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.34,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
}
Тикет упоминает возврат, позднюю доставку и проблему с оплатой, и вероятности отдела говорят об этом. Вот почему Kev возвращает вероятности, а не одну метку: ваш код может маршрутизировать уверенные случаи, а остальные отправить человеку.
Использовать из Python
Если вы уже вызываете Jev, направьте клиент на Kev и оставьте остальной код. TypeSafe SDK входит в uv sync --extra serve:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
Дообучение на собственных данных
Выпущенные модели обучались на публичных наборах данных и сгенерированных примерах политик. Если ваши вопросы выглядят иначе — например, собственные категории маршрутизации, собственные правила эскалации или другой язык, — короткое дообучение обычно помогает больше, чем любое изменение промпта. Оно также подгоняет температуру под ваши данные, так что уверенность, по которой вы задаёте пороги, измеряется на ваших собственных метках.
Что ожидать: на примере нагрузки поддержки (три вопроса, 1 050 сгенерированных записей, 15 минут на H100) дообучение подняло Kev-4B с 67.7% до 73.6% точности и с автоматизации 34% решений при бюджете ошибок 5% до 48% (подробности). На реальных данных одна эпоха на 5 219 размеченных потребительских финансовых жалобах подняла Kev-4B с 0.804 до 0.904 точности на жалобах, которых она никогда не видела. Такие приросты — в распределении: они говорят, насколько хорошо Kev учит вашу задачу, а не как он работает на всём остальном. Сначала определите размер набора данных. При 400 записях прирост на примере нагрузки был внутри шума.
С помощью coding-agent
npx skills add jaredpalmer/kev@kev-finetuneЗатем попросите агента «дообучить Kev на моих тикетах поддержки». Навык kev-finetune проводит с вами интервью, находит вопросы, которые ваш код уже задаёт Jev или TypeSafe, преобразует имеющиеся у вас метки или генерирует их достаточно любым LLM, чтобы измерить прирост, дообучает от выпущенного чекпойнта на Modal, подгоняет температуру на отложенном срезе, оценивает результат против нетронутой модели, разворачивает эндпоинт и в конце всё сносит. Вам не нужна локальная GPU или клон этого репозитория. Прогон обучения Kev-4B стоит около $1 на H100.
Вручную
README навыка — это тот же рецепт для людей: шесть коротких скриптов на стандартной библиотеке и одно приложение Modal. Чтобы обучать из этого репозитория, положите примеры в файл JSONL, по одному запросу на строку. Это та же форма, что и у запроса к API, плюс label на каждом вопросе:
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
   "priority": {"type": "score",  "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}
Для choice метка — это имя варианта, для noul — true или false, а для score — позиция уровня, начиная с 0. Отложите 10–20% файла для оценки.
Затем стартуйте от выпущенного чекпойнта с --init_from:
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine

uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
uv run --extra serve python -m kev.serve --run runs/mine --port 8009
--init_from загружает адаптер и указательную голову из выпущенной модели до обучения, поэтому вы сохраняете то, что Kev уже знает, и добавляете сверху свой домен. Старт от базовой модели вместо этого всё это выбрасывает: в тесте одного пользователя на 836 решениях по инструментам поддержки дообучение от базы набрало 0.33 на собственном оценочном наборе Kev против 0.84 у выпущенной модели; те же данные с --init_from сохранили там 0.83 и достигли 0.88 на новом домене. Используйте меньшую скорость обучения, чем в рецепте с нуля (2e-5 — хорошее начало), и выбирайте --base в соответствии с чекпойнтом, от которого стартуете; тренер проверяет, что база, ревизия, ранг LoRA и размер головы совпадают, прежде чем что-либо загрузить.
--batch 1 --accum 8 в bf16 помещает модель 0.8B на GPU на 4 ГБ. Бенчмарк сообщает точность, Brier и калибровку по каждому типу вопросов, так что видно, каким из ваших вопросов дообучение помогло. Чекпойнт, от которого вы стартовали, записан в runs/mine/training_config.json. На Mac запускайте по одному заданию обучения за раз; два задания на одной GPU Apple работают гораздо медленнее.
Развернуть собственный эндпоинт
Чтобы получить HTTPS-эндпоинт вместо локального сервера, этот репозиторий не нужен — только аккаунт Modal:
pip install modal && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
Это обслуживает Kev-4B на L40S по адресу https://<your-workspace>--kev-api.modal.run, с тем же API, что выше, за Authorization: Bearer <key>. В простое он масштабируется до нуля, так что неиспользуемый эндпоинт ничего не стоит. Первый запрос после простоя ждёт около 35 секунд, пока запустится контейнер. KEV_MODEL=jaredpalmer/kev-9b обслуживает другую модель на подходящей для неё GPU; Kev-27B идёт на B200 с откатом на H200 или H100. Если вы используете coding-agent, npx skills add jaredpalmer/kev@kev-deploy делает то же самое и прописывает URL в ваш код. В skills/kev-deploy есть таблица GPU и стоимости.
Модель, дообученная вами с помощью навыка kev-finetune, разворачивается так же из собственного приложения Modal (KEV_SERVE_SECRET=kev-serve-key KEV_SERVE_RUN=<run> modal deploy scripts/kev_modal.py; см. её руководство по деплою). Чтобы вместо этого разместить Kev на собственных машинах, запустите kev.serve из «Запустить локально» на машине с GPU с --host 0.0.0.0 и поставьте за собственным прокси; Производительность обслуживания говорит, какую GPU выбрать.
Что ожидать
Точность. Kev-27B отстаёт от Jev не более чем на три пункта или опережает его в 9 из 11 категорий новых источников на диаграмме ниже. Kev-4B и Kev-9B примерно так же близки на источниках классификационной формы, таких как маршрутизация, логическое следование и научные вопросы. Вопросы на знания зависят в основном от базовой модели: на MMLU Kev-9B набирает 0.73, а Kev-27B сравнивается с Jev на 0.90, но на более сложном MMLU-Pro Kev-27B набирает 0.675 против 0.840 у Jev. Меньшие модели также отстают в арифметике дат с точностью до дня.
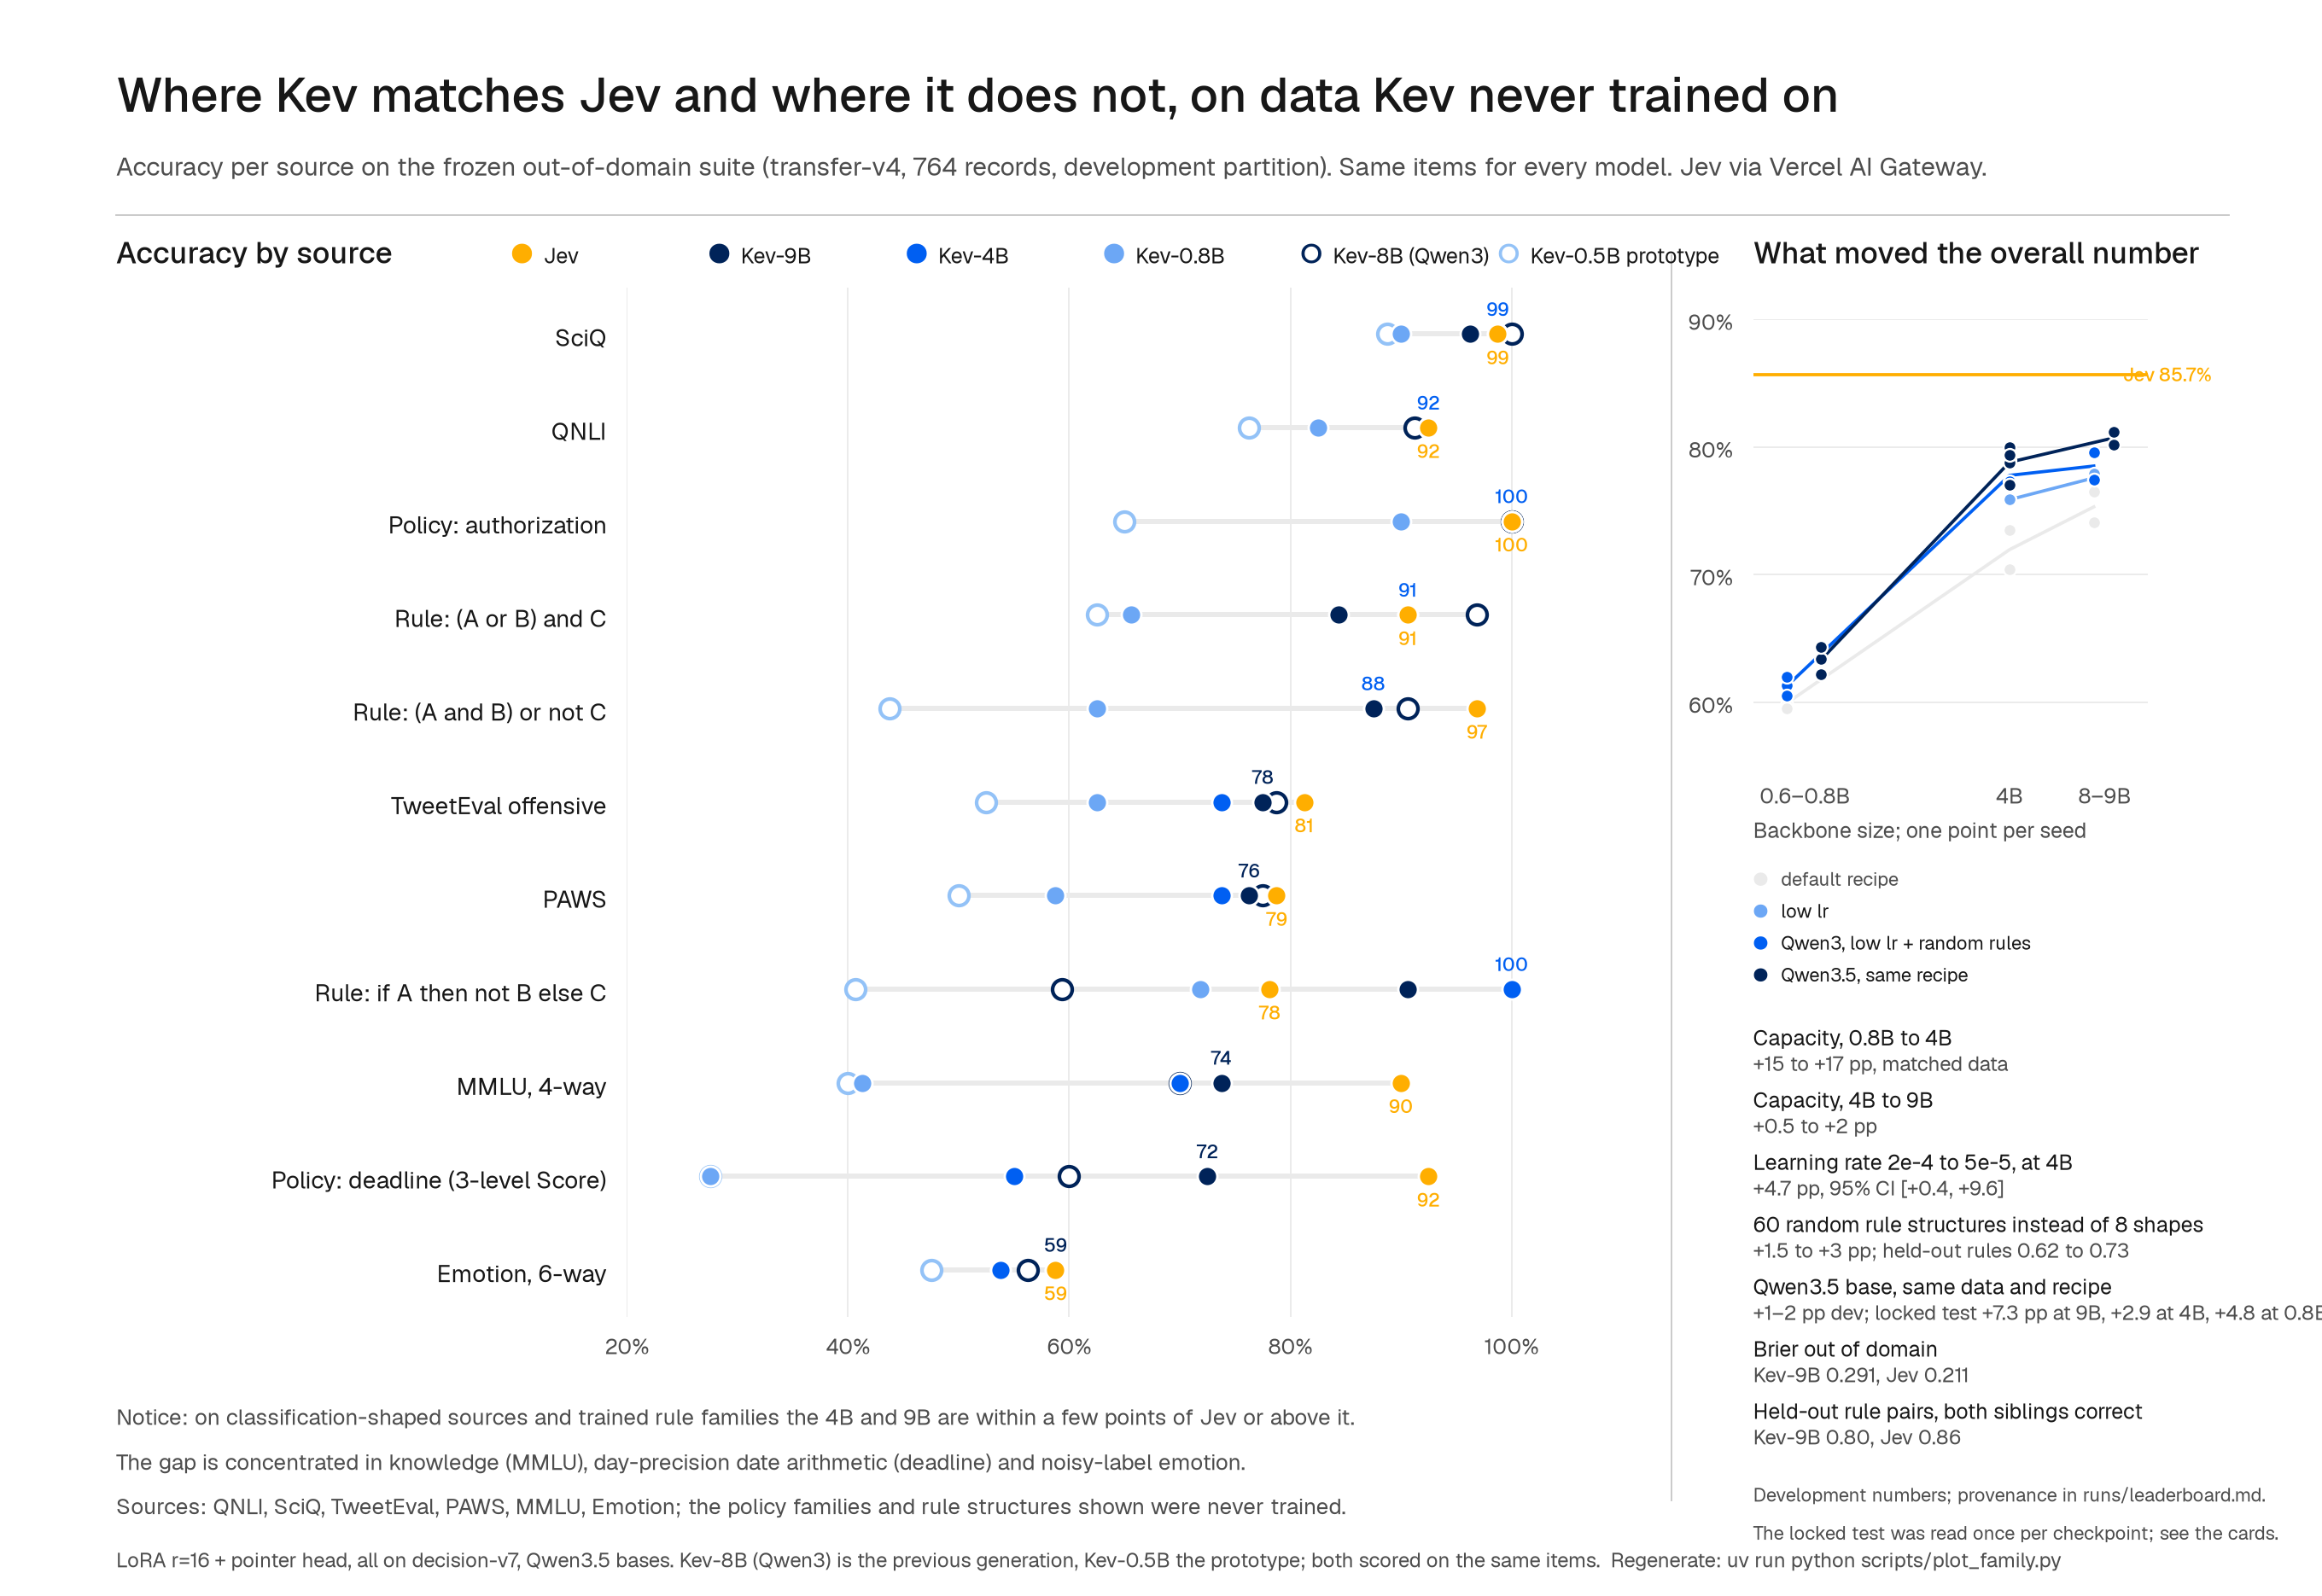
Уверенность. Каждый чекпойнт поставляется с подогнанной температурой, поэтому его вероятности калиброваны по умолчанию. Как обслуживается, Kev-9B ставит не менее 0.9 вероятности на неверный ответ для 2.4% вопросов из новых источников против 3.7% у Jev. Jev всё ещё лучше ранжирует свои ответы: при бюджете ошибок 5% Kev-4B, 9B и 27B могут автоматизировать 0.52–0.69 решений из новых источников, Kev-0.8B — 0.14, Jev — 0.70. Проверьте порог на собственных данных, прежде чем полагаться на него.
Скорость. Kev-4B отвечает на шесть вопросов о новом коротком тексте за 18.1 мс модельного времени на H100 и 41.5 мс на L40S, а контейнер обслуживает около 101 запроса в секунду на H100. На Apple M5 Kev-4B тратит 721 мс на пять вопросов, или 136 мс, когда текст повторяется и берётся из кэша. В Производительность обслуживания есть каждая GPU и размер батча.
Длина. Kev-0.8B, 4B и 9B обучались в основном на состояниях до 384 токенов, с более длинными в их дообучении по документам и навыкам (до 7 552 токенов), Kev-27B — на состояниях до 32 768. Сервер принимает состояния до 65 536 токенов и ещё 8 192 на каждый вопрос и отклоняет более длинное с 422 вместо того, чтобы его обрезать. Насколько далеко за пределы своей обучающей длины каждая модель остаётся точной — это столбец «Проверенный контекст» в «Модели». Для Kev-0.8B, 4B и 9B это 8 192 токена: на 16k измерение на реальных контрактах уже не может исключить падение больше 3 пунктов, а на 32k все три измеримо менее точны, чем на 8k. Kev-27B держится до лимита в 65 536 токенов. На реальных контрактах до 64k токенов (CUAD) Kev-27B набирает 0.874, и её уверенность там менее надёжна, чем на коротком тексте; в её карточке модели есть числа по длине.
Playground
С запущенным сервером откройте другой терминал. Понадобится Node 20.9+:
cd playground
npm install
npm run dev -- -p 3001
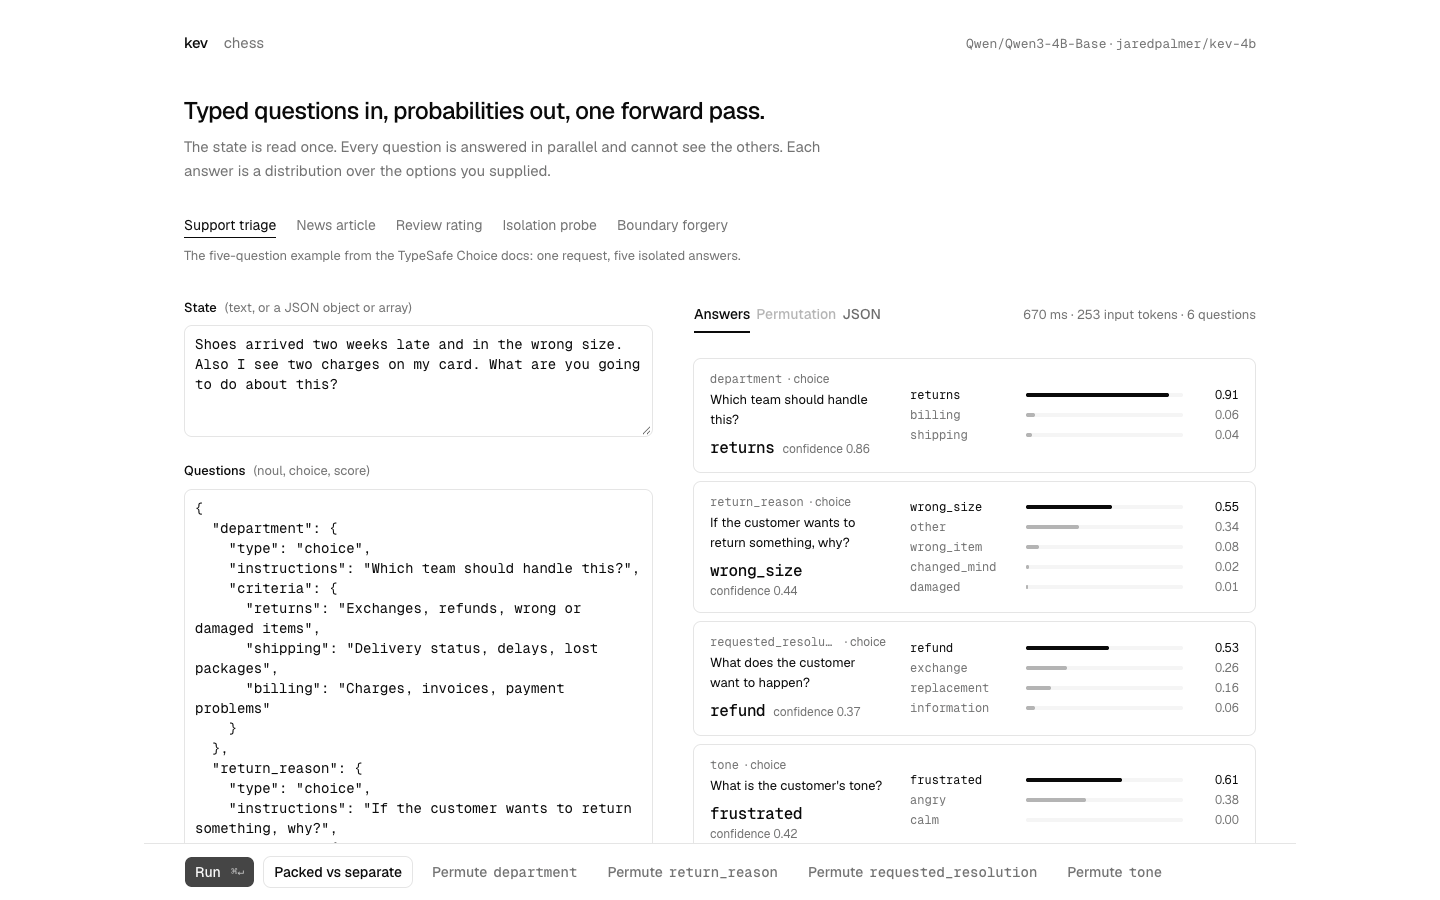
Откройте localhost:3001, загрузите пресет и отредактируйте текст и вопросы. Нажмите ⌘↵, чтобы запустить. «Packed vs separate» сравнивает, как задать все вопросы сразу, с тем, как задавать их по одному. «Permute» прогоняет вопрос Choice с шестью порядками вариантов. Есть также пресеты для проверки изоляции вопросов и фальшивых токенов-разделителей.
Есть также шахматное демо. Доска — это вход, легальные ходы — варианты Choice, а вопрос Score оценивает позицию. Можно играть против Kev или дать ей играть самой с собой. Партии сохраняются в localStorage.
API
POST /v1/systemone
state — это текст для оценки. У каждого вопроса есть инструкции и, где нужно, набор ответов для выбора.
{
  "state": "…",                          // string | object | array — the content to evaluate
  "model": "kev-latest",
  "questions": {
    "<id>": {                            // you choose the id; the model never sees it
      "type": "noul" | "choice" | "score",
      "instructions": "…",               // string | object | array, optional
      "criteria": …                      // noul: {true?, false?}  choice: {option: description|null}  score: [level, …]
    }
  }
}| Тип | Критерии | Ответ |
|---|---|---|
noul |
Необязательные описания для true и false |
noul: вероятность «да» |
choice |
1–255 имён вариантов, каждое с описанием или null |
choice: наиболее вероятный вариант; probabilities и confidence |
score |
1–255 описаний, упорядоченных от низшего к высшему | score: средний индекс уровня, начиная с 0; legend, probabilities и confidence |
Для Choice с K > 1 вариантами уверенность — это (p_max − 1/K) / (1 − 1/K). Один вариант имеет уверенность 1. Уверенность Score — это max(0, 1 − E|level − mode| / D): mode — наиболее вероятный уровень, а D — среднее расстояние равномерного распределения по уровням от его середины (2/3 для трёх уровней), поэтому вся вероятность на одном уровне даёт 1, а равномерное или более широкое распределение даёт 0. Обе формулы — те же, что в эталонном адаптере TypeSafe (system-one-adapter 0.2.1). Ни одно из полей не является измеренной долей точности.
Объекты и массивы преобразуются в размеченный текст. Строки, похожие на разделители, во входных данных пользователя экранируются до токенизации. Недействительные запросы возвращают 422, как и состояние длиннее 65 536 токенов: сервер никогда не отбрасывает часть документа молча, и ошибка даёт число токенов состояния и лимит. usage.output_tokens считает токены в сериализованных ответах, а не сгенерированные токены.
| Метод | Путь | Назначение |
|---|---|---|
GET |
/v1/models |
Карточки моделей (name, description, release_date) плюс детали загруженного чекпойнта |
POST |
/v1/systemone/permute |
Прогнать один вопрос Choice с разными порядками вариантов (n_perm от 1 до 64, по умолчанию 6) |
POST |
/v1/systemone/separate |
Прогнать каждый вопрос в его собственном прямом проходе |
Запрос может нести любое число вопросов. Сервер прогоняет их по одному бюджету токенов за раз (одна максимальная строка в 16 384 токена на прямой проход, при этом кэшированный документ считается один раз на вопрос в этом проходе), поэтому память не растёт с числом вопросов, а ответы не зависят от разбиения. Каждый ответ несёт заголовок x-typesafe-request-id. Сервер привязывается к 127.0.0.1 (--host 0.0.0.0, чтобы принимать другие машины) и открыт по умолчанию; задайте KEV_API_KEY, чтобы требовать Authorization: Bearer <key> на /v1/*, — клиенты TypeSafe всегда его отправляют.
| Переменная | Эффект |
|---|---|
KEV_TEMPERATURE=1.0 |
Возвращать сырые вероятности вместо калиброванных |
KEV_DATE_FACTS=1 |
Дописать число дней между любыми двумя датами в состоянии (см. Бенчмарки) |
KEV_TRUNCATE_STATES=1 |
Читать первые 65 536 токенов более длинного состояния вместо отказа от него; тогда каждый ответ содержит truncated и usage.state_tokens / state_tokens_used |
KEV_DTYPE=fp32 |
Обслуживать точный путь fp32, который используют оценки (bf16 — по умолчанию на GPU) |
KEV_API_KEY |
Требовать ключ-носитель |
Как это работает
Каждый чекпойнт — это LoRA-адаптер ранга 16 и небольшая указательная голова на базовой модели Qwen. На базе только со вниманием (Qwen3) состояние и вопросы идут в одну последовательность токенов:
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
Маска внимания позволяет токену читать состояние и свой собственный вопрос, но не другие вопросы и не будущие токены. Позиционные ID каждого вопроса начинаются заново сразу после состояния. Это позволяет модели обработать состояние один раз и ответить на каждый вопрос независимо.
Qwen3.5 и Qwen3.8 смешивают слои внимания со слоями Gated DeltaNet, которые рекуррентны и игнорируют маски внимания. Для этих моделей, а это каждый текущий Kev, каждый вопрос идёт как собственная строка: состояние, за которым следует этот вопрос, с теми же позициями, что выше. Строки независимы, поэтому изоляция точна, а сервер и DecisionModel.probs() вычисляют состояние один раз и переиспользуют его кэш для каждой строки. forward(), который оценивает kev.benchmark и из которого происходят все опубликованные числа, сохраняет простые строки и прогоняет состояние один раз на вопрос; эти два варианта совпадают с точностью до округления fp32. На моделях только со вниманием строки и маска выше дают идентичные вероятности (tests/test_model.py).
Kev-27B использует тот же дизайн на Qwen/Qwen3.8-27B, с двумя отличиями. Её база — релиз Qwen после дообучения, а не чекпойнт -Base, и мы не знаем, на чём его дообучали. И каждый вес бэкбона обучен, а не только адаптер, и хранится в bf16, поэтому чекпойнт — это вся модель: 51 ГБ весов bf16 плюс указательная голова. Она обслуживается только в bf16 (около 66 ГБ резидентно с буферами обслуживания), поэтому ей нужна карта на 80 ГБ. На Apple Silicon бэкенд MLX загружает эти веса как есть, без слияния (см. Производительность обслуживания); мы ожидаем, что это поместится на Mac с 96–128 ГБ, но не измеряли. Её обслуживаемые вероятности держатся в пределах 0.022 от пути оценки на H200 (runs/serving-27b-r23).
Указательная голова оценивает скрытое состояние </opt> каждого варианта против скрытого состояния <decide> вопроса. Softmax превращает эти оценки в вероятности. Поскольку <decide> идёт последним, он может обращать внимание на весь список вариантов.
Обучение использует кросс-энтропию по правильному ответу. Адаптер и голова обучаются вместе; остальные веса базы остаются фиксированными (Kev-27B обучает их все). Обучающие примеры и запросы к API используют один и тот же текстовый формат. Выходы Jev для обучения не использовались.
Задание вопросов вместе или по отдельности даёт вероятности в пределах 4e-6 в тестах fp32. Это не значит, что порядок вариантов неважен: варианты внутри вопроса всё ещё могут влиять друг на друга. См. код модели и тесты паритета.
Обучение
Выпущенные модели делят один базовый обучающий набор, decision-v7: 10 000 примеров из десяти публичных наборов данных, 896 сгенерированных примеров политик и 1 680 примеров из 60 сгенерированных структур правил. Kev-0.8B, 4B и 9B обучаются на нём две эпохи с LoRA ранга 16 и кросс-энтропией. Скорость обучения — 1e-4 для 0.8B и 5e-5 для 4B и 9B. На этих гибридных базах адаптер покрывает проекции внимания, MLP и DeltaNet; kev.train выбирает нужные цели из конфига модели.
Затем Kev-0.8B, 4B и 9B получают короткие последующие дообучения от своих выпущенных чекпойнтов через тот же путь --init_from, который вы использовали бы для собственных данных: сгенерированные случаи, где указано число дней или удалено решающее доказательство (все три), затем реальные документы и сгенерированные данные навыков (все три; Kev-9B начиная с v2, 2026-09-30). Kev-27B обучается иначе. Каждый вес базы дообучается на одну эпоху на восьми H200 (--full_ft 1, скорость обучения 2e-6) на корпусе из 145 840 записей: собственные данные Kev, наборы документов, навыков и инструментов разработчика, публичные наборы данных, лицензированные семейства задач и сгенерированные записи длинных документов, маршрутизации инструментов, журналов агентов и ограничителей, с состояниями до 32 768 токенов. Результат затем усредняется с более ранней обученной через адаптер Kev-27B, 0.85 к 0.15. Карточки моделей перечисляют каждый этап с его данными и стоимостью.
# sanity run, ~1 minute
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# the first stage of Kev-0.8B (~20 min on one H100; the Mac path works but is slow for Qwen3.5 bases)
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base --base_revision dc7cdfe2ee4154fa7e30f5b51ca41bfa40174e68 \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b

# the first stage of Kev-4B (one H100 via Modal, ~1 h; see below). Swap in Qwen/Qwen3-4B-Base for the previous generation.
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base --base_revision 1001bb4d826a52d1f399e183466143f4da7b741b \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
Используйте uv run python -m kev.train --help для всех опций обучения. Выпущенные модели не используют необязательные лоссы --perm_kl или --ord_w. PLAN.md фиксирует, что пробовали, что помогло и что нет.
Modal
Каждый прогон получает собственную H100. Исследование продолжает работать, если вы отключитесь, и вы можете скачать результаты, когда оно завершится:
uv run modal token new                                    # once; opens the browser
KEV_GPU=T4 uv run modal run modal_app.py::smoke           # end-to-end check, ~1 minute of GPU

uv run modal deploy modal_app.py                          # once; studies run on the deployed app and survive disconnects
uv run modal run modal_app.py::study \
    --suite evals/v7/decision-v7 --plan experiments/v7-final.json \
    --name my-study --transfer evals/v4/transfer-v4 --budget 30 --timeout 7200
uv run modal run modal_app.py::pull --name my-study       # results -> runs/my-study, ranked
Планы исследования перечисляют настройки обучения. Каждый прогон сохраняет настройки, хеши кода, хеши наборов данных и результаты. Выбирайте модели по девелоперским результатам, а не по закрытому тесту. После выбора финального кандидата вы можете один раз прочитать его тестовые результаты:
uv run modal run modal_app.py::locked_test --trial my-study/00-trial-0 --name my-candidate # one read, everБенчмарки
Оценочные данные в evals/ заморожены: версии наборов данных и контрольные суммы файлов записаны в каждом манифесте. Большие файлы скачиваются с зеркала Hub и сверяются с этими хешами. Каждая модель в таблицах выше оценивается на одних и тех же элементах. Числа в этом README и карточках моделей проверяются в CI против закоммиченных отчётов, из которых они происходят (docs/claims.json, uv run python scripts/verify_claims.py).
| Набор | Что измеряет |
|---|---|
decision-v7 |
Отложенные примеры из десяти обучающих наборов данных, сгенерированных политик и структур правил («обученные источники») |
transfer-v4 |
764 записи из наборов данных и типов политик и правил, на которых Kev никогда не обучался: QNLI, SciQ, PAWS, MMLU, Emotion, TweetEval, отложенные политики и правила («новые источники») |
transfer-v9 |
transfer-v4 плюс 10-вариантный MMLU-Pro, записи, зарытые в не относящийся к делу текст, и «непознаваемые» записи, чьё решающее доказательство было удалено |
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v4/transfer-v4 --out runs/my-eval      # new sources
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v9/transfer-v9 --out runs/my-eval-v9   # + MMLU-Pro, buried states, unknowable items
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v7/decision-v7 --out runs/my-eval-id   # trained sources
uv run python -m kev.benchmark --remote http://127.0.0.1:8009 --suite evals/v4/transfer-v4 --out runs/my-remote   # any System One endpoint, Jev included
Эти команды используют девелоперские данные. Тестовые данные требуют --allow-test. Бенчмарк сообщает точность, Brier, ошибку калибровки, долю решений, которые вы могли бы автоматизировать при бюджете ошибок 5%, изменения порядка вариантов и изоляцию вопросов. На непознаваемых записях он сообщает, как часто модель всё ещё отвечает с уверенностью не меньше 0.9 (Kev-9B 0%, Jev 9%). Опубликованные числа точности используют оценку fp32, а не путь обслуживания bf16. kev.jev прогоняет те же вопросы против Jev через Vercel AI Gateway, а kev.compare сравнивает два сохранённых прогона с парными бутстрэп-доверительными интервалами.
Калибровка. Каждый чекпойнт хранит температуру, и указательная голова применяет её при загрузке модели. Kev-4B (2.41) и Kev-0.8B (2.35) подогнали свои на своих девелоперских наборах в распределении; Kev-27B (1.32) и Kev-9B (2.19) подогнали свои на отложенных наборах данных, на которых они никогда не обучались. Перенастройка двух меньших моделей на этих отложенных наборах была протестирована и не была принята ни для одной: она не улучшила Kev-4B и ухудшила калибровку Kev-0.8B на её наборах документов и навыков (числа есть в карточках моделей). Температура никогда не меняет то, какой ответ побеждает. На новых источниках она снижает ошибку калибровки Kev-9B с 0.103 до 0.041, а её уверенные ошибки (неверные ответы с вероятностью ≥ 0.9) с 8.2% до 2.4%, ниже 3.7% у Jev. Числа точности выше одинаковы в обоих случаях; числа Brier — для сырых вероятностей. scripts/calibrate_checkpoint.py также сообщает оценку вне фолда, поэтому подгонку по выборке можно сверить с записями, которых она не видела.
Даты. Kev не умеет надёжно вычитать даты, но может использовать данный ей счётчик дней. KEV_DATE_FACTS=1 дописывает по одному предложению на каждую пару дат в состоянии (“June 26, 2026 is 8 days before July 4, 2026”). На вопросах политики deadline это поднимает Kev-9B с 0.80 до 0.90 (Jev 0.93). Ни одна из таблиц его не использует.
Чужие тестовые наборы. evals/external/ содержит тестовые наборы из других проектов, преобразованные в этот формат, с их опубликованными живыми результатами Jev. Некоторые оценивались на более ранних версиях весов Kev, что указывает столбец Kev. Три были удалены, потому что не могут служить гейтом, и карточки моделей сохраняют числа, по которым принимались решения об их выпуске: синтетические тикеты поддержки scienthoon 2026-09-27 (шаблонный текст; один из его трёх вопросов зависит от правила, которого текст не излагает), и 2026-09-30 — WANLI (wanli-v1, wanli-v2: четверть пар — это те, что два аннотатора WANLI разметили по-разному, при этом золото выставлено по одной из них) и публичные оценки TypeSafe (typesafe-v1: золото — это усреднённый ответ двух закрытых передовых моделей, и на 89 вопросах оно не может различить чекпойнты).
| Набор | Что это | Jev | Kev |
|---|---|---|---|
| SemIf | 144 авторских решения | 0.965 | 0.917 (Kev-9B на v7-base) |
Метки SemIf выдерживают проверку, но он близок к насыщению: каждый чекпойнт Kev-27B отвечает правильно на 130 из 144, поэтому это проверка на вменяемость, а не способ ранжировать модели.
Производительность обслуживания
Выбирайте GPU по модели:
| Модель | GPU ($/ч) | 6 вопросов, короткий текст | 5 вопросов, текст в 2 200 токенов | Запросов/с, 64 клиента |
|---|---|---|---|---|
| Kev-0.8B | L4 (0.80) | 22.7 / 16.1 мс | 108.6 / 32.3 мс | 62.8 |
| Kev-4B | L40S (1.95) | 41.5 / 27.7 мс | 145.2 / 43.0 мс | 51.4 |
| Kev-4B | H100 (3.95) | 18.1 / 12.9 мс | 89.4 / 22.5 мс | 100.8 |
| Kev-9B | L40S (1.95) | 66.4 / 42.7 мс | 235.6 / 57.5 мс | 32.7 |
| Kev-9B | H100 (3.95) | 24.0 / 16.6 мс | 88.5 / 26.4 мс | 79.5 |
| Kev-27B | B200 (6.25) | 46.5 / 32.2 мс | 178.0 / 52.1 мс | 44.2 |
| Kev-27B | H200 (4.54) | 67.2 / 50.0 мс | 274.8 / 73.8 мс | 28.6 |
| Kev-27B | H100 (3.95) | 75.0 / 52.0 мс | 277.5 / 79.3 мс | 28.9 |
Времена — это модельное время на запрос (latency_ms, которое возвращает API), медиана из 20, для нового текста / того же текста снова. Сервер кэширует текст, поэтому задать больше вопросов о документе, который вы уже отправили, стоит только за вопросы. Запросы в секунду — для 64 одновременных клиентов, каждый шлёт шесть вопросов о новом коротком тексте; сервер их пакетирует. Строки B200 и H100 для Kev-27B измерялись на её предыдущей версии, той же архитектуре, обслуживаемой в bf16 (runs/fused-27b-*); строка H200 — текущий чекпойнт (runs/serving-27b-r23). Сетевое время — дополнительно: около 65 мс на круговой обмен через веб-эндпоинт Modal в том же регионе.
L4 достаточно для Kev-0.8B, но слишком медленна для Kev-4B. A100 здесь медленнее L40S и стоит дороже. Kev-9B нужно около 17 ГБ памяти GPU, а Kev-27B — 51 ГБ весов (около 66 ГБ с буферами пакетирования); под нагрузкой Kev-27B упирается в вычисления, и B200, H200 или H100 стоят примерно одинаково на запрос. На CUDA установите flash-linear-attention для моделей Qwen3.5 (kev_serve.py и образы Modal уже это делают).
На Apple Silicon uv sync --extra serve устанавливает MLX, и сервер использует его автоматически. Пять вопросов о тексте ~270 токенов на M5 (32 ГБ):
| Модель | Новый текст | Тот же текст снова |
|---|---|---|
| Kev-0.8B | 149 мс | 28 мс |
| Kev-4B | 721 мс | 136 мс |
Длинные документы читаются в кэш по 1 024 токена за раз, поэтому память остаётся близкой к размерам весов. С документом в 65 000 токенов Kev-0.8B тратит 21.2 с в первый раз и 202 мс после этого, при пике 3.8 ГБ, а Kev-4B — 84.5 с и 716 мс при 13.0 ГБ (runs/mlx-long-states; в карточках моделей есть каждая длина). Kev-9B так ещё не измерялась.
Чекпойнты-адаптеры сворачиваются в базу при загрузке, что ненадолго держит вторую копию весов. Полновесные чекпойнты вроде Kev-27B загружаются как сохранены, ничего не сливая, поэтому загрузке нужны только веса. Мы проверили это на Kev-4B, выписанной как полные веса bf16: загрузка дала пик 8.4 ГБ при 8.4 ГБ весов против 15.9 ГБ для пути с адаптером. Её ответы совпали с путём адаптера в точности, как только обе содержат одни и те же значения bf16, и остались в пределах 0.015 от пути fp32 на 60 вопросах (runs/mlx-full-4b). Веса Kev-27B — 51 ГБ. По тем же измерениям ей нужно около 51 ГБ плюс рабочая память, поэтому Mac на 64 ГБ — на грани, а Mac на 96–128 ГБ должен помещать. Мы ещё не запускали её на настолько большом Mac. Первая версия Kev-27B, адаптер, всё же работала так на 128 ГБ M5 Max, совпав с опубликованной точностью (спасибо Sean Connelly, #175).
Сервер работает в bf16 на GPU и Mac. Его вероятности отличаются от пути fp32, который используют опубликованные оценки, не более чем примерно на 0.03 на GPU и 0.05 на Mac, а верхний ответ меняется примерно на одном вопросе из 300. Задайте KEV_DTYPE=fp32 для точного пути. /v1/models сообщает используемый бэкенд и точность. uv run modal run modal_app.py::serving --run jaredpalmer/kev-4b --gpu L40S --name <name> измеряет строку таблицы в вашем собственном аккаунте (строки выше: runs/serve-*, runs/grouping-4b-h100, runs/fused-27b-*, runs/serving-27b-r23).
Ограничения
- Калибровка — это одна температура. Она не может переупорядочить уверенности, поэтому доля решений из новых источников, которые можно автоматизировать при бюджете ошибок 5% (0.52–0.69 для Kev-4B, 9B и 27B), всё ещё ниже 0.70 у Jev. Проверьте порог вероятности на собственных данных, прежде чем полагаться на него.
- Вопросы на знания задаются базовой моделью. MMLU — 0.73 у Kev-9B против 0.90 у Jev, а MMLU-Pro — 0.59 против 0.84.
- Дообучение может сделать базовую модель хуже на отдельных задачах. Арифметика дат была самым ясным случаем (issue #8); обучение на указанных числах дней плюс
KEV_DATE_FACTS=1это восстанавливает. - Изменение порядка вариантов может изменить ответ. Изоляция вопросов этого не предотвращает.
- Kev-0.8B, 4B и 9B обучались в основном на не более чем 384 токенах состояния и 1 024 токенах для состояния плюс один вопрос (их дообучение по документам и навыкам — на состояниях до 7 552 токенов), Kev-27B — на состояниях до 32 768 токенов. Обслуживание допускает состояние в 65 536 токенов; проверенная длина контекста каждой модели — в «Модели».
- На Mac ответы занимают сотни миллисекунд, а не десятки. Kev-27B нужна GPU на 80 ГБ. На Mac ей нужно около 51 ГБ плюс рабочая память; мы ожидаем, что Mac на 96–128 ГБ её вместит, но не измеряли такой.
- Kev-27B стартует с модели после дообучения, обучающие данные которой нам неизвестны.
Разработка
uv run --extra serve python -m pytest tests/test_unit.py tests/test_research.py tests/test_generators.py tests/test_conventions.py \
    tests/test_documents_tools.py tests/test_hard_v1.py tests/test_devtools_v1.py tests/test_breadth_v1.py tests/test_rounds.py tests/test_skill_scripts.py -q   # no weights, no server; what CI runs
KEV_BASE_URL=http://127.0.0.1:8009 uv run --extra serve python -m pytest tests/test_api.py -q   # against a running server
cd playground && npm run lint && npx next typegen && npx tsc --noEmit -p .
Тесты API прогоняют примеры запросов TypeSafe и официальный SDK против вашего локального сервера. PLAN.md — это план исследований: что мы узнали, правила, которым следует каждый эксперимент, и по строке на раунд. Полный журнал (каждый эксперимент, критерии, заданные до его запуска, и как он вышел) — по git-тегу research-archive-2026-09-24.
Предыдущее поколение (Qwen3) и прототип
Первое семейство Kev использовало базы Qwen3 с теми же данными и настройками. Эти веса остаются опубликованными и работают на чистом PyTorch на Mac, но больше не развиваются.
| Модель | База | Точность: обученные источники | Точность: новые источники | Brier: новые источники | Карточка модели |
|---|---|---|---|---|---|
Kev-0.6B (Qwen3) — jaredpalmer/kev-0.6b |
Qwen3-0.6B-Base | 0.801 / 0.808 | 0.620 / 0.642 | 0.536 / 0.483 | Подробнее |
Kev-4B (Qwen3) — jaredpalmer/kev-4b@qwen3 |
Qwen3-4B-Base | 0.854 / 0.856 | 0.790 / 0.806 | 0.328 / 0.294 | Подробнее |
Kev-8B (Qwen3) — jaredpalmer/kev-8b |
Qwen3-8B-Base | 0.863 / 0.870 | 0.796 / 0.780 | 0.337 / 0.327 | Подробнее |
Исходная Kev-0.5B использовала Qwen2.5-0.5B и хранится для справки; см. её карточку модели.
Устранение неполадок
- Если MPS исчерпывает память во время обучения, проверьте, что запущено только одно задание. Не включайте
output_hidden_statesи не добавляйте токены с помощьюtrainable_token_indicesиз peft; и то и другое вызывало здесь проблемы с памятью. - Если playground загружается, но кнопки не работают, используйте
localhost:3001. Next.js проверяет имена хостов разработки. Другим хостам нужна запись вallowedDevOriginsвplayground/next.config.ts. - Если загрузка набора данных сообщает
Dataset scripts are no longer supported, используйтеlegacy-datasets/banking77. Этот репозиторий уже его использует.
Авторы
- Jared Palmer (@jaredpalmer)
Построено с помощью Devin. Спасибо Archer Hume за описание архитектуры, TypeSafe за дизайн API и Qwen за базовые модели.
Связанные работы: Hydragen, DeFT, FIRST.
Лицензия
Apache-2.0. Базовые модели Qwen3, Qwen3.5 и Qwen3.8 также под Apache-2.0. Обучающие наборы данных имеют собственные лицензии; см. карточки моделей.