Pequenos modelos de decisão semelhantes ao Jev que podes treinar e executar por ti próprio.
O Kev é uma família de pequenos modelos de decisão construídos sobre o Qwen3.5 e o Qwen3.8 e baseados na arquitetura descrita em Jev’s Architecture Unmasked. Podes usar os pesos pré-treinados ou treinar os teus. A API corresponde à System One da TypeSafe, por isso podes apontar o SDK Python deles para o teu servidor local.
Destaques
- Perguntas de sim/não (
noul), de escolha múltipla (choice) e de classificação (score) num único pedido. As perguntas partilham o texto mas não conseguem ler umas às outras. - Probabilidades calibradas por predefinição: cada checkpoint vem com uma temperatura ajustada.
- Substituível para o Jev: o SDK Python da TypeSafe funciona com um servidor Kev sem alterações.
- Quatro tamanhos, versionados em conjunto como Kev 1.0: de um 0.8B que corre num portátil a um 27B para uma única GPU de centro de dados.
- Documentos até 65,536 tokens, em CUDA e em Apple Silicon através do MLX. Cada ficha de modelo indica até que ponto um documento pode crescer antes de a precisão cair.
- Afina com os teus próprios exemplos etiquetados. Uma skill de agente de programação corre todo o ciclo no Modal, desde encontrar as tuas perguntas até servir o resultado.
- Implementa o teu próprio endpoint HTTPS com um único comando. Escala até zero quando está inativo.
- Experimenta-o primeiro no navegador: huggingface.co/spaces/jaredpalmer/kev.
Modelos
Começa pelo Kev-4B. Passa para o Kev-9B se tiveres uma GPU maior, ou para o Kev-27B se tiveres uma GPU de 80 GB e quiseres o Kev mais preciso. Usa o Kev-0.8B quando o tamanho importar mais do que a precisão.
| Modelo | Base (licença) | Corre em: CUDA | Corre em: Mac (MLX) | Contexto validado | Conjuntos de dados reservados: índice | Ficha |
|---|---|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base (Apache-2.0) | L4, qualquer GPU de 4 GB | Qualquer Mac com Apple Silicon; medido até 65k tokens | 8,192 | 23.3 | Detalhes |
| Kev-4B | Qwen3.5-4B-Base (Apache-2.0) | L40S, H100 | Mac de 32 GB; medido até 65k tokens | 8,192 | 38.0 | Detalhes |
| Kev-9B | Qwen3.5-9B-Base (Apache-2.0) | L40S, H100 | Mac de 32 GB ou maior (esperado, não medido) | 8,192 | 41.0 | Detalhes |
| Kev-27B | Qwen3.8-27B, pós-treinado (Apache-2.0) | B200, H200, H100 80 GB | Mac de 96–128 GB (esperado, não medido) | 65,536 | 52.3 | Detalhes |
| Jev | Alojado | API da TypeSafe | – | – | 54.0 | – |
“Conjuntos de dados reservados” é o índice corrigido para o acaso do Decision Index da comunidade, avaliado na partição de teste do breadth-v1: 14 conjuntos de dados públicos em cinco áreas nos quais nenhum Kev foi treinado. “Contexto validado” é o documento mais longo, em tokens, para o qual a precisão em contratos reais (CUAD) se mantém dentro de 3 pontos da precisão do mesmo modelo a 8k tokens, no limite inferior de 95 %; cada ficha de modelo tem a medição por comprimento.
| Modelo | Precisão: novas fontes | Precisão: fontes treinadas | Brier: novas fontes |
|---|---|---|---|
| Kev-0.8B | 0.648 / 0.697 | 0.827 / 0.838 | 0.481 / 0.416 |
| Kev-4B | 0.817 / 0.838 | 0.873 / 0.865 | 0.269 / 0.242 |
| Kev-9B | 0.820 / 0.852 | 0.874 / 0.873 | 0.289 / 0.217 |
| Kev-27B | 0.851 / 0.889 | 0.865 / 0.866 | 0.225 / 0.156 |
| Jev | 0.857 / – | 0.845 / – | 0.211 / – |
Cada célula é desenvolvimento / teste. “Novas fontes” significa conjuntos de dados e regras de política que o Kev nunca viu durante o treino. É o que aqui mais se aproxima das tuas próprias perguntas. “Fontes treinadas” significa exemplos reservados dos conjuntos de dados em que o Kev foi treinado. Escolhemos os checkpoints com os conjuntos de desenvolvimento e lemos cada conjunto de teste apenas uma vez por modelo lançado. O Jev só foi corrido nos conjuntos de desenvolvimento destas duas suites. O Brier avalia toda a distribuição de probabilidade, não apenas a resposta mais provável; quanto mais baixo, melhor.
Em novas fontes, o Kev-27B está a um ponto do Jev (0.851 vs 0.857), e o Kev-4B e o Kev-9B estão a menos de quatro pontos. Não sabemos em que foi treinado o Jev, por isso isto não é uma comparação controlada das duas arquiteturas. O que esperar diz onde o Kev é tão bom como o Jev e onde não é.
O Kev-0.8B, o 4B e o 9B partem de modelos base Qwen e partilham uma receita de treino: um pequeno adaptador sobre uma base congelada. O Kev-27B parte da versão pós-treinada da Qwen, e não sabemos em que foi treinada; todos os seus pesos são afinados, por isso é distribuído como 51 GB de pesos completos em vez de um adaptador. Cada ficha de modelo tem a receita completa, todos os resultados e as versões anteriores mantidas como tags do Hub.
Kev 1.0
Os quatro modelos acima são lançados em conjunto como Kev 1.0. Cada repositório do Hub tem uma tag v1.0, por isso --run jaredpalmer/kev-4b@v1.0 carrega sempre os mesmos pesos, e a release do GitHub kev-1.0 tem os checkpoints 0.8B, 4B e 9B com somas de verificação SHA-256. Os 51 GB de pesos do Kev-27B são demasiado grandes para um recurso de release e estão apenas no Hub.
| Modelo | Revisão dos pesos no Hub | Temperatura | Treinado com estados até |
|---|---|---|---|
| Kev-0.8B | 9a45d25e |
2.35 | 7,552 tokens |
| Kev-4B | 139fdd94 |
2.41 | 7,552 tokens |
| Kev-9B | b5d8c18e (v2) |
2.19 | 7,552 tokens |
| Kev-27B | 28be62e9 (v2, pesos completos) |
1.32 | 32,768 tokens |
O Kev 1.0 não treina nada de novo. Fixa os checkpoints, as fichas, as suites de avaliação e o código de serviço com que a próxima geração do Kev será comparada. As notas de lançamento listam o que mudou desde o lançamento anterior da família e o que se sabe que não funciona bem.
Início rápido
Experimenta no navegador
O Hugging Face Space corre o Kev-4B e o Kev-0.8B, sem nada para instalar.
Executar localmente
Vais precisar de Python 3.12 ou 3.13 e de uv. O .python-version do repositório faz com que o uv sync use o 3.13; o torch ainda não tem wheels para 3.14.
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
Isto inicia o Kev-4B na tua máquina: CUDA ou ROCm se tiveres uma GPU, MLX em Apple Silicon. A primeira execução descarrega o adaptador e o modelo base. O --run também aceita um diretório de checkpoint local ou uma revisão do Hub como jaredpalmer/kev-4b@qwen3.
Noutro terminal, envia-lhe um ticket:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
Resposta de exemplo do Kev-4B, a correr em bf16 num Apple M5:
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.34,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
}
O ticket menciona uma devolução, uma entrega atrasada e um problema de faturação, e as probabilidades do departamento dizem isso mesmo. É por isso que o Kev devolve probabilidades em vez de uma única etiqueta: o teu código pode encaminhar os casos com confiança e mandar o resto para uma pessoa.
Usar a partir do Python
Se já chamas o Jev, aponta o teu cliente para o Kev e mantém o resto do teu código. O SDK da TypeSafe está incluído no uv sync --extra serve:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
Ajuste fino com os teus próprios dados
Os modelos lançados foram treinados em conjuntos de dados públicos e em exemplos de política gerados. Se as tuas perguntas forem diferentes, como as tuas próprias categorias de encaminhamento, as tuas próprias regras de escalonamento ou outro idioma, um ajuste fino curto costuma ajudar mais do que qualquer alteração ao prompt. Também ajusta a temperatura aos teus dados, para que a confiança com que defines limiares seja medida nas tuas próprias etiquetas.
O que esperar: numa carga de trabalho de apoio ao cliente de exemplo (três perguntas, 1,050 registos gerados, 15 minutos numa H100), o ajuste fino levou o Kev-4B de 67.7% para 73.6% de precisão, e de automatizar 34% das decisões com um orçamento de erro de 5% para 48% (detalhes). Em dados reais, uma época em 5,219 reclamações de finanças pessoais etiquetadas levou o Kev-4B de 0.804 para 0.904 de precisão em reclamações que nunca tinha visto. Ganhos como estes estão dentro da distribuição: dizem-te quão bem o Kev aprende a tua tarefa, não como se comporta em tudo o resto. Dá primeiro o tamanho certo ao teu conjunto de dados. Com 400 registos, o ganho na carga de trabalho de exemplo estava dentro do ruído.
Com um agente de programação
npx skills add jaredpalmer/kev@kev-finetuneDepois pede ao teu agente para “afinar o Kev nos meus tickets de apoio”. A skill kev-finetune entrevista-te, encontra as perguntas que o teu código já faz ao Jev ou à TypeSafe, converte as etiquetas que tens ou gera o suficiente com qualquer LLM para medir um ganho, afina a partir de um checkpoint lançado no Modal, ajusta a temperatura numa porção reservada, avalia o resultado contra o modelo não tocado, implementa um endpoint e desmonta tudo no fim. Não precisas de uma GPU local nem de um clone deste repositório. Uma execução de treino do Kev-4B custa cerca de $1 numa H100.
À mão
O README da skill é a mesma receita para pessoas: seis pequenos scripts da biblioteca padrão e uma aplicação Modal. Para treinar a partir deste repositório, coloca os teus exemplos num ficheiro JSONL, um pedido por linha. Tem a mesma forma que um pedido à API, mais um label em cada pergunta:
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
   "priority": {"type": "score",  "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}
Para choice a etiqueta é o nome da opção, para noul é true ou false, e para score é a posição do nível a começar em 0. Guarda 10–20% do ficheiro de lado para avaliação.
Depois parte de um checkpoint lançado com --init_from:
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine

uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
uv run --extra serve python -m kev.serve --run runs/mine --port 8009
O --init_from carrega o adaptador e a cabeça de ponteiro do modelo lançado antes do treino, por isso mantém o que o Kev já sabe e acrescenta o teu domínio por cima. Começar antes pelo modelo base deita isso fora: num teste de um utilizador em 836 decisões de ferramentas de apoio, um ajuste fino a partir da base obteve 0.33 no próprio conjunto de avaliação do Kev, contra 0.84 do modelo lançado; os mesmos dados com --init_from mantiveram 0.83 aí e chegaram a 0.88 no novo domínio. Usa uma taxa de aprendizagem mais baixa do que a receita de raiz (2e-5 é um bom começo) e escolhe --base para corresponder ao checkpoint de que partes; o treinador verifica que a base, a revisão, o rank do LoRA e o tamanho da cabeça coincidem antes de carregar seja o que for.
--batch 1 --accum 8 em bf16 encaixa o modelo 0.8B numa GPU de 4 GB. O benchmark reporta precisão, pontuação Brier e calibração por tipo de pergunta, para que vejas em quais das tuas perguntas o ajuste fino ajudou. O checkpoint de que partiste fica registado em runs/mine/training_config.json. Num Mac, corre um único trabalho de treino de cada vez; dois trabalhos na mesma GPU Apple são muito mais lentos.
Implementa o teu próprio endpoint
Para obteres um endpoint HTTPS em vez de um servidor local, não precisas deste repositório, apenas de uma conta Modal:
pip install modal && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
Isto serve o Kev-4B numa L40S em https://<your-workspace>--kev-api.modal.run, com a mesma API que acima, atrás de Authorization: Bearer <key>. Escala até zero quando está inativo, por isso um endpoint não usado não custa nada. O primeiro pedido após a inatividade espera cerca de 35 segundos até um contentor arrancar. KEV_MODEL=jaredpalmer/kev-9b serve outro modelo na GPU que lhe convém; o Kev-27B vai para uma B200, com recurso a uma H200 ou H100. Se usares um agente de programação, npx skills add jaredpalmer/kev@kev-deploy faz o mesmo e liga o URL ao teu código. skills/kev-deploy tem a tabela de GPUs e custos.
Um modelo que afinares com a skill kev-finetune implementa-se da mesma forma a partir da sua própria aplicação Modal (KEV_SERVE_SECRET=kev-serve-key KEV_SERVE_RUN=<run> modal deploy scripts/kev_modal.py; vê o seu guia de implementação). Para alojares o Kev nas tuas próprias máquinas, corre o kev.serve de Executar localmente numa máquina com GPU com --host 0.0.0.0 e coloca-o atrás do teu próprio proxy; Desempenho em serviço indica que GPU escolher.
O que esperar
Precisão. O Kev-27B está a menos de três pontos do Jev, ou à frente dele, em 9 das 11 categorias de novas fontes no gráfico abaixo. O Kev-4B e o Kev-9B estão quase tão próximos em fontes com forma de classificação, como encaminhamento, implicação e perguntas de ciência. As perguntas de conhecimento dependem sobretudo do modelo base: no MMLU o Kev-9B obtém 0.73 e o Kev-27B iguala o Jev com 0.90, mas no mais difícil MMLU-Pro o Kev-27B obtém 0.675 contra 0.840 do Jev. Os modelos mais pequenos também ficam atrás na aritmética de datas com precisão ao dia.
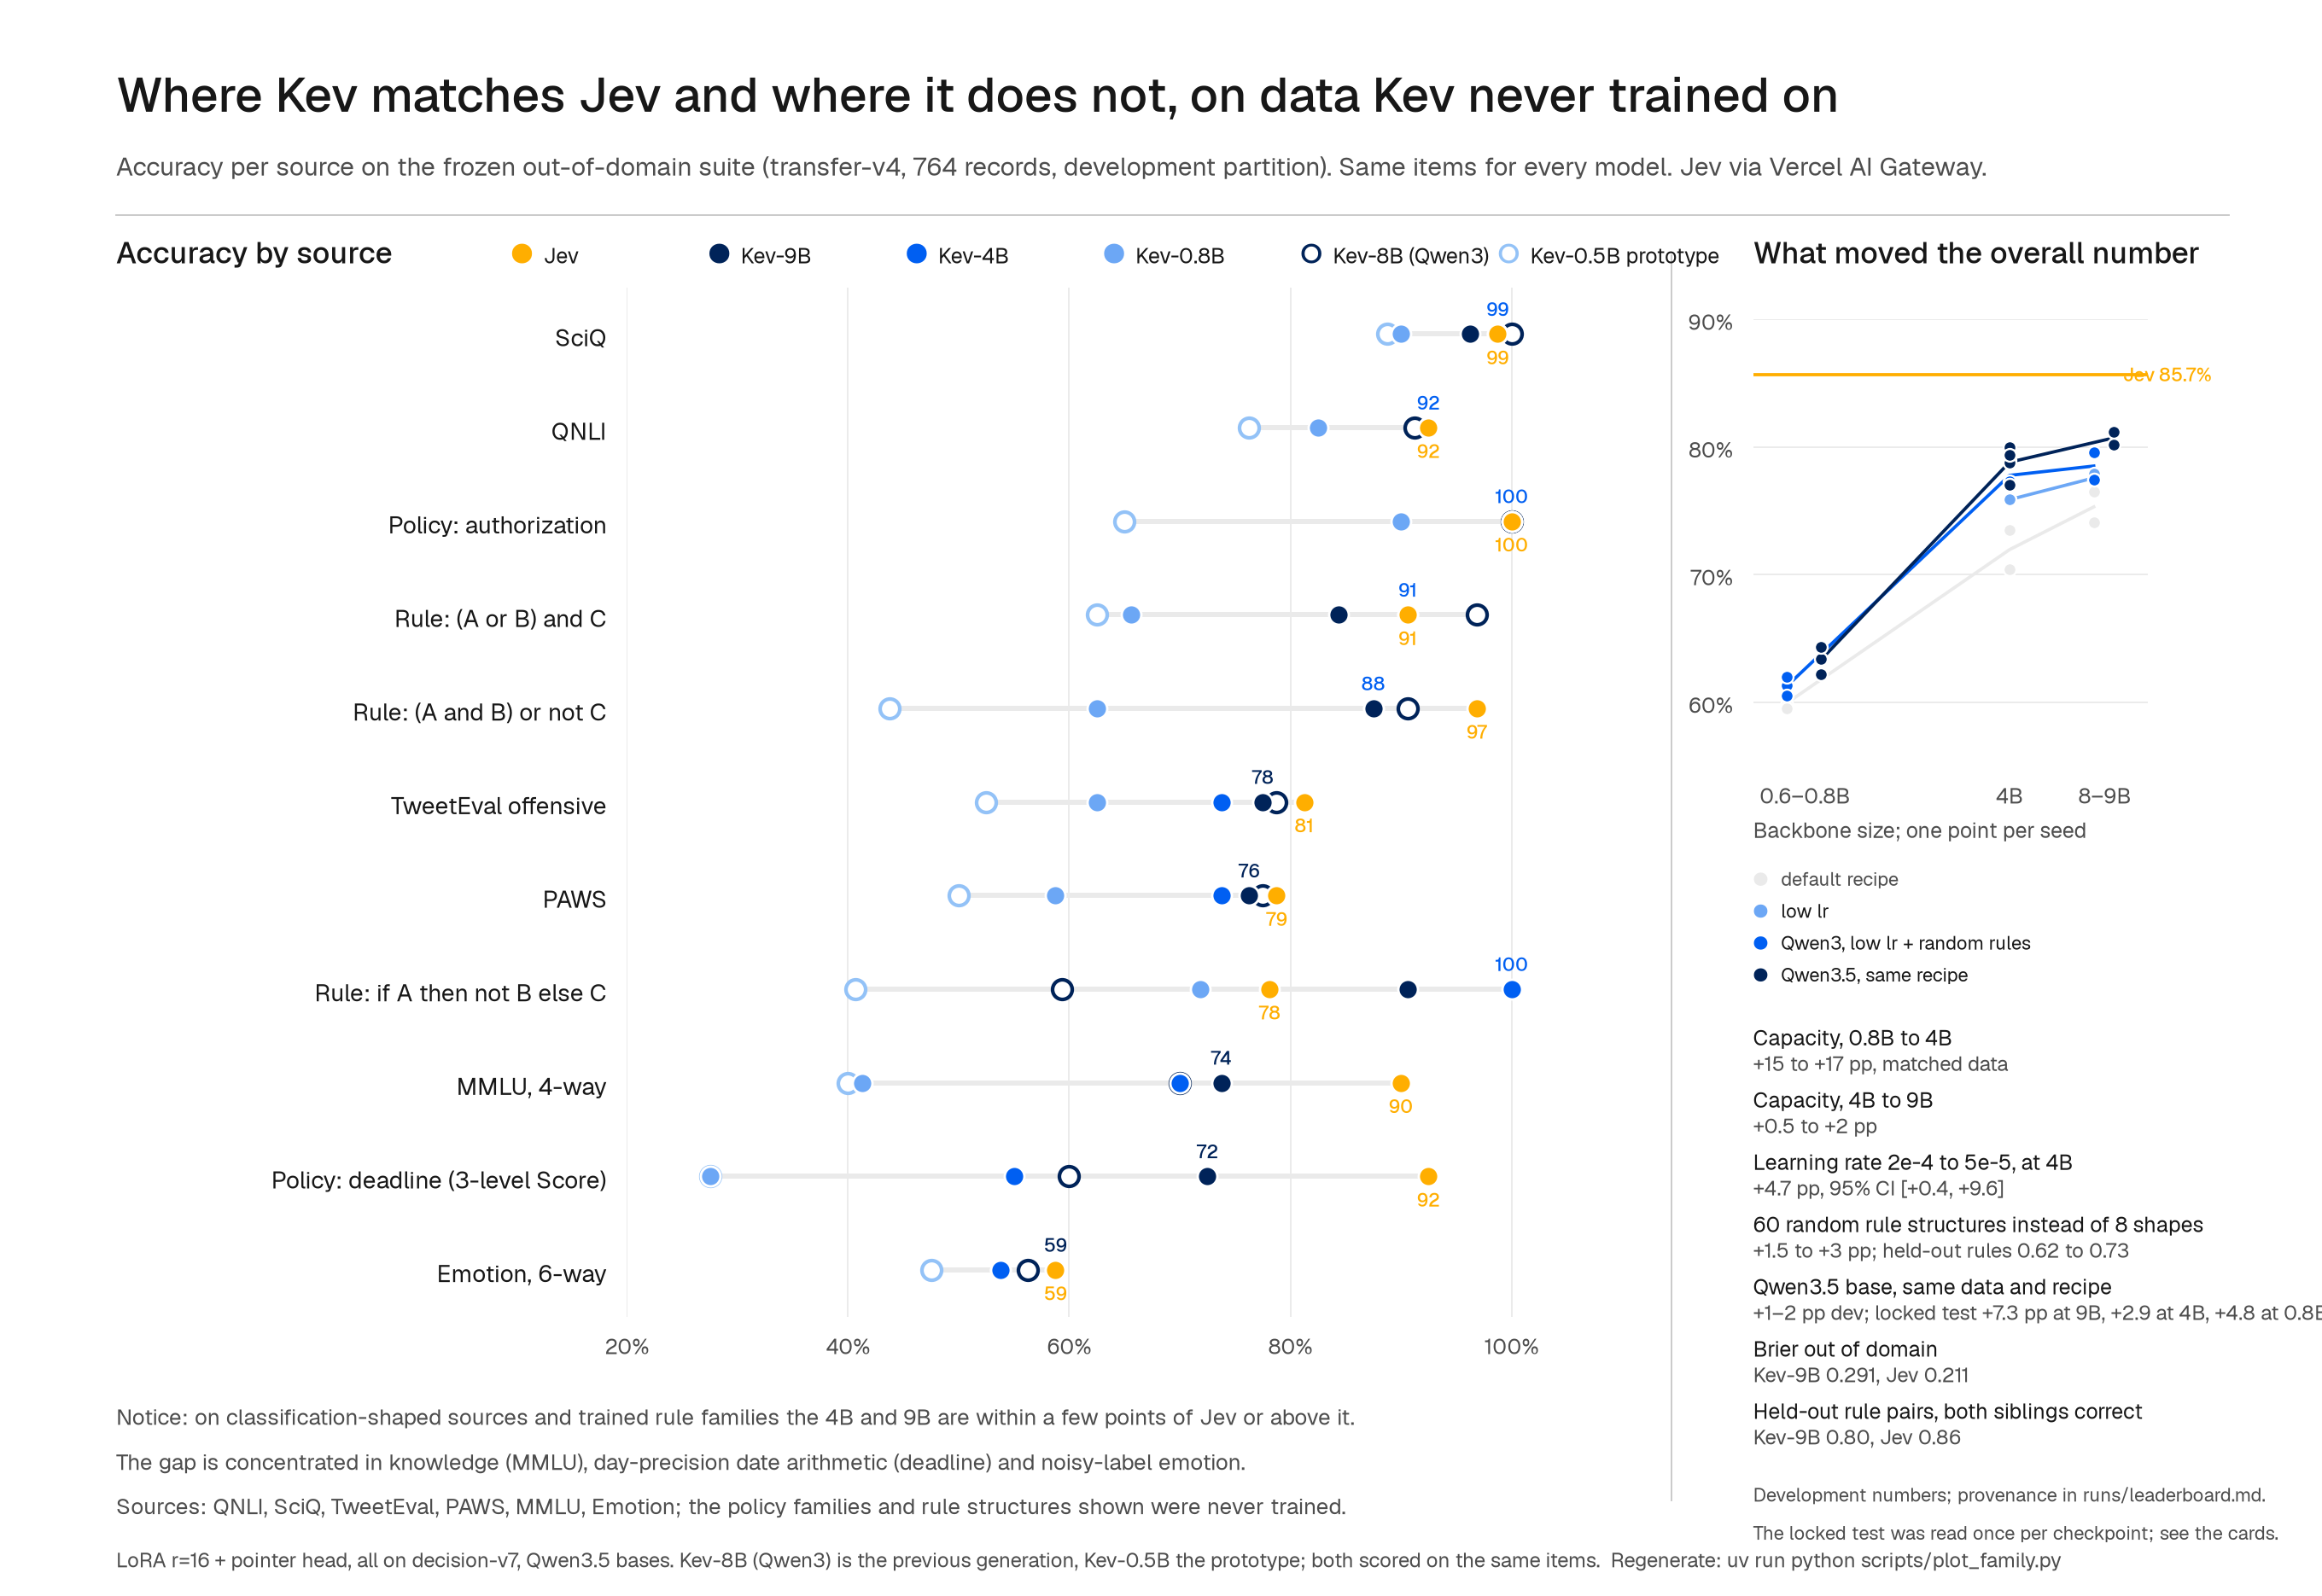
Confiança. Cada checkpoint vem com uma temperatura ajustada, por isso as suas probabilidades são calibradas por predefinição. Tal como é servido, o Kev-9B atribui pelo menos 0.9 de probabilidade a uma resposta errada em 2.4% das perguntas de novas fontes, contra 3.7% do Jev. O Jev continua a ordenar melhor as suas respostas: com um orçamento de erro de 5%, o Kev-4B, o 9B e o 27B conseguem automatizar 0.52–0.69 das decisões em novas fontes, o Kev-0.8B 0.14 e o Jev 0.70. Verifica um limiar nos teus próprios dados antes de confiares nele.
Velocidade. O Kev-4B responde a seis perguntas sobre um novo texto curto em 18.1 ms de tempo de modelo numa H100 e 41.5 ms numa L40S, e um contentor serve cerca de 101 pedidos por segundo numa H100. Num Apple M5, o Kev-4B demora 721 ms para cinco perguntas, ou 136 ms quando o texto se repete e vem da cache. Desempenho em serviço tem todas as GPUs e tamanhos de lote.
Comprimento. O Kev-0.8B, o 4B e o 9B treinaram sobretudo em estados até 384 tokens, com outros mais longos nos seus ajustes finos de documentos e skills (até 7,552 tokens), e o Kev-27B em estados até 32,768. O servidor aceita estados até 65,536 tokens, e mais 8,192 por cada pergunta, e recusa um mais longo com um 422 em vez de o cortar. Até onde cada modelo se mantém preciso para além do seu comprimento de treino é a coluna “Contexto validado” em Modelos. Para o Kev-0.8B, o 4B e o 9B isso são 8,192 tokens: a 16k, a medição em contratos reais já não consegue excluir uma queda superior a 3 pontos, e a 32k os três são mensuravelmente menos precisos do que a 8k. O Kev-27B aguenta até ao limite de 65,536 tokens. Em contratos reais até 64k tokens (CUAD) o Kev-27B obtém 0.874, e a sua confiança aí é menos fiável do que em texto curto; a sua ficha de modelo tem os números por comprimento.
Playground
Com o servidor a correr, abre outro terminal. Vais precisar do Node 20.9+:
cd playground
npm install
npm run dev -- -p 3001
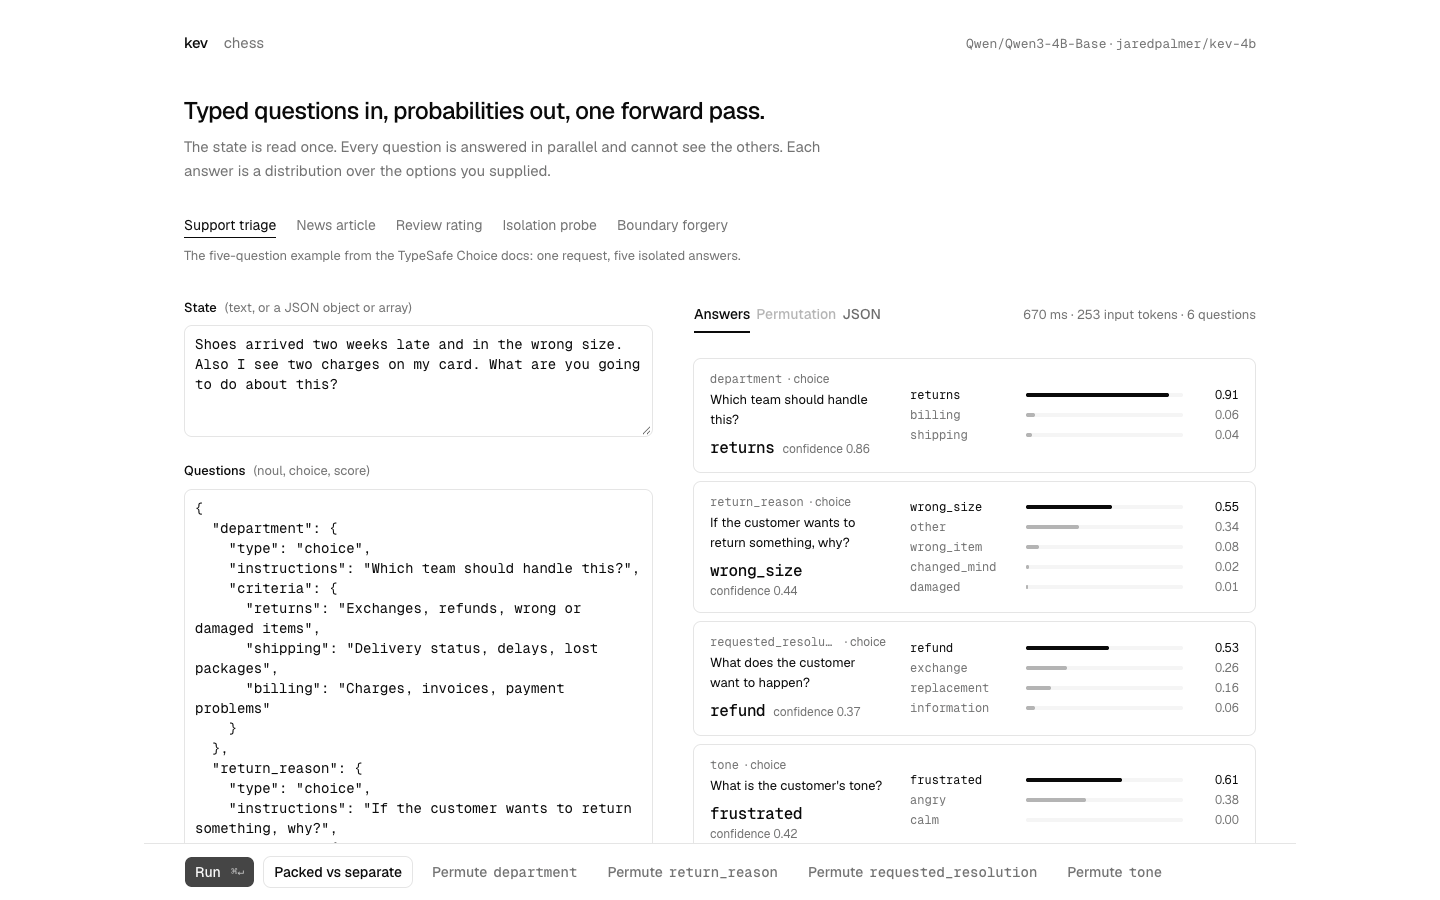
Abre localhost:3001, carrega uma predefinição e edita o texto e as perguntas. Prime ⌘↵ para o correr. “Packed vs separate” compara fazer todas as perguntas de uma vez com fazê-las uma a uma. “Permute” corre uma pergunta Choice com seis ordens de opções. Há também predefinições para testar o isolamento das perguntas e tokens delimitadores falsos.
Há também uma demonstração de xadrez. O tabuleiro é a entrada, os lances legais são opções Choice, e uma pergunta Score avalia a posição. Podes jogar contra o Kev ou deixá-lo jogar sozinho. Os jogos ficam guardados em localStorage.
API
POST /v1/systemone
state é o texto a avaliar. Cada pergunta tem instruções e, quando necessário, um conjunto de respostas entre as quais escolher.
{
  "state": "…",                          // string | object | array — the content to evaluate
  "model": "kev-latest",
  "questions": {
    "<id>": {                            // you choose the id; the model never sees it
      "type": "noul" | "choice" | "score",
      "instructions": "…",               // string | object | array, optional
      "criteria": …                      // noul: {true?, false?}  choice: {option: description|null}  score: [level, …]
    }
  }
}| Tipo | Critérios | Resposta |
|---|---|---|
noul |
Descrições opcionais para true e false |
noul: probabilidade de sim |
choice |
1–255 nomes de opções, cada um com uma descrição ou null |
choice: opção mais provável; probabilities e confidence |
score |
1–255 descrições, ordenadas da mais baixa para a mais alta | score: índice médio do nível, a começar em 0; legend, probabilities e confidence |
Para Choice com K > 1 opções, a confiança é (p_max − 1/K) / (1 − 1/K). Uma única opção tem confiança 1. A confiança do Score é max(0, 1 − E|level − mode| / D): mode é o nível mais provável e D é a distância média de uma distribuição uniforme sobre os níveis ao seu centro (2/3 para três níveis), por isso toda a probabilidade num nível dá 1 e uma distribuição uniforme ou mais larga dá 0. Ambas as fórmulas são as do adaptador de referência da TypeSafe (system-one-adapter 0.2.1). Nenhum dos campos é uma taxa de precisão medida.
Objetos e arrays são convertidos em texto etiquetado. Cadeias semelhantes a delimitadores na entrada do utilizador são escapadas antes da tokenização. Pedidos inválidos devolvem 422, e um estado com mais de 65,536 tokens também: o servidor nunca descarta silenciosamente parte de um documento, e o erro indica a contagem de tokens do estado e o limite. usage.output_tokens conta os tokens das respostas serializadas, não os tokens gerados.
| Método | Caminho | Finalidade |
|---|---|---|
GET |
/v1/models |
Fichas de modelo (name, description, release_date) mais os detalhes do checkpoint carregado |
POST |
/v1/systemone/permute |
Corre uma pergunta Choice com diferentes ordens de opções (n_perm de 1 a 64, predefinição 6) |
POST |
/v1/systemone/separate |
Corre cada pergunta na sua própria passagem direta |
Um pedido pode transportar qualquer número de perguntas. O servidor corre-as um orçamento de tokens de cada vez (uma linha máxima de 16,384 tokens por passagem direta, contando o documento em cache uma vez por pergunta nessa passagem), por isso a memória não cresce com o número de perguntas e as respostas não dependem da divisão. Cada resposta transporta um cabeçalho x-typesafe-request-id. O servidor liga-se a 127.0.0.1 (--host 0.0.0.0 para aceitar outras máquinas) e está aberto por predefinição; define KEV_API_KEY para exigir Authorization: Bearer <key> em /v1/*, tal como os clientes TypeSafe o enviam sempre.
| Variável | Efeito |
|---|---|
KEV_TEMPERATURE=1.0 |
Devolve probabilidades em bruto em vez das calibradas |
KEV_DATE_FACTS=1 |
Acrescenta o número de dias entre quaisquer duas datas no estado (vê Benchmarks) |
KEV_TRUNCATE_STATES=1 |
Lê os primeiros 65,536 tokens de um estado mais longo em vez de o recusar; cada resposta passa então a ter truncated e usage.state_tokens / state_tokens_used |
KEV_DTYPE=fp32 |
Serve o caminho exato em fp32 que as avaliações usam (bf16 é a predefinição nas GPUs) |
KEV_API_KEY |
Exige uma chave bearer |
Como funciona
Cada checkpoint é um adaptador LoRA de rank 16 e uma pequena cabeça de ponteiro sobre um modelo base Qwen. Numa base apenas de atenção (Qwen3), o estado e as perguntas entram numa única sequência de tokens:
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
A máscara de atenção deixa um token ler o estado e a sua própria pergunta, mas não outras perguntas nem tokens futuros. Os IDs de posição de cada pergunta recomeçam logo após o estado. Isto permite ao modelo processar o estado uma vez e responder a cada pergunta de forma independente.
O Qwen3.5 e o Qwen3.8 misturam camadas de atenção com camadas Gated DeltaNet, que são recorrentes e ignoram as máscaras de atenção. Para esses modelos, que são todos os Kev atuais, cada pergunta corre como a sua própria linha: o estado seguido dessa pergunta, com as mesmas posições que acima. As linhas são independentes, por isso o isolamento é exato, e o servidor e o DecisionModel.probs() calculam o estado uma vez e reutilizam a sua cache em cada linha. O forward(), que o kev.benchmark avalia e de que vem cada número publicado, mantém as linhas simples e corre o estado uma vez por pergunta; os dois coincidem até ao arredondamento fp32. Nos modelos apenas de atenção, as linhas e a máscara acima dão probabilidades idênticas (tests/test_model.py).
O Kev-27B usa o mesmo desenho sobre o Qwen/Qwen3.8-27B, com duas diferenças. A sua base é a versão pós-treinada da Qwen e não um checkpoint -Base, e não sabemos em que foi pós-treinada. E todos os pesos do backbone são treinados, não apenas um adaptador, e mantidos em bf16, por isso o checkpoint é o modelo inteiro: 51 GB de pesos bf16 mais a cabeça de ponteiro. Serve apenas em bf16 (cerca de 66 GB residentes com os buffers de serviço), e é por isso que precisa de uma placa de 80 GB. Em Apple Silicon o backend MLX carrega esses pesos tal como estão, sem fusão (vê Desempenho em serviço); esperamos que caiba num Mac de 96–128 GB, mas não o medimos. As suas probabilidades servidas mantêm-se dentro de 0.022 do caminho de avaliação numa H200 (runs/serving-27b-r23).
A cabeça de ponteiro avalia o estado oculto </opt> de cada opção contra o estado oculto <decide> da pergunta. Uma softmax transforma essas pontuações em probabilidades. Como o <decide> vem por último, pode atender à lista completa de opções.
O treino usa entropia cruzada sobre a resposta correta. O adaptador e a cabeça são treinados em conjunto; o resto dos pesos da base fica fixo (o Kev-27B treina-os todos). Os exemplos de treino e os pedidos à API usam o mesmo formato de texto. Não foi usada nenhuma saída do Jev para o treino.
Fazer as perguntas em conjunto ou em separado produz probabilidades dentro de 4e-6 nos testes em fp32. Isto não significa que a ordem das opções seja irrelevante: as opções dentro de uma pergunta ainda podem influenciar-se mutuamente. Vê o código do modelo e os testes de paridade.
Treino
Os modelos lançados partilham um conjunto de treino base, decision-v7: 10,000 exemplos de dez conjuntos de dados públicos, 896 exemplos de política gerados e 1,680 exemplos de 60 estruturas de regras geradas. O Kev-0.8B, o 4B e o 9B treinam nele durante duas épocas com LoRA de rank 16 e entropia cruzada. A taxa de aprendizagem é 1e-4 para o 0.8B e 5e-5 para o 4B e o 9B. Nestas bases híbridas o adaptador cobre as projeções de atenção, MLP e DeltaNet; o kev.train escolhe os alvos certos a partir da configuração do modelo.
O Kev-0.8B, o 4B e o 9B recebem depois curtos ajustes finos de seguimento a partir dos seus checkpoints lançados, através do mesmo percurso --init_from que usarias para os teus próprios dados: casos gerados que indicam contagens de dias ou têm a prova decisiva removida (os três), depois documentos reais e dados de skills gerados (os três; o Kev-9B desde a v2, 2026-09-30). O Kev-27B é treinado de forma diferente. Todos os pesos da base são afinados durante uma época em oito H200s (--full_ft 1, taxa de aprendizagem 2e-6) num corpus de 145,840 registos: os próprios dados do Kev, as suites de documentos, skills e ferramentas de desenvolvimento, conjuntos de dados públicos, famílias de tarefas licenciadas e registos gerados de documentos longos, encaminhamento de ferramentas, registos de agentes e guardrails, com estados até 32,768 tokens. O resultado é depois combinado por média com o Kev-27B anterior, treinado com adaptador, 0.85 para 0.15. As fichas de modelo listam cada etapa com os seus dados e custo.
# sanity run, ~1 minute
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# the first stage of Kev-0.8B (~20 min on one H100; the Mac path works but is slow for Qwen3.5 bases)
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base --base_revision dc7cdfe2ee4154fa7e30f5b51ca41bfa40174e68 \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b

# the first stage of Kev-4B (one H100 via Modal, ~1 h; see below). Swap in Qwen/Qwen3-4B-Base for the previous generation.
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base --base_revision 1001bb4d826a52d1f399e183466143f4da7b741b \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
Usa uv run python -m kev.train --help para todas as opções de treino. Os modelos lançados não usam as perdas opcionais --perm_kl ou --ord_w. O PLAN.md registra o que foi tentado, o que ajudou e o que não.
Modal
Cada ensaio tem a sua própria H100. O estudo continua a correr se te desligares, e podes descarregar os resultados quando terminar:
uv run modal token new                                    # once; opens the browser
KEV_GPU=T4 uv run modal run modal_app.py::smoke           # end-to-end check, ~1 minute of GPU

uv run modal deploy modal_app.py                          # once; studies run on the deployed app and survive disconnects
uv run modal run modal_app.py::study \
    --suite evals/v7/decision-v7 --plan experiments/v7-final.json \
    --name my-study --transfer evals/v4/transfer-v4 --budget 30 --timeout 7200
uv run modal run modal_app.py::pull --name my-study       # results -> runs/my-study, ranked
Os planos de estudo listam as definições de treino. Cada ensaio guarda as definições, os hashes do código, os hashes dos conjuntos de dados e os resultados. Escolhe os modelos com os resultados de desenvolvimento, não com o teste bloqueado. Depois de escolheres um candidato final, podes ler os seus resultados de teste uma vez:
uv run modal run modal_app.py::locked_test --trial my-study/00-trial-0 --name my-candidate # one read, everBenchmarks
Os dados de avaliação em evals/ são congelados: as versões dos conjuntos de dados e as somas de verificação dos ficheiros ficam registadas em cada manifesto. Os ficheiros grandes são descarregados do espelho do Hub e verificados contra esses hashes. Cada modelo nas tabelas acima é avaliado nos mesmos itens. Os números neste README e nas fichas de modelo são verificados em CI contra os relatórios confirmados de onde vêm (docs/claims.json, uv run python scripts/verify_claims.py).
| Suite | O que mede |
|---|---|
decision-v7 |
Exemplos reservados dos dez conjuntos de dados de treino, das políticas geradas e das estruturas de regras (“fontes treinadas”) |
transfer-v4 |
764 registos de conjuntos de dados e de tipos de política e regras em que o Kev nunca treinou: QNLI, SciQ, PAWS, MMLU, Emotion, TweetEval, políticas e regras reservadas (“novas fontes”) |
transfer-v9 |
transfer-v4 mais MMLU-Pro de 10 vias, registos enterrados em texto não relacionado e registos “incognoscíveis” cuja prova decisiva foi removida |
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v4/transfer-v4 --out runs/my-eval      # new sources
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v9/transfer-v9 --out runs/my-eval-v9   # + MMLU-Pro, buried states, unknowable items
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v7/decision-v7 --out runs/my-eval-id   # trained sources
uv run python -m kev.benchmark --remote http://127.0.0.1:8009 --suite evals/v4/transfer-v4 --out runs/my-remote   # any System One endpoint, Jev included
Estes comandos usam dados de desenvolvimento. Os dados de teste exigem --allow-test. O benchmark reporta precisão, pontuação Brier, erro de calibração, a proporção de decisões que poderias automatizar com um orçamento de erro de 5%, alterações da ordem das opções e isolamento das perguntas. Nos registos incognoscíveis reporta com que frequência o modelo ainda responde com pelo menos 0.9 de confiança (Kev-9B 0%, Jev 9%). Os números de precisão publicados usam avaliação em fp32, não o caminho de serviço em bf16. O kev.jev corre as mesmas perguntas contra o Jev através do Vercel AI Gateway, e o kev.compare compara duas execuções guardadas com intervalos de confiança bootstrap emparelhados.
Calibração. Cada checkpoint guarda uma temperatura, e a cabeça de ponteiro aplica-a quando o modelo é carregado. O Kev-4B (2.41) e o Kev-0.8B (2.35) ajustaram as suas nos seus conjuntos de desenvolvimento em distribuição; o Kev-27B (1.32) e o Kev-9B (2.19) ajustaram as suas em conjuntos de dados reservados em que nunca treinaram. Um reajuste dos dois modelos mais pequenos nesses conjuntos de dados reservados foi testado e não foi adotado para nenhum: não melhorou o Kev-4B e tornou o Kev-0.8B pior calibrado nas suas suites de documentos e skills (as fichas de modelo têm os números). Uma temperatura nunca muda qual resposta ganha. Em novas fontes, leva o erro de calibração do Kev-9B de 0.103 para 0.041 e os seus erros confiantes (respostas erradas com probabilidade ≥ 0.9) de 8.2% para 2.4%, abaixo dos 3.7% do Jev. Os números de precisão acima são iguais de qualquer forma; os números de Brier são para as probabilidades em bruto. O scripts/calibrate_checkpoint.py reporta também uma estimativa fora da amostra, para que o ajuste na amostra possa ser verificado contra registos que não viu.
Datas. O Kev não consegue subtrair datas de forma fiável, mas consegue usar uma contagem de dias que lhe seja dada. KEV_DATE_FACTS=1 acrescenta uma frase por cada par de datas no estado (“June 26, 2026 is 8 days before July 4, 2026”). Nas perguntas da política de prazos isto leva o Kev-9B de 0.80 para 0.90 (Jev 0.93). Nenhuma das tabelas o usa.
Conjuntos de teste de outras pessoas. evals/external/ contém conjuntos de teste de outros projetos, convertidos para este formato, com os seus resultados Jev ao vivo publicados. Alguns foram avaliados em versões anteriores dos pesos do Kev, que a coluna Kev nomeia. Três foram removidos por não poderem servir de gate, e as fichas de modelo mantêm os números com que os seus lançamentos foram decididos: os tickets de apoio sintéticos do scienthoon em 2026-09-27 (texto com templates; uma das suas três perguntas depende de uma regra que o texto não indica) e, em 2026-09-30, o WANLI (wanli-v1, wanli-v2: um quarto dos pares são pares que os dois anotadores do WANLI etiquetaram de forma diferente, com o gold fixado num deles) e as avaliações públicas da TypeSafe (typesafe-v1: o gold é a resposta média de dois modelos de fronteira fechados, e em 89 perguntas não consegue distinguir checkpoints).
| Suite | O que é | Jev | Kev |
|---|---|---|---|
| SemIf | 144 decisões de autoria própria | 0.965 | 0.917 (Kev-9B em v7-base) |
As etiquetas do SemIf resistem, mas está perto da saturação: cada checkpoint do Kev-27B acerta em 130 das 144, por isso é uma verificação de sanidade, não uma forma de ordenar modelos.
Desempenho em serviço
Escolhe a GPU consoante o modelo:
| Modelo | GPU ($/h) | 6 perguntas, texto curto | 5 perguntas, texto de 2,200 tokens | Pedidos/s, 64 clientes |
|---|---|---|---|---|
| Kev-0.8B | L4 (0.80) | 22.7 / 16.1 ms | 108.6 / 32.3 ms | 62.8 |
| Kev-4B | L40S (1.95) | 41.5 / 27.7 ms | 145.2 / 43.0 ms | 51.4 |
| Kev-4B | H100 (3.95) | 18.1 / 12.9 ms | 89.4 / 22.5 ms | 100.8 |
| Kev-9B | L40S (1.95) | 66.4 / 42.7 ms | 235.6 / 57.5 ms | 32.7 |
| Kev-9B | H100 (3.95) | 24.0 / 16.6 ms | 88.5 / 26.4 ms | 79.5 |
| Kev-27B | B200 (6.25) | 46.5 / 32.2 ms | 178.0 / 52.1 ms | 44.2 |
| Kev-27B | H200 (4.54) | 67.2 / 50.0 ms | 274.8 / 73.8 ms | 28.6 |
| Kev-27B | H100 (3.95) | 75.0 / 52.0 ms | 277.5 / 79.3 ms | 28.9 |
Os tempos são tempo de modelo por pedido (o latency_ms que a API devolve), mediana de 20, para um texto novo / o mesmo texto outra vez. O servidor coloca o texto em cache, por isso fazer mais perguntas sobre um documento já enviado só paga as perguntas. Os pedidos por segundo são para 64 clientes em simultâneo a enviar seis perguntas sobre um novo texto curto cada; o servidor agrupa-os em lotes. As linhas B200 e H100 do Kev-27B foram medidas na sua versão anterior, a mesma arquitetura servida em bf16 (runs/fused-27b-*); a linha H200 é o checkpoint atual (runs/serving-27b-r23). O tempo de rede é à parte: cerca de 65 ms por ida e volta através de um endpoint web do Modal na mesma região.
Uma L4 chega para o Kev-0.8B mas é demasiado lenta para o Kev-4B. A A100 é mais lenta do que a L40S aqui e custa mais. O Kev-9B precisa de cerca de 17 GB de memória de GPU e o Kev-27B de 51 GB de pesos (cerca de 66 GB com os buffers de lote); sob carga o Kev-27B está limitado pela computação, e uma B200, H200 ou H100 custa mais ou menos o mesmo por pedido. Em CUDA, instala flash-linear-attention para os modelos Qwen3.5 (o kev_serve.py e as imagens Modal já o fazem).
Em Apple Silicon, uv sync --extra serve instala o MLX e o servidor usa-o automaticamente. Cinco perguntas sobre um texto de ~270 tokens num M5 (32 GB):
| Modelo | Texto novo | Mesmo texto outra vez |
|---|---|---|
| Kev-0.8B | 149 ms | 28 ms |
| Kev-4B | 721 ms | 136 ms |
Os documentos longos são lidos para a cache 1,024 tokens de cada vez, por isso a memória mantém-se próxima dos pesos. Com um documento de 65,000 tokens, o Kev-0.8B demora 21.2 s na primeira vez e 202 ms depois disso, com um pico de 3.8 GB, e o Kev-4B 84.5 s e 716 ms a 13.0 GB (runs/mlx-long-states; as fichas de modelo têm todos os comprimentos). O Kev-9B ainda não foi medido desta forma.
Os checkpoints de adaptador são integrados na base à medida que carregam, o que mantém brevemente uma segunda cópia dos pesos. Os checkpoints de pesos completos como o Kev-27B carregam tal como estão guardados, sem nada fundido, por isso o carregamento só precisa dos pesos. Verificámos isto no Kev-4B escrito como pesos bf16 completos: o carregamento atingiu um pico de 8.4 GB para 8.4 GB de pesos, contra 15.9 GB no percurso do adaptador. As suas respostas coincidiram exatamente com o percurso do adaptador assim que ambos têm os mesmos valores bf16, e mantiveram-se dentro de 0.015 do percurso fp32 em 60 perguntas (runs/mlx-full-4b). Os pesos do Kev-27B são 51 GB. Pelas mesmas medições precisa de cerca de 51 GB mais memória de trabalho, por isso um Mac de 64 GB está no limite e um Mac de 96–128 GB deve caber. Ainda não o corremos num Mac tão grande. A primeira versão do Kev-27B, um adaptador, correu desta forma num M5 Max de 128 GB, igualando a precisão publicada (obrigado a Sean Connelly, #175).
O servidor corre em bf16 em GPUs e Macs. As suas probabilidades diferem do percurso fp32 que as avaliações publicadas usam em, no máximo, cerca de 0.03 numa GPU e 0.05 num Mac, e a resposta mais provável muda em cerca de uma pergunta em 300. Define KEV_DTYPE=fp32 para o caminho exato. O /v1/models reporta o backend e a precisão em uso. uv run modal run modal_app.py::serving --run jaredpalmer/kev-4b --gpu L40S --name <name> mede uma linha da tabela na tua própria conta (as linhas acima: runs/serve-*, runs/grouping-4b-h100, runs/fused-27b-*, runs/serving-27b-r23).
Limitações
- A calibração é uma única temperatura. Não consegue reordenar as confianças, por isso a proporção de decisões em novas fontes que podes automatizar com um orçamento de erro de 5% (0.52–0.69 para o Kev-4B, o 9B e o 27B) continua abaixo dos 0.70 do Jev. Testa um limiar de probabilidade nos teus próprios dados antes de confiares nele.
- As perguntas de conhecimento são determinadas pelo modelo base. O MMLU é 0.73 para o Kev-9B contra 0.90 do Jev, e o MMLU-Pro 0.59 contra 0.84.
- O ajuste fino pode piorar o modelo base em tarefas individuais. A aritmética de datas foi o caso mais claro (issue #8); treinar com contagens de dias indicadas mais
KEV_DATE_FACTS=1recupera-a. - Alterar a ordem das opções pode mudar uma resposta. O isolamento das perguntas não impede isto.
- O Kev-0.8B, o 4B e o 9B treinaram sobretudo em, no máximo, 384 tokens de estado e 1,024 tokens para o estado mais uma pergunta (os seus ajustes finos de documentos e skills em estados até 7,552 tokens), e o Kev-27B em estados até 32,768 tokens. O serviço permite um estado de 65,536 tokens; o comprimento de contexto validado de cada modelo está em Modelos.
- Num Mac, as respostas demoram centenas de milissegundos, não dezenas. O Kev-27B precisa de uma GPU de 80 GB. Num Mac precisa de cerca de 51 GB mais memória de trabalho; esperamos que um Mac de 96–128 GB o comporte, mas não medimos nenhum.
- O Kev-27B parte de um modelo pós-treinado cujos dados de treino não conhecemos.
Desenvolvimento
uv run --extra serve python -m pytest tests/test_unit.py tests/test_research.py tests/test_generators.py tests/test_conventions.py \
    tests/test_documents_tools.py tests/test_hard_v1.py tests/test_devtools_v1.py tests/test_breadth_v1.py tests/test_rounds.py tests/test_skill_scripts.py -q   # no weights, no server; what CI runs
KEV_BASE_URL=http://127.0.0.1:8009 uv run --extra serve python -m pytest tests/test_api.py -q   # against a running server
cd playground && npm run lint && npx next typegen && npx tsc --noEmit -p .
Os testes da API correm os pedidos de exemplo da TypeSafe e o SDK oficial contra o teu servidor local. O PLAN.md é o plano de investigação: o que aprendemos, as regras que cada experiência segue e uma linha por ronda. O registo completo (cada experiência, os critérios definidos antes de correr e como saiu) está na tag git research-archive-2026-09-24.
Geração anterior (Qwen3) e o protótipo
A primeira família Kev usou bases Qwen3 com os mesmos dados e definições. Esses pesos continuam publicados e correm em PyTorch simples num Mac, mas já não são desenvolvidos.
| Modelo | Base | Precisão: fontes treinadas | Precisão: novas fontes | Brier: novas fontes | Ficha de modelo |
|---|---|---|---|---|---|
Kev-0.6B (Qwen3) — jaredpalmer/kev-0.6b |
Qwen3-0.6B-Base | 0.801 / 0.808 | 0.620 / 0.642 | 0.536 / 0.483 | Detalhes |
Kev-4B (Qwen3) — jaredpalmer/kev-4b@qwen3 |
Qwen3-4B-Base | 0.854 / 0.856 | 0.790 / 0.806 | 0.328 / 0.294 | Detalhes |
Kev-8B (Qwen3) — jaredpalmer/kev-8b |
Qwen3-8B-Base | 0.863 / 0.870 | 0.796 / 0.780 | 0.337 / 0.327 | Detalhes |
O Kev-0.5B original usava o Qwen2.5-0.5B e é mantido como referência; vê a sua ficha de modelo.
Resolução de problemas
- Se o MPS ficar sem memória durante o treino, verifica que estás a correr apenas um trabalho. Não atives
output_hidden_statesnem acrescentes tokens com otrainable_token_indicesdo peft; ambos já causaram problemas de memória aqui. - Se o playground carregar mas os botões não funcionarem, usa
localhost:3001. O Next.js verifica os nomes de anfitrião de desenvolvimento. Outros anfitriões precisam de uma entrada emallowedDevOriginsnoplayground/next.config.ts. - Se o carregamento do conjunto de dados reportar
Dataset scripts are no longer supported, usalegacy-datasets/banking77. Este repositório já o usa.
Autores
- Jared Palmer (@jaredpalmer)
Construído com Devin. Obrigado a Archer Hume pelo texto sobre a arquitetura, à TypeSafe pelo desenho da API e à Qwen pelos modelos base.
Trabalho relacionado: Hydragen, DeFT, FIRST.
Licença
Apache-2.0. Os modelos base Qwen3, Qwen3.5 e Qwen3.8 também são Apache-2.0. Os conjuntos de dados de treino têm as suas próprias licenças; vê as fichas de modelo.