小巧的、类 Jev 的决策模型,你可以自己训练、自己运行。
Kev 是一族建立在 Qwen3.5 和 Qwen3.8 上的小型决策模型,基于 Jev’s Architecture Unmasked 里描述的架构。你可以用预训练权重,也可以自己训练。API 与 TypeSafe 的 System One 一致,所以你可以把他们的 Python SDK 指向你自己的本地服务器。
亮点
- 一次请求里同时问是非题(
noul)、多选题(choice)和评分题(score)。这些问题共享文本,但彼此读不到对方。 - 默认输出校准概率:每个 checkpoint 都带一个拟合好的温度。
- 可直接替换 Jev:TypeSafe Python SDK 无需改动就能对 Kev 服务器使用。
- 四种规模,一起作为 Kev 1.0 发行:从能在笔记本上跑的 0.8B 到面向单张数据中心 GPU 的 27B。
- 文档最长 65,536 tokens,支持 CUDA,也支持 Apple Silicon 上的 MLX。每张模型卡都说明在准确率下降之前文档能有多长。
- 在你自己的标注样本上微调。一个 coding-agent 技能在 Modal 上跑通整个闭环,从找出你的问题到服务结果。
- 一条命令部署你自己的 HTTPS 端点。空闲时缩容到零。
- 先在浏览器里试: huggingface.co/spaces/jaredpalmer/kev。
模型
从 Kev-4B 开始。有更大的 GPU 就转 Kev-9B,有 80 GB GPU 且想要最准确的 Kev 就转 Kev-27B。当体积比准确率更重要时用 Kev-0.8B。
| 模型 | 基座(许可证) | 可在:CUDA 上运行 | 可在:Mac (MLX) 上运行 | 已验证上下文 | 留出数据集:指数 | 模型卡 |
|---|---|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base (Apache-2.0) | L4,任何 4 GB GPU | 任何 Apple Silicon Mac;实测到 65k tokens | 8,192 | 23.3 | 详情 |
| Kev-4B | Qwen3.5-4B-Base (Apache-2.0) | L40S, H100 | 32 GB Mac;实测到 65k tokens | 8,192 | 38.0 | 详情 |
| Kev-9B | Qwen3.5-9B-Base (Apache-2.0) | L40S, H100 | 32 GB 或更大的 Mac(预期,未实测) | 8,192 | 41.0 | 详情 |
| Kev-27B | Qwen3.8-27B,后训练版 (Apache-2.0) | B200, H200, H100 80 GB | 96–128 GB Mac(预期,未实测) | 65,536 | 52.3 | 详情 |
| Jev | 托管 | TypeSafe 的 API | – | – | 54.0 | – |
「留出数据集」是社区 Decision Index 的随机校正指数,在 breadth-v1 的测试划分上打分:五个领域里 14 个公开数据集,没有任何 Kev 训练过。「已验证上下文」是以 tokens 计的最长文档,在该长度上,真实合同(CUAD)上的准确率与同一模型在 8k tokens 时的准确率相比保持在 3 个点以内(95 % 下界);每张模型卡都有按长度的测量。
| 模型 | 准确率:新来源 | 准确率:已训练来源 | Brier:新来源 |
|---|---|---|---|
| Kev-0.8B | 0.648 / 0.697 | 0.827 / 0.838 | 0.481 / 0.416 |
| Kev-4B | 0.817 / 0.838 | 0.873 / 0.865 | 0.269 / 0.242 |
| Kev-9B | 0.820 / 0.852 | 0.874 / 0.873 | 0.289 / 0.217 |
| Kev-27B | 0.851 / 0.889 | 0.865 / 0.866 | 0.225 / 0.156 |
| Jev | 0.857 / – | 0.845 / – | 0.211 / – |
每个单元格是开发 / 测试。「新来源」是指 Kev 训练时从未见过的数据集和政策规则。它是这里最接近你自己问题的一类。「已训练来源」是指 Kev 训练所用数据集的留出样本。我们用开发集选 checkpoint,每个已发布模型只读一次各自的测试集。Jev 只在这两个套件的开发集上跑过。Brier 给整个概率分布打分,而不只是最高答案;越低越好。
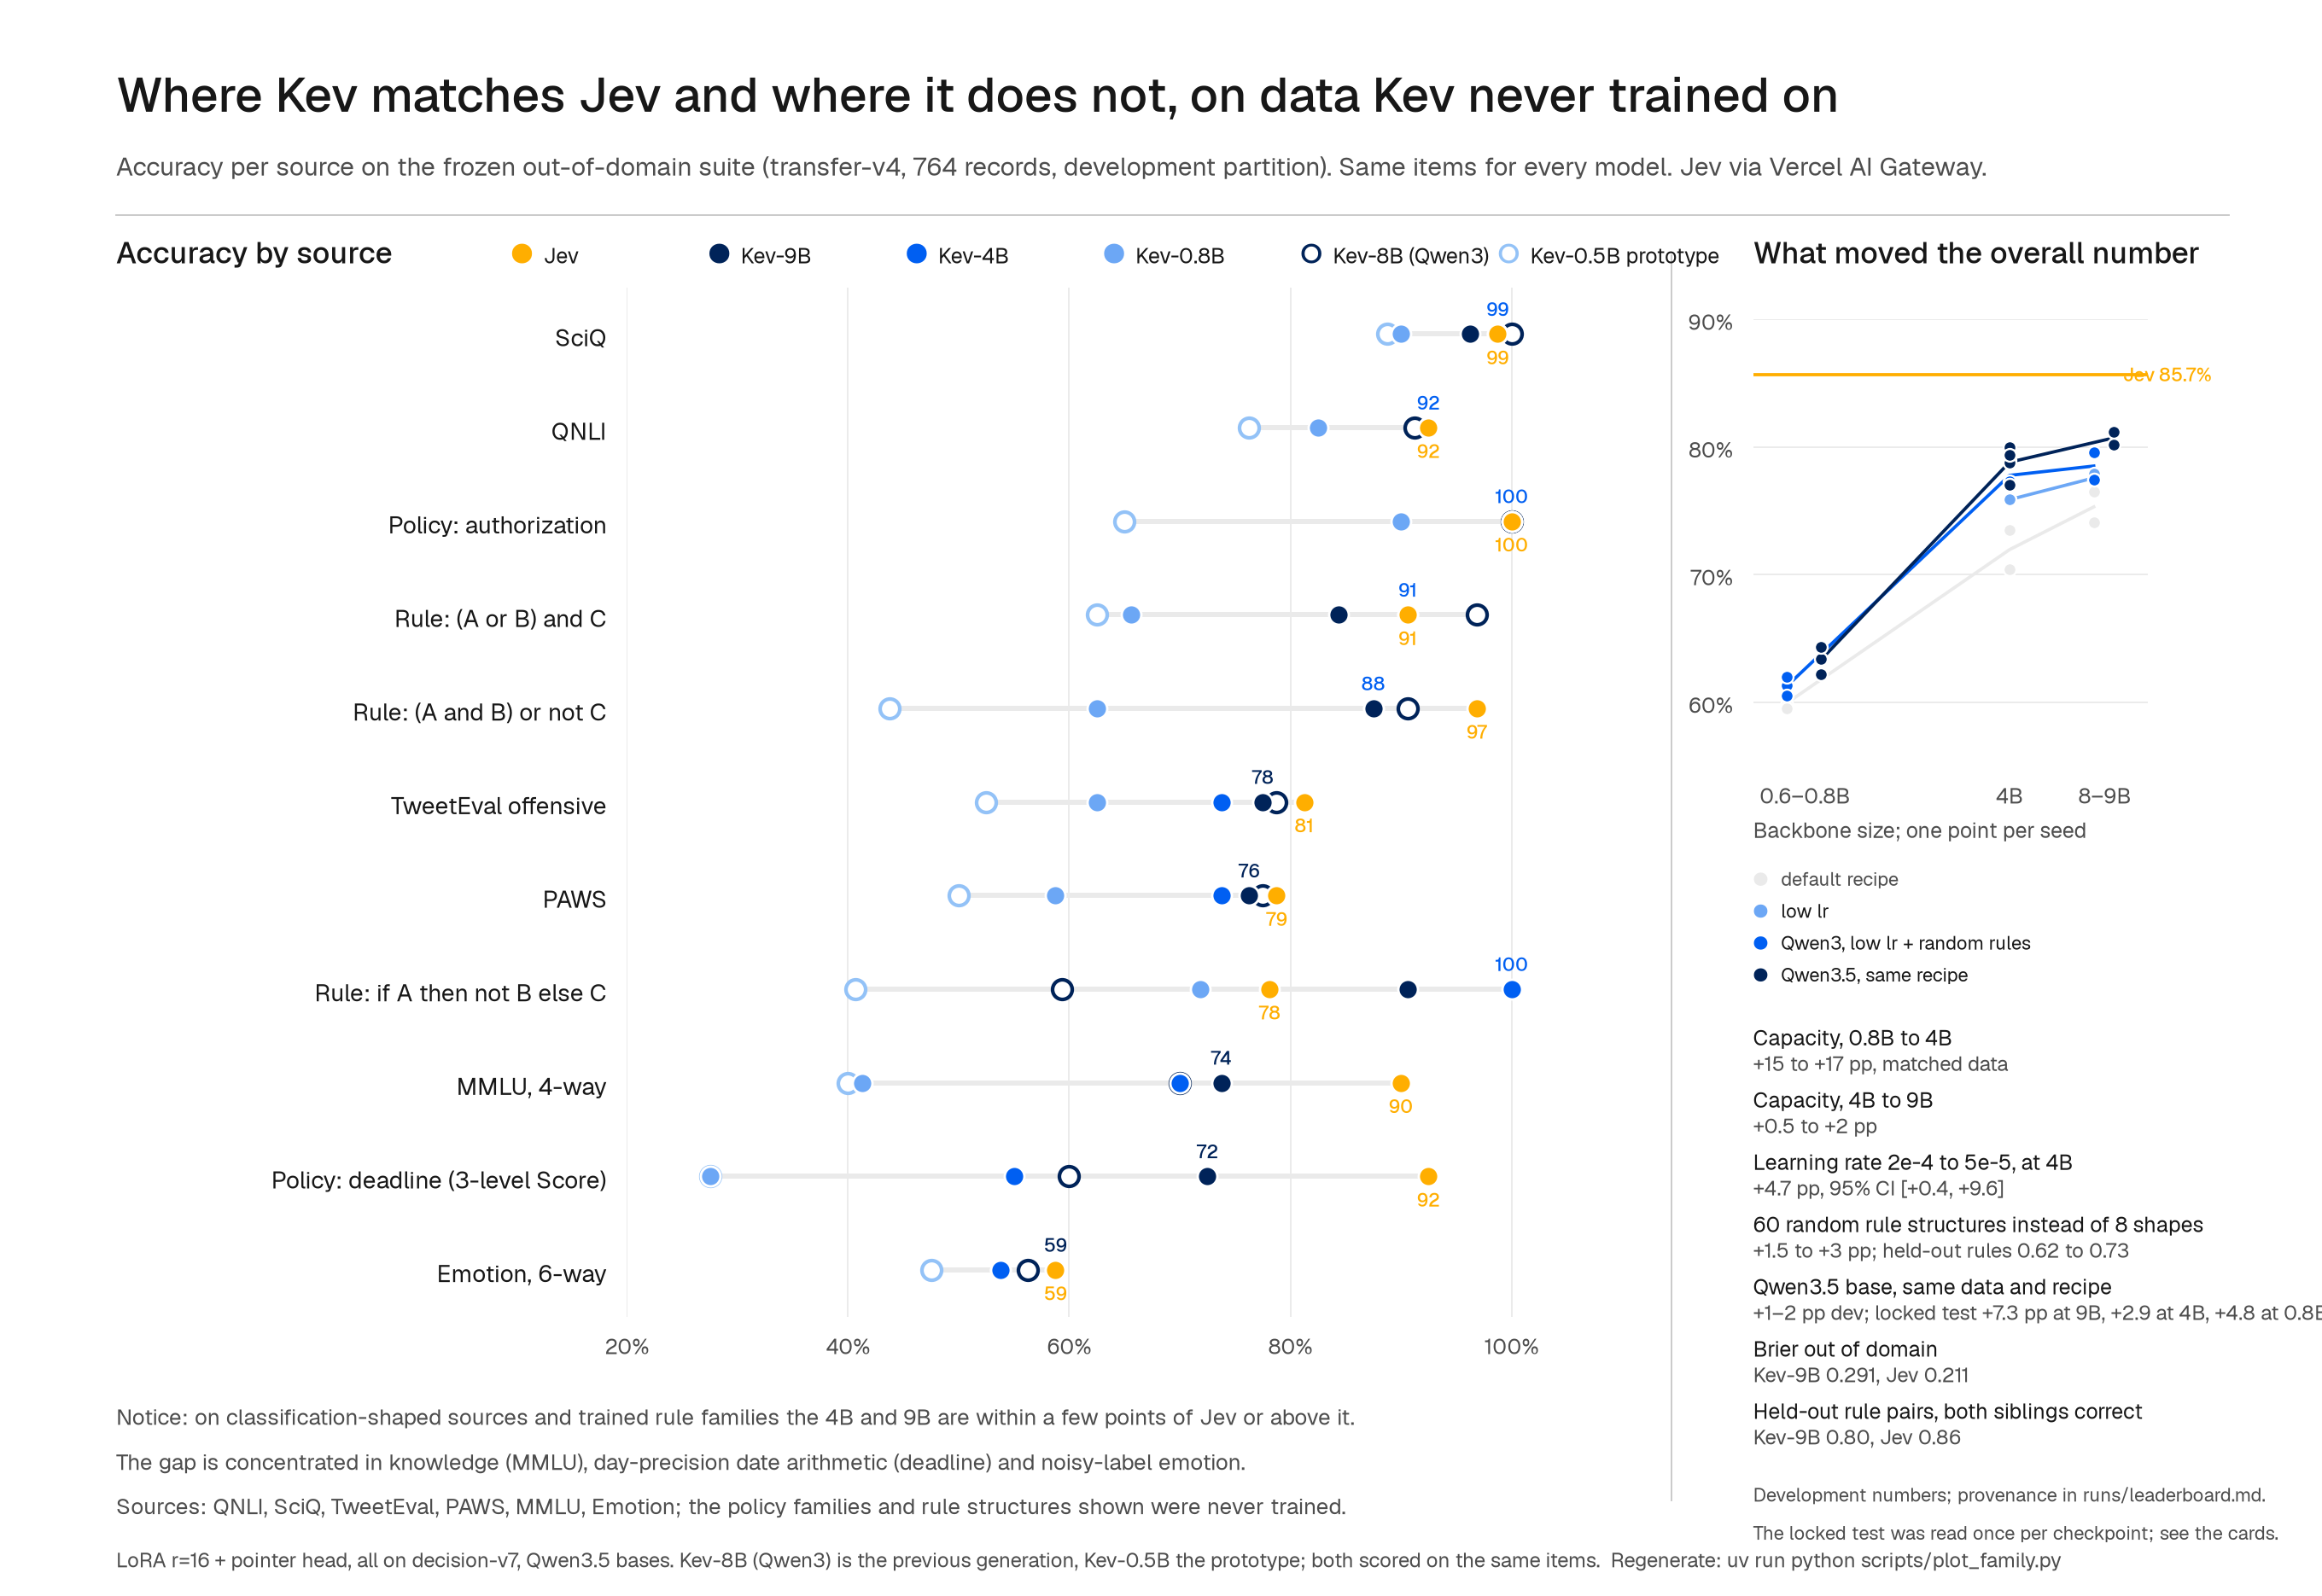
在新来源上,Kev-27B 与 Jev 相差一个点以内(0.851 对 0.857),Kev-4B 和 Kev-9B 在四个点以内。我们不知道 Jev 训练用了什么,所以这不是两种架构的受控比较。What to Expect 说明 Kev 在哪些地方与 Jev 一样好、哪些地方不是。
Kev-0.8B、4B 和 9B 从 Qwen 基座模型出发,共用一个训练配方:在冻结基座上挂一个小适配器。Kev-27B 从 Qwen 的后训练发布版出发,我们不知道它训练用了什么;它的每一个权重都经过微调,所以发布出来的是 51 GB 完整权重,而不是适配器。每张模型卡都有完整配方、全部结果,以及作为 Hub tag 保留的早期版本。
Kev 1.0
上面四个模型一起作为 Kev 1.0 发布。每个 Hub 仓库都有一个 v1.0 tag,所以 --run jaredpalmer/kev-4b@v1.0 总是加载同一批权重,而 GitHub release kev-1.0 带有 0.8B、4B 和 9B 的 checkpoint 及 SHA-256 校验和。Kev-27B 的 51 GB 权重对 release 资产来说太大,只在 Hub 上。
| 模型 | 权重的 Hub revision | 温度 | 训练所用 state 最长到 |
|---|---|---|---|
| Kev-0.8B | 9a45d25e |
2.35 | 7,552 tokens |
| Kev-4B | 139fdd94 |
2.41 | 7,552 tokens |
| Kev-9B | b5d8c18e (v2) |
2.19 | 7,552 tokens |
| Kev-27B | 28be62e9 (v2, 完整权重) |
1.32 | 32,768 tokens |
Kev 1.0 没有新训练任何东西。它固定了下一代 Kev 将要对标的 checkpoint、模型卡、评测套件和服务代码。release notes 列出上个家族发布以来的变化,以及已知哪些地方效果不好。
快速开始
在浏览器里试
Hugging Face Space 运行 Kev-4B 和 Kev-0.8B,无需安装任何东西。
在本地运行
你需要 Python 3.12 或 3.13 和 uv。仓库的 .python-version 让 uv sync 使用 3.13;torch 还没有 3.14 的 wheel。
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
这会在你的机器上启动 Kev-4B:有 GPU 就走 CUDA 或 ROCm,Apple Silicon 上走 MLX。首次运行会下载适配器和基座模型。--run 也接受本地 checkpoint 目录或像 jaredpalmer/kev-4b@qwen3 这样的 Hub revision。
在另一个终端里,给它发一张工单:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
来自 Kev-4B 的示例响应,在 Apple M5 上以 bf16 运行:
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.34,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
}
这张工单提到了退货、延迟送达和账单问题,部门概率也如实反映了这一点。这就是 Kev 返回概率而不是单个标签的原因:你的代码可以把有把握的案例路由出去,把其余的交给人工。
从 Python 使用
如果你已经在调用 Jev,把客户端指向 Kev,其余代码保持不变。TypeSafe SDK 包含在 uv sync --extra serve 里:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
在你自己的数据上微调
已发布的模型是在公开数据集和生成的政策样本上训练的。如果你的问题看起来不一样,比如你自己的路由类别、你自己的升级规则或另一种语言,一次短微调通常比任何 prompt 改动都更有效。它还会把温度拟合到你的数据上,所以你据此设阈值的置信度是在你自己的标签上测量的。
可以期待什么:在一个示例支持工作负载上(三个问题、1,050 条生成记录、H100 上 15 分钟),微调把 Kev-4B 的准确率从 67.7% 提到 73.6%,并把 5% 误差预算下可自动化的决策比例从 34% 提到 48%(详情)。在真实数据上,对 5,219 条标注的消费金融投诉训练一个 epoch,把 Kev-4B 在它从未见过的投诉上的准确率从 0.804 提到 0.904。这类增益是分布内的:它们告诉你 Kev 学你的任务学得多好,而不是它在其他一切上表现如何。先确定你的数据集规模。只有 400 条记录时,示例工作负载上的增益落在噪声之内。
用 coding agent
npx skills add jaredpalmer/kev@kev-finetune然后让你的 agent「在我的支持工单上微调 Kev」。这个 kev-finetune 技能 会与你访谈,找出你的代码已经在向 Jev 或 TypeSafe 问的问题,转换你已有的标签,或用任意 LLM 生成足够的标签来测出增益,从已发布的 checkpoint 出发在 Modal 上微调,在留出切片上拟合温度,把结果与未改动的模型对比打分,部署一个端点,并在结束时拆掉一切。你不需要本地 GPU,也不需要克隆这个仓库。一次 Kev-4B 训练在 H100 上约 1 美元。
手工做
该技能的 README 是给人类看的同一套配方:六个简短的标准库脚本和一个 Modal 应用。若要从本仓库训练,把你的样本放进一个 JSONL 文件,每行一个请求。它的形状与 API 请求相同,只是每个问题上多一个 label:
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
   "priority": {"type": "score",  "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}
对 choice,标签是选项名;对 noul,是 true 或 false;对 score,是从 0 开始的档位位置。留出文件的 10–20% 用于评测。
然后用 --init_from 从已发布的 checkpoint 出发:
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine

uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
uv run --extra serve python -m kev.serve --run runs/mine --port 8009
--init_from 在训练前从已发布模型加载适配器和指针头,这样你保留 Kev 已知的东西,并在其上叠加你的领域。改从基座模型出发会把它丢掉:在一个用户对 836 个支持工具决策的测试中,从基座微调在 Kev 自己的评测集上得 0.33,而已发布模型得 0.84;同样的数据用 --init_from 在那里保持 0.83,并在新领域上达到 0.88。使用比从零配方更小的学习率(2e-5 是个好起点),并让 --base 与你出发的 checkpoint 匹配;trainer 在加载任何东西之前会检查基座、revision、LoRA rank 和指针头大小是否一致。
bf16 下的 --batch 1 --accum 8 能把 0.8B 模型放进 4 GB GPU。benchmark 会按问题类型报告准确率、Brier 分数和校准,所以你能看出微调帮到了你的哪些问题。你出发的 checkpoint 记在 runs/mine/training_config.json。在 Mac 上一次只跑一个训练任务;同一块 Apple GPU 上两个任务会慢很多。
部署你自己的端点
要得到 HTTPS 端点而不是本地服务器,你不需要这个仓库,只需要一个 Modal 账号:
pip install modal && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
这会在 L40S 上服务 Kev-4B,地址是 https://<your-workspace>--kev-api.modal.run,API 与上面相同,前面加 Authorization: Bearer <key>。空闲时缩容到零,所以闲置的端点不花钱。空闲后的第一个请求要等约 35 秒让容器启动。KEV_MODEL=jaredpalmer/kev-9b 在其合适的 GPU 上服务另一个模型;Kev-27B 走 B200,回落到 H200 或 H100。如果你用 coding agent,npx skills add jaredpalmer/kev@kev-deploy 做同样的事,并把 URL 接进你的代码。skills/kev-deploy 有 GPU 与成本表。
你用 kev-finetune 技能微调出来的模型,用自己的 Modal 应用以同样方式部署(KEV_SERVE_SECRET=kev-serve-key KEV_SERVE_RUN=<run> modal deploy scripts/kev_modal.py;见 它的部署指南)。要把 Kev 托管在自己的机器上,改为在一台 GPU 机器上跑 Run It Locally 里的 kev.serve,加 --host 0.0.0.0,并把它放在你自己的代理之后;Serving Performance 说明该选哪块 GPU。
What to Expect
准确率。 在下图 11 个新来源类别中的 9 个上,Kev-27B 与 Jev 相差三个点以内,或领先它。在路由、蕴含和科学问题这类分类形状的来源上,Kev-4B 和 Kev-9B 也差不多接近。知识问题主要取决于基座模型:在 MMLU 上 Kev-9B 得 0.73,Kev-27B 以 0.90 追平 Jev,但在更难的 MMLU-Pro 上 Kev-27B 得 0.675,而 Jev 为 0.840。更小的模型在日精度日期算术上也落后。
置信度。 每个 checkpoint 都带一个拟合好的温度,所以其概率默认是校准的。按服务状态,Kev-9B 对新来源问题有 2.4% 在错误答案上给出至少 0.9 的概率,而 Jev 是 3.7%。Jev 对自己的答案排序仍然更好:在 5% 误差预算下,Kev-4B、9B 和 27B 能自动化 0.52–0.69 的新来源决策,Kev-0.8B 是 0.14,Jev 是 0.70。在依赖某个阈值之前,先在你自己的数据上检查它。
速度。 Kev-4B 在 H100 上用 18.1 ms 模型时间回答关于一段新短文本的六个问题,在 L40S 上是 41.5 ms,一个容器在 H100 上每秒服务约 101 个请求。在 Apple M5 上,Kev-4B 五个问题要 721 ms,文本重复且来自缓存时是 136 ms。Serving Performance 有每块 GPU 和每个 batch size。
长度。 Kev-0.8B、4B 和 9B 主要在最多个 384 tokens 的 state 上训练,其文档和技能微调里有更长的(最多 7,552 tokens),Kev-27B 则训练到 32,768。服务器接受最长 65,536 tokens 的 state,每个问题再各加 8,192,遇到更长的会以 422 拒绝而不是截断它。每个模型在超出其训练长度后还能准确多远,就是 Models 里的「已验证上下文」列。对 Kev-0.8B、4B 和 9B 那列是 8,192 tokens:在 16k 时真实合同上的测量已无法排除超过 3 个点的下降,在 32k 时三者都可测地不如 8k 准确。Kev-27B 保持到 65,536-token 上限。在最长 64k tokens 的真实合同(CUAD)上 Kev-27B 得 0.874,它在那种情况下比在短文本上更不可靠;它的模型卡有按长度的数字。
Playground
服务器运行起来后,再开一个终端。你需要 Node 20.9+:
cd playground
npm install
npm run dev -- -p 3001
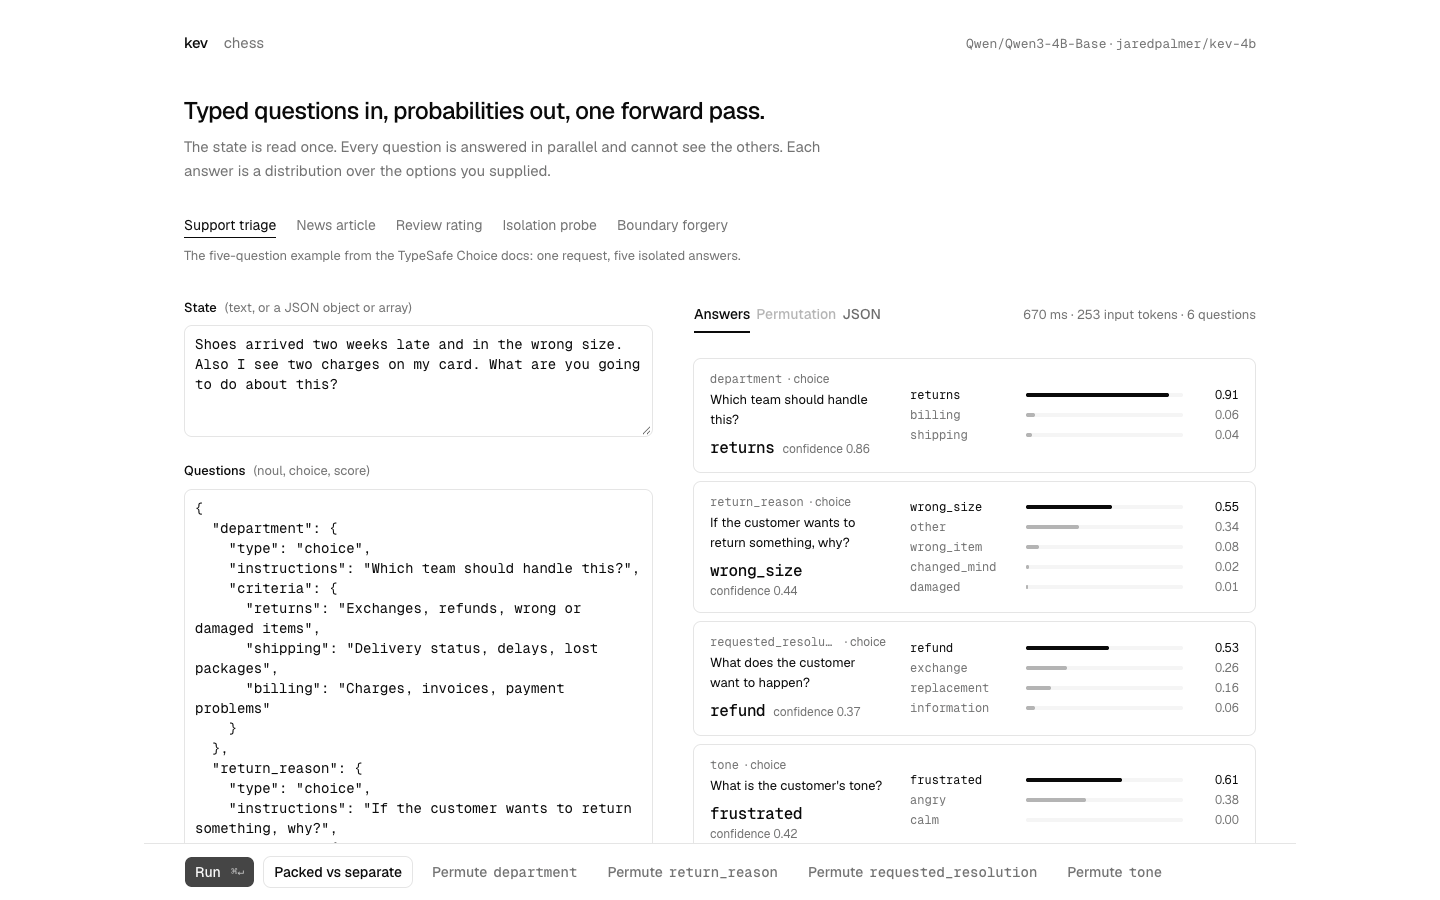
打开 localhost:3001,载入一个预设,编辑文本和问题。按 ⌘↵ 运行。 「Packed vs separate」比较一次问所有问题与一次问一个。「Permute」用一个 Choice 问题跑六种选项顺序。还有用于测试问题隔离和假分隔符 token 的预设。
还有一个国际象棋演示。棋盘是输入,合法着法是 Choice 选项,一个 Score 问题给局面打分。你可以和 Kev 对弈,也可以让它自己下。对局保存在 localStorage 里。
API
POST /v1/systemone
state 是要评估的文本。每个问题都有指令,在需要时还有一组可选的答案。
{
  "state": "…",                          // string | object | array — the content to evaluate
  "model": "kev-latest",
  "questions": {
    "<id>": {                            // you choose the id; the model never sees it
      "type": "noul" | "choice" | "score",
      "instructions": "…",               // string | object | array, optional
      "criteria": …                      // noul: {true?, false?}  choice: {option: description|null}  score: [level, …]
    }
  }
}| 类型 | 判据 | 答案 |
|---|---|---|
noul |
true 和 false 的可选描述 |
noul:为是的概率 |
choice |
1–255 个选项名,各带一个描述或 null |
choice:最可能的选项;probabilities 和 confidence |
score |
1–255 个描述,从最低到最高有序 | score:平均档位索引,从 0 开始;legend、probabilities 和 confidence |
对 K > 1 个选项的 Choice,置信度是 (p_max − 1/K) / (1 − 1/K)。单个选项的置信度为 1。Score 置信度是 max(0, 1 − E|level − mode| / D):mode 是最可能的档位,D 是档位上均匀分布到其中点的平均距离(三个档位时为 2/3),所以全部概率落在一个档位时给出 1,均匀或更分散时给出 0。两个公式都来自 TypeSafe 的参考适配器(system-one-adapter 0.2.1)。两个字段都不是实测的准确率。
对象和数组会被转换成带标签的文本。用户输入里类似分隔符的字符串在 tokenize 之前会被转义。无效请求返回 422,超过 65,536 tokens 的 state 也一样:服务器从不会静默丢弃文档的一部分,错误会给出该 state 的 token 数和上限。usage.output_tokens 计的是序列化答案里的 tokens,不是生成的 tokens。
| 方法 | 路径 | 用途 |
|---|---|---|
GET |
/v1/models |
模型卡(name、description、release_date)加上已加载 checkpoint 的详情 |
POST |
/v1/systemone/permute |
用不同选项顺序跑一个 Choice 问题(n_perm 1 到 64,默认 6) |
POST |
/v1/systemone/separate |
每个问题各跑一次前向 |
一个请求可以带任意数量的问题。服务器按一个 token 预算一批地跑它们(每次前向一行最多 16,384 tokens,该次前向中每个问题把缓存的文档计一次),所以内存不随问题数增长,答案也不依赖如何切分。每个响应都带一个 x-typesafe-request-id 头。服务器绑定到 127.0.0.1(--host 0.0.0.0 接受其他机器),默认开放;设置 KEV_API_KEY 要求 /v1/* 上带 Authorization: Bearer <key>,因为 TypeSafe 客户端总是会发它。
| 变量 | 作用 |
|---|---|
KEV_TEMPERATURE=1.0 |
返回原始概率而不是校准后的概率 |
KEV_DATE_FACTS=1 |
追加 state 中任意两个日期之间的天数(见 Benchmarks) |
KEV_TRUNCATE_STATES=1 |
读取更长 state 的前 65,536 tokens 而不是拒绝它;此时每个响应都带 truncated 和 usage.state_tokens / state_tokens_used |
KEV_DTYPE=fp32 |
服务评测所用的确切 fp32 路径(GPU 上默认是 bf16) |
KEV_API_KEY |
要求 bearer key |
How It Works
每个 checkpoint 都是一个 rank-16 LoRA 适配器加一个在 Qwen 基座模型上的小指针头。在纯注意力基座(Qwen3)上,state 和问题进入一条 token 序列:
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
注意力掩码让一个 token 能读到 state 和它自己的问题,但读不到其他问题或未来的 token。每个问题的 position ID 紧接在 state 之后重新开始。这让模型把 state 处理一次,并各自独立地回答每个问题。
Qwen3.5 和 Qwen3.8 把注意力层与 Gated DeltaNet 层混合,后者是循环的、忽略注意力掩码。对这类模型(也就是当前每一个 Kev),每个问题各跑一行:state 后接该问题,position 与上面相同。各行相互独立,所以隔离是精确的,服务器和 DecisionModel.probs() 把 state 计算一次,并为每一行复用它。forward()(kev.benchmark 打分、每个已发布数字都来自它)保留普通行,每个问题把 state 跑一次;两者在 fp32 舍入范围内一致。在纯注意力模型上,上述行与掩码给出完全相同的概率(tests/test_model.py)。
Kev-27B 在 Qwen/Qwen3.8-27B 上用同样的设计,有两处不同。它的基座是 Qwen 的后训练发布版而不是 -Base checkpoint,我们不知道它后训练用了什么。并且每个主干权重都被训练,而不只是适配器,且以 bf16 保存,所以 checkpoint 就是整个模型:51 GB 的 bf16 权重加指针头。它只以 bf16 服务(含服务缓冲常驻约 66 GB),这也是它需要 80 GB 卡的原因。在 Apple Silicon 上 MLX 后端按原样加载这些权重,不做合并(见 Serving Performance);我们预计它装得进 96–128 GB 的 Mac,但尚未测量。它在 H200 上服务时的概率与评测路径保持在 0.022 以内(runs/serving-27b-r23)。
指针头把每个选项 </opt> 的隐状态与问题的 <decide> 隐状态打分。softmax 把分数转成概率。因为 <decide> 在最后,它能注意到完整的选项列表。
训练在正确答案上使用交叉熵。适配器和指针头一起训练;基座其余权重保持不变(Kev-27B 把它们全都训练)。训练样本和 API 请求使用相同的文本格式。没有使用任何 Jev 输出做训练。
一起问和分开问产生概率相差在 4e-6 以内(fp32 测试)。这不意味着选项顺序无关紧要:一个问题内的选项仍可能相互影响。见模型代码和一致性测试。
Training
已发布的模型共用一个基础训练集 decision-v7:来自十个公开数据集的 10,000 条样本、896 条生成的政策样本,以及 1,680 条来自 60 个生成规则结构的样本。Kev-0.8B、4B 和 9B 在其上训练两个 epoch,LoRA rank 16 加交叉熵。学习率对 0.8B 是 1e-4,对 4B 和 9B 是 5e-5。在这些混合基座上,适配器覆盖注意力、MLP 和 DeltaNet 投影;kev.train 从模型配置里挑出正确的目标。
Kev-0.8B、4B 和 9B 随后从各自已发布的 checkpoint 做简短的后续微调,走的就是你会用于自己数据的同一条 --init_from 路径:声明天数计数或被去掉决定证据的生成案例(三者都有),然后是真实文档和生成的技能数据(三者都有;Kev-9B 自 v2、2026-09-30 起)。Kev-27B 的训练方式不同。基座的每个权重都在 8 张 H200 上对一个 145,840 条记录的语料微调一个 epoch(--full_ft 1,学习率 2e-6):Kev 自己的数据、文档、技能与开发者工具套件、公开数据集、授权任务家族,以及生成的长文档、工具路由、agent 日志和护栏记录,state 最多 32,768 tokens。结果随后与更早的适配器训练的 Kev-27B 按 0.85 对 0.15 平均。模型卡列出每个阶段及其数据与成本。
# sanity run, ~1 minute
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# the first stage of Kev-0.8B (~20 min on one H100; the Mac path works but is slow for Qwen3.5 bases)
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base --base_revision dc7cdfe2ee4154fa7e30f5b51ca41bfa40174e68 \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b

# the first stage of Kev-4B (one H100 via Modal, ~1 h; see below). Swap in Qwen/Qwen3-4B-Base for the previous generation.
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base --base_revision 1001bb4d826a52d1f399e183466143f4da7b741b \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
用 uv run python -m kev.train --help 看所有训练选项。已发布的模型不使用可选的 --perm_kl 或 --ord_w 损失。PLAN.md 记录了什么试过、什么有帮助、什么没有。
Modal
每次试验各拿一张 H100。你断开连接后研究仍在跑,完成后可以把结果下载下来:
uv run modal token new                                    # once; opens the browser
KEV_GPU=T4 uv run modal run modal_app.py::smoke           # end-to-end check, ~1 minute of GPU

uv run modal deploy modal_app.py                          # once; studies run on the deployed app and survive disconnects
uv run modal run modal_app.py::study \
    --suite evals/v7/decision-v7 --plan experiments/v7-final.json \
    --name my-study --transfer evals/v4/transfer-v4 --budget 30 --timeout 7200
uv run modal run modal_app.py::pull --name my-study       # results -> runs/my-study, ranked
Study plans 列出训练设置。每次试验都保存设置、代码 hash、数据集 hash 和结果。用开发结果选模型,而不是锁定的测试。选定最终候选后,你可以读一次它的测试结果:
uv run modal run modal_app.py::locked_test --trial my-study/00-trial-0 --name my-candidate # one read, everBenchmarks
evals/ 下的评测数据是冻结的:数据集版本和文件校验和记录在每个 manifest 里。大文件从 Hub 镜像下载,并对照这些 hash 校验。上面各表中的每个模型都在相同的条目上打分。本 README 和模型卡里的数字在 CI 中对照它们来源的已提交报告校验(docs/claims.json、uv run python scripts/verify_claims.py)。
| 套件 | 它测什么 |
|---|---|
decision-v7 |
来自十个训练数据集、生成的政策和规则结构的留出样本(「已训练来源」) |
transfer-v4 |
来自 Kev 从未训练过的数据集以及政策与规则类型的 764 条记录:QNLI、SciQ、PAWS、MMLU、Emotion、TweetEval、留出政策和规则(「新来源」) |
transfer-v9 |
transfer-v4 加上 10 路 MMLU-Pro、埋在无关文本里的记录,以及去掉了决定证据的「不可知」记录 |
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v4/transfer-v4 --out runs/my-eval      # new sources
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v9/transfer-v9 --out runs/my-eval-v9   # + MMLU-Pro, buried states, unknowable items
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v7/decision-v7 --out runs/my-eval-id   # trained sources
uv run python -m kev.benchmark --remote http://127.0.0.1:8009 --suite evals/v4/transfer-v4 --out runs/my-remote   # any System One endpoint, Jev included
这些命令使用开发数据。测试数据需要 --allow-test。benchmark 报告准确率、Brier 分数、校准误差、5% 误差预算下可自动化的决策比例、选项顺序变化和问题隔离。在不可知记录上,它报告模型仍以至少 0.9 置信度作答的频率(Kev-9B 0%,Jev 9%)。已发布的准确率数字使用 fp32 评测,而不是 bf16 服务路径。kev.jev 通过 Vercel AI Gateway 对 Jev 跑同样的问题,kev.compare 用配对 bootstrap 置信区间比较两次已保存的运行。
校准。 每个 checkpoint 存一个温度,指针头在模型加载时施加它。Kev-4B (2.41) 和 Kev-0.8B (2.35) 在各自的分布内开发集上拟合;Kev-27B (1.32) 和 Kev-9B (2.19) 在它们从未训练过的留出数据集上拟合。对两个较小模型在这些留出数据集上的一次重拟合经过测试,两个都没保留:它没有改善 Kev-4B,还让 Kev-0.8B 在其文档和技能套件上校准变差(模型卡有数字)。温度从不改变哪个答案胜出。在新来源上,它把 Kev-9B 的校准误差从 0.103 降到 0.041,把它的自信错误(概率 ≥ 0.9 的错误答案)从 8.2% 降到 2.4%,低于 Jev 的 3.7%。上面的准确率数字两种情况下都一样;Brier 数字是原始概率的。scripts/calibrate_checkpoint.py 还会报告一个折外估计,所以样本内拟合可以对照它没见过的记录检查。
日期。 Kev 无法可靠地做日期减法,但它能用给定的天数计数。KEV_DATE_FACTS=1 为 state 中每一对日期追加一句话(「June 26, 2026 is 8 days before July 4, 2026」)。在截止日期政策问题上,这把 Kev-9B 从 0.80 提到 0.90(Jev 0.93)。没有任何表使用它。
别人的测试集。 evals/external/ 装着来自其他项目的测试集,转成本格式,并附上它们已发布的实时 Jev 结果。有些是在更早版本的 Kev 权重上打分的,Kev 那一列的名称标明了这点。三个被移除,因为它们无法作为关卡,模型卡保留它们各自发布时所依据的数字:scienthoon 在 2026-09-27 的合成支持工单(模板化文本;它三个问题中有一个依赖文本未陈述的规则),以及 2026-09-30 的 WANLI(wanli-v1、wanli-v2:四分之一的配对是 WANLI 两位标注者标注不同的,gold 取其中之一)和 TypeSafe 的公开评测(typesafe-v1:gold 是两个闭源前沿模型的平均答案,在 89 个问题上它无法区分 checkpoint)。
| 套件 | 它是什么 | Jev | Kev |
|---|---|---|---|
| SemIf | 144 个手写决策 | 0.965 | 0.917(Kev-9B 在 v7-base) |
SemIf 的标签站得住,但它接近饱和:每个 Kev-27B checkpoint 都答对 144 个中的 130 个,所以它是一个健全性检查,不是给模型排名的方法。
Serving Performance
按模型选 GPU:
| 模型 | GPU ($/h) | 6 个问题,短文本 | 5 个问题,2,200-token 文本 | 请求/s,64 客户端 |
|---|---|---|---|---|
| Kev-0.8B | L4 (0.80) | 22.7 / 16.1 ms | 108.6 / 32.3 ms | 62.8 |
| Kev-4B | L40S (1.95) | 41.5 / 27.7 ms | 145.2 / 43.0 ms | 51.4 |
| Kev-4B | H100 (3.95) | 18.1 / 12.9 ms | 89.4 / 22.5 ms | 100.8 |
| Kev-9B | L40S (1.95) | 66.4 / 42.7 ms | 235.6 / 57.5 ms | 32.7 |
| Kev-9B | H100 (3.95) | 24.0 / 16.6 ms | 88.5 / 26.4 ms | 79.5 |
| Kev-27B | B200 (6.25) | 46.5 / 32.2 ms | 178.0 / 52.1 ms | 44.2 |
| Kev-27B | H200 (4.54) | 67.2 / 50.0 ms | 274.8 / 73.8 ms | 28.6 |
| Kev-27B | H100 (3.95) | 75.0 / 52.0 ms | 277.5 / 79.3 ms | 28.9 |
时间是每个请求的模型时间(API 返回的 latency_ms),20 次的中位数,分别为新文本 / 同一文本再来一次。服务器缓存文本,所以对已经发过的文档多问问题只为问题付费。每秒请求数是针对 64 个并发客户端、各自发送关于一段新短文本的六个问题;服务器把它们批处理。Kev-27B 的 B200 和 H100 行是在其上一版本上测的,相同架构以 bf16 服务(runs/fused-27b-*);H200 行是当前 checkpoint(runs/serving-27b-r23)。网络时间另算:经同一区域的 Modal web 端点,每个往返约 65 ms。
对 Kev-0.8B 来说 L4 足够,但对 Kev-4B 太慢。A100 在这里比 L40S 慢且更贵。Kev-9B 需要约 17 GB GPU 显存,Kev-27B 需要 51 GB 权重(含批处理缓冲约 66 GB);负载下 Kev-27B 受算力限制,B200、H200 或 H100 每个请求成本差不多。在 CUDA 上,为 Qwen3.5 模型安装 flash-linear-attention(kev_serve.py 和 Modal 镜像已经这么做)。
在 Apple Silicon 上,uv sync --extra serve 会安装 MLX,服务器自动使用它。在 M5(32 GB)上对一段约 270-token 文本问五个问题:
| 模型 | 新文本 | 同一文本再来一次 |
|---|---|---|
| Kev-0.8B | 149 ms | 28 ms |
| Kev-4B | 721 ms | 136 ms |
长文档以每次 1,024 tokens 读入缓存,所以内存贴近权重。对一份 65,000-token 文档,Kev-0.8B 首次要 21.2 s,之后 202 ms,峰值 3.8 GB,Kev-4B 是 84.5 s 和 716 ms,峰值 13.0 GB(runs/mlx-long-states;模型卡有每个长度)。Kev-9B 尚未用这种方式测量。
适配器 checkpoint 在加载时被折进基座,会短暂持有第二份权重。像 Kev-27B 这样的完整权重 checkpoint 按保存的样子加载,不合并任何东西,所以加载只需要权重。我们在写出的完整 bf16 权重 Kev-4B 上验证了这一点:8.4 GB 权重加载峰值 8.4 GB,而适配器路径是 15.9 GB。两者的答案在持有相同 bf16 值后完全一致,并在 60 个问题上与 fp32 路径保持在 0.015 以内(runs/mlx-full-4b)。Kev-27B 的权重是 51 GB。按同样的测量它需要约 51 GB 加工作内存,所以 64 GB Mac 是边界,96–128 GB Mac 应该能装。我们还没在那么大的 Mac 上跑过它。Kev-27B 的第一个版本(一个适配器)确实在一台 128 GB M5 Max 上这样跑过,与已发布的准确率一致(感谢 Sean Connelly,#175)。
服务器在 GPU 和 Mac 上以 bf16 运行。它的概率与已发布评测所用的 fp32 路径相差至多约 0.03(GPU)和 0.05(Mac),最高答案大约每 300 个问题改变一个。设 KEV_DTYPE=fp32 走确切路径。/v1/models 报告所用的后端和精度。uv run modal run modal_app.py::serving --run jaredpalmer/kev-4b --gpu L40S --name <name> 在你自己的账号上测表中的一行(上面各行:runs/serve-*、runs/grouping-4b-h100、runs/fused-27b-*、runs/serving-27b-r23)。
Limitations
- 校准只有一个温度。它无法重排置信度顺序,所以在 5% 误差预算下你能自动化的新来源决策比例(Kev-4B、9B 和 27B 为 0.52–0.69)仍低于 Jev 的 0.70。在依赖某个概率阈值之前,先在你自己的数据上测试它。
- 知识问题由基座模型决定。MMLU 上 Kev-9B 是 0.73,对 Jev 的 0.90,MMLU-Pro 是 0.59 对 0.84。
- 微调可能让基座模型在个别任务上变差。日期算术是最清楚的一例(issue #8);在陈述的天数计数上训练加
KEV_DATE_FACTS=1能恢复它。 - 改动选项顺序可能改变答案。问题隔离并不能阻止这一点。
- Kev-0.8B、4B 和 9B 主要训练时最多 384 个 state token,state 加一个问题最多 1,024 tokens(其文档和技能微调到最多 7,552 tokens 的 state),Kev-27B 训练到最多 32,768 tokens。服务允许 65,536-token 的 state;每个模型的已验证上下文长度在 Models 里。
- 在 Mac 上,答案要几百毫秒,不是几十毫秒。Kev-27B 需要一张 80 GB GPU。在 Mac 上它需要约 51 GB 加工作内存;我们预计 96–128 GB Mac 装得下,但尚未测量。
- Kev-27B 从一个训练数据不为我们所知的后训练模型出发。
Development
uv run --extra serve python -m pytest tests/test_unit.py tests/test_research.py tests/test_generators.py tests/test_conventions.py \
    tests/test_documents_tools.py tests/test_hard_v1.py tests/test_devtools_v1.py tests/test_breadth_v1.py tests/test_rounds.py tests/test_skill_scripts.py -q   # no weights, no server; what CI runs
KEV_BASE_URL=http://127.0.0.1:8009 uv run --extra serve python -m pytest tests/test_api.py -q   # against a running server
cd playground && npm run lint && npx next typegen && npx tsc --noEmit -p .
API 测试对你的本地服务器跑 TypeSafe 的示例请求和官方 SDK。PLAN.md 是研究计划:我们学到了什么、每个实验遵循的规则,以及每轮一行。完整日志(每个实验、运行前设定的判据、以及结果如何)在 git tag research-archive-2026-09-24。
Previous generation (Qwen3) and the prototype
第一个 Kev 家族使用 Qwen3 基座,数据和设置相同。那些权重仍然发布,能在 Mac 上用普通 PyTorch 跑,但不再继续开发。
| 模型 | 基座 | 准确率:已训练来源 | 准确率:新来源 | Brier:新来源 | 模型卡 |
|---|---|---|---|---|---|
Kev-0.6B (Qwen3) — jaredpalmer/kev-0.6b |
Qwen3-0.6B-Base | 0.801 / 0.808 | 0.620 / 0.642 | 0.536 / 0.483 | 详情 |
Kev-4B (Qwen3) — jaredpalmer/kev-4b@qwen3 |
Qwen3-4B-Base | 0.854 / 0.856 | 0.790 / 0.806 | 0.328 / 0.294 | 详情 |
Kev-8B (Qwen3) — jaredpalmer/kev-8b |
Qwen3-8B-Base | 0.863 / 0.870 | 0.796 / 0.780 | 0.337 / 0.327 | 详情 |
Troubleshooting
- 如果训练时 MPS 显存不足,检查你是否只跑了一个任务。不要启用
output_hidden_states,也不要用 peft 的trainable_token_indices添加 tokens;两者在这里都造成过内存问题。 - 如果 playground 能加载但按钮不工作,使用
localhost:3001。Next.js 会检查开发主机名。其他主机需要在playground/next.config.ts的allowedDevOrigins里加一条。 - 如果数据集加载报告
Dataset scripts are no longer supported,改用legacy-datasets/banking77。本仓库已经在用它。
Authors
- Jared Palmer (@jaredpalmer)
用 Devin 构建。感谢 Archer Hume 的架构文章、TypeSafe 的 API 设计,以及 Qwen 的基座模型。
License
Apache-2.0。Qwen3、Qwen3.5 和 Qwen3.8 基座模型也是 Apache-2.0。训练数据集各有自己的许可证;见模型卡。