직접 학습하고 실행할 수 있는, Jev를 닮은 작은 의사결정 모델입니다.
Kev는 Qwen3.5와 Qwen3.8 위에 올린, 그리고 Jev’s Architecture Unmasked에 설명된 아키텍처를 바탕으로 한 작은 의사결정 모델 패밀리입니다. 사전 학습된 가중치를 쓰거나 직접 학습할 수 있습니다. API는 TypeSafe의 System One과 맞으므로, 그들의 Python SDK를 자신의 로컬 서버로 향하게 할 수 있습니다.
하이라이트
- 한 요청에 예/아니오(
noul), 객관식(choice), 평점(score) 질문을 함께 넣습니다. 질문은 텍스트를 공유하지만 서로를 읽을 수 없습니다. - 기본으로 캘리브레이션된 확률: 각 체크포인트는 적합된 온도와 함께 배포됩니다.
- Jev에 그대로 대체 가능: TypeSafe Python SDK가 변경 없이 Kev 서버에 동작합니다.
- 네 가지 크기, Kev 1.0으로 함께 버전 관리: 노트북에서 도는 0.8B부터 데이터센터 GPU 하나를 위한 27B까지.
- 최대 65,536 토큰 문서, CUDA와 Apple Silicon에서 MLX를 통해. 각 모델 카드가 정확도가 떨어지기 전까지 문서가 얼마나 길어질 수 있는지 밝힙니다.
- 자신의 레이블된 예제로 파인튜닝하십시오. 코딩 에이전트 스킬이 질문을 찾는 것부터 결과 서빙까지 전체 루프를 Modal에서 돌립니다.
- 한 명령으로 자신의 HTTPS 엔드포인트를 배포하십시오. 유휴 시 0으로 스케일됩니다.
- 먼저 브라우저에서 써보십시오: huggingface.co/spaces/jaredpalmer/kev.
모델
Kev-4B로 시작하십시오. 더 큰 GPU가 있으면 Kev-9B로, 80 GB GPU가 있고 가장 정확한 Kev를 원하면 Kev-27B로 옮기십시오. 크기가 정확도보다 중요할 때는 Kev-0.8B를 쓰십시오.
| 모델 | 베이스(라이선스) | 실행: CUDA | 실행: Mac (MLX) | 검증된 컨텍스트 | 홀드아웃 데이터셋: 지수 | 카드 |
|---|---|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base (Apache-2.0) | L4, 아무 4 GB GPU | 아무 Apple Silicon Mac; 65k 토큰까지 측정 | 8,192 | 23.3 | 세부 정보 |
| Kev-4B | Qwen3.5-4B-Base (Apache-2.0) | L40S, H100 | 32 GB Mac; 65k 토큰까지 측정 | 8,192 | 38.0 | 세부 정보 |
| Kev-9B | Qwen3.5-9B-Base (Apache-2.0) | L40S, H100 | 32 GB Mac 이상(예상, 미측정) | 8,192 | 41.0 | 세부 정보 |
| Kev-27B | Qwen3.8-27B, post-trained (Apache-2.0) | B200, H200, H100 80 GB | 96–128 GB Mac (예상, 미측정) | 65,536 | 52.3 | 세부 정보 |
| Jev | 호스팅 | TypeSafe의 API | – | – | 54.0 | – |
“Held-out datasets”는 커뮤니티 Decision Index의 우연 보정 지수로, breadth-v1의 테스트 분할에서 채점합니다: 어떤 Kev도 학습하지 않은 다섯 영역의 공개 데이터셋 14개입니다. “Validated context”는 실제 계약(CUAD)에 대한 정확도가 8k 토큰에서의 같은 모델 정확도와 3점 이내로 유지되는, 토큰 단위의 가장 긴 문서입니다(95 % 하한). 각 모델 카드에 길이별 측정이 있습니다.
| 모델 | 정확도: 새 소스 | 정확도: 학습된 소스 | Brier: 새 소스 |
|---|---|---|---|
| Kev-0.8B | 0.648 / 0.697 | 0.827 / 0.838 | 0.481 / 0.416 |
| Kev-4B | 0.817 / 0.838 | 0.873 / 0.865 | 0.269 / 0.242 |
| Kev-9B | 0.820 / 0.852 | 0.874 / 0.873 | 0.289 / 0.217 |
| Kev-27B | 0.851 / 0.889 | 0.865 / 0.866 | 0.225 / 0.156 |
| Jev | 0.857 / – | 0.845 / – | 0.211 / – |
각 칸은 개발 / 테스트입니다. “새 소스”는 Kev가 학습 중에 한 번도 보지 못한 데이터셋과 정책 규칙을 뜻합니다. 여기서 당신의 질문에 가장 가까운 것입니다. “학습된 소스”는 Kev가 학습한 데이터셋의 홀드아웃 예제를 뜻합니다. 우리는 개발 세트로 체크포인트를 고르고, 릴리스된 모델마다 각 테스트 세트를 한 번만 읽습니다. Jev는 이 두 스위트의 개발 세트에서만 실행했습니다. Brier는 최상위 답만이 아니라 확률 분포 전체를 채점하며, 낮을수록 좋습니다.
새 소스에서 Kev-27B는 Jev와 1점 이내이고(0.851 대 0.857), Kev-4B와 Kev-9B는 4점 이내입니다. Jev가 무엇으로 학습되었는지 우리는 모르므로, 이것은 두 아키텍처의 통제된 비교가 아닙니다. 예상할 수 있는 것에서 Kev가 Jev만큼 좋은 곳과 그렇지 않은 곳을 설명합니다.
Kev-0.8B, 4B, 9B는 Qwen 베이스 모델에서 출발하며 하나의 학습 레시피를 공유합니다: 동결된 베이스 위의 작은 어댑터입니다. Kev-27B는 Qwen의 post-trained 릴리스에서 출발하는데, 그것이 무엇으로 학습되었는지는 모릅니다. Kev-27B는 모든 가중치를 파인튜닝하므로 어댑터가 아니라 51 GB의 전체 가중치로 배포됩니다. 각 모델 카드에 전체 레시피, 모든 결과, 그리고 Hub 태그로 보관된 이전 버전이 있습니다.
Kev 1.0
위의 네 모델은 Kev 1.0으로 함께 릴리스됩니다. 각 Hub 저장소에는 v1.0 태그가 있어 --run jaredpalmer/kev-4b@v1.0이 항상 같은 가중치를 로드하고, GitHub 릴리스 kev-1.0에 0.8B, 4B, 9B 체크포인트와 SHA-256 체크섬이 있습니다. Kev-27B의 51 GB 가중치는 릴리스 자산으로는 너무 커서 Hub에만 있습니다.
| 모델 | 가중치의 Hub revision | 온도 | 학습한 state 상한 |
|---|---|---|---|
| Kev-0.8B | 9a45d25e |
2.35 | 7,552 토큰 |
| Kev-4B | 139fdd94 |
2.41 | 7,552 토큰 |
| Kev-9B | b5d8c18e (v2) |
2.19 | 7,552 토큰 |
| Kev-27B | 28be62e9 (v2, 전체 가중치) |
1.32 | 32,768 토큰 |
Kev 1.0은 새로 학습한 것이 없습니다. 다음 세대 Kev를 비교하는 기준이 될 체크포인트, 카드, 평가 스위트와 서빙 코드를 고정합니다. 릴리스 노트에 이전 패밀리 릴리스 이후 바뀐 것과 잘 동작하지 않는 것으로 알려진 것이 나열되어 있습니다.
빠른 시작
브라우저에서 써보기
Hugging Face Space가 Kev-4B와 Kev-0.8B를 설치할 것 없이 돌립니다.
로컬에서 실행
Python 3.12나 3.13과 uv가 필요합니다. 저장소의 .python-version 때문에 uv sync는 3.13을 사용합니다; torch는 아직 3.14용 휠이 없습니다.
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
이 명령은 자신의 기계에서 Kev-4B를 시작합니다: GPU가 있으면 CUDA나 ROCm, Apple Silicon에서는 MLX입니다. 첫 실행은 어댑터와 베이스 모델을 내려받습니다. --run은 로컬 체크포인트 디렉터리나 jaredpalmer/kev-4b@qwen3 같은 Hub revision도 받습니다.
다른 터미널에서 티켓을 보내보십시오:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
Apple M5에서 bf16으로 도는 Kev-4B의 응답 예:
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.34,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
}
티켓은 반품, 늦은 배송과 청구 문제를 언급하고, 부서 확률이 그렇게 말합니다. Kev가 단일 레이블이 아니라 확률을 돌려주는 이유가 이것입니다: 코드가 확신하는 사례를 라우팅하고 나머지를 사람에게 보낼 수 있습니다.
Python에서 사용
이미 Jev를 호출하고 있다면 클라이언트를 Kev로 향하게 하고 나머지 코드는 그대로 두십시오. TypeSafe SDK는 uv sync --extra serve에 포함되어 있습니다:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
자신의 데이터로 파인튜닝
릴리스된 모델은 공개 데이터셋과 생성된 정책 예제로 학습했습니다. 자신의 질문이 다르게 생겼다면, 예컨대 자신만의 라우팅 분류, 자신만의 에스컬레이션 규칙 또는 다른 언어라면, 짧은 파인튜닝이 보통 어떤 프롬프트 변경보다 더 도움이 됩니다. 또한 온도를 자신의 데이터에 맞추므로, 임계값을 정하는 신뢰도가 자신의 레이블로 측정됩니다.
예상할 수 있는 것: 예시 지원 업무량(질문 세 개, 생성 레코드 1,050건, H100에서 15분)에서 파인튜닝은 Kev-4B를 정확도 67.7%에서 73.6%로, 그리고 5% 오류 예산에서 결정의 34%를 자동화하는 것에서 48%로 끌어올렸습니다(세부 정보). 실제 데이터에서는 5,219건의 레이블된 소비자 금융 불만에 한 에포크를 돌려, 한 번도 본 적 없는 불만에 대해 Kev-4B를 정확도 0.804에서 0.904로 끌어올렸습니다. 이런 이득은 분포 내의 것입니다: Kev가 당신의 과제를 얼마나 잘 배우는지 알려줄 뿐, 다른 모든 것에서 어떻게 하는지는 알려주지 않습니다. 데이터셋 크기를 먼저 정하십시오. 레코드 400건에서는 예시 업무량에서의 이득이 잡음 안에 있었습니다.
코딩 에이전트로
npx skills add jaredpalmer/kev@kev-finetune그런 다음 에이전트에게 “내 지원 티켓으로 Kev를 파인튜닝해줘”라고 요청하십시오. kev-finetune 스킬이 당신을 인터뷰하고, 당신의 코드가 이미 Jev나 TypeSafe에 던지는 질문을 찾아내고, 가진 레이블을 변환하거나 이득을 측정할 만큼 아무 LLM으로 생성하고, Modal에서 릴리스된 체크포인트로 파인튜닝하고, 홀드아웃 조각에서 온도를 적합하고, 손대지 않은 모델과 결과를 비교 채점하고, 엔드포인트를 배포하고, 끝에 모든 것을 정리합니다. 로컬 GPU나 이 저장소의 클론이 필요 없습니다. Kev-4B 학습 실행은 H100에서 약 $1이 듭니다.
수동으로
스킬의 README는 사람을 위한 같은 레시피입니다: 짧은 표준 라이브러리 스크립트 여섯 개와 Modal 앱 하나입니다. 이 저장소에서 바로 학습하려면 예제를 JSONL 파일에 한 줄에 요청 하나씩 넣으십시오. API 요청과 같은 모양에, 모든 질문에 label을 더한 것입니다:
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
"priority": {"type": "score", "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}choice의 레이블은 옵션 이름, noul은 true나 false, score는 0부터 시작하는 단계 위치입니다. 파일의 10–20%는 평가용으로 남겨 두십시오.
그런 다음 --init_from으로 릴리스된 체크포인트에서 시작하십시오:
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine

uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
uv run --extra serve python -m kev.serve --run runs/mine --port 8009--init_from은 학습 전에 릴리스된 모델의 어댑터와 포인터 헤드를 로드하므로, Kev가 이미 아는 것을 유지하고 그 위에 자신의 도메인을 더합니다. 대신 베이스 모델에서 시작하면 그것을 버립니다: 한 사용자가 836건의 지원 도구 결정으로 시험했을 때, 베이스에서 파인튜닝한 것은 Kev 자체 평가 세트에서 0.33을 받았고, 릴리스된 모델은 0.84였습니다; 같은 데이터에 --init_from을 쓰면 거기서 0.83을 유지하고 새 도메인에서 0.88에 도달했습니다. 처음부터 하는 레시피보다 작은 학습률을 쓰고(2e-5가 좋은 시작입니다), 시작하는 체크포인트에 맞춰 --base를 고르십시오; 트레이너는 아무것도 로드하기 전에 base, revision, LoRA rank와 헤드 크기가 맞는지 확인합니다.
bf16에서 --batch 1 --accum 8은 0.8B 모델을 4 GB GPU에 맞춥니다. 벤치마크는 질문 유형별로 정확도, Brier 점수와 캘리브레이션을 보고하므로, 파인튜닝이 자신의 질문 중 어느 것을 도왔는지 볼 수 있습니다. 시작한 체크포인트는 runs/mine/training_config.json에 기록됩니다. Mac에서는 한 번에 학습 작업 하나만 돌리십시오; 같은 Apple GPU에서 두 작업은 훨씬 느립니다.
자신의 엔드포인트 배포
로컬 서버 대신 HTTPS 엔드포인트를 얻으려면 이 저장소가 필요 없고, Modal 계정만 있으면 됩니다:
pip install modal && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
이것은 L40S에서 Kev-4B를 https://<your-workspace>--kev-api.modal.run에 서빙하며, 위와 같은 API가 Authorization: Bearer <key> 뒤에 있습니다. 유휴 시 0으로 스케일되므로 쓰지 않는 엔드포인트는 비용이 들지 않습니다. 유휴 후 첫 요청은 컨테이너 시작을 위해 약 35초 기다립니다. KEV_MODEL=jaredpalmer/kev-9b는 다른 모델을 그에 맞는 GPU에서 서빙합니다; Kev-27B는 B200으로 가고, H200이나 H100으로 폴백합니다. 코딩 에이전트를 쓴다면 npx skills add jaredpalmer/kev@kev-deploy가 같은 일을 하고 URL을 당신의 코드에 연결합니다. skills/kev-deploy에 GPU와 비용 표가 있습니다.
kev-finetune 스킬로 파인튜닝한 모델도 자체 Modal 앱에서 같은 방식으로 배포합니다(KEV_SERVE_SECRET=kev-serve-key KEV_SERVE_RUN=<run> modal deploy scripts/kev_modal.py; 배포 가이드를 참고하십시오). 대신 자신의 기계에서 Kev를 호스팅하려면, 로컬에서 실행의 kev.serve를 --host 0.0.0.0으로 GPU 박스에서 실행하고 자신의 프록시 뒤에 두십시오; 서빙 성능이 어느 GPU를 고를지 말합니다.
예상할 수 있는 것
정확도. Kev-27B는 아래 차트의 새 소스 범주 11개 중 9개에서 Jev와 3점 이내이거나 앞섭니다. Kev-4B와 Kev-9B는 라우팅, 함의, 과학 질문처럼 분류 모양의 소스에서 비슷하게 근접합니다. 지식 질문은 주로 베이스 모델에 달려 있습니다: MMLU에서 Kev-9B는 0.73이고 Kev-27B는 Jev와 같은 0.90이지만, 더 어려운 MMLU-Pro에서 Kev-27B는 0.675로 Jev의 0.840에 못 미칩니다. 더 작은 모델들은 일 단위 정밀도의 날짜 산술에서도 뒤처집니다.
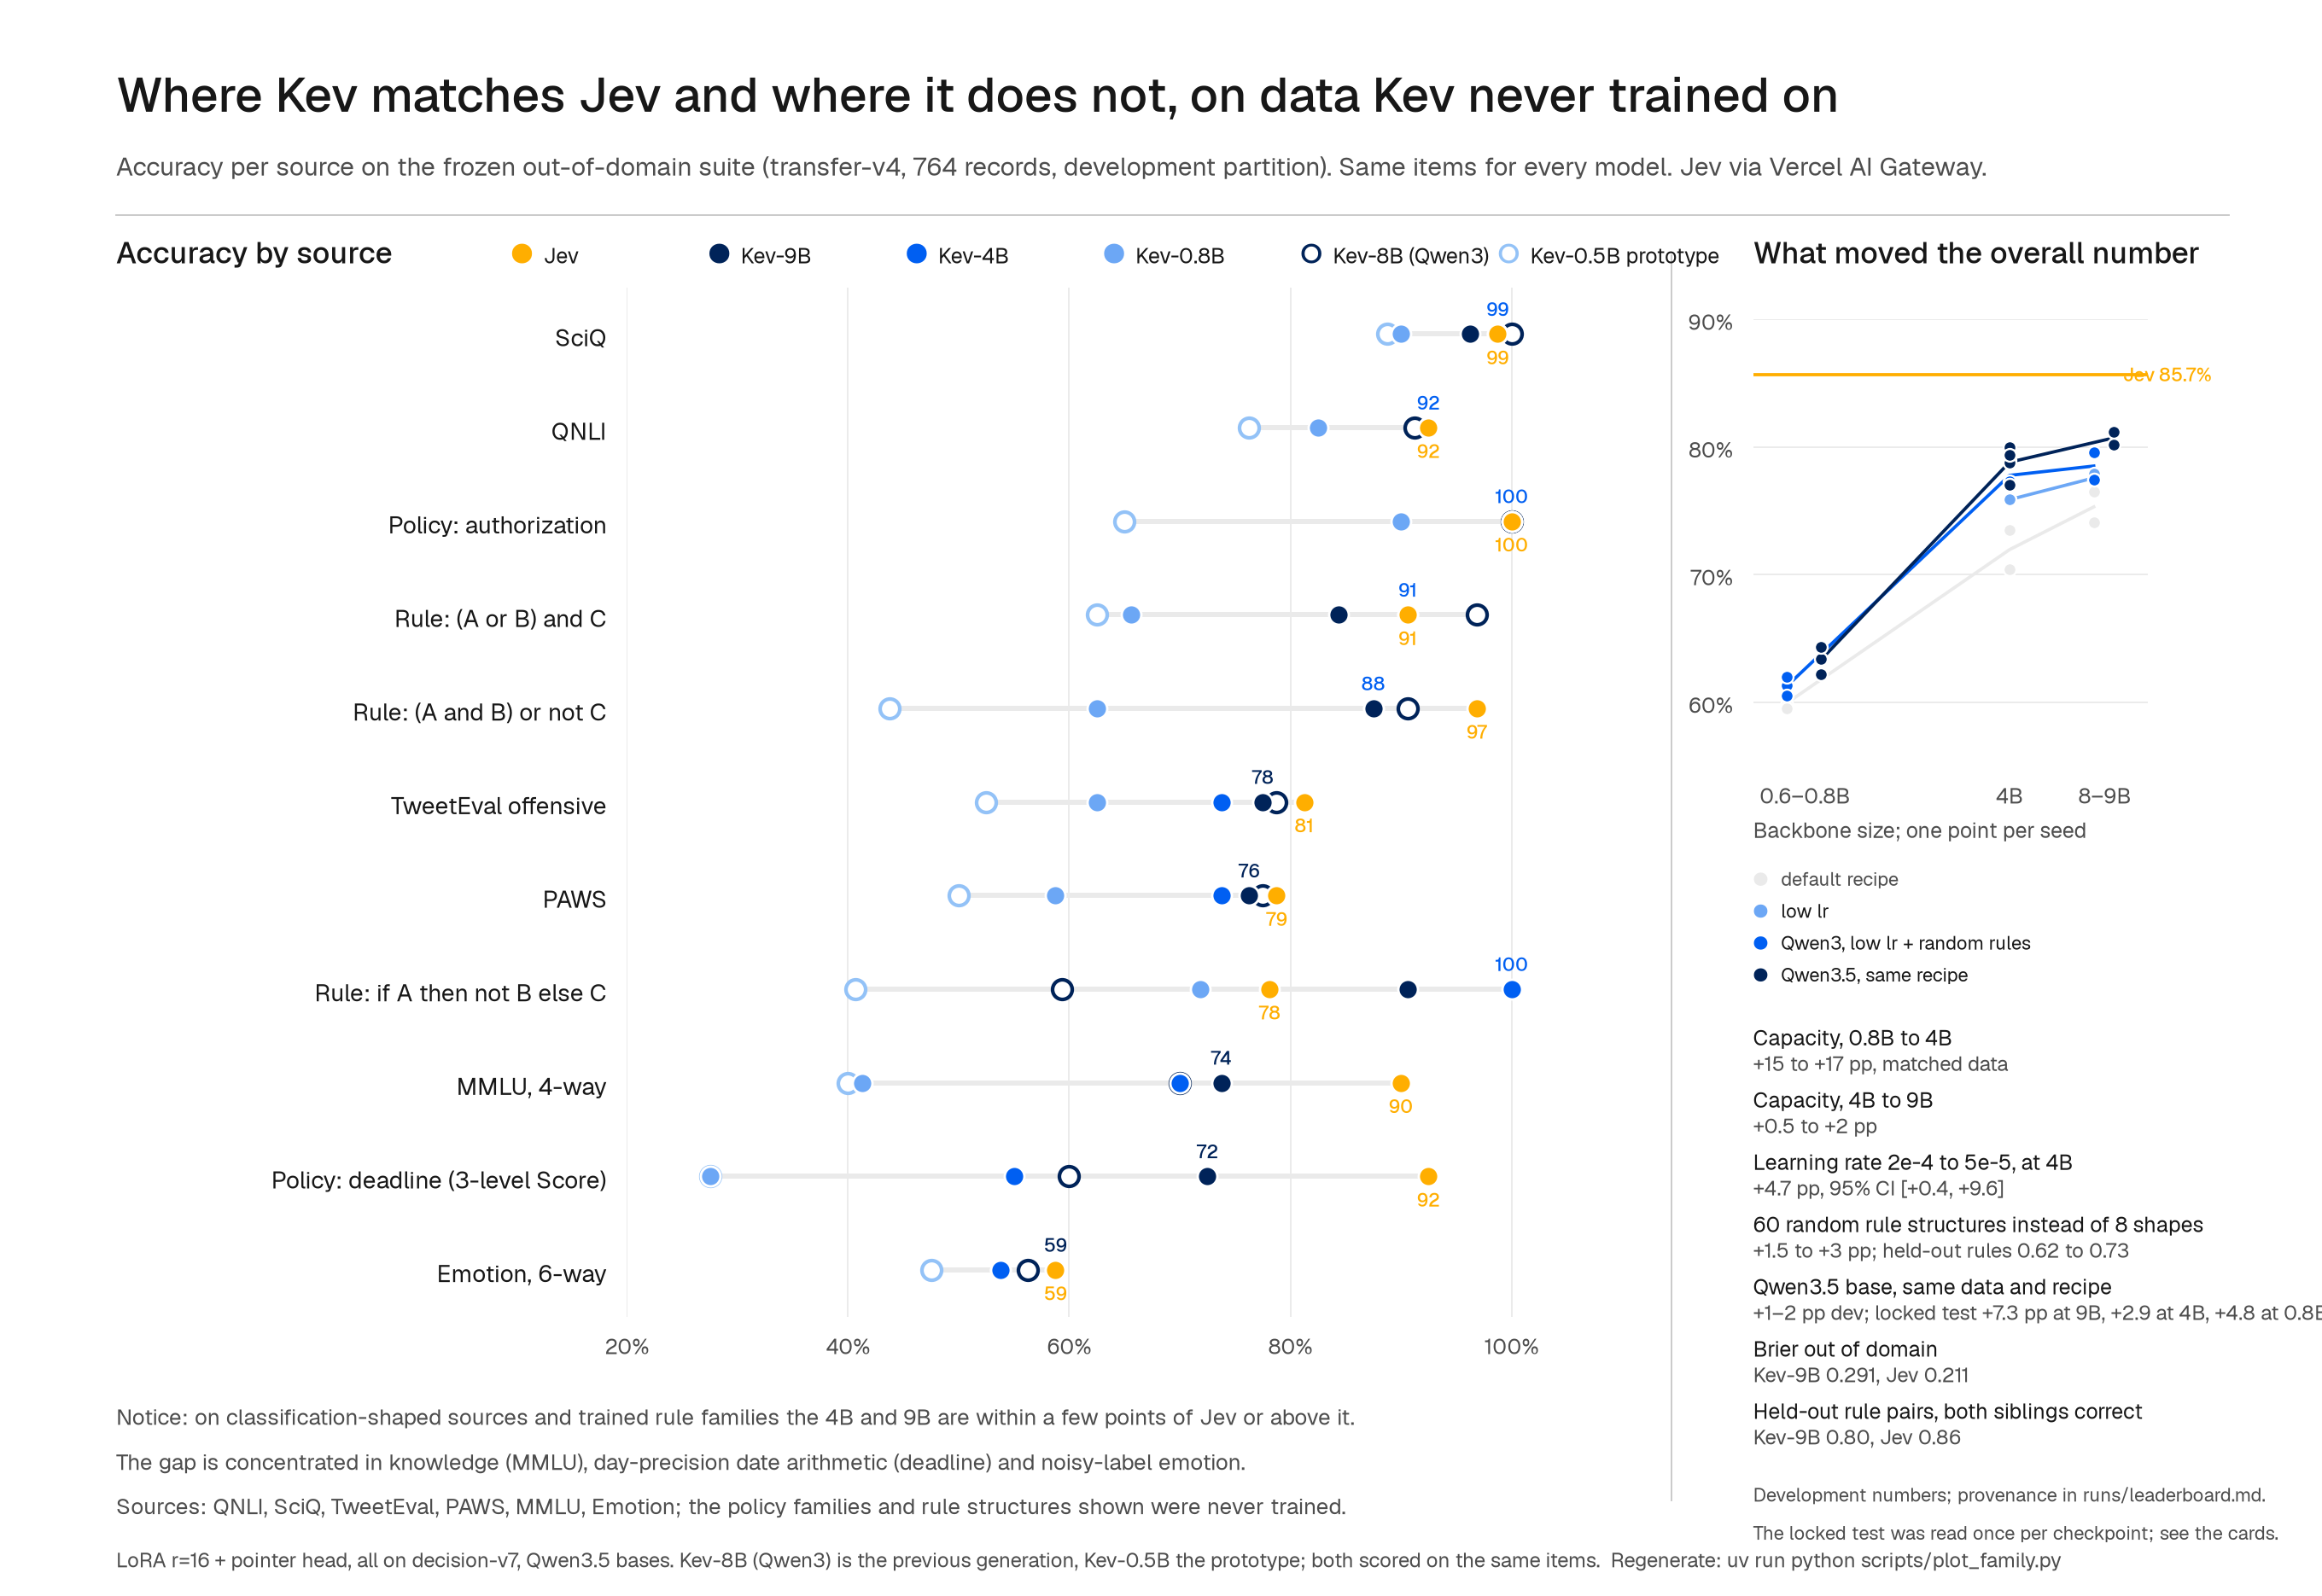
신뢰도. 각 체크포인트는 적합된 온도와 함께 배포되므로, 그 확률은 기본으로 캘리브레이션되어 있습니다. 서빙 상태에서 Kev-9B는 새 소스 질문의 2.4%에서 틀린 답에 최소 0.9의 확률을 주며, Jev는 3.7%입니다. Jev는 여전히 답의 순위를 더 잘 매깁니다: 5% 오류 예산에서 Kev-4B, 9B, 27B는 새 소스 결정의 0.52–0.69를 자동화할 수 있고, Kev-0.8B는 0.14, Jev는 0.70입니다. 의존하기 전에 자신의 데이터에서 임계값을 확인하십시오.
속도. Kev-4B는 새 짧은 텍스트에 대한 여섯 질문을 H100에서 모델 시간 18.1 ms, L40S에서 41.5 ms에 답하고, 컨테이너는 H100에서 초당 약 101 요청을 서빙합니다. Apple M5에서 Kev-4B는 다섯 질문에 721 ms가 걸리고, 텍스트가 반복되어 캐시에서 오면 136 ms입니다. 서빙 성능에 모든 GPU와 배치 크기가 있습니다.
길이. Kev-0.8B, 4B, 9B는 주로 최대 384 토큰 state로 학습했고, 문서·스킬 파인튜닝에서는 더 긴 것(최대 7,552 토큰)을 썼으며, Kev-27B는 최대 32,768 state로 학습했습니다. 서버는 최대 65,536 토큰 state와 질문마다 8,192 토큰을 더 받고, 더 긴 것은 자르지 않고 422로 거부합니다. 각 모델이 학습 길이를 넘어 얼마나 정확도를 유지하는지는 모델의 “검증된 컨텍스트” 열입니다. Kev-0.8B, 4B, 9B의 경우 8,192 토큰입니다: 16k에서는 실제 계약에 대한 측정이 3점을 넘는 하락을 더 이상 배제할 수 없고, 32k에서는 셋 다 8k보다 측정 가능하게 덜 정확합니다. Kev-27B는 65,536 토큰 한도까지 유지합니다. 최대 64k 토큰의 실제 계약(CUAD)에서 Kev-27B는 0.874를 받고, 거기서의 신뢰도는 짧은 텍스트에서보다 덜 믿을 만합니다; 모델 카드에 길이별 수치가 있습니다.
플레이그라운드
서버를 실행한 상태에서 다른 터미널을 여십시오. Node 20.9+가 필요합니다:
cd playground
npm install
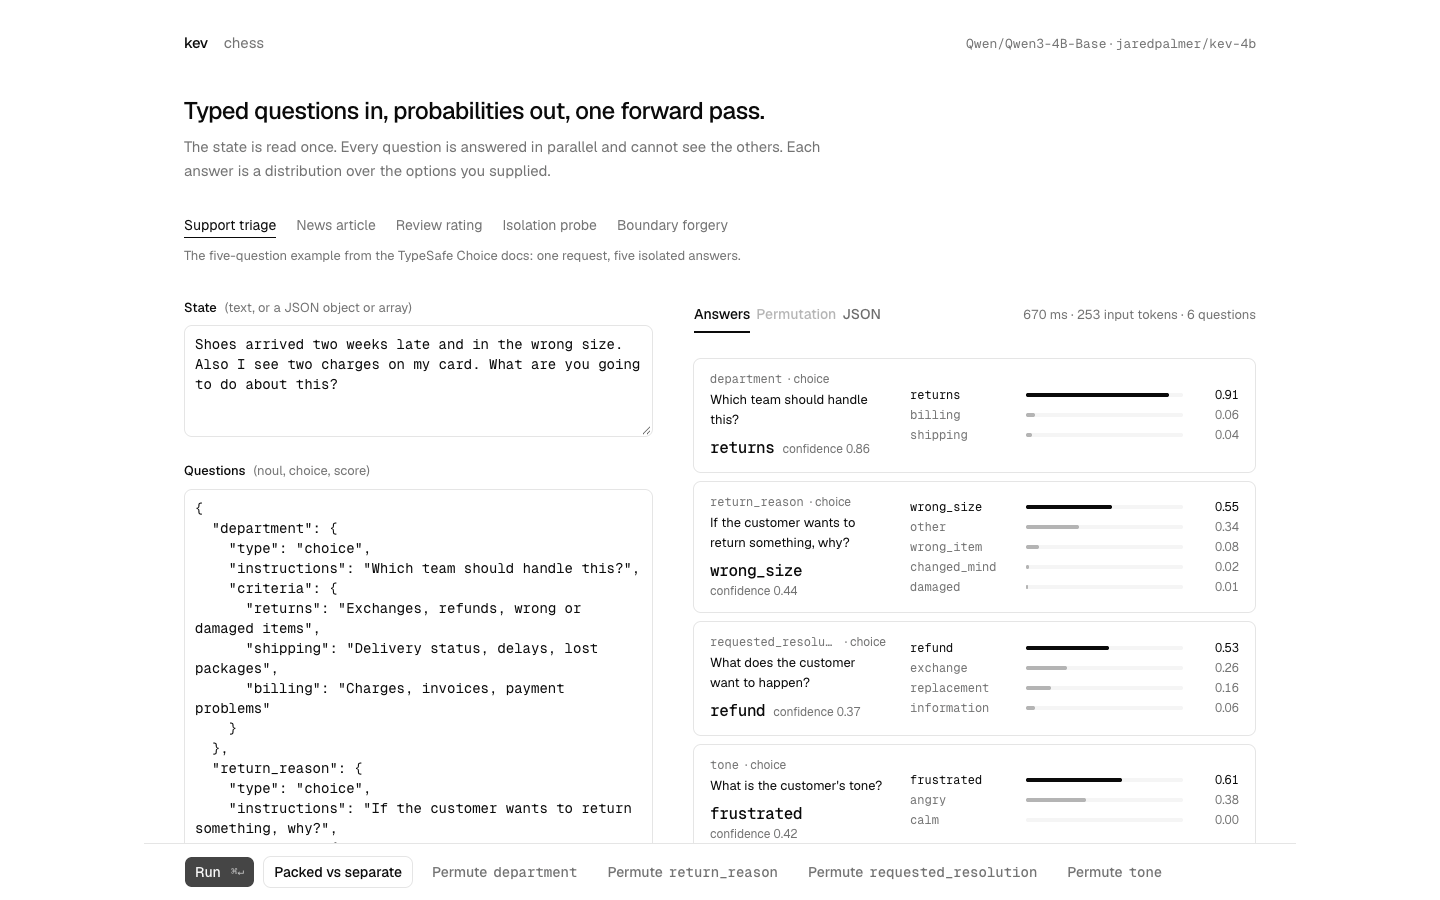
npm run dev -- -p 3001localhost:3001을 열고, 프리셋을 로드하고, 텍스트와 질문을 편집하십시오. ⌘↵를 눌러 실행합니다. “Packed vs separate”(묶음 대 분리)는 모든 질문을 한 번에 묻는 것과 하나씩 묻는 것을 비교합니다. “Permute”(순열)는 여섯 가지 선택지 순서로 Choice 질문을 실행합니다. 질문 격리와 가짜 구분자 토큰을 테스트하는 프리셋도 있습니다.
체스 데모도 있습니다. 보드가 입력이고, 합법 수가 Choice 선택지이며, Score 질문이 국면을 평가합니다. Kev와 대국하거나 스스로 두게 할 수 있습니다. 게임은 localStorage에 저장됩니다.
API
POST /v1/systemone
state는 평가할 텍스트입니다. 각 질문에는 instructions가 있고, 필요하면 고를 답변 집합이 있습니다.
{
  "state": "…",                          // string | object | array — the content to evaluate
  "model": "kev-latest",
  "questions": {
    "<id>": {                            // you choose the id; the model never sees it
      "type": "noul" | "choice" | "score",
      "instructions": "…",               // string | object | array, optional
      "criteria": …                      // noul: {true?, false?}  choice: {option: description|null}  score: [level, …]
    }
  }
}| 유형 | 기준 | 답 |
|---|---|---|
noul |
true와 false의 선택적 설명 |
noul: 예일 확률 |
choice |
1–255개 옵션 이름, 각각 설명 또는 null |
choice: 가장 가능성 높은 옵션; probabilities와 confidence |
score |
1–255개 설명, 낮은 것부터 높은 것 순 | score: 0부터 시작하는 평균 단계 인덱스; legend, probabilities, confidence |
옵션이 K > 1개인 Choice의 경우, confidence는 (p_max − 1/K) / (1 − 1/K)입니다. 옵션이 하나면 confidence는 1입니다. Score confidence는 max(0, 1 − E|level − mode| / D)입니다: mode는 가장 가능성 높은 단계이고 D는 단계 위의 균등 분포가 중앙에서 갖는 평균 거리입니다(단계가 셋이면 2/3). 그래서 한 단계에 확률이 모두 쏠리면 1이고, 균등하거나 더 넓게 퍼지면 0입니다. 두 공식 모두 TypeSafe의 참조 어댑터(system-one-adapter 0.2.1)에 있는 것입니다. 두 필드 모두 측정된 정확도가 아닙니다.
객체와 배열은 레이블이 붙은 텍스트로 변환됩니다. 사용자 입력의 구분자 같은 문자열은 토큰화 전에 이스케이프됩니다. 잘못된 요청은 422를 반환하며, 65,536 토큰보다 긴 state도 그렇습니다: 서버는 문서의 일부를 조용히 버리지 않고, 오류가 state의 토큰 수와 한도를 알려줍니다. usage.output_tokens는 생성된 토큰이 아니라 직렬화된 답의 토큰을 셉니다.
| 메서드 | 경로 | 용도 |
|---|---|---|
GET |
/v1/models |
모델 카드(name, description, release_date)와 로드된 체크포인트의 세부 사항 |
POST |
/v1/systemone/permute |
서로 다른 옵션 순서로 Choice 질문 하나를 실행(n_perm 1~64, 기본 6) |
POST |
/v1/systemone/separate |
각 질문을 자체 포워드 패스에서 실행 |
요청은 임의 개수의 질문을 담을 수 있습니다. 서버는 토큰 예산 단위로 그것들을 실행합니다(포워드 패스당 최대 16,384 토큰의 행 하나, 그 패스에서 캐시된 문서를 질문마다 한 번씩 셈). 그래서 메모리가 질문 수에 따라 늘지 않고 답이 분할에 의존하지 않습니다. 모든 응답은 x-typesafe-request-id 헤더를 답니다. 서버는 127.0.0.1에 바인드하고(--host 0.0.0.0이면 다른 기계를 받음) 기본으로 열려 있습니다; TypeSafe 클라이언트가 항상 보내듯 /v1/*에 Authorization: Bearer <key>를 요구하려면 KEV_API_KEY를 설정하십시오.
| 변수 | 효과 |
|---|---|
KEV_TEMPERATURE=1.0 |
캘리브레이션된 확률 대신 원시 확률을 반환 |
KEV_DATE_FACTS=1 |
state 안의 임의의 두 날짜 사이 일수를 덧붙임(벤치마크 참고) |
KEV_TRUNCATE_STATES=1 |
더 긴 state를 거부하는 대신 앞 65,536 토큰을 읽음; 그러면 모든 응답에 truncated와 usage.state_tokens / state_tokens_used가 붙음 |
KEV_DTYPE=fp32 |
평가가 쓰는 정확한 fp32 경로를 서빙(GPU 기본은 bf16) |
KEV_API_KEY |
bearer 키를 요구 |
동작 방식
각 체크포인트는 Qwen 베이스 모델 위의 rank-16 LoRA 어댑터와 작은 포인터 헤드입니다. 어텐션 전용 베이스(Qwen3)에서는 state와 질문이 하나의 토큰 시퀀스로 들어갑니다:
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
어텐션 마스크는 토큰이 state와 자기 질문을 읽게 하되, 다른 질문이나 미래 토큰은 읽지 못하게 합니다. 각 질문의 position ID는 state 바로 뒤에서 다시 시작합니다. 그래서 모델이 state를 한 번 처리하고 각 질문에 독립적으로 답할 수 있습니다.
Qwen3.5와 Qwen3.8은 어텐션 층을 Gated DeltaNet 층과 섞는데, 후자는 순환적이라 어텐션 마스크를 무시합니다. 그런 모델(현재 모든 Kev)에서는 각 질문이 자체 행으로 실행됩니다: state 뒤에 그 질문이 오고, 위치는 위와 같습니다. 행들이 독립적이라 격리가 정확하며, 서버와 DecisionModel.probs()는 state를 한 번 계산해 모든 행에 그 캐시를 재사용합니다. kev.benchmark가 채점하고 모든 공개 수치가 나오는 forward()는 평범한 행을 유지하고 질문마다 state를 한 번 실행합니다; 둘은 fp32 반올림 수준에서 일치합니다. 어텐션 전용 모델에서는 행과 위의 마스크가 같은 확률을 냅니다(tests/test_model.py).
Kev-27B는 Qwen/Qwen3.8-27B에 같은 설계를 씁니다. 두 가지가 다릅니다. 베이스가 -Base 체크포인트가 아니라 Qwen의 post-trained 릴리스이고, 그것이 무엇으로 post-training되었는지 모릅니다. 그리고 어댑터만이 아니라 모든 백본 가중치가 학습되어 bf16으로 유지되므로, 체크포인트가 모델 전체입니다: bf16 가중치 51 GB에 포인터 헤드를 더한 것입니다. bf16으로만 서빙되며(서빙 버퍼를 포함해 약 66 GB 상주), 그래서 80 GB 카드가 필요합니다. Apple Silicon에서는 MLX 백엔드가 그 가중치를 병합 없이 있는 그대로 로드합니다(서빙 성능 참고); 96–128 GB Mac에 들어갈 것으로 예상하지만 측정하지는 않았습니다. 그 서빙 확률은 H200에서 평가 경로와 0.022 이내로 유지됩니다(runs/serving-27b-r23).
포인터 헤드는 각 옵션의 </opt> 히든 상태를 질문의 <decide> 히든 상태와 대조해 점수를 매깁니다. softmax가 그 점수를 확률로 바꿉니다. <decide>가 마지막에 오므로 전체 옵션 목록을 어텐션할 수 있습니다.
학습은 정답에 대한 교차 엔트로피를 씁니다. 어댑터와 헤드는 함께 학습되고, 나머지 베이스 가중치는 고정됩니다(Kev-27B는 전부 학습). 학습 예제와 API 요청은 같은 텍스트 형식을 씁니다. 학습에 Jev 출력은 쓰지 않았습니다.
질문을 함께 묻든 따로 묻든 fp32 테스트에서 확률이 4e-6 이내로 나옵니다. 이것은 옵션 순서가 무관하다는 뜻이 아닙니다: 한 질문 안의 옵션은 여전히 서로에게 영향을 줄 수 있습니다. 모델 코드와 동등성 테스트를 참고하십시오.
학습
릴리스된 모델은 하나의 베이스 학습 세트 decision-v7을 공유합니다: 공개 데이터셋 열 개에서 온 10,000 예제, 생성된 정책 예제 896건, 그리고 생성된 규칙 구조 60개에서 온 1,680 예제입니다. Kev-0.8B, 4B, 9B는 LoRA rank 16과 교차 엔트로피로 두 에포크 학습합니다. 학습률은 0.8B가 1e-4, 4B와 9B가 5e-5입니다. 이 하이브리드 베이스에서 어댑터는 어텐션, MLP와 DeltaNet 투영을 덮으며; kev.train이 모델 config에서 올바른 대상을 고릅니다.
그런 다음 Kev-0.8B, 4B, 9B는 릴리스된 체크포인트에서 짧은 후속 파인튜닝을 받는데, 자신의 데이터에 쓸 --init_from 경로와 같습니다: 일수를 명시하거나 결정 근거를 제거한 생성 사례(셋 다), 그다음 실제 문서와 생성 스킬 데이터(셋 다; Kev-9B는 v2부터, 2026-09-30)입니다. Kev-27B는 다르게 학습합니다. 베이스의 모든 가중치를 H200 여덟 대에서 한 에포크 파인튜닝하는데(--full_ft 1, 학습률 2e-6), 145,840건 코퍼스로 합니다: Kev 자체 데이터, 문서·스킬·개발자 도구 스위트, 공개 데이터셋, 라이선스된 태스크 패밀리, 그리고 생성된 긴 문서·도구 라우팅·에이전트 로그·가드레일 레코드이며, state는 최대 32,768 토큰입니다. 그 결과를 이전 어댑터 학습 Kev-27B와 0.85 대 0.15로 평균합니다. 모델 카드에 각 단계의 데이터와 비용이 나열되어 있습니다.
# sanity run, ~1 minute
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# the first stage of Kev-0.8B (~20 min on one H100; the Mac path works but is slow for Qwen3.5 bases)
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base --base_revision dc7cdfe2ee4154fa7e30f5b51ca41bfa40174e68 \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b

# the first stage of Kev-4B (one H100 via Modal, ~1 h; see below). Swap in Qwen/Qwen3-4B-Base for the previous generation.
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base --base_revision 1001bb4d826a52d1f399e183466143f4da7b741b \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
모든 학습 옵션은 uv run python -m kev.train --help를 쓰십시오. 릴리스된 모델은 선택 사항인 --perm_kl이나 --ord_w 손실을 쓰지 않습니다. PLAN.md에 무엇을 시도했고, 무엇이 도움이 되었고, 무엇이 안 되었는지가 기록되어 있습니다.
Modal
각 트라이얼은 자체 H100을 받습니다. 연결이 끊겨도 스터디는 계속 실행되고, 끝나면 결과를 내려받을 수 있습니다:
uv run modal token new                                    # once; opens the browser
KEV_GPU=T4 uv run modal run modal_app.py::smoke           # end-to-end check, ~1 minute of GPU

uv run modal deploy modal_app.py                          # once; studies run on the deployed app and survive disconnects
uv run modal run modal_app.py::study \
    --suite evals/v7/decision-v7 --plan experiments/v7-final.json \
    --name my-study --transfer evals/v4/transfer-v4 --budget 30 --timeout 7200
uv run modal run modal_app.py::pull --name my-study       # results -> runs/my-study, ranked
스터디 계획이 학습 설정을 나열합니다. 각 트라이얼은 설정, 코드 해시, 데이터셋 해시와 결과를 저장합니다. 모델은 잠긴 테스트가 아니라 개발 결과로 고르십시오. 최종 후보를 고른 뒤에는 그 테스트 결과를 한 번 읽을 수 있습니다:
uv run modal run modal_app.py::locked_test --trial my-study/00-trial-0 --name my-candidate # one read, ever벤치마크
evals/ 아래의 평가 데이터는 고정되어 있습니다: 데이터셋 버전과 파일 체크섬이 각 manifest에 기록됩니다. 큰 파일은 Hub 미러에서 내려받아 그 해시와 대조합니다. 위 표의 모든 모델은 같은 항목으로 채점됩니다. 이 README와 모델 카드의 수치는 CI에서 그것이 나온 커밋된 리포트와 대조해 확인합니다(docs/claims.json, uv run python scripts/verify_claims.py).
| 스위트 | 측정하는 것 |
|---|---|
decision-v7 |
학습 데이터셋 열 개, 생성된 정책과 규칙 구조의 홀드아웃 예제(“학습된 소스”) |
transfer-v4 |
Kev가 한 번도 학습하지 않은 데이터셋과 정책·규칙 유형의 764 레코드: QNLI, SciQ, PAWS, MMLU, Emotion, TweetEval, 홀드아웃 정책과 규칙(“새 소스”) |
transfer-v9 |
transfer-v4에 10지선다 MMLU-Pro, 무관한 텍스트에 묻힌 레코드, 결정 근거를 제거한 “알 수 없는” 레코드를 더한 것 |
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v4/transfer-v4 --out runs/my-eval      # new sources
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v9/transfer-v9 --out runs/my-eval-v9   # + MMLU-Pro, buried states, unknowable items
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v7/decision-v7 --out runs/my-eval-id   # trained sources
uv run python -m kev.benchmark --remote http://127.0.0.1:8009 --suite evals/v4/transfer-v4 --out runs/my-remote   # any System One endpoint, Jev included
이 명령들은 개발 데이터를 씁니다. 테스트 데이터에는 --allow-test가 필요합니다. 벤치마크는 정확도, Brier 점수, 캘리브레이션 오차, 5% 오류 예산에서 자동화할 수 있는 결정의 비율, 옵션 순서 변화와 질문 격리를 보고합니다. 알 수 없는 레코드에서는 모델이 최소 0.9 신뢰도로 여전히 답하는 빈도를 보고합니다(Kev-9B 0%, Jev 9%). 공개 정확도 수치는 bf16 서빙 경로가 아니라 fp32 평가를 씁니다. kev.jev는 Vercel AI Gateway를 통해 같은 질문을 Jev에 대해 실행하고, kev.compare는 저장된 두 실행을 짝지은 부트스트랩 신뢰구간으로 비교합니다.
캘리브레이션. 각 체크포인트는 온도를 저장하고, 포인터 헤드가 모델이 로드될 때 그것을 적용합니다. Kev-4B(2.41)와 Kev-0.8B(2.35)는 분포 내 개발 세트에서 적합했고, Kev-27B(1.32)와 Kev-9B(2.19)는 한 번도 학습하지 않은 홀드아웃 데이터셋에서 적합했습니다. 더 작은 두 모델을 그 홀드아웃 데이터셋에서 재적합하는 것을 시험했으나 둘 다 채택하지 않았습니다: Kev-4B를 개선하지 못했고 Kev-0.8B는 문서·스킬 스위트에서 캘리브레이션이 더 나빠졌습니다(모델 카드에 수치가 있습니다). 온도는 어느 답이 이기는지를 결코 바꾸지 않습니다. 새 소스에서 Kev-9B의 캘리브레이션 오차를 0.103에서 0.041로, 확신 오류(확률 ≥ 0.9인 틀린 답)를 8.2%에서 2.4%로 낮추며, 이는 Jev의 3.7%보다 낮습니다. 위의 정확도 수치는 어느 쪽이든 같고, Brier 수치는 원시 확률에 대한 것입니다. scripts/calibrate_checkpoint.py는 out-of-fold 추정도 보고하므로, 표본 내 적합을 보지 못한 레코드와 대조해 확인할 수 있습니다.
날짜. Kev는 날짜를 안정적으로 빼지 못하지만, 주어진 일수는 쓸 수 있습니다. KEV_DATE_FACTS=1은 state 안의 날짜 쌍마다 문장 하나를 덧붙입니다(“June 26, 2026 is 8 days before July 4, 2026”). 마감 정책 질문에서 이것은 Kev-9B를 0.80에서 0.90으로 끌어올립니다(Jev 0.93). 어느 표도 이것을 쓰지 않습니다.
다른 사람들의 테스트 세트. evals/external/에는 다른 프로젝트의 테스트 세트가 이 형식으로 변환되어, 공개된 라이브 Jev 결과와 함께 있습니다. 일부는 더 이른 버전의 Kev 가중치로 채점되었고, Kev 열이 그 이름을 밝힙니다. 세 개는 게이트로 쓸 수 없어 제거되었으며, 모델 카드는 그 릴리스가 결정될 때의 수치를 유지합니다: 2026-09-27의 scienthoon의 합성 지원 티켓(템플릿 텍스트; 세 질문 중 하나가 텍스트가 명시하지 않은 규칙에 의존)과, 2026-09-30의 WANLI(wanli-v1, wanli-v2: 쌍의 4분의 1이 WANLI의 두 주석자가 다르게 레이블한 것이고, 금은 그중 하나로 설정)와 TypeSafe의 공개 평가(typesafe-v1: 금이 두 폐쇄 프런티어 모델 답의 평균이고, 89 질문에서는 체크포인트를 구분하지 못함)입니다.
| 스위트 | 무엇인가 | Jev | Kev |
|---|---|---|---|
| SemIf | 직접 작성한 결정 144건 | 0.965 | 0.917 (Kev-9B at v7-base) |
SemIf의 레이블은 견고하지만 포화에 가깝습니다: 모든 Kev-27B 체크포인트가 144개 중 130개를 정확히 답하므로, 이것은 모델을 순위 매기는 방법이 아니라 온전성 검사입니다.
서빙 성능
모델에 맞춰 GPU를 고르십시오:
| 모델 | GPU ($/h) | 질문 6개, 짧은 텍스트 | 질문 5개, 2,200 토큰 텍스트 | 요청/s, 클라이언트 64 |
|---|---|---|---|---|
| Kev-0.8B | L4 (0.80) | 22.7 / 16.1 ms | 108.6 / 32.3 ms | 62.8 |
| Kev-4B | L40S (1.95) | 41.5 / 27.7 ms | 145.2 / 43.0 ms | 51.4 |
| Kev-4B | H100 (3.95) | 18.1 / 12.9 ms | 89.4 / 22.5 ms | 100.8 |
| Kev-9B | L40S (1.95) | 66.4 / 42.7 ms | 235.6 / 57.5 ms | 32.7 |
| Kev-9B | H100 (3.95) | 24.0 / 16.6 ms | 88.5 / 26.4 ms | 79.5 |
| Kev-27B | B200 (6.25) | 46.5 / 32.2 ms | 178.0 / 52.1 ms | 44.2 |
| Kev-27B | H200 (4.54) | 67.2 / 50.0 ms | 274.8 / 73.8 ms | 28.6 |
| Kev-27B | H100 (3.95) | 75.0 / 52.0 ms | 277.5 / 79.3 ms | 28.9 |
시간은 요청당 모델 시간(API가 돌려주는 latency_ms)이며, 새 텍스트 / 같은 텍스트를 다시 쓴 것의 중앙값(20회)입니다. 서버가 텍스트를 캐시하므로, 이미 보낸 문서에 질문을 더 묻는 것은 질문 값만 지불합니다. 초당 요청은 각자 새 짧은 텍스트에 여섯 질문을 보내는 동시 클라이언트 64개 기준이며, 서버가 그것들을 배치합니다. Kev-27B의 B200과 H100 행은 이전 버전, 즉 같은 아키텍처를 bf16으로 서빙한 것에서 측정했습니다(runs/fused-27b-*); H200 행은 현재 체크포인트입니다(runs/serving-27b-r23). 네트워크 시간은 별도입니다: 같은 리전의 Modal 웹 엔드포인트를 거치는 왕복당 약 65 ms입니다.
Kev-0.8B에는 L4로 충분하지만 Kev-4B에는 너무 느립니다. A100은 여기서 L40S보다 느리고 더 비쌉니다. Kev-9B는 GPU 메모리 약 17 GB가 필요하고 Kev-27B는 가중치 51 GB(배칭 버퍼를 포함하면 약 66 GB)가 필요합니다; 부하가 걸리면 Kev-27B는 컴퓨트 바운드이고, B200, H200, H100은 요청당 비용이 비슷합니다. CUDA에서 Qwen3.5 모델에는 flash-linear-attention을 설치하십시오(kev_serve.py와 Modal 이미지는 이미 설치합니다).
Apple Silicon에서는 uv sync --extra serve가 MLX를 설치하고 서버가 자동으로 그것을 씁니다. M5(32 GB)에서 약 270 토큰 텍스트에 대한 다섯 질문:
| 모델 | 새 텍스트 | 같은 텍스트 다시 |
|---|---|---|
| Kev-0.8B | 149 ms | 28 ms |
| Kev-4B | 721 ms | 136 ms |
긴 문서는 1,024 토큰씩 캐시로 읽히므로 메모리가 가중치에 가깝게 유지됩니다. 65,000 토큰 문서에서 Kev-0.8B는 처음 21.2초, 이후 202 ms가 걸리고 피크는 3.8 GB이며, Kev-4B는 84.5초와 716 ms에 13.0 GB입니다(runs/mlx-long-states; 모델 카드에 모든 길이가 있습니다). Kev-9B는 이 방식으로 아직 측정하지 않았습니다.
어댑터 체크포인트는 로드될 때 베이스로 접혀 들어가므로 잠시 가중치 사본을 하나 더 들고 있습니다. Kev-27B 같은 전체 가중치 체크포인트는 저장된 대로 로드되고 아무것도 병합되지 않아, 로딩에 가중치만 필요합니다. Kev-4B를 전체 bf16 가중치로 써서 확인했습니다: 로딩 피크가 가중치 8.4 GB에 8.4 GB였고, 어댑터 경로는 15.9 GB였습니다. 둘 다 같은 bf16 값을 들면 답이 어댑터 경로와 정확히 일치했고, 60 질문에서 fp32 경로와 0.015 이내로 유지되었습니다(runs/mlx-full-4b). Kev-27B의 가중치는 51 GB입니다. 같은 측정에 따르면 약 51 GB에 작업 메모리를 더한 정도가 필요하므로 64 GB Mac은 경계선이고 96–128 GB Mac이면 들어갈 것입니다. 그렇게 큰 Mac에서 실행해 본 적은 없습니다. Kev-27B의 첫 버전, 즉 어댑터는 128 GB M5 Max에서 이 방식으로 돌았고 공개 정확도와 일치했습니다(Sean Connelly에게 감사, #175).
서버는 GPU와 Mac에서 bf16으로 돌아갑니다. 그 확률은 공개 평가가 쓰는 fp32 경로와 GPU에서 최대 약 0.03, Mac에서 0.05만큼 다르고, 최상위 답은 약 300 질문에 하나꼴로 바뀝니다. 정확한 경로를 쓰려면 KEV_DTYPE=fp32를 설정하십시오. /v1/models는 사용 중인 백엔드와 정밀도를 보고합니다. uv run modal run modal_app.py::serving --run jaredpalmer/kev-4b --gpu L40S --name <name>은 자신의 계정에서 표의 한 행을 측정합니다(위 행들: runs/serve-*, runs/grouping-4b-h100, runs/fused-27b-*, runs/serving-27b-r23).
한계
- 캘리브레이션은 단일 온도입니다. 신뢰도의 순서를 바꿀 수 없으므로, 5% 오류 예산에서 자동화할 수 있는 새 소스 결정의 비율(Kev-4B, 9B, 27B의 경우 0.52–0.69)은 여전히 Jev의 0.70 아래입니다. 의존하기 전에 자신의 데이터에서 확률 임계값을 시험하십시오.
- 지식 질문은 베이스 모델이 정합니다. MMLU는 Kev-9B가 0.73으로 Jev의 0.90에 못 미치고, MMLU-Pro는 0.59 대 0.84입니다.
- 파인튜닝은 베이스 모델을 개별 과제에서 더 나쁘게 만들 수 있습니다. 날짜 산술이 가장 분명한 사례였습니다(이슈 #8); 명시된 일수와
KEV_DATE_FACTS=1로 학습하면 회복됩니다. - 옵션 순서를 바꾸면 답이 바뀔 수 있습니다. 질문 격리가 이것을 막지는 않습니다.
- Kev-0.8B, 4B, 9B는 주로 최대 384 state 토큰과 state+질문 하나에 1,024 토큰으로 학습했고(문서·스킬 파인튜닝은 최대 7,552 토큰 state), Kev-27B는 최대 32,768 토큰 state로 학습했습니다. 서빙은 65,536 토큰 state를 허용하며, 각 모델의 검증된 컨텍스트 길이는 모델에 있습니다.
- Mac에서는 답이 수십 ms가 아니라 수백 ms 걸립니다. Kev-27B는 80 GB GPU가 필요합니다. Mac에서는 약 51 GB에 작업 메모리를 더한 정도가 필요하며, 96–128 GB Mac이면 들어갈 것으로 예상하지만 측정해 본 적은 없습니다.
- Kev-27B는 학습 데이터를 모르는 post-trained 모델에서 출발합니다.
개발
uv run --extra serve python -m pytest tests/test_unit.py tests/test_research.py tests/test_generators.py tests/test_conventions.py \
    tests/test_documents_tools.py tests/test_hard_v1.py tests/test_devtools_v1.py tests/test_breadth_v1.py tests/test_rounds.py tests/test_skill_scripts.py -q   # no weights, no server; what CI runs
KEV_BASE_URL=http://127.0.0.1:8009 uv run --extra serve python -m pytest tests/test_api.py -q   # against a running server
cd playground && npm run lint && npx next typegen && npx tsc --noEmit -p .
API 테스트는 TypeSafe의 예제 요청과 공식 SDK를 로컬 서버에 대해 실행합니다. PLAN.md는 연구 계획입니다: 배운 것, 모든 실험이 따르는 규칙, 라운드당 한 줄입니다. 전체 로그(모든 실험, 실행 전에 정한 기준, 그리고 결과)는 git tag research-archive-2026-09-24에 있습니다.
이전 세대(Qwen3)와 프로토타입
첫 Kev 패밀리는 Qwen3 베이스를 같은 데이터와 설정으로 썼습니다. 그 가중치는 계속 공개되어 있고 Mac에서 순수 PyTorch로 돌지만, 더 이상 개발되지 않습니다.
| 모델 | 베이스 | 정확도: 학습된 소스 | 정확도: 새 소스 | Brier: 새 소스 | 모델 카드 |
|---|---|---|---|---|---|
Kev-0.6B (Qwen3) — jaredpalmer/kev-0.6b |
Qwen3-0.6B-Base | 0.801 / 0.808 | 0.620 / 0.642 | 0.536 / 0.483 | 세부 정보 |
Kev-4B (Qwen3) — jaredpalmer/kev-4b@qwen3 |
Qwen3-4B-Base | 0.854 / 0.856 | 0.790 / 0.806 | 0.328 / 0.294 | 세부 정보 |
Kev-8B (Qwen3) — jaredpalmer/kev-8b |
Qwen3-8B-Base | 0.863 / 0.870 | 0.796 / 0.780 | 0.337 / 0.327 | 세부 정보 |
문제 해결
- 학습 중 MPS 메모리가 부족하면 작업을 하나만 돌리고 있는지 확인하십시오.
output_hidden_states를 켜거나 peft의trainable_token_indices로 토큰을 추가하지 마십시오; 둘 다 여기서 메모리 문제를 일으켰습니다. - 플레이그라운드는 로드되지만 버튼이 동작하지 않으면
localhost:3001을 쓰십시오. Next.js가 개발 호스트명을 검사합니다. 다른 호스트는playground/next.config.ts의allowedDevOrigins에 항목이 필요합니다. - 데이터셋 로딩이
Dataset scripts are no longer supported를 보고하면legacy-datasets/banking77을 쓰십시오. 이 저장소는 이미 그것을 씁니다.
작성자
- Jared Palmer (@jaredpalmer)
Devin으로 만들었습니다. 아키텍처 해설을 써준 Archer Hume, API 설계를 위한 TypeSafe, 베이스 모델을 위한 Qwen에 감사합니다.
라이선스
Apache-2.0. Qwen3, Qwen3.5와 Qwen3.8 베이스 모델도 Apache-2.0입니다. 학습 데이터셋은 자체 라이선스를 가집니다; 모델 카드를 참고하십시오.