Kleine Jev-ähnliche Entscheidungsmodelle, die du selbst trainieren und ausführen kannst.
Kev ist eine Familie kleiner Entscheidungsmodelle, die auf Qwen3.5 und Qwen3.8 aufbauen und auf der Architektur beruhen, die in Jev’s Architecture Unmasked beschrieben wird. Du kannst die vortrainierten Gewichte verwenden oder deine eigenen trainieren. Die API entspricht dem System One von TypeSafe, sodass du deren Python-SDK auf deinen lokalen Server richten kannst.
Highlights
- Ja/Nein- (
noul), Multiple-Choice- (choice) und Bewertungsfragen (score) in einer einzigen Anfrage. Die Fragen teilen sich den Text, können sich aber nicht gegenseitig lesen. - Kalibrierte Wahrscheinlichkeiten standardmäßig: Jeder Checkpoint wird mit einer angepassten Temperatur ausgeliefert.
- Drop-in-Ersatz für Jev: Das TypeSafe-Python-SDK funktioniert unverändert gegen einen Kev-Server.
- Vier Größen, gemeinsam als Kev 1.0 versioniert: von einem 0.8B-Modell, das auf einem Laptop läuft, bis zu einem 27B-Modell für eine einzelne Rechenzentrums-GPU.
- Dokumente mit bis zu 65,536 Token, auf CUDA und auf Apple Silicon über MLX. Jede Modellkarte sagt, wie lang ein Dokument werden kann, bevor die Genauigkeit sinkt.
- Feinabstimmung mit deinen eigenen beschrifteten Beispielen. Ein Coding-Agent-Skill führt die gesamte Schleife auf Modal aus, vom Auffinden deiner Fragen bis zum Ausliefern des Ergebnisses.
- Stelle deinen eigenen HTTPS-Endpunkt mit einem einzigen Befehl bereit. Er skaliert auf null, wenn er inaktiv ist.
- Probiere es zuerst im Browser aus: huggingface.co/spaces/jaredpalmer/kev.
Modelle
Beginne mit Kev-4B. Wechsle zu Kev-9B, wenn du eine größere GPU hast, oder zu Kev-27B, wenn du eine 80-GB-GPU hast und den genauesten Kev willst. Nutze Kev-0.8B, wenn die Größe mehr zählt als die Genauigkeit.
| Modell | Basis (Lizenz) | Läuft auf: CUDA | Läuft auf: Mac (MLX) | Validisierter Kontext | Zurückgehaltene Datensätze: Index | Karte |
|---|---|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base (Apache-2.0) | L4, jede 4-GB-GPU | Jeder Apple-Silicon-Mac; gemessen bis 65k Token | 8,192 | 23.3 | Details |
| Kev-4B | Qwen3.5-4B-Base (Apache-2.0) | L40S, H100 | 32-GB-Mac; gemessen bis 65k Token | 8,192 | 38.0 | Details |
| Kev-9B | Qwen3.5-9B-Base (Apache-2.0) | L40S, H100 | 32-GB-Mac oder größer (erwartet, nicht gemessen) | 8,192 | 41.0 | Details |
| Kev-27B | Qwen3.8-27B, nachtrainiert (Apache-2.0) | B200, H200, H100 80 GB | 96–128-GB-Mac (erwartet, nicht gemessen) | 65,536 | 52.3 | Details |
| Jev | Gehostet | API von TypeSafe | – | – | 54.0 | – |
„Zurückgehaltene Datensätze” ist der zufallskorrigierte Index des Community Decision Index, bewertet auf dem Test-Split von breadth-v1: 14 öffentliche Datensätze in fünf Bereichen, auf denen kein Kev trainiert wurde. „Validierter Kontext” ist das längste Dokument, in Token, für das die Genauigkeit auf echten Verträgen (CUAD) an der 95-%-Untergrenze im Rahmen von 3 Punkten der Genauigkeit desselben Modells bei 8k Token bleibt; jede Modellkarte enthält die Messung nach Länge.
| Modell | Genauigkeit: Neue Quellen | Genauigkeit: Trainierte Quellen | Brier: Neue Quellen |
|---|---|---|---|
| Kev-0.8B | 0.648 / 0.697 | 0.827 / 0.838 | 0.481 / 0.416 |
| Kev-4B | 0.817 / 0.838 | 0.873 / 0.865 | 0.269 / 0.242 |
| Kev-9B | 0.820 / 0.852 | 0.874 / 0.873 | 0.289 / 0.217 |
| Kev-27B | 0.851 / 0.889 | 0.865 / 0.866 | 0.225 / 0.156 |
| Jev | 0.857 / – | 0.845 / – | 0.211 / – |
Jede Zelle ist Development / Test. „Neue Quellen” bedeutet Datensätze und Policy-Regeln, die Kev während des Trainings nie gesehen hat. Das kommt deinen eigenen Fragen hier am nächsten. „Trainierte Quellen” bedeutet zurückgehaltene Beispiele aus den Datensätzen, auf denen Kev trainiert wurde. Wir wählen Checkpoints anhand der Development-Sets und lesen jedes Test-Set nur einmal pro veröffentlichtem Modell. Jev wurde nur auf den Development-Sets dieser beiden Suites ausgeführt. Brier bewertet die gesamte Wahrscheinlichkeitsverteilung, nicht nur die beste Antwort; niedriger ist besser.
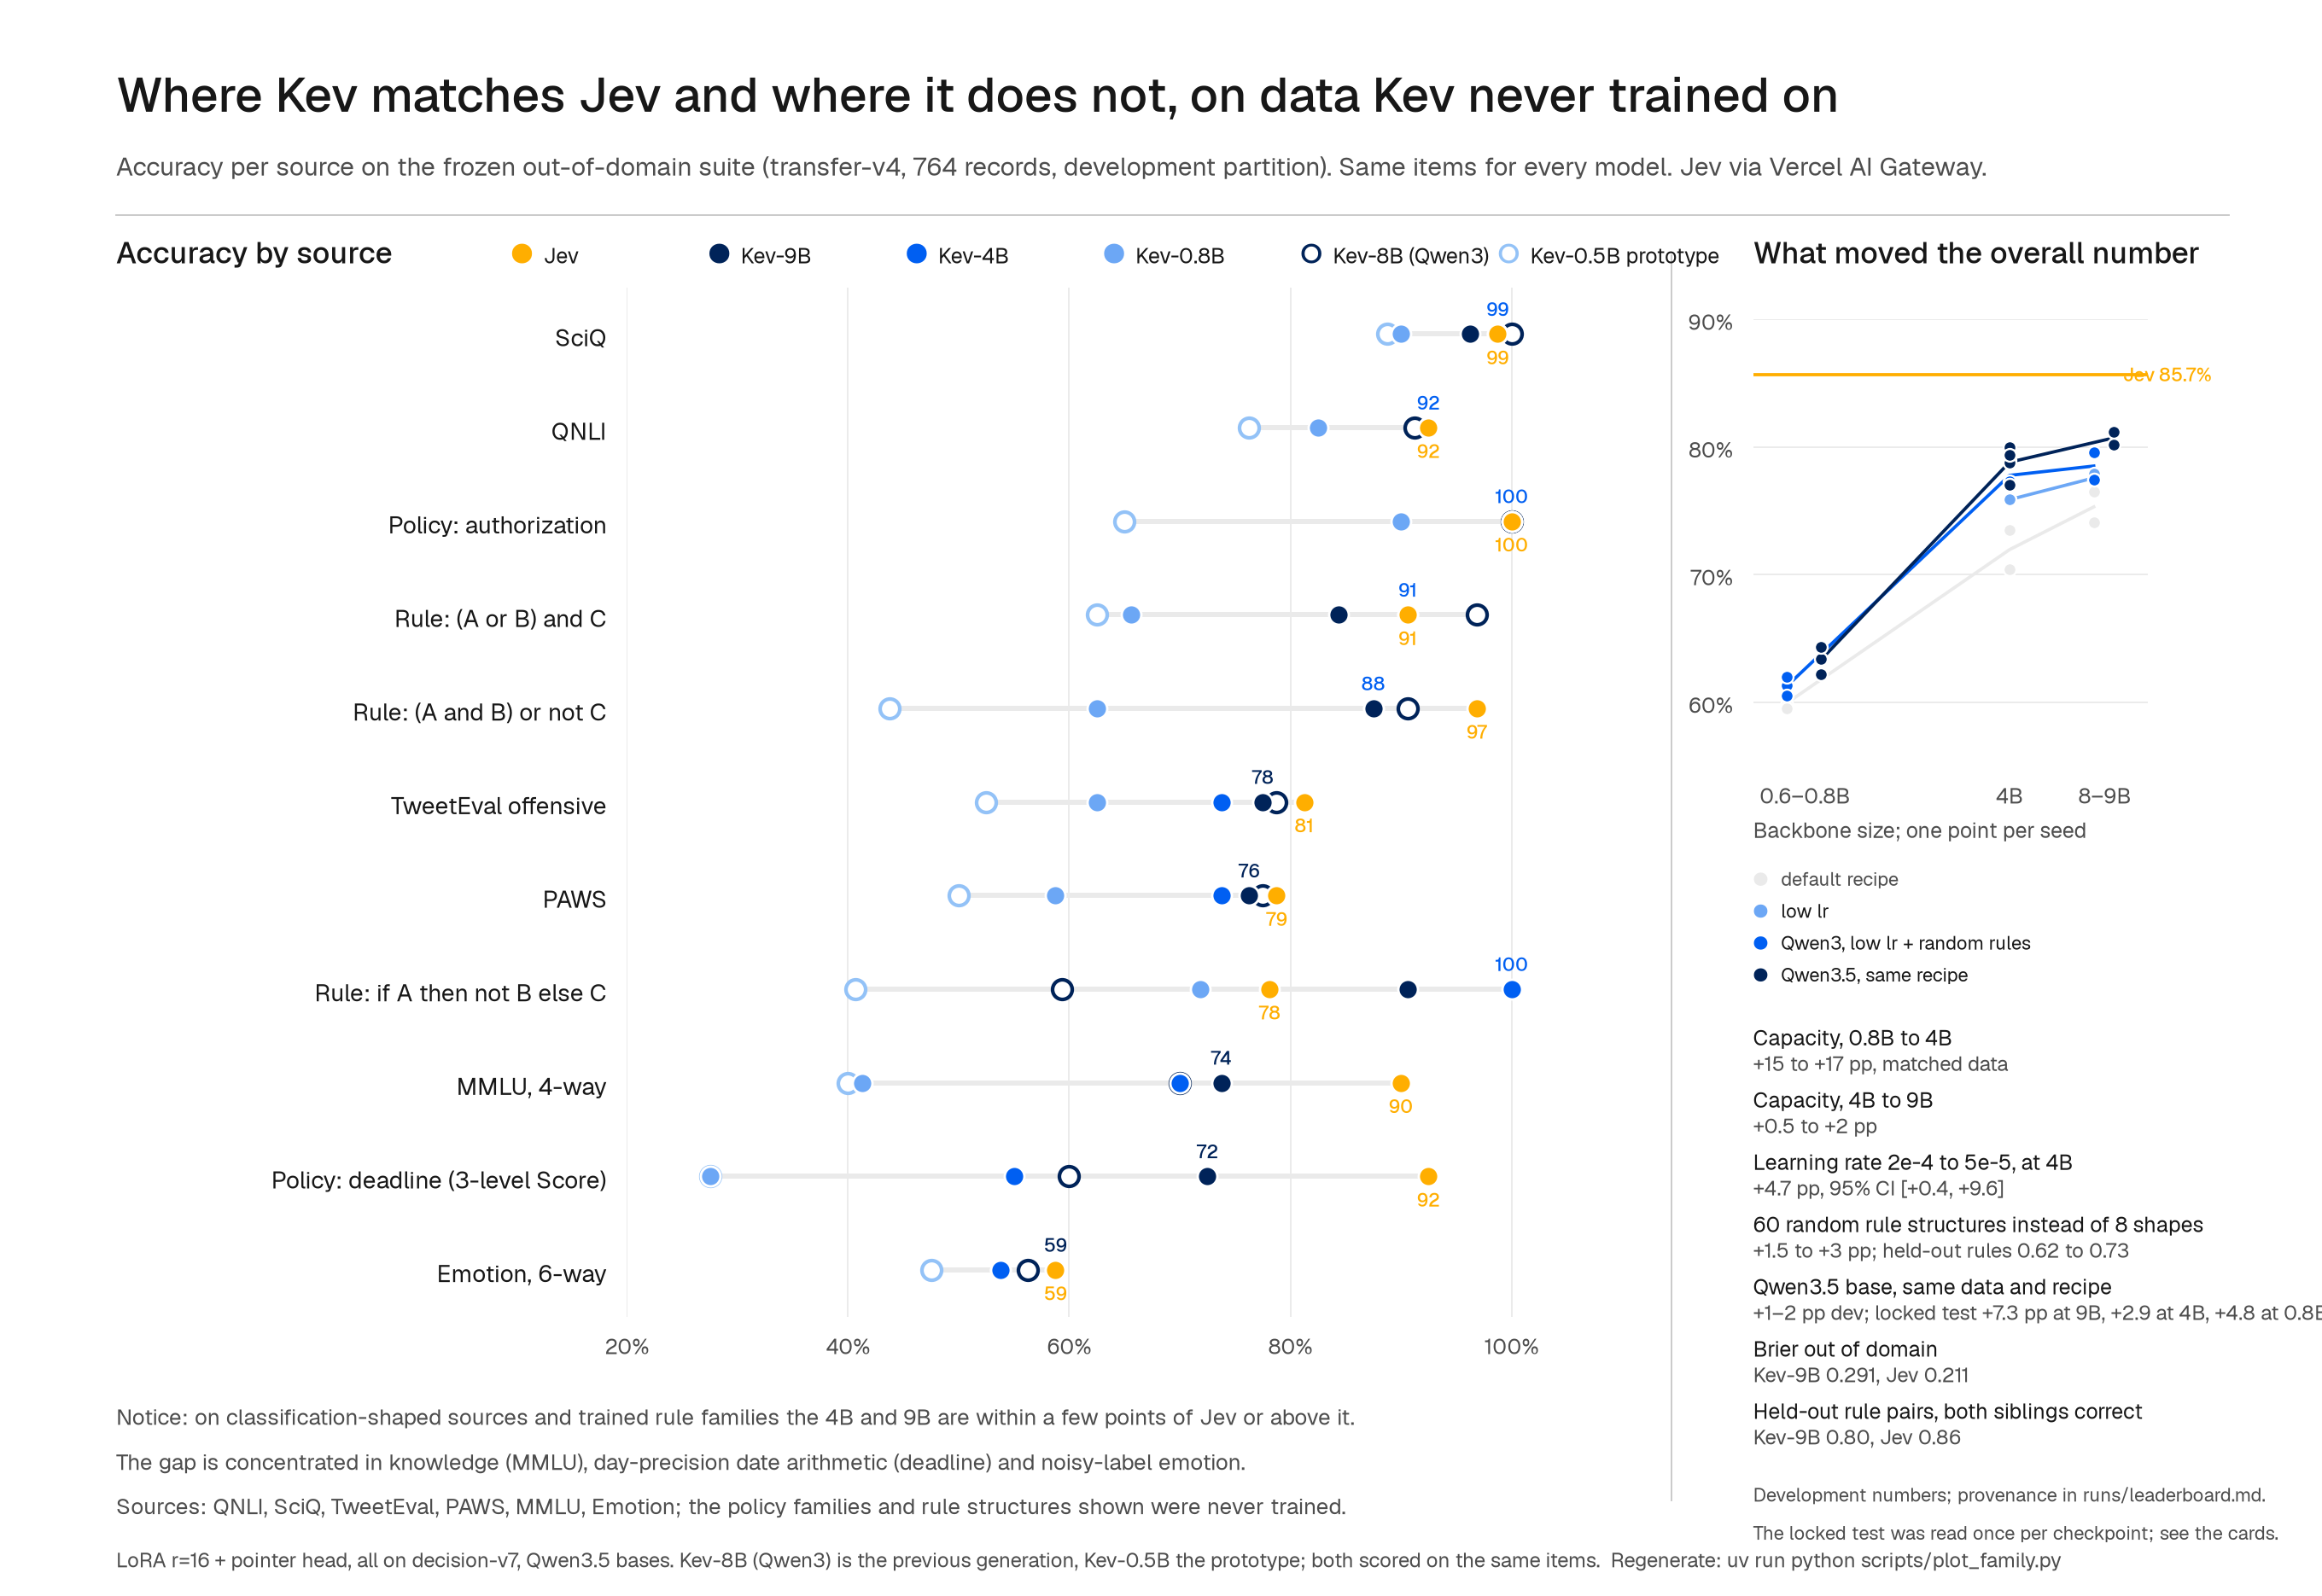
Bei neuen Quellen liegt Kev-27B innerhalb eines Punkts von Jev (0.851 vs 0.857), und Kev-4B und Kev-9B liegen innerhalb von vier Punkten. Wir wissen nicht, worauf Jev trainiert wurde, daher ist dies kein kontrollierter Vergleich der beiden Architekturen. Was zu erwarten ist sagt, wo Kev so gut ist wie Jev und wo nicht.
Kev-0.8B, 4B und 9B starten von Qwen-Basismodellen und teilen sich ein Trainingsrezept: ein kleiner Adapter auf einer eingefrorenen Basis. Kev-27B startet von Qwens nachtrainierter Veröffentlichung, und wir wissen nicht, worauf diese trainiert wurde; jedes seiner Gewichte ist feinabgestimmt, daher wird es als 51 GB vollständige Gewichte statt als Adapter ausgeliefert. Jede Modellkarte enthält das vollständige Rezept, alle Ergebnisse und die früheren Versionen, die als Hub-Tags erhalten bleiben.
Kev 1.0
Die vier obigen Modelle werden gemeinsam als Kev 1.0 veröffentlicht. Jedes Hub-Repo hat ein v1.0-Tag, sodass --run jaredpalmer/kev-4b@v1.0 immer dieselben Gewichte lädt, und die GitHub-Release kev-1.0 enthält die 0.8B-, 4B- und 9B-Checkpoints mit SHA-256-Prüfsummen. Die 51 GB Gewichte von Kev-27B sind zu groß für ein Release-Artefakt und liegen nur auf dem Hub.
| Modell | Hub-Revision der Gewichte | Temperatur | Trainiert auf Zuständen bis zu |
|---|---|---|---|
| Kev-0.8B | 9a45d25e |
2.35 | 7,552 Token |
| Kev-4B | 139fdd94 |
2.41 | 7,552 Token |
| Kev-9B | b5d8c18e (v2) |
2.19 | 7,552 Token |
| Kev-27B | 28be62e9 (v2, vollständige Gewichte) |
1.32 | 32,768 Token |
Kev 1.0 trainiert nichts Neues. Es fixiert die Checkpoints, Karten, Evaluations-Suites und den Serving-Code, gegen die die nächste Generation von Kev gemessen wird. Die Release-Notes listen, was sich seit der vorherigen Familienveröffentlichung geändert hat und was bekanntermaßen nicht gut funktioniert.
Schnellstart
Im Browser ausprobieren
Der Hugging Face Space führt Kev-4B und Kev-0.8B aus, ohne dass etwas installiert werden muss.
Lokal ausführen
Du brauchst Python 3.12 oder 3.13 und uv. Die .python-version des Repos sorgt dafür, dass uv sync 3.13 verwendet; torch hat noch keine Wheels für 3.14.
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
Dies startet Kev-4B auf deiner Maschine: CUDA oder ROCm, wenn du eine GPU hast, MLX auf Apple Silicon. Der erste Lauf lädt den Adapter und das Basismodell herunter. --run akzeptiert auch ein lokales Checkpoint-Verzeichnis oder eine Hub-Revision wie jaredpalmer/kev-4b@qwen3.
Sende ihm in einem anderen Terminal ein Ticket:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
Beispielantwort von Kev-4B, ausgeführt in bf16 auf einem Apple M5:
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.34,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
}
Das Ticket erwähnt eine Rücksendung, eine verspätete Lieferung und ein Abrechnungsproblem, und die Abteilungswahrscheinlichkeiten sagen genau das. Deshalb gibt Kev Wahrscheinlichkeiten statt eines einzelnen Labels zurück: Dein Code kann die sicheren Fälle weiterleiten und den Rest an einen Menschen schicken.
Aus Python verwenden
Wenn du Jev bereits aufrufst, richte deinen Client auf Kev und behalte den Rest deines Codes. Das TypeSafe-SDK ist in uv sync --extra serve enthalten:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
Auf eigenen Daten feinabstimmen
Die veröffentlichten Modelle wurden auf öffentlichen Datensätzen und generierten Policy-Beispielen trainiert. Wenn deine Fragen anders aussehen – etwa deine eigenen Routing-Kategorien, deine eigenen Eskalationsregeln oder eine andere Sprache –, hilft eine kurze Feinabstimmung meist mehr als jede Prompt-Änderung. Sie passt außerdem die Temperatur an deine Daten an, sodass die Konfidenz, auf der du Schwellenwerte setzt, an deinen eigenen Labels gemessen wird.
Was zu erwarten ist: Bei einer beispielhaften Support-Arbeitslast (drei Fragen, 1,050 generierte Datensätze, 15 Minuten auf einer H100) hob die Feinabstimmung Kev-4B von 67.7% auf 73.6% Genauigkeit und von der Automatisierung von 34% der Entscheidungen bei einem 5%-Fehlerbudget auf 48% (Details). Auf echten Daten hob eine Epoche auf 5,219 beschrifteten Verbraucherfinanz-Beschwerden Kev-4B von 0.804 auf 0.904 Genauigkeit bei Beschwerden, die es nie gesehen hatte. Solche Zugewinne liegen in der Verteilung: Sie sagen dir, wie gut Kev deine Aufgabe lernt, nicht wie es auf allem anderen abschneidet. Dimensioniere zuerst deinen Datensatz. Bei 400 Datensätzen lag der Zugewinn auf der Beispiel-Arbeitslast im Rauschen.
Mit einem Coding-Agent
npx skills add jaredpalmer/kev@kev-finetuneBitte dann deinen Agenten, „Kev auf meinen Support-Tickets feinabzustimmen”. Der kev-finetune-Skill befragt dich, findet die Fragen, die dein Code bereits Jev oder TypeSafe stellt, konvertiert die Labels, die du hast, oder generiert genug mit einem beliebigen LLM, um einen Zugewinn zu messen, stimmt von einem veröffentlichten Checkpoint auf Modal fein ab, fittet die Temperatur auf einem zurückgehaltenen Ausschnitt, bewertet das Ergebnis gegen das unangetastete Modell, stellt einen Endpunkt bereit und reißt am Ende alles wieder ab. Du brauchst keine lokale GPU und keinen Klon dieses Repos. Ein Kev-4B-Trainingslauf kostet etwa $1 auf einer H100.
Von Hand
Die README des Skills ist dasselbe Rezept für Menschen: sechs kurze Standardbibliotheks-Skripte und eine Modal-App. Um stattdessen aus diesem Repo zu trainieren, lege deine Beispiele in eine JSONL-Datei, eine Anfrage pro Zeile. Sie hat dieselbe Form wie eine API-Anfrage, plus ein label an jeder Frage:
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
   "priority": {"type": "score",  "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}
Für choice ist das Label der Optionsname, für noul ist es true oder false, und für score ist es die Position der Stufe, beginnend bei 0. Behalte 10–20% der Datei für die Evaluation zurück.
Starte dann von einem veröffentlichten Checkpoint mit --init_from:
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine

uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
uv run --extra serve python -m kev.serve --run runs/mine --port 8009
--init_from lädt den Adapter und den Pointer-Head aus dem veröffentlichten Modell vor dem Training, sodass du behältst, was Kev bereits weiß, und deine Domäne oben draufsetzt. Stattdessen vom Basismodell zu starten wirft das weg: In einem Nutzertest mit 836 Support-Tool-Entscheidungen erzielte eine Feinabstimmung von der Basis 0.33 auf Kevs eigenem Evaluations-Set, gegenüber 0.84 für das veröffentlichte Modell; dieselben Daten mit --init_from hielten dort 0.83 und erreichten 0.88 in der neuen Domäne. Verwende eine kleinere Lernrate als im From-Scratch-Rezept ( 2e-5 ist ein guter Anfang), und wähle --base passend zum Checkpoint, von dem du startest; der Trainer prüft, dass Basis, Revision, LoRA-Rang und Head-Größe übereinstimmen, bevor er etwas lädt.
--batch 1 --accum 8 in bf16 passt das 0.8B-Modell auf eine 4-GB-GPU. Das Benchmark berichtet Genauigkeit, Brier-Score und Kalibrierung pro Fragetyp, sodass du siehst, welchen deiner Fragen die Feinabstimmung geholfen hat. Der Checkpoint, von dem du gestartet bist, wird in runs/mine/training_config.json festgehalten. Führe auf einem Mac jeweils einen Trainingsjob aus; zwei Jobs auf derselben Apple-GPU sind deutlich langsamer.
Eigenen Endpunkt bereitstellen
Um einen HTTPS-Endpunkt statt eines lokalen Servers zu bekommen, brauchst du dieses Repo nicht, nur ein Modal-Konto:
pip install modal && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
Das bedient Kev-4B auf einer L40S unter https://<your-workspace>--kev-api.modal.run, mit derselben API wie oben hinter Authorization: Bearer <key>. Es skaliert auf null, wenn es inaktiv ist, sodass ein ungenutzter Endpunkt nichts kostet. Die erste Anfrage nach der Ruhephase wartet etwa 35 Sekunden, bis ein Container startet. KEV_MODEL=jaredpalmer/kev-9b bedient ein anderes Modell auf der dazu passenden GPU; Kev-27B geht auf eine B200, mit Rückfall auf eine H200 oder H100. Wenn du einen Coding-Agent nutzt, macht npx skills add jaredpalmer/kev@kev-deploy dasselbe und verdrahtet die URL in deinen Code. skills/kev-deploy enthält die GPU- und Kostentabelle.
Ein Modell, das du mit dem kev-finetune-Skill feinabgestimmt hast, wird auf dieselbe Weise aus seiner eigenen Modal-App bereitgestellt (KEV_SERVE_SECRET=kev-serve-key KEV_SERVE_RUN=<run> modal deploy scripts/kev_modal.py; siehe seine Bereitstellungsanleitung). Um Kev stattdessen auf deinen eigenen Maschinen zu hosten, führe kev.serve aus Lokal ausführen auf einer GPU-Box mit --host 0.0.0.0 aus und stelle es hinter deinen eigenen Proxy; Serving-Leistung sagt, welche GPU du wählen solltest.
Was zu erwarten ist
Genauigkeit. Kev-27B liegt bei 9 der 11 Kategorien neuer Quellen im untenstehenden Diagramm innerhalb von drei Punkten von Jev oder davor. Kev-4B und Kev-9B sind bei klassifikationsförmigen Quellen wie Routing, Entailment und Wissenschaftsfragen ähnlich nah dran. Wissensfragen hängen größtenteils vom Basismodell ab: Bei MMLU erreicht Kev-9B 0.73 und Kev-27B zieht mit Jev bei 0.90 gleich, aber beim schwierigeren MMLU-Pro erreicht Kev-27B 0.675 gegenüber Jevs 0.840. Die kleineren Modelle liegen auch bei der Datumsarithmetik mit Tagesgenauigkeit zurück.
Konfidenz. Jeder Checkpoint wird mit einer angepassten Temperatur ausgeliefert, sodass seine Wahrscheinlichkeiten standardmäßig kalibriert sind. Im ausgelieferten Zustand legt Kev-9B bei 2.4% der Fragen neuer Quellen mindestens 0.9 Wahrscheinlichkeit auf eine falsche Antwort, gegenüber Jevs 3.7%. Jev ordnet seine Antworten weiterhin besser: Bei einem 5%-Fehlerbudget können Kev-4B, 9B und 27B 0.52–0.69 der Entscheidungen bei neuen Quellen automatisieren, Kev-0.8B 0.14 und Jev 0.70. Prüfe einen Schwellenwert an deinen eigenen Daten, bevor du dich darauf verlässt.
Geschwindigkeit. Kev-4B beantwortet sechs Fragen zu einem neuen kurzen Text in 18.1 ms Modellzeit auf einer H100 und 41.5 ms auf einer L40S, und ein Container bedient rund 101 Anfragen pro Sekunde auf einer H100. Auf einem Apple M5 braucht Kev-4B 721 ms für fünf Fragen, oder 136 ms, wenn der Text sich wiederholt und aus dem Cache kommt. Serving-Leistung enthält jede GPU und Batch-Größe.
Länge. Kev-0.8B, 4B und 9B wurden größtenteils auf Zuständen von bis zu 384 Token trainiert, mit längeren in ihren Dokument- und Skill-Feinabstimmungen (bis zu 7,552 Token), Kev-27B auf Zuständen von bis zu 32,768. Der Server akzeptiert Zustände von bis zu 65,536 Token, und 8,192 mehr für jede Frage, und lehnt einen längeren mit einem 422 ab, statt ihn zu kürzen. Wie weit über seine Trainingslänge hinaus jedes Modell genau bleibt, ist die Spalte „Validierter Kontext” in Modelle. Für Kev-0.8B, 4B und 9B sind das 8,192 Token: Bei 16k kann die Messung auf echten Verträgen einen Rückgang von mehr als 3 Punkten nicht mehr ausschließen, und bei 32k sind alle drei messbar weniger genau als bei 8k. Kev-27B hält das 65,536-Token-Limit. Auf echten Verträgen von bis zu 64k Token (CUAD) erreicht Kev-27B 0.874, und seine Konfidenz dort ist weniger verlässlich als auf kurzem Text; seine Modellkarte enthält die Zahlen nach Länge.
Playground
Öffne bei laufendem Server ein weiteres Terminal. Du brauchst Node 20.9+:
cd playground
npm install
npm run dev -- -p 3001
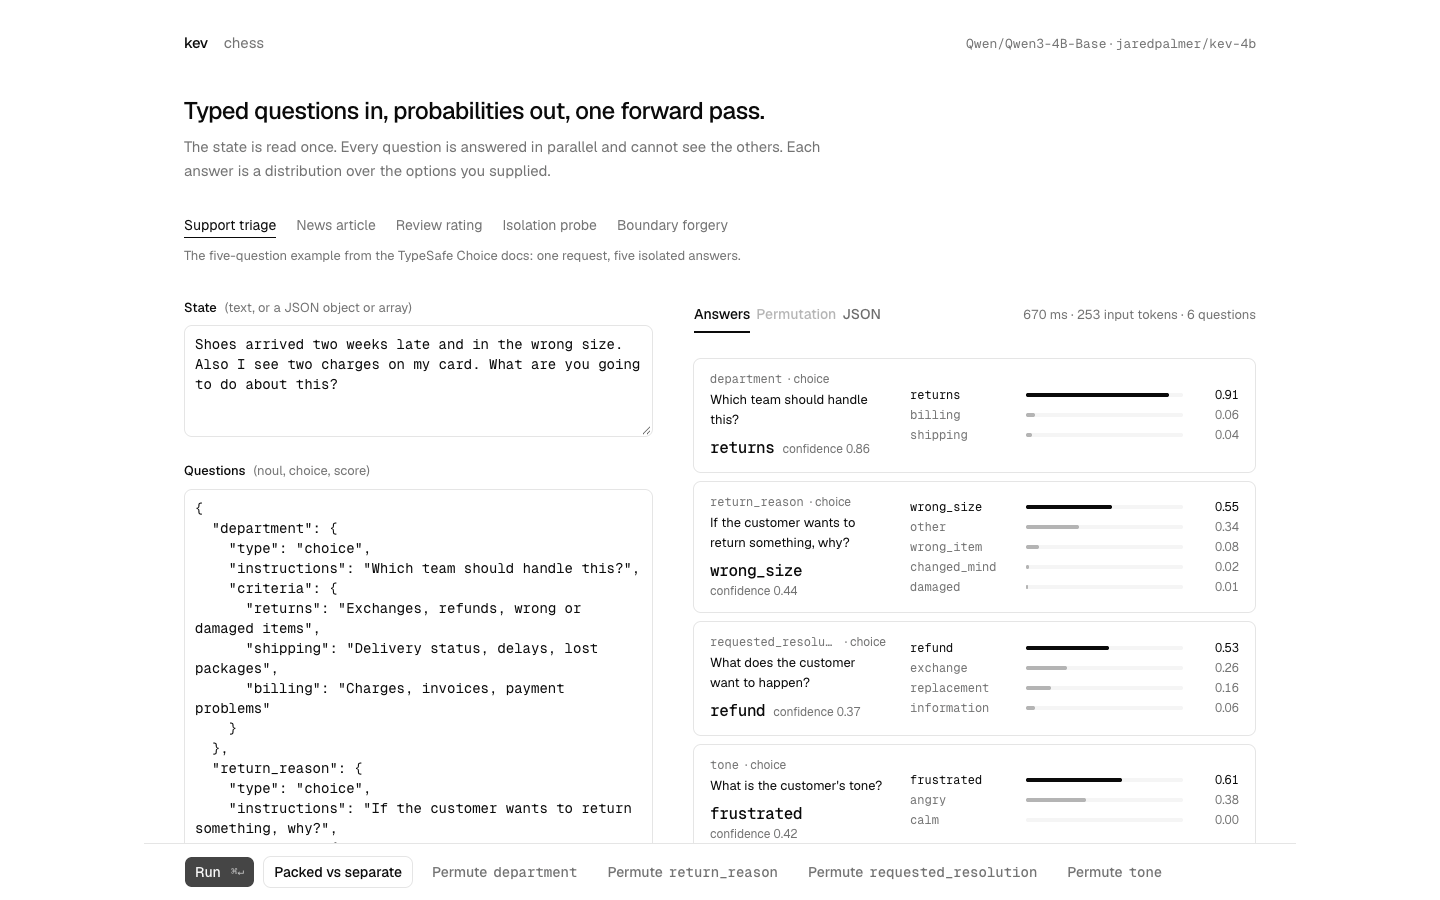
Öffne localhost:3001, lade ein Preset und bearbeite den Text und die Fragen. Drücke ⌘↵, um es auszuführen. „Packed vs separate” vergleicht das Fragen aller Fragen auf einmal mit dem Fragen eine nach der anderen. „Permute” führt eine Choice-Frage mit sechs Optionsreihenfolgen aus. Es gibt auch Presets zum Testen der Fragenisolation und gefälschter Delimiter-Token.
Es gibt auch eine Schach-Demo. Das Brett ist die Eingabe, legale Züge sind Choice-Optionen, und eine Score-Frage bewertet die Stellung. Du kannst gegen Kev spielen oder es gegen sich selbst spielen lassen. Spiele werden in localStorage gespeichert.
API
POST /v1/systemone
state ist der Text, der ausgewertet werden soll. Jede Frage hat Anweisungen und, wo nötig, eine Menge von Antworten zur Auswahl.
{
  "state": "…",                          // string | object | array — the content to evaluate
  "model": "kev-latest",
  "questions": {
    "<id>": {                            // you choose the id; the model never sees it
      "type": "noul" | "choice" | "score",
      "instructions": "…",               // string | object | array, optional
      "criteria": …                      // noul: {true?, false?}  choice: {option: description|null}  score: [level, …]
    }
  }
}| Typ | Kriterien | Antwort |
|---|---|---|
noul |
Optionale Beschreibungen für true und false |
noul: Wahrscheinlichkeit für Ja |
choice |
1–255 Optionsnamen, jeder mit einer Beschreibung oder null |
choice: wahrscheinlichste Option; probabilities und confidence |
score |
1–255 Beschreibungen, geordnet von niedrigster bis höchster | score: mittlerer Level-Index, beginnend bei 0; legend, probabilities und confidence |
Für Choice mit K > 1 Optionen ist die Konfidenz (p_max − 1/K) / (1 − 1/K). Eine einzelne Option hat Konfidenz 1. Die Score-Konfidenz ist max(0, 1 − E|level − mode| / D): mode ist die wahrscheinlichste Stufe und D ist die mittlere Distanz einer Gleichverteilung über die Stufen von ihrer Mitte (2/3 bei drei Stufen), sodass die ganze Wahrscheinlichkeit auf einer Stufe 1 ergibt und eine Gleichverteilung oder breitere Streuung 0. Beide Formeln sind die aus TypeSafes Referenzadapter (system-one-adapter 0.2.1). Keines der Felder ist eine gemessene Genauigkeitsrate.
Objekte und Arrays werden in beschrifteten Text umgewandelt. Delimiter-artige Zeichenketten in der Nutzereingabe werden vor der Tokenisierung maskiert. Ungültige Anfragen geben 422 zurück, und ebenso ein Zustand, der länger als 65,536 Token ist: Der Server verwirft niemals stillschweigend einen Teil eines Dokuments, und der Fehler gibt die Token-Anzahl des Zustands und das Limit an. usage.output_tokens zählt Token in den serialisierten Antworten, keine generierten Token.
| Methode | Pfad | Zweck |
|---|---|---|
GET |
/v1/models |
Modellkarten (name, description, release_date) plus die Details des geladenen Checkpoints |
POST |
/v1/systemone/permute |
Eine Choice-Frage mit verschiedenen Optionsreihenfolgen ausführen (n_perm 1 bis 64, Standard 6) |
POST |
/v1/systemone/separate |
Jede Frage in ihrem eigenen Vorwärtspass ausführen |
Eine Anfrage kann beliebig viele Fragen tragen. Der Server führt sie jeweils ein Token-Budget auf einmal aus (eine maximale Zeile von 16,384 Token pro Vorwärtspass, wobei das gecachte Dokument einmal pro Frage in diesem Pass gezählt wird), sodass der Speicher nicht mit der Fragenanzahl wächst und die Antworten nicht von der Aufteilung abhängen. Jede Antwort trägt einen x-typesafe-request-id-Header. Der Server bindet an 127.0.0.1 (--host 0.0.0.0, um andere Maschinen zu akzeptieren) und ist standardmäßig offen; setze KEV_API_KEY, um für /v1/* Authorization: Bearer <key> zu verlangen, wie es die TypeSafe-Clients immer senden.
| Variable | Wirkung |
|---|---|
KEV_TEMPERATURE=1.0 |
Rohe Wahrscheinlichkeiten statt der kalibrierten zurückgeben |
KEV_DATE_FACTS=1 |
Die Anzahl der Tage zwischen zwei beliebigen Daten im Zustand anhängen (siehe Benchmarks) |
KEV_TRUNCATE_STATES=1 |
Die ersten 65,536 Token eines längeren Zustands lesen, statt ihn abzulehnen; jede Antwort hat dann truncated und usage.state_tokens / state_tokens_used |
KEV_DTYPE=fp32 |
Den exakten fp32-Pfad bedienen, den die Evaluationen verwenden (bf16 ist der Standard auf GPUs) |
KEV_API_KEY |
Einen Bearer-Schlüssel verlangen |
Wie es funktioniert
Jeder Checkpoint ist ein Rank-16-LoRA-Adapter und ein kleiner Pointer-Head auf einem Qwen-Basismodell. Auf einer reinen Attention-Basis (Qwen3) gehen der Zustand und die Fragen in eine einzige Token-Sequenz:
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
Die Attention-Maske lässt ein Token den Zustand und seine eigene Frage lesen, aber keine anderen Fragen oder zukünftigen Token. Die Position-IDs jeder Frage beginnen direkt nach dem Zustand neu. Dadurch kann das Modell den Zustand einmal verarbeiten und jede Frage unabhängig beantworten.
Qwen3.5 und Qwen3.8 mischen Attention-Schichten mit Gated-DeltaNet-Schichten, die rekurrent sind und Attention-Masken ignorieren. Für diese Modelle, also für jedes aktuelle Kev, läuft jede Frage als ihre eigene Zeile: der Zustand gefolgt von dieser Frage, mit denselben Positionen wie oben. Die Zeilen sind unabhängig, sodass die Isolation exakt ist, und der Server und DecisionModel.probs() berechnen den Zustand einmal und verwenden seinen Cache für jede Zeile wieder. forward(), das kev.benchmark bewertet und aus dem jede veröffentlichte Zahl stammt, behält die einfachen Zeilen und führt den Zustand einmal pro Frage aus; beide stimmen bis auf fp32-Rundung überein. Auf reinen Attention-Modellen ergeben die Zeilen und die obige Maske identische Wahrscheinlichkeiten (tests/test_model.py).
Kev-27B verwendet dasselbe Design auf Qwen/Qwen3.8-27B, mit zwei Unterschieden. Seine Basis ist Qwens nachtrainierte Veröffentlichung statt eines -Base-Checkpoints, und wir wissen nicht, worauf sie nachtrainiert wurde. Und jedes Backbone-Gewicht wird trainiert, nicht nur ein Adapter, und in bf16 gehalten, sodass der Checkpoint das ganze Modell ist: 51 GB bf16-Gewichte plus der Pointer-Head. Es wird nur in bf16 bedient (etwa 66 GB resident mit den Serving-Puffern), weshalb es eine 80-GB-Karte braucht. Auf Apple Silicon lädt das MLX-Backend diese Gewichte so, wie sie sind, ohne Merge (siehe Serving-Leistung); wir erwarten, dass das auf einen 96–128-GB-Mac passt, haben es aber nicht gemessen. Seine bedienten Wahrscheinlichkeiten bleiben auf einer H200 innerhalb von 0.022 des Evaluationspfads (runs/serving-27b-r23).
Der Pointer-Head bewertet den </opt>-Hidden-State jeder Option gegen den <decide>-Hidden-State der Frage. Ein Softmax verwandelt diese Scores in Wahrscheinlichkeiten. Da <decide> zuletzt kommt, kann es auf die vollständige Optionsliste achten.
Das Training verwendet Cross-Entropy auf der richtigen Antwort. Der Adapter und der Head werden zusammen trainiert; die übrigen Gewichte der Basis bleiben fest (Kev-27B trainiert sie alle). Trainingsbeispiele und API-Anfragen verwenden dasselbe Textformat. Es wurden keine Jev-Ausgaben für das Training verwendet.
Fragen gemeinsam oder getrennt zu stellen erzeugt in den fp32-Tests Wahrscheinlichkeiten innerhalb von 4e-6. Das bedeutet nicht, dass die Optionsreihenfolge irrelevant ist: Optionen innerhalb einer Frage können sich weiterhin gegenseitig beeinflussen. Siehe den Modellcode und Paritätstests.
Training
Die veröffentlichten Modelle teilen sich ein Basistraining-Set, decision-v7: 10,000 Beispiele aus zehn öffentlichen Datensätzen, 896 generierte Policy-Beispiele und 1,680 Beispiele aus 60 generierten Regelstrukturen. Kev-0.8B, 4B und 9B trainieren zwei Epochen darauf mit LoRA-Rang 16 und Cross-Entropy. Die Lernrate ist 1e-4 für 0.8B und 5e-5 für 4B und 9B. Auf diesen hybriden Basen deckt der Adapter die Attention-, MLP- und DeltaNet-Projektionen ab; kev.train wählt die richtigen Ziele aus der Modellkonfiguration.
Kev-0.8B, 4B und 9B bekommen dann kurze Folge-Feinabstimmungen von ihren veröffentlichten Checkpoints, über denselben --init_from-Pfad, den du für deine eigenen Daten nutzen würdest: generierte Fälle, die Tageszahlen angeben oder bei denen die entscheidende Evidenz entfernt wurde (alle drei), danach echte Dokumente und generierte Skill-Daten (alle drei; Kev-9B seit v2, 2026-09-30). Kev-27B wird anders trainiert. Jedes Gewicht der Basis wird eine Epoche lang auf acht H200s feinabgestimmt (--full_ft 1, Lernrate 2e-6) auf einem Korpus mit 145,840 Datensätzen: Kevs eigene Daten, die Dokument-, Skill- und Entwickler-Tooling-Suites, öffentliche Datensätze, lizenzierte Aufgabenfamilien und generierte Langdokument-, Tool-Routing-, Agent-Log- und Guardrail-Datensätze, mit Zuständen von bis zu 32,768 Token. Das Ergebnis wird dann mit dem früheren adapter-trainierten Kev-27B gemittelt, 0.85 zu 0.15. Die Modellkarten listen jede Stufe mit ihren Daten und Kosten.
# sanity run, ~1 minute
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# the first stage of Kev-0.8B (~20 min on one H100; the Mac path works but is slow for Qwen3.5 bases)
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base --base_revision dc7cdfe2ee4154fa7e30f5b51ca41bfa40174e68 \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b

# the first stage of Kev-4B (one H100 via Modal, ~1 h; see below). Swap in Qwen/Qwen3-4B-Base for the previous generation.
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base --base_revision 1001bb4d826a52d1f399e183466143f4da7b741b \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
Verwende uv run python -m kev.train --help für alle Trainingsoptionen. Die veröffentlichten Modelle verwenden die optionalen --perm_kl- oder --ord_w-Verluste nicht. PLAN.md hält fest, was versucht wurde, was geholfen hat und was nicht.
Modal
Jeder Versuch bekommt seine eigene H100. Die Studie läuft weiter, wenn du dich trennst, und du kannst die Ergebnisse herunterladen, wenn sie fertig ist:
uv run modal token new                                    # once; opens the browser
KEV_GPU=T4 uv run modal run modal_app.py::smoke           # end-to-end check, ~1 minute of GPU

uv run modal deploy modal_app.py                          # once; studies run on the deployed app and survive disconnects
uv run modal run modal_app.py::study \
    --suite evals/v7/decision-v7 --plan experiments/v7-final.json \
    --name my-study --transfer evals/v4/transfer-v4 --budget 30 --timeout 7200
uv run modal run modal_app.py::pull --name my-study       # results -> runs/my-study, ranked
Studienpläne listen Trainings-Einstellungen. Jeder Versuch speichert die Einstellungen, Code-Hashes, Datensatz-Hashes und Ergebnisse. Wähle Modelle anhand der Development-Ergebnisse, nicht des gesperrten Tests. Nachdem du einen finalen Kandidaten gewählt hast, kannst du seine Testergebnisse einmal lesen:
uv run modal run modal_app.py::locked_test --trial my-study/00-trial-0 --name my-candidate # one read, everBenchmarks
Die Evaluationsdaten unter evals/ sind eingefroren: Datensatzversionen und Datei-Prüfsummen sind in jedem Manifest festgehalten. Große Dateien werden vom Hub-Spiegel heruntergeladen und gegen diese Hashes geprüft. Jedes Modell in den obigen Tabellen wird auf denselben Elementen bewertet. Die Zahlen in dieser README und in den Modellkarten werden in der CI gegen die committeten Berichte geprüft, aus denen sie stammen (docs/claims.json, uv run python scripts/verify_claims.py).
| Suite | Was sie misst |
|---|---|
decision-v7 |
Zurückgehaltene Beispiele aus den zehn Trainingsdatensätzen, den generierten Policies und den Regelstrukturen („trainierte Quellen”) |
transfer-v4 |
764 Datensätze aus Datensätzen sowie Policy- und Regeltypen, auf denen Kev nie trainiert hat: QNLI, SciQ, PAWS, MMLU, Emotion, TweetEval, zurückgehaltene Policies und Regeln („neue Quellen”) |
transfer-v9 |
transfer-v4 plus 10-Wege-MMLU-Pro, in irrelevantem Text vergrabene Datensätze und „unerkennbare” Datensätze, deren entscheidende Evidenz entfernt wurde |
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v4/transfer-v4 --out runs/my-eval      # new sources
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v9/transfer-v9 --out runs/my-eval-v9   # + MMLU-Pro, buried states, unknowable items
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v7/decision-v7 --out runs/my-eval-id   # trained sources
uv run python -m kev.benchmark --remote http://127.0.0.1:8009 --suite evals/v4/transfer-v4 --out runs/my-remote   # any System One endpoint, Jev included
Diese Befehle verwenden Development-Daten. Test-Daten erfordern --allow-test. Das Benchmark berichtet Genauigkeit, Brier-Score, Kalibrierungsfehler, den Anteil der Entscheidungen, die du bei einem 5%-Fehlerbudget automatisieren könntest, Optionsreihenfolgen-Änderungen und Fragenisolation. Bei den unerkennbaren Datensätzen berichtet es, wie oft das Modell trotzdem mit mindestens 0.9 Konfidenz antwortet (Kev-9B 0%, Jev 9%). Veröffentlichte Genauigkeitszahlen verwenden die fp32-Evaluation, nicht den bf16-Serving-Pfad. kev.jev stellt dieselben Fragen über Vercel AI Gateway an Jev, und kev.compare vergleicht zwei gespeicherte Läufe mit gepaarten Bootstrap-Konfidenzintervallen.
Kalibrierung. Jeder Checkpoint speichert eine Temperatur, und der Pointer-Head wendet sie beim Laden des Modells an. Kev-4B (2.41) und Kev-0.8B (2.35) fitteten ihre auf ihren In-Distribution-Development-Sets; Kev-27B (1.32) und Kev-9B (2.19) fitteten ihre auf zurückgehaltenen Datensätzen, auf denen sie nie trainiert hatten. Ein Refit der beiden kleineren Modelle auf diesen zurückgehaltenen Datensätzen wurde getestet und für keines übernommen: Er verbesserte Kev-4B nicht und machte Kev-0.8B auf seinen Dokument- und Skill-Suites schlechter kalibriert (die Modellkarten enthalten die Zahlen). Eine Temperatur ändert nie, welche Antwort gewinnt. Bei neuen Quellen senkt sie den Kalibrierungsfehler von Kev-9B von 0.103 auf 0.041 und seine sicheren Fehler (falsche Antworten mit Wahrscheinlichkeit ≥ 0.9) von 8.2% auf 2.4%, unter Jevs 3.7%. Die obigen Genauigkeitszahlen sind in beiden Fällen gleich; die Brier-Zahlen gelten für die rohen Wahrscheinlichkeiten. scripts/calibrate_checkpoint.py berichtet außerdem eine Out-of-Fold-Schätzung, sodass sich der In-Sample-Fit gegen Datensätze prüfen lässt, die er nicht gesehen hat.
Datumsangaben. Kev kann Daten nicht verlässlich subtrahieren, aber es kann eine ihm gegebene Tageszahl verwenden. KEV_DATE_FACTS=1 hängt einen Satz pro Datumspaar im Zustand an („June 26, 2026 is 8 days before July 4, 2026”). Bei den Deadline-Policy-Fragen hebt das Kev-9B von 0.80 auf 0.90 (Jev 0.93). Keine der Tabellen verwendet es.
Test-Sets anderer Leute. evals/external/ enthält Test-Sets aus anderen Projekten, in dieses Format konvertiert, mit ihren veröffentlichten Live-Jev-Ergebnissen. Einige wurden auf früheren Versionen der Kev-Gewichte bewertet, die die Kev-Spalte benennt. Drei wurden entfernt, weil sie nicht als Gate dienen können, und die Modellkarten behalten die Zahlen, auf deren Grundlage ihre Releases entschieden wurden: scienthoons synthetische Support-Tickets am 2026-09-27 (Template-Text; eine seiner drei Fragen hängt von einer Regel ab, die der Text nicht nennt), und am 2026-09-30 WANLI (wanli-v1, wanli-v2: ein Viertel der Paare sind solche, die WANLIs zwei Annotatoren unterschiedlich beschriftet haben, mit dem Gold auf einen von ihnen gesetzt) und TypeSafes öffentliche Evals (typesafe-v1: Das Gold ist die gemittelte Antwort zweier geschlossener Frontier-Modelle, und bei 89 Fragen kann es Checkpoints nicht auseinanderhalten).
| Suite | Was sie ist | Jev | Kev |
|---|---|---|---|
| SemIf | 144 verfasste Entscheidungen | 0.965 | 0.917 (Kev-9B bei v7-base) |
SemIfs Labels halten stand, aber es ist nahe der Sättigung: Jeder Kev-27B-Checkpoint beantwortet 130 der 144 korrekt, daher ist es ein Plausibilitätscheck, keine Möglichkeit, Modelle zu ranken.
Serving-Leistung
Wähle die GPU nach dem Modell:
| Modell | GPU ($/h) | 6 Fragen, kurzer Text | 5 Fragen, 2,200-Token-Text | Anfragen/s, 64 Clients |
|---|---|---|---|---|
| Kev-0.8B | L4 (0.80) | 22.7 / 16.1 ms | 108.6 / 32.3 ms | 62.8 |
| Kev-4B | L40S (1.95) | 41.5 / 27.7 ms | 145.2 / 43.0 ms | 51.4 |
| Kev-4B | H100 (3.95) | 18.1 / 12.9 ms | 89.4 / 22.5 ms | 100.8 |
| Kev-9B | L40S (1.95) | 66.4 / 42.7 ms | 235.6 / 57.5 ms | 32.7 |
| Kev-9B | H100 (3.95) | 24.0 / 16.6 ms | 88.5 / 26.4 ms | 79.5 |
| Kev-27B | B200 (6.25) | 46.5 / 32.2 ms | 178.0 / 52.1 ms | 44.2 |
| Kev-27B | H200 (4.54) | 67.2 / 50.0 ms | 274.8 / 73.8 ms | 28.6 |
| Kev-27B | H100 (3.95) | 75.0 / 52.0 ms | 277.5 / 79.3 ms | 28.9 |
Die Zeiten sind Modellzeit pro Anfrage (die latency_ms, die die API zurückgibt), Median aus 20, für einen neuen Text / denselben Text erneut. Der Server cacht den Text, sodass das Stellen weiterer Fragen zu einem bereits gesendeten Dokument nur die Fragen kostet. Anfragen pro Sekunde gelten für 64 gleichzeitige Clients, die je sechs Fragen zu einem neuen kurzen Text senden; der Server batcht sie. Die B200- und H100-Zeilen von Kev-27B wurden auf seiner vorherigen Version gemessen, derselben Architektur in bf16 bedient (runs/fused-27b-*); die H200-Zeile ist der aktuelle Checkpoint (runs/serving-27b-r23). Netzwerkzeit kommt hinzu: etwa 65 ms pro Roundtrip durch einen Modal-Web-Endpunkt in derselben Region.
Eine L4 reicht für Kev-0.8B, ist aber zu langsam für Kev-4B. Die A100 ist hier langsamer als die L40S und kostet mehr. Kev-9B braucht etwa 17 GB GPU-Speicher und Kev-27B 51 GB Gewichte (etwa 66 GB mit den Batching-Puffern); unter Last ist Kev-27B rechengebunden, und eine B200, H200 oder H100 kostet pro Anfrage etwa gleich viel. Installiere unter CUDA flash-linear-attention für die Qwen3.5-Modelle ( kev_serve.py und die Modal-Images tun das bereits).
Auf Apple Silicon installiert uv sync --extra serve MLX, und der Server verwendet es automatisch. Fünf Fragen zu einem ~270-Token-Text auf einem M5 (32 GB):
| Modell | Neuer Text | Derselbe Text erneut |
|---|---|---|
| Kev-0.8B | 149 ms | 28 ms |
| Kev-4B | 721 ms | 136 ms |
Lange Dokumente werden in 1,024-Token-Schritten in den Cache gelesen, sodass der Speicher nahe an den Gewichten bleibt. Mit einem 65,000-Token-Dokument braucht Kev-0.8B 21.2 s beim ersten Mal und danach 202 ms, bei einem Peak von 3.8 GB, und Kev-4B 84.5 s und 716 ms bei 13.0 GB (runs/mlx-long-states; die Modellkarten enthalten jede Länge). Kev-9B wurde auf diese Weise noch nicht gemessen.
Adapter-Checkpoints werden beim Laden in die Basis gefaltet, was kurzzeitig eine zweite Kopie der Gewichte hält. Checkpoints mit vollständigen Gewichten wie Kev-27B laden so, wie sie gespeichert sind, ohne dass etwas gemerged wird, sodass das Laden nur die Gewichte braucht. Wir haben das an Kev-4B geprüft, das als vollständige bf16-Gewichte herausgeschrieben wurde: Das Laden erreichte einen Peak von 8.4 GB bei 8.4 GB Gewichten, gegenüber 15.9 GB beim Adapter-Pfad. Seine Antworten stimmten genau mit dem Adapter-Pfad überein, sobald beide dieselben bf16-Werte halten, und blieben innerhalb von 0.015 des fp32-Pfads bei 60 Fragen (runs/mlx-full-4b). Kev-27Bs Gewichte sind 51 GB. Nach denselben Messungen braucht es etwa 51 GB plus Arbeitsspeicher, sodass ein 64-GB-Mac grenzwertig ist und ein 96–128-GB-Mac passen sollte. Wir haben es noch nicht auf einem so großen Mac ausgeführt. Kev-27Bs erste Version, ein Adapter, lief auf diese Weise auf einem 128-GB-M5-Max und erreichte die veröffentlichte Genauigkeit (Dank an Sean Connelly, #175).
Der Server läuft in bf16 auf GPUs und Macs. Seine Wahrscheinlichkeiten weichen vom fp32-Pfad, den die veröffentlichten Evaluationen verwenden, um höchstens etwa 0.03 auf einer GPU und 0.05 auf einem Mac ab, und die beste Antwort ändert sich bei etwa einer von 300 Fragen. Setze KEV_DTYPE=fp32 für den exakten Pfad. /v1/models berichtet das verwendete Backend und die Präzision. uv run modal run modal_app.py::serving --run jaredpalmer/kev-4b --gpu L40S --name <name> misst eine Zeile der Tabelle auf deinem eigenen Konto (die obigen Zeilen: runs/serve-*, runs/grouping-4b-h100, runs/fused-27b-*, runs/serving-27b-r23).
Grenzen
- Die Kalibrierung ist eine einzelne Temperatur. Sie kann Konfidenzen nicht umsortieren, daher liegt der Anteil der Entscheidungen bei neuen Quellen, den du bei einem 5%-Fehlerbudget automatisieren kannst (0.52–0.69 für Kev-4B, 9B und 27B), weiterhin unter Jevs 0.70. Teste einen Wahrscheinlichkeitsschwellenwert an deinen eigenen Daten, bevor du dich darauf verlässt.
- Wissensfragen werden vom Basismodell bestimmt. MMLU liegt bei 0.73 für Kev-9B gegenüber Jevs 0.90, und MMLU-Pro bei 0.59 gegenüber 0.84.
- Feinabstimmung kann das Basismodell bei einzelnen Aufgaben schlechter machen. Datumsarithmetik war der klarste Fall (Issue #8); Training auf angegebenen Tageszahlen plus
KEV_DATE_FACTS=1stellt sie wieder her. - Das Ändern der Optionsreihenfolge kann eine Antwort ändern. Die Fragenisolation verhindert das nicht.
- Kev-0.8B, 4B und 9B wurden größtenteils auf höchstens 384 Zustands-Token und 1,024 Token für Zustand plus eine Frage trainiert (ihre Dokument- und Skill-Feinabstimmungen auf Zuständen von bis zu 7,552 Token), Kev-27B auf Zuständen von bis zu 32,768 Token. Das Serving erlaubt einen Zustand von 65,536 Token; die validierte Kontextlänge jedes Modells steht in Modelle.
- Auf einem Mac dauern Antworten Hunderte Millisekunden, nicht Zehner. Kev-27B braucht eine 80-GB-GPU. Auf einem Mac braucht es etwa 51 GB plus Arbeitsspeicher; wir erwarten, dass ein 96–128-GB-Mac passt, haben aber keinen gemessen.
- Kev-27B startet von einem nachtrainierten Modell, dessen Trainingsdaten wir nicht kennen.
Entwicklung
uv run --extra serve python -m pytest tests/test_unit.py tests/test_research.py tests/test_generators.py tests/test_conventions.py \
    tests/test_documents_tools.py tests/test_hard_v1.py tests/test_devtools_v1.py tests/test_breadth_v1.py tests/test_rounds.py tests/test_skill_scripts.py -q   # no weights, no server; what CI runs
KEV_BASE_URL=http://127.0.0.1:8009 uv run --extra serve python -m pytest tests/test_api.py -q   # against a running server
cd playground && npm run lint && npx next typegen && npx tsc --noEmit -p .
Die API-Tests führen TypeSafes Beispielanfragen und das offizielle SDK gegen deinen lokalen Server aus. PLAN.md ist der Forschungsplan: was wir gelernt haben, die Regeln, denen jedes Experiment folgt, und eine Zeile pro Runde. Das vollständige Log (jedes Experiment, die vor seinem Lauf festgelegten Kriterien und sein Ausgang) liegt am Git-Tag research-archive-2026-09-24.
Vorherige Generation (Qwen3) und der Prototyp
Die erste Kev-Familie verwendete Qwen3-Basen mit denselben Daten und Einstellungen. Diese Gewichte bleiben veröffentlicht und laufen auf einfachem PyTorch auf einem Mac, werden aber nicht mehr weiterentwickelt.
| Modell | Basis | Genauigkeit: Trainierte Quellen | Genauigkeit: Neue Quellen | Brier: Neue Quellen | Modellkarte |
|---|---|---|---|---|---|
Kev-0.6B (Qwen3) — jaredpalmer/kev-0.6b |
Qwen3-0.6B-Base | 0.801 / 0.808 | 0.620 / 0.642 | 0.536 / 0.483 | Details |
Kev-4B (Qwen3) — jaredpalmer/kev-4b@qwen3 |
Qwen3-4B-Base | 0.854 / 0.856 | 0.790 / 0.806 | 0.328 / 0.294 | Details |
Kev-8B (Qwen3) — jaredpalmer/kev-8b |
Qwen3-8B-Base | 0.863 / 0.870 | 0.796 / 0.780 | 0.337 / 0.327 | Details |
Das ursprüngliche Kev-0.5B verwendete Qwen2.5-0.5B und wird als Referenz erhalten; siehe seine Modellkarte.
Fehlerbehebung
- Wenn MPS während des Trainings keinen Speicher mehr hat, prüfe, ob du nur einen Job ausführst. Aktiviere nicht
output_hidden_statesund füge keine Token mit peftstrainable_token_indiceshinzu; beides hat hier Speicherprobleme verursacht. - Wenn der Playground lädt, aber die Schaltflächen nicht funktionieren, verwende
localhost:3001. Next.js prüft Development-Hostnamen. Andere Hosts brauchen einen Eintrag inallowedDevOriginsinplayground/next.config.ts. - Wenn das Laden der Datensätze
Dataset scripts are no longer supportedmeldet, verwendelegacy-datasets/banking77. Dieses Repo verwendet es bereits.
Autoren
- Jared Palmer (@jaredpalmer)
Gebaut mit Devin. Dank an Archer Hume für die Architekturbeschreibung, TypeSafe für das API-Design und Qwen für die Basismodelle.
Verwandte Arbeiten: Hydragen, DeFT, FIRST.
Lizenz
Apache-2.0. Die Basismodelle Qwen3, Qwen3.5 und Qwen3.8 stehen ebenfalls unter Apache-2.0. Trainingsdatensätze haben ihre eigenen Lizenzen; siehe die Modellkarten.