De petits modèles de décision de type Jev que tu peux entraîner et exécuter toi-même.
Kev est une famille de petits modèles de décision construits sur Qwen3.5 et Qwen3.8 et fondés sur l’architecture décrite dans Jev’s Architecture Unmasked. Tu peux utiliser les poids préentraînés ou entraîner les tiens. L’API correspond à System One de TypeSafe, donc tu peux pointer leur SDK Python sur ton serveur local.
Points forts
- Des questions oui/non (
noul), à choix multiple (choice) et de notation (score) dans une même requête. Les questions partagent le texte mais ne peuvent pas se lire entre elles. - Probabilités calibrées par défaut : chaque checkpoint est livré avec une température ajustée.
- Compatible Jev sans modification : le SDK Python TypeSafe fonctionne contre un serveur Kev tel quel.
- Quatre tailles, versionnées ensemble sous Kev 1.0 : d’un 0.8B qui tourne sur un ordinateur portable à un 27B pour un seul GPU de centre de données.
- Des documents jusqu’à 65 536 jetons, sur CUDA et sur Apple Silicon via MLX. Chaque fiche de modèle dit jusqu’où un document peut aller avant que l’exactitude chute.
- Fine-tuning sur tes propres exemples étiquetés. Une compétence d’agent de codage fait tourner toute la boucle sur Modal, de la recherche de tes questions jusqu’au service du résultat.
- Déploie ton propre point de terminaison HTTPS avec une seule commande. Il descend à zéro au repos.
- Essaie-le d’abord dans le navigateur : huggingface.co/spaces/jaredpalmer/kev.
Modèles
Commence par Kev-4B. Passe à Kev-9B si tu as un plus gros GPU, ou à Kev-27B si tu as un GPU 80 GB et veux le Kev le plus exact. Utilise Kev-0.8B quand la taille compte plus que l’exactitude.
| Modèle | Base (licence) | Tourne sur : CUDA | Tourne sur : Mac (MLX) | Contexte validé | Jeux de données tenus à l’écart : indice | Fiche |
|---|---|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base (Apache-2.0) | L4, tout GPU 4 GB | Tout Mac Apple Silicon ; mesuré jusqu’à 65k jetons | 8 192 | 23.3 | Détails |
| Kev-4B | Qwen3.5-4B-Base (Apache-2.0) | L40S, H100 | Mac 32 GB ; mesuré jusqu’à 65k jetons | 8 192 | 38.0 | Détails |
| Kev-9B | Qwen3.5-9B-Base (Apache-2.0) | L40S, H100 | Mac 32 GB ou plus grand (attendu, non mesuré) | 8 192 | 41.0 | Détails |
| Kev-27B | Qwen3.8-27B, post-entraîné (Apache-2.0) | B200, H200, H100 80 GB | Mac 96–128 GB (attendu, non mesuré) | 65 536 | 52.3 | Détails |
| Jev | Hébergé | API de TypeSafe | – | – | 54.0 | – |
« Jeux de données tenus à l’écart » est l’indice corrigé du hasard du Decision Index communautaire, noté sur la partition de test de breadth-v1 : 14 jeux de données publics dans cinq domaines sur lesquels aucun Kev ne s’est entraîné. « Contexte validé » est le document le plus long, en jetons, pour lequel l’exactitude sur de vrais contrats (CUAD) reste à moins de 3 points de l’exactitude du même modèle à 8k jetons, à la borne inférieure à 95 % ; chaque fiche de modèle a la mesure par longueur.
| Modèle | Exactitude : nouvelles sources | Exactitude : sources entraînées | Brier : nouvelles sources |
|---|---|---|---|
| Kev-0.8B | 0.648 / 0.697 | 0.827 / 0.838 | 0.481 / 0.416 |
| Kev-4B | 0.817 / 0.838 | 0.873 / 0.865 | 0.269 / 0.242 |
| Kev-9B | 0.820 / 0.852 | 0.874 / 0.873 | 0.289 / 0.217 |
| Kev-27B | 0.851 / 0.889 | 0.865 / 0.866 | 0.225 / 0.156 |
| Jev | 0.857 / – | 0.845 / – | 0.211 / – |
Chaque cellule est développement / test. « Nouvelles sources » désigne des jeux de données et des règles de politique que Kev n’a jamais vus à l’entraînement. C’est ce qui ressemble le plus ici à tes propres questions. « Sources entraînées » désigne des exemples tenus à l’écart des jeux de données sur lesquels Kev s’est entraîné. Nous choisissons les checkpoints avec les ensembles de développement et ne lisons chaque ensemble de test qu’une fois par modèle publié. Jev n’a été exécuté que sur les ensembles de développement de ces deux suites. Le Brier note toute la distribution de probabilité, pas seulement la meilleure réponse ; plus bas est mieux.
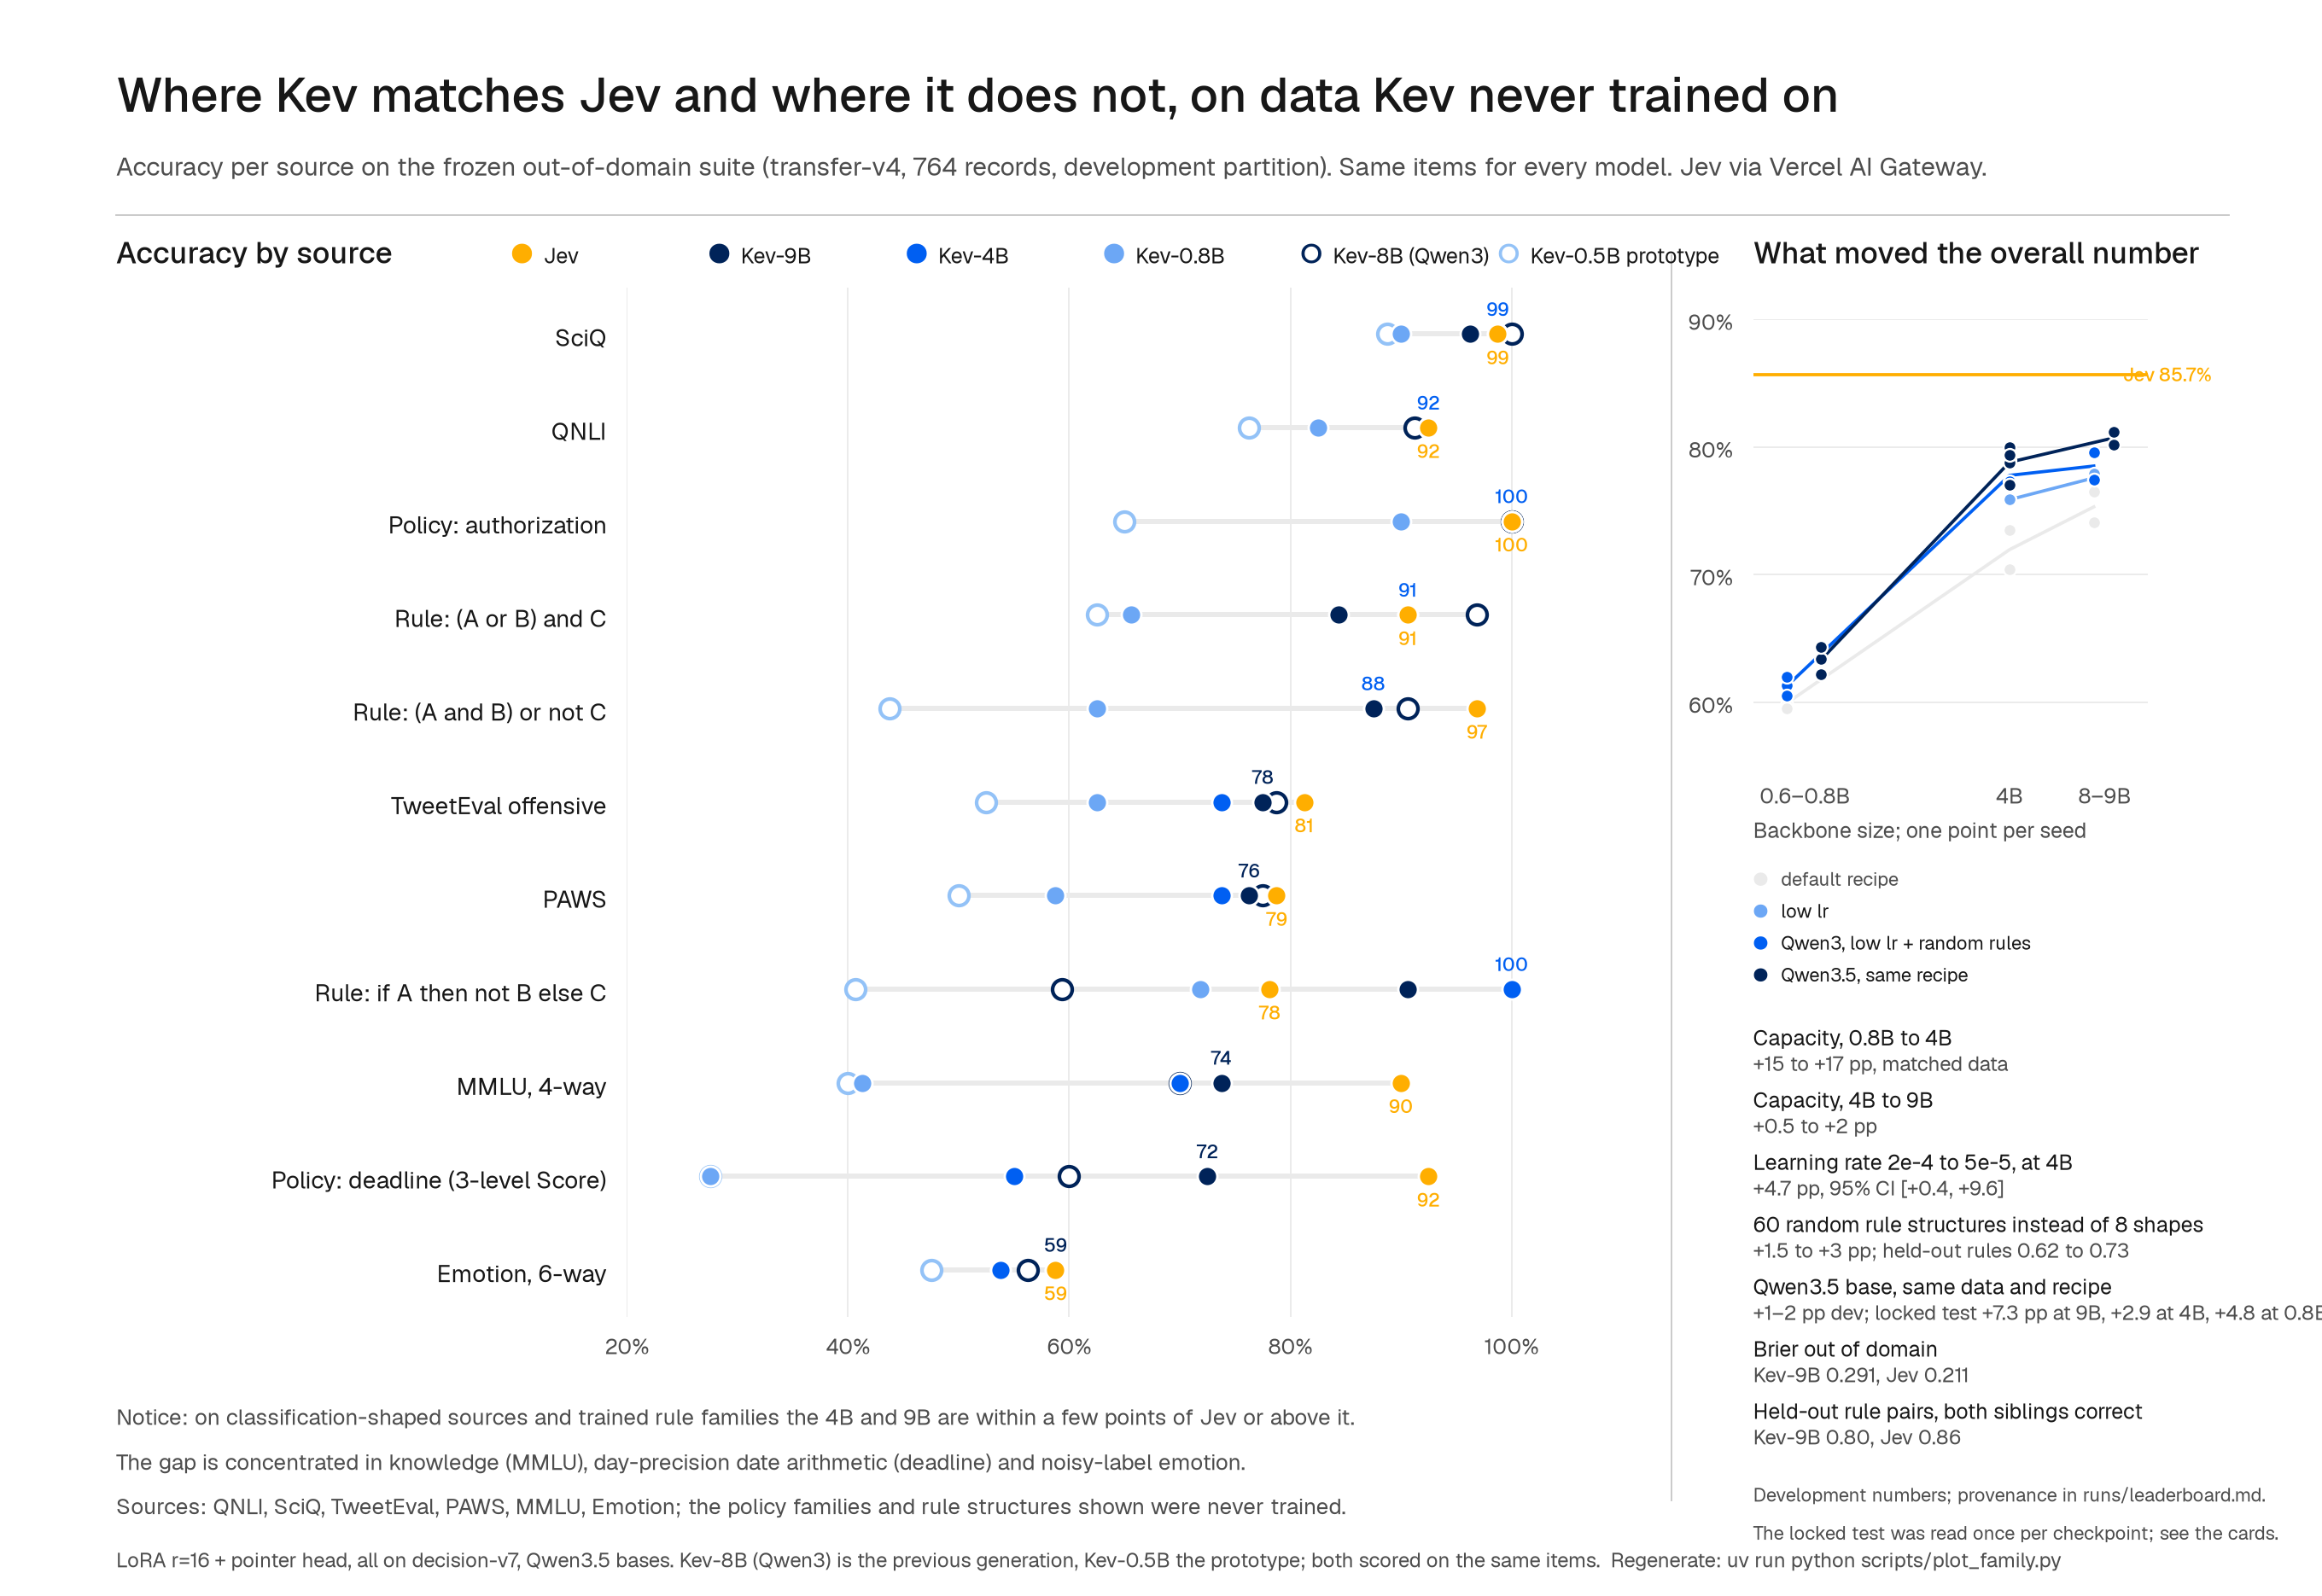
Sur les nouvelles sources, Kev-27B est à un point de Jev (0.851 contre 0.857), et Kev-4B et Kev-9B sont à moins de quatre points. Nous ne savons pas sur quoi Jev a été entraîné, donc ce n’est pas une comparaison contrôlée des deux architectures. À quoi s’attendre dit où Kev vaut Jev et où il ne le vaut pas.
Kev-0.8B, 4B et 9B partent de modèles de base Qwen et partagent une seule recette d’entraînement : un petit adaptateur sur une base gelée. Kev-27B part de la publication post-entraînée de Qwen, et nous ne savons pas sur quoi celle-ci a été entraînée ; chacun de ses poids est fine-tuné, donc il est livré comme 51 GB de poids complets plutôt qu’un adaptateur. Chaque fiche de modèle contient la recette complète, tous les résultats et les versions antérieures conservées comme étiquettes Hub.
Kev 1.0
Les quatre modèles ci-dessus sont publiés ensemble sous Kev 1.0. Chaque dépôt Hub a une étiquette v1.0, donc --run jaredpalmer/kev-4b@v1.0 charge toujours les mêmes poids, et la publication GitHub kev-1.0 contient les checkpoints 0.8B, 4B et 9B avec leurs sommes de contrôle SHA-256. Les 51 GB de poids de Kev-27B sont trop volumineux pour une ressource de publication et ne sont que sur le Hub.
| Modèle | Révision Hub des poids | Température | Entraîné sur des états jusqu’à |
|---|---|---|---|
| Kev-0.8B | 9a45d25e |
2.35 | 7 552 jetons |
| Kev-4B | 139fdd94 |
2.41 | 7 552 jetons |
| Kev-9B | b5d8c18e (v2) |
2.19 | 7 552 jetons |
| Kev-27B | 28be62e9 (v2, poids complets) |
1.32 | 32 768 jetons |
Kev 1.0 n’entraîne rien de nouveau. Il fige les checkpoints, les fiches, les suites d’évaluation et le code de service contre lesquels la prochaine génération de Kev sera comparée. Les notes de publication listent ce qui a changé depuis la publication de famille précédente et ce qui est connu pour mal marcher.
Démarrage rapide
L’essayer dans le navigateur
Le Hugging Face Space fait tourner Kev-4B et Kev-0.8B, sans rien à installer.
L’exécuter en local
Tu auras besoin de Python 3.12 ou 3.13 et de uv. Le .python-version du dépôt fait que uv sync utilise 3.13 ; torch n’a pas encore de wheels pour 3.14.
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
Cela démarre Kev-4B sur ta machine : CUDA ou ROCm si tu as un GPU, MLX sur Apple Silicon. La première exécution télécharge l’adaptateur et le modèle de base. --run accepte aussi un répertoire de checkpoint local ou une révision Hub comme jaredpalmer/kev-4b@qwen3.
Dans un autre terminal, envoie-lui un ticket :
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
Exemple de réponse de Kev-4B, tournant en bf16 sur un Apple M5 :
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.34,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
}
Le ticket mentionne un retour, une livraison en retard et un problème de facturation, et les probabilités du département le disent. C’est pourquoi Kev renvoie des probabilités plutôt qu’une seule étiquette : ton code peut router les cas confiants et envoyer le reste à une personne.
L’utiliser depuis Python
Si tu appelles déjà Jev, pointe ton client sur Kev et garde le reste de ton code. Le SDK TypeSafe est inclus dans uv sync --extra serve :
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
Fine-tuning sur tes propres données
Les modèles publiés ont été entraînés sur des jeux de données publics et des exemples de politique générés. Si tes questions sont différentes, comme tes propres catégories de routage, tes propres règles d’escalade ou une autre langue, un court fine-tuning aide en général plus que n’importe quel changement de prompt. Il ajuste aussi la température à tes données, donc la confiance sur laquelle tu fixes des seuils est mesurée sur tes propres étiquettes.
À quoi t’attendre : sur une charge de support d’exemple (trois questions, 1 050 enregistrements générés, 15 minutes sur un H100), le fine-tuning a fait passer Kev-4B de 67.7 % à 73.6 % d’exactitude, et d’une automatisation de 34 % des décisions à un budget d’erreur de 5 % à 48 % (détails). Sur de vraies données, une époque sur 5 219 plaintes de finance à la consommation étiquetées a fait passer Kev-4B de 0.804 à 0.904 d’exactitude sur des plaintes qu’il n’avait jamais vues. Des gains comme ceux-ci sont en distribution : ils te disent à quel point Kev apprend ta tâche, pas comment il se débrouille sur tout le reste. Dimensionne ton jeu de données d’abord. Avec 400 enregistrements, le gain sur la charge d’exemple était dans le bruit.
Avec un agent de codage
npx skills add jaredpalmer/kev@kev-finetuneDemande ensuite à ton agent de « fine-tune Kev on my support tickets ». La compétence kev-finetune t’interroge, trouve les questions que ton code pose déjà à Jev ou TypeSafe, convertit les étiquettes dont tu disposes ou en génère assez avec n’importe quel LLM pour mesurer un gain, fait un fine-tuning depuis un checkpoint publié sur Modal, ajuste la température sur une tranche tenue à l’écart, note le résultat contre le modèle intact, déploie un point de terminaison et démonte tout à la fin. Tu n’as pas besoin d’un GPU local ni d’un clone de ce dépôt. Une exécution d’entraînement de Kev-4B coûte environ $1 sur un H100.
À la main
Le README de la compétence est la même recette pour des humains : six courts scripts de bibliothèque standard et une app Modal. Pour entraîner depuis ce dépôt à la place, mets tes exemples dans un fichier JSONL, une requête par ligne. C’est la même forme qu’une requête d’API, plus un label sur chaque question :
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
   "priority": {"type": "score",  "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}
Pour choice, l’étiquette est le nom de l’option, pour noul c’est true ou false, et pour score c’est la position du niveau à partir de 0. Garde 10–20 % du fichier de côté pour l’évaluation.
Puis pars d’un checkpoint publié avec --init_from :
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine

uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
uv run --extra serve python -m kev.serve --run runs/mine --port 8009
--init_from charge l’adaptateur et la tête pointeur depuis le modèle publié avant l’entraînement, donc tu gardes ce que Kev sait déjà et tu ajoutes ton domaine par-dessus. Partir du modèle de base à la place jette cela : dans le test d’un utilisateur sur 836 décisions d’outils de support, un fine-tuning depuis la base a obtenu 0.33 sur l’ensemble d’évaluation propre de Kev, contre 0.84 pour le modèle publié ; les mêmes données avec --init_from y ont conservé 0.83 et atteint 0.88 sur le nouveau domaine. Utilise un taux d’apprentissage plus petit que la recette depuis zéro (2e-5 est un bon départ), et choisis --base pour correspondre au checkpoint dont tu pars ; l’entraîneur vérifie que la base, la révision, le rang LoRA et la taille de tête concordent avant de charger quoi que ce soit.
--batch 1 --accum 8 en bf16 fait tenir le modèle 0.8B sur un GPU 4 GB. Le benchmark rapporte exactitude, score de Brier et calibration par type de question, donc tu vois à quelles questions ton fine-tuning a profité. Le checkpoint dont tu es parti est consigné dans runs/mine/training_config.json. Sur un Mac, fais tourner un seul job d’entraînement à la fois ; deux jobs sur le même GPU Apple sont bien plus lents.
Déployer ton propre point de terminaison
Pour obtenir un point de terminaison HTTPS au lieu d’un serveur local, tu n’as pas besoin de ce dépôt, juste d’un compte Modal :
pip install modal && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
Cela sert Kev-4B sur une L40S à https://<your-workspace>--kev-api.modal.run, avec la même API que ci-dessus derrière Authorization: Bearer <key>. Il descend à zéro au repos, donc un point de terminaison inutilisé ne coûte rien. La première requête après le repos attend environ 35 secondes qu’un conteneur démarre. KEV_MODEL=jaredpalmer/kev-9b sert un autre modèle sur le GPU qui lui convient ; Kev-27B va sur un B200, avec repli sur un H200 ou H100. Si tu utilises un agent de codage, npx skills add jaredpalmer/kev@kev-deploy fait la même chose et câble l’URL dans ton code. skills/kev-deploy a le tableau des GPU et des coûts.
Un modèle que tu as fine-tuné avec la compétence kev-finetune se déploie de la même façon depuis sa propre app Modal (KEV_SERVE_SECRET=kev-serve-key KEV_SERVE_RUN=<run> modal deploy scripts/kev_modal.py ; voir son guide de déploiement). Pour héberger Kev sur tes propres machines à la place, lance kev.serve depuis L’exécuter en local sur une machine GPU avec --host 0.0.0.0 et mets-le derrière ton propre proxy ; Performances de service dit quel GPU choisir.
À quoi s’attendre
Exactitude. Kev-27B est à moins de trois points de Jev, ou devant, sur 9 des 11 catégories de nouvelles sources du graphique ci-dessous. Kev-4B et Kev-9B sont à peu près aussi proches sur les sources de forme classification comme le routage, l’implication et les questions scientifiques. Les questions de connaissances dépendent surtout du modèle de base : sur MMLU, Kev-9B obtient 0.73 et Kev-27B égale Jev à 0.90, mais sur le plus difficile MMLU-Pro, Kev-27B obtient 0.675 contre 0.840 pour Jev. Les modèles plus petits sont aussi en retrait sur l’arithmétique de dates à précision du jour.
Confiance. Chaque checkpoint est livré avec une température ajustée, donc ses probabilités sont calibrées par défaut. Tel que servi, Kev-9B met au moins 0.9 de probabilité sur une mauvaise réponse pour 2.4 % des questions de nouvelles sources, contre 3.7 % pour Jev. Jev classe encore mieux ses réponses : à un budget d’erreur de 5 %, Kev-4B, 9B et 27B peuvent automatiser 0.52–0.69 des décisions de nouvelles sources, Kev-0.8B 0.14 et Jev 0.70. Vérifie un seuil sur tes propres données avant de t’y fier.
Vitesse. Kev-4B répond à six questions sur un nouveau texte court en 18.1 ms de temps de modèle sur un H100 et 41.5 ms sur une L40S, et un conteneur sert environ 101 requêtes par seconde sur un H100. Sur un Apple M5, Kev-4B prend 721 ms pour cinq questions, ou 136 ms quand le texte se répète et vient du cache. Performances de service a chaque GPU et taille de batch.
Longueur. Kev-0.8B, 4B et 9B se sont entraînés surtout sur des états d’au plus 384 jetons, avec des plus longs dans leurs fine-tunings de documents et de compétences (jusqu’à 7 552 jetons), Kev-27B sur des états d’au plus 32 768. Le serveur accepte des états d’au plus 65 536 jetons, et 8 192 de plus pour chaque question, et refuse un état plus long par un 422 au lieu de le couper. Jusqu’où chaque modèle reste exact au-delà de sa longueur d’entraînement est la colonne « Contexte validé » de Modèles. Pour Kev-0.8B, 4B et 9B, c’est 8 192 jetons : à 16k, la mesure sur de vrais contrats ne peut plus exclure une chute de plus de 3 points, et à 32k les trois sont mesurablement moins exacts qu’à 8k. Kev-27B tient jusqu’à la limite de 65 536 jetons. Sur de vrais contrats allant jusqu’à 64k jetons (CUAD), Kev-27B obtient 0.874, et sa confiance y est moins fiable que sur du texte court ; sa fiche de modèle a les chiffres par longueur.
Playground
Le serveur lancé, ouvre un autre terminal. Tu auras besoin de Node 20.9+ :
cd playground
npm install
npm run dev -- -p 3001
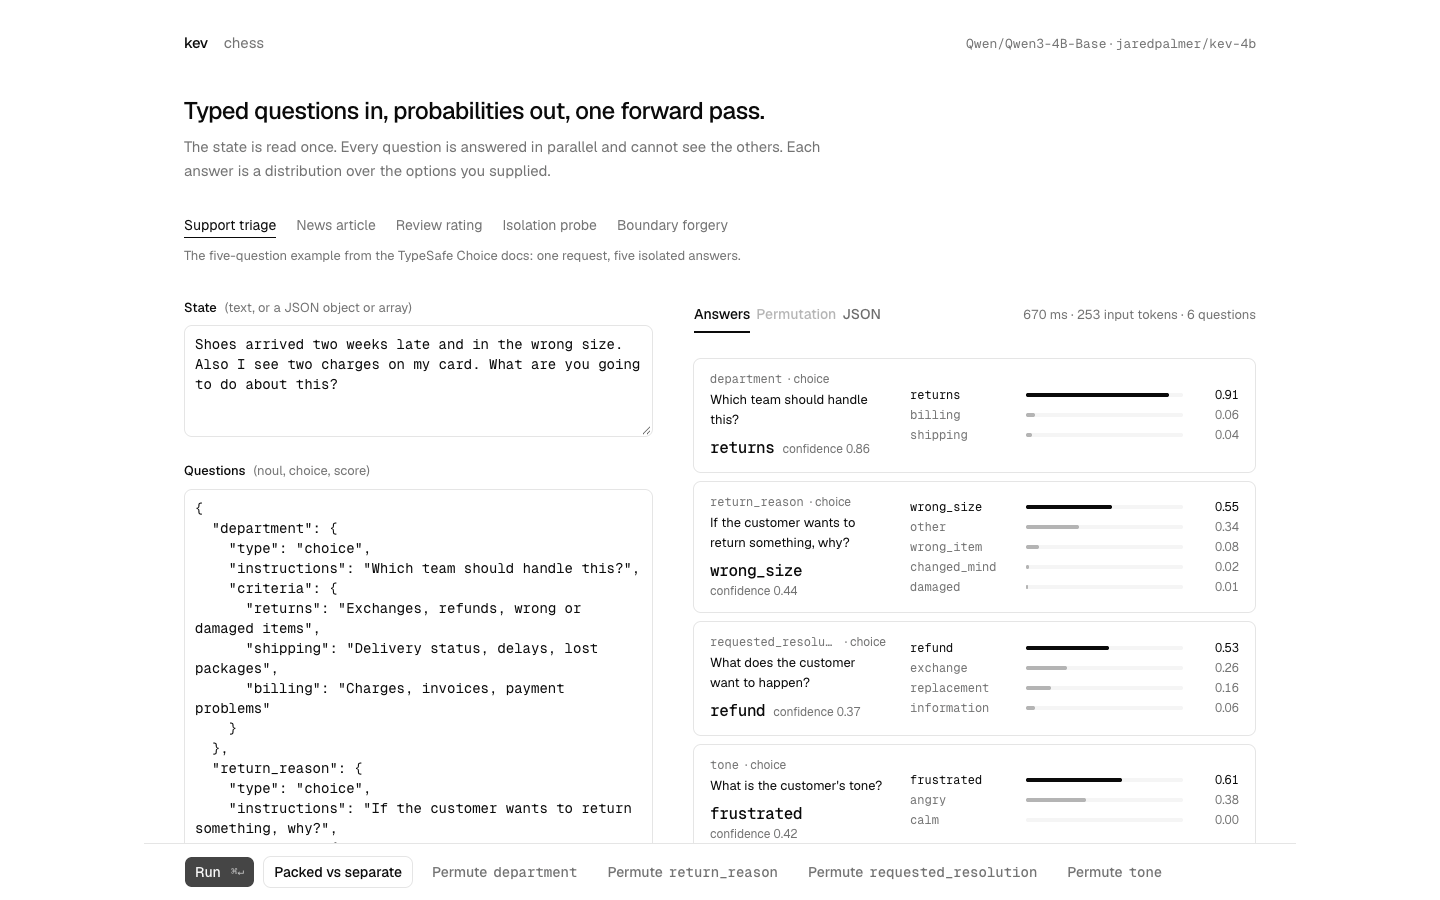
Ouvre localhost:3001, charge un préréglage, et modifie le texte et les questions. Appuie sur ⌘↵ pour l’exécuter. « Packed vs separate » compare le fait de poser toutes les questions d’un coup avec celui de les poser une par une. « Permute » exécute une question Choice avec six ordres d’options. Il y a aussi des préréglages pour tester l’isolation des questions et les faux jetons délimiteurs.
Il y a aussi une démo d’échecs. L’échiquier est l’entrée, les coups légaux sont des options Choice, et une question Score note la position. Tu peux jouer contre Kev ou le laisser jouer seul. Les parties sont sauvegardées dans localStorage.
API
POST /v1/systemone
state est le texte à évaluer. Chaque question a des instructions et, le cas échéant, un ensemble de réponses parmi lesquelles choisir.
{
  "state": "…",                          // string | object | array — the content to evaluate
  "model": "kev-latest",
  "questions": {
    "<id>": {                            // you choose the id; the model never sees it
      "type": "noul" | "choice" | "score",
      "instructions": "…",               // string | object | array, optional
      "criteria": …                      // noul: {true?, false?}  choice: {option: description|null}  score: [level, …]
    }
  }
}| Type | Critères | Réponse |
|---|---|---|
noul |
Descriptions facultatives pour true et false |
noul : probabilité de oui |
choice |
1–255 noms d’option, chacun avec une description ou null |
choice : option la plus probable ; probabilities et confidence |
score |
1–255 descriptions, ordonnées du plus bas au plus haut | score : indice de niveau moyen, à partir de 0 ; legend, probabilities et confidence |
Pour Choice avec K > 1 options, la confiance est (p_max − 1/K) / (1 − 1/K). Une seule option a une confiance de 1. La confiance Score est max(0, 1 − E|level − mode| / D) : mode est le niveau le plus probable et D est la distance moyenne d’une distribution uniforme sur les niveaux par rapport à son milieu (2/3 pour trois niveaux), donc toute la probabilité sur un niveau donne 1 et un étalement uniforme ou plus large donne 0. Les deux formules sont celles de l’adaptateur de référence de TypeSafe (system-one-adapter 0.2.1). Aucun des deux champs n’est un taux d’exactitude mesuré.
Les objets et tableaux sont convertis en texte étiqueté. Les chaînes ressemblant à des délimiteurs dans l’entrée utilisateur sont échappées avant la tokenisation. Les requêtes invalides renvoient 422, et de même un état de plus de 65 536 jetons : le serveur n’abandonne jamais une partie d’un document en silence, et l’erreur donne le nombre de jetons de l’état et la limite. usage.output_tokens compte les jetons des réponses sérialisées, pas les jetons générés.
| Méthode | Chemin | Objet |
|---|---|---|
GET |
/v1/models |
Fiches de modèle (name, description, release_date) plus les détails du checkpoint chargé |
POST |
/v1/systemone/permute |
Exécute une question Choice avec différents ordres d’options (n_perm de 1 à 64, défaut 6) |
POST |
/v1/systemone/separate |
Exécute chaque question dans sa propre passe avant |
Une requête peut porter un nombre quelconque de questions. Le serveur les exécute un budget de jetons à la fois (une ligne maximale de 16 384 jetons par passe avant, en comptant le document mis en cache une fois par question dans cette passe), donc la mémoire ne grandit pas avec le nombre de questions et les réponses ne dépendent pas du découpage. Chaque réponse porte un en-tête x-typesafe-request-id. Le serveur se lie à 127.0.0.1 (--host 0.0.0.0 pour accepter d’autres machines) et est ouvert par défaut ; définis KEV_API_KEY pour exiger Authorization: Bearer <key> sur /v1/*, comme les clients TypeSafe l’envoient toujours.
| Variable | Effet |
|---|---|
KEV_TEMPERATURE=1.0 |
Renvoie les probabilités brutes au lieu des calibrées |
KEV_DATE_FACTS=1 |
Ajoute le nombre de jours entre deux dates quelconques de l’état (voir Benchmarks) |
KEV_TRUNCATE_STATES=1 |
Lit les 65 536 premiers jetons d’un état plus long au lieu de le refuser ; chaque réponse a alors truncated et usage.state_tokens / state_tokens_used |
KEV_DTYPE=fp32 |
Sert le chemin fp32 exact qu’utilisent les évaluations (bf16 est le défaut sur GPU) |
KEV_API_KEY |
Exige une clé bearer |
Comment ça marche
Chaque checkpoint est un adaptateur LoRA de rang 16 et une petite tête pointeur sur un modèle de base Qwen. Sur une base à attention seule (Qwen3), l’état et les questions vont dans une seule séquence de jetons :
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
Le masque d’attention permet à un jeton de lire l’état et sa propre question, mais pas les autres questions ni les jetons futurs. Les position IDs de chaque question redémarrent juste après l’état. Cela permet au modèle de traiter l’état une fois et de répondre à chaque question indépendamment.
Qwen3.5 et Qwen3.8 mêlent des couches d’attention à des couches Gated DeltaNet, qui sont récurrentes et ignorent les masques d’attention. Pour ces modèles, c’est-à-dire tous les Kev actuels, chaque question tourne comme sa propre ligne : l’état suivi de cette question, avec les mêmes positions que ci-dessus. Les lignes sont indépendantes, donc l’isolation est exacte, et le serveur et DecisionModel.probs() calculent l’état une fois et réutilisent son cache pour chaque ligne. forward(), que kev.benchmark note et dont vient chaque chiffre publié, garde les lignes simples et exécute l’état une fois par question ; les deux concordent à l’arrondi fp32 près. Sur les modèles à attention seule, les lignes et le masque ci-dessus donnent des probabilités identiques (tests/test_model.py).
Kev-27B utilise la même conception sur Qwen/Qwen3.8-27B, avec deux différences. Sa base est la publication post-entraînée de Qwen plutôt qu’un checkpoint -Base, et nous ne savons pas sur quoi elle a été post-entraînée. Et chaque poids du backbone est entraîné, pas seulement un adaptateur, et gardé en bf16, donc le checkpoint est le modèle entier : 51 GB de poids bf16 plus la tête pointeur. Il ne sert qu’en bf16 (environ 66 GB résidents avec les tampons de service), ce qui explique qu’il ait besoin d’une carte 80 GB. Sur Apple Silicon, le backend MLX charge ces poids tels quels, sans fusion (voir Performances de service) ; nous nous attendons à ce que cela tienne dans un Mac 96–128 GB mais ne l’avons pas mesuré. Ses probabilités servies restent à moins de 0.022 du chemin d’évaluation sur un H200 (runs/serving-27b-r23).
La tête pointeur évalue l’état caché </opt> de chaque option contre l’état caché <decide> de la question. Un softmax transforme ces scores en probabilités. Comme <decide> vient en dernier, il peut assister à la liste complète des options.
L’entraînement utilise l’entropie croisée sur la bonne réponse. L’adaptateur et la tête sont entraînés ensemble ; le reste des poids de base reste figé (Kev-27B les entraîne tous). Les exemples d’entraînement et les requêtes d’API utilisent le même format de texte. Aucune sortie de Jev n’a servi à l’entraînement.
Poser les questions ensemble ou séparément produit des probabilités à moins de 4e-6 dans les tests fp32. Cela ne signifie pas que l’ordre des options soit sans importance : les options au sein d’une question peuvent encore s’influencer. Voir le code du modèle et les tests de parité.
Entraînement
Les modèles publiés partagent un seul ensemble d’entraînement de base, decision-v7 : 10 000 exemples issus de dix jeux de données publics, 896 exemples de politique générés, et 1 680 exemples issus de 60 structures de règles générées. Kev-0.8B, 4B et 9B s’y entraînent pendant deux époques avec LoRA de rang 16 et entropie croisée. Le taux d’apprentissage est 1e-4 pour le 0.8B et 5e-5 pour le 4B et le 9B. Sur ces bases hybrides, l’adaptateur couvre les projections d’attention, de MLP et DeltaNet ; kev.train choisit les bonnes cibles d’après la config du modèle.
Kev-0.8B, 4B et 9B reçoivent ensuite de courts fine-tunings de suivi depuis leurs checkpoints publiés, par le même chemin --init_from que tu utiliserais pour tes propres données : des cas générés qui énoncent des décomptes de jours ou dont la preuve décisive a été retirée (les trois), puis de vrais documents et des données de compétences générées (les trois ; Kev-9B depuis la v2, 2026-09-30). Kev-27B est entraîné différemment. Chaque poids de la base est fine-tuné pendant une époque sur huit H200 (--full_ft 1, taux d’apprentissage 2e-6) sur un corpus de 145 840 enregistrements : les données propres de Kev, les suites de documents, de compétences et d’outillage pour développeurs, des jeux de données publics, des familles de tâches sous licence et des enregistrements générés de documents longs, de routage d’outils, de journaux d’agent et de garde-fous, avec des états d’au plus 32 768 jetons. Le résultat est ensuite moyenné avec le Kev-27B antérieur entraîné par adaptateur, 0.85 contre 0.15. Les fiches de modèle listent chaque étape avec ses données et son coût.
# sanity run, ~1 minute
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# the first stage of Kev-0.8B (~20 min on one H100; the Mac path works but is slow for Qwen3.5 bases)
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base --base_revision dc7cdfe2ee4154fa7e30f5b51ca41bfa40174e68 \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b

# the first stage of Kev-4B (one H100 via Modal, ~1 h; see below). Swap in Qwen/Qwen3-4B-Base for the previous generation.
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base --base_revision 1001bb4d826a52d1f399e183466143f4da7b741b \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
Utilise uv run python -m kev.train --help pour toutes les options d’entraînement. Les modèles publiés n’utilisent pas les pertes optionnelles --perm_kl ou --ord_w. PLAN.md consigne ce qui a été essayé, ce qui a aidé et ce qui n’a pas aidé.
Modal
Chaque essai a son propre H100. L’étude continue de tourner si tu te déconnectes, et tu peux télécharger les résultats quand elle finit :
uv run modal token new                                    # once; opens the browser
KEV_GPU=T4 uv run modal run modal_app.py::smoke           # end-to-end check, ~1 minute of GPU

uv run modal deploy modal_app.py                          # once; studies run on the deployed app and survive disconnects
uv run modal run modal_app.py::study \
    --suite evals/v7/decision-v7 --plan experiments/v7-final.json \
    --name my-study --transfer evals/v4/transfer-v4 --budget 30 --timeout 7200
uv run modal run modal_app.py::pull --name my-study       # results -> runs/my-study, ranked
Les plans d’étude listent les réglages d’entraînement. Chaque essai sauvegarde les réglages, les hachages de code, les hachages de jeux de données et les résultats. Choisis les modèles avec les résultats de développement, pas le test verrouillé. Après avoir choisi un candidat final, tu peux lire ses résultats de test une fois :
uv run modal run modal_app.py::locked_test --trial my-study/00-trial-0 --name my-candidate # one read, everBenchmarks
Les données d’évaluation sous evals/ sont gelées : les versions des jeux de données et les sommes de contrôle des fichiers sont consignées dans chaque manifeste. Les gros fichiers sont téléchargés depuis le miroir Hub et vérifiés contre ces hachages. Chaque modèle des tableaux ci-dessus est noté sur les mêmes éléments. Les chiffres de ce README et des fiches de modèle sont vérifiés en CI contre les rapports commités dont ils viennent (docs/claims.json, uv run python scripts/verify_claims.py).
| Suite | Ce qu’elle mesure |
|---|---|
decision-v7 |
Exemples tenus à l’écart des dix jeux de données d’entraînement, des politiques générées et des structures de règles (« sources entraînées ») |
transfer-v4 |
764 enregistrements issus de jeux de données et de types de politique et de règles sur lesquels Kev ne s’est jamais entraîné : QNLI, SciQ, PAWS, MMLU, Emotion, TweetEval, des politiques et règles tenues à l’écart (« nouvelles sources ») |
transfer-v9 |
transfer-v4 plus MMLU-Pro à 10 choix, des enregistrements enfouis dans du texte sans rapport, et des enregistrements « inconnaissables » dont la preuve décisive a été retirée |
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v4/transfer-v4 --out runs/my-eval      # new sources
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v9/transfer-v9 --out runs/my-eval-v9   # + MMLU-Pro, buried states, unknowable items
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v7/decision-v7 --out runs/my-eval-id   # trained sources
uv run python -m kev.benchmark --remote http://127.0.0.1:8009 --suite evals/v4/transfer-v4 --out runs/my-remote   # any System One endpoint, Jev included
Ces commandes utilisent les données de développement. Les données de test exigent --allow-test. Le benchmark rapporte l’exactitude, le score de Brier, l’erreur de calibration, la part de décisions que tu pourrais automatiser à un budget d’erreur de 5 %, les changements dus à l’ordre des options et l’isolation des questions. Sur les enregistrements inconnaissables, il rapporte à quelle fréquence le modèle répond encore avec au moins 0.9 de confiance (Kev-9B 0 %, Jev 9 %). Les chiffres d’exactitude publiés utilisent l’évaluation fp32, pas le chemin de service bf16. kev.jev exécute les mêmes questions contre Jev via Vercel AI Gateway, et kev.compare compare deux exécutions sauvegardées avec des intervalles de confiance par bootstrap apparié.
Calibration. Chaque checkpoint stocke une température, et la tête pointeur l’applique au chargement du modèle. Kev-4B (2.41) et Kev-0.8B (2.35) ont ajusté la leur sur leurs ensembles de développement en distribution ; Kev-27B (1.32) et Kev-9B (2.19) ont ajusté la leur sur des jeux de données tenus à l’écart sur lesquels ils ne se sont jamais entraînés. Un réajustement des deux plus petits modèles sur ces jeux de données tenus à l’écart a été testé et n’a été retenu pour aucun : il n’a pas amélioré Kev-4B et a rendu Kev-0.8B moins bien calibré sur ses suites de documents et de compétences (les fiches de modèle ont les chiffres). Une température ne change jamais quelle réponse gagne. Sur les nouvelles sources, elle fait passer l’erreur de calibration de Kev-9B de 0.103 à 0.041 et ses erreurs confiantes (mauvaises réponses avec probabilité ≥ 0.9) de 8.2 % à 2.4 %, sous les 3.7 % de Jev. Les chiffres d’exactitude ci-dessus sont les mêmes dans les deux cas ; les chiffres de Brier portent sur les probabilités brutes. scripts/calibrate_checkpoint.py rapporte aussi une estimation hors pli, donc l’ajustement en échantillon peut être vérifié contre des enregistrements qu’il n’a pas vus.
Dates. Kev ne sait pas soustraire des dates de façon fiable, mais il peut utiliser un décompte de jours qu’on lui donne. KEV_DATE_FACTS=1 ajoute une phrase par paire de dates dans l’état (« June 26, 2026 is 8 days before July 4, 2026 »). Sur les questions de politique deadline, cela fait passer Kev-9B de 0.80 à 0.90 (Jev 0.93). Aucun des tableaux ne l’utilise.
Les ensembles de test d’autres personnes. evals/external/ contient des ensembles de test d’autres projets, convertis à ce format, avec leurs résultats Jev publiés en direct. Certains ont été notés sur des versions antérieures des poids Kev, que la colonne Kev nomme. Trois ont été retirés parce qu’ils ne peuvent pas servir de garde, et les fiches de modèle gardent les chiffres sur lesquels leurs publications ont été décidées : les tickets de support synthétiques de scienthoon le 2026-09-27 (texte gabarit ; une de ses trois questions dépend d’une règle que le texte n’énonce pas), et le 2026-09-30 WANLI (wanli-v1, wanli-v2 : un quart des paires sont des paires que les deux annotateurs de WANLI ont étiquetées différemment, avec l’or fixé à l’une d’elles) et les évaluations publiques de TypeSafe (typesafe-v1 : l’or est la réponse moyennée de deux modèles frontière fermés, et sur 89 questions il ne peut pas distinguer les checkpoints).
| Suite | Ce que c’est | Jev | Kev |
|---|---|---|---|
| SemIf | 144 décisions rédigées | 0.965 | 0.917 (Kev-9B à v7-base) |
Les étiquettes de SemIf tiennent, mais la suite est proche de la saturation : chaque checkpoint Kev-27B répond correctement à 130 des 144, donc c’est un contrôle de bon sens, pas un moyen de classer les modèles.
Performances de service
Choisis le GPU selon le modèle :
| Modèle | GPU ($/h) | 6 questions, texte court | 5 questions, texte de 2 200 jetons | Requêtes/s, 64 clients |
|---|---|---|---|---|
| Kev-0.8B | L4 (0.80) | 22.7 / 16.1 ms | 108.6 / 32.3 ms | 62.8 |
| Kev-4B | L40S (1.95) | 41.5 / 27.7 ms | 145.2 / 43.0 ms | 51.4 |
| Kev-4B | H100 (3.95) | 18.1 / 12.9 ms | 89.4 / 22.5 ms | 100.8 |
| Kev-9B | L40S (1.95) | 66.4 / 42.7 ms | 235.6 / 57.5 ms | 32.7 |
| Kev-9B | H100 (3.95) | 24.0 / 16.6 ms | 88.5 / 26.4 ms | 79.5 |
| Kev-27B | B200 (6.25) | 46.5 / 32.2 ms | 178.0 / 52.1 ms | 44.2 |
| Kev-27B | H200 (4.54) | 67.2 / 50.0 ms | 274.8 / 73.8 ms | 28.6 |
| Kev-27B | H100 (3.95) | 75.0 / 52.0 ms | 277.5 / 79.3 ms | 28.9 |
Les temps sont le temps de modèle par requête (le latency_ms que renvoie l’API), médiane sur 20, pour un texte nouveau / le même texte à nouveau. Le serveur met le texte en cache, donc poser plus de questions sur un document déjà envoyé ne paie que les questions. Les requêtes par seconde concernent 64 clients simultanés envoyant chacun six questions sur un nouveau texte court ; le serveur les groupe. Les lignes B200 et H100 de Kev-27B ont été mesurées sur sa version précédente, la même architecture servie en bf16 (runs/fused-27b-*) ; la ligne H200 est le checkpoint actuel (runs/serving-27b-r23). Le temps réseau est en plus : environ 65 ms par aller-retour via un point de terminaison web Modal dans la même région.
Une L4 suffit pour Kev-0.8B mais est trop lente pour Kev-4B. L’A100 est plus lente que la L40S ici et coûte plus cher. Kev-9B a besoin d’environ 17 GB de mémoire GPU et Kev-27B de 51 GB de poids (environ 66 GB avec les tampons de groupage) ; sous charge, Kev-27B est limité par le calcul, et un B200, H200 ou H100 coûte à peu près autant par requête. Sur CUDA, installe flash-linear-attention pour les modèles Qwen3.5 (kev_serve.py et les images Modal le font déjà).
Sur Apple Silicon, uv sync --extra serve installe MLX et le serveur l’utilise automatiquement. Cinq questions sur un texte d’environ 270 jetons sur un M5 (32 GB) :
| Modèle | Texte nouveau | Même texte à nouveau |
|---|---|---|
| Kev-0.8B | 149 ms | 28 ms |
| Kev-4B | 721 ms | 136 ms |
Les documents longs sont lus dans le cache par blocs de 1 024 jetons, donc la mémoire reste proche des poids. Avec un document de 65 000 jetons, Kev-0.8B prend 21.2 s la première fois et 202 ms ensuite, à un pic de 3.8 GB, et Kev-4B 84.5 s et 716 ms à 13.0 GB (runs/mlx-long-states ; les fiches de modèle ont chaque longueur). Kev-9B n’a pas encore été mesuré de cette façon.
Les checkpoints adaptateurs sont repliés dans la base au chargement, ce qui détient brièvement une seconde copie des poids. Les checkpoints à poids complets comme Kev-27B se chargent tels qu’enregistrés, sans rien fusionner, donc le chargement n’a besoin que des poids. Nous l’avons vérifié sur un Kev-4B écrit comme poids bf16 complets : le chargement a culminé à 8.4 GB pour 8.4 GB de poids, contre 15.9 GB pour le chemin adaptateur. Ses réponses correspondaient exactement au chemin adaptateur une fois que les deux détenaient les mêmes valeurs bf16, et restaient à moins de 0.015 du chemin fp32 sur 60 questions (runs/mlx-full-4b). Les poids de Kev-27B font 51 GB. D’après les mêmes mesures, il a besoin d’environ 51 GB plus la mémoire de travail, donc un Mac 64 GB est limite et un Mac 96–128 GB devrait convenir. Nous ne l’avons pas encore exécuté sur un Mac aussi grand. La première version de Kev-27B, un adaptateur, a bien tourné ainsi sur un M5 Max 128 GB, à l’exactitude publiée près (merci à Sean Connelly, #175).
Le serveur tourne en bf16 sur GPU et Mac. Ses probabilités diffèrent du chemin fp32 qu’utilisent les évaluations publiées d’au plus environ 0.03 sur un GPU et 0.05 sur un Mac, et la meilleure réponse change sur environ une question sur 300. Définis KEV_DTYPE=fp32 pour le chemin exact. /v1/models rapporte le backend et la précision en usage. uv run modal run modal_app.py::serving --run jaredpalmer/kev-4b --gpu L40S --name <name> mesure une ligne du tableau sur ton propre compte (les lignes ci-dessus : runs/serve-*, runs/grouping-4b-h100, runs/fused-27b-*, runs/serving-27b-r23).
Limites
- La calibration est une seule température. Elle ne peut pas réordonner les confiances, donc la part de décisions de nouvelles sources que tu peux automatiser à un budget d’erreur de 5 % (0.52–0.69 pour Kev-4B, 9B et 27B) reste sous les 0.70 de Jev. Teste un seuil de probabilité sur tes propres données avant de t’y fier.
- Les questions de connaissances sont fixées par le modèle de base. MMLU est 0.73 pour Kev-9B contre 0.90 pour Jev, et MMLU-Pro 0.59 contre 0.84.
- Le fine-tuning peut rendre le modèle de base moins bon sur certaines tâches. L’arithmétique de dates en était le cas le plus clair (issue #8) ; l’entraînement sur des décomptes de jours énoncés plus
KEV_DATE_FACTS=1la rétablit. - Changer l’ordre des options peut changer une réponse. L’isolation des questions ne l’empêche pas.
- Kev-0.8B, 4B et 9B se sont entraînés surtout sur au plus 384 jetons d’état et 1 024 jetons pour l’état plus une question (leurs fine-tunings de documents et de compétences sur des états d’au plus 7 552 jetons), Kev-27B sur des états d’au plus 32 768 jetons. Le service autorise un état de 65 536 jetons ; la longueur de contexte validée de chaque modèle est dans Modèles.
- Sur un Mac, les réponses prennent des centaines de millisecondes, pas des dizaines. Kev-27B a besoin d’un GPU 80 GB. Sur un Mac, il a besoin d’environ 51 GB plus la mémoire de travail ; nous nous attendons à ce qu’un Mac 96–128 GB le fasse tenir mais n’en avons pas mesuré un.
- Kev-27B part d’un modèle post-entraîné dont nous ne connaissons pas les données d’entraînement.
Développement
uv run --extra serve python -m pytest tests/test_unit.py tests/test_research.py tests/test_generators.py tests/test_conventions.py \
    tests/test_documents_tools.py tests/test_hard_v1.py tests/test_devtools_v1.py tests/test_breadth_v1.py tests/test_rounds.py tests/test_skill_scripts.py -q   # no weights, no server; what CI runs
KEV_BASE_URL=http://127.0.0.1:8009 uv run --extra serve python -m pytest tests/test_api.py -q   # against a running server
cd playground && npm run lint && npx next typegen && npx tsc --noEmit -p .
Les tests d’API exécutent les requêtes d’exemple de TypeSafe et le SDK officiel contre ton serveur local. PLAN.md est le plan de recherche : ce que nous avons appris, les règles que suit chaque expérience, et une ligne par ronde. Le journal complet (chaque expérience, les critères fixés avant son exécution, et son issue) est à l’étiquette git research-archive-2026-09-24.
Génération précédente (Qwen3) et le prototype
La première famille Kev utilisait des bases Qwen3 avec les mêmes données et réglages. Ces poids restent publiés et tournent sur du PyTorch simple sur un Mac, mais ils ne sont plus développés.
| Modèle | Base | Exactitude : sources entraînées | Exactitude : nouvelles sources | Brier : nouvelles sources | Fiche de modèle |
|---|---|---|---|---|---|
Kev-0.6B (Qwen3) — jaredpalmer/kev-0.6b |
Qwen3-0.6B-Base | 0.801 / 0.808 | 0.620 / 0.642 | 0.536 / 0.483 | Détails |
Kev-4B (Qwen3) — jaredpalmer/kev-4b@qwen3 |
Qwen3-4B-Base | 0.854 / 0.856 | 0.790 / 0.806 | 0.328 / 0.294 | Détails |
Kev-8B (Qwen3) — jaredpalmer/kev-8b |
Qwen3-8B-Base | 0.863 / 0.870 | 0.796 / 0.780 | 0.337 / 0.327 | Détails |
Le Kev-0.5B d’origine utilisait Qwen2.5-0.5B et est conservé pour référence ; voir sa fiche de modèle.
Dépannage
- Si MPS manque de mémoire pendant l’entraînement, vérifie que tu ne fais tourner qu’un seul job. N’active pas
output_hidden_stateset n’ajoute pas de jetons avectrainable_token_indicesde peft ; les deux ont causé des problèmes de mémoire ici. - Si le playground se charge mais que les boutons ne marchent pas, utilise
localhost:3001. Next.js vérifie les noms d’hôtes de développement. Les autres hôtes ont besoin d’une entrée dansallowedDevOriginsdansplayground/next.config.ts. - Si le chargement des jeux de données rapporte
Dataset scripts are no longer supported, utiliselegacy-datasets/banking77. Ce dépôt l’utilise déjà.
Auteurs
- Jared Palmer (@jaredpalmer)
Construit avec Devin. Merci à Archer Hume pour l’article sur l’architecture, à TypeSafe pour la conception de l’API, et à Qwen pour les modèles de base.
Travaux connexes : Hydragen, DeFT, FIRST.
Licence
Apache-2.0. Les modèles de base Qwen3, Qwen3.5 et Qwen3.8 sont aussi Apache-2.0. Les jeux de données d’entraînement ont leurs propres licences ; voir les fiches de modèle.