Pequeños modelos de decisión tipo Jev que puedes entrenar y ejecutar por tu cuenta.
Kev es una familia de pequeños modelos de decisión construidos sobre Qwen3.5 y Qwen3.8 y basados en la arquitectura descrita en Jev’s Architecture Unmasked. Puedes usar los pesos preentrenados o entrenar los tuyos. La API coincide con System One de TypeSafe, así que puedes apuntar su SDK de Python a tu servidor local.
Puntos destacados
- Preguntas de sí/no (
noul), de opción múltiple (choice) y de valoración (score) en una sola solicitud. Las preguntas comparten el texto, pero no pueden leerse entre sí. - Probabilidades calibradas por defecto: cada checkpoint incluye una temperatura ajustada.
- Sustituto directo de Jev: el SDK de Python de TypeSafe funciona contra un servidor Kev sin cambios.
- Cuatro tamaños, versionados juntos como Kev 1.0: desde un 0.8B que corre en un portátil hasta un 27B para una sola GPU de centro de datos.
- Documentos de hasta 65,536 tokens, en CUDA y en Apple Silicon mediante MLX. Cada tarjeta de modelo indica hasta cuánto puede crecer un documento antes de que caiga la precisión.
- Haz fine-tuning con tus propios ejemplos etiquetados. Una skill de agente de programación ejecuta todo el ciclo en Modal, desde encontrar tus preguntas hasta servir el resultado.
- Despliega tu propio endpoint HTTPS con un solo comando. Se reduce a cero cuando está inactivo.
- Pruébalo primero en el navegador: huggingface.co/spaces/jaredpalmer/kev.
Modelos
Empieza con Kev-4B. Pasa a Kev-9B si tienes una GPU más grande, o a Kev-27B si tienes una GPU de 80 GB y quieres el Kev más preciso. Usa Kev-0.8B cuando el tamaño importe más que la precisión.
| Modelo | Base (licencia) | Se ejecuta en: CUDA | Se ejecuta en: Mac (MLX) | Contexto validado | Conjuntos reservados: índice | Tarjeta |
|---|---|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base (Apache-2.0) | L4, cualquier GPU de 4 GB | Cualquier Mac con Apple Silicon; medido hasta 65k tokens | 8,192 | 23.3 | Detalles |
| Kev-4B | Qwen3.5-4B-Base (Apache-2.0) | L40S, H100 | Mac de 32 GB; medido hasta 65k tokens | 8,192 | 38.0 | Detalles |
| Kev-9B | Qwen3.5-9B-Base (Apache-2.0) | L40S, H100 | Mac de 32 GB o mayor (esperado, no medido) | 8,192 | 41.0 | Detalles |
| Kev-27B | Qwen3.8-27B, postentrenado (Apache-2.0) | B200, H200, H100 80 GB | Mac de 96–128 GB (esperado, no medido) | 65,536 | 52.3 | Detalles |
| Jev | Alojado | API de TypeSafe | – | – | 54.0 | – |
“Conjuntos reservados” es el índice corregido por azar del Decision Index de la comunidad, evaluado sobre la partición de test de breadth-v1: 14 conjuntos de datos públicos en cinco áreas con los que ningún Kev se entrenó. “Contexto validado” es el documento más largo, en tokens, para el que la precisión en contratos reales (CUAD) se mantiene dentro de 3 puntos de la precisión del mismo modelo a 8k tokens, en el límite inferior del 95 %; cada tarjeta de modelo incluye la medición por longitud.
| Modelo | Precisión: fuentes nuevas | Precisión: fuentes entrenadas | Brier: fuentes nuevas |
|---|---|---|---|
| Kev-0.8B | 0.648 / 0.697 | 0.827 / 0.838 | 0.481 / 0.416 |
| Kev-4B | 0.817 / 0.838 | 0.873 / 0.865 | 0.269 / 0.242 |
| Kev-9B | 0.820 / 0.852 | 0.874 / 0.873 | 0.289 / 0.217 |
| Kev-27B | 0.851 / 0.889 | 0.865 / 0.866 | 0.225 / 0.156 |
| Jev | 0.857 / – | 0.845 / – | 0.211 / – |
Cada celda es desarrollo / test. “Fuentes nuevas” significa conjuntos de datos y reglas de política que Kev nunca vio durante el entrenamiento. Es lo más parecido aquí a tus propias preguntas. “Fuentes entrenadas” significa ejemplos reservados de los conjuntos de datos con los que se entrenó Kev. Elegimos los checkpoints con los conjuntos de desarrollo y leemos cada conjunto de test una sola vez por modelo publicado. Jev solo se ha ejecutado sobre los conjuntos de desarrollo de estas dos suites. El Brier puntúa toda la distribución de probabilidad, no solo la respuesta más probable; cuanto más bajo, mejor.
En fuentes nuevas, Kev-27B está a menos de un punto de Jev (0.851 frente a 0.857), y Kev-4B y Kev-9B están a menos de cuatro puntos. No sabemos con qué se entrenó Jev, así que no es una comparación controlada de las dos arquitecturas. Qué esperar dice dónde Kev está a la altura de Jev y dónde no.
Kev-0.8B, 4B y 9B parten de modelos base de Qwen y comparten una misma receta de entrenamiento: un adaptador pequeño sobre una base congelada. Kev-27B parte de la versión postentrenada de Qwen, y no sabemos con qué se entrenó; cada uno de sus pesos se ajusta, así que se distribuye como 51 GB de pesos completos en lugar de un adaptador. Cada tarjeta de modelo incluye la receta completa, todos los resultados y las versiones anteriores conservadas como etiquetas del Hub.
Kev 1.0
Los cuatro modelos anteriores se publican juntos como Kev 1.0. Cada repo del Hub tiene una etiqueta v1.0, así que --run jaredpalmer/kev-4b@v1.0 siempre carga los mismos pesos, y la release de GitHub kev-1.0 incluye los checkpoints de 0.8B, 4B y 9B con sumas de comprobación SHA-256. Los 51 GB de pesos de Kev-27B son demasiado grandes para un asset de release y están solo en el Hub.
| Modelo | Revisión del Hub de los pesos | Temperatura | Entrenado con estados de hasta |
|---|---|---|---|
| Kev-0.8B | 9a45d25e |
2.35 | undefined tokens |
| Kev-4B | 139fdd94 |
2.41 | undefined tokens |
| Kev-9B | b5d8c18e (v2) |
2.19 | undefined tokens |
| Kev-27B | 28be62e9 (v2, pesos completos) |
1.32 | 32,768 tokens |
Kev 1.0 no entrena nada nuevo. Fija los checkpoints, las tarjetas, las suites de evaluación y el código de servicio con los que se comparará la próxima generación de Kev. Las notas de la versión enumeran qué cambió desde la release anterior de la familia y qué se sabe que no funciona bien.
Inicio rápido
Pruébalo en el navegador
El Space de Hugging Face ejecuta Kev-4B y Kev-0.8B, sin nada que instalar.
Ejecútalo en local
Necesitarás Python 3.12 o 3.13 y uv. El .python-version del repo hace que uv sync use 3.13; torch todavía no tiene wheels para 3.14.
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
Esto inicia Kev-4B en tu máquina: CUDA o ROCm si tienes GPU, MLX en Apple Silicon. La primera ejecución descarga el adaptador y el modelo base. --run también acepta un directorio de checkpoint local o una revisión del Hub como jaredpalmer/kev-4b@qwen3.
En otra terminal, envíale un ticket:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
Respuesta de ejemplo de Kev-4B, ejecutándose en bf16 en un Apple M5:
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.34,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
}
El ticket menciona una devolución, una entrega tardía y un problema de facturación, y las probabilidades por departamento lo reflejan. Por eso Kev devuelve probabilidades en lugar de una única etiqueta: tu código puede enrutar los casos con confianza y enviar el resto a una persona.
Úsalo desde Python
Si ya llamas a Jev, apunta tu cliente a Kev y conserva el resto de tu código. El SDK de TypeSafe se incluye en uv sync --extra serve:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
Haz fine-tuning con tus propios datos
Los modelos publicados se entrenaron con conjuntos de datos públicos y ejemplos de política generados. Si tus preguntas son distintas, como tus propias categorías de enrutamiento, tus propias reglas de escalado u otro idioma, un fine-tuning corto suele ayudar más que cualquier cambio de prompt. También ajusta la temperatura a tus datos, así que la confianza sobre la que fijas umbrales se mide con tus propias etiquetas.
Qué esperar: en una carga de trabajo de soporte de ejemplo (tres preguntas, 1,050 registros generados, 15 minutos en una H100), el fine-tuning llevó a Kev-4B del 67.7% al 73.6% de precisión, y de automatizar el 34% de las decisiones con un presupuesto de error del 5% al 48% (detalles). Con datos reales, una época sobre 5,219 quejas de finanzas de consumo etiquetadas llevó a Kev-4B de 0.804 a 0.904 de precisión en quejas que nunca había visto. Ganancias como estas son en distribución: te dicen qué tan bien aprende Kev tu tarea, no cómo se comporta en todo lo demás. Dimensiona primero tu conjunto de datos. Con 400 registros, la ganancia en la carga de trabajo de ejemplo quedó dentro del ruido.
Con un agente de programación
npx skills add jaredpalmer/kev@kev-finetuneLuego pídele a tu agente: “haz fine-tuning de Kev con mis tickets de soporte”. La skill kev-finetune te entrevista, encuentra las preguntas que tu código ya hace a Jev o TypeSafe, convierte las etiquetas que tengas o genera suficientes con cualquier LLM para medir una ganancia, hace fine-tuning desde un checkpoint publicado en Modal, ajusta la temperatura en una porción reservada, puntúa el resultado contra el modelo intacto, despliega un endpoint y lo desmonta todo al final. No necesitas una GPU local ni un clon de este repo. Un entrenamiento de Kev-4B cuesta alrededor de $1 en una H100.
A mano
El README de la skill es la misma receta para personas: seis scripts cortos de la biblioteca estándar y una app de Modal. Para entrenar desde este repo, en su lugar, pon tus ejemplos en un archivo JSONL, una solicitud por línea. Tiene la misma forma que una solicitud a la API, más un label en cada pregunta:
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
   "priority": {"type": "score",  "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}
Para choice la etiqueta es el nombre de la opción, para noul es true o false, y para score es la posición del nivel empezando en 0. Reserva un 10–20% del archivo para evaluación.
Luego parte de un checkpoint publicado con --init_from:
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine

uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
uv run --extra serve python -m kev.serve --run runs/mine --port 8009
--init_from carga el adaptador y la cabeza de puntero del modelo publicado antes del entrenamiento, así conservas lo que Kev ya sabe y añades tu dominio encima. Partir del modelo base en su lugar tira eso por la borda: en una prueba de un usuario con 836 decisiones de herramientas de soporte, un fine-tuning desde la base puntuó 0.33 en el propio conjunto de evaluación de Kev, frente a 0.84 del modelo publicado; los mismos datos con --init_from mantuvieron 0.83 ahí y llegaron a 0.88 en el nuevo dominio. Usa una tasa de aprendizaje menor que la receta desde cero (2e-5 es un buen comienzo) y elige --base para que coincida con el checkpoint del que partes; el entrenador comprueba que la base, la revisión, el rango de LoRA y el tamaño de la cabeza coincidan antes de cargar nada.
--batch 1 --accum 8 en bf16 hace que el modelo 0.8B quepa en una GPU de 4 GB. El benchmark informa de la precisión, la puntuación Brier y la calibración por tipo de pregunta, así puedes ver a cuáles de tus preguntas ayudó el fine-tuning. El checkpoint del que partiste queda registrado en runs/mine/training_config.json. En un Mac, ejecuta un solo trabajo de entrenamiento a la vez; dos trabajos en la misma GPU de Apple son mucho más lentos.
Despliega tu propio endpoint
Para obtener un endpoint HTTPS en lugar de un servidor local, no necesitas este repo, solo una cuenta de Modal:
pip install modal && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
Eso sirve Kev-4B en una L40S en https://<your-workspace>--kev-api.modal.run, con la misma API que arriba detrás de Authorization: Bearer <key>. Se reduce a cero cuando está inactivo, así que un endpoint sin usar no cuesta nada. La primera solicitud tras la inactividad espera unos 35 segundos a que arranque un contenedor. KEV_MODEL=jaredpalmer/kev-9b sirve otro modelo en la GPU que le convenga; Kev-27B va a una B200, con repliegue a una H200 o H100. Si usas un agente de programación, npx skills add jaredpalmer/kev@kev-deploy hace lo mismo y conecta la URL a tu código. skills/kev-deploy tiene la tabla de GPU y costes.
Un modelo al que hiciste fine-tuning con la skill kev-finetune se despliega igual desde su propia app de Modal (KEV_SERVE_SECRET=kev-serve-key KEV_SERVE_RUN=<run> modal deploy scripts/kev_modal.py; consulta su guía de despliegue). Para alojar Kev en tus propias máquinas, en su lugar, ejecuta kev.serve desde Ejecútalo en local en un equipo con GPU con --host 0.0.0.0 y ponlo detrás de tu propio proxy; Rendimiento de servicio dice qué GPU elegir.
Qué esperar
Precisión. Kev-27B está a menos de tres puntos de Jev, o por delante, en 9 de las 11 categorías de fuentes nuevas del gráfico de abajo. Kev-4B y Kev-9B están casi igual de cerca en fuentes de tipo clasificación, como enrutamiento, implicación y preguntas de ciencia. Las preguntas de conocimiento dependen sobre todo del modelo base: en MMLU Kev-9B puntúa 0.73 y Kev-27B iguala a Jev con 0.90, pero en el más difícil MMLU-Pro Kev-27B puntúa 0.675 frente al 0.840 de Jev. Los modelos más pequeños también van por detrás en aritmética de fechas con precisión de día.
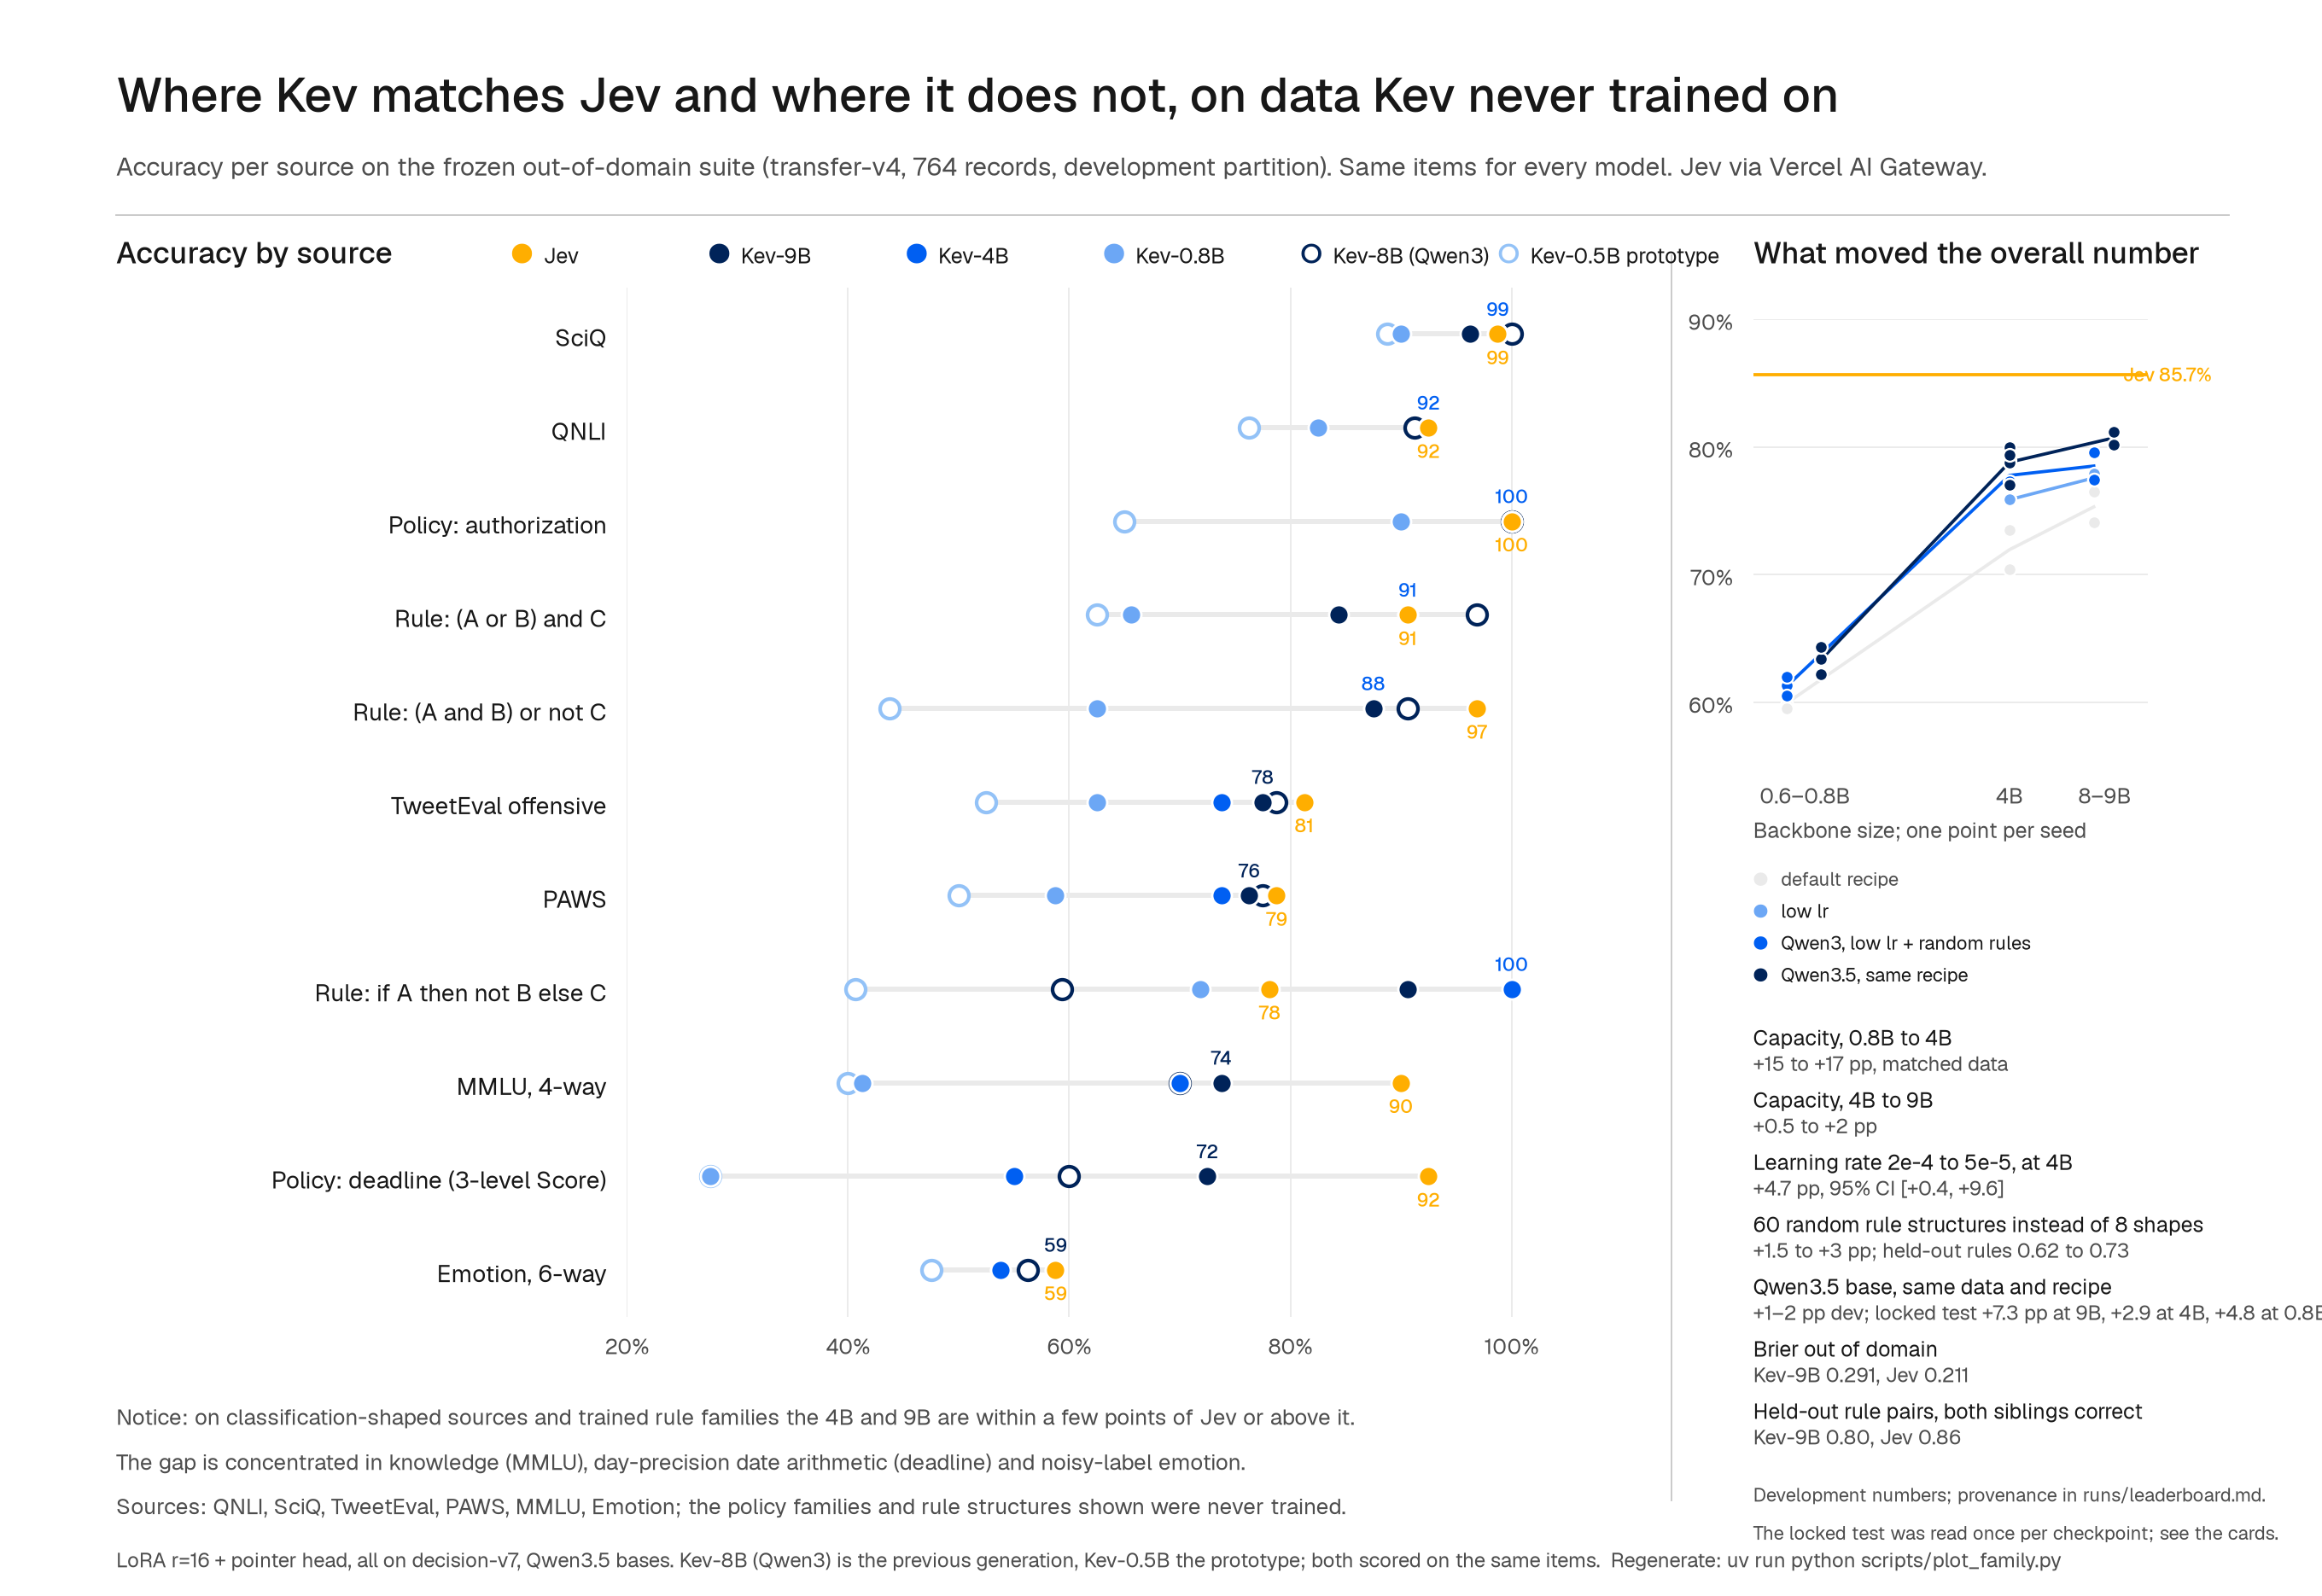
Confianza. Cada checkpoint incluye una temperatura ajustada, así que sus probabilidades están calibradas por defecto. Tal como se sirve, Kev-9B pone al menos 0.9 de probabilidad a una respuesta incorrecta en el 2.4% de las preguntas de fuentes nuevas, frente al 3.7% de Jev. Jev sigue ordenando mejor sus respuestas: con un presupuesto de error del 5%, Kev-4B, 9B y 27B pueden automatizar 0.52–0.69 de las decisiones de fuentes nuevas, Kev-0.8B 0.14 y Jev 0.70. Comprueba un umbral con tus propios datos antes de fiarte de él.
Velocidad. Kev-4B responde seis preguntas sobre un texto corto nuevo en 18.1 ms de tiempo de modelo en una H100 y 41.5 ms en una L40S, y un contenedor sirve unas 101 solicitudes por segundo en una H100. En un Apple M5, Kev-4B tarda 721 ms en cinco preguntas, o 136 ms cuando el texto se repite y viene de la caché. Rendimiento de servicio tiene todas las GPU y tamaños de lote.
Longitud. Kev-0.8B, 4B y 9B se entrenaron sobre todo con estados de hasta 384 tokens, con otros más largos en sus fine-tunings de documentos y habilidades (hasta undefined tokens), y Kev-27B con estados de hasta 32,768. El servidor acepta estados de hasta 65,536 tokens, y 8,192 más por cada pregunta, y rechaza uno más largo con un 422 en lugar de recortarlo. Hasta qué punto cada modelo sigue siendo preciso más allá de su longitud de entrenamiento es la columna “Contexto validado” en Modelos. Para Kev-0.8B, 4B y 9B son 8,192 tokens: a 16k la medición sobre contratos reales ya no puede descartar una caída de más de 3 puntos, y a 32k los tres son mediblemente menos precisos que a 8k. Kev-27B se mantiene hasta el límite de 65,536 tokens. En contratos reales de hasta 64k tokens (CUAD) Kev-27B puntúa 0.874, y su confianza ahí es menos fiable que en texto corto; su tarjeta de modelo tiene los números por longitud.
Playground
Con el servidor en marcha, abre otra terminal. Necesitarás Node 20.9+:
cd playground
npm install
npm run dev -- -p 3001
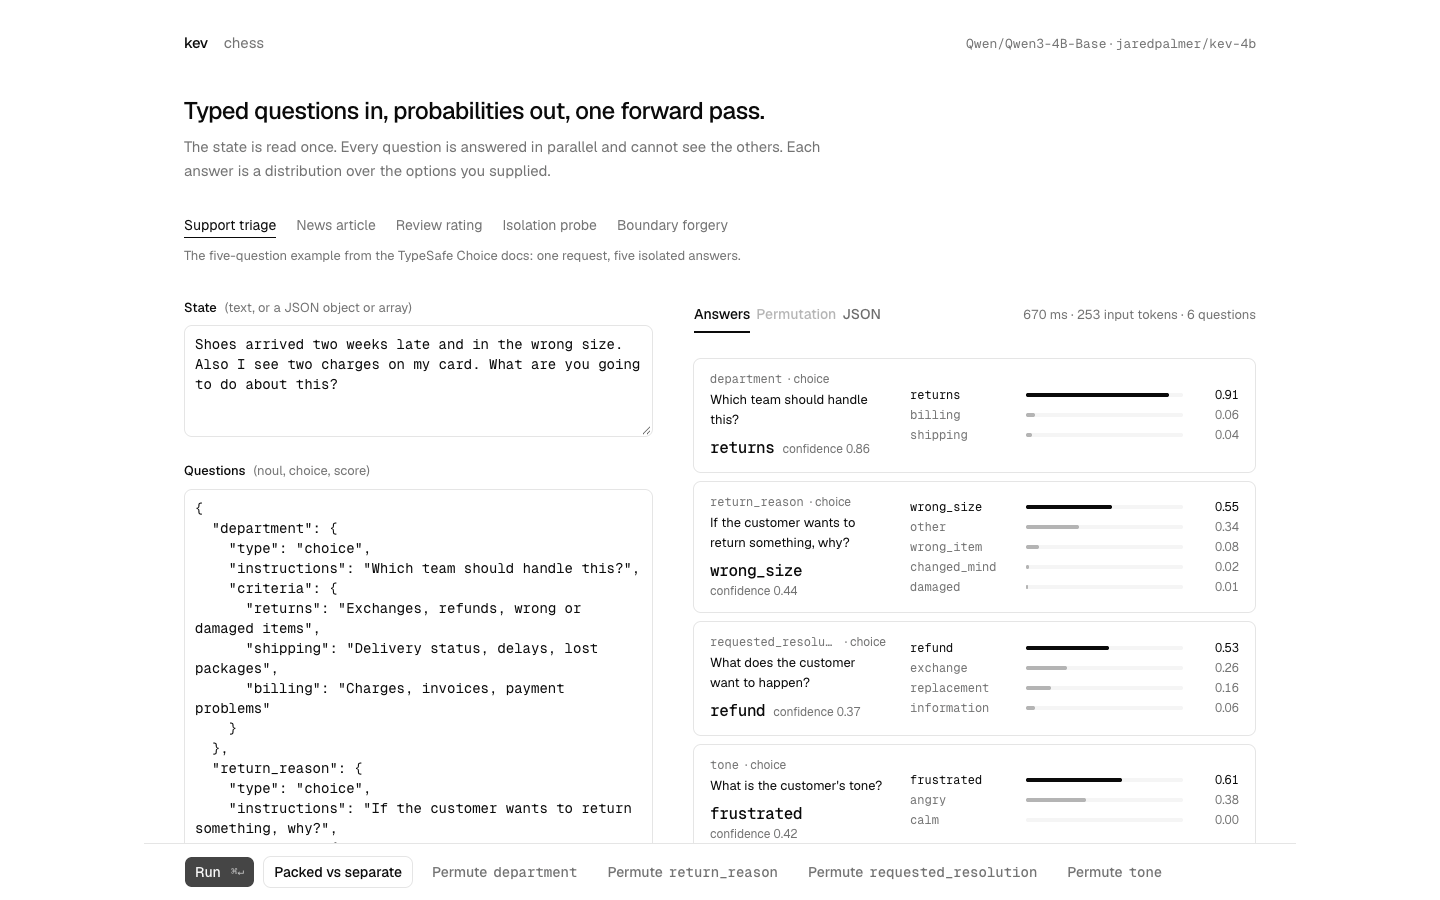
Abre localhost:3001, carga un preset y edita el texto y las preguntas. Pulsa ⌘↵ para ejecutarlo. “Packed vs separate” compara preguntar todas las preguntas a la vez con preguntarlas de una en una. “Permute” ejecuta una pregunta Choice con seis órdenes de opciones. También hay presets para probar el aislamiento de preguntas y tokens delimitadores falsos.
También hay una demo de ajedrez. El tablero es la entrada, los movimientos legales son opciones Choice y una pregunta Score valora la posición. Puedes jugar contra Kev o dejar que juegue solo. Las partidas se guardan en localStorage.
API
POST /v1/systemone
state es el texto a evaluar. Cada pregunta tiene instrucciones y, cuando hace falta, un conjunto de respuestas entre las que elegir.
{
  "state": "…",                          // string | object | array — the content to evaluate
  "model": "kev-latest",
  "questions": {
    "<id>": {                            // you choose the id; the model never sees it
      "type": "noul" | "choice" | "score",
      "instructions": "…",               // string | object | array, optional
      "criteria": …                      // noul: {true?, false?}  choice: {option: description|null}  score: [level, …]
    }
  }
}| Tipo | Criterios | Respuesta |
|---|---|---|
noul |
Descripciones opcionales para true y false |
noul: probabilidad de sí |
choice |
1–255 nombres de opción, cada uno con una descripción o null |
choice: opción más probable; probabilities y confidence |
score |
1–255 descripciones, ordenadas de menor a mayor | score: índice de nivel medio, empezando en 0; legend, probabilities y confidence |
Para Choice con K > 1 opciones, la confianza es (p_max − 1/K) / (1 − 1/K). Una sola opción tiene confianza 1. La confianza de Score es max(0, 1 − E|level − mode| / D): mode es el nivel más probable y D es la distancia media de una distribución uniforme sobre los niveles respecto a su centro (2/3 para tres niveles), así que toda la probabilidad en un nivel da 1 y una distribución uniforme o más amplia da 0. Ambas fórmulas son las del adaptador de referencia de TypeSafe (system-one-adapter 0.2.1). Ninguno de los dos campos es una tasa de precisión medida.
Los objetos y los arrays se convierten en texto etiquetado. Las cadenas que parecen delimitadores en la entrada del usuario se escapan antes de la tokenización. Las solicitudes no válidas devuelven 422, y también lo hace un estado de más de 65,536 tokens: el servidor nunca descarta parte de un documento en silencio, y el error da el número de tokens del estado y el límite. usage.output_tokens cuenta los tokens de las respuestas serializadas, no los tokens generados.
| Método | Ruta | Propósito |
|---|---|---|
GET |
/v1/models |
Tarjetas de modelo (name, description, release_date) más los detalles del checkpoint cargado |
POST |
/v1/systemone/permute |
Ejecuta una pregunta Choice con distintos órdenes de opciones (n_perm de 1 a 64, por defecto 6) |
POST |
/v1/systemone/separate |
Ejecuta cada pregunta en su propia pasada hacia adelante |
Una solicitud puede llevar cualquier número de preguntas. El servidor las ejecuta de un presupuesto de tokens en un presupuesto de tokens (una fila máxima de 16,384 tokens por pasada hacia adelante, contando el documento en caché una vez por pregunta en esa pasada), así que la memoria no crece con el número de preguntas y las respuestas no dependen de la división. Cada respuesta lleva una cabecera x-typesafe-request-id. El servidor se enlaza a 127.0.0.1 (--host 0.0.0.0 para aceptar otras máquinas) y está abierto por defecto; define KEV_API_KEY para exigir Authorization: Bearer <key> en /v1/*, como lo envían siempre los clientes de TypeSafe.
| Variable | Efecto |
|---|---|
KEV_TEMPERATURE=1.0 |
Devuelve las probabilidades sin calibrar en lugar de las calibradas |
KEV_DATE_FACTS=1 |
Añade el número de días entre cualesquiera dos fechas del estado (véase Benchmarks) |
KEV_TRUNCATE_STATES=1 |
Lee los primeros 65,536 tokens de un estado más largo en lugar de rechazarlo; cada respuesta tiene entonces truncated y usage.state_tokens / state_tokens_used |
KEV_DTYPE=fp32 |
Sirve la ruta fp32 exacta que usan las evaluaciones (bf16 es el valor por defecto en las GPU) |
KEV_API_KEY |
Exige una clave bearer |
Cómo funciona
Cada checkpoint es un adaptador LoRA de rango 16 y una pequeña cabeza de puntero sobre un modelo base de Qwen. En una base solo de atención (Qwen3), el estado y las preguntas van en una sola secuencia de tokens:
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
La máscara de atención permite que un token lea el estado y su propia pregunta, pero no otras preguntas ni tokens futuros. Los IDs de posición de cada pregunta se reinician justo después del estado. Esto permite al modelo procesar el estado una vez y responder a cada pregunta de forma independiente.
Qwen3.5 y Qwen3.8 mezclan capas de atención con capas Gated DeltaNet, que son recurrentes e ignoran las máscaras de atención. Para esos modelos, que son todos los Kev actuales, cada pregunta se ejecuta como su propia fila: el estado seguido de esa pregunta, con las mismas posiciones que arriba. Las filas son independientes, así que el aislamiento es exacto, y el servidor y DecisionModel.probs() calculan el estado una vez y reutilizan su caché para cada fila. forward(), con el que puntúa kev.benchmark y del que procede cada número publicado, conserva las filas simples y ejecuta el estado una vez por pregunta; los dos coinciden hasta el redondeo de fp32. En modelos solo de atención, las filas y la máscara de arriba dan probabilidades idénticas (tests/test_model.py).
Kev-27B usa el mismo diseño sobre Qwen/Qwen3.8-27B, con dos diferencias. Su base es la versión postentrenada de Qwen en lugar de un checkpoint -Base, y no sabemos con qué se postentrenó. Y se entrena cada peso del backbone, no solo un adaptador, y se guarda en bf16, así que el checkpoint es el modelo entero: 51 GB de pesos en bf16 más la cabeza de puntero. Sirve solo en bf16 (unos 66 GB residentes con los búferes de servicio), por eso necesita una tarjeta de 80 GB. En Apple Silicon, el backend de MLX carga esos pesos tal cual, sin fusionar nada (véase Rendimiento de servicio); esperamos que quepa en un Mac de 96–128 GB, pero no lo hemos medido. Sus probabilidades servidas se mantienen dentro de 0.022 de la ruta de evaluación en una H200 (runs/serving-27b-r23).
La cabeza de puntero puntúa el estado oculto </opt> de cada opción contra el estado oculto <decide> de la pregunta. Un softmax convierte esas puntuaciones en probabilidades. Como <decide> va al final, puede atender a la lista completa de opciones.
El entrenamiento usa entropía cruzada sobre la respuesta correcta. El adaptador y la cabeza se entrenan juntos; el resto de los pesos base permanece fijo (Kev-27B los entrena todos). Los ejemplos de entrenamiento y las solicitudes a la API usan el mismo formato de texto. No se usaron salidas de Jev para el entrenamiento.
Hacer las preguntas juntas o por separado produce probabilidades dentro de 4e-6 en las pruebas de fp32. Esto no significa que el orden de las opciones sea irrelevante: las opciones dentro de una pregunta todavía pueden afectarse entre sí. Consulta el código del modelo y las pruebas de paridad.
Entrenamiento
Los modelos publicados comparten un conjunto base de entrenamiento, decision-v7: 10,000 ejemplos de diez conjuntos de datos públicos, 896 ejemplos de política generados y 1,680 ejemplos de 60 estructuras de reglas generadas. Kev-0.8B, 4B y 9B se entrenan con él durante dos épocas con rango de LoRA 16 y entropía cruzada. La tasa de aprendizaje es 1e-4 para 0.8B y 5e-5 para 4B y 9B. En estas bases híbridas el adaptador cubre las proyecciones de atención, MLP y DeltaNet; kev.train elige los objetivos correctos a partir de la configuración del modelo.
Kev-0.8B, 4B y 9B reciben después fine-tunings de seguimiento cortos desde sus checkpoints publicados, por la misma ruta --init_from que usarías para tus propios datos: casos generados que indican recuentos de días o a los que se les quita la evidencia decisiva (los tres), y luego documentos reales y datos de habilidades generados (los tres; Kev-9B desde v2, 2026-09-30). Kev-27B se entrena de otra forma. Cada peso de la base se ajusta durante una época en ocho H200 (--full_ft 1, tasa de aprendizaje 2e-6) sobre un corpus de 145,840 registros: los datos propios de Kev, las suites de documentos, habilidades y herramientas de desarrollo, conjuntos de datos públicos, familias de tareas con licencia y registros generados de documentos largos, enrutamiento de herramientas, registros de agentes y guardarraíles, con estados de hasta 32,768 tokens. El resultado se promedia después con el Kev-27B anterior entrenado con adaptador, 0.85 frente a 0.15. Las tarjetas de modelo enumeran cada etapa con sus datos y su coste.
# sanity run, ~1 minute
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# the first stage of Kev-0.8B (~20 min on one H100; the Mac path works but is slow for Qwen3.5 bases)
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base --base_revision dc7cdfe2ee4154fa7e30f5b51ca41bfa40174e68 \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b

# the first stage of Kev-4B (one H100 via Modal, ~1 h; see below). Swap in Qwen/Qwen3-4B-Base for the previous generation.
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base --base_revision 1001bb4d826a52d1f399e183466143f4da7b741b \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
Usa uv run python -m kev.train --help para todas las opciones de entrenamiento. Los modelos publicados no usan las pérdidas opcionales --perm_kl ni --ord_w. PLAN.md registra qué se probó, qué ayudó y qué no.
Modal
Cada prueba tiene su propia H100. El estudio sigue en marcha si te desconectas, y puedes descargar los resultados cuando termine:
uv run modal token new                                    # once; opens the browser
KEV_GPU=T4 uv run modal run modal_app.py::smoke           # end-to-end check, ~1 minute of GPU

uv run modal deploy modal_app.py                          # once; studies run on the deployed app and survive disconnects
uv run modal run modal_app.py::study \
    --suite evals/v7/decision-v7 --plan experiments/v7-final.json \
    --name my-study --transfer evals/v4/transfer-v4 --budget 30 --timeout 7200
uv run modal run modal_app.py::pull --name my-study       # results -> runs/my-study, ranked
Los planes de estudio enumeran los ajustes de entrenamiento. Cada prueba guarda los ajustes, hashes de código, hashes de conjuntos de datos y resultados. Elige modelos con los resultados de desarrollo, no con el test bloqueado. Después de elegir un candidato final, puedes leer sus resultados de test una vez:
uv run modal run modal_app.py::locked_test --trial my-study/00-trial-0 --name my-candidate # one read, everBenchmarks
Los datos de evaluación bajo evals/ están congelados: las versiones de los conjuntos de datos y las sumas de comprobación de los archivos se registran en cada manifiesto. Los archivos grandes se descargan del espejo del Hub y se contrastan con esos hashes. Cada modelo de las tablas anteriores se puntúa con los mismos elementos. Los números de este README y de las tarjetas de modelo se comprueban en CI contra los informes comprometidos de los que proceden (docs/claims.json, uv run python scripts/verify_claims.py).
| Suite | Qué mide |
|---|---|
decision-v7 |
Ejemplos reservados de los diez conjuntos de datos de entrenamiento, las políticas generadas y las estructuras de reglas (“fuentes entrenadas”) |
transfer-v4 |
764 registros de conjuntos de datos y tipos de política y reglas con los que Kev nunca se entrenó: QNLI, SciQ, PAWS, MMLU, Emotion, TweetEval, políticas y reglas reservadas (“fuentes nuevas”) |
transfer-v9 |
transfer-v4 más MMLU-Pro de 10 opciones, registros enterrados en texto no relacionado y registros “imposibles de saber” cuya evidencia decisiva se eliminó |
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v4/transfer-v4 --out runs/my-eval      # new sources
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v9/transfer-v9 --out runs/my-eval-v9   # + MMLU-Pro, buried states, unknowable items
uv run python -m kev.benchmark --run jaredpalmer/kev-4b --suite evals/v7/decision-v7 --out runs/my-eval-id   # trained sources
uv run python -m kev.benchmark --remote http://127.0.0.1:8009 --suite evals/v4/transfer-v4 --out runs/my-remote   # any System One endpoint, Jev included
Estos comandos usan datos de desarrollo. Los datos de test requieren --allow-test. El benchmark informa de la precisión, la puntuación Brier, el error de calibración, la proporción de decisiones que podrías automatizar con un presupuesto de error del 5%, los cambios por orden de opciones y el aislamiento de preguntas. Sobre los registros imposibles de saber, informa de con qué frecuencia el modelo sigue respondiendo con al menos 0.9 de confianza (Kev-9B 0%, Jev 9%). Los números de precisión publicados usan evaluación en fp32, no la ruta de servicio en bf16. kev.jev ejecuta las mismas preguntas contra Jev a través de Vercel AI Gateway, y kev.compare compara dos ejecuciones guardadas con intervalos de confianza bootstrap emparejados.
Calibración. Cada checkpoint guarda una temperatura, y la cabeza de puntero la aplica cuando se carga el modelo. Kev-4B (2.41) y Kev-0.8B (2.35) ajustaron la suya en sus conjuntos de desarrollo en distribución; Kev-27B (1.32) y Kev-9B (2.19) ajustaron la suya en conjuntos reservados con los que nunca se entrenaron. Se probó un reajuste de los dos modelos más pequeños sobre esos conjuntos reservados y no se adoptó para ninguno: no mejoró Kev-4B y empeoró la calibración de Kev-0.8B en sus suites de documentos y habilidades (las tarjetas de modelo tienen los números). Una temperatura nunca cambia qué respuesta gana. En fuentes nuevas, lleva el error de calibración de Kev-9B de 0.103 a 0.041 y sus errores con confianza (respuestas incorrectas con probabilidad ≥ 0.9) del 8.2% al 2.4%, por debajo del 3.7% de Jev. Los números de precisión anteriores son los mismos en ambos casos; los números de Brier son para las probabilidades sin calibrar. scripts/calibrate_checkpoint.py también informa de una estimación fuera de pliegue, así que el ajuste en muestra puede contrastarse con registros que no vio.
Fechas. Kev no sabe restar fechas de forma fiable, pero puede usar un recuento de días que se le dé. KEV_DATE_FACTS=1 añade una frase por cada par de fechas del estado (“el 26 de junio de 2026 es 8 días antes del 4 de julio de 2026”). En las preguntas de política deadline esto lleva a Kev-9B de 0.80 a 0.90 (Jev 0.93). Ninguna de las tablas lo usa.
Conjuntos de test de otros. evals/external/ contiene conjuntos de test de otros proyectos, convertidos a este formato, con sus resultados publicados de Jev en vivo. Algunos se puntuaron con versiones anteriores de los pesos de Kev, que la columna Kev nombra. Tres se eliminaron porque no pueden servir como puerta, y las tarjetas de modelo conservan los números con los que se decidieron sus publicaciones: los tickets de soporte sintéticos de scienthoon el 2026-09-27 (texto con plantillas; una de sus tres preguntas depende de una regla que el texto no enuncia), y el 2026-09-30 WANLI (wanli-v1, wanli-v2: un cuarto de los pares son etiquetados de forma distinta por los dos anotadores de WANLI, con el gold puesto a uno de ellos) y las evaluaciones públicas de TypeSafe (typesafe-v1: el gold es la respuesta promediada de dos modelos frontera cerrados, y con 89 preguntas no puede distinguir checkpoints).
| Suite | Qué es | Jev | Kev |
|---|---|---|---|
| SemIf | 144 decisiones escritas a mano | 0.965 | 0.917 (Kev-9B en v7-base) |
Las etiquetas de SemIf se sostienen, pero está cerca de la saturación: cada checkpoint de Kev-27B responde correctamente 130 de las 144, así que es una comprobación de cordura, no una forma de clasificar modelos.
Rendimiento de servicio
Elige la GPU según el modelo:
| Modelo | GPU ($/h) | 6 preguntas, texto corto | 5 preguntas, texto de 2,200 tokens | Solicitudes/s, 64 clientes |
|---|---|---|---|---|
| Kev-0.8B | L4 (0.80) | 22.7 / 16.1 ms | 108.6 / 32.3 ms | 62.8 |
| Kev-4B | L40S (1.95) | 41.5 / 27.7 ms | 145.2 / 43.0 ms | 51.4 |
| Kev-4B | H100 (3.95) | 18.1 / 12.9 ms | 89.4 / 22.5 ms | 100.8 |
| Kev-9B | L40S (1.95) | 66.4 / 42.7 ms | 235.6 / 57.5 ms | 32.7 |
| Kev-9B | H100 (3.95) | 24.0 / 16.6 ms | 88.5 / 26.4 ms | 79.5 |
| Kev-27B | B200 (6.25) | 46.5 / 32.2 ms | 178.0 / 52.1 ms | 44.2 |
| Kev-27B | H200 (4.54) | 67.2 / 50.0 ms | 274.8 / 73.8 ms | 28.6 |
| Kev-27B | H100 (3.95) | 75.0 / 52.0 ms | 277.5 / 79.3 ms | 28.9 |
Los tiempos son tiempo de modelo por solicitud (el latency_ms que devuelve la API), mediana de 20, para un texto nuevo / el mismo texto otra vez. El servidor guarda el texto en caché, así que hacer más preguntas sobre un documento que ya enviaste solo paga las preguntas. Las solicitudes por segundo son para 64 clientes concurrentes que envían seis preguntas cada uno sobre un texto corto nuevo; el servidor los agrupa en lotes. Las filas de B200 y H100 de Kev-27B se midieron con su versión anterior, la misma arquitectura servida en bf16 (runs/fused-27b-*); la fila de H200 es el checkpoint actual (runs/serving-27b-r23). El tiempo de red es aparte: unos 65 ms por ida y vuelta a través de un endpoint web de Modal en la misma región.
Una L4 basta para Kev-0.8B, pero es demasiado lenta para Kev-4B. La A100 es más lenta que la L40S aquí y cuesta más. Kev-9B necesita unos 17 GB de memoria de GPU y Kev-27B 51 GB de pesos (unos 66 GB con los búferes de agrupación); bajo carga, Kev-27B está limitado por el cómputo, y una B200, H200 o H100 cuesta más o menos lo mismo por solicitud. En CUDA, instala flash-linear-attention para los modelos Qwen3.5 (kev_serve.py y las imágenes de Modal ya lo hacen).
En Apple Silicon, uv sync --extra serve instala MLX y el servidor lo usa automáticamente. Cinco preguntas sobre un texto de ~270 tokens en un M5 (32 GB):
| Modelo | Texto nuevo | El mismo texto otra vez |
|---|---|---|
| Kev-0.8B | 149 ms | 28 ms |
| Kev-4B | 721 ms | 136 ms |
Los documentos largos se leen en la caché de 1,024 tokens en 1,024 tokens, así que la memoria se mantiene cerca de los pesos. Con un documento de 65,000 tokens, Kev-0.8B tarda 21.2 s la primera vez y 202 ms después, con un pico de 3.8 GB, y Kev-4B 84.5 s y 716 ms con 13.0 GB (runs/mlx-long-states; las tarjetas de modelo tienen todas las longitudes). Kev-9B aún no se ha medido de esta forma.
Los checkpoints de adaptador se pliegan en la base a medida que se cargan, lo que mantiene brevemente una segunda copia de los pesos. Los checkpoints de pesos completos como Kev-27B se cargan tal cual se guardaron, sin fusionar nada, así que la carga solo necesita los pesos. Lo comprobamos con Kev-4B escrito como pesos bf16 completos: la carga alcanzó un pico de 8.4 GB para 8.4 GB de pesos, frente a 15.9 GB para la ruta del adaptador. Sus respuestas coincidieron exactamente con la ruta del adaptador una vez que ambas contienen los mismos valores bf16, y se mantuvieron dentro de 0.015 de la ruta fp32 en 60 preguntas (runs/mlx-full-4b). Los pesos de Kev-27B son 51 GB. Según esas mismas mediciones necesita unos 51 GB más memoria de trabajo, así que un Mac de 64 GB está al límite y uno de 96–128 GB debería bastar. Todavía no lo hemos ejecutado en un Mac tan grande. La primera versión de Kev-27B, un adaptador, sí se ejecutó así en un M5 Max de 128 GB, igualando la precisión publicada (gracias a Sean Connelly, #175).
El servidor se ejecuta en bf16 en GPU y Mac. Sus probabilidades difieren de la ruta fp32 que usan las evaluaciones publicadas en como máximo unos 0.03 en una GPU y 0.05 en un Mac, y la respuesta más probable cambia en aproximadamente una de cada 300 preguntas. Define KEV_DTYPE=fp32 para la ruta exacta. /v1/models informa del backend y la precisión en uso. uv run modal run modal_app.py::serving --run jaredpalmer/kev-4b --gpu L40S --name <name> mide una fila de la tabla en tu propia cuenta (las filas anteriores: runs/serve-*, runs/grouping-4b-h100, runs/fused-27b-*, runs/serving-27b-r23).
Limitaciones
- La calibración es una sola temperatura. No puede reordenar las confianzas, así que la proporción de decisiones de fuentes nuevas que puedes automatizar con un presupuesto de error del 5% (0.52–0.69 para Kev-4B, 9B y 27B) sigue por debajo del 0.70 de Jev. Prueba un umbral de probabilidad con tus propios datos antes de fiarte de él.
- Las preguntas de conocimiento las fija el modelo base. MMLU es 0.73 para Kev-9B frente al 0.90 de Jev, y MMLU-Pro 0.59 frente a 0.84.
- El fine-tuning puede empeorar el modelo base en tareas concretas. La aritmética de fechas fue el caso más claro (issue #8); entrenar con recuentos de días indicados más
KEV_DATE_FACTS=1lo recupera. - Cambiar el orden de las opciones puede cambiar una respuesta. El aislamiento de preguntas no lo impide.
- Kev-0.8B, 4B y 9B se entrenaron sobre todo con estados de como máximo 384 tokens y 1,024 tokens para el estado más una pregunta (sus fine-tunings de documentos y habilidades, con estados de hasta undefined tokens), y Kev-27B con estados de hasta 32,768 tokens. El servicio permite un estado de 65,536 tokens; la longitud de contexto validada de cada modelo está en Modelos.
- En un Mac, las respuestas tardan cientos de milisegundos, no decenas. Kev-27B necesita una GPU de 80 GB. En un Mac necesita unos 51 GB más memoria de trabajo; esperamos que un Mac de 96–128 GB pueda con él, pero no hemos medido ninguno.
- Kev-27B parte de un modelo postentrenado cuyo conjunto de datos de entrenamiento no conocemos.
Desarrollo
uv run --extra serve python -m pytest tests/test_unit.py tests/test_research.py tests/test_generators.py tests/test_conventions.py \
    tests/test_documents_tools.py tests/test_hard_v1.py tests/test_devtools_v1.py tests/test_breadth_v1.py tests/test_rounds.py tests/test_skill_scripts.py -q   # no weights, no server; what CI runs
KEV_BASE_URL=http://127.0.0.1:8009 uv run --extra serve python -m pytest tests/test_api.py -q   # against a running server
cd playground && npm run lint && npx next typegen && npx tsc --noEmit -p .
Las pruebas de API ejecutan las solicitudes de ejemplo de TypeSafe y el SDK oficial contra tu servidor local. PLAN.md es el plan de investigación: lo que hemos aprendido, las reglas que sigue cada experimento y una línea por ronda. El registro completo (cada experimento, los criterios fijados antes de ejecutarlo y cómo resultó) está en la etiqueta de git research-archive-2026-09-24.
Generación anterior (Qwen3) y el prototipo
La primera familia de Kev usaba bases Qwen3 con los mismos datos y ajustes. Esos pesos siguen publicados y se ejecutan con PyTorch normal en un Mac, pero ya no se desarrollan.
| Modelo | Base | Precisión: fuentes entrenadas | Precisión: fuentes nuevas | Brier: fuentes nuevas | Tarjeta de modelo |
|---|---|---|---|---|---|
Kev-0.6B (Qwen3) — jaredpalmer/kev-0.6b |
Qwen3-0.6B-Base | 0.801 / 0.808 | 0.620 / 0.642 | 0.536 / 0.483 | Detalles |
Kev-4B (Qwen3) — jaredpalmer/kev-4b@qwen3 |
Qwen3-4B-Base | 0.854 / 0.856 | 0.790 / 0.806 | 0.328 / 0.294 | Detalles |
Kev-8B (Qwen3) — jaredpalmer/kev-8b |
Qwen3-8B-Base | 0.863 / 0.870 | 0.796 / 0.780 | 0.337 / 0.327 | Detalles |
El Kev-0.5B original usaba Qwen2.5-0.5B y se conserva como referencia; consulta su tarjeta de modelo.
Solución de problemas
- Si MPS se queda sin memoria durante el entrenamiento, comprueba que solo se está ejecutando un trabajo. No actives
output_hidden_statesni añadas tokens contrainable_token_indicesde peft; ambos han causado problemas de memoria aquí. - Si el playground carga pero los botones no funcionan, usa
localhost:3001. Next.js comprueba los nombres de host de desarrollo. Otros hosts necesitan una entrada enallowedDevOriginsenplayground/next.config.ts. - Si la carga del conjunto de datos informa de
Dataset scripts are no longer supported, usalegacy-datasets/banking77. Este repo ya lo usa.
Autores
- Jared Palmer (@jaredpalmer)
Construido con Devin. Gracias a Archer Hume por el artículo sobre la arquitectura, a TypeSafe por el diseño de la API y a Qwen por los modelos base.
Trabajos relacionados: Hydragen, DeFT, FIRST.
Licencia
Apache-2.0. Los modelos base Qwen3, Qwen3.5 y Qwen3.8 también son Apache-2.0. Los conjuntos de datos de entrenamiento tienen sus propias licencias; consulta las tarjetas de modelo.