Extraktion vorab geparster Werte
Findet mit Regexes Kandidaten wie E-Mails, Telefonnummern und Beträge und lässt TypeSafe dann die angeforderte Spanne auswählen, damit der Code einen wörtlichen Wert normalisieren kann.
Ein Regex findet die Kandidatenwerte, TypeSafe wählt den aus, nach dem die Frage fragt, und der Code kopiert ihn wörtlich.
Das Paar find und pick hier kannst du auf deine eigenen Dokumente richten, und drei
durchgearbeitete Fälle zeigen es im Einsatz: die Adresse, an die ein Absender seinen Beleg
geschickt haben will, eine Telefonnummer als +14155550177 und ein Rechnungsbetrag als
1315.50 USD, der als Belastung gekennzeichnet ist.
TypeSafe wählt eine der Optionen, die du ihm gibst, also müssen die Kandidaten zuerst gefunden werden. Ein Regex findet sie, TypeSafe wählt einen aus und der Code kopiert die Wahl, in drei Schritten:
- Ein Regex findet die Kandidatenwerte im Text. Stimme ihn darauf ab, eher zu viel zu finden.
- TypeSafe wählt aus, nach welchem Kandidaten die Frage fragt, und liest jedes Attribut ab, das der Code nachgelagert braucht (Währung, Land, ob ein Betrag eine Gutschrift oder eine Belastung ist).
- Der Code kopiert den gewählten Wert und normalisiert ihn.
Weil TypeSafe nur jemals unter den Spannen wählt, die der Regex gefunden hat, ist der Wert, den du zurückbekommst, eine dieser Spannen, unverändert kopiert. Es kann keinen Wert erfinden oder eine Ziffer vertauschen.
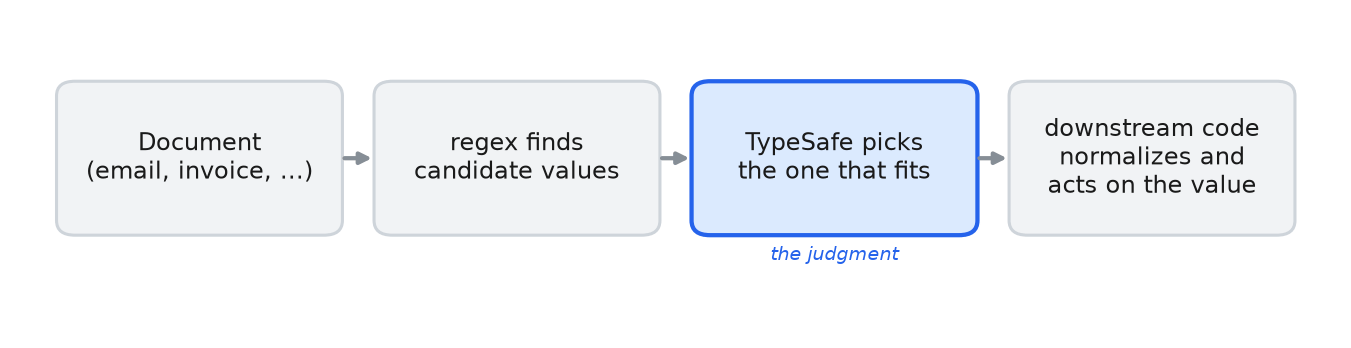
Der Regex findet Kandidatenwerte im Dokument, TypeSafe wählt einen aus, und nachgelagerter Code normalisiert ihn und handelt danach.
Einrichtung
pip install ipython phonenumbers 'cooksafe>=0.2.0,<0.3.0'Setze dann TYPESAFE_API_KEY.
import os
import re
from decimal import Decimal
from pathlib import Path

import phonenumbers
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, Noul, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
NONE = "none"  # the escape hatch on every selection: "none of the candidates fits"

# base_url defaults to https://api.typesafe.ai/ ; the env override points at another deployment.
ts = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # cached re-renders need no key
    base_url=os.environ.get("TYPESAFE_BASE_URL"),
    timeout=30.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Hilfsfunktionen
find führt einen Regex aus, der darauf abgestimmt ist, zu viel zu finden, und entdoppelt
die Treffer. pick ist eine Choice-Frage, deren Optionen die Spannen sind, die find
zurückgibt, ihre Antwort ist also eine dieser Spannen, exakt kopiert, oder none, wenn kein
Kandidat passt. classify ist eine Choice-Frage über eine feste Menge von Labels, hier für
die Währung und das Land verwendet.
is_true ist ein Noul, hier verwendet, um zu fragen, ob ein Betrag eine Gutschrift ist.
Jeder Aufruf wird in json_cache.json zwischengespeichert, sodass ein erneutes Rendern keine
API-Aufrufe macht.
EMAIL_RE = re.compile(r"[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}")
PHONE_RE = re.compile(r"\(?\+?\d[\d\s()\-.]{6,}\d")
MONEY_RE = re.compile(r"[$€£¥]\s?\d[\d,]*(?:\.\d{2})?")

def find(pattern: re.Pattern, text: str) -> list[str]:
    """Code-side candidate finder: recall-tuned regex, deduped, in document order."""
    seen: set[str] = set()
    out: list[str] = []
    for match in pattern.findall(text):
        span = match.strip()
        if span and span not in seen:
            seen.add(span)
            out.append(span)
    return out

@json_cache
def pick(document: str, candidates: list[str], question: str) -> dict:
    """TypeSafe selects which found span plays the role. Returns {choice, confidence}.

    The options ARE the candidate spans, so ``choice`` is a verbatim copy of one of them (or the
    ``none`` hatch) - the model chooses, code owns the string."""
    criteria = {c: None for c in candidates} | {
        NONE: "None of these is the requested value."
    }
    answer = ts.system_one(
        state=document,
        questions={"pick": Choice(instructions=question, criteria=criteria)},
        model=TYPESAFE_MODEL,
    ).answers["pick"]
    return {"choice": answer.choice, "confidence": answer.confidence}

@json_cache
def classify(document: str, question: str, options: list[str]) -> dict:
    """A small Choice over a fixed label set (currency, country, ...). Returns {choice, confidence}."""
    answer = ts.system_one(
        state=document,
        questions={
            "q": Choice(instructions=question, criteria={o: None for o in options})
        },
        model=TYPESAFE_MODEL,
    ).answers["q"]
    return {"choice": answer.choice, "confidence": answer.confidence}

@json_cache
def is_true(document: str, question: str) -> float:
    """A yes/no Noul. Returns P(yes)."""
    return (
        ts.system_one(
            state=document,
            questions={"q": Noul(instructions=question)},
            model=TYPESAFE_MODEL,
        )
        .answers["q"]
        .noul
    )
E-Mail: die richtige Adresse nach Rolle auswählen
Vier Adressen in den Kopfzeilen. Der Text bittet darum, den Beleg an eine persönliche Adresse
statt an den Abrechnungs-Alias To: zu schicken, die Antwort hängt also davon ab, den Text
zu lesen. Zwei Fragen hier: welche Adresse den Beleg bekommt und welche die Nachricht
gesendet hat.
EMAIL_DOC = """From: Dana Whit <dana.whit@acme-corp.com>
To: billing@acme-corp.com
Cc: orders@acme-corp.com
Reply-To: dana.personal@gmail.com

Hi team - please don't use the billing alias for this one. Send my receipt to my
personal address instead. Thanks, Dana."""

emails = find(EMAIL_RE, EMAIL_DOC)
receipt = pick(
    EMAIL_DOC, emails, "Which email address does the sender want their receipt sent to?"
)
sender = pick(
    EMAIL_DOC, emails, "Which email address did this message come from (the From line)?"
)

print("candidates :", emails)
# code copies the picked value verbatim and normalizes (lowercase); it never re-types it
print(
    f"receipt -> : {receipt['choice'].lower():<28} (conf {receipt['confidence']:.2f})"
)
print(f"sender  -> : {sender['choice'].lower():<28} (conf {sender['confidence']:.2f})")
candidates : ['dana.whit@acme-corp.com', 'billing@acme-corp.com', 'orders@acme-corp.com', 'dana.personal@gmail.com']
receipt -> : dana.personal@gmail.com (conf 0.98)
sender -> : dana.whit@acme-corp.com (conf 1.00)receipt ist die persönliche Gmail-Adresse in der Reply-To:-Zeile, was der Text verlangt;
sender ist die in der From-Zeile. Beide sind Kopien von Regex-Treffern, im Code
kleingeschrieben.
Telefon: das Mobiltelefon auswählen und nach E.164 normalisieren
Drei Nummern, keine davon mit Ländervorwahl. TypeSafe wählt das Mobiltelefon aus und liest
das Land aus dem Text; phonenumbers kombiniert diese beiden Antworten zu E.164, dem
internationalen Format, das mit einem + und der Ländervorwahl beginnt.
PHONE_DOC = """Reach our San Francisco office at these numbers: main desk (415) 555-0199,
billing fax (415) 555-0142, and my direct cell (415) 555-0177. Call the cell if it's urgent."""

phones = find(PHONE_RE, PHONE_DOC)
mobile = pick(PHONE_DOC, phones, "Which of these is the direct mobile / cell number?")
region = classify(
    PHONE_DOC,
    "In what country is this office located?",
    ["US", "GB", "DE", "FR", "CA", "AU"],
)

# code copies the picked value and normalizes it with the model-supplied country
parsed = phonenumbers.parse(mobile["choice"], region["choice"])
e164 = phonenumbers.format_number(parsed, phonenumbers.PhoneNumberFormat.E164)

print("candidates :", phones)
print(f"mobile  -> : {mobile['choice']}  (conf {mobile['confidence']:.2f})")
print(f"country -> : {region['choice']}  (conf {region['confidence']:.2f})")
print(f"E.164   -> : {e164}")
candidates : ['(415) 555-0199', '(415) 555-0142', '(415) 555-0177']
mobile -> : (415) 555-0177 (conf 1.00)
country -> : US (conf 0.90)
E.164 -> : +14155550177Nichts in den Ziffern sagt, welche Nummer das Mobiltelefon ist oder in welchem Land sie sich
befindet; die Wörter drumherum tun es. TypeSafe liest diese Wörter, und phonenumbers
formatiert die gewählte Nummer als +14155550177.
Geld: den Betrag auswählen, die Währung klassifizieren, Gutschrift oder Belastung kennzeichnen
Eine Rechnung mit vier Beträgen. TypeSafe wählt den fälligen Gesamtbetrag und die Gutschrift
aus, liest die Währung und kennzeichnet jeden gewählten Betrag als Belastung oder
Gutschrift. Der Code kopiert jede gewählte Zeichenkette und zerlegt sie in einen Decimal.
MONEY_DOC = """Invoice INV-2087.
Subtotal: $1,200.00
Sales tax: $115.50
Total due: $1,315.50
A $50.00 courtesy credit from last month has already been applied."""

amounts = find(MONEY_RE, MONEY_DOC)
currency = classify(
    MONEY_DOC,
    "What currency are these amounts in?",
    ["USD", "EUR", "GBP", "JPY", "CAD"],
)
total = pick(MONEY_DOC, amounts, "Which amount is the total the customer must pay?")
credit = pick(
    MONEY_DOC, amounts, "Which amount is the courtesy credit that was applied?"
)

def to_decimal(value: str) -> Decimal:
    """Copy the picked value and parse the number in code (US grouping/decimal here)."""
    return Decimal(re.sub(r"[^\d.]", "", value))

for label, chosen in [("total due", total), ("credit", credit)]:
    is_credit = is_true(
        MONEY_DOC,
        f"Is the amount {chosen['choice']} a credit or refund to the customer, not a charge?",
    )
    kind = "credit" if is_credit > 0.5 else "charge"
    print(
        f"{label:<10}: {chosen['choice']:<10} -> {to_decimal(chosen['choice'])} {currency['choice']} "
        f"({kind}, P(credit)={is_credit:.2f})"
    )
print("\ncandidates :", amounts)
total due : $1,315.50 -> 1315.50 USD (charge, P(credit)=0.01)
credit : $50.00 -> 50.00 USD (credit, P(credit)=0.99)
candidates : ['$1,200.00', '$115.50', '$1,315.50', '$50.00']Der fällige Gesamtbetrag ist $1,315.50 und die Gutschrift ist $50.00, beide in USD. Das
Gutschrift-oder-Belastung-Noul antwortet mit 0.01 beim Gesamtbetrag und 0.99 bei der
Gutschrift, sodass der Code das Vorzeichen jedes Decimal kennt, das er zerlegt.
to_decimalnimmt an, dass das Komma Tausender gruppiert und der Punkt das Dezimaltrennzeichen ist. Das gilt für$1,315.50; in€1.315,50ist es umgekehrt. Frag mit einerNoul-Frage, welche Konvention das Dokument verwendet, und verzweige im Code danach.
Im TypeSafe-Playground öffnen
Ein Share-Link, der den E-Mail-Thread im Browser öffnet, mit der Beleg-Frage darauf und den vier Adressen, die der Regex gefunden hat, unter seinen Optionen.
receipt_criteria = {e: None for e in emails} | {
    NONE: "None of these is the requested value."
}
playground_link = make_playground_link(
    EMAIL_DOC,
    {
        "receipt": Choice(
            instructions="Which email address does the sender want their receipt sent to?",
            criteria=receipt_criteria,
        )
    },
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this thread + selection in the TypeSafe playground]({playground_link})"
    )
)Zwei Grenzen
- Eine
Choice-Frage erlaubt höchstens 255 Optionen. Bei mehr Kandidaten als das grenzt du in zwei Stufen ein: Wähle zuerst den Abschnitt und dann die Spanne darin. - Die Kandidaten zu finden ist der Teil, der Arbeit macht. E-Mails, Telefonnummern und Beträge haben Regexes, die sie abdecken; ein Name nicht, seine Kandidaten müssen also aus einer Liste stammen, die du bereits hast, oder aus einem Named-Entity-Recognizer oder einem LLM, der sie vorschlägt. TypeSafe wählt dann den aus, nach dem die Frage fragt.