Demonstração compartilhável do Snake
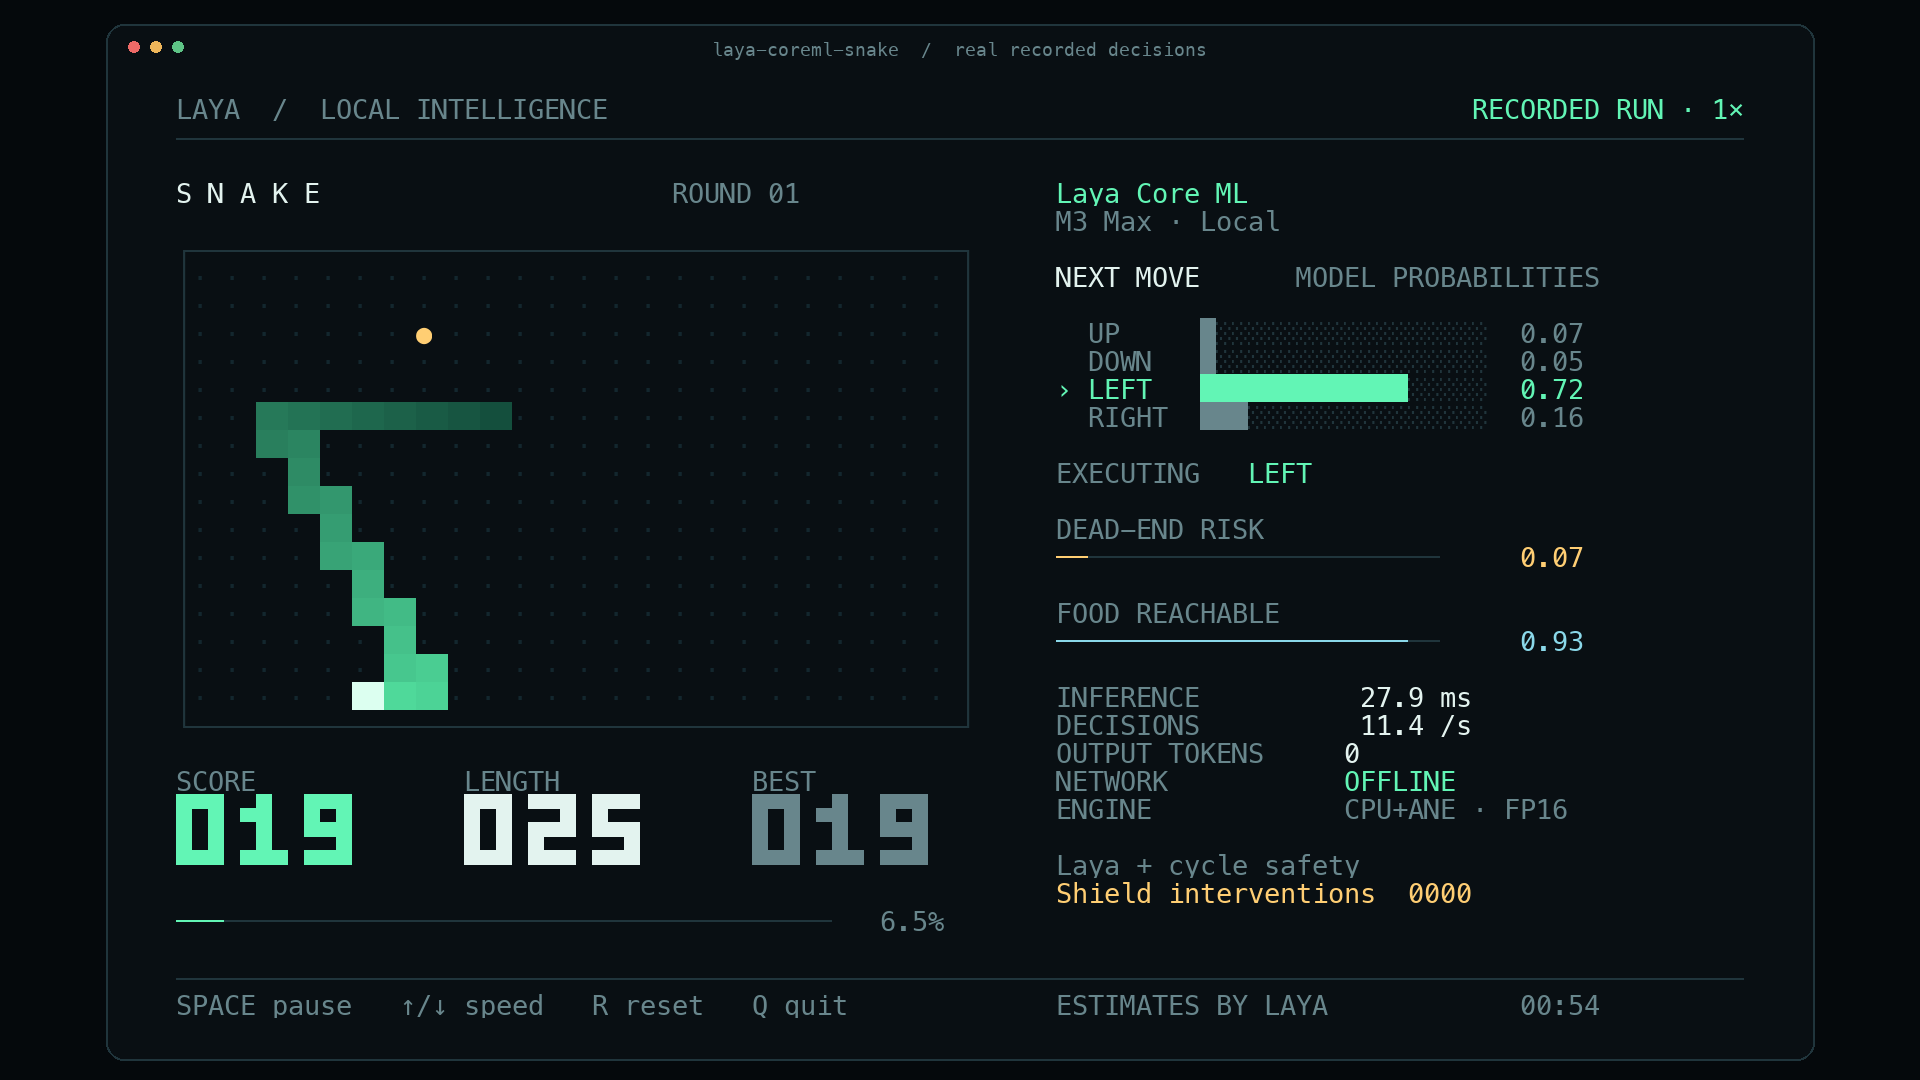
O README abre com um GIF de 15 segundos de uma execução real do terminal Core ML. O MP4 de 20 segundos, 1920×1080 correspondente é adequado para uma publicação em rede social. Ambos reproduzem a gravação original a velocidade de relógio de parede de 1×.
- Baixe o MP4
- Baixe o GIF
- Prévia em PNG
- Proveniência da mídia e hashes do renderizador
- Gravação original de 75 segundos das decisões
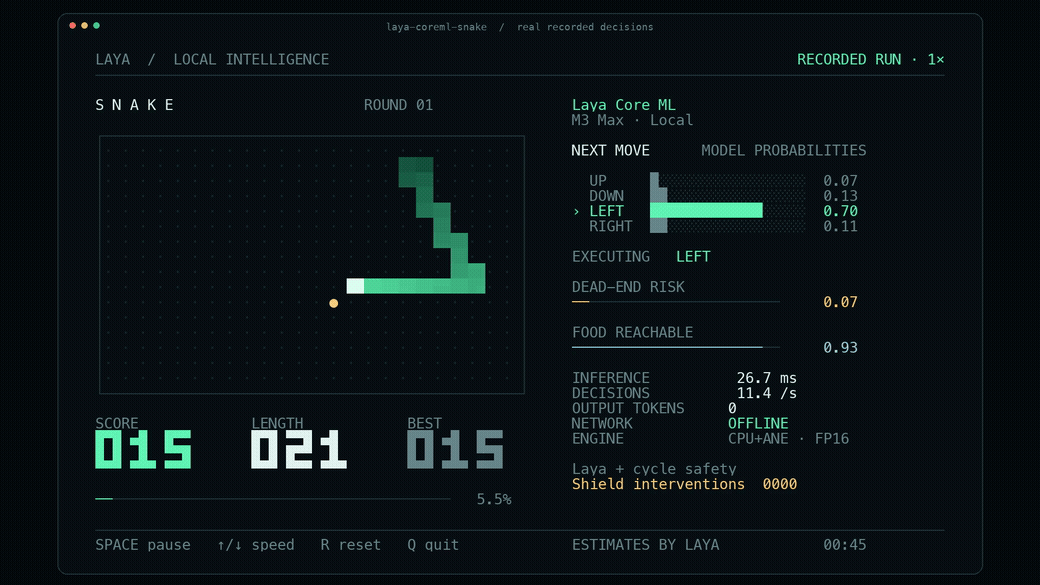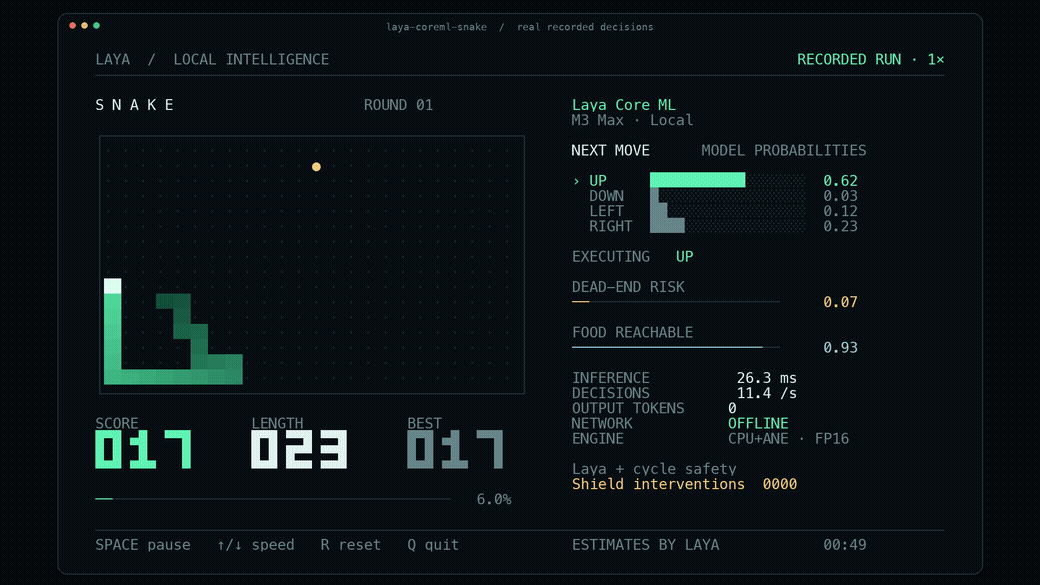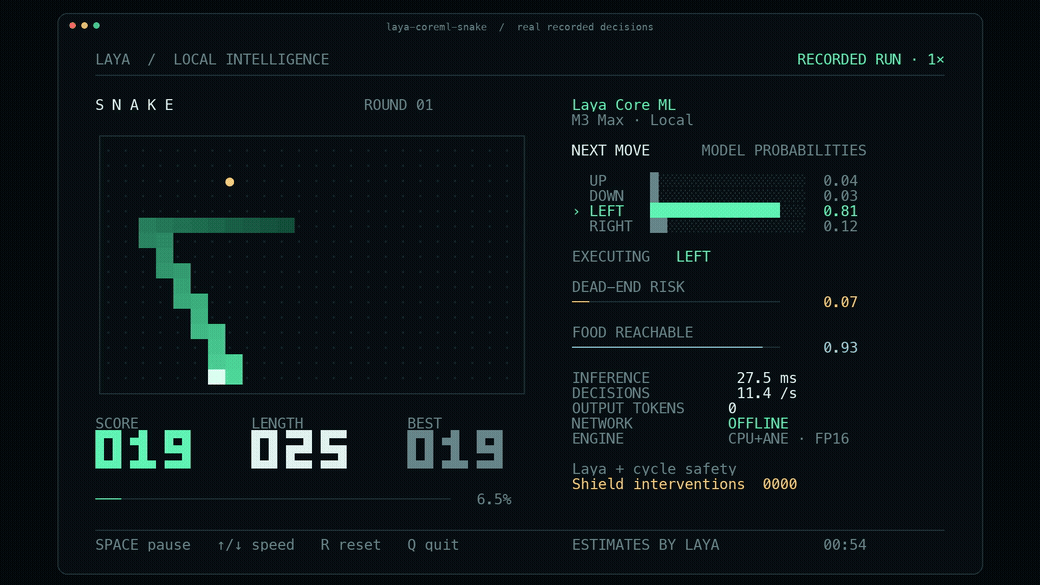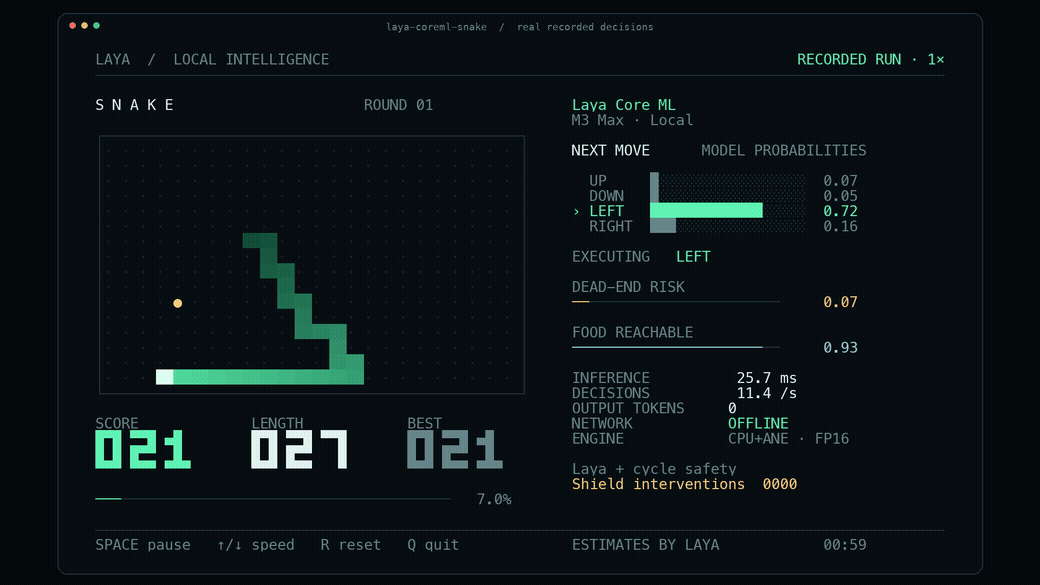

O que foi gravado
A wheel laya-coreml instalada rodou em um pseudo-terminal real de 112 colunas × 38 linhas
em um M3 Max. O modelo foi baixado do snapshot público e fixado do ANE FP16 no Hub
antes de o jogo começar. A jogabilidade rodou offline com o runtime Core ML,
sem Torch, Transformers ou MLX instalados naquele ambiente.
| Configuração ou resultado | Valor |
|---|---|
| Tabuleiro / semente | 24×16 / 7 |
| Comprimento inicial da cobra | 6 |
| Taxa de apresentação solicitada | 12 decisões/s |
| Duração real da execução | 75.034 s |
| Chamadas novas de decisão / movimentos executados | 855 / 855 |
| Taxa de decisão observada | 11.395/s |
| Pontuação / comprimento final | 26 / 32 |
| Mortes / intervenções de segurança | 0 / 0 |
predict de três perguntas P50 / P95 |
26.63 / 28.09 ms |
| Tokens de saída do modelo | 0 |
| Trecho do MP4 | Segundos 45–65, 30 quadros de vídeo/s |
| Trecho do GIF | Segundos 45–60, 10 quadros de vídeo/s |
| Prévia estática | Segundo 55 |
Os quadros de vídeo amostram as decisões originais. Eles não disparam predições
adicionais nem aceleram a cobra. O renderizador usa a mesma composição de células de terminal
da interface ao vivo e rotula as exportações como RECORDED RUN · 1×. O GIF tem
cerca de 1.6 MB; o MP4 tem cerca de 0.7 MB.
O modelo recebe recursos exatos do planejador. Uma camada de segurança de ciclo está habilitada e seu contador de intervenções permanece visível, mesmo que esta execução não tenha precisado de nenhuma substituição. Zero mortes aqui é uma observação limitada, não evidência de jogabilidade ilimitada sem assistência. O risco exibido e a alcançabilidade da comida são estimativas do modelo.
O cronômetro de inferência da interface inclui três perguntas tipadas sequenciais. O benchmark separado de 4.98 ms mede uma pergunta curta sob carga sustentada. Essas cargas de trabalho, cadências e fronteiras de medição diferem. Os testes completos de taxa do laço de jogo estão em SNAKE_BENCHMARKS.md.
Reproduza a gravação
Instale laya-coreml[demo]==0.1.0, baixe o modelo fixado de
RELEASE.md e execute:
laya-coreml-snake --model ./models/ane --seed 7 --fps 12 \
  --duration 75 --record snake.jsonl
laya-coreml-snake export snake.jsonl --start 45 --seconds 20 \
  --output snake-demo.mp4 --gif snake-demo.gif --gif-seconds 15
laya-coreml-snake export snake.jsonl --start 55 --output snake-preview.png
Para uma captura roteirizada de terminal real, o checkout do código-fonte inclui
scripts/record_terminal.py:
python scripts/record_terminal.py --log artifacts/session.ansi -- \
  laya-coreml-snake --model ./models/ane --seed 7 --fps 12 \
  --duration 75 --record snake.jsonl
Texto sugerido para publicação
Inglês:
Um modelo de decisão de 322M jogando Snake no Neural Engine do meu Mac. Zero tokens gerados. Inferência offline, probabilidades ao vivo e uma camada de segurança visível. Runtime Core ML, pesos abertos, benchmarks reproduzíveis: https://github.com/mizorewww/laya-coreml
中文:
把一个 3.22 亿参数的决策模型搬到了 Mac 的 Neural Engine 上,用它实时玩贪吃蛇。 概率实时变化,0 个生成 token,下载模型后完全离线。视频是原速实录,安全层和干预 次数直接显示在界面上。代码、权重、PyPI 包和完整 benchmark 都已开放: https://github.com/mizorewww/laya-coreml
Para um desdobramento focado em desempenho, use a afirmação exata: 4.98 ms de P50 para uma decisão multilíngue curta, com energia de sistema por decisão estimada 2.78× menor do que o MLX FP16 compilado no experimento pareado no M3 Max. Aponte para o método de medição, mantenha sua qualificação de carga de trabalho e não o rotule como tempo de quadro do Snake nem como resultado de 10×.