Teilbare Snake-Demo
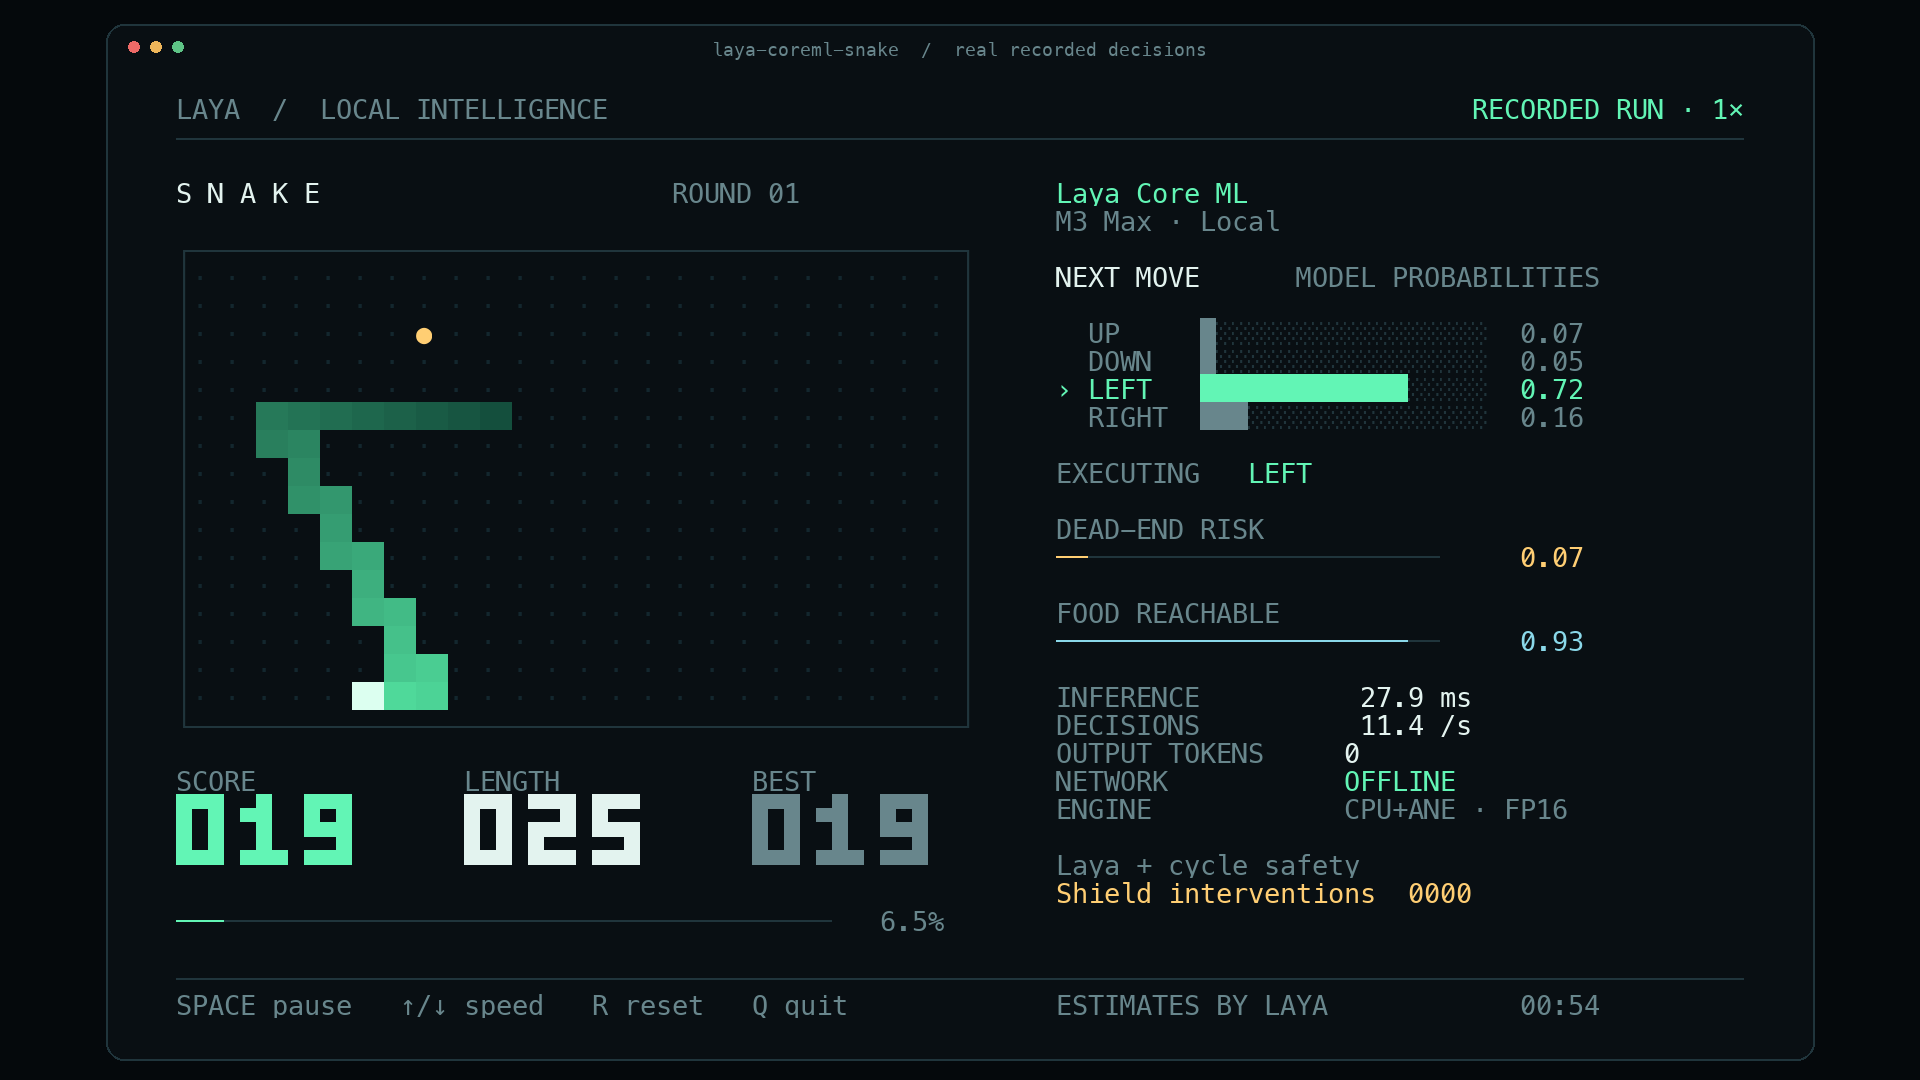
Das README beginnt mit einem 15-sekündigen GIF eines echten Core ML-Terminallaufs. Das passende 20-sekündige, 1920×1080 MP4 eignet sich für einen Social-Media-Beitrag. Beide spielen die Originalaufzeichnung in 1× Echtzeitgeschwindigkeit ab.
- Das MP4 herunterladen
- Das GIF herunterladen
- Vorschau-PNG
- Herkunft der Medien und Renderer-Hashes
- Originale 75-Sekunden-Entscheidungsaufzeichnung
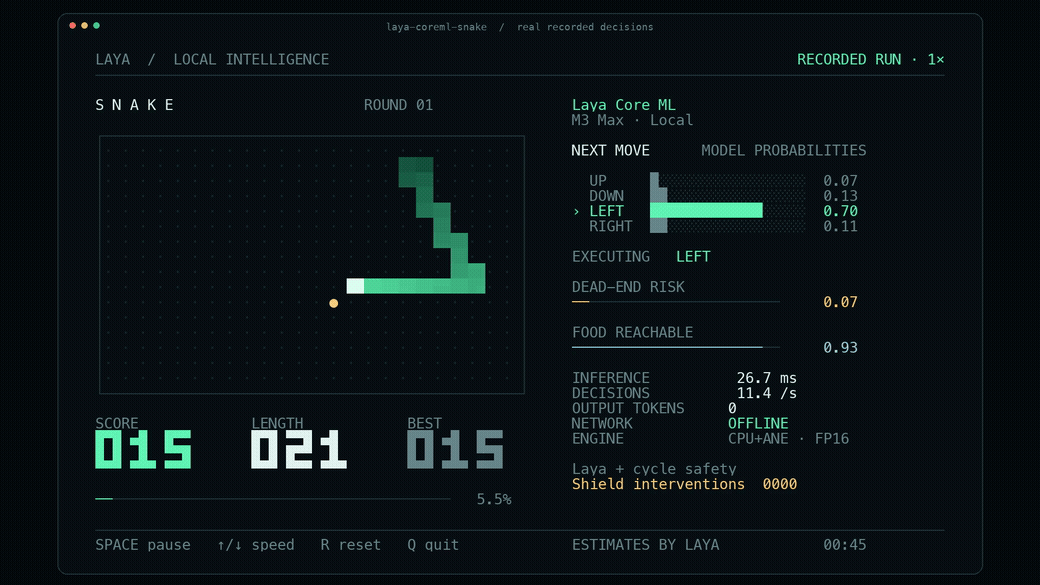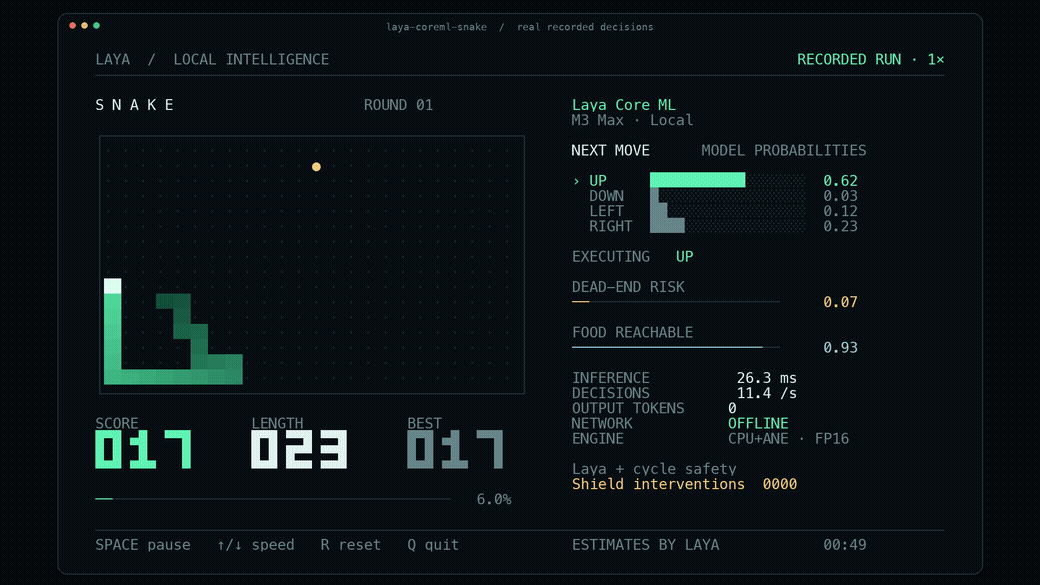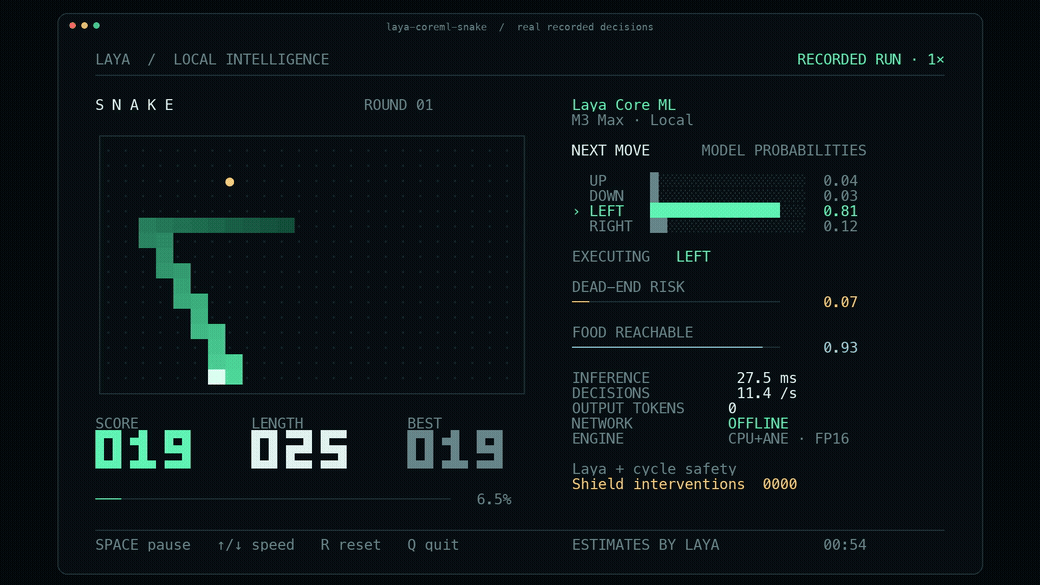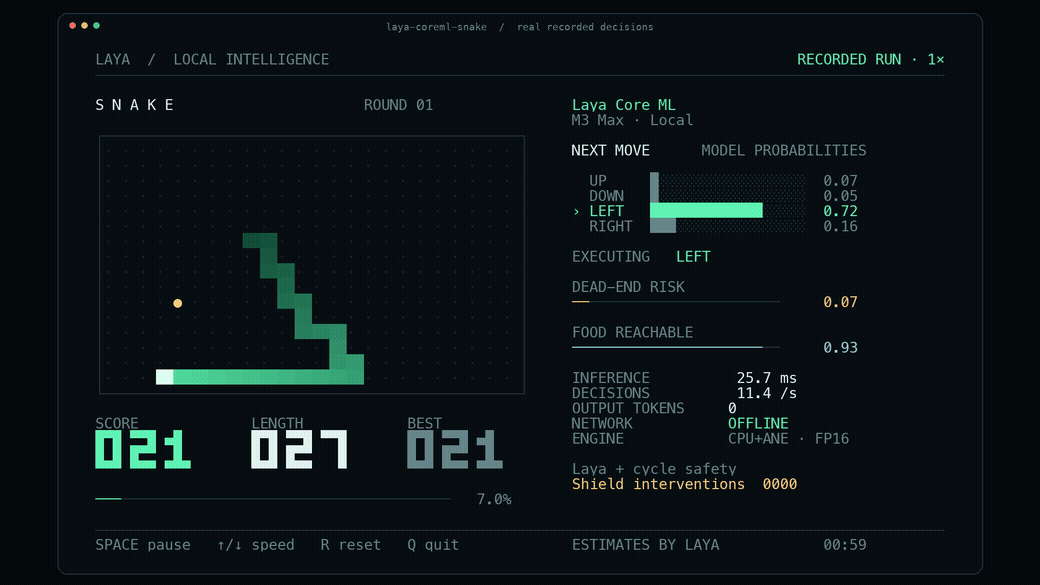

Was aufgezeichnet wurde
Das installierte laya-coreml-Wheel lief in einem echten Pseudoterminal mit 112 Spalten × 38
Zeilen auf einem M3 Max. Das Modell wurde vor Spielbeginn aus dem öffentlichen, fixierten
ANE-FP16-Hub-Snapshot heruntergeladen. Das Spiel lief offline mit der Core ML-Laufzeit, ohne
Torch, Transformers oder MLX in dieser Umgebung.
| Einstellung oder Ergebnis | Wert |
|---|---|
| Spielfeld / Seed | 24×16 / 7 |
| Anfängliche Snake-Länge | 6 |
| Angeforderte Darstellungsrate | 12 Entscheidungen/s |
| Tatsächliche Laufdauer | 75.034 s |
| Frische Entscheidungsaufrufe / ausgeführte Züge | 855 / 855 |
| Beobachtete Entscheidungsrate | 11.395/s |
| Endpunktzahl / Länge | 26 / 32 |
| Tode / Sicherheitseingriffe | 0 / 0 |
predict mit drei Fragen P50 / P95 |
26.63 / 28.09 ms |
| Ausgabe-Tokens des Modells | 0 |
| MP4-Ausschnitt | Sekunden 45–65, 30 Videoframes/s |
| GIF-Ausschnitt | Sekunden 45–60, 10 Videoframes/s |
| Standbildvorschau | Sekunde 55 |
Videoframes entnehmen Stichproben der ursprünglichen Entscheidungen. Sie lösen keine
zusätzlichen Vorhersagen aus und beschleunigen die Snake nicht. Der Renderer verwendet
dieselbe Terminal-Zellkomposition wie die Live-UI und beschriftet Exporte mit
RECORDED RUN · 1×. Das GIF ist etwa 1.6 MB groß; das MP4 etwa 0.7 MB.
Das Modell erhält exakte Planner-Features. Eine Zyklus-Sicherheitsschicht ist aktiviert, und ihr Eingriffszähler bleibt sichtbar, obwohl dieser Lauf keine Überschreibungen benötigte. Null Tode sind hier eine begrenzte Beobachtung, kein Beleg für unbegrenztes Spiel ohne Unterstützung. Das angezeigte Risiko und die Erreichbarkeit des Futters sind Modellschätzungen.
Der Inferenz-Timer der UI umfasst drei sequenzielle typisierte Fragen. Der separate 4.98-ms-Benchmark misst eine kurze Frage unter Dauerlast. Diese Workloads, die Taktung und die Timing-Grenzen unterscheiden sich. Vollständige Tests der Spielschleifenrate stehen in SNAKE_BENCHMARKS.md.
Die Aufzeichnung reproduzieren
Installiere laya-coreml[demo]==0.1.0, lade das fixierte Modell aus RELEASE.md
herunter und führe aus:
laya-coreml-snake --model ./models/ane --seed 7 --fps 12 \
  --duration 75 --record snake.jsonl
laya-coreml-snake export snake.jsonl --start 45 --seconds 20 \
  --output snake-demo.mp4 --gif snake-demo.gif --gif-seconds 15
laya-coreml-snake export snake.jsonl --start 55 --output snake-preview.png
Für eine skriptgesteuerte Aufnahme eines echten Terminals enthält der Quell-Checkout
scripts/record_terminal.py:
python scripts/record_terminal.py --log artifacts/session.ansi -- \
  laya-coreml-snake --model ./models/ane --seed 7 --fps 12 \
  --duration 75 --record snake.jsonl
Vorgeschlagener Beitragstext
Englisch:
A 322M decision model playing Snake on my Mac’s Neural Engine. Zero generated tokens. Offline inference, live probabilities, and a visible safety layer. Core ML runtime, open weights, reproducible benchmarks: https://github.com/mizorewww/laya-coreml
中文:
把一个 3.22 亿参数的决策模型搬到了 Mac 的 Neural Engine 上,用它实时玩贪吃蛇。 概率实时变化,0 个生成 token,下载模型后完全离线。视频是原速实录,安全层和干预 次数直接显示在界面上。代码、权重、PyPI 包和完整 benchmark 都已开放: https://github.com/mizorewww/laya-coreml
Für einen performanceorientierten Nachtrag verwende die exakte Aussage: 4.98 ms P50 für eine kurze mehrsprachige Entscheidung, mit 2.78× niedrigerer geschätzter Systemenergie pro Entscheidung als kompiliertes MLX FP16 im gepaarten M3 Max-Experiment. Verlinke die Messmethode, behalte ihre Workload-Qualifikation bei und bezeichne sie nicht als Snake-Frame-Zeit oder 10×-Ergebnis.